Bạn có hai, ba chiếc Mac nằm trong văn phòng, mỗi máy chạy được một mô hình AI cỡ vừa nhưng không đủ sức với các mô hình lớn hơn? Claris Harbor là lời giải mà Claris, công ty phần mềm thuộc Apple, đang thử nghiệm: biến những chiếc Mac bạn đã có thành một máy chủ AI riêng, và khi một máy không đủ bộ nhớ thì ghép nhiều máy lại bằng cáp Thunderbolt 5.
Câu trả lời ngắn: Claris Harbor là ứng dụng biến máy Mac chip Apple silicon thành máy chủ AI cục bộ, chạy mô hình trọng số mở mà không trả phí theo token, dữ liệu không rời khỏi máy. Nhiều Mac có thể nối qua Thunderbolt 5 để gộp bộ nhớ, chạy mô hình lớn hơn. Harbor hiện mới ở dạng xem trước riêng tư.
Bài viết này không chỉ đưa tin. Chúng ta sẽ đi vào câu hỏi thú vị hơn: ghép nhiều máy để chạy một mô hình AI lớn hoạt động ra sao, vì sao hai máy 64 GB không bằng một máy 128 GB, và nếu muốn thử ngay hôm nay thì làm thế nào.
Tóm tắt nhanh
- Claris Harbor biến Mac thành máy chủ AI riêng, chạy mô hình trọng số mở, không phí đám mây hay phí theo token.
- Nhiều Mac có thể ghép cụm qua Thunderbolt 5 để gộp bộ nhớ hợp nhất, chạy mô hình quá lớn cho một máy.
- Harbor đang là bản xem trước riêng tư, chưa công bố ngày ra mắt, giá hay cấu hình tối thiểu.
- Cáp Thunderbolt 5 (80 Gb/s, khoảng 10 GB/s) vẫn chậm hơn bộ nhớ trong hàng chục lần, nên thêm máy không làm tốc độ tăng theo cấp số.
- Muốn thử ghép cụm ngay, bạn có thể dùng Exo, công cụ mã nguồn mở hỗ trợ Thunderbolt 5 từ macOS 26.2.
Nội dung chính:
- Claris Harbor là gì?
- Vì sao cần ghép nhiều máy để chạy AI?
- Chạy mô hình AI trên nhiều máy Mac hoạt động thế nào?
- Thunderbolt 5 và bộ nhớ hợp nhất: nút thắt nằm ở đâu
- Hai máy 64 GB có bằng một máy 128 GB?
- So sánh Harbor, Exo, LM Studio và Ollama
- Ứng dụng cho văn phòng và doanh nghiệp nhỏ ở Việt Nam
- Cách thử ghép cụm AI bằng Exo ngay hôm nay
- Rủi ro khi tự chạy AI tại chỗ
- Câu hỏi thường gặp
Claris Harbor là gì?
Theo trang giới thiệu chính thức, Claris Harbor “biến các máy tính Apple silicon bạn sở hữu thành một máy chủ AI riêng tư”. Nói đơn giản, thay vì gửi câu hỏi lên dịch vụ AI trên đám mây và trả tiền theo lượng chữ xử lý, bạn tải một mô hình về chạy ngay trên Mac, rồi để các máy và ứng dụng khác trong mạng nội bộ gửi yêu cầu tới đó.
Claris tự giới thiệu là “một công ty của Apple”. Đây là đơn vị làm phần mềm cho doanh nghiệp, nổi tiếng với nền tảng tạo ứng dụng FileMaker. Harbor được nhắc đến rộng rãi sau khi một bài đăng trên mạng xã hội X ngày 10/11/2026 chia sẻ trang đăng ký của sản phẩm.
Bốn điểm chính Claris công bố
- Máy chủ AI tại chỗ: có thể dựng một điểm kết nối (endpoint) trong vài phút trên một máy Mac.
- Mô hình trọng số mở: chạy các mô hình open-weight, tức mô hình mà nhà phát triển công bố cả phần “bộ não” đã huấn luyện để ai cũng tải về được.
- Không phí theo token: không trả phí đám mây cho mỗi lần hỏi. Chi phí chủ yếu là máy và điện.
- Ghép cụm Thunderbolt 5: nối nhiều máy để gộp bộ nhớ hợp nhất, phục vụ các mô hình đòi hỏi nhiều bộ nhớ.
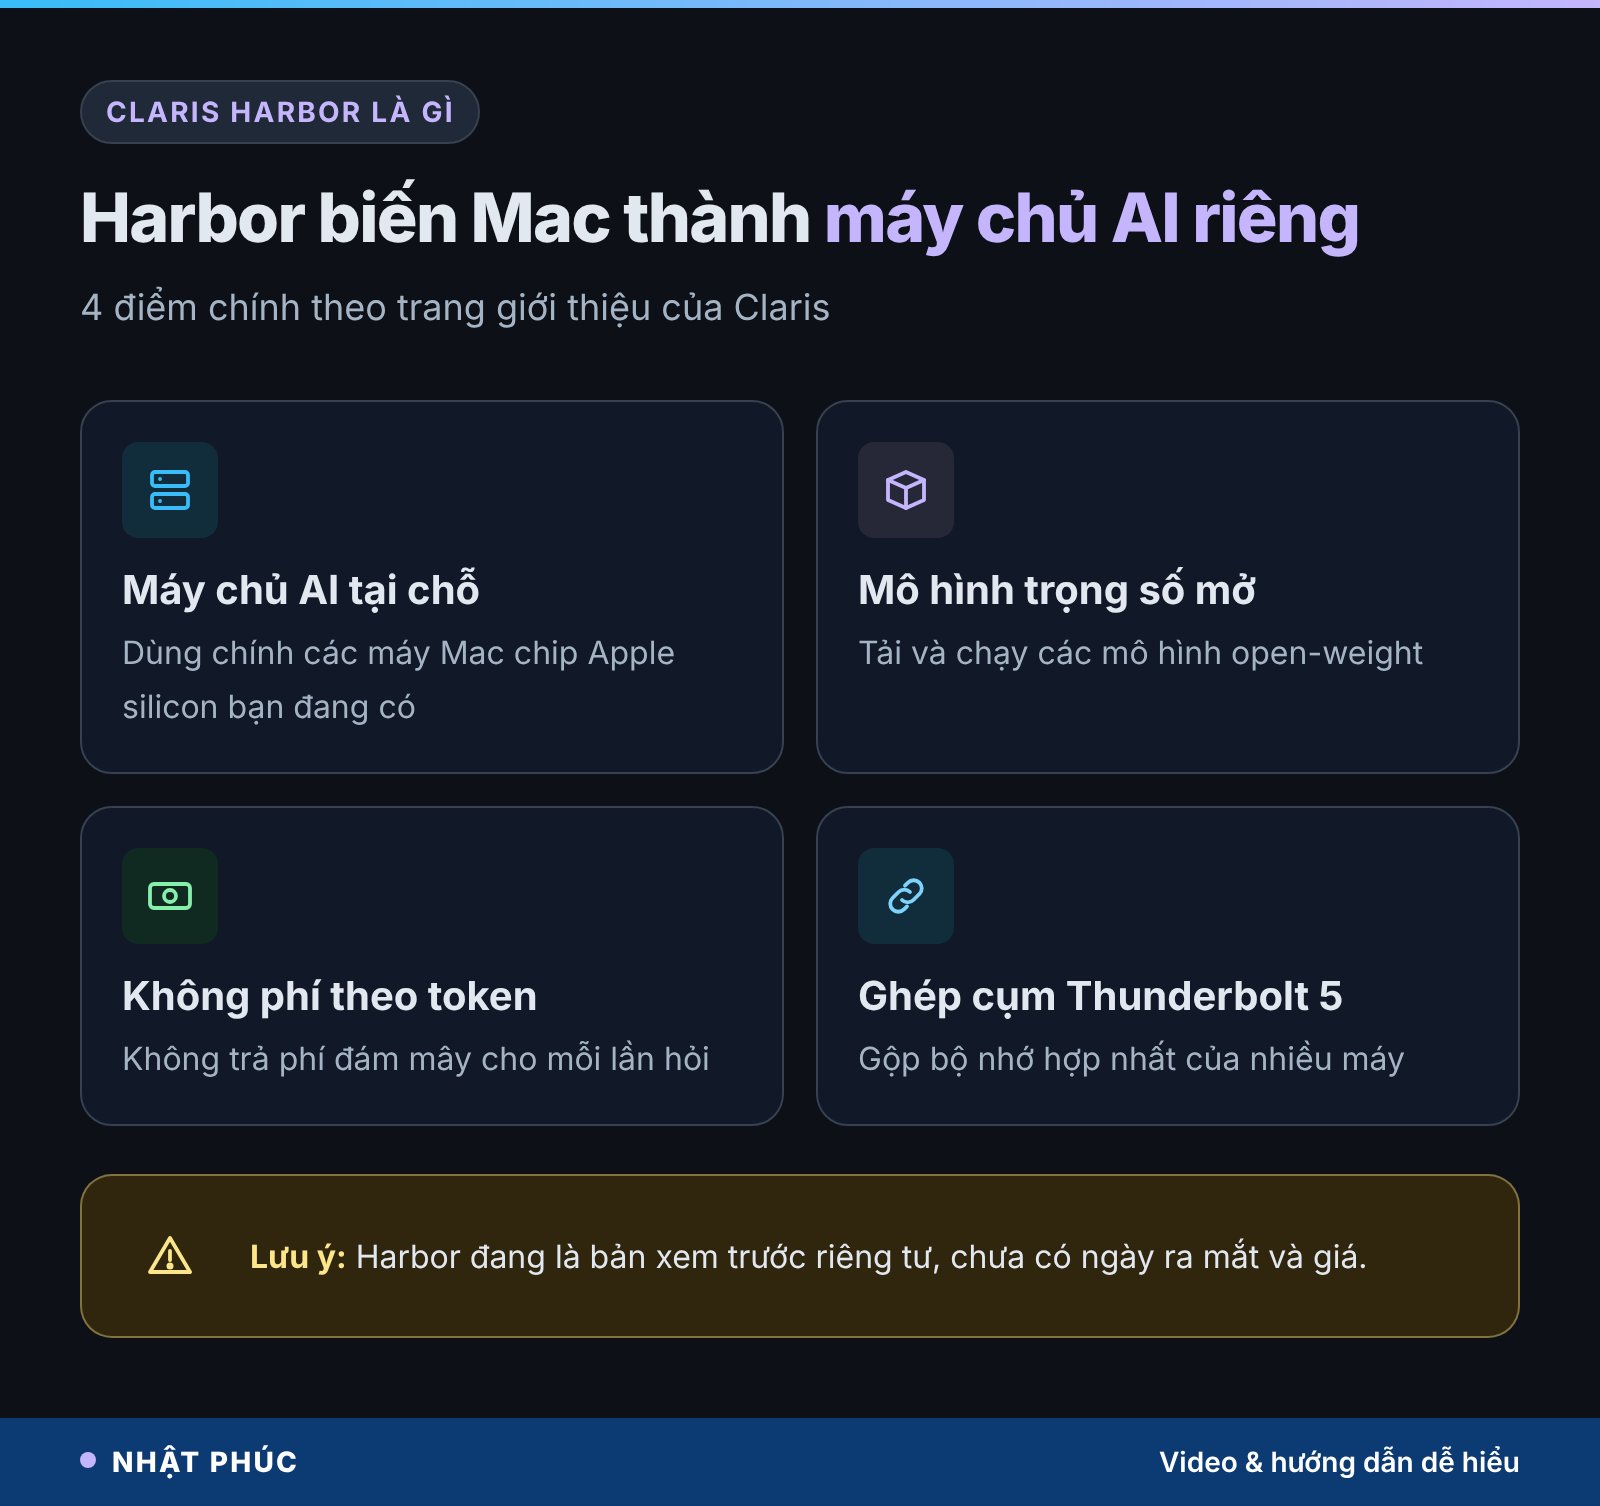
Cần nói rõ: Harbor đang ở giai đoạn xem trước riêng tư (private preview). Trang chính thức chỉ có biểu mẫu đăng ký nhận tin, chưa nêu ngày phát hành, giá bán, phiên bản macOS hay cấu hình tối thiểu. Mọi so sánh hiệu năng về Harbor lúc này đều là phỏng đoán, nên bài viết sẽ dựa vào những công cụ đã có số đo thật để giải thích nguyên lý.
Vì sao cần ghép nhiều máy để chạy AI?
Một mô hình ngôn ngữ lớn về bản chất là một tệp chứa hàng tỷ con số, gọi là tham số. Muốn mô hình trả lời, máy phải nạp gần như toàn bộ các con số đó vào bộ nhớ và đọc đi đọc lại liên tục. Vì vậy, với AI chạy tại chỗ, dung lượng bộ nhớ thường là giới hạn đầu tiên, trước cả tốc độ chip.
Để dễ hình dung, các mô hình thường được “lượng tử hoá” (quantization), tức nén mỗi tham số xuống ít bit hơn. Ở mức 4-bit, mỗi tham số chiếm khoảng nửa byte. Từ đó có thể ước tính:
- Mô hình 8 tỷ tham số: khoảng 5 GB, chạy được trên nhiều laptop.
- Mô hình 70 tỷ tham số: khoảng 40 GB, cần máy có bộ nhớ lớn.
- Mô hình 235 tỷ tham số: khoảng 130 GB, vượt sức hầu hết máy đơn lẻ.
- Mô hình 671 tỷ tham số: khoảng 380 GB, gần như chỉ chạy được khi ghép nhiều máy.
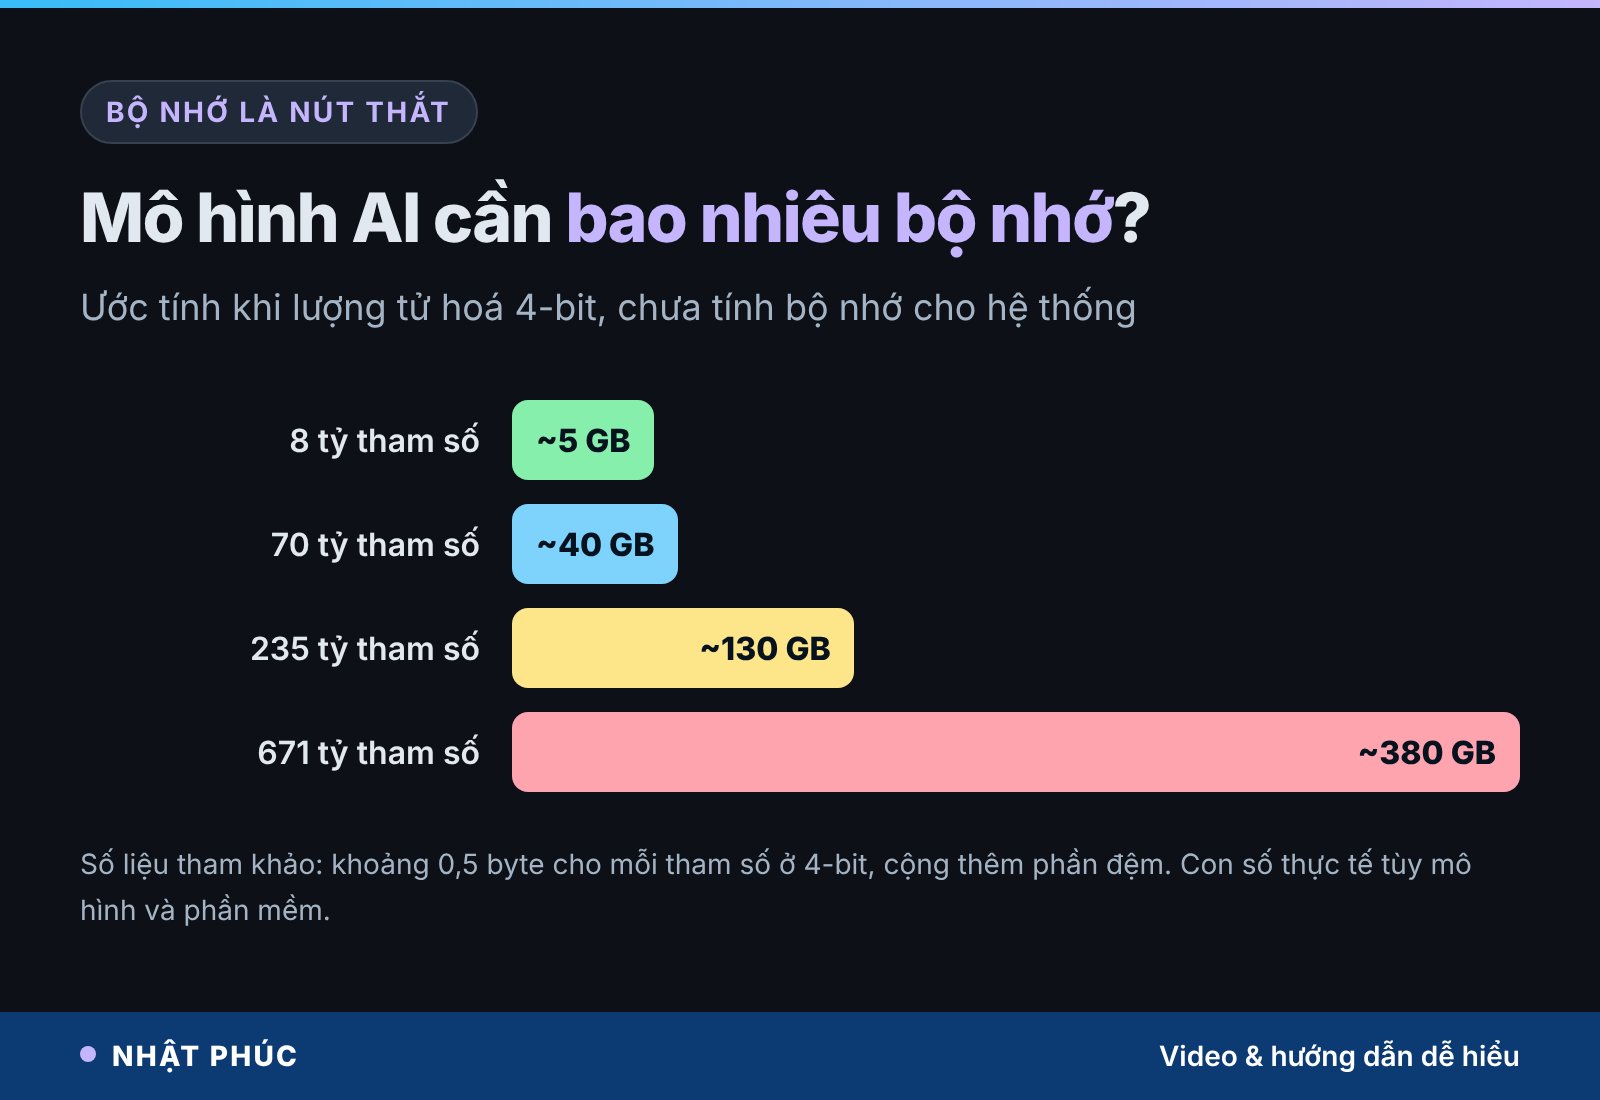
Những con số trên là ước tính tham khảo. Thực tế còn cần thêm bộ nhớ cho “bộ nhớ đệm hội thoại” (KV cache), phần này lớn dần khi cuộc trò chuyện dài ra. Khi mô hình bạn muốn dùng lớn hơn bộ nhớ của một máy, có hai lựa chọn: mua một máy lớn hơn, hoặc ghép những máy đang có. Harbor và Exo đi theo hướng thứ hai.
Chạy mô hình AI trên nhiều máy Mac hoạt động thế nào?
Hãy hình dung mô hình AI là một bộ bách khoa toàn thư hàng trăm tập. Một chiếc bàn không đủ chỗ để bày hết, nên bạn kê thêm vài chiếc bàn, mỗi bàn giữ một phần. Khi có câu hỏi, các bàn cùng tra cứu và chuyền ghi chú cho nhau để ra câu trả lời. Đó chính là suy luận phân tán (distributed inference).
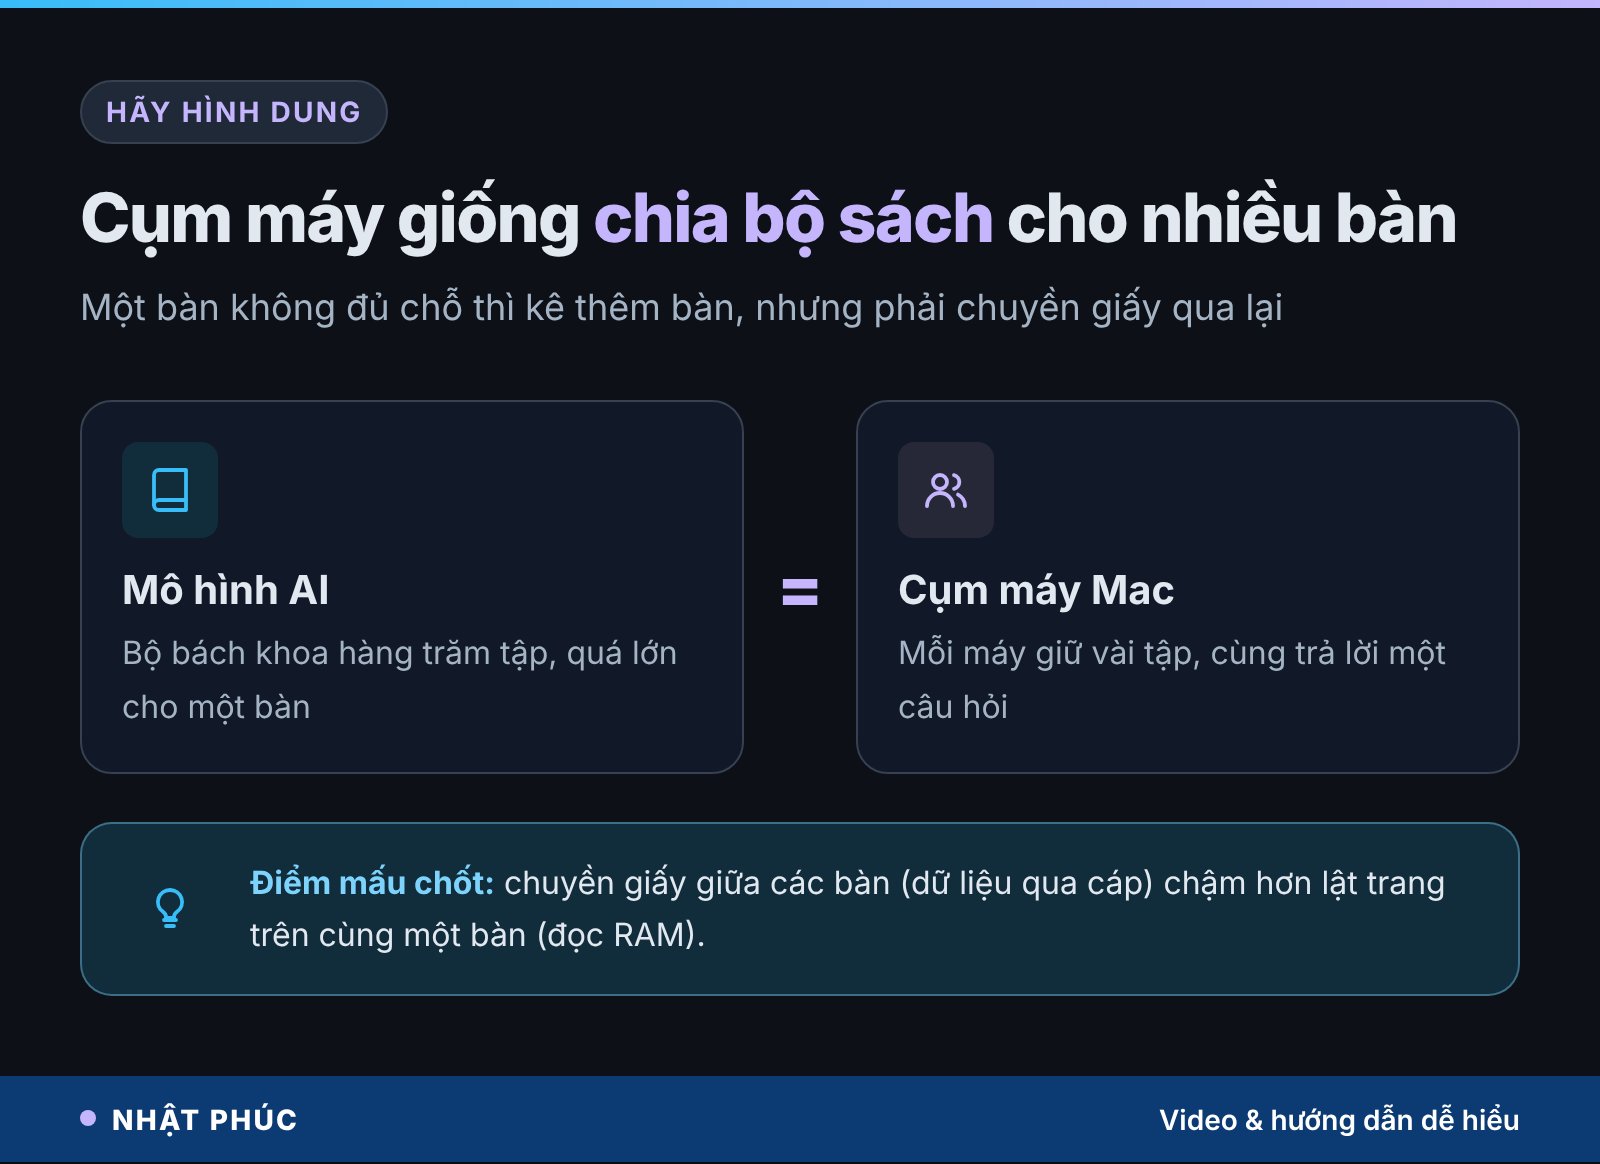
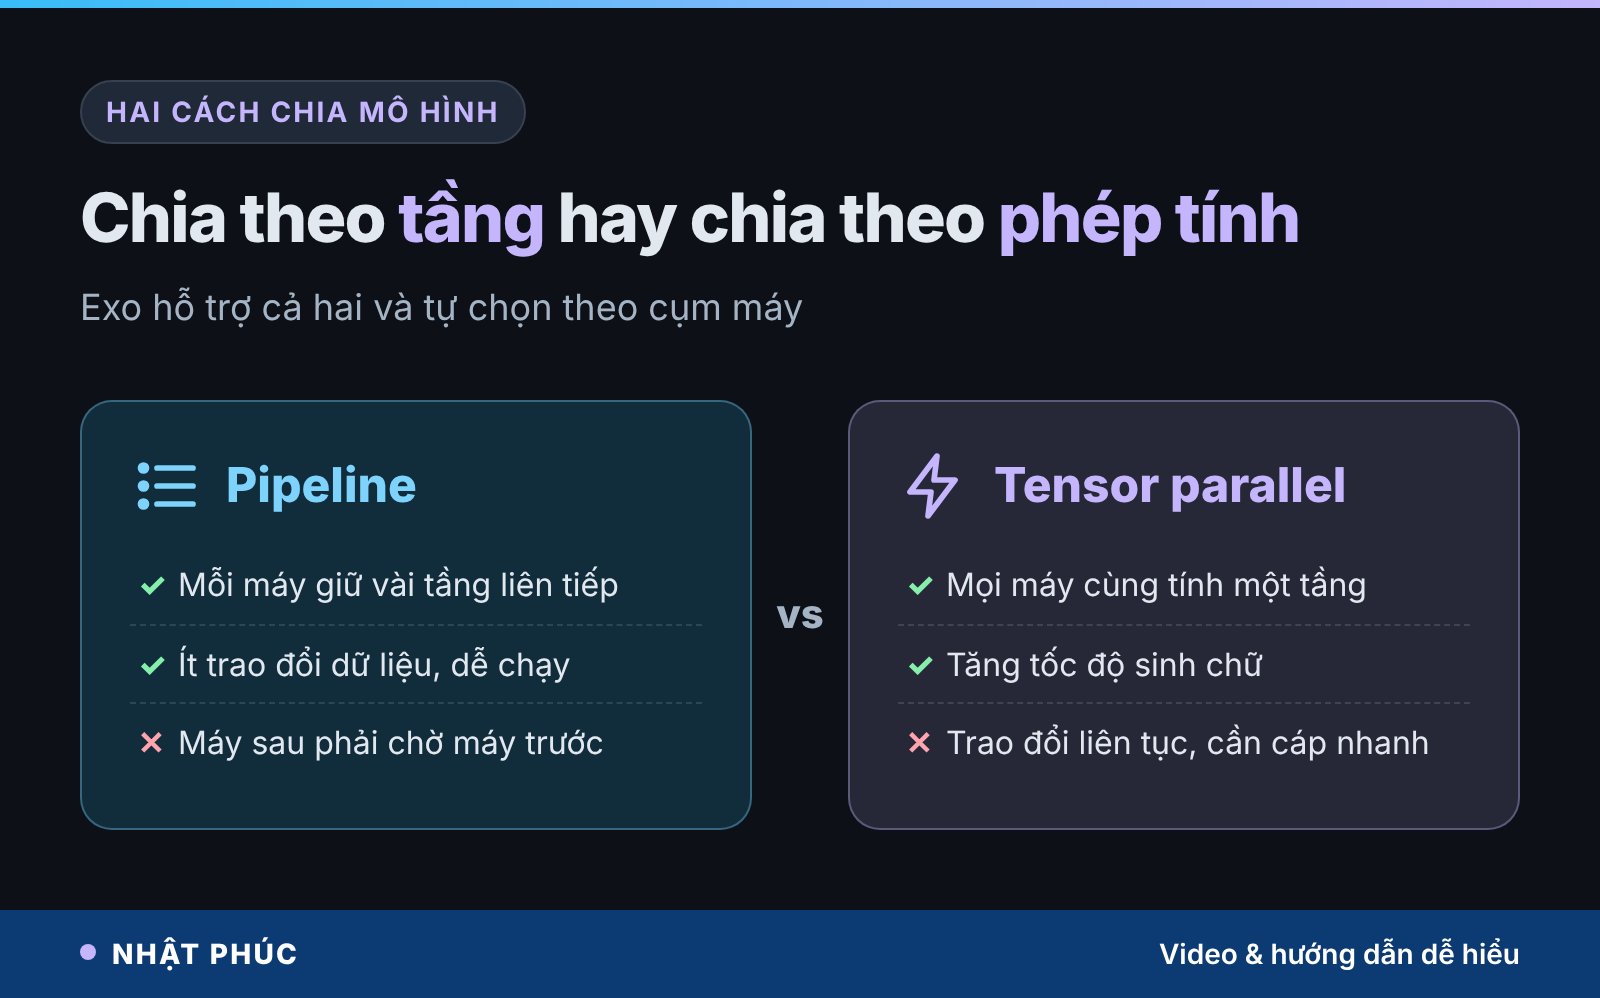
Có hai cách chia phổ biến, và Exo hỗ trợ cả hai.
Chia theo tầng (pipeline parallel)
Mô hình ngôn ngữ gồm nhiều tầng xếp chồng. Cách này giao cho mỗi máy một đoạn tầng liên tiếp: máy 1 xử lý nửa đầu, chuyển kết quả cho máy 2 xử lý nửa sau. Lượng dữ liệu truyền qua cáp ít, dễ triển khai, nhưng máy sau phải chờ máy trước, giống dây chuyền lắp ráp chỉ có một sản phẩm đang chạy. Cách này giúp chạy được mô hình lớn hơn, nhưng không làm câu trả lời ra nhanh hơn.
Chia theo phép tính (tensor parallel)
Cách này cắt nhỏ từng phép tính trong mỗi tầng và giao cho tất cả các máy cùng làm một lúc. Tốc độ sinh chữ có thể tăng, nhưng các máy phải trao đổi dữ liệu sau gần như mỗi tầng. Lúc này, tốc độ và độ trễ của cáp nối trở thành yếu tố quyết định. Trang GitHub của Exo cho biết với tensor parallel, tốc độ tăng khoảng 1,8 lần với 2 thiết bị và 3,2 lần với 4 thiết bị (số liệu do dự án tự công bố).
Thunderbolt 5 và bộ nhớ hợp nhất: nút thắt nằm ở đâu
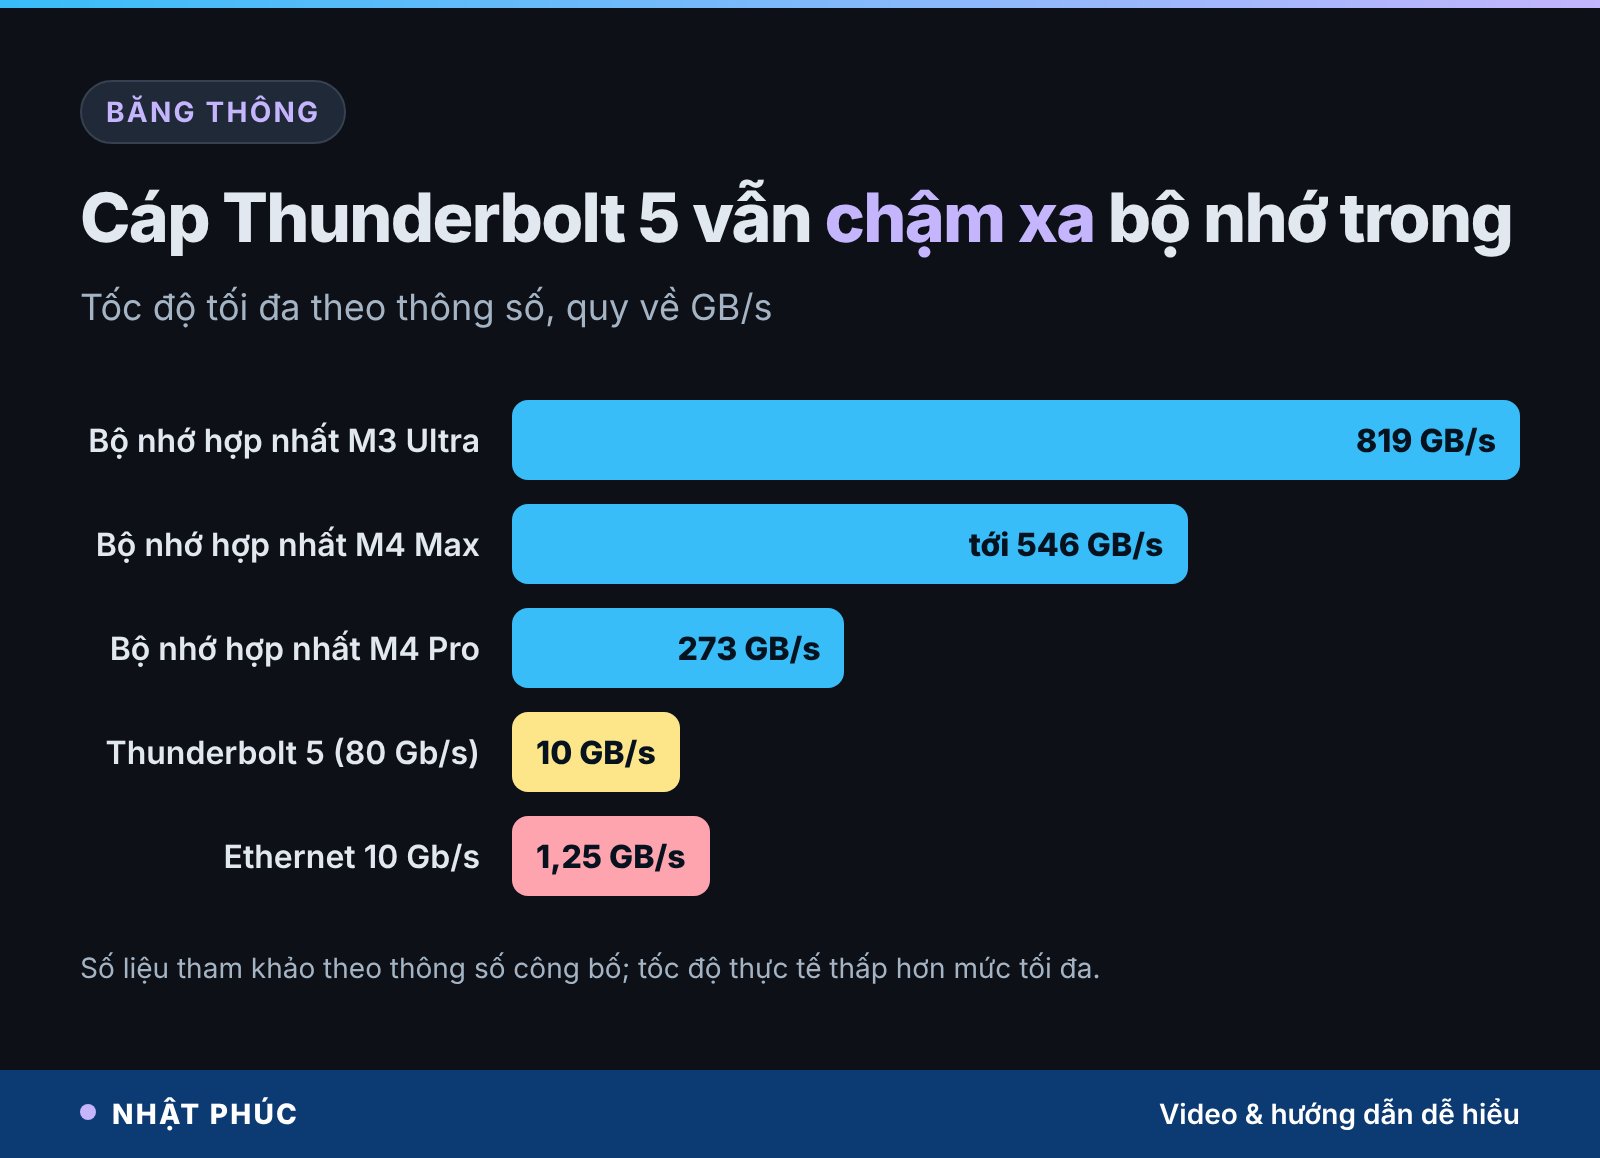
Máy Mac chip Apple silicon dùng bộ nhớ hợp nhất (unified memory): CPU và GPU dùng chung một vùng nhớ, không phải sao chép dữ liệu qua lại như máy tính có card đồ hoạ rời. Nhờ đó, một chiếc Mac có nhiều bộ nhớ có thể dành phần lớn cho mô hình AI, và đọc dữ liệu với băng thông rất cao. Theo thông số của Apple, băng thông bộ nhớ của chip M4 Pro là 273 GB/s, M4 Max lên tới 546 GB/s, còn M3 Ultra là 819 GB/s.
So với đó, cáp Thunderbolt 5 có băng thông tối đa 80 Gb/s, tương đương khoảng 10 GB/s. Thunderbolt 4 là 40 Gb/s, còn Ethernet phổ biến trong văn phòng là 10 Gb/s, tức khoảng 1,25 GB/s. Nghĩa là dữ liệu đi qua cáp chậm hơn đọc trong bộ nhớ của chính máy hàng chục lần.
RDMA: bước tiến của macOS 26.2
Ngoài băng thông, còn có độ trễ: mỗi lần chuyển dữ liệu, hệ điều hành phải xử lý qua nhiều lớp. Từ macOS Tahoe 26.2, Apple bổ sung khả năng RDMA qua Thunderbolt 5 (Remote Direct Memory Access, truy cập bộ nhớ từ xa trực tiếp), cho phép máy này ghi thẳng vào bộ nhớ của máy kia mà không phải đi vòng qua nhiều bước. Bộ thư viện học máy MLX của Apple cũng được cập nhật để hỗ trợ ghép cụm qua Thunderbolt 5. RDMA được bật bằng một lệnh trong chế độ Recovery.
Harbor được giới thiệu là tự nhận ra các máy nối qua Thunderbolt 5 và ghép cụm mà không cần dòng lệnh. Đây là điểm khác biệt lớn nếu bản chính thức giữ đúng như mô tả, vì hiện nay việc ghép cụm vẫn đòi hỏi khá nhiều thao tác kỹ thuật.
Hai máy 64 GB có bằng một máy 128 GB?
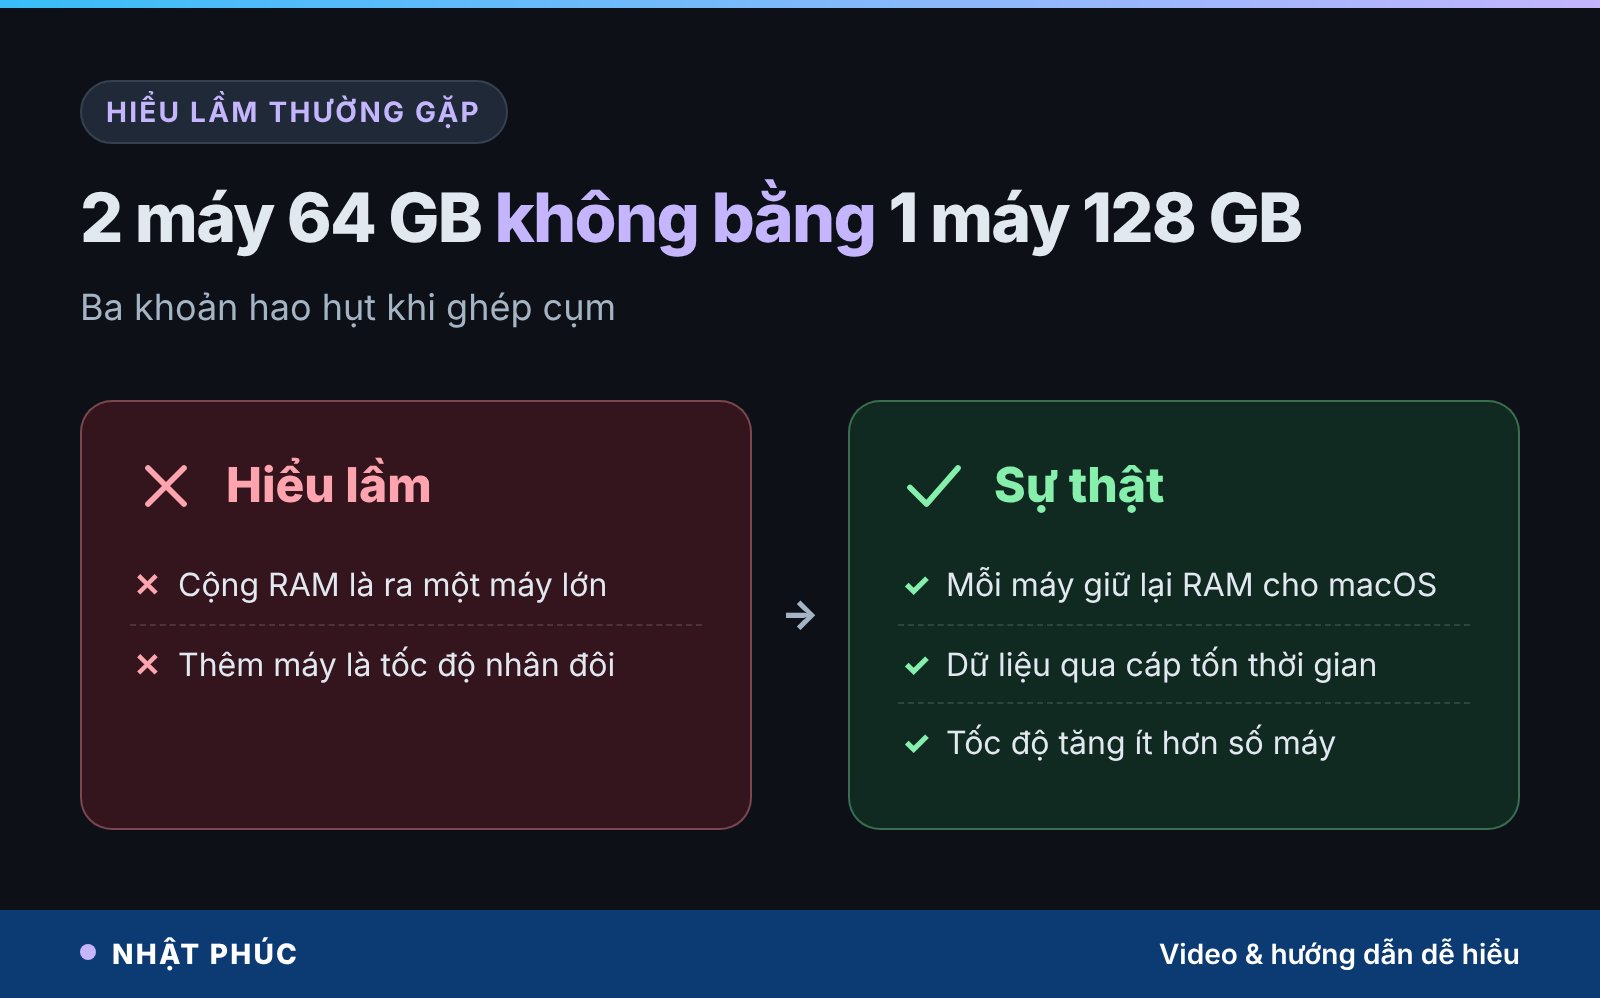
Câu trả lời ngắn: không hoàn toàn. Ghép hai máy 64 GB giúp bạn chạy được mô hình mà một máy 64 GB không nạp nổi, nhưng không biến chúng thành một máy 128 GB thực thụ. Có ba khoản hao hụt.
- Bộ nhớ dành cho hệ thống: mỗi máy vẫn phải giữ lại một phần bộ nhớ cho macOS và các ứng dụng khác. Hai máy là hai lần trừ hao.
- Thời gian truyền dữ liệu: mỗi lần các máy trao đổi kết quả qua cáp là một lần chờ, dù đã có RDMA.
- Tốc độ không tăng tương ứng: thêm máy giúp chạy được mô hình lớn hơn, nhưng tốc độ chỉ tăng nếu phần mềm chia việc khéo, và hiếm khi tăng đúng bằng số máy.
Số đo thực tế cho thấy gì
Một thử nghiệm do trang AppleInsider công bố tháng 12/2025 dùng 4 máy Mac Studio chip M3 Ultra (tổng khoảng 1,5 TB bộ nhớ) cho thấy rõ điều này. Với mô hình Qwen3 235B, Exo đạt 19,5 token/giây trên 1 máy, 26,2 token/giây trên 2 máy và 31,9 token/giây trên 4 máy khi bật RDMA. Ngược lại, llama.cpp, phần mềm không hỗ trợ RDMA, còn chậm đi khi thêm máy: 17,2 token/giây trên 2 máy và 15,2 token/giây trên 4 máy.
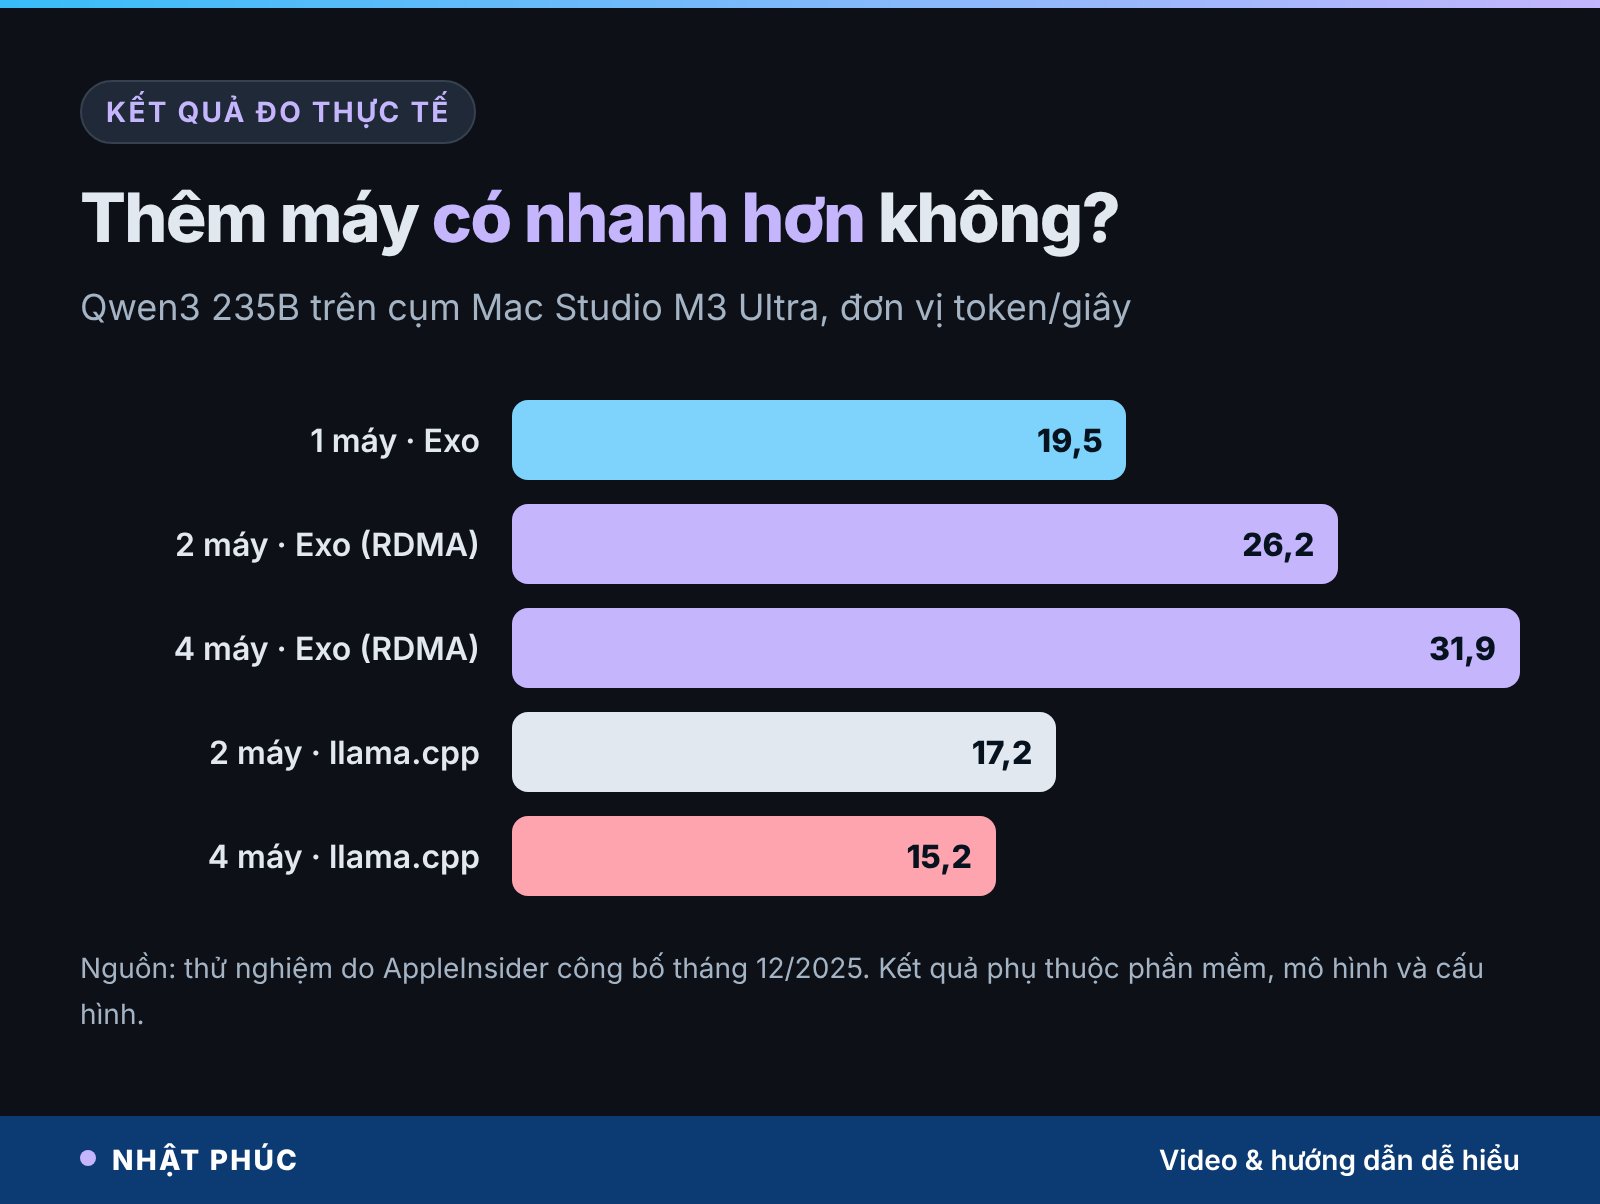
Bài học: bốn máy chỉ nhanh hơn một máy khoảng 1,6 lần trong trường hợp tốt, và có thể chậm hơn nếu phần mềm không tận dụng được kết nối. Ghép cụm chủ yếu để chạy được mô hình lớn, tốc độ là phần thưởng thêm.
So sánh Harbor, Exo, LM Studio và Ollama
Nếu bạn từng chạy AI trên máy tính cá nhân, có lẽ đã quen với LM Studio hoặc Ollama. Hai công cụ này chủ yếu tối ưu cho một máy. Exo và Harbor nhắm vào việc ghép nhiều máy.
| Công cụ | Ghép nhiều máy | Cách dùng | Tình trạng |
|---|---|---|---|
| Claris Harbor | Có, qua Thunderbolt 5 | Ứng dụng Mac | Xem trước riêng tư |
| Exo | Có, tự tìm các máy | Ứng dụng Mac, dòng lệnh, API | Mã nguồn mở (Apache-2.0) |
| LM Studio | Chủ yếu một máy | Giao diện đồ hoạ | Miễn phí |
| Ollama | Chủ yếu một máy | Dòng lệnh, API | Mã nguồn mở |
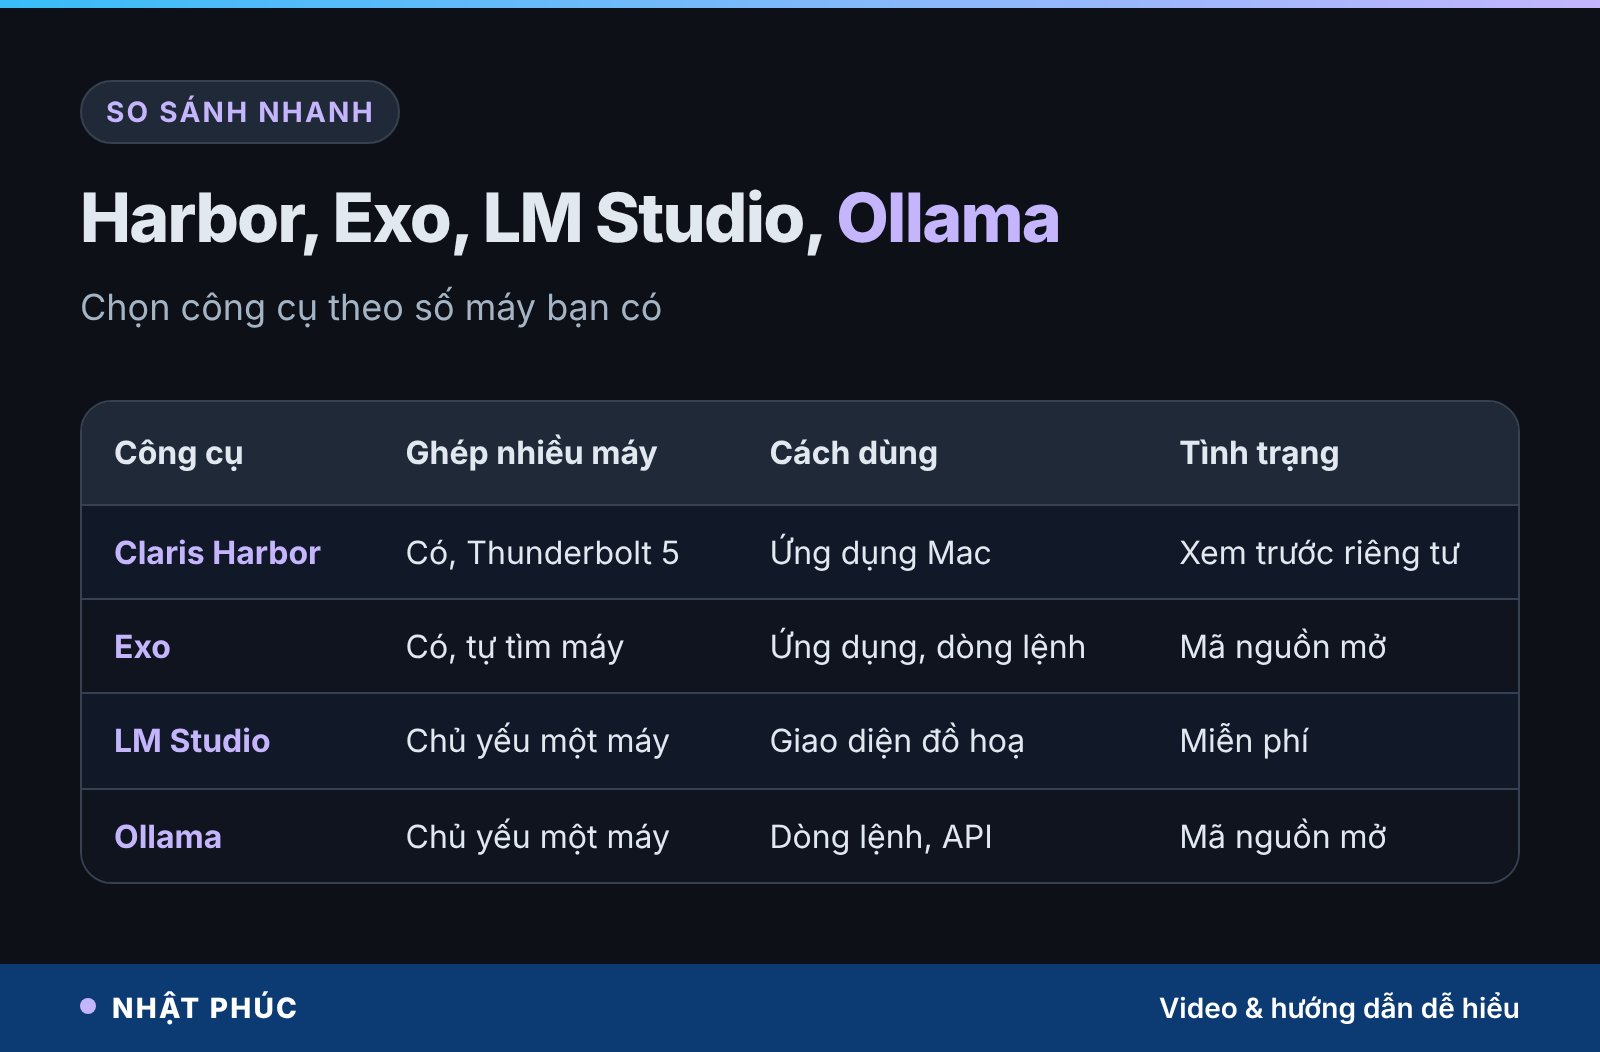
Điểm đáng chú ý của Exo là có sẵn điểm kết nối tương thích chuẩn API của OpenAI, Claude và Ollama. Nghĩa là các ứng dụng đang gọi AI qua những chuẩn này có thể trỏ sang cụm máy nội bộ mà không phải viết lại nhiều. Claris chưa công bố Harbor có tương thích chuẩn nào, nên đây là điều cần chờ bản chính thức.
Ứng dụng cho văn phòng và doanh nghiệp nhỏ ở Việt Nam
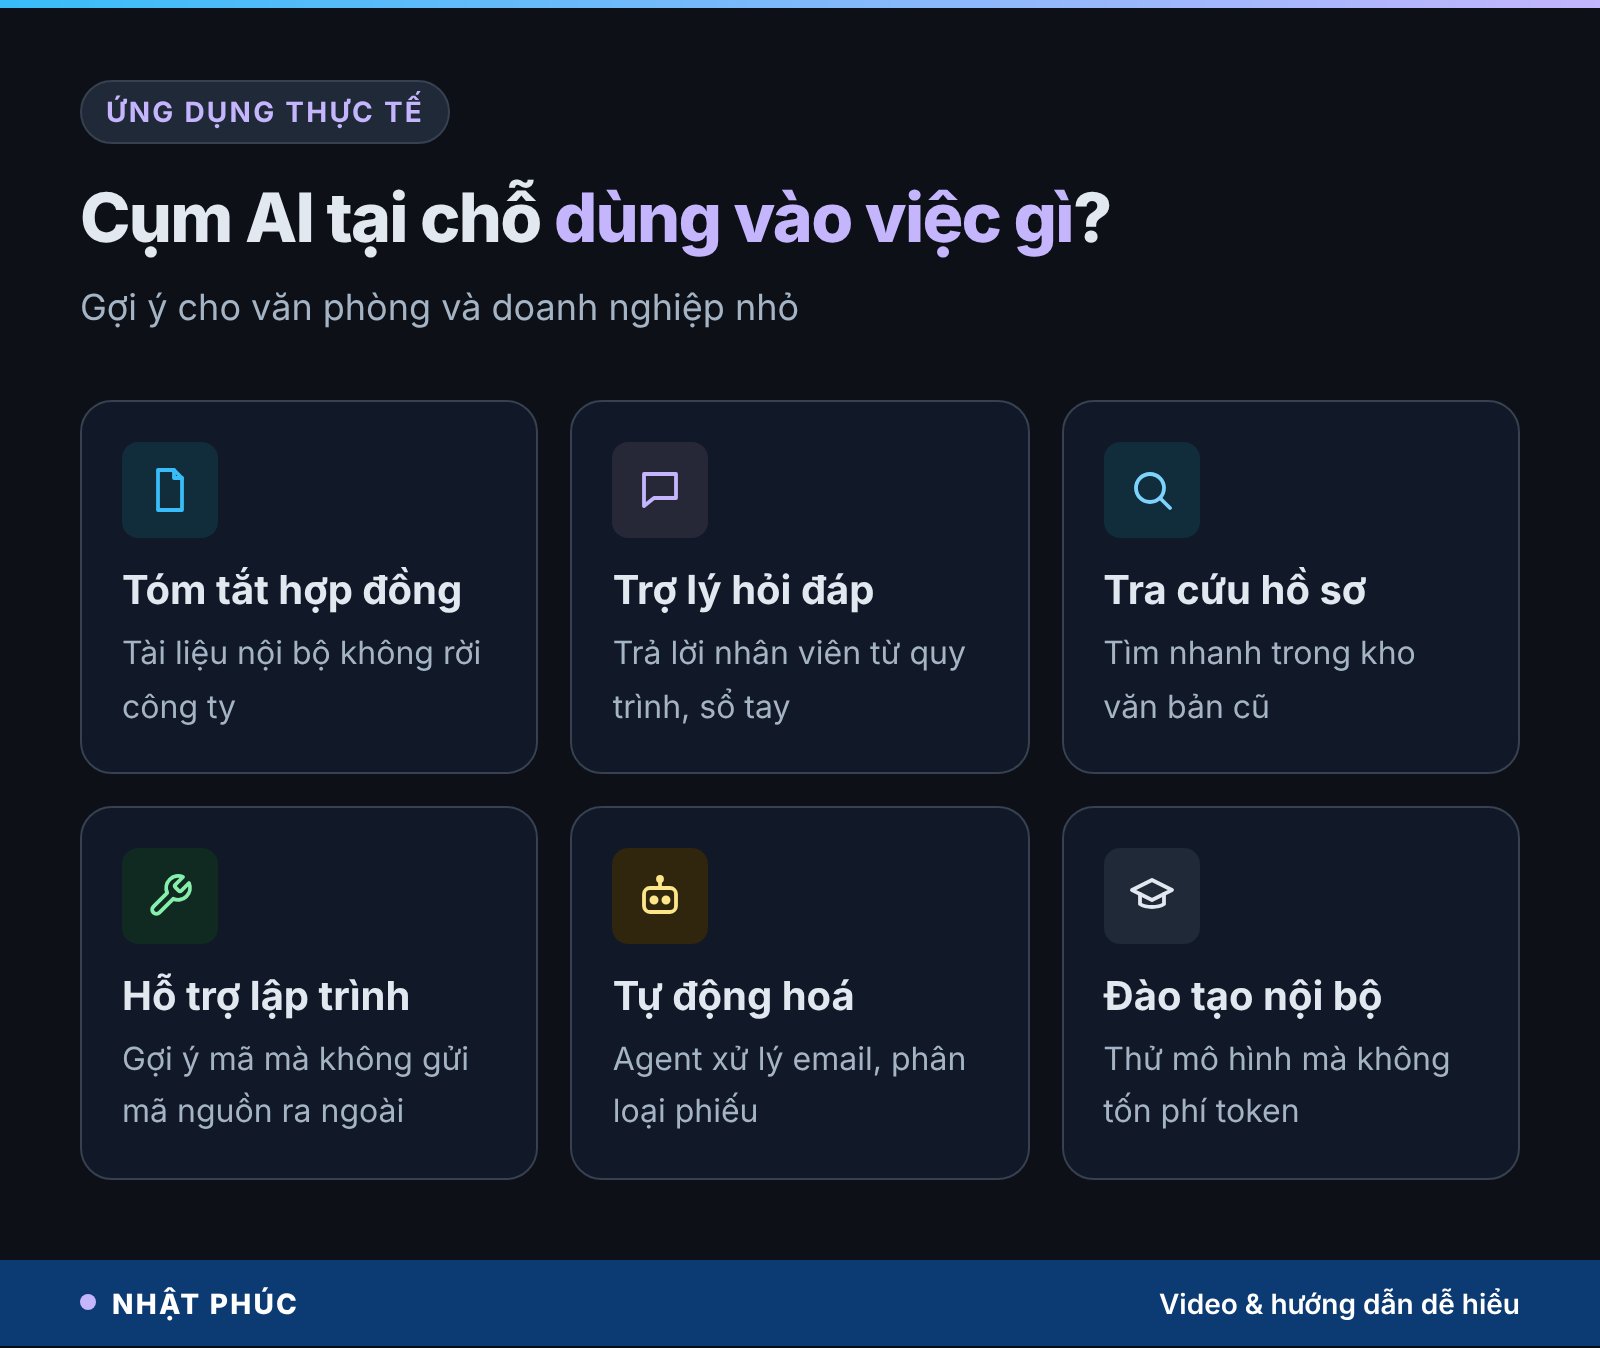
Với cá nhân, một máy là đủ cho hầu hết nhu cầu. Cụm máy AI tại chỗ hợp hơn với những nơi có nhiều người dùng chung và dữ liệu nhạy cảm, ví dụ văn phòng luật, phòng kế toán, công ty phần mềm hay phòng khám.
Dữ liệu không rời khỏi công ty
Theo Claris, với Harbor, dữ liệu và câu lệnh nằm hoàn toàn trong phần cứng Mac của bạn. Đây là lợi thế lớn khi xử lý hợp đồng, hồ sơ khách hàng hay mã nguồn. Ở Việt Nam, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ ngày 1/1/2026 đặt ra nhiều nghĩa vụ khi xử lý và chuyển dữ liệu cá nhân. Chạy AI tại chỗ giúp giảm rủi ro chuyển dữ liệu ra nước ngoài, nhưng không miễn trừ nghĩa vụ: bạn vẫn cần có cơ sở xử lý dữ liệu, phân quyền và bảo mật hệ thống.
Bài toán chi phí
Dịch vụ AI đám mây tính tiền theo lượng chữ xử lý, nên chi phí tăng theo mức dùng. Cụm máy tại chỗ thì ngược lại: tốn một khoản lớn ban đầu cho máy, sau đó chủ yếu là tiền điện. Nếu chỉ thỉnh thoảng hỏi AI vài câu, đám mây thường rẻ hơn. Nếu cả văn phòng dùng liên tục, hoặc dữ liệu không được phép gửi ra ngoài, máy tại chỗ mới đáng cân nhắc. Ngoài ra, mô hình trọng số mở thường vẫn kém các mô hình đám mây hàng đầu ở những việc khó, nên hãy thử trên công việc thật trước khi đầu tư.
Tiếng Việt thì sao?
Harbor chưa công bố danh sách mô hình hỗ trợ. Tuy vậy, nhiều mô hình trọng số mở phổ biến như Qwen hay các dòng mô hình đa ngôn ngữ khác hiểu và viết tiếng Việt ở mức dùng được. Chất lượng tiếng Việt phụ thuộc vào mô hình bạn chọn, không phụ thuộc vào công cụ chạy mô hình.
Cách thử ghép cụm AI bằng Exo ngay hôm nay
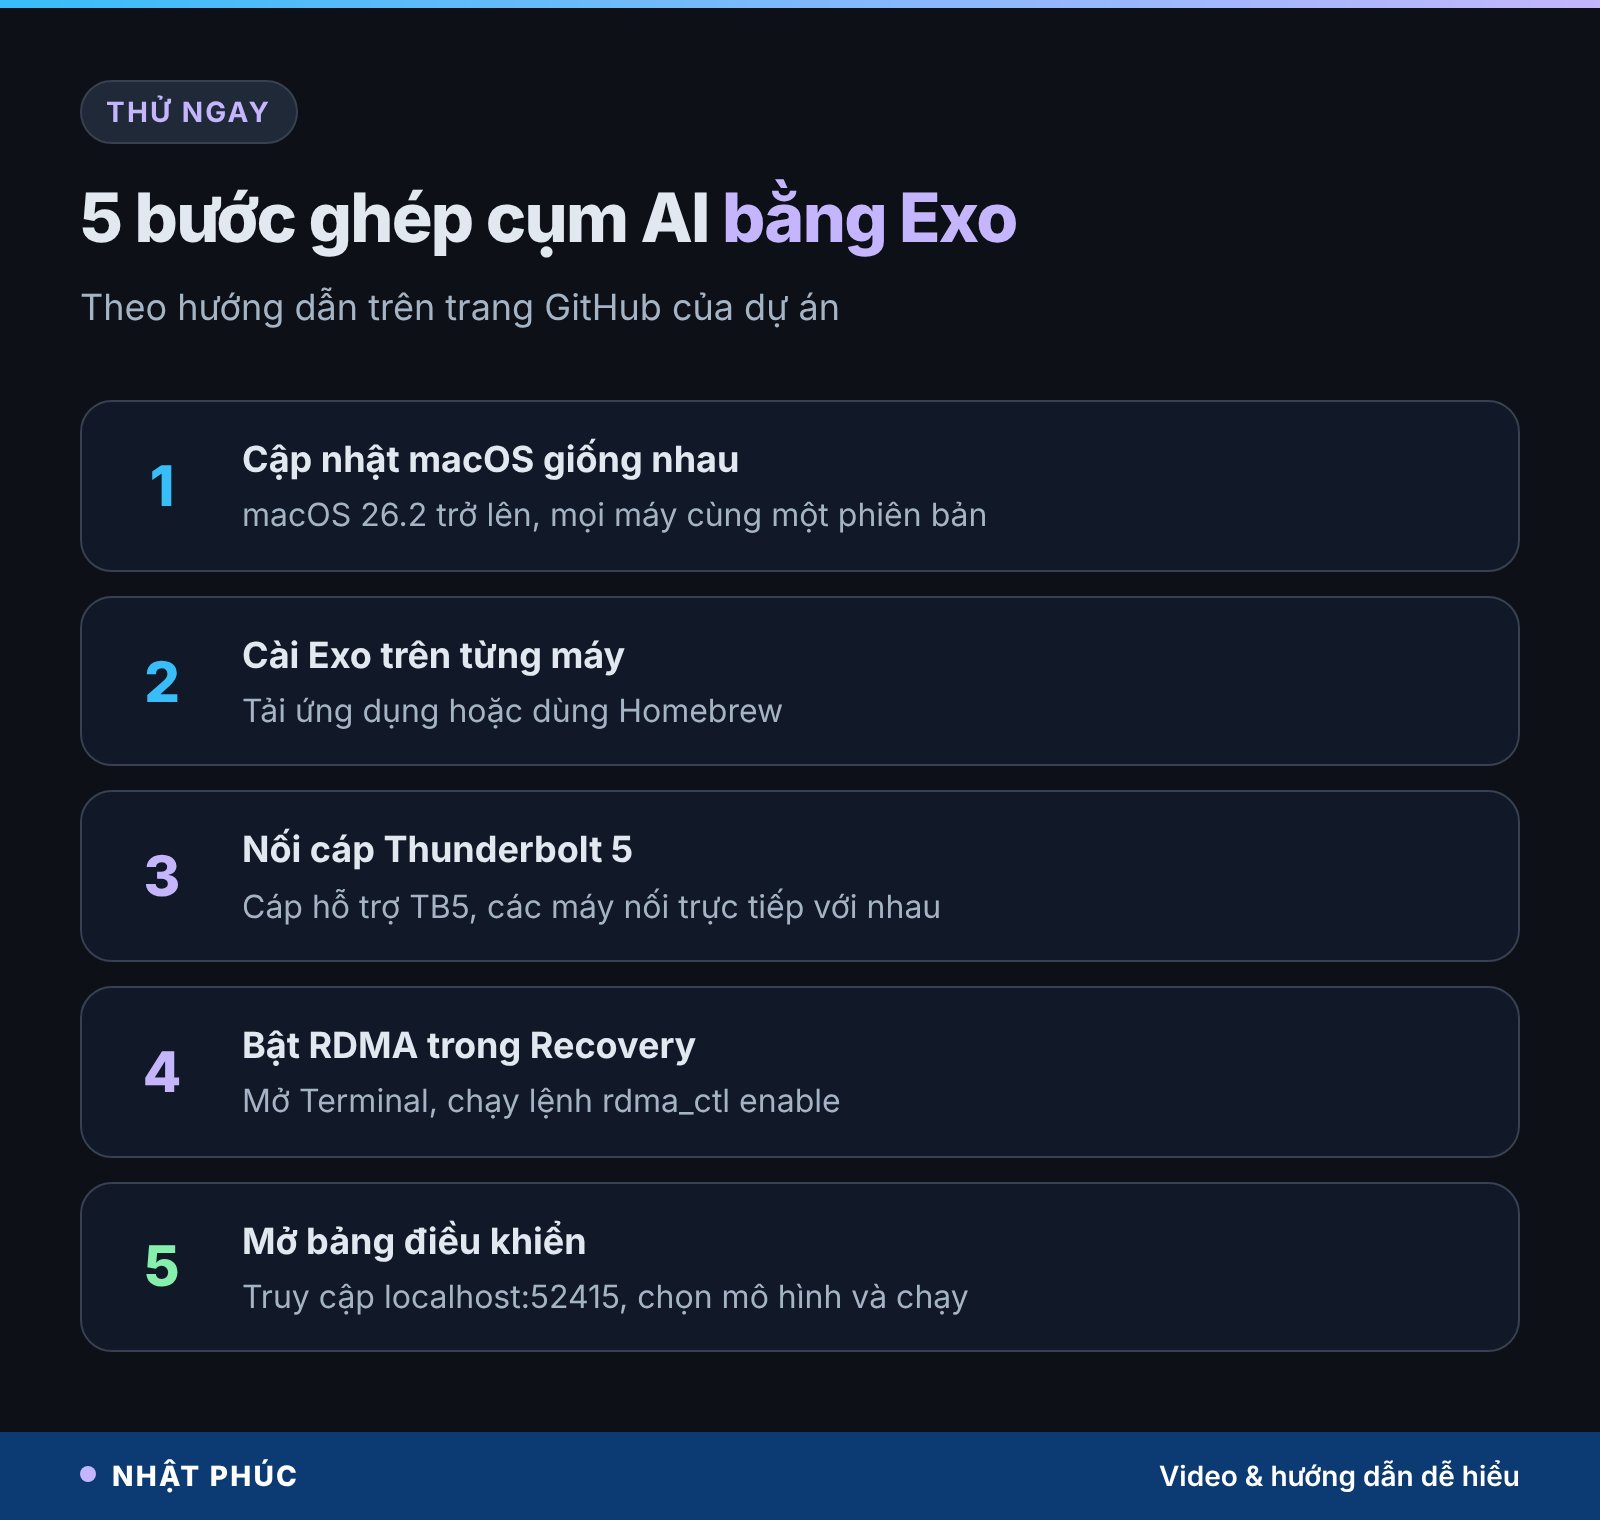
Nếu không muốn chờ Harbor, bạn có thể thử Exo theo hướng dẫn trên trang GitHub của dự án. Yêu cầu chính: các máy Mac có cổng Thunderbolt 5 (ví dụ Mac mini M4 Pro, Mac Studio M3 Ultra) và cáp hỗ trợ Thunderbolt 5. Muốn kiểm tra máy mình có Thunderbolt 5 không, hãy xem trang thông số kỹ thuật của đúng mẫu máy trên trang Apple.
1. Cập nhật macOS giống nhau trên mọi máy
Ứng dụng Exo cho macOS cần macOS Tahoe 26.2 trở lên. Các máy trong cụm phải chạy đúng cùng một phiên bản macOS.
2. Cài Exo trên từng máy
Tải ứng dụng từ trang phát hành của dự án, hoặc dùng Homebrew với lệnh brew install –cask exo. Các máy chạy Exo sẽ tự tìm thấy nhau, không cần cấu hình thủ công.
3. Nối cáp Thunderbolt 5
Nối các máy với nhau bằng cáp Thunderbolt 5. Với cụm nhỏ 2–4 máy, nên nối trực tiếp thay vì nối nối tiếp dài, vì mỗi chặng trung gian đều thêm độ trễ.
4. Bật RDMA trong chế độ Recovery
Tắt máy, giữ nút nguồn khoảng 10 giây để vào menu khởi động, chọn Options để vào Recovery, mở Terminal và chạy lệnh rdma_ctl enable, rồi khởi động lại. Làm trên từng máy.
5. Mở bảng điều khiển và chọn mô hình
Bảng điều khiển và API của Exo chạy tại địa chỉ localhost:52415. Chọn mô hình phù hợp tổng bộ nhớ của cụm, bắt đầu với mô hình nhỏ để kiểm tra trước khi tải mô hình hàng trăm GB.
Rủi ro khi tự chạy AI tại chỗ
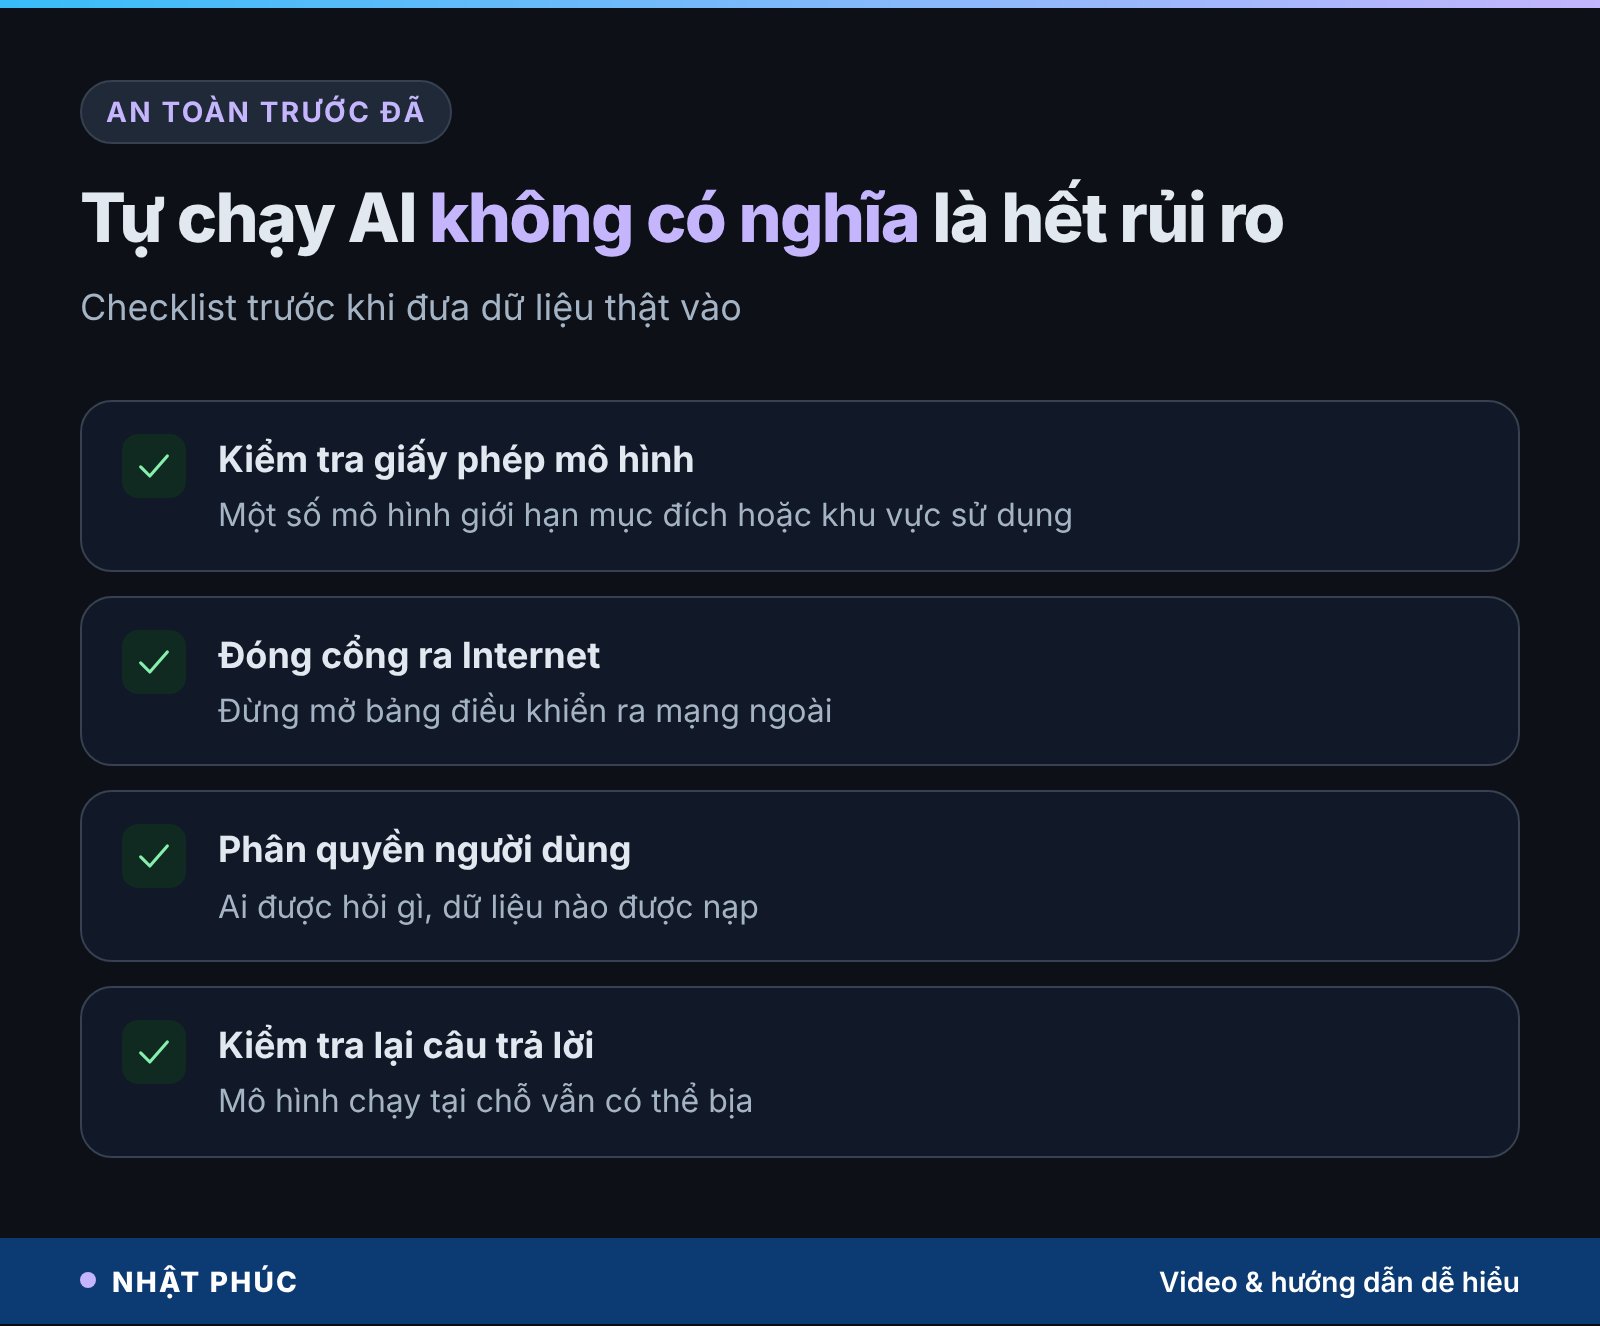
Chạy AI trong nhà không có nghĩa là hết rủi ro. Một số điểm cần kiểm tra trước khi đưa dữ liệu thật vào:
- Giấy phép mô hình: “trọng số mở” không luôn đồng nghĩa với “dùng tự do”. Một số mô hình giới hạn mục đích thương mại hoặc khu vực sử dụng. Đọc kỹ giấy phép trước khi dùng cho công việc.
- Cổng mạng: đừng mở bảng điều khiển hay API ra Internet. Một máy chủ AI không có mật khẩu là cửa ngõ để người lạ dùng máy và đọc dữ liệu của bạn.
- Phân quyền: xác định ai được dùng, tài liệu nào được nạp cho AI, và lưu lại nhật ký truy cập.
- Câu trả lời sai: mô hình chạy tại chỗ vẫn có thể “bịa” thông tin. Với hợp đồng, số liệu tài chính hay tư vấn chuyên môn, luôn cần người kiểm tra lại.
- Phần mềm thử nghiệm: Harbor còn ở bản xem trước, RDMA là tính năng mới. Đừng đặt hệ thống quan trọng lên nền tảng chưa ổn định.
Nên chọn công cụ nào?
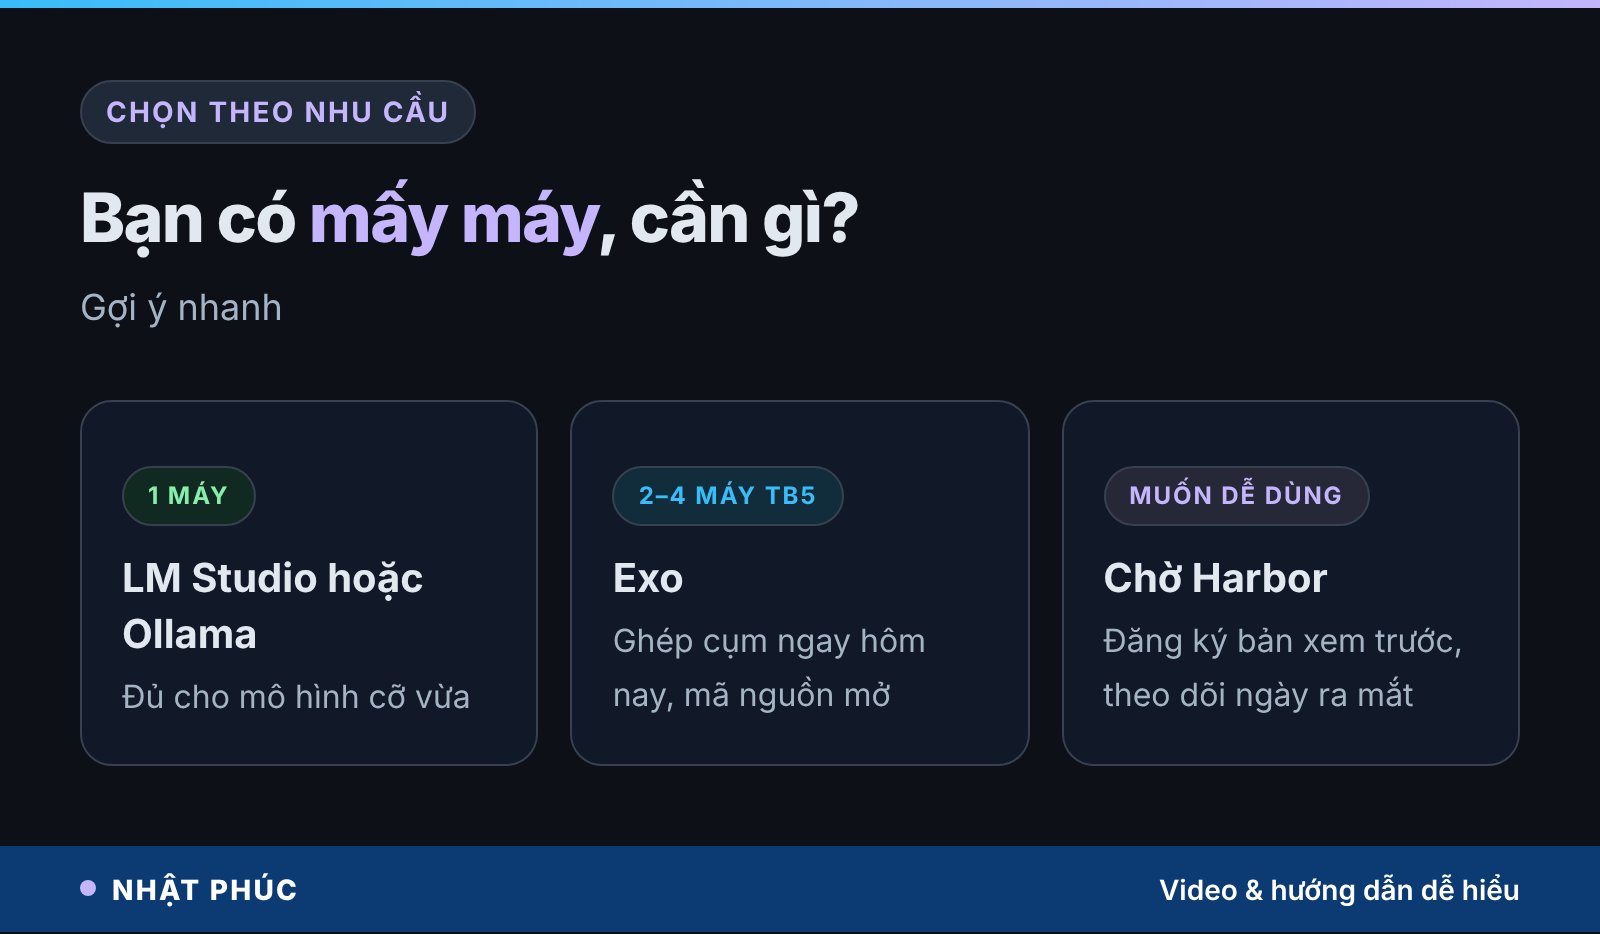
Nếu chỉ có một máy Mac, LM Studio hoặc Ollama là đủ cho phần lớn mô hình vừa và nhỏ. Nếu có 2–4 máy hỗ trợ Thunderbolt 5 và muốn thử chạy mô hình lớn ngay, Exo là lựa chọn hiện có. Nếu bạn cần một giải pháp ít thao tác kỹ thuật cho doanh nghiệp, có thể đăng ký bản xem trước Harbor và chờ thông tin chính thức về giá, cấu hình.
Câu hỏi thường gặp
Claris Harbor đã có để tải về chưa?
Chưa. Harbor đang ở giai đoạn xem trước riêng tư. Trang chính thức của Claris chỉ có biểu mẫu đăng ký nhận cập nhật, chưa công bố ngày phát hành, giá bán hay cấu hình tối thiểu. Bạn có thể đăng ký để theo dõi, còn muốn ghép cụm ngay thì dùng Exo.
Máy Mac nào ghép cụm qua Thunderbolt 5 được?
Máy cần có cổng Thunderbolt 5. Một số mẫu có cổng này là Mac mini M4 Pro, MacBook Pro M4 Pro, M4 Max và Mac Studio M3 Ultra. Máy chỉ có Thunderbolt 4 vẫn nối được, nhưng không dùng được RDMA qua Thunderbolt 5. Hãy kiểm tra trang thông số của đúng mẫu máy.
Ghép cụm có làm AI trả lời nhanh hơn không?
Có thể, nhưng không tăng theo số máy. Trong thử nghiệm với Qwen3 235B, 4 máy chạy Exo nhanh hơn 1 máy khoảng 1,6 lần. Mục đích chính của ghép cụm là chạy được mô hình quá lớn cho một máy; tốc độ phụ thuộc phần mềm và cách nối.
Có cần máy Mac không, hay dùng PC Windows được?
Harbor chỉ dành cho Mac chip Apple silicon. Exo cũng chạy trên Linux, nhưng theo trang dự án, trên Linux hiện chỉ dùng CPU, chưa hỗ trợ GPU. Với PC, các giải pháp ghép cụm GPU khác tồn tại nhưng nằm ngoài phạm vi bài này.
AI chạy tại chỗ có an toàn dữ liệu hơn AI đám mây không?
Dữ liệu không rời khỏi máy nên giảm rủi ro lộ qua bên thứ ba. Tuy vậy, an toàn còn phụ thuộc vào cách bạn cấu hình mạng, phân quyền và sao lưu. Một máy chủ AI mở ra Internet không mật khẩu có thể nguy hiểm hơn dịch vụ đám mây được quản lý tốt.
Kết luận
Claris Harbor cho thấy Apple đang nghiêm túc với ý tưởng biến những chiếc Mac sẵn có thành hạ tầng AI riêng: chạy mô hình trọng số mở, không trả phí theo token, dữ liệu nằm trong văn phòng, và ghép nhiều máy khi cần mô hình lớn. Nhưng nguyên lý vật lý không đổi: cáp Thunderbolt 5 vẫn chậm hơn bộ nhớ trong rất nhiều, nên ghép cụm chủ yếu để chạy được mô hình lớn, không phải để tăng tốc gấp bội. Trong lúc chờ Harbor ra mắt chính thức, Exo là cách tốt để bạn tự trải nghiệm.
Bạn có định dựng một máy chủ AI riêng cho văn phòng không, và sẽ dùng nó cho việc gì? Hãy để lại bình luận và theo dõi Nhật Phúc để cập nhật khi Harbor có thông tin chính thức.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.