Giữa tháng 11/2026, hai mô hình AI mới ra mắt cách nhau chưa đầy một ngày đều mang con số “khổng lồ”: Qwen4-Max của Alibaba có 2,4 nghìn tỷ tham số, Hy4 flash của Tencent có 224 tỷ. Thế nhưng cả hai lại được quảng bá là rẻ hơn thế hệ trước. Bí mật nằm ở ba chữ cái: MoE. Vậy MoE là gì, và vì sao một mô hình to gấp nhiều lần vẫn có thể chạy nhanh, rẻ?
Câu trả lời ngắn: MoE (Mixture of Experts, mô hình chuyên gia hỗn hợp) là cách xây mô hình AI gồm nhiều khối con gọi là “chuyên gia”. Với mỗi từ (token) đi vào, một bộ định tuyến chỉ đánh thức vài chuyên gia phù hợp. Nhờ vậy mô hình có rất nhiều tham số nhưng mỗi lần tính chỉ dùng một phần nhỏ, nên tốn ít phép tính hơn.
Bài viết này giải thích MoE từ con số 0: tham số tổng khác tham số kích hoạt ra sao, bộ định tuyến làm việc thế nào, vì sao MoE rẻ khi chạy nhưng vẫn “ngốn” bộ nhớ, rồi xem hai ví dụ thật là Qwen4-Max và Hy4 flash, kèm cách chọn mô hình cho công việc tự động hoá.
Tóm tắt nhanh
- MoE chia mô hình thành nhiều “chuyên gia”; mỗi token chỉ đi qua vài chuyên gia do bộ định tuyến chọn.
- Tham số tổng quyết định mô hình “biết” bao nhiêu; tham số kích hoạt quyết định mỗi token tốn bao nhiêu phép tính.
- Qwen4-Max có 2,4 nghìn tỷ tham số nhưng mỗi token chỉ kích hoạt 71 tỷ; Hy4 flash có 224 tỷ, kích hoạt 12 tỷ.
- MoE rẻ về tính toán nhưng vẫn phải nạp toàn bộ chuyên gia vào bộ nhớ, nên khó chạy trên máy cá nhân.
- Giá mỗi token chưa nói hết chi phí; cần nhìn chi phí trọn một tác vụ.
Nội dung chính:
- MoE là gì? Hiểu bằng ví dụ bệnh viện
- Tham số tổng và tham số kích hoạt
- Bộ định tuyến chọn chuyên gia ra sao
- Vì sao MoE rẻ khi chạy nhưng vẫn ngốn bộ nhớ
- Lịch sử MoE từ 1991 đến nay
- Qwen4-Max: MoE 2,4 nghìn tỷ tham số
- Hy4 flash: MoE gọn cho việc hằng ngày
- Giá mỗi token và chi phí mỗi tác vụ
- Người Việt dùng mô hình MoE được không
- Chọn MoE lớn hay nhỏ cho tự động hoá
- Hiểu lầm phổ biến về MoE
- Câu hỏi thường gặp
MoE là gì? Hiểu bằng ví dụ bệnh viện nhiều chuyên khoa
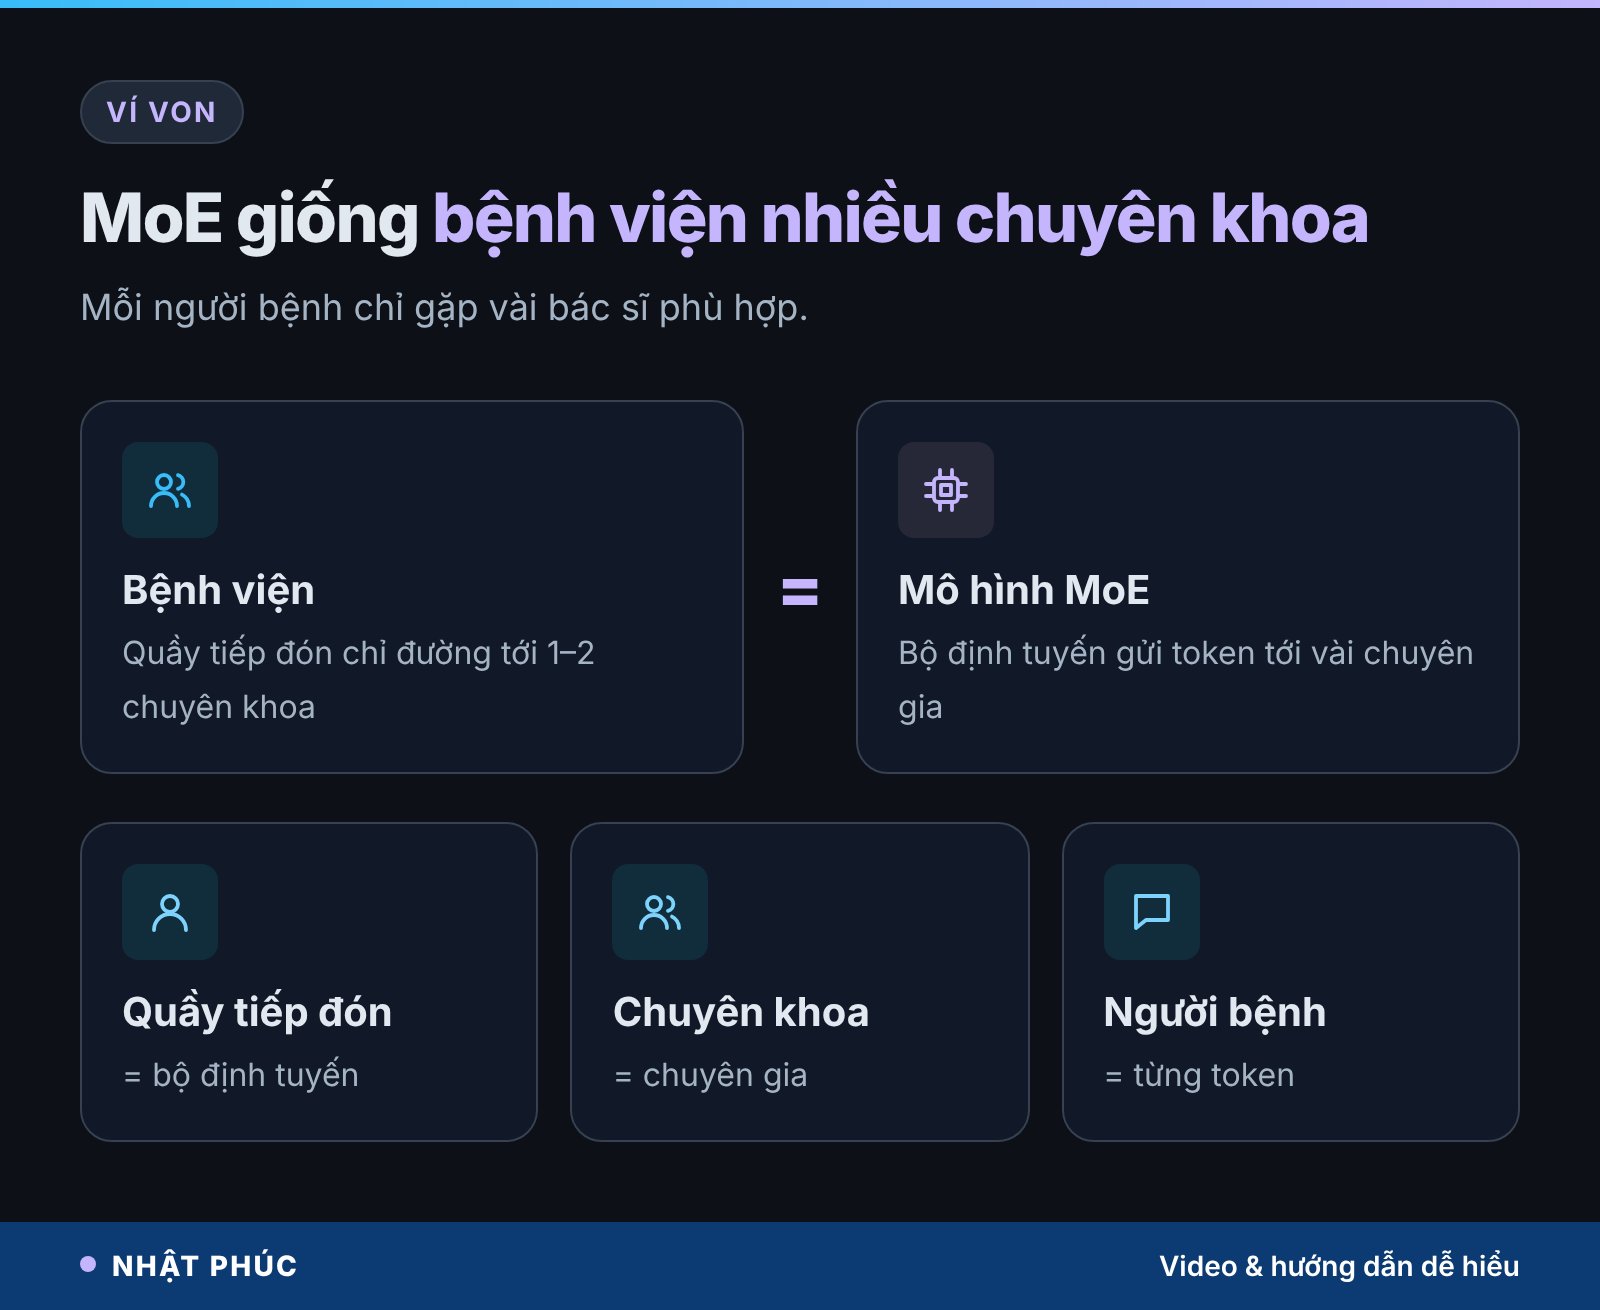
Hãy hình dung một bệnh viện lớn có hàng chục chuyên khoa. Bệnh nhân bước vào không đi gặp tất cả bác sĩ. Quầy tiếp đón hỏi vài câu rồi chỉ đường tới đúng một hai phòng khám. Bệnh viện “biết” rất nhiều, nhưng mỗi người bệnh chỉ dùng một phần nhỏ nguồn lực.
MoE vận hành giống hệt vậy. Trong một mô hình ngôn ngữ lớn thông thường (gọi là mô hình “dày”, dense), mỗi token đi qua toàn bộ mạng nơ-ron. Trong mô hình MoE, một số lớp được thay bằng nhiều mạng con song song, gọi là chuyên gia (expert). Đi kèm là một mạng nhỏ đóng vai quầy tiếp đón, gọi là bộ định tuyến (router hay gating network). Bộ định tuyến quyết định token nào đi tới chuyên gia nào.
Nếu bạn chưa rõ mô hình ngôn ngữ lớn là gì, nên đọc trước bài giải thích LLM là gì. MoE không phải một loại AI mới, mà là một cách sắp xếp bên trong LLM để nó lớn hơn mà không chậm đi tương ứng.
Tham số tổng và tham số kích hoạt khác nhau thế nào?
Tham số là các con số mà mô hình học được trong quá trình huấn luyện, giống như “nếp nhăn” của bộ não. Với MoE, bạn sẽ luôn thấy hai con số đi cùng nhau:
- Tham số tổng (total parameters): tất cả tham số của mọi chuyên gia cộng lại. Con số này phản ánh dung lượng kiến thức mô hình có thể chứa.
- Tham số kích hoạt (active parameters): số tham số thực sự tham gia tính toán cho mỗi token. Con số này quyết định tốc độ và chi phí tính toán.
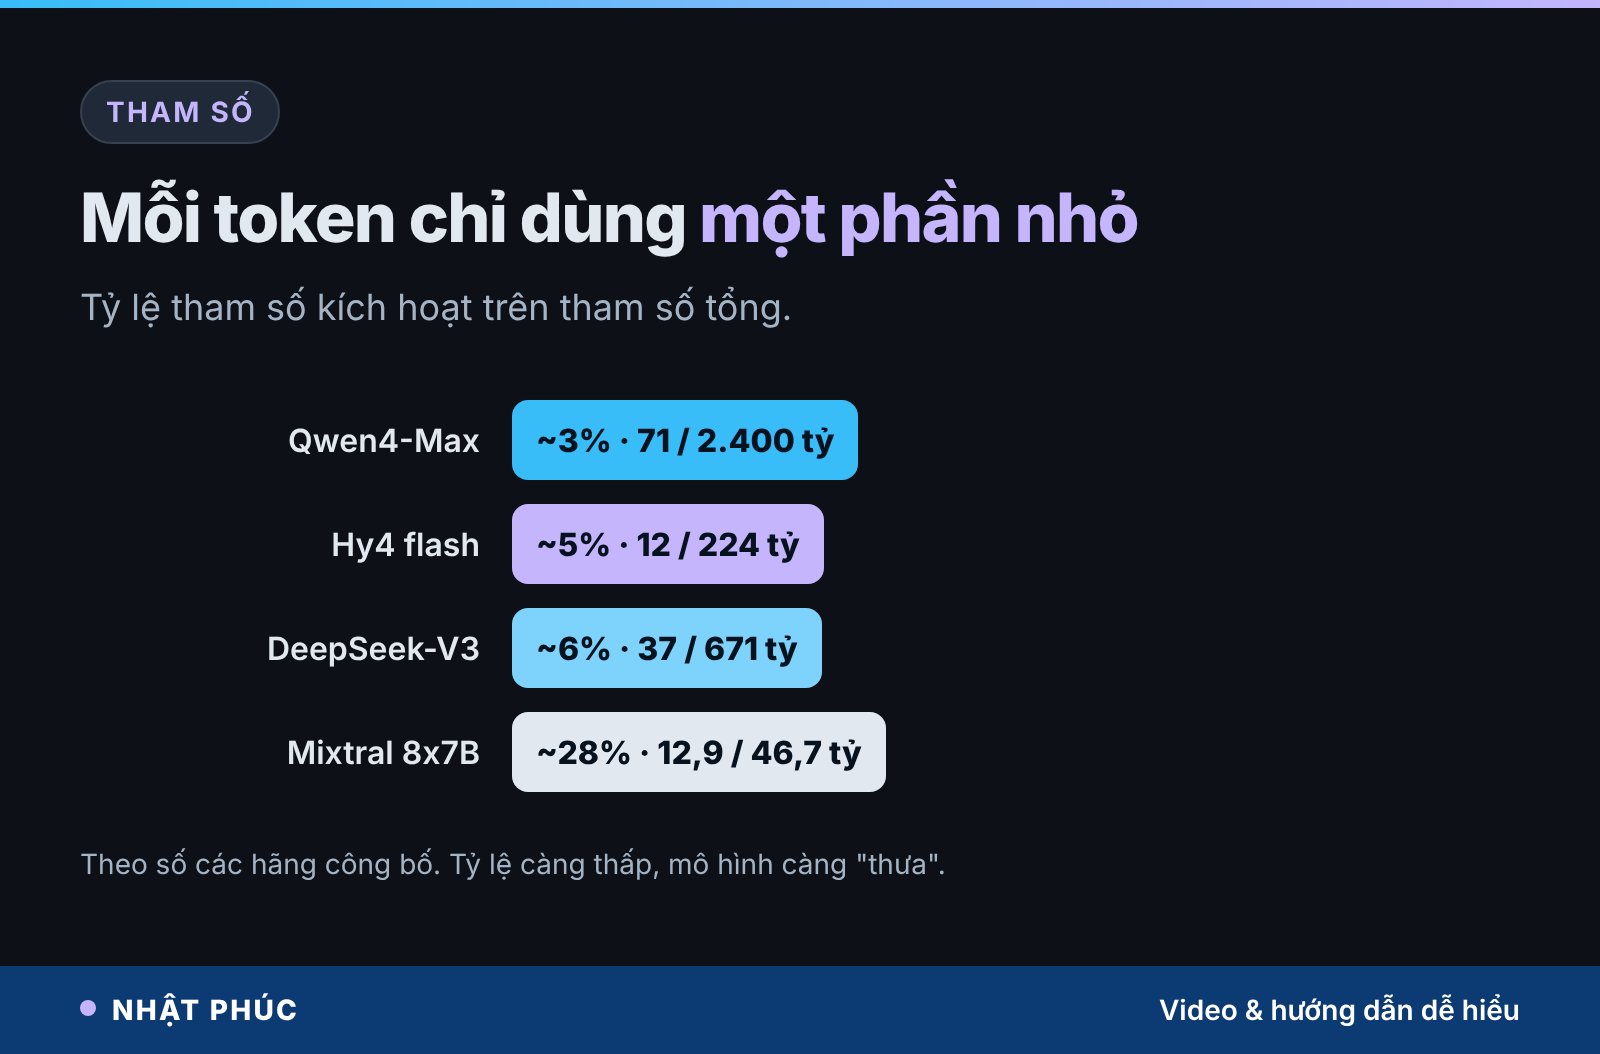
Ví dụ, Qwen4-Max có 2,4 nghìn tỷ tham số tổng nhưng mỗi token chỉ kích hoạt khoảng 71 tỷ, tức chừng 3%. Hy4 flash có 224 tỷ tham số tổng, kích hoạt 12 tỷ, khoảng 5%. Mô hình mã nguồn mở Mixtral 8x7B ra mắt cuối năm 2023 có 46,7 tỷ tham số tổng, kích hoạt 12,9 tỷ, khoảng 28%. Tỷ lệ kích hoạt càng thấp thì mô hình càng “thưa” (sparse).
Một quy tắc ước lượng hay dùng: số phép tính cho mỗi token tỷ lệ gần đúng với tham số kích hoạt. Vì thế, về mặt tính toán, Qwen4-Max chạy gần giống một mô hình dày cỡ 70 tỷ tham số chứ không phải 2,4 nghìn tỷ.
Bộ định tuyến chọn chuyên gia ra sao?
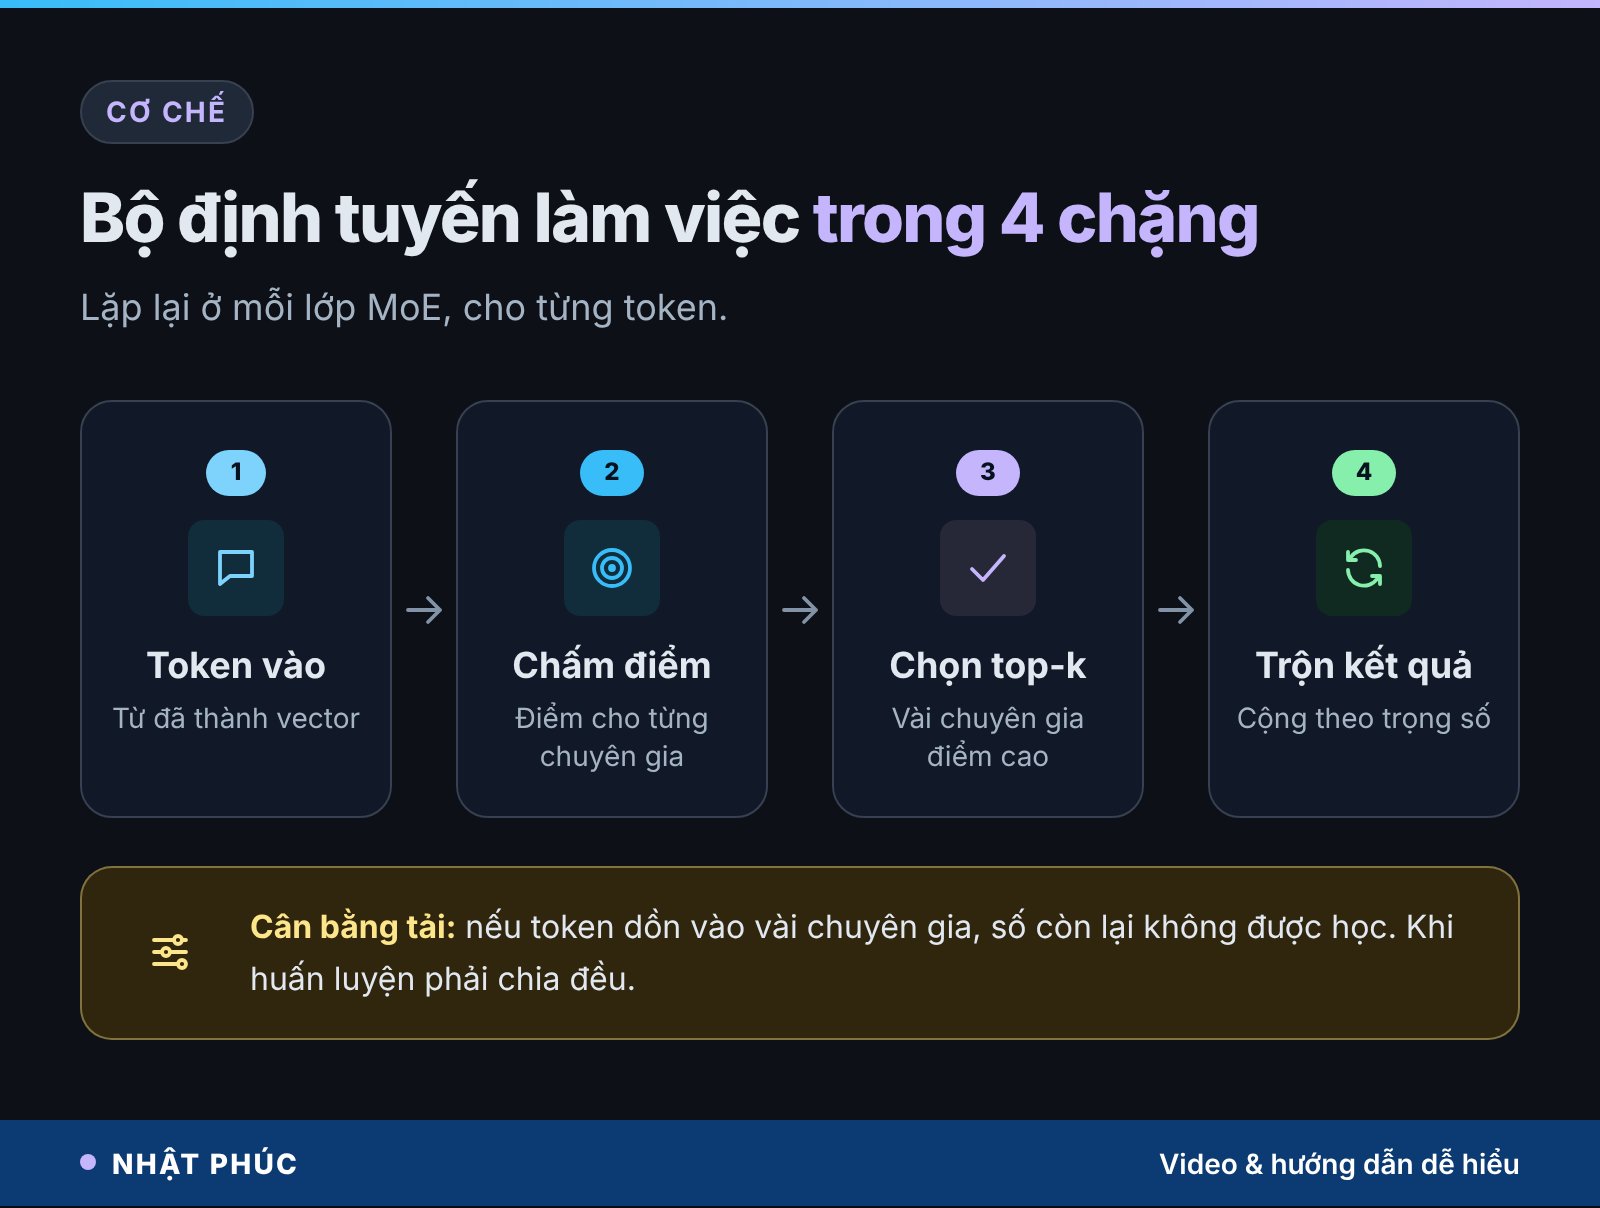
Hành trình của một token qua lớp MoE có thể tóm gọn trong bốn chặng:
- Token đi vào: mỗi từ đã được biến thành một dãy số (vector) mang nghĩa của nó trong câu.
- Bộ định tuyến chấm điểm: mạng nhỏ này cho mỗi chuyên gia một điểm “mức phù hợp”.
- Chọn vài chuyên gia điểm cao nhất: gọi là cách chọn top-k, ví dụ chọn 1 (Switch Transformer) hoặc 2 trong 8 (Mixtral). Các chuyên gia còn lại nghỉ.
- Trộn kết quả: đầu ra của các chuyên gia được chọn được cộng lại theo trọng số điểm, rồi chuyển sang lớp kế tiếp.
“Chuyên gia” không phải chuyên gia theo chủ đề
Cái tên dễ gây hiểu lầm. Các chuyên gia không được giao sẵn “toán”, “tiếng Việt” hay “lập trình”. Chúng tự phân công trong lúc huấn luyện, và sự chuyên môn hoá thường rất khó đặt tên: có chuyên gia hay nhận dấu câu, có chuyên gia hay nhận một kiểu cấu trúc câu. Hơn nữa, việc định tuyến diễn ra ở từng lớp và từng token, nên một câu tiếng Việt có thể đi qua rất nhiều chuyên gia khác nhau.
Bài toán cân bằng tải
Nếu bộ định tuyến cứ dồn token cho vài chuyên gia “quen tay”, số còn lại sẽ không được học, còn phần cứng chạy các chuyên gia đông khách thì quá tải. Vì vậy các nhóm nghiên cứu thêm cơ chế cân bằng tải (load balancing) trong huấn luyện để token được chia đều hơn. Đây là một trong những phần khó nhất khi làm MoE.
Vì sao MoE rẻ khi chạy nhưng vẫn ngốn bộ nhớ?
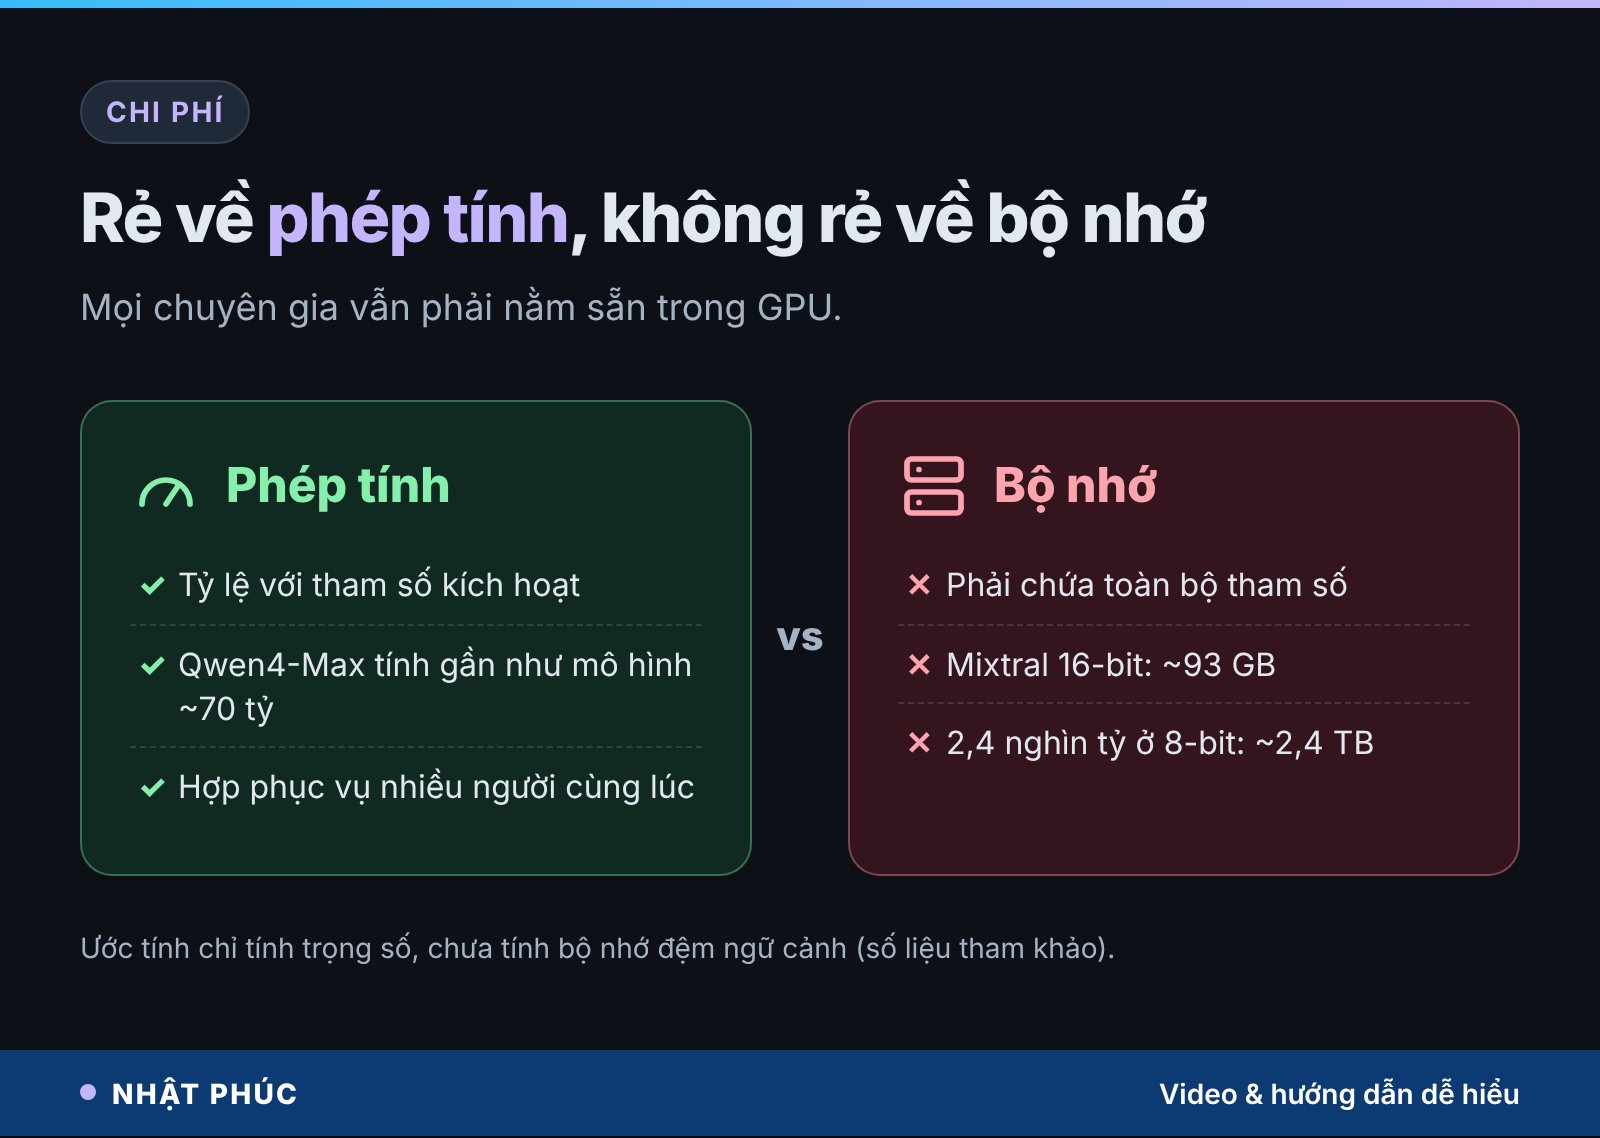
MoE giảm phép tính chứ không giảm dung lượng. Quay lại ví dụ bệnh viện: mỗi bệnh nhân chỉ gặp hai bác sĩ, nhưng bệnh viện vẫn phải trả lương và giữ phòng cho tất cả bác sĩ, vì không biết người tiếp theo cần ai.
Với máy chủ AI cũng thế. Toàn bộ chuyên gia phải nằm sẵn trong bộ nhớ GPU để bộ định tuyến gọi bất cứ lúc nào. Một phép ước tính thô (chỉ tính trọng số, chưa tính bộ nhớ đệm ngữ cảnh):
- Mixtral 8x7B với 46,7 tỷ tham số ở độ chính xác 16-bit cần khoảng 93 GB; nén xuống 4-bit còn khoảng 23–26 GB.
- Một mô hình 2,4 nghìn tỷ tham số, dù nén xuống 8-bit, vẫn cần cỡ 2,4 TB chỉ để chứa trọng số (số liệu tham khảo).
Đó là lý do MoE rất hợp với nhà cung cấp đám mây phục vụ hàng triệu yêu cầu cùng lúc: chi phí bộ nhớ chia đều cho nhiều người, còn phép tính mỗi token thì thấp. Ngược lại, người muốn tự chạy trên máy tính cá nhân thường thấy MoE “nặng” hơn con số tham số kích hoạt gợi ý. Nếu bạn quan tâm việc chạy AI tại chỗ, xem thêm bài hướng dẫn chạy AI offline trên máy tính.
Lịch sử MoE: từ ý tưởng 1991 đến mô hình nghìn tỷ tham số
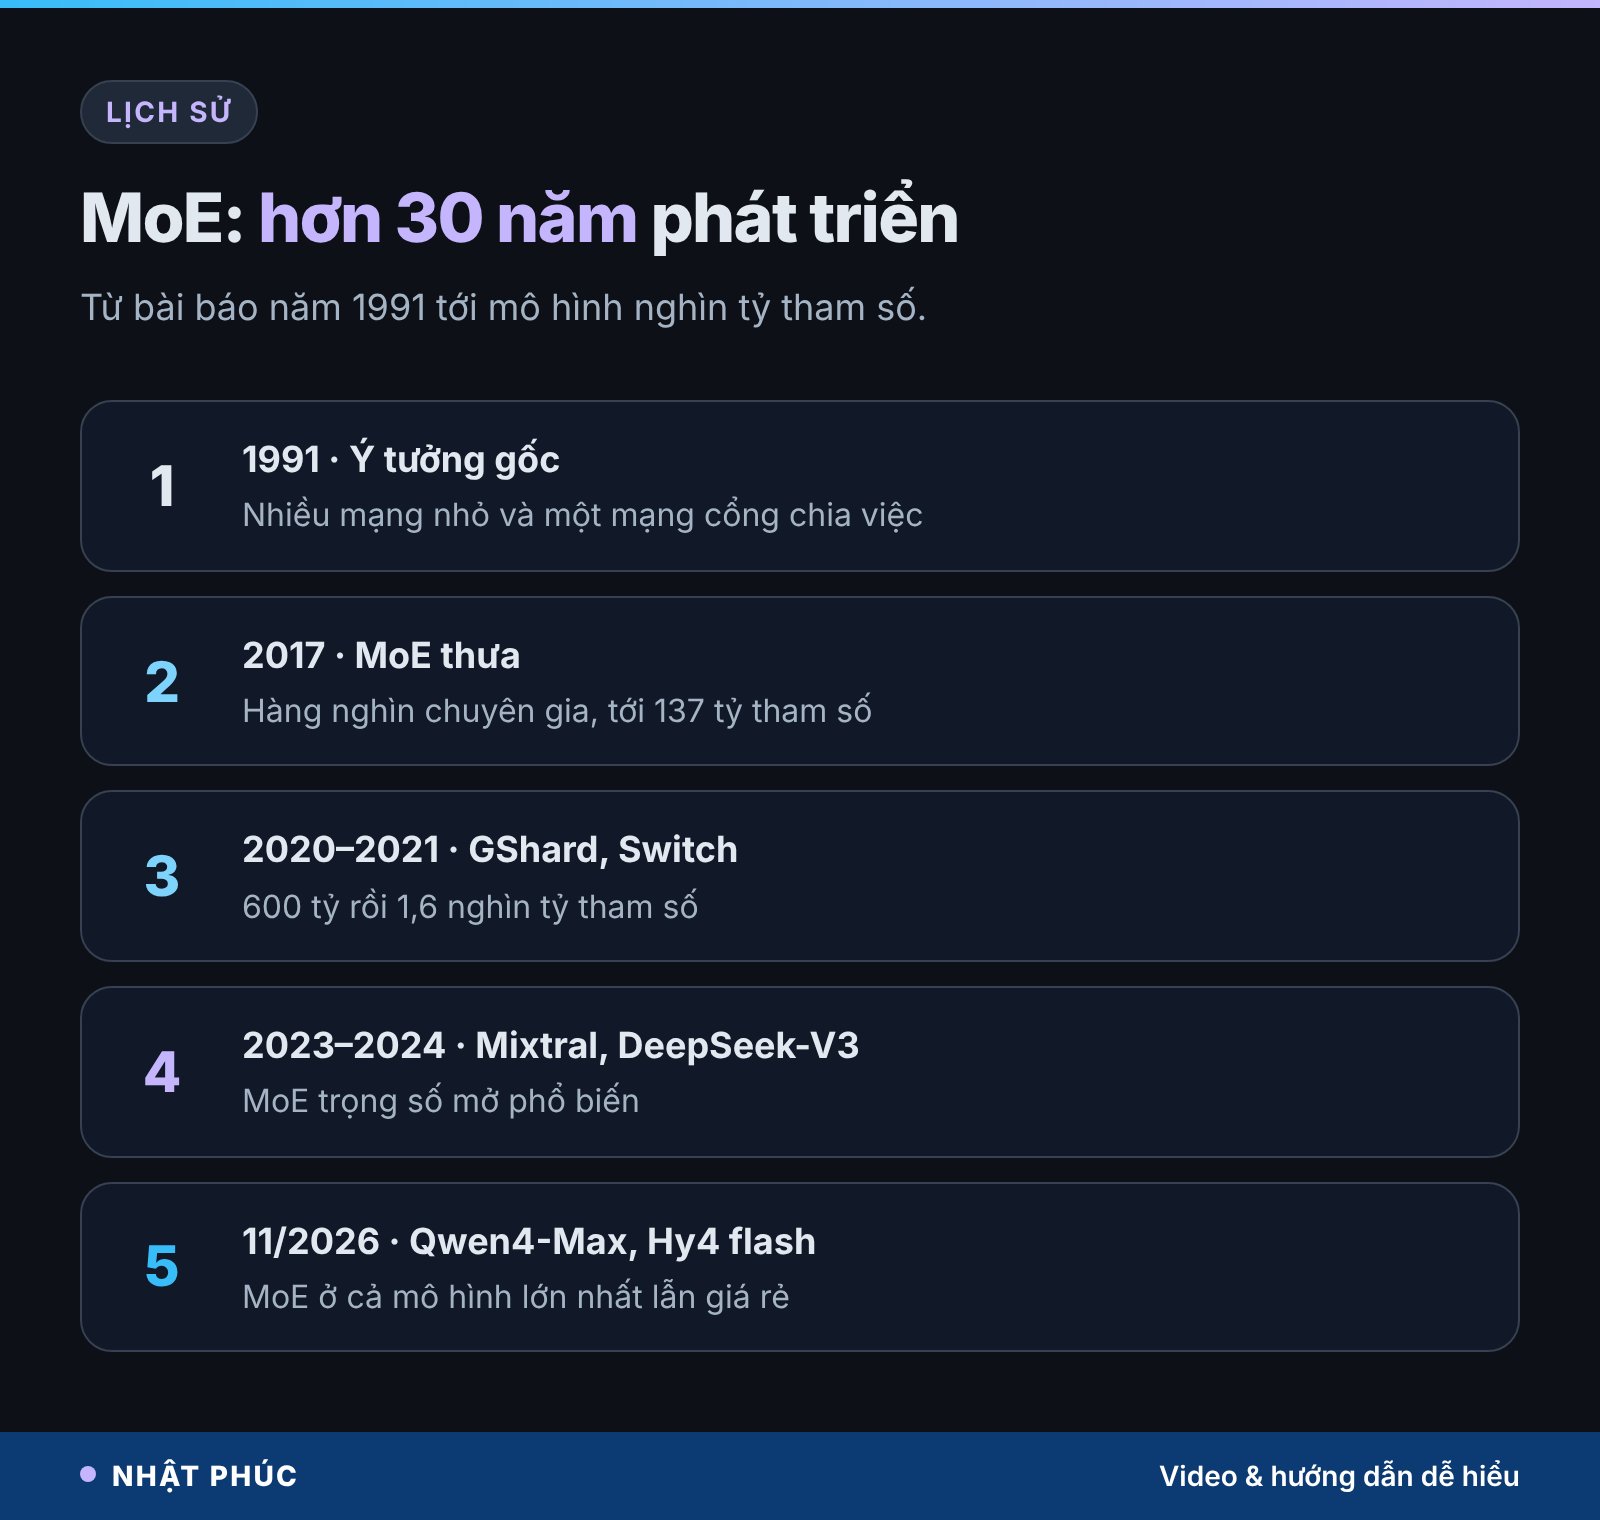
MoE không phải phát minh của thời ChatGPT. Ý tưởng đã có hơn 30 năm:
- 1991: bài báo “Adaptive Mixtures of Local Experts” của Jacobs, Jordan, Nowlan và Hinton đề xuất nhiều mạng nhỏ cùng một mạng cổng chia việc.
- 2017: nhóm Google công bố lớp “Sparsely-Gated Mixture-of-Experts”, đưa MoE vào mạng ngôn ngữ với hàng nghìn chuyên gia và tới 137 tỷ tham số.
- 2020: GShard của Google mở rộng MoE lên 600 tỷ tham số cho bài toán dịch máy.
- 2021: Switch Transformer mỗi token chỉ chọn một chuyên gia, đạt 1,6 nghìn tỷ tham số.
- 12/2023: Mixtral 8x7B của Mistral AI phát hành trọng số mở, giúp cộng đồng làm quen với MoE.
- 12/2024: DeepSeek-V3 có 671 tỷ tham số tổng, 37 tỷ kích hoạt mỗi token.
- 11/2026: Qwen4-Max (2,4 nghìn tỷ) và Hy4 flash (224 tỷ) cho thấy MoE đã thành lựa chọn phổ biến ở cả mô hình lớn nhất lẫn mô hình giá rẻ.
Qwen4-Max: ví dụ MoE 2,4 nghìn tỷ tham số
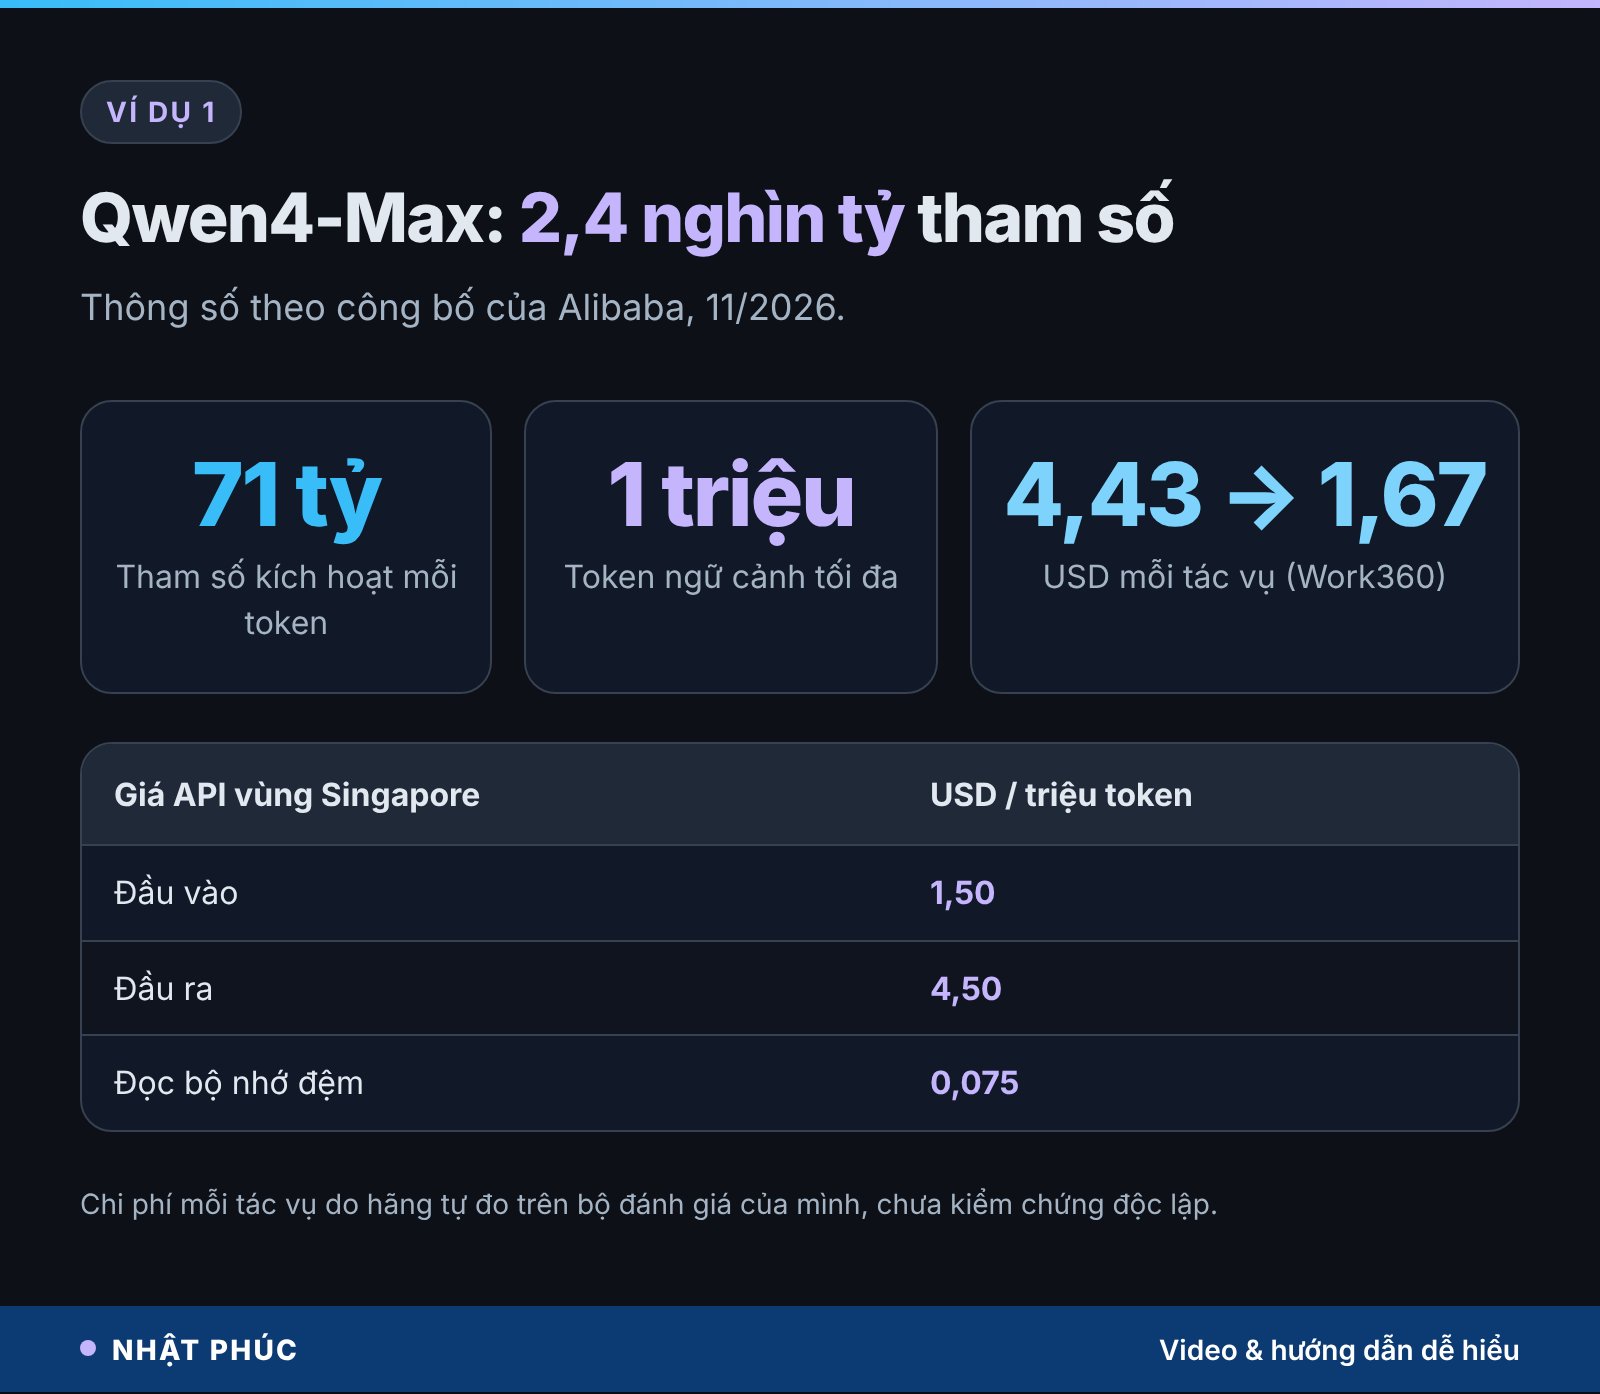
Qwen4-Max là mô hình lớn nhất của dòng Qwen4 do Alibaba phát triển, mở API trả theo lượng dùng trên nền tảng QwenCloud vào ngày 16/11/2026, sau một tuần chạy thử bản xem trước. Những thông số chính theo công bố của hãng:
- Kiến trúc: MoE thưa với 2,4 nghìn tỷ tham số tổng, khoảng 71 tỷ tham số kích hoạt mỗi token, cộng thêm 328 tỷ tham số cho lớp nhúng N-gram (giúp nắm các cụm từ hay đi cùng nhau).
- Ngữ cảnh: tới 1 triệu token; đầu ra tối đa 131.072 token khi tắt chế độ suy nghĩ, 262.144 token khi bật (gồm cả phần suy nghĩ).
- Đầu vào: văn bản, hình ảnh, video; đầu ra là văn bản.
- Trọng số: đóng, chỉ dùng qua API và ứng dụng của hãng. Alibaba nói các mô hình Qwen4 nhỏ hơn sẽ được mở trọng số nhưng chưa có lịch.
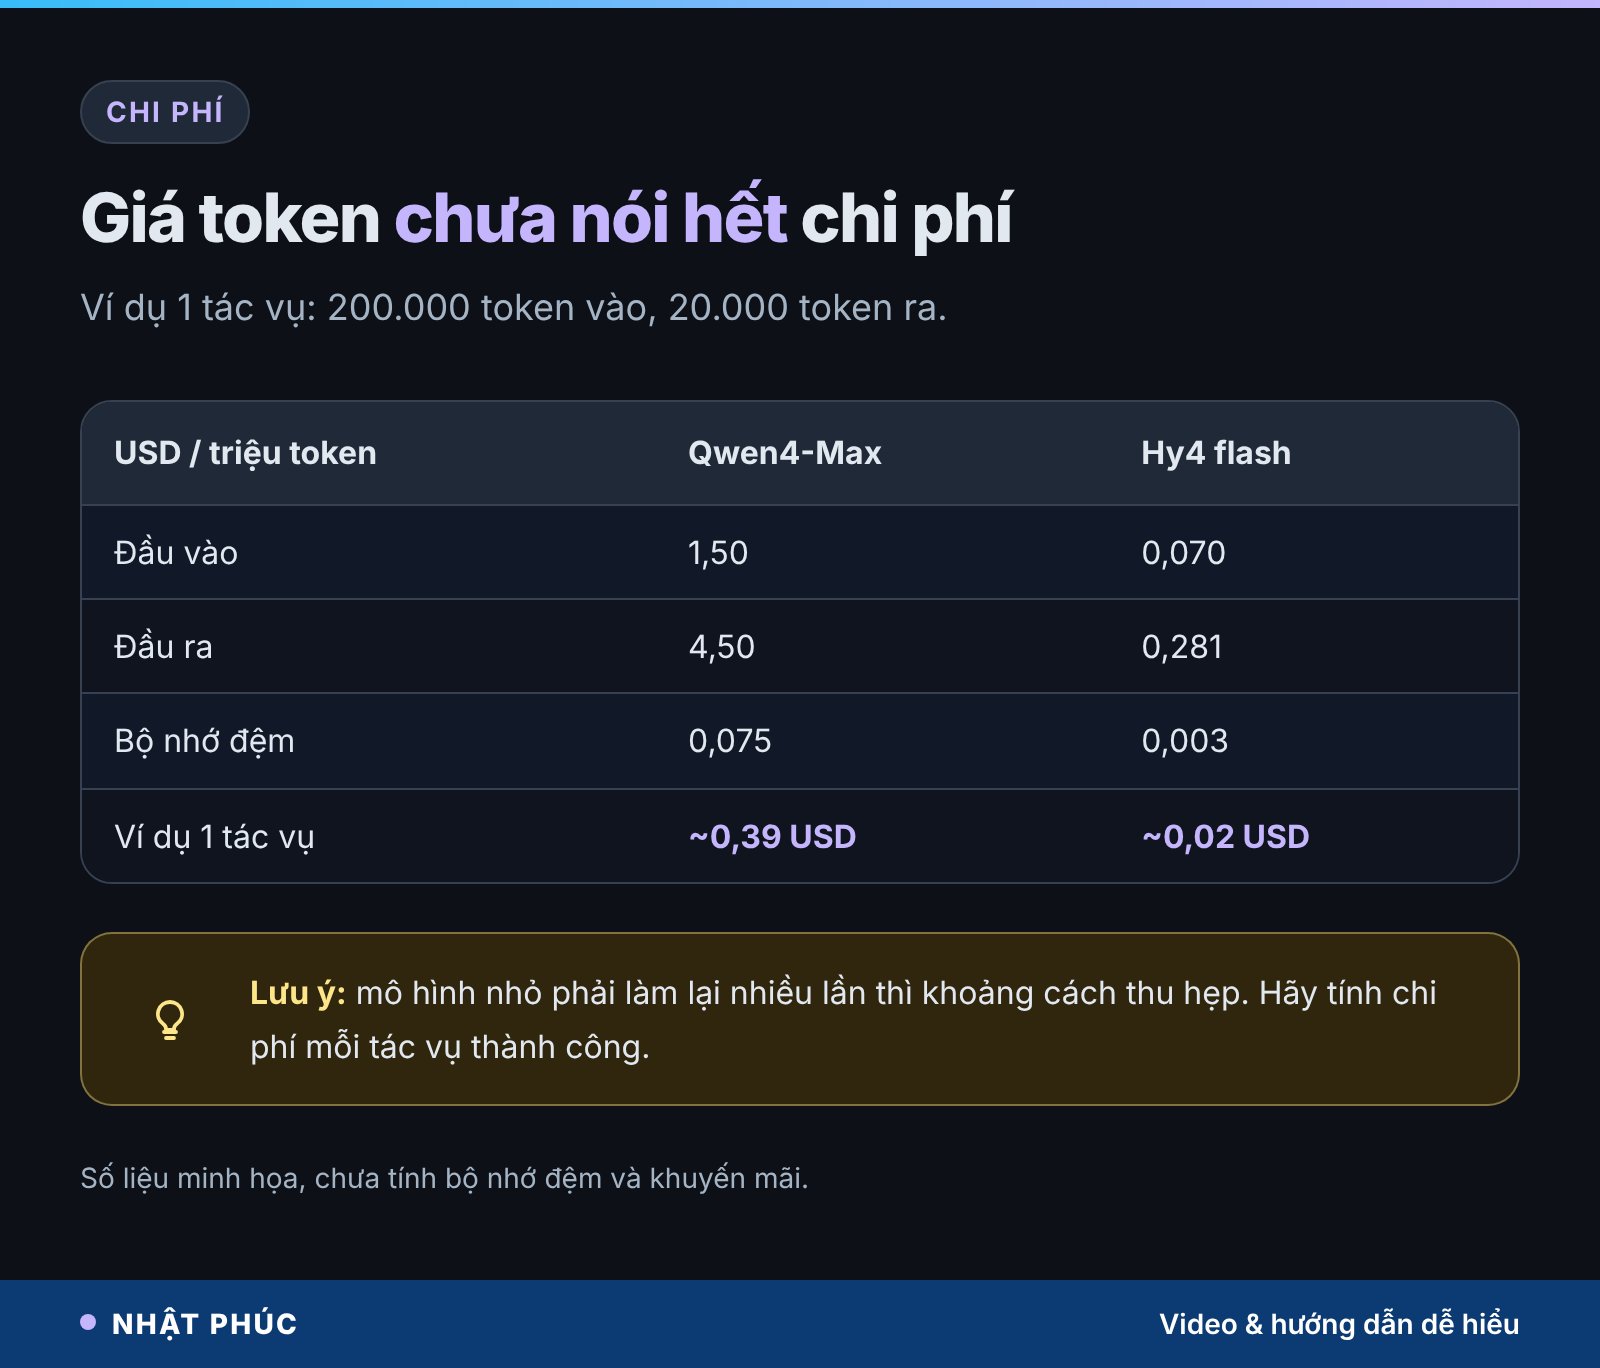
- Giá API (vùng Singapore): 1,50 USD mỗi triệu token đầu vào, 4,50 USD mỗi triệu token đầu ra, đọc bộ nhớ đệm 0,075 USD mỗi triệu token.
Điểm đáng chú ý là cách hãng nói về chi phí. Trên bộ đánh giá công việc Work360 do chính Alibaba xây, chi phí trung bình mỗi tác vụ giảm từ 4,43 USD (Qwen3.8-Max) xuống 1,67 USD. Trên Terminal-Bench 4.0, số token mỗi lần thử giảm từ khoảng 289.000 xuống 151.000 trong khi điểm tăng từ 37,9 lên 48,5. Đây là số liệu hãng tự công bố, chưa có kiểm chứng độc lập, nhưng cho thấy hướng tối ưu: mô hình lớn hơn nhưng làm việc gọn hơn.
Hy4 flash: MoE gọn cho việc hằng ngày
Hy4 flash là mô hình “Flash” đầu tiên của dòng Hy4 do nhóm Hunyuan của Tencent công bố ngày 16/11/2026. Nếu Qwen4-Max nhắm tới việc khó, Hy4 flash nhắm tới việc nhiều: soạn tài liệu, làm slide, tìm kiếm sâu, thao tác máy tính.
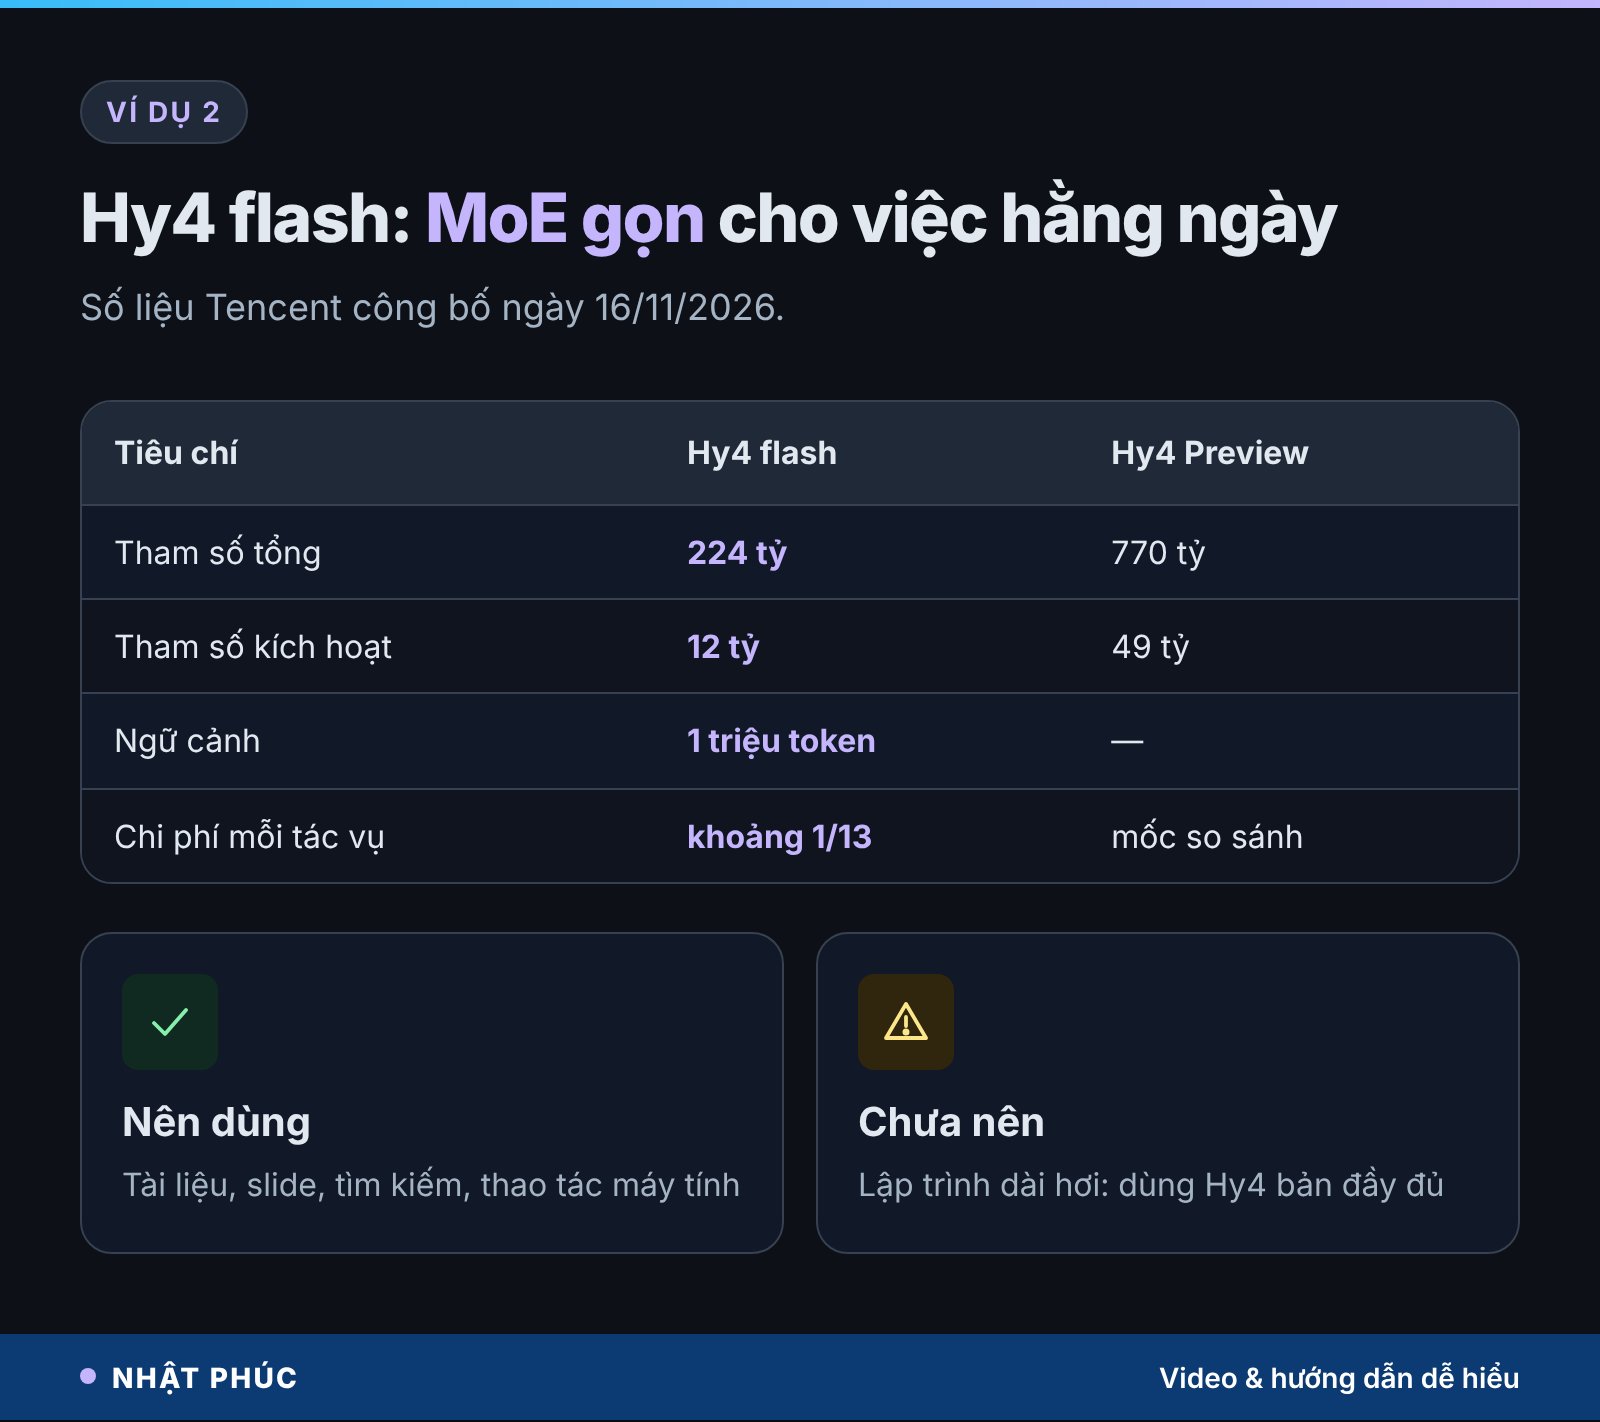
- Kích thước: 224 tỷ tham số tổng (trong đó 64 tỷ là tham số tra cứu kiểu Engram), 12 tỷ tham số kích hoạt. Để so sánh, bản Hy4 Preview có 770 tỷ tham số tổng, 49 tỷ kích hoạt.
- Kiến trúc: kết hợp attention lai, LatentMoE và Engram. Bộ nhớ đệm KV (phần lưu ngữ cảnh khi trò chuyện) chỉ bằng 1/6 của Hy4 và 1/24 của Hy3.
- Tốc độ: nhờ lượng tử hoá 4-bit và tối ưu nhân tính toán, hãng công bố tốc độ sinh trên 150 token mỗi giây.
- Ngữ cảnh: tới 1 triệu token, nhận đầu vào đa phương thức.
- Giá API: khoảng 0,070 USD mỗi triệu token đầu vào, 0,281 USD mỗi triệu token đầu ra, 0,003 USD mỗi triệu token đầu vào lấy từ bộ nhớ đệm.
Tencent nói trên bộ đánh giá nội bộ WorkIndex, Hy4 flash nhỉnh hơn Hy4 Preview một chút, với chi phí mỗi tác vụ chỉ khoảng 1/13 của Hy4 Preview và 1/20 của Hy4. Hãng cũng thẳng thắn khuyên: việc lập trình dài hơi, nhiều bước vẫn nên dùng Hy4 bản đầy đủ. Tencent hứa sẽ mở trọng số Hy4 flash nhưng chưa đưa ngày cụ thể.
| Tiêu chí | Hy4 flash | Hy4 Preview |
|---|---|---|
| Tham số tổng | 224 tỷ | 770 tỷ |
| Tham số kích hoạt | 12 tỷ | 49 tỷ |
| Chi phí mỗi tác vụ (WorkIndex) | khoảng 1/13 | mốc so sánh |
| Việc nên dùng | tài liệu, slide, tìm kiếm, thao tác máy tính | việc khó, lập trình dài hơi (bản Hy4) |
Giá mỗi token và chi phí mỗi tác vụ khác nhau thế nào?
Bảng giá API thường tính theo triệu token. Nhưng một tác vụ thật, nhất là tác vụ của AI agent, có thể dùng hàng trăm nghìn token, gồm cả phần mô hình “suy nghĩ”. Mô hình giá rẻ mà lan man, phải thử lại nhiều lần, có khi tốn hơn mô hình đắt mà làm một lần đúng. Đó là lý do cả Alibaba lẫn Tencent đều nhấn mạnh chi phí mỗi tác vụ thay vì chỉ giá token. Khái niệm này đã được phân tích kỹ trong bài mô hình AI nhỏ và bài toán AI agent giá rẻ.
Thử một phép tính minh hoạ: một tác vụ đọc 200.000 token đầu vào và viết 20.000 token đầu ra, chưa tính bộ nhớ đệm (số liệu minh họa):
- Qwen4-Max: 0,2 × 1,50 + 0,02 × 4,50 = khoảng 0,39 USD.
- Hy4 flash: 0,2 × 0,070 + 0,02 × 0,281 = khoảng 0,02 USD.
Chênh khoảng 20 lần. Nhưng nếu tác vụ khó tới mức mô hình nhỏ làm sai và phải làm lại năm lần, khoảng cách sẽ thu hẹp, cộng thêm thời gian của bạn để kiểm tra. Vì thế, câu hỏi đúng không phải “mô hình nào rẻ hơn” mà là “mô hình nào hoàn thành việc này với tổng chi phí thấp nhất”.
Người Việt dùng mô hình MoE như Qwen4-Max, Hy4 flash được không?
Cả hai đều là dịch vụ trên đám mây, nên điều kiện dùng phụ thuộc vào nền tảng mà hãng mở cho người dùng quốc tế:
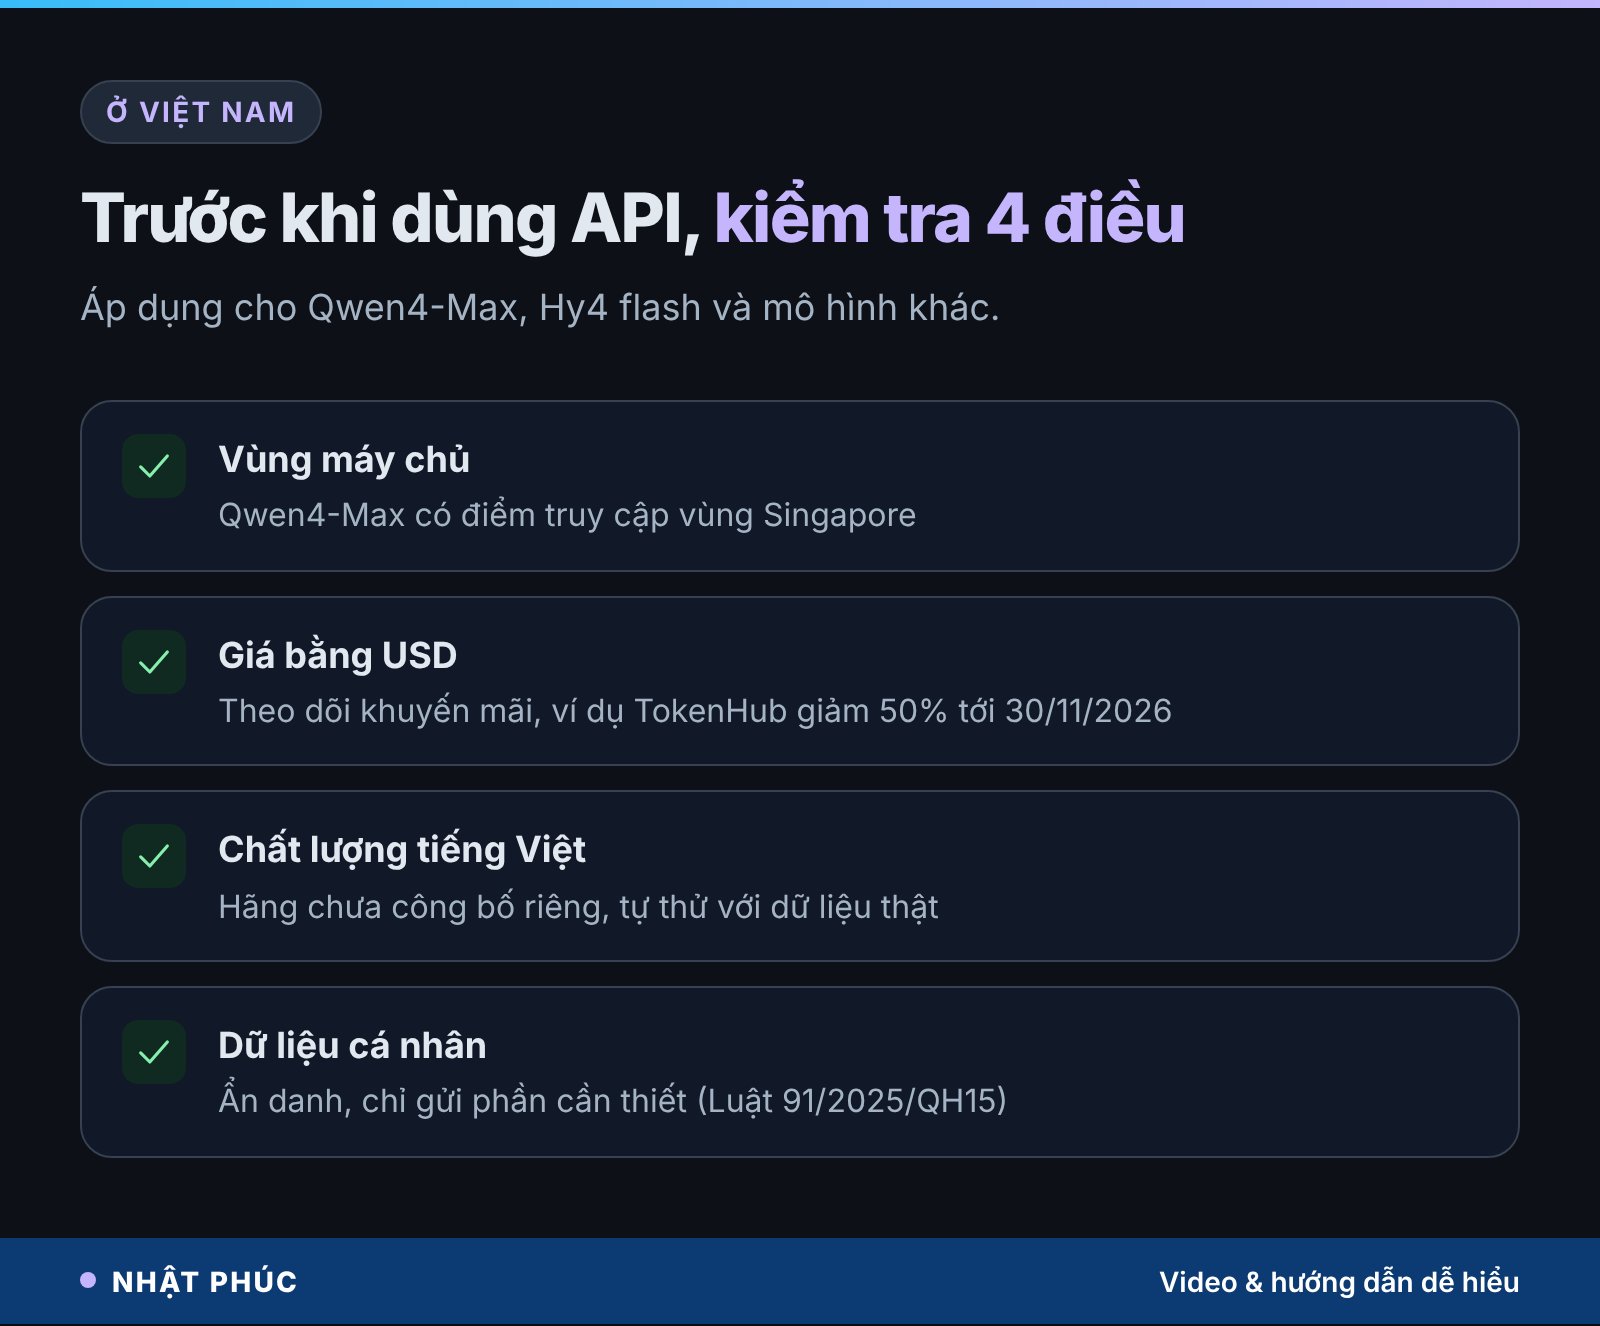
- Qwen4-Max: gọi qua API QwenCloud với các điểm truy cập theo vùng, trong đó có Singapore (bảng giá USD ở trên là giá vùng Singapore). Bạn cũng có thể trò chuyện qua ứng dụng Qwen Studio. Hãng chưa công bố riêng chất lượng tiếng Việt, nên hãy tự thử với dữ liệu của mình.
- Hy4 flash: có trên nền tảng TokenHub của Tencent Cloud (giảm 50% tới hết 30/11/2026) và trong các ứng dụng của Tencent. Tencent cho biết sẽ sớm đưa lên OpenRouter, một cổng gọi nhiều mô hình qua một tài khoản, rất tiện cho lập trình viên Việt.
Điều quan trọng hơn giá là dữ liệu. Gọi API nghĩa là gửi văn bản lên máy chủ ở nước ngoài. Nếu nội dung có thông tin khách hàng, nhân viên, hãy nhớ các nghĩa vụ theo Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15: chỉ gửi dữ liệu cần thiết, ẩn danh khi có thể, đọc kỹ điều khoản lưu trữ của nhà cung cấp.
Chọn MoE lớn hay nhỏ cho công việc tự động hoá?
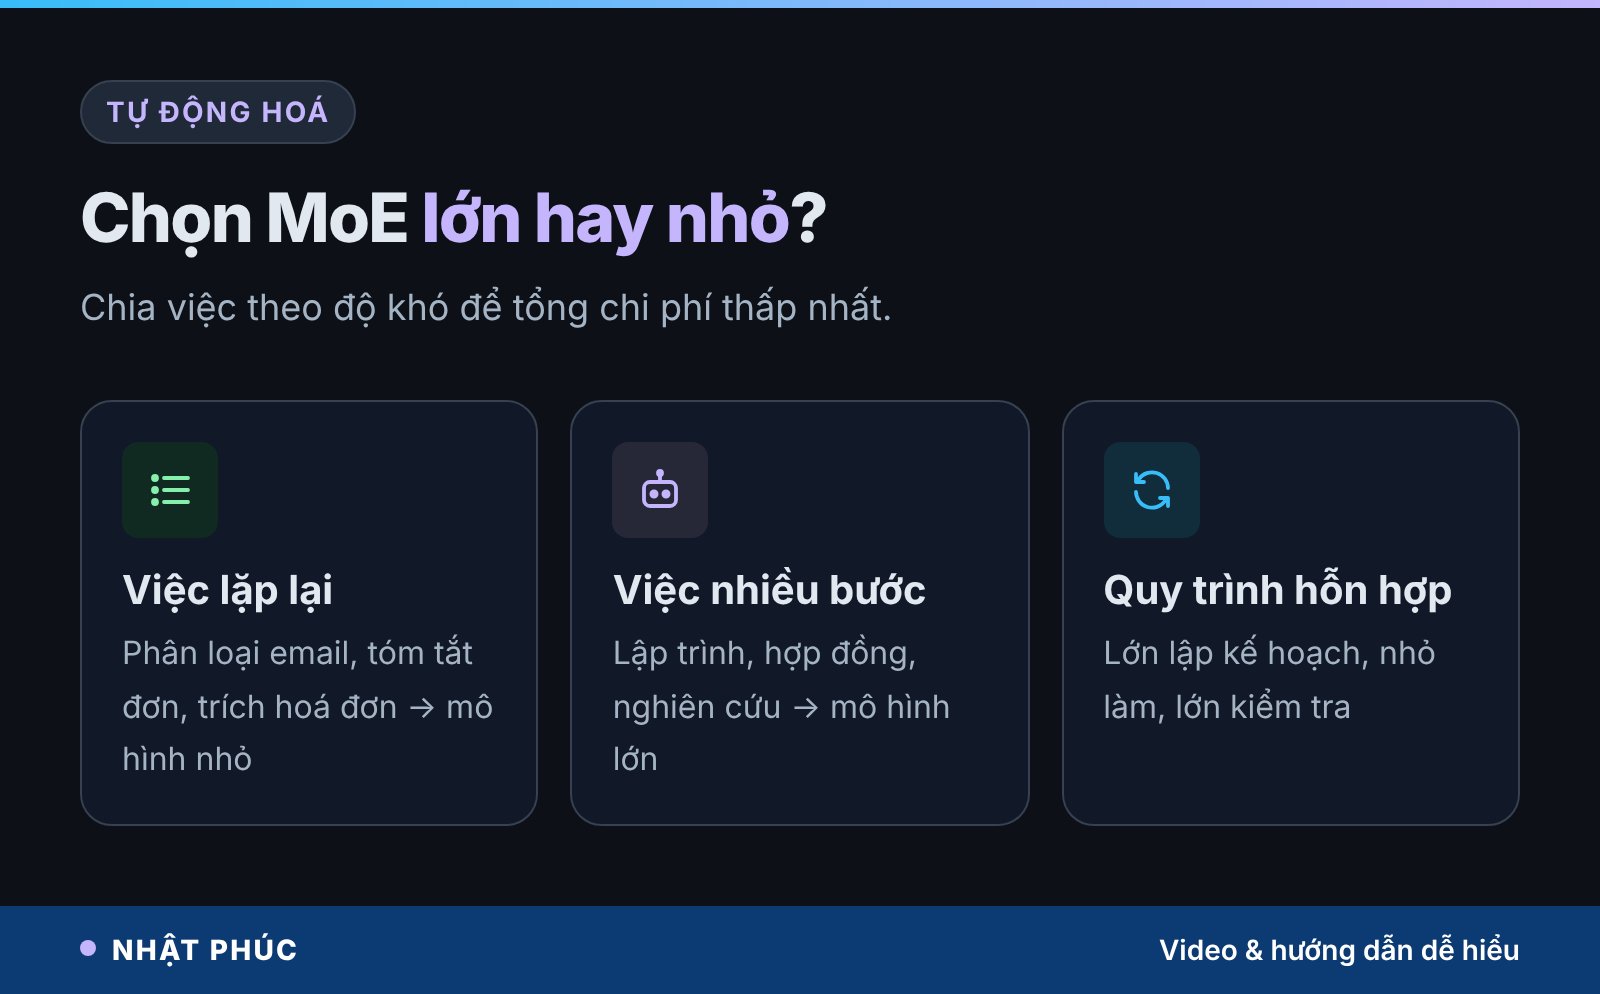
Hai mô hình trong bài đại diện cho hai cực: một bên mạnh và đắt hơn, một bên nhanh và rất rẻ. Cách chọn thực tế là chia việc theo độ khó, giống bệnh viện chia bệnh nhân theo mức độ:
- Việc lặp lại số lượng lớn (phân loại email, tóm tắt đơn hàng, trích thông tin hoá đơn): dùng mô hình nhỏ, tham số kích hoạt thấp.
- Việc nhiều bước, cần suy luận dài (lập trình, phân tích hợp đồng, nghiên cứu): dùng mô hình lớn.
- Quy trình hỗn hợp: để mô hình lớn lập kế hoạch, mô hình nhỏ làm từng bước, rồi mô hình lớn kiểm tra kết quả cuối.
1. Ghi lại một tác vụ mẫu
Chọn 10–20 ví dụ thật, chẳng hạn 20 email khách hỏi về đơn hàng của một shop online, kèm câu trả lời bạn cho là đúng.
2. Chạy thử cả mô hình lớn và nhỏ
Dùng cùng một câu lệnh cho cả hai. Ghi lại số token đầu vào, đầu ra mà API trả về cho từng lần.
3. Chấm điểm bằng tay
Đếm số câu trả lời dùng được ngay, số câu phải sửa, số câu sai hẳn. Đừng chỉ nhìn một hai ví dụ đẹp.
4. Tính chi phí mỗi tác vụ thành công
Lấy tổng tiền API chia cho số tác vụ đạt yêu cầu, cộng thêm thời gian bạn phải sửa. Con số này mới phản ánh đúng.
5. Thiết lập ngưỡng chuyển lên mô hình lớn
Ví dụ: mô hình nhỏ trả lời kèm mức tự tin, hoặc khi gặp từ khoá như “khiếu nại”, “hoàn tiền” thì chuyển sang mô hình lớn hoặc người thật.
Hiểu lầm phổ biến về MoE
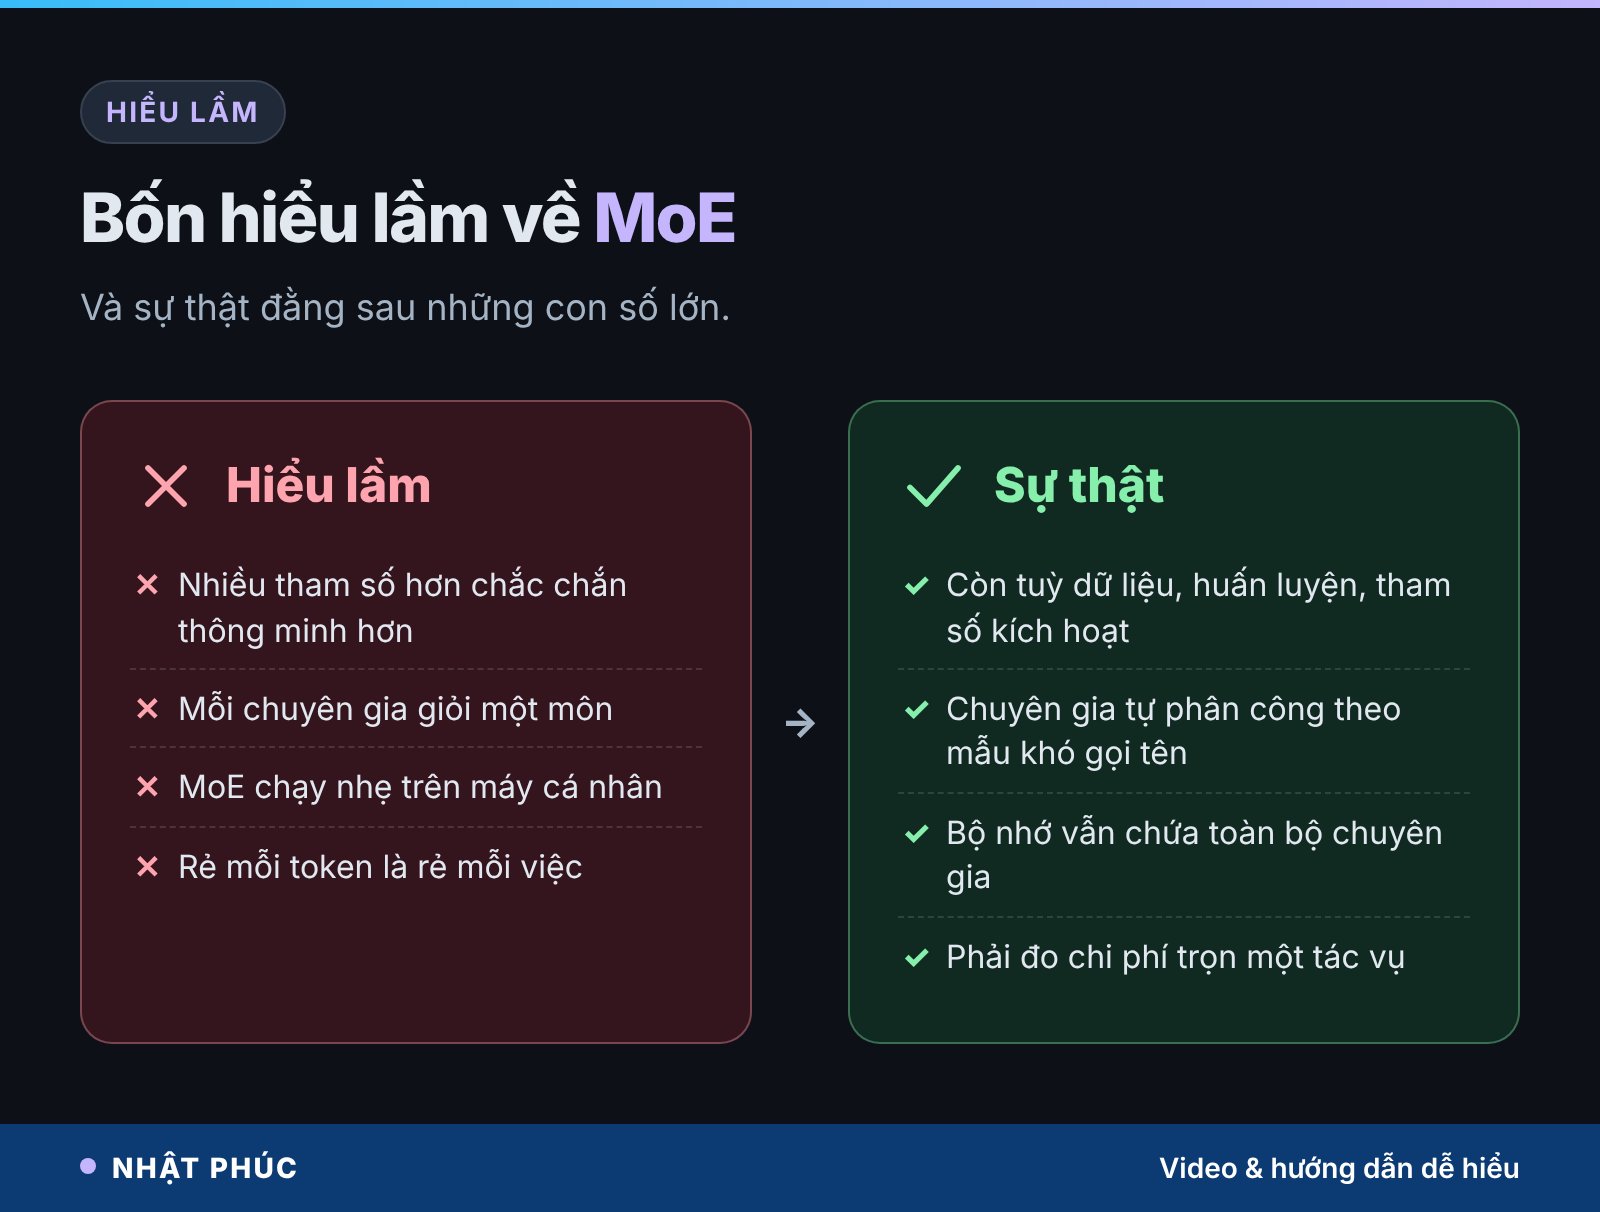
Vì chữ “chuyên gia” và những con số rất lớn, MoE hay bị hiểu sai theo vài kiểu:
- “Nhiều tham số hơn chắc chắn thông minh hơn”: không hẳn. Chất lượng phụ thuộc dữ liệu, cách huấn luyện, và tham số kích hoạt. So một mô hình MoE với một mô hình dày chỉ bằng tham số tổng là so khập khiễng.
- “Mỗi chuyên gia giỏi một môn”: sai. Chuyên gia tự phân công theo những mẫu khó gọi tên, không theo môn học.
- “MoE chạy nhẹ trên máy cá nhân”: sai. Phép tính ít nhưng bộ nhớ vẫn phải chứa toàn bộ chuyên gia.
- “Rẻ mỗi token là rẻ mỗi việc”: chưa chắc. Cần đo chi phí trọn một tác vụ.
Câu hỏi thường gặp về MoE
MoE viết tắt của gì?
MoE là viết tắt của Mixture of Experts, tiếng Việt thường gọi là mô hình chuyên gia hỗn hợp hoặc hỗn hợp chuyên gia. Đây là kiến trúc chia một phần mạng nơ-ron thành nhiều mạng con, mỗi token chỉ đi qua vài mạng con do bộ định tuyến chọn.
Mô hình MoE có chính xác kém hơn mô hình dày không?
Không nhất thiết. Với cùng ngân sách tính toán khi huấn luyện và khi chạy, MoE thường đạt chất lượng tốt hơn vì chứa được nhiều kiến thức hơn. Đổi lại, MoE khó huấn luyện hơn (phải cân bằng tải) và cần nhiều bộ nhớ hơn khi triển khai.
Tôi có tự chạy Qwen4-Max hay Hy4 flash trên máy tính được không?
Qwen4-Max hiện là mô hình đóng, chỉ dùng qua API và ứng dụng của Alibaba. Hy4 flash được Tencent hứa mở trọng số nhưng chưa có ngày. Kể cả khi mở, 224 tỷ tham số vẫn cần bộ nhớ vượt xa máy tính cá nhân phổ thông.
Làm sao biết một mô hình có dùng MoE không?
Hãy tìm trong trang công bố hoặc thẻ mô hình (model card): nếu thấy hai con số “tham số tổng” và “tham số kích hoạt”, hoặc chữ “MoE”, “sparse”, “experts”, thì đó là mô hình MoE. Nhiều hãng mô hình đóng không công bố kiến trúc, nên không thể khẳng định.
Số liệu “chi phí giảm 62%” hay “rẻ bằng 1/20” có đáng tin không?
Đó là số liệu hãng tự đo trên bộ đánh giá do chính họ xây dựng, nên chỉ nên xem là tham khảo. Cách đáng tin nhất là tự chạy thử với 10–20 tác vụ thật của bạn và tính chi phí trên mỗi tác vụ đạt yêu cầu.
Kết luận: MoE giúp AI lớn hơn mà không đắt tương ứng
MoE là lý do những con số “nghìn tỷ tham số” không còn đồng nghĩa với “chậm và đắt”. Bằng cách để bộ định tuyến chỉ đánh thức vài chuyên gia cho mỗi token, các hãng tách được dung lượng kiến thức khỏi chi phí tính toán. Qwen4-Max và Hy4 flash là hai ví dụ cho hai hướng: mạnh hơn với chi phí tác vụ thấp hơn, và rẻ tới mức có thể chạy hàng loạt việc tự động hoá hằng ngày.
Khi chọn mô hình, hãy nhìn cả hai con số tham số, đo chi phí trọn một tác vụ và cân nhắc dữ liệu bạn gửi đi. Bạn đang dùng mô hình AI nào cho công việc hằng ngày, và nó đã tiết kiệm cho bạn được bao nhiêu? Hãy chia sẻ trong phần bình luận và theo dõi Nhật Phúc để đọc thêm những bài giải thích AI dễ hiểu.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.