Bạn có bao giờ tự hỏi: tại sao một cỗ máy chỉ được dạy làm đúng một việc là đoán chữ tiếp theo, lại có thể viết thơ, sửa code và giải thích cả vật lý lượng tử? Câu trả lời nằm ở ba chữ cái: LLM. Bài viết này sẽ giải thích LLM là gì, vì sao nó “lớn”, máy đọc chữ ra sao và vì sao đôi khi AI trả lời sai một cách rất tự tin.
Câu trả lời ngắn: LLM (Large Language Model) là mô hình ngôn ngữ lớn, một mạng nơ-ron có hàng chục đến hàng trăm tỷ tham số, được huấn luyện trên lượng văn bản khổng lồ để làm đúng một việc: dự đoán chữ tiếp theo. Từ nhiệm vụ đơn giản ấy, ở quy mô cực lớn, mô hình học được ngữ pháp, kiến thức và cả cách suy luận.
Nghe thì phức tạp, nhưng ý tưởng cốt lõi lại đơn giản đến bất ngờ. Bạn không cần biết toán cao cấp để hiểu. Chỉ cần đi lần lượt từng mảnh ghép, từ chiếc bàn phím điện thoại quen thuộc cho đến những trợ lý AI như ChatGPT, Gemini hay Claude.
Nếu thích xem hơn đọc, bạn có thể xem video giải thích LLM là gì trên kênh Nhật Phúc ngay bên dưới. Bài viết này mở rộng từng ý trong video, kèm hình minh họa, bảng so sánh và câu hỏi thường gặp.
Tóm tắt nhanh
- LLM là mô hình ngôn ngữ lớn, làm đúng một việc: đoán chữ tiếp theo, giống gợi ý bàn phím nhưng ở quy mô lớn hơn rất nhiều.
- “Lớn” nghĩa là đọc hàng nghìn tỷ từ và có hàng chục đến hàng trăm tỷ tham số.
- Máy cắt văn bản thành token, đổi thành số; ý nghĩa nằm ở quan hệ giữa các con số.
- Kiến trúc Transformer với cơ chế attention giúp mô hình hiểu từ nào liên quan đến từ nào.
- Huấn luyện gồm tiền huấn luyện (học nối chữ) và tinh chỉnh (học cách trò chuyện).
- LLM có thể “ảo giác”, có giới hạn kiến thức và thiên kiến, nên luôn kiểm chứng thông tin quan trọng.
Nội dung chính:
- LLM là gì? Hiểu qua gợi ý bàn phím điện thoại
- Mô hình ngôn ngữ lớn “lớn” cỡ nào?
- LLM đọc chữ bằng cách nào? Token và con số
- Transformer và attention: bộ não của LLM
- LLM được huấn luyện như thế nào?
- Khi bạn gõ câu hỏi, LLM trả lời ra sao?
- Giới hạn của LLM: ảo giác, kiến thức, thiên kiến
- LLM làm được gì trong đời sống và công việc?
- Những hiểu lầm phổ biến về LLM
- Cách dùng LLM hiệu quả và an toàn
- Câu hỏi thường gặp về LLM
- Kết luận
LLM là gì? Hiểu qua gợi ý bàn phím điện thoại
LLM là viết tắt của Large Language Model, tức mô hình ngôn ngữ lớn. “Mô hình” ở đây không phải mô hình đồ chơi, mà là một chương trình toán học học từ dữ liệu. “Ngôn ngữ” là thứ nó học. Còn “lớn” là quy mô, thứ mà ta sẽ bàn kỹ ở phần sau.
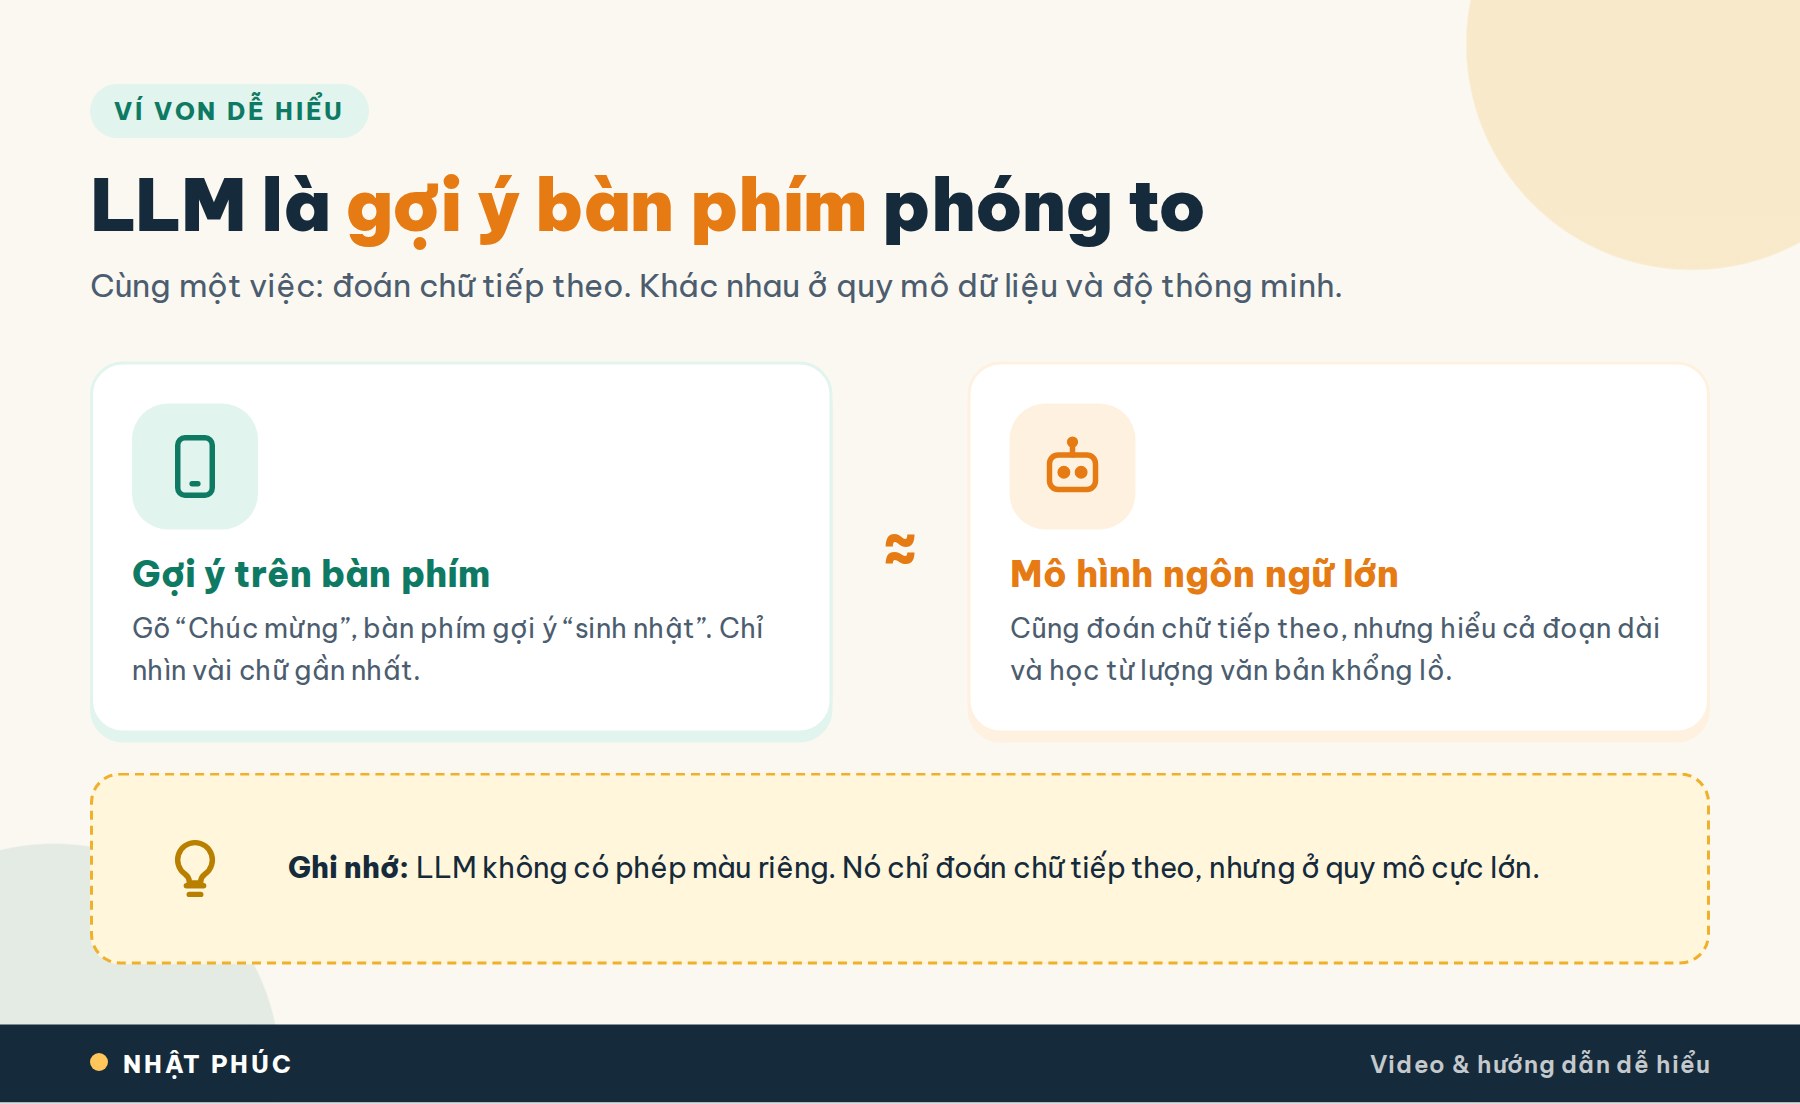
Cách dễ nhất để hiểu LLM là nghĩ đến chức năng gợi ý từ trên bàn phím điện thoại. Bạn gõ “Chúc mừng”, bàn phím gợi ý “sinh nhật”. Bạn gõ “Hẹn gặp”, nó gợi ý “lại”. Bàn phím làm được vậy vì đã thấy rất nhiều câu có cụm từ đó, nên nó biết chữ nào thường đi kèm.
Một LLM cũng làm đúng việc đó: dự đoán chữ tiếp theo. Điểm khác là quy mô lớn hơn hàng triệu lần. Bàn phím chỉ nhìn vài chữ gần nhất và học từ những gì bạn hay gõ. LLM thì nhìn cả đoạn văn dài, thậm chí cả cuộc hội thoại, và học từ lượng văn bản mà một người không thể đọc hết dù sống nhiều kiếp.
Vậy vì sao chỉ đoán chữ mà lại viết được thơ, sửa được code? Hãy thử nghĩ: để đoán đúng chữ tiếp theo trong một bài toán vật lý, mô hình phải “nắm” được phần nào kiến thức vật lý. Để đoán đúng dòng code tiếp theo, nó phải nắm được quy tắc lập trình. Khi bị ép đoán giỏi trên hàng nghìn tỷ ví dụ thuộc đủ mọi lĩnh vực, mô hình buộc phải học được rất nhiều thứ nằm ẩn bên dưới con chữ.
Mô hình ngôn ngữ lớn “lớn” cỡ nào?
Chữ “lớn” trong mô hình ngôn ngữ lớn có hai nghĩa: lớn về dữ liệu và lớn về cấu trúc bên trong.
Lớn về dữ liệu: hàng nghìn tỷ từ
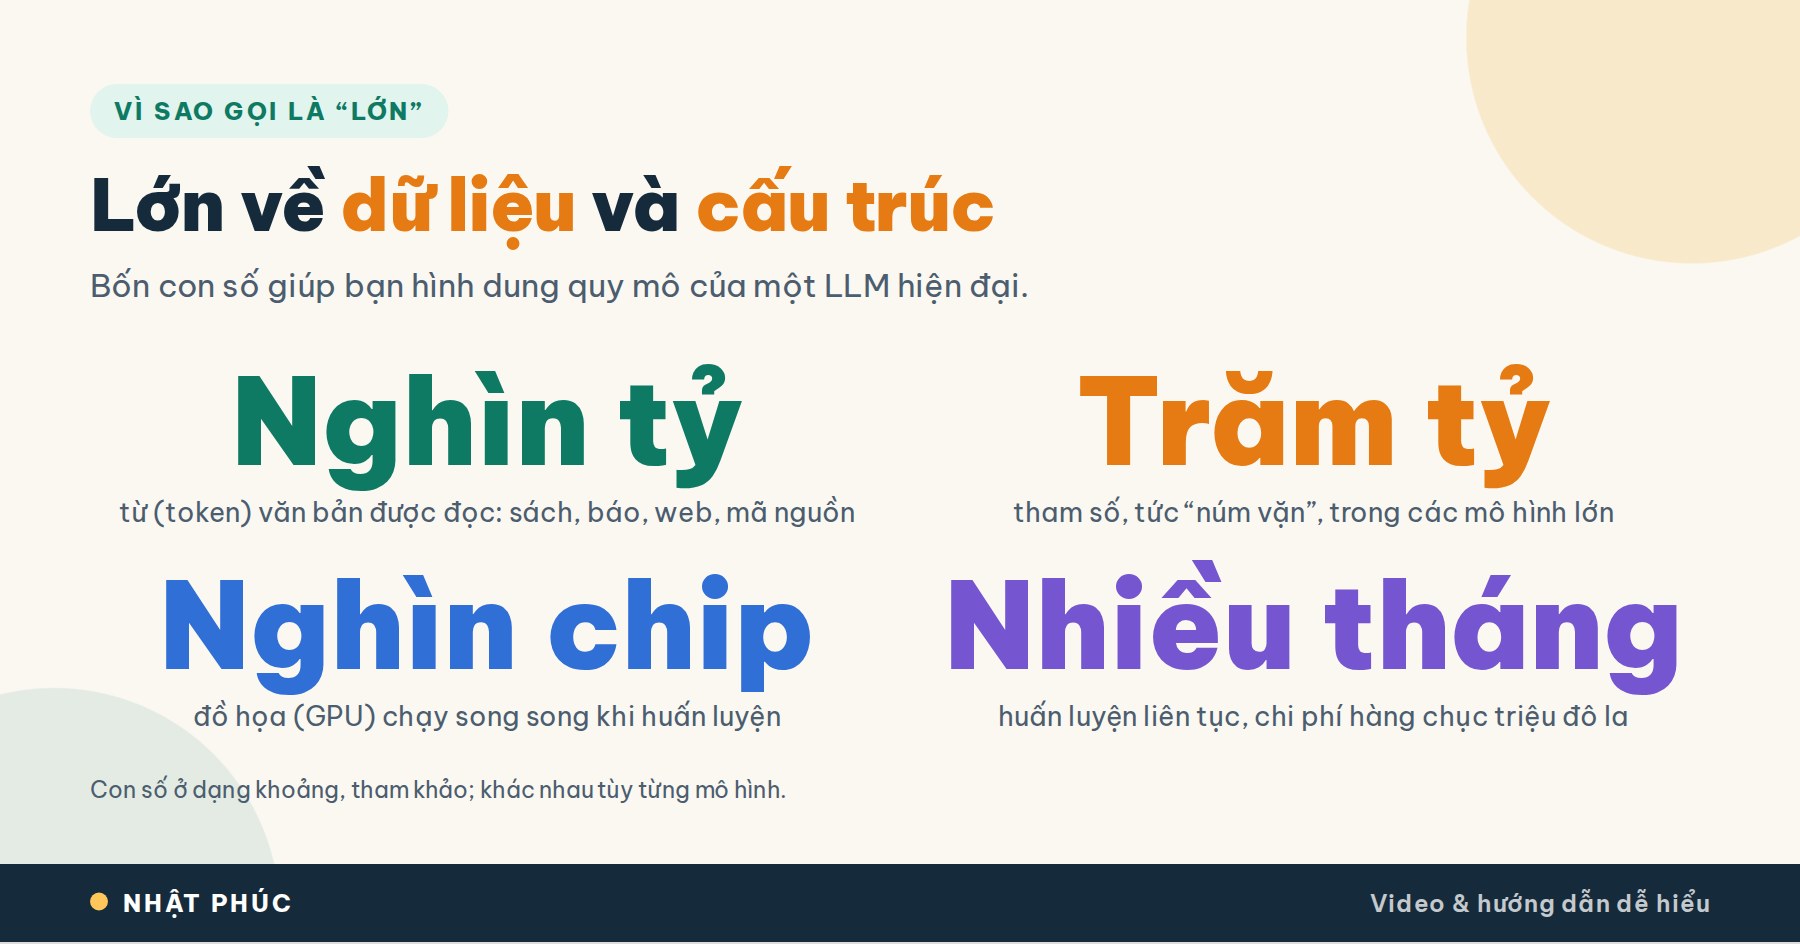
Một LLM được cho đọc lượng văn bản khổng lồ: sách, bài báo, trang web, mã nguồn, diễn đàn thảo luận. Con số lên đến hàng nghìn tỷ từ. Để dễ hình dung, một người ham đọc sách cả đời có lẽ chỉ đọc được vài nghìn cuốn. Lượng chữ mà LLM “đọc” nhiều hơn những gì một con người có thể đọc trong hàng nghìn kiếp sống.
Dữ liệu càng đa dạng, mô hình càng gặp nhiều cách diễn đạt, nhiều chủ đề, nhiều ngôn ngữ. Đó là lý do một LLM có thể chuyển từ viết email sang giải thích hóa học chỉ trong vài giây.
Lớn về cấu trúc: hàng trăm tỷ tham số
Bên trong LLM là một mạng nơ-ron (neural network), một cấu trúc toán học lấy cảm hứng rất lỏng lẻo từ cách các tế bào thần kinh kết nối. Mạng này có hàng chục, thậm chí hàng trăm tỷ tham số (parameters). Ví dụ quen thuộc: mô hình GPT-3 công bố năm 2020 có khoảng 175 tỷ tham số.
Tham số giống những núm vặn nhỏ xíu
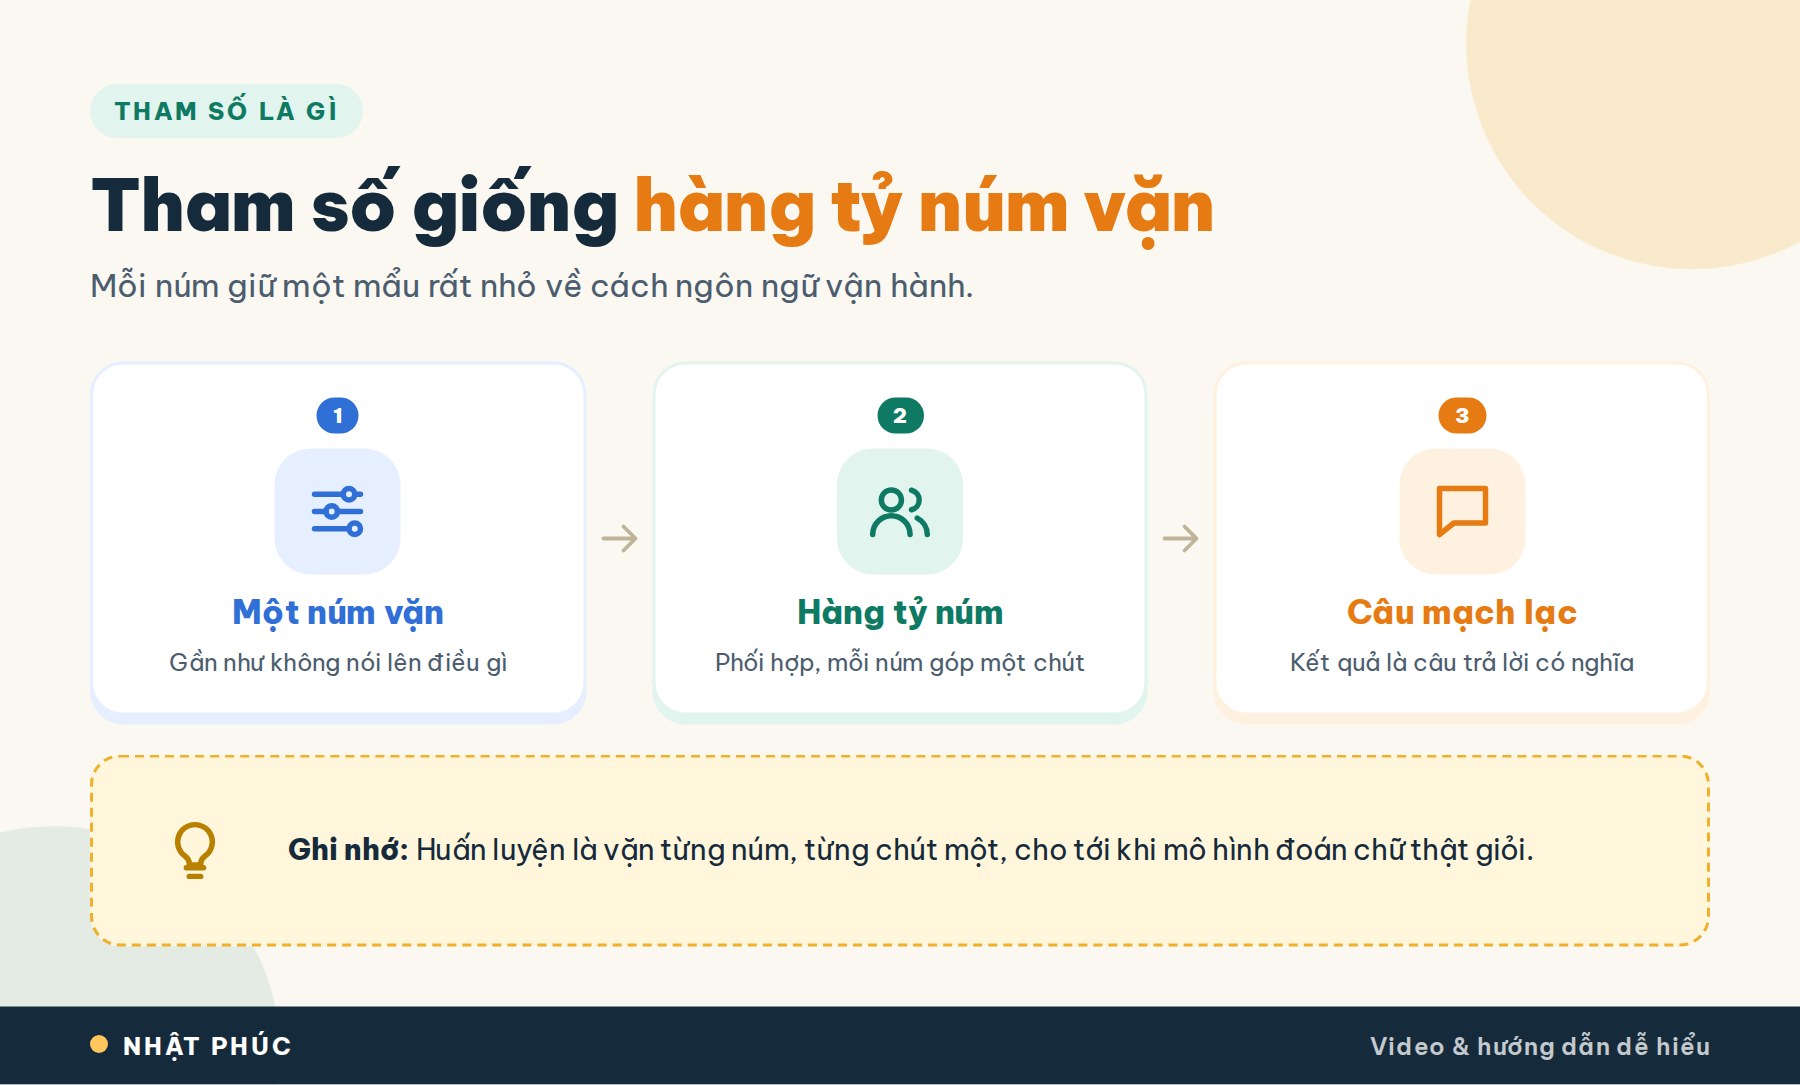
Bạn có thể hình dung tham số như những núm vặn nhỏ xíu trên một bàn điều khiển âm thanh khổng lồ. Mỗi núm lưu một mẩu rất nhỏ về cách ngôn ngữ vận hành. Một núm riêng lẻ gần như chẳng nói lên điều gì. Chỉ khi hàng tỷ núm vặn ấy phối hợp với nhau, mô hình mới tạo ra được câu trả lời mạch lạc.
Điều thú vị là không ai tự tay vặn các núm này. Chúng được điều chỉnh tự động trong quá trình huấn luyện, từng chút một, qua hàng nghìn tỷ lần đoán chữ.
LLM đọc chữ bằng cách nào? Token và con số
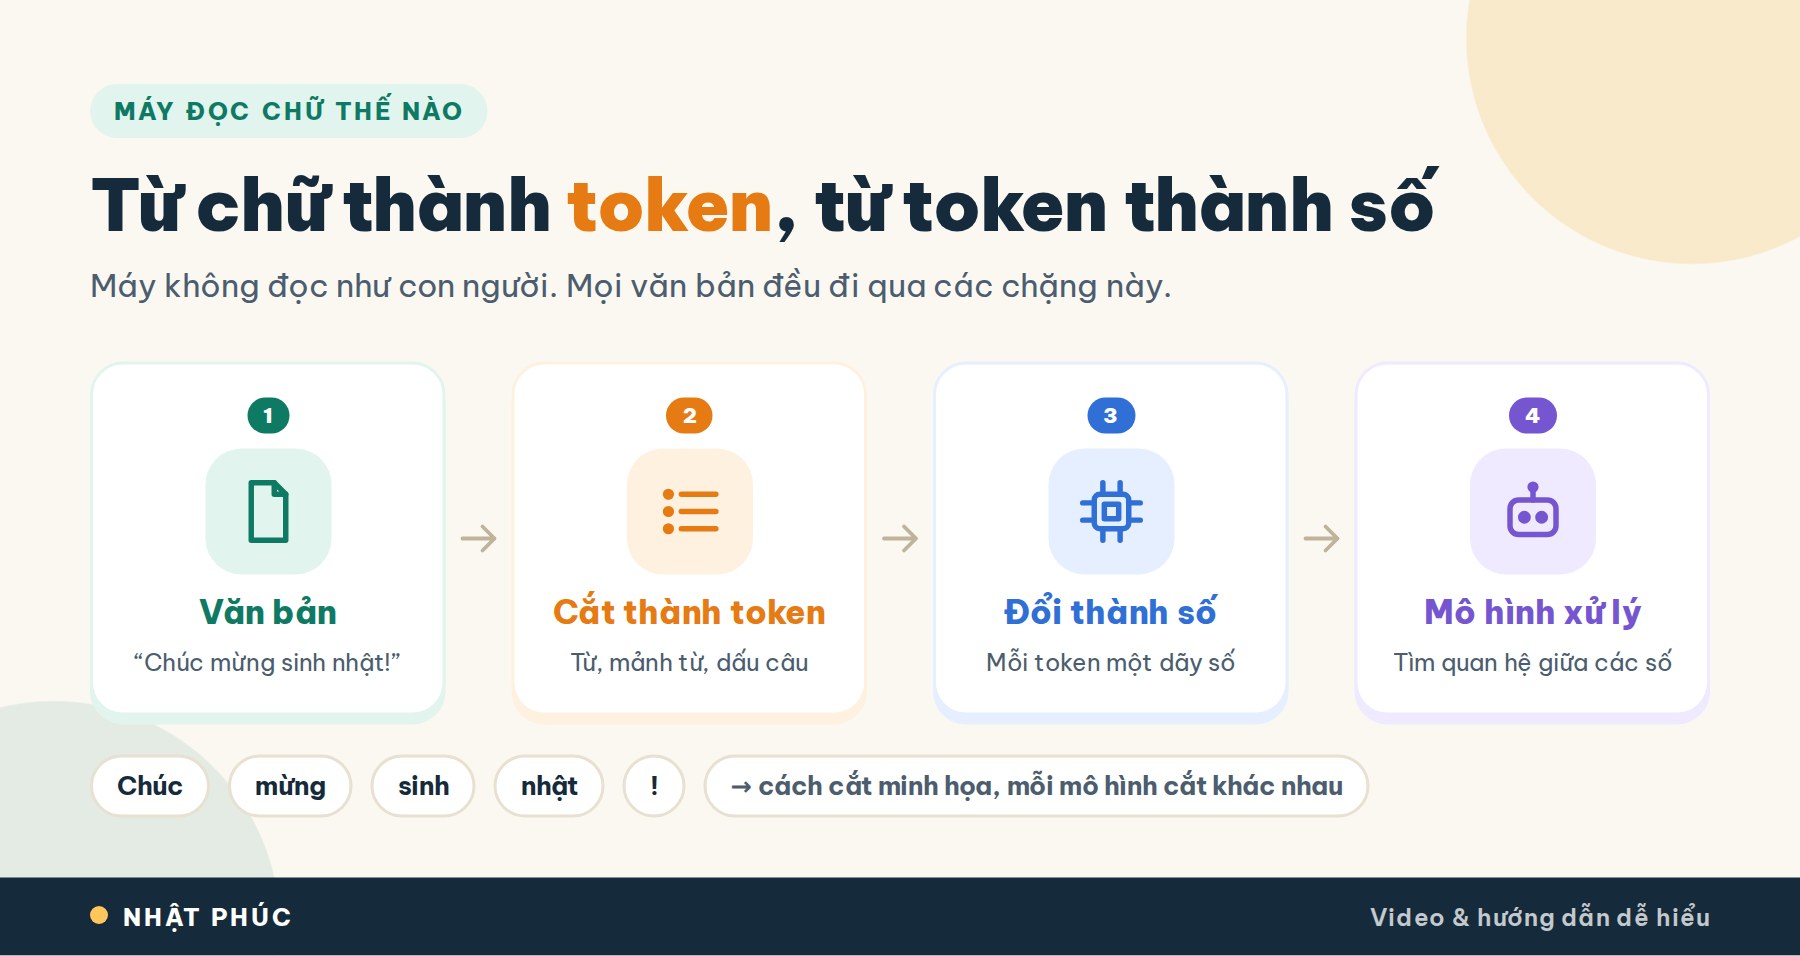
Máy không đọc chữ như chúng ta. Nó không “thấy” chữ cái hay âm thanh. Mọi thứ phải được chuyển thành số trước khi mô hình xử lý được. Quá trình này đi qua vài chặng.
Bước 1: Cắt văn bản thành token
Đầu tiên, văn bản được cắt thành những mảnh nhỏ gọi là token. Một token có thể là một từ trọn vẹn, một phần của từ, hoặc một dấu câu. Ví dụ, câu “Chúc mừng sinh nhật!” có thể được cắt thành “Chúc”, “mừng”, “sinh”, “nhật” và “!”. Mỗi mô hình có cách cắt riêng, nên cùng một câu có thể ra số token khác nhau.
Với tiếng Anh, một token thường tương đương khoảng ba phần tư từ. Tiếng Việt có dấu, nên tùy mô hình, một câu tiếng Việt thường tốn nhiều token hơn câu tiếng Anh cùng độ dài. Đây cũng là lý do các dịch vụ AI tính phí và giới hạn độ dài theo token chứ không theo chữ.
Bước 2: Đổi mỗi token thành một dãy số
Sau đó, mỗi token được chuyển thành một dãy số, giới chuyên môn gọi là embedding hay vector. Với máy, ngôn ngữ chỉ là những con số, và ý nghĩa nằm ở mối quan hệ giữa các con số ấy.
Từ gần nghĩa thì nằm gần nhau
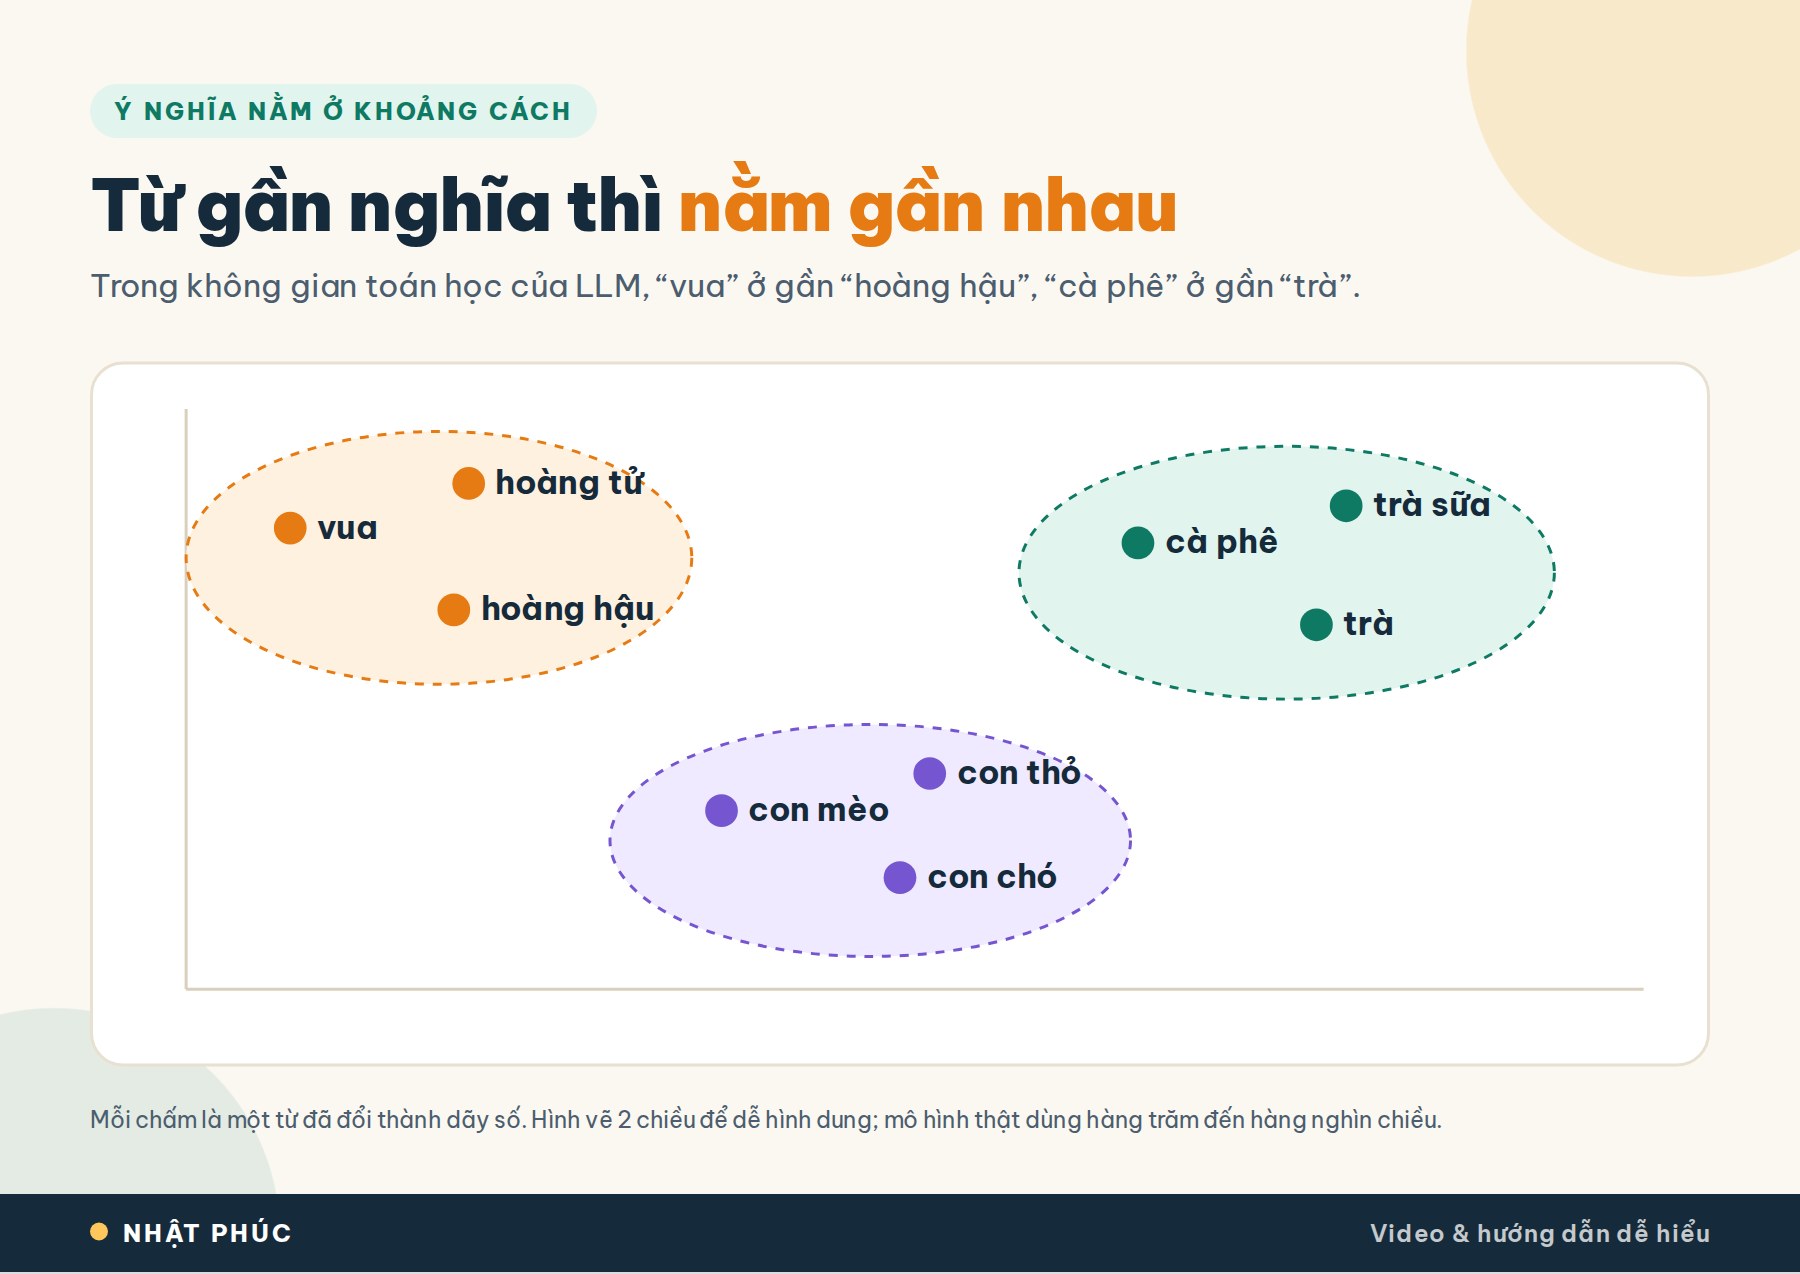
Hãy tưởng tượng mỗi từ là một chấm trên bản đồ. Những từ có nghĩa gần nhau sẽ nằm gần nhau trong không gian toán học đó. “Vua” nằm gần “hoàng hậu”. “Cà phê” nằm gần “trà”. “Con mèo” nằm gần “con chó”. Còn “vua” và “cà phê” thì ở rất xa nhau.
Bản đồ thật của LLM không phải hai chiều như tờ giấy, mà có hàng trăm đến hàng nghìn chiều. Nhờ vậy, nó lưu được rất nhiều sắc thái: số ít hay số nhiều, trang trọng hay suồng sã, tích cực hay tiêu cực. Đó là cách máy bắt đầu “hiểu” về thế giới, không phải qua định nghĩa trong từ điển, mà qua vị trí tương đối giữa các khái niệm.
Transformer và attention: bộ não của LLM
Có token và con số rồi, mô hình cần một “bộ não” để xử lý chúng. Bộ não thực sự của LLM là kiến trúc Transformer, được nhóm nghiên cứu của Google giới thiệu năm 2017 trong bài báo nổi tiếng mang tên Attention Is All You Need. Chữ “T” trong GPT chính là Transformer.
Attention là gì?
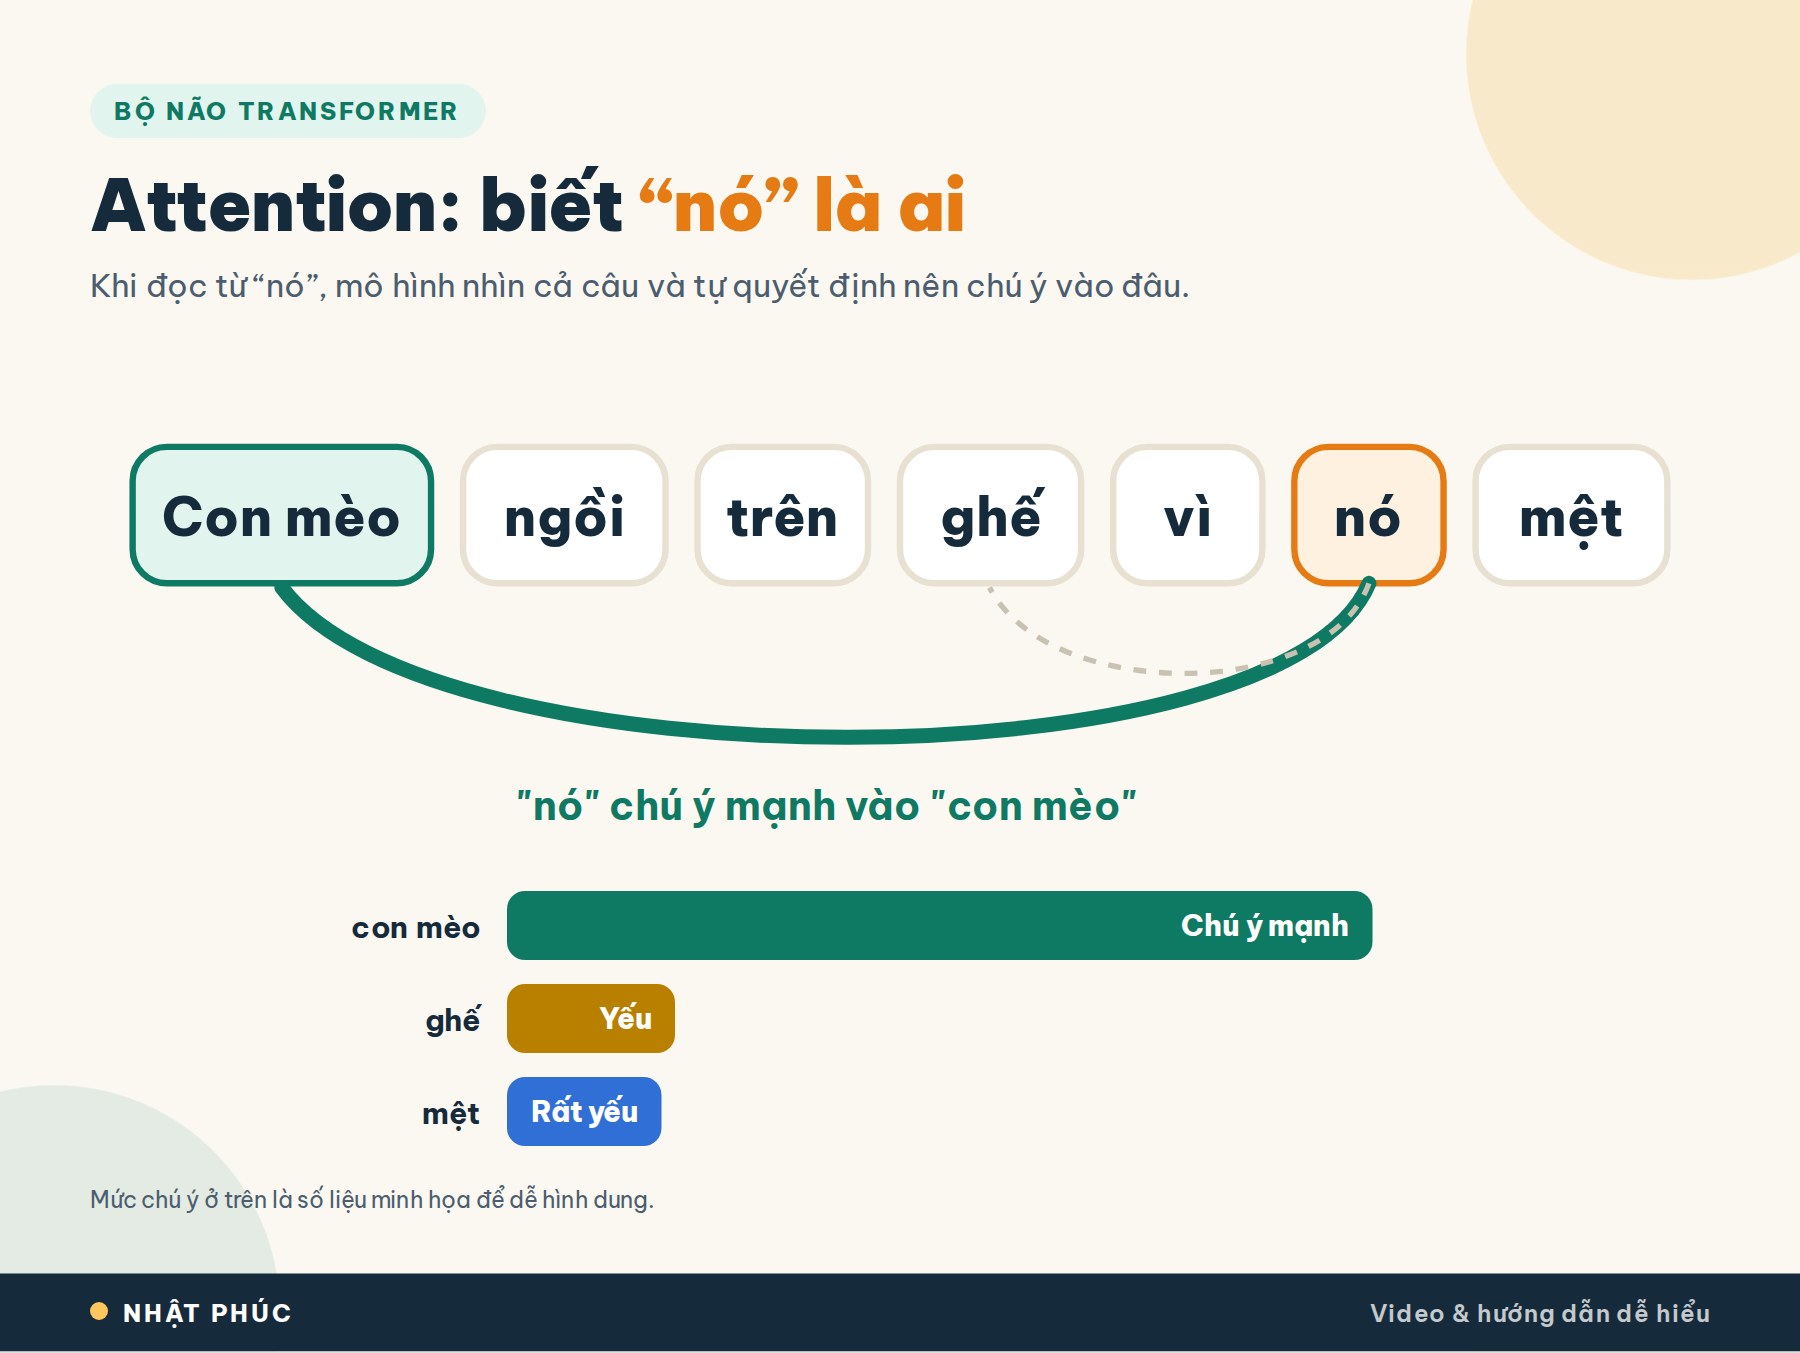
Trái tim của Transformer là cơ chế attention, hay sự chú ý. Hãy xem câu: “Con mèo ngồi trên ghế vì nó mệt.” Đọc đến chữ “nó”, bạn biết ngay “nó” là con mèo chứ không phải cái ghế, vì ghế thì không biết mệt.
Mô hình cũng phải làm được điều đó. Attention cho phép mô hình nhìn toàn bộ câu cùng lúc và tự quyết định từ nào quan trọng với từ nào. Khi xử lý “nó”, mô hình dồn sự chú ý mạnh vào “con mèo”, chú ý rất ít vào “ghế”.
Vì sao Transformer tạo ra bước nhảy vọt?
Trước Transformer, nhiều mô hình ngôn ngữ đọc chữ lần lượt từ trái sang phải, giống người đọc từng chữ một và dễ quên phần đầu khi câu quá dài. Transformer nhìn mọi token trong đoạn cùng lúc. Nhờ vậy, nó vừa nắm được liên hệ xa trong văn bản, vừa tận dụng tốt khả năng tính toán song song của chip đồ họa (GPU). Hai điều này mở đường cho việc huấn luyện những mô hình cực lớn.
Một LLM thực tế xếp chồng nhiều lớp Transformer lên nhau. Lớp đầu nắm các quan hệ đơn giản như ngữ pháp, lớp sau tổng hợp thành ý nghĩa phức tạp hơn. Bạn có thể ví như một dây chuyền: mỗi trạm tinh chỉnh thêm một chút hiểu biết về câu văn.
Lượng văn bản mà mô hình nhìn được cùng lúc gọi là cửa sổ ngữ cảnh (context window), tính bằng token. Cửa sổ càng lớn, mô hình càng “nhớ” được nhiều nội dung trong cuộc trò chuyện hoặc tài liệu bạn đưa vào.
LLM được huấn luyện như thế nào?
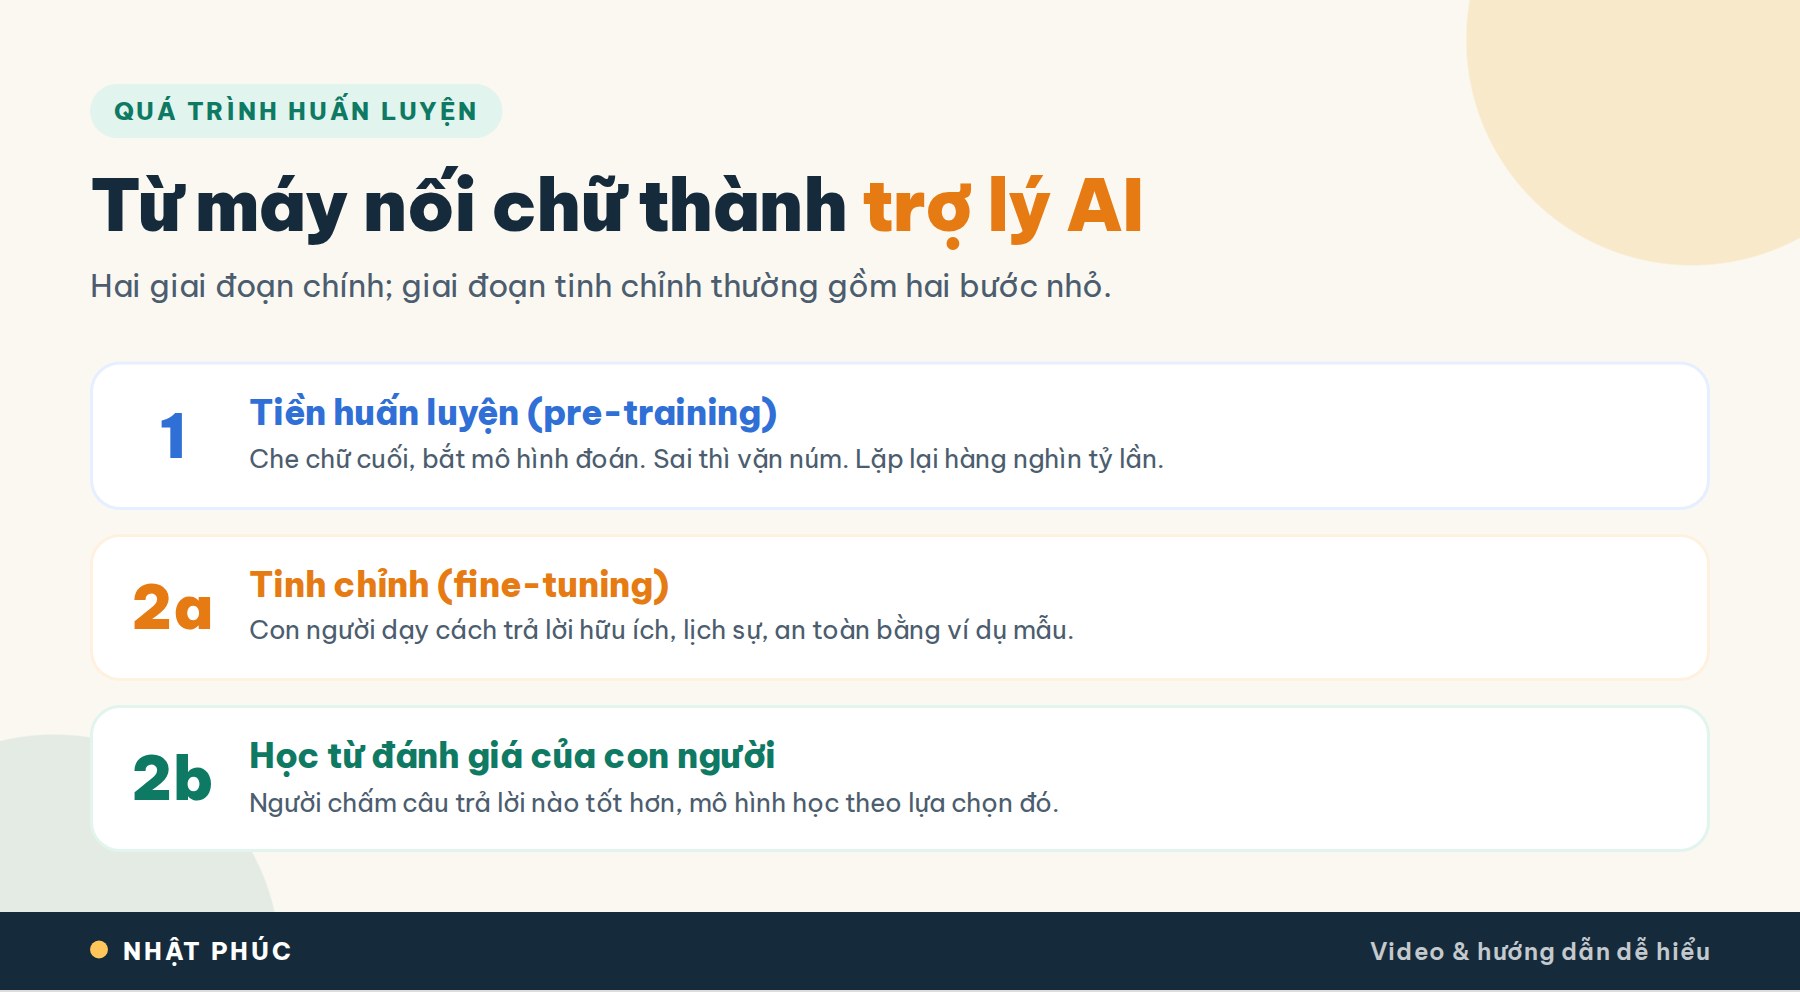
Có bộ não rồi, giờ phải dạy nó. Quá trình huấn luyện LLM gồm hai giai đoạn chính.
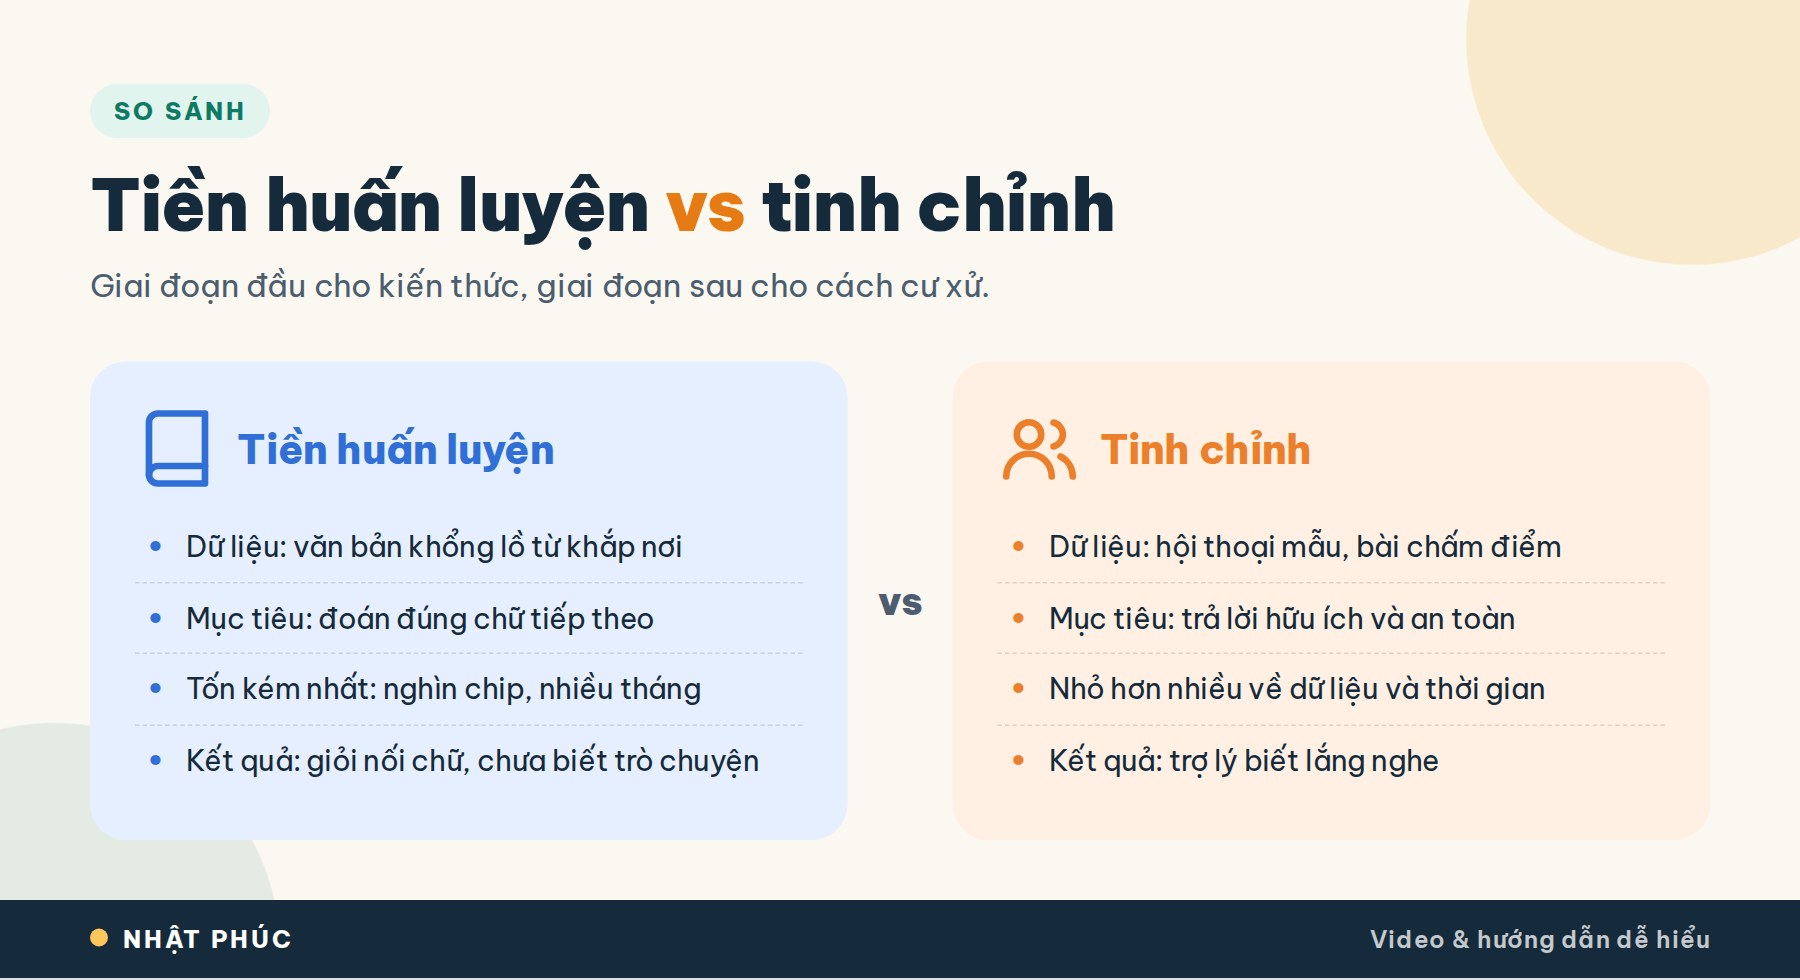
Giai đoạn 1: Tiền huấn luyện (pre-training)
Mô hình được cho xem một đoạn văn bản bị che mất chữ cuối, rồi phải đoán chữ đó. Ví dụ: “Thủ đô của Việt Nam là ___”. Đoán sai thì các núm vặn được điều chỉnh một chút theo hướng giúp lần sau đoán đúng hơn. Việc này lặp lại hàng nghìn tỷ lần, chạy trên hàng nghìn chip đồ họa trong nhiều tháng, tốn hàng chục triệu đô la.
Điều hay là không cần người ngồi dán nhãn từng câu. Bản thân văn bản đã chứa đáp án: chữ bị che chính là chữ đúng. Nhờ vậy, mô hình học được từ khối dữ liệu khổng lồ.
Sau giai đoạn này, mô hình đã nắm ngữ pháp, kiến thức, thậm chí cả cách suy luận. Nhưng nó vẫn chỉ biết nối chữ, chưa biết trò chuyện. Hỏi nó “Làm sao nấu phở?”, nó có thể viết tiếp thành “Làm sao nấu bún bò? Làm sao nấu hủ tiếu?” như một danh sách câu hỏi trên diễn đàn, thay vì trả lời bạn.
Giai đoạn 2: Tinh chỉnh (fine-tuning)
Ở giai đoạn này, con người dạy mô hình cách trả lời hữu ích, lịch sự và an toàn. Thường có hai bước nhỏ. Đầu tiên, mô hình học từ nhiều đoạn hội thoại mẫu do người viết, để biết thế nào là một câu trả lời đúng kiểu trợ lý.
Tiếp theo, mô hình đưa ra nhiều câu trả lời khác nhau cho cùng một câu hỏi, rồi con người chấm xem câu nào tốt hơn. Mô hình học theo những lựa chọn đó. Kỹ thuật này thường được gọi là học tăng cường từ phản hồi của con người (RLHF). Nhờ vậy, từ một cỗ máy nối chữ, nó trở thành một trợ lý biết lắng nghe.
Bảng dưới đây so sánh hai giai đoạn để bạn dễ hình dung:
| Tiêu chí | Tiền huấn luyện | Tinh chỉnh |
|---|---|---|
| Dữ liệu | Văn bản khổng lồ từ sách, web, mã nguồn | Hội thoại mẫu và bài chấm điểm của con người |
| Mục tiêu | Đoán đúng chữ tiếp theo | Trả lời hữu ích, lịch sự, an toàn |
| Chi phí | Rất lớn: nghìn chip, nhiều tháng | Nhỏ hơn nhiều |
| Kết quả | Giỏi nối chữ, chưa biết trò chuyện | Trợ lý biết lắng nghe |
Khi bạn gõ câu hỏi, LLM trả lời ra sao?
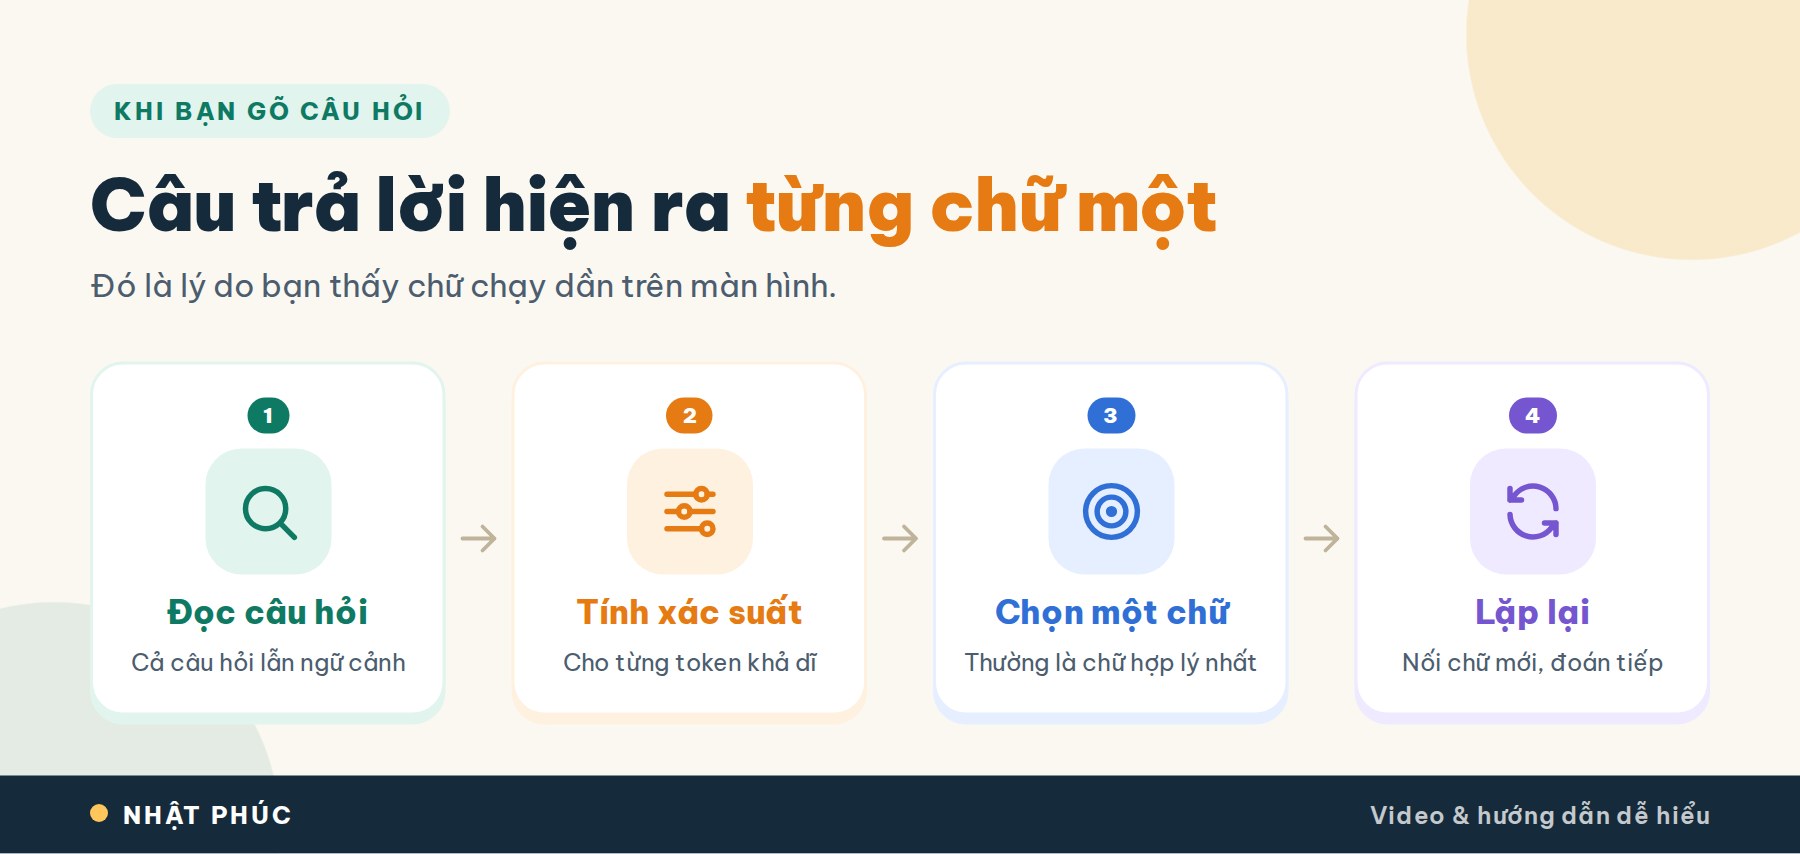
Bây giờ đến phần bạn trực tiếp nhìn thấy mỗi ngày. Khi bạn gõ một câu hỏi, mô hình làm bốn việc lặp đi lặp lại:
- Đọc câu hỏi, cùng với phần hội thoại phía trước nếu có.
- Tính xác suất cho từng chữ (token) có thể xuất hiện tiếp theo.
- Chọn một chữ.
- Gắn chữ đó vào cuối, rồi lặp lại từ đầu để đoán chữ kế tiếp.
Từng chữ một, câu trả lời hiện ra trước mắt bạn. Đó là lý do bạn thấy chữ chạy dần trên màn hình, chứ không phải mô hình viết xong rồi mới hiện ra cả đoạn.
Vì sao hỏi cùng một câu lại có câu trả lời khác nhau?
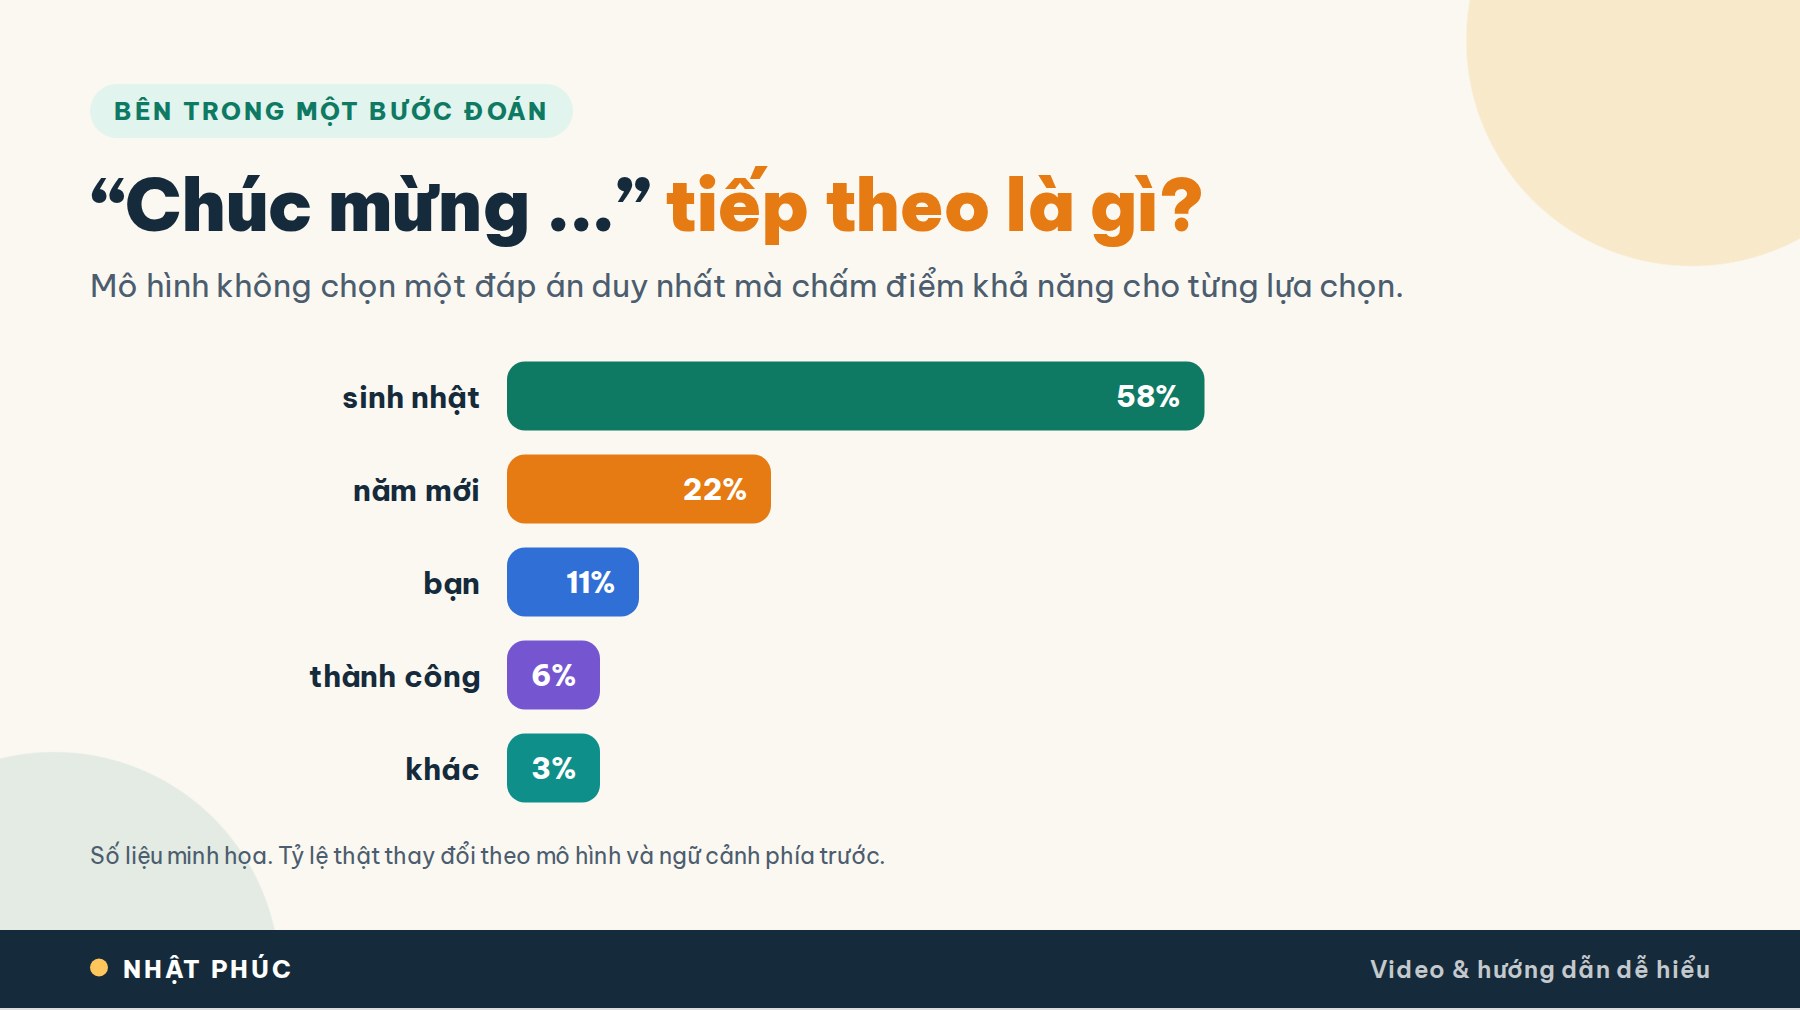
Ở bước chọn chữ, mô hình không nhất thiết lấy chữ có xác suất cao nhất. Với “Chúc mừng ___”, “sinh nhật” có thể có khả năng cao nhất, nhưng “năm mới” hay “thành công” vẫn có cơ hội. Mức độ “chịu chọn chữ ít phổ biến hơn” được điều chỉnh bằng một thông số thường gọi là nhiệt độ (temperature).
Nhiệt độ thấp cho câu trả lời ổn định, ít bất ngờ, hợp với tra cứu hay viết code. Nhiệt độ cao cho câu trả lời đa dạng, sáng tạo hơn, hợp với làm thơ hay lên ý tưởng. Đó là lý do bạn hỏi lại cùng một câu mà nhận được cách diễn đạt khác.
Giới hạn của LLM: ảo giác, kiến thức, thiên kiến
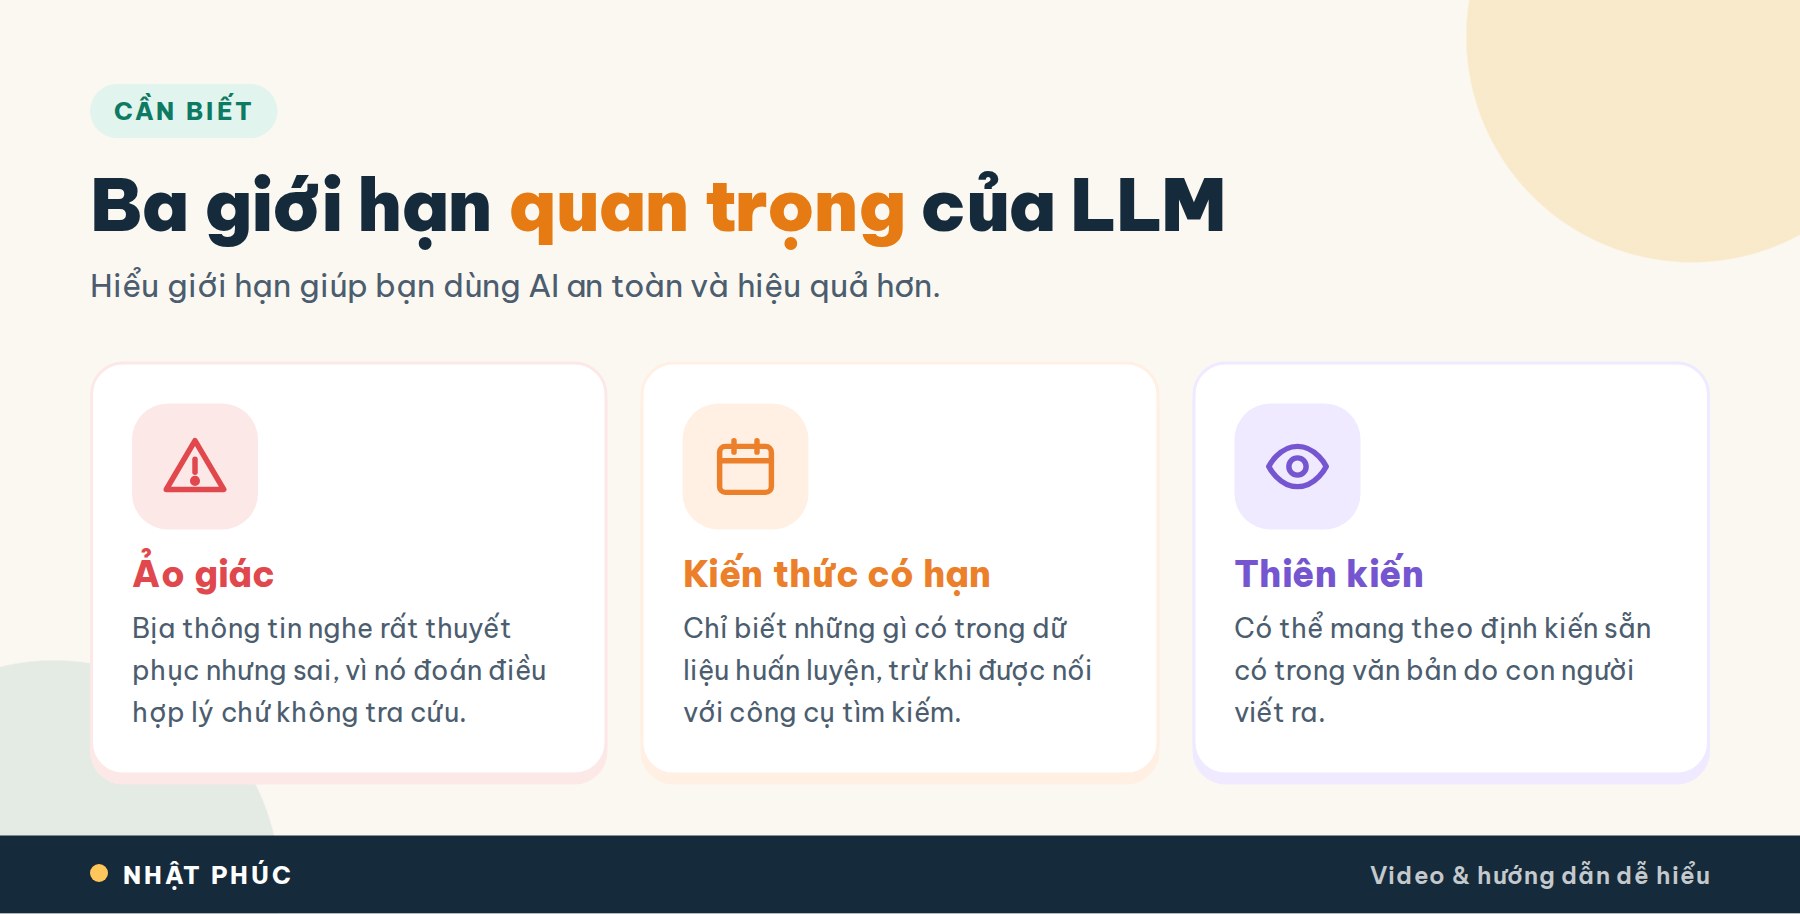
Hiểu cách LLM hoạt động cũng giúp bạn hiểu vì sao nó có lúc sai. Có ba giới hạn quan trọng bạn nên biết.
Ảo giác (hallucination)
Có một điều bạn cần nhớ: LLM không tra cứu sự thật. Nó dự đoán điều nghe hợp lý nhất. Vì vậy, đôi khi nó bịa ra thông tin nghe rất thuyết phục nhưng hoàn toàn sai: một cuốn sách không tồn tại, một con số thống kê không có nguồn, một điều luật không có thật. Giới chuyên môn gọi hiện tượng này là ảo giác, hay hallucination.
Ảo giác nguy hiểm ở chỗ giọng văn vẫn tự tin, mạch lạc như khi nó nói đúng. Bạn không thể dựa vào độ “chắc nịch” của câu trả lời để đánh giá độ chính xác. Đây là lý do bạn luôn nên kiểm chứng những thông tin quan trọng.
Kiến thức có hạn
Mô hình chỉ biết những gì nằm trong dữ liệu huấn luyện, vốn dừng lại ở một thời điểm nhất định. Nó không tự biết tin tức mới, trừ khi được kết nối với công cụ tìm kiếm hoặc được bạn cung cấp tài liệu. Nhiều trợ lý AI hiện nay đã có tính năng tìm kiếm web, nhưng bạn vẫn nên để ý xem câu trả lời có dẫn nguồn hay không.
Thiên kiến
Dữ liệu huấn luyện do con người viết ra, nên mô hình có thể mang theo những thiên kiến có sẵn trong đó: định kiến về giới, vùng miền, nghề nghiệp. Các nhà phát triển cố gắng giảm bớt ở giai đoạn tinh chỉnh, nhưng không thể loại bỏ hoàn toàn.
Bảng sau giúp bạn phân biệt LLM với công cụ tìm kiếm quen thuộc, để biết nên dùng cái nào cho việc gì:
| Tiêu chí | LLM (trợ lý AI) | Công cụ tìm kiếm |
|---|---|---|
| Cách hoạt động | Tạo câu trả lời mới bằng cách đoán chữ | Tìm và liệt kê trang web có sẵn |
| Điểm mạnh | Giải thích, tóm tắt, viết, dịch theo yêu cầu | Dẫn tới nguồn gốc, tin tức mới |
| Rủi ro | Có thể bịa thông tin nghe hợp lý | Nguồn kém chất lượng, phải tự lọc |
| Nên dùng khi | Cần hiểu, diễn đạt hoặc xử lý văn bản | Cần dữ kiện mới, nguồn kiểm chứng |
LLM làm được gì trong đời sống và công việc?
Dù có giới hạn, sức mạnh của LLM là có thật. Cùng một mô hình có thể tóm tắt tài liệu, dịch thuật, viết mã, soạn email, giải thích bài toán khó. Chưa từng có một công cụ nào linh hoạt đến vậy.
- Học tập: giải thích lại khái niệm khó bằng ví dụ đời thường, tạo câu hỏi ôn tập, kiểm tra cách bạn hiểu bài.
- Công việc văn phòng: tóm tắt biên bản họp, soạn nháp email, viết lại đoạn văn cho rõ ràng hơn.
- Lập trình: gợi ý code, giải thích đoạn code lạ, tìm nguyên nhân lỗi.
- Sáng tạo nội dung: lên dàn ý, gợi ý tiêu đề, viết kịch bản nháp.
- Ngôn ngữ: dịch, sửa ngữ pháp, chuyển giọng văn trang trọng sang thân mật và ngược lại.
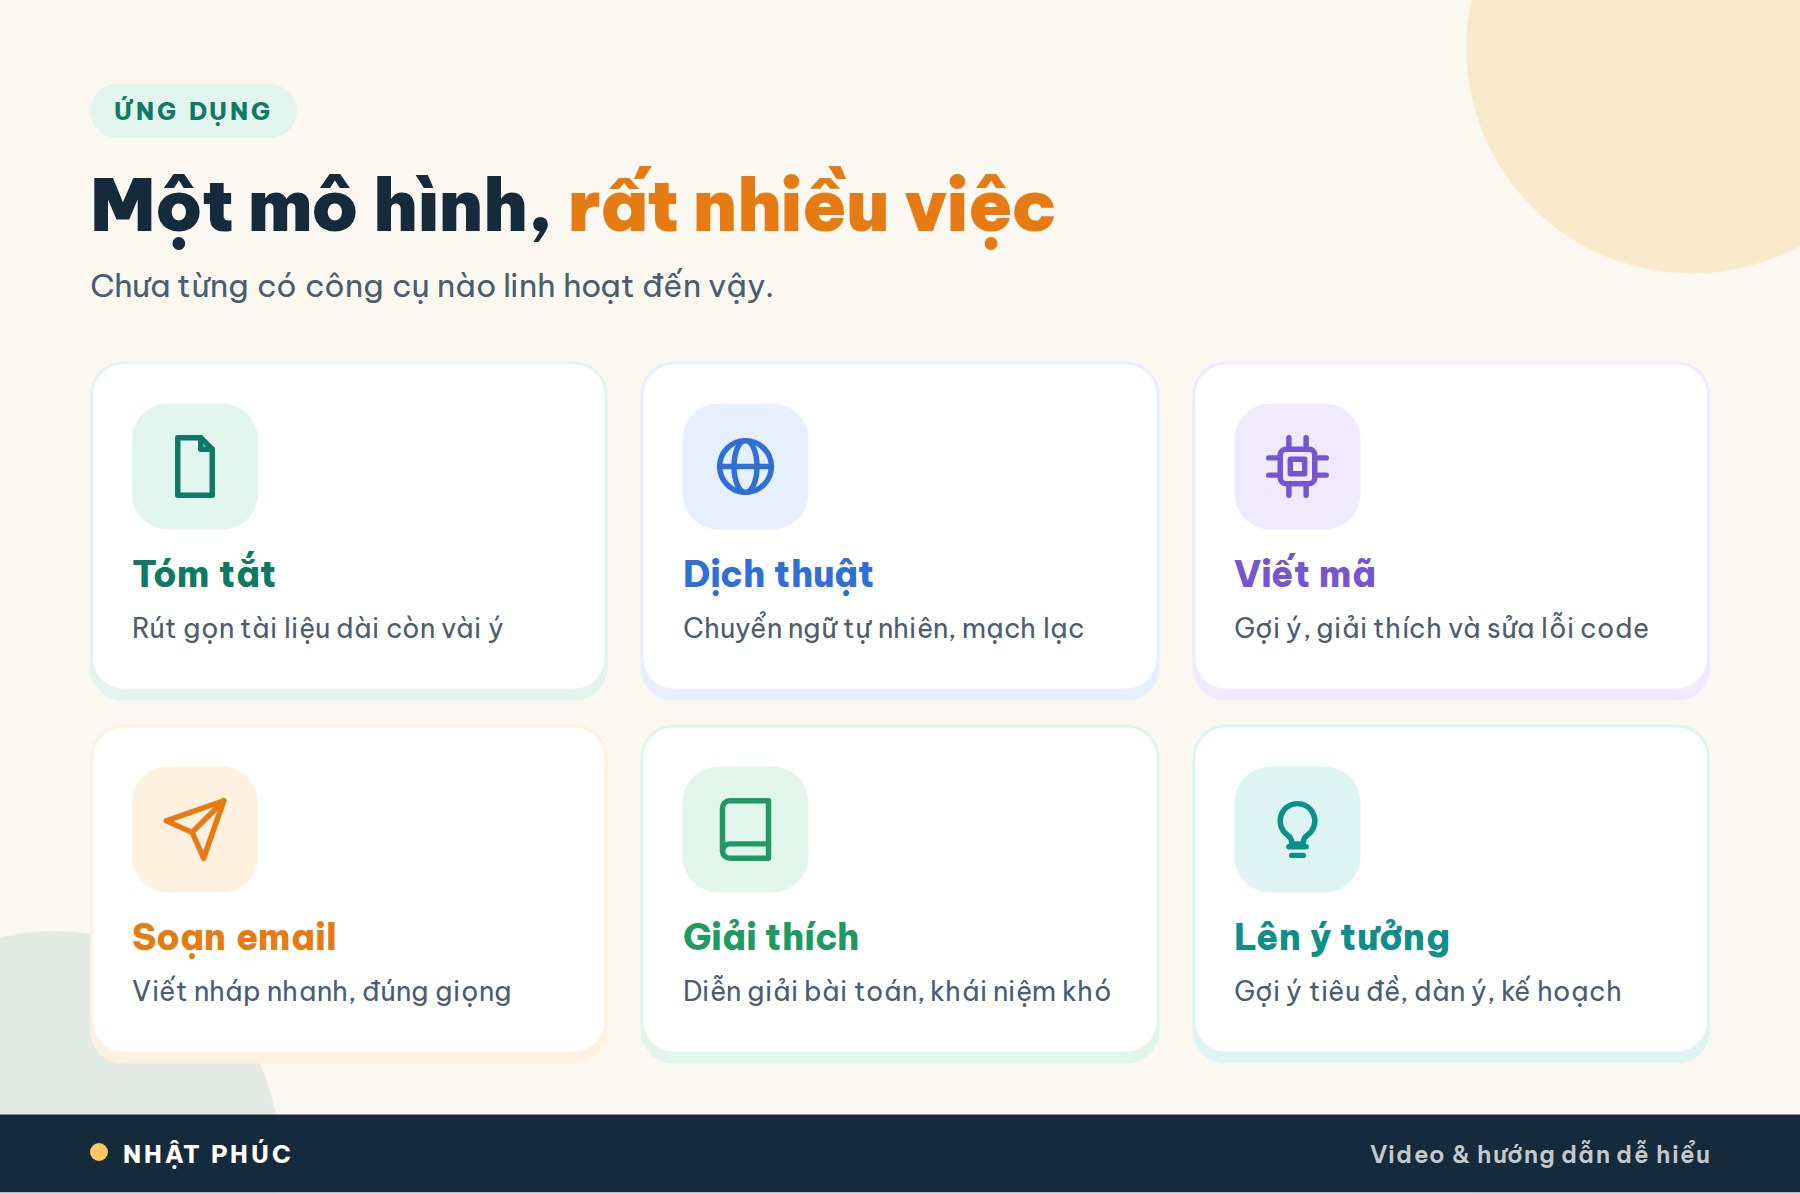
Điểm chung của các việc trên là đều xoay quanh ngôn ngữ. LLM mạnh nhất khi bạn cần hiểu, diễn đạt hay biến đổi văn bản. Với việc cần độ chính xác tuyệt đối như tính toán tài chính, chẩn đoán bệnh hay tư vấn pháp lý, hãy coi nó là trợ lý gợi ý, còn quyết định cuối cùng vẫn thuộc về con người và chuyên gia.
Những hiểu lầm phổ biến về LLM
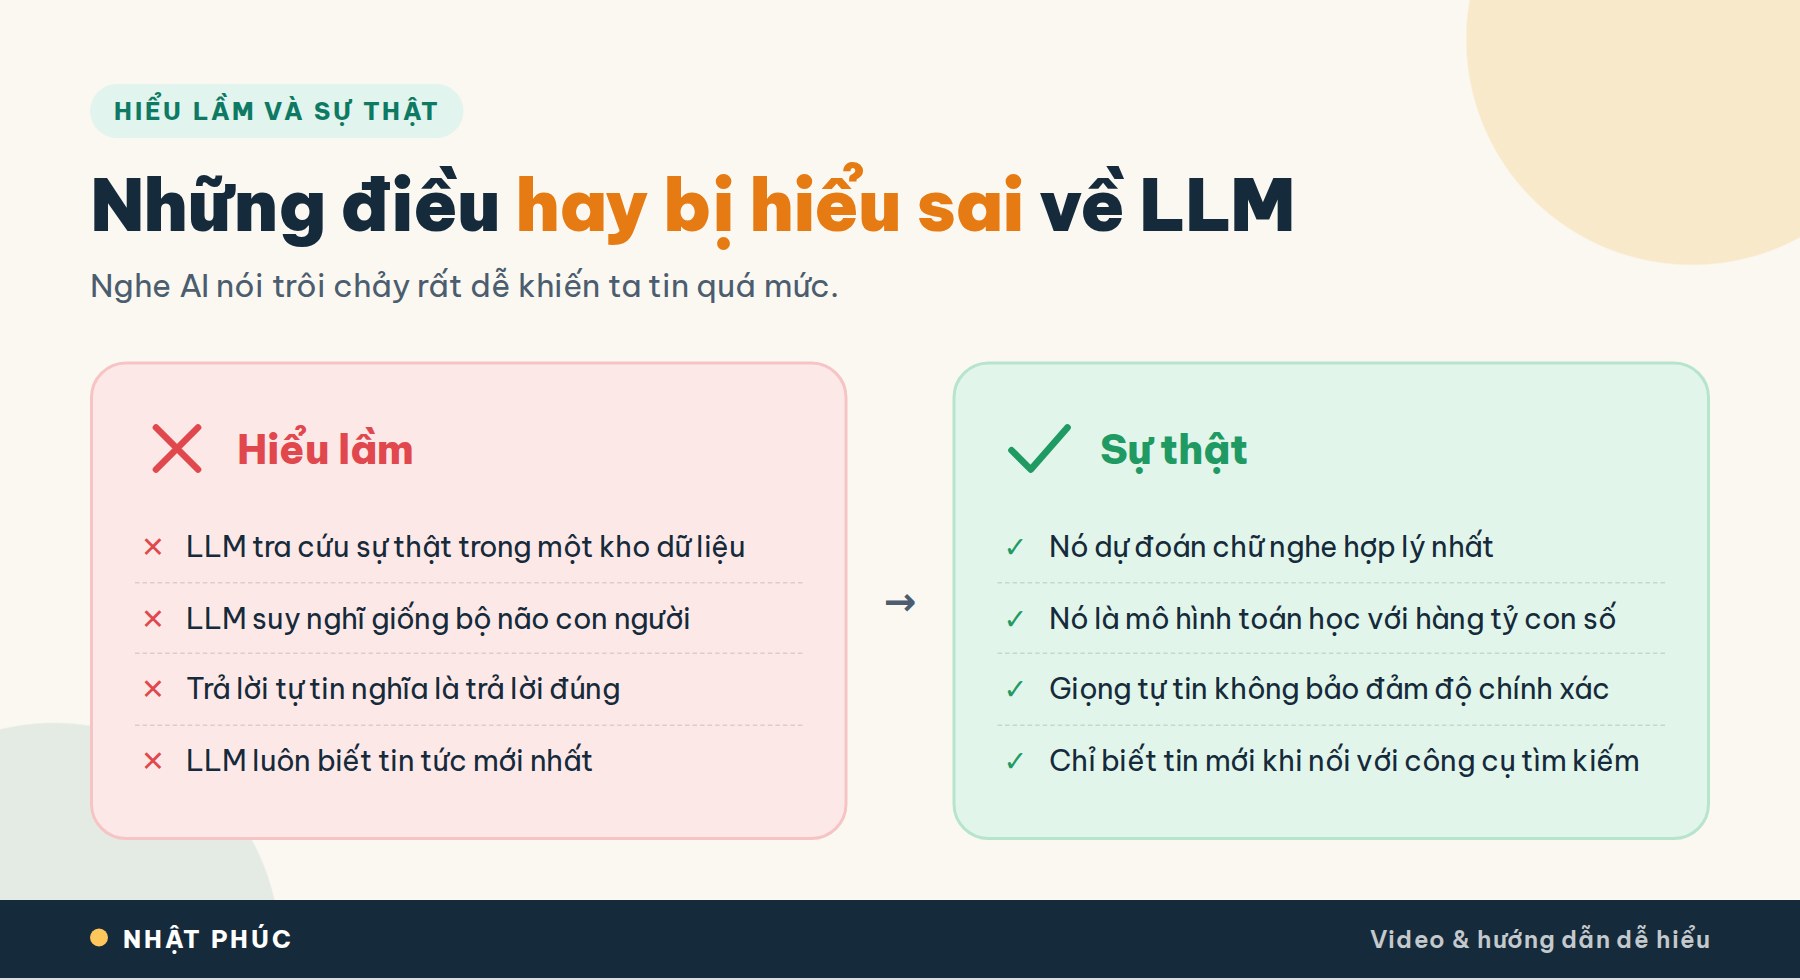
Vì AI nói chuyện trôi chảy như người, chúng ta rất dễ hiểu sai về nó. Dưới đây là những hiểu lầm hay gặp nhất.
Hiểu lầm 1: LLM tra cứu sự thật trong một kho dữ liệu
Thực tế, mô hình không mở một cuốn bách khoa toàn thư nào khi trả lời. Kiến thức được “nén” vào hàng tỷ tham số, và câu trả lời là kết quả của việc đoán chữ nghe hợp lý nhất.
Hiểu lầm 2: LLM suy nghĩ giống bộ não con người
Mạng nơ-ron chỉ lấy cảm hứng rất lỏng lẻo từ não bộ. LLM là một mô hình toán học khổng lồ với hàng tỷ con số. Nó không phải phép màu, cũng không phải bộ não con người.
Hiểu lầm 3: Trả lời tự tin nghĩa là trả lời đúng
Giọng điệu tự tin là kết quả của việc học cách viết trôi chảy, không phải bằng chứng của sự chính xác. Câu trả lời sai vẫn có thể rất chắc nịch.
Hiểu lầm 4: LLM luôn biết tin tức mới nhất
Mô hình chỉ biết tới thời điểm dữ liệu huấn luyện dừng lại. Muốn có thông tin mới, nó cần được nối với công cụ tìm kiếm hoặc được bạn đưa tài liệu.
Cách dùng LLM hiệu quả và an toàn
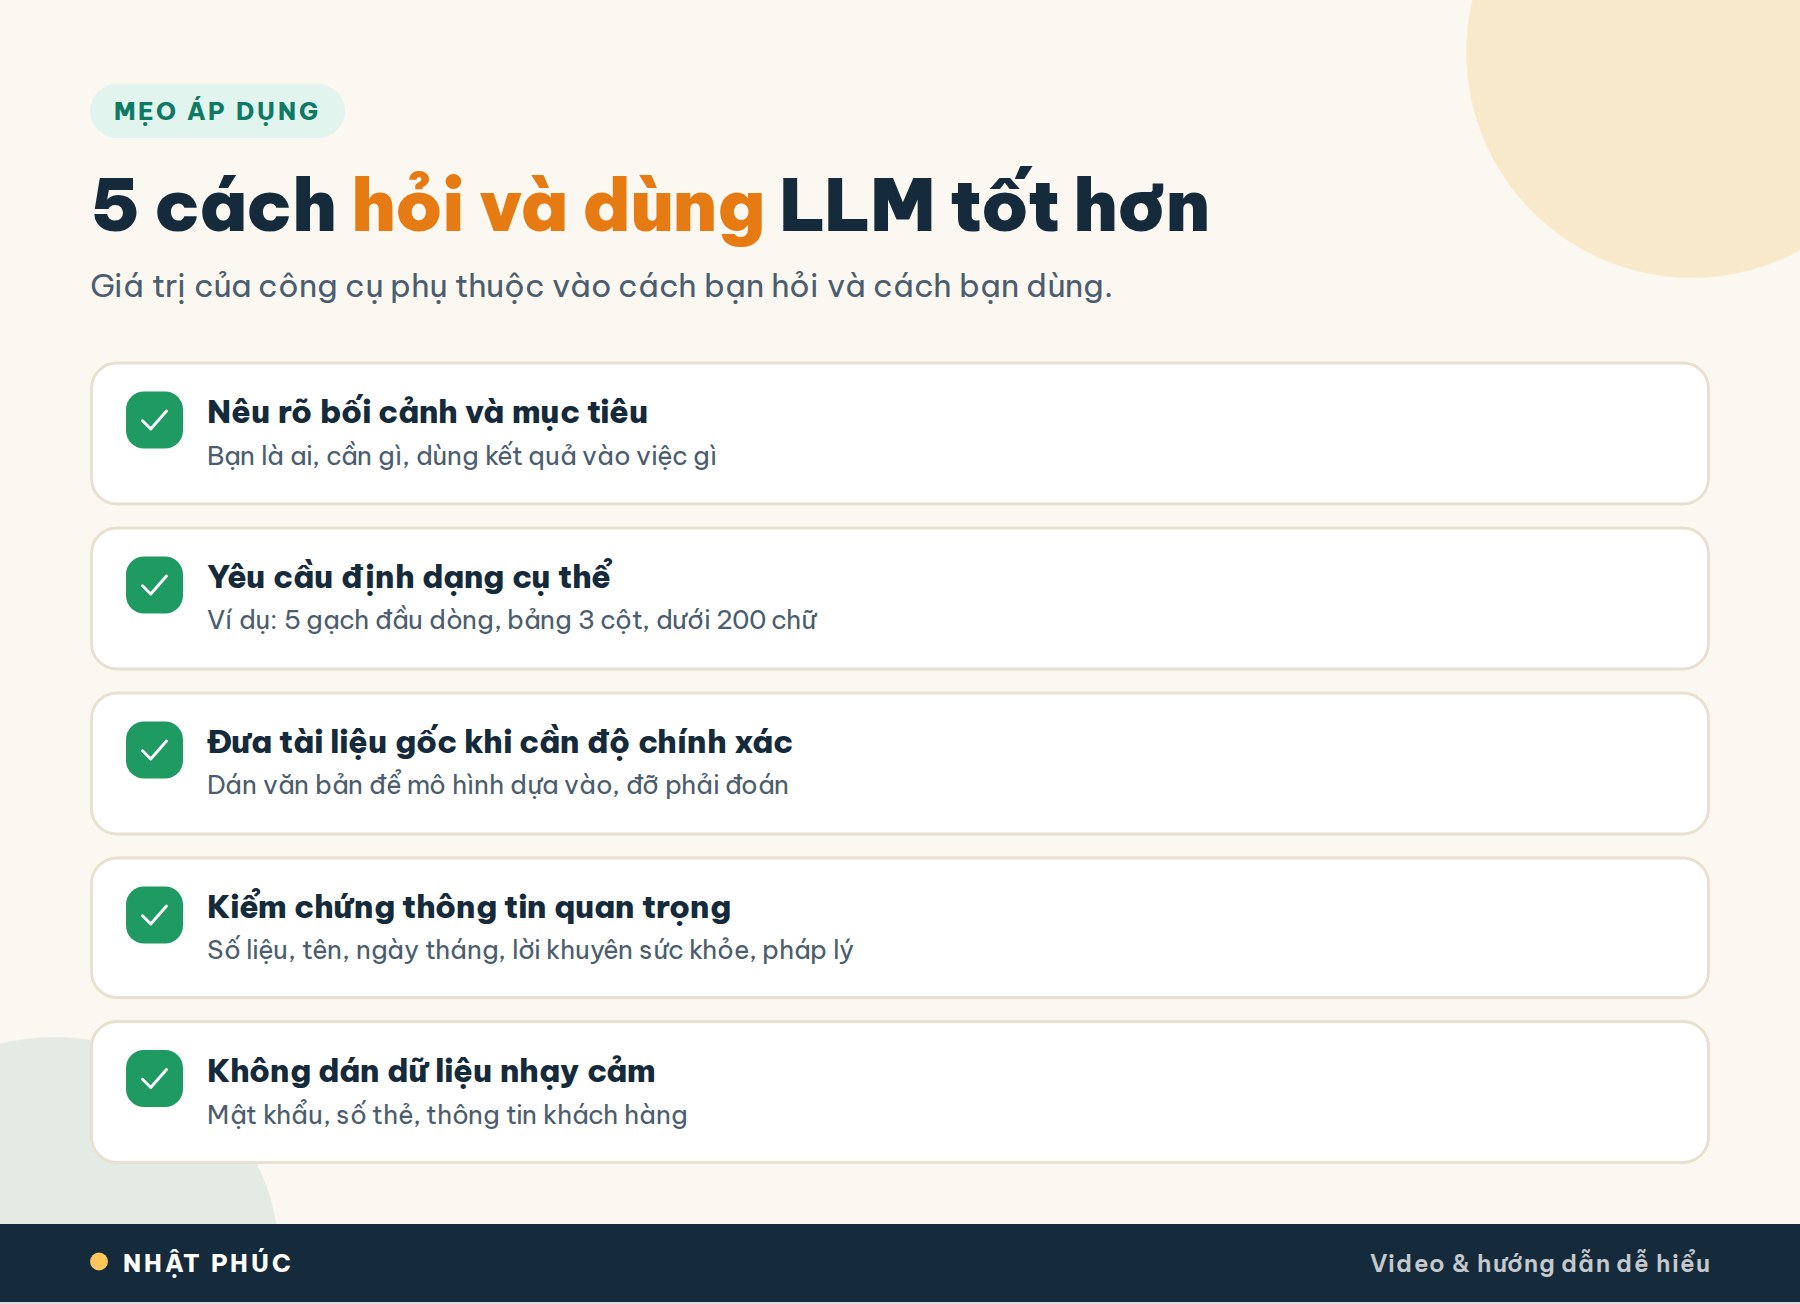
LLM là một công cụ. Và như mọi công cụ, giá trị của nó phụ thuộc vào cách bạn hỏi và cách bạn dùng. Năm thói quen sau giúp bạn nhận được câu trả lời tốt hơn rõ rệt.
1. Nêu rõ bối cảnh và mục tiêu
Thay vì hỏi “Viết email xin nghỉ”, hãy nói “Tôi là nhân viên văn phòng, cần email gửi trưởng phòng xin nghỉ thứ Sáu vì việc gia đình, giọng lịch sự, ngắn gọn”. Càng nhiều bối cảnh, mô hình càng ít phải đoán.
2. Yêu cầu định dạng cụ thể
Nói rõ bạn muốn kết quả ở dạng nào: 5 gạch đầu dòng, bảng 3 cột, dưới 200 chữ. Mô hình làm theo khuôn rất tốt khi được chỉ rõ.
3. Đưa tài liệu gốc khi cần độ chính xác
Nếu cần tóm tắt hợp đồng hay trả lời dựa trên quy định công ty, hãy dán chính văn bản đó vào. Khi có tài liệu để dựa vào, mô hình bớt phải “đoán” và ít bịa hơn.
4. Kiểm chứng thông tin quan trọng
Số liệu, tên người, ngày tháng, trích dẫn, lời khuyên sức khỏe hay pháp lý: luôn đối chiếu với nguồn đáng tin. Bạn cũng có thể hỏi lại mô hình “Nguồn của thông tin này là gì?” để tự kiểm tra.
5. Không dán dữ liệu nhạy cảm
Tránh đưa mật khẩu, số thẻ ngân hàng, thông tin khách hàng hay tài liệu mật vào trợ lý AI công cộng. Hãy kiểm tra chính sách của công ty bạn về việc dùng AI trước khi đưa tài liệu nội bộ vào.
Câu hỏi thường gặp về LLM
LLM và AI khác nhau thế nào?
AI (trí tuệ nhân tạo) là lĩnh vực rộng, gồm mọi hệ thống máy tính làm được việc cần trí thông minh: nhận diện ảnh, chơi cờ, lái xe tự động. LLM là một loại AI chuyên về ngôn ngữ. Có thể nói mọi LLM đều là AI, nhưng không phải AI nào cũng là LLM.
ChatGPT có phải là LLM không?
ChatGPT là một sản phẩm trợ lý trò chuyện được xây dựng trên các mô hình ngôn ngữ lớn dòng GPT. Nói chính xác, LLM là “động cơ” bên trong, còn ChatGPT là chiếc xe hoàn chỉnh có giao diện, tính năng và lớp an toàn. Gemini, Claude cũng tương tự: đều là trợ lý chạy trên LLM.
Token là gì và vì sao quan trọng?
Token là mảnh văn bản nhỏ mà mô hình xử lý: một từ, một phần của từ hoặc một dấu câu. Token quan trọng vì nó quyết định độ dài tối đa mô hình đọc được một lần (cửa sổ ngữ cảnh) và thường là đơn vị tính phí khi dùng AI qua API.
Vì sao AI đôi khi trả lời sai một cách tự tin?
Vì LLM được huấn luyện để tạo ra câu nghe hợp lý nhất, không phải để tra cứu sự thật. Khi thiếu thông tin, nó vẫn có thể ghép chữ thành câu trả lời trôi chảy nhưng sai. Hiện tượng này gọi là ảo giác (hallucination), nên hãy kiểm chứng thông tin quan trọng.
LLM có hiểu thật sự những gì nó nói không?
Đây vẫn là câu hỏi các nhà nghiên cứu còn tranh luận. Điều chắc chắn là LLM nắm được rất nhiều quy luật của ngôn ngữ và kiến thức qua quan hệ giữa các con số, nhưng nó không có trải nghiệm hay ý định như con người. Cách an toàn nhất là coi nó là một công cụ mạnh, không phải một người biết tuốt.
Huấn luyện một LLM tốn bao nhiêu?
Với các mô hình lớn nhất, giai đoạn tiền huấn luyện cần hàng nghìn chip đồ họa chạy trong nhiều tháng, chi phí có thể lên tới hàng chục triệu đô la. Các mô hình nhỏ hơn hoặc việc tinh chỉnh một mô hình có sẵn thì rẻ hơn rất nhiều.
Kết luận: LLM là gì, gói gọn trong một câu
Tóm lại, LLM là một mô hình toán học khổng lồ, được huấn luyện trên lượng văn bản khổng lồ, để làm một việc duy nhất: đoán chữ tiếp theo. Từ nhiệm vụ giản dị ấy, những khả năng đáng kinh ngạc đã xuất hiện: viết, dịch, lập trình, giải thích.
Nó không phải phép màu, cũng không phải bộ não con người. Nó là một công cụ, và giá trị của nó phụ thuộc vào cách bạn hỏi và cách bạn dùng. Hiểu cách LLM hoạt động, bạn sẽ biết lúc nào nên tin nó, lúc nào nên kiểm chứng.
Vậy lần tới khi trò chuyện với AI, hãy nhớ: phía sau mỗi câu trả lời là hàng tỷ con số, cùng nhau đoán xem chữ nào nên đến tiếp theo.
Bạn hay dùng trợ lý AI vào việc gì nhất? Hãy để lại bình luận chia sẻ, và theo dõi kênh Nhật Phúc để xem thêm những video giải thích công nghệ dễ hiểu.