Một bức ảnh gấu trúc, thêm vào một lớp nhiễu mỏng đến mức mắt người không thấy gì khác, và mô hình AI lập tức khẳng định đó là con vượn, còn tự tin hơn lúc nhìn ảnh gốc. Nghe như trò ảo thuật, nhưng đây là lý do cả ngành AI phải học một kỹ năng mới: tự tấn công hệ thống của mình trước khi kẻ xấu làm điều đó. Kỹ năng ấy có tên là red teaming AI.
Câu trả lời ngắn: Red teaming AI là việc một nhóm người (hoặc công cụ) đóng vai kẻ tấn công, cố tình tìm mọi cách làm hệ thống AI trả lời sai, lộ dữ liệu, bị lừa hoặc gây hại, để đội phát triển vá lỗ hổng trước khi sản phẩm đến tay người dùng. Nó khác chấm điểm thông thường ở chỗ đi tìm điểm yếu, không đo điểm trung bình.
Bài viết này giải thích red teaming AI từ gốc: vì sao những “ví dụ đối kháng” như ảnh gấu trúc hoá vượn khiến nó trở nên bắt buộc, các kiểu tấn công mà đội đỏ hay thử, quy trình 6 bước, công cụ phổ biến, cách phòng thủ và cách bạn tự kiểm tra chatbot của chính mình.
Nếu muốn nắm phần gốc rễ của câu chuyện bằng hình ảnh, bạn có thể xem video Ví dụ đối kháng là gì trên kênh Vọc Sĩ trước, rồi đọc tiếp phần mở rộng bên dưới.
Tóm tắt nhanh
- Red teaming AI là tấn công thử có chủ đích để tìm điểm yếu của hệ thống AI trước khi kẻ xấu tìm ra.
- Ví dụ đối kháng (ảnh gấu trúc hoá vượn năm 2014, biển báo dừng dán băng dính năm 2018) cho thấy AI giỏi trung bình vẫn có thể rất yếu trước người cố tình phá.
- Bốn nhóm tấn công hay gặp: đánh lừa đầu vào, đầu độc dữ liệu, moi thông tin riêng tư và lạm dụng mô hình tạo sinh.
- Quy trình gồm 6 bước: khoanh phạm vi, lập đội, viết kịch bản, tấn công, chấm mức độ, sửa rồi thử lại.
- Chưa có cách phòng thủ nào trọn vẹn, nên cần nhiều lớp bảo vệ và giữ con người trong vòng kiểm soát với việc rủi ro cao.
Nội dung chính:
- Red teaming AI là gì?
- Ví dụ đối kháng: vì sao AI cần bị tấn công thử
- 4 kiểu tấn công đội đỏ AI hay thử
- Red teaming khác kiểm thử thông thường ở đâu
- Quy trình red teaming AI 6 bước
- Khung tham chiếu và công cụ phổ biến
- Ai đang làm red teaming AI?
- Phòng thủ sau khi bị đánh: làm gì tiếp?
- Tự red team chatbot của bạn: 7 bước
- Hiểu lầm phổ biến
- Câu hỏi thường gặp
Red teaming AI là gì?
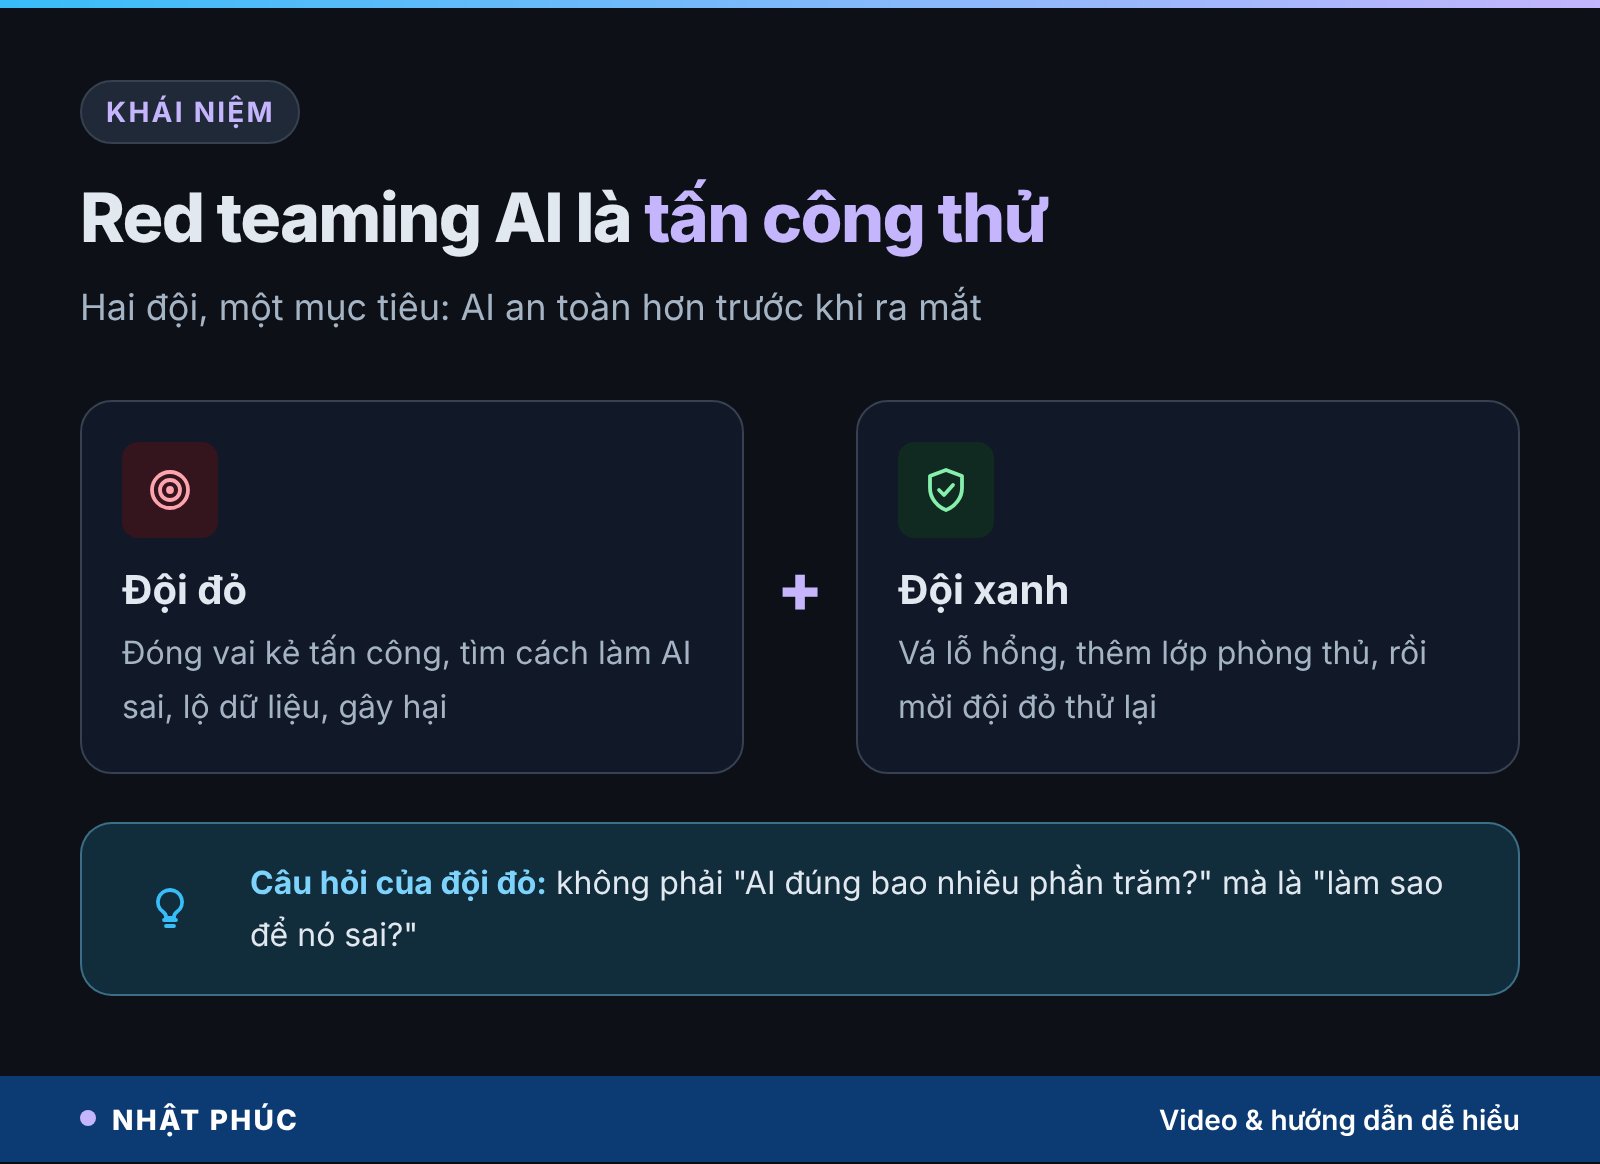
Cụm từ “red team” (đội đỏ) có gốc từ các cuộc diễn tập quân sự: một nhóm đóng vai phe địch để thử xem kế hoạch của phe mình có lỗ hổng gì. Sau này giới an ninh mạng mượn lại: đội đỏ tấn công hệ thống công ty theo cách hacker thật sẽ làm, còn đội xanh (blue team) phòng thủ và vá lỗi.
Red teaming AI áp dụng tinh thần ấy cho mô hình học máy và các sản phẩm dùng AI. Đội đỏ không hỏi “mô hình đúng bao nhiêu phần trăm?” mà hỏi “làm sao để nó sai, và sai nguy hiểm đến đâu?”. Mục tiêu có thể là một bộ phân loại ảnh, một hệ nhận diện khuôn mặt ở cổng ra vào, một chatbot chăm sóc khách hàng hay một trợ lý AI có quyền gửi email thay bạn.
Hãy hình dung một người gác cổng cực giỏi, nhìn mặt là biết ai được vào. Kiểm thử thông thường giống như cho hàng nghìn người bình thường đi qua và đếm xem anh ta nhận đúng bao nhiêu. Red teaming thì cử một người chuyên đi tìm điểm mù của anh ta: dán một vết nhỏ đúng chỗ anh hay nhìn, hoá trang nửa vời, hay nói khéo để được mở cổng.
Với AI tạo sinh, phạm vi còn rộng hơn chuyện bảo mật. Đội đỏ còn thử xem chatbot có bị dụ nói điều nguy hiểm, có định kiến, có bịa thông tin trong lĩnh vực nhạy cảm hay có làm lộ dữ liệu nội bộ không. Vì thế nhiều tổ chức chia ra hai mảng: red teaming về bảo mật và red teaming về an toàn, trách nhiệm.
Ví dụ đối kháng: vì sao AI cần bị tấn công thử
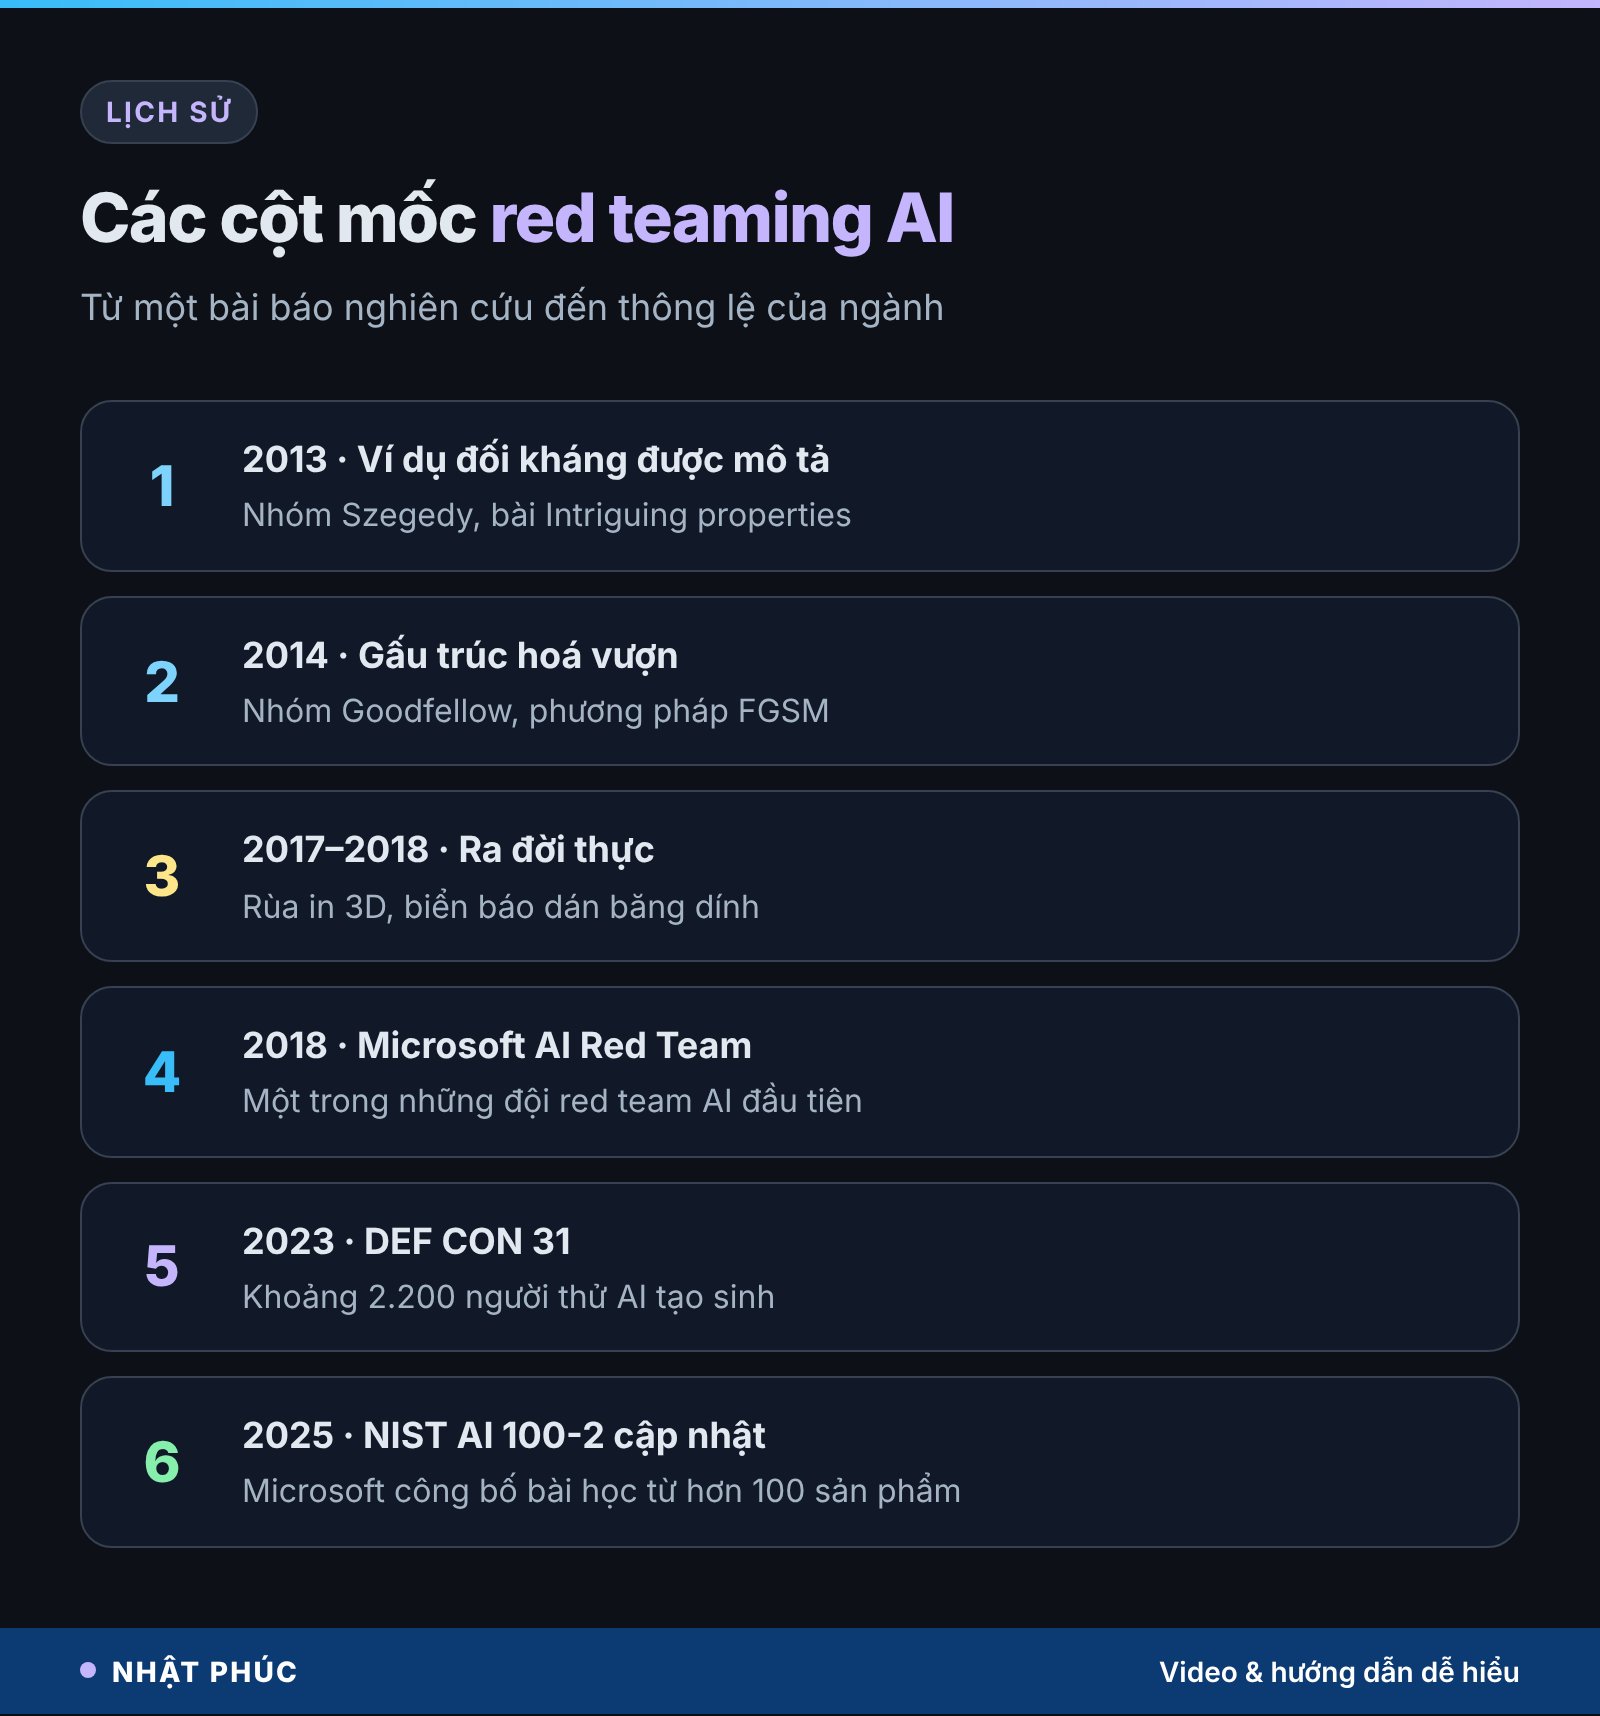
Lý do red teaming AI trở nên bắt buộc nằm ở một hiện tượng có tên ví dụ đối kháng (adversarial examples): dữ liệu bị chỉnh rất nhẹ, con người không nhận ra, nhưng được tính toán để mô hình trả lời sai. Năm 2013, nhóm của Christian Szegedy mô tả hiện tượng này trong bài báo “Intriguing properties of neural networks”. Năm 2014, nhóm của Ian Goodfellow đưa ra ví dụ trở thành kinh điển.
Gấu trúc hoá vượn trong một phép tính
Trong thí nghiệm của Goodfellow, mô hình nhận ra ảnh gấu trúc với độ tin cậy khoảng 57,7%. Nhóm cộng thêm một lớp nhiễu nhân với hệ số rất nhỏ (0,007), được tính theo đúng hướng làm mô hình sai nhiều nhất. Ảnh mới trông y hệt, nhưng mô hình kết luận “vượn” với độ tin cậy khoảng 99,3%. Phương pháp này có tên Fast Gradient Sign Method (FGSM).
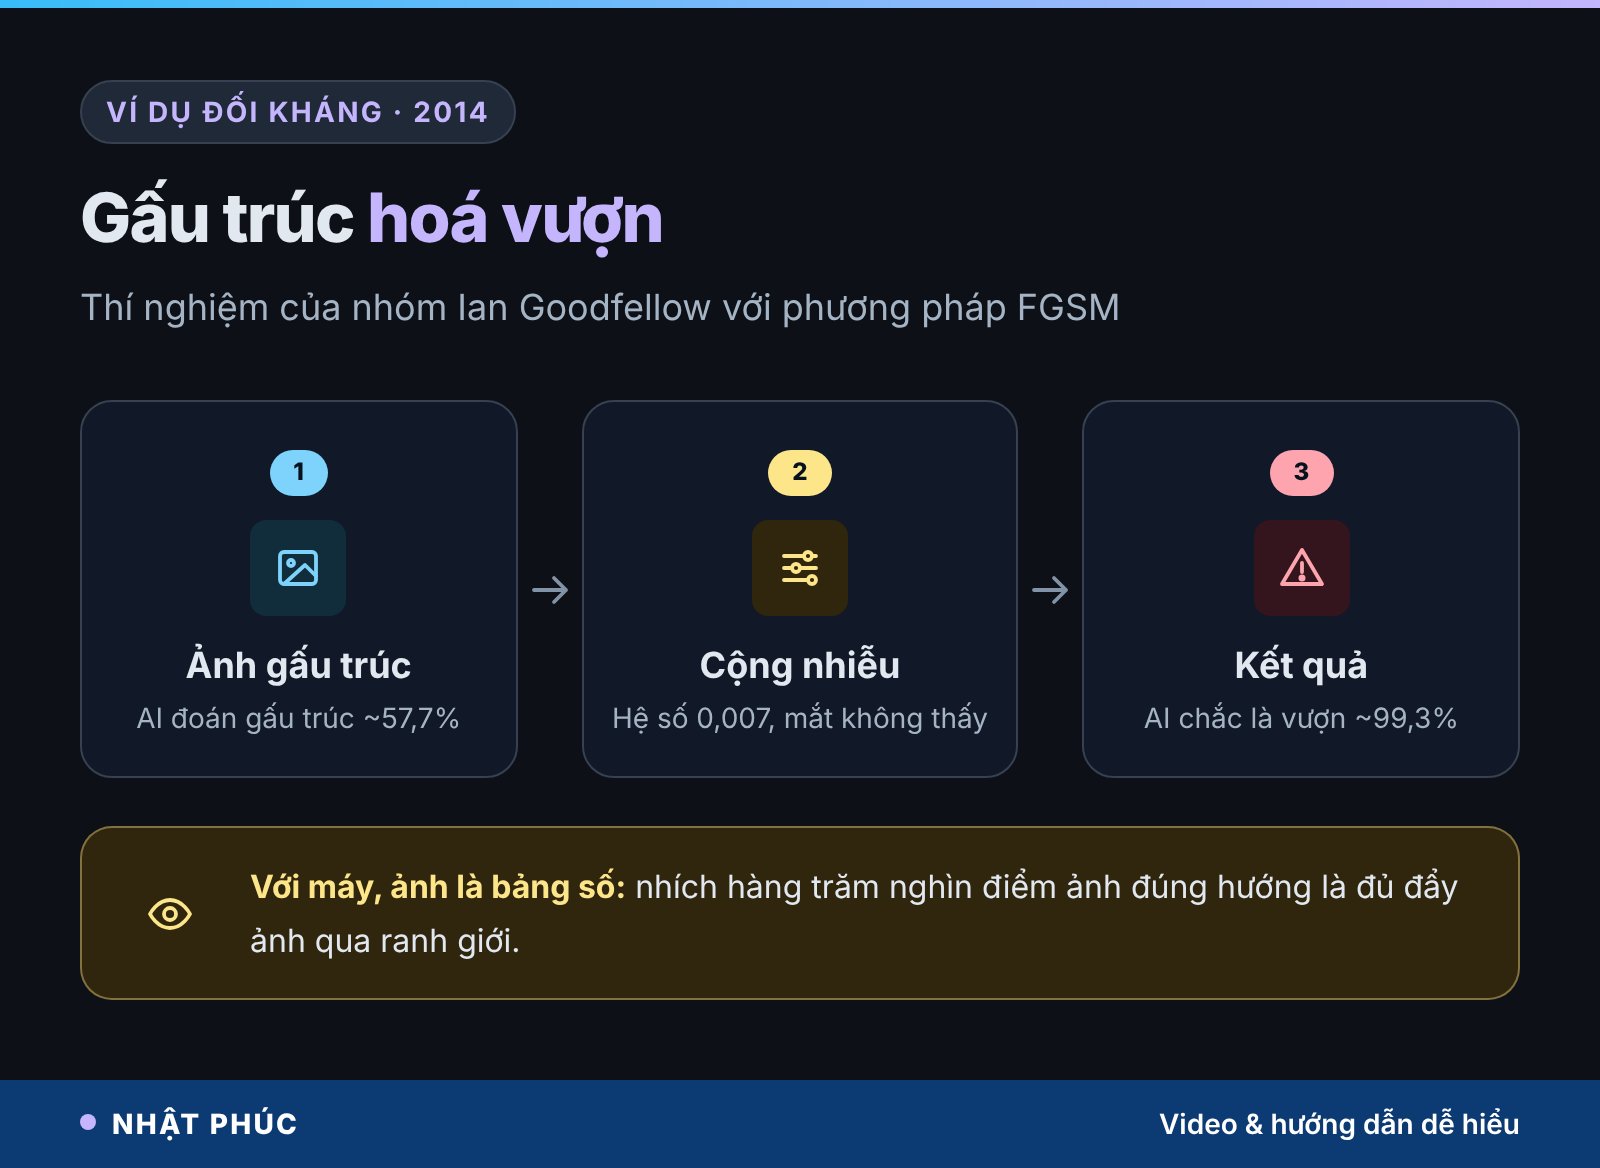
Vì sao làm được? Với máy, bức ảnh chỉ là một bảng số khổng lồ, mỗi ô là độ sáng của một điểm ảnh. Mô hình học được một ranh giới vô hình: bên này là gấu trúc, bên kia là vượn. Khi huấn luyện, người ta chỉnh các tham số để giảm sai số. Kẻ tấn công làm ngược lại: giữ nguyên mô hình, nhích từng điểm ảnh một chút theo hướng tăng sai số. Hàng trăm nghìn nhích nhỏ cộng lại đủ đẩy bức ảnh qua ranh giới.
Từ phòng thí nghiệm ra đường phố
Năm 2017, một nhóm ở MIT in 3D một con rùa đồ chơi được mô hình nhận thành khẩu súng trường từ hầu hết các góc nhìn. Năm 2018, nhóm của Kevin Eykholt dán vài miếng băng dính đen trắng lên biển báo dừng thật, khiến bộ nhận dạng biển báo đọc nó thành biển giới hạn tốc độ 45 dặm/giờ: 100% ảnh trong thử nghiệm tĩnh và 84,8% khung hình quay từ xe đang chạy.
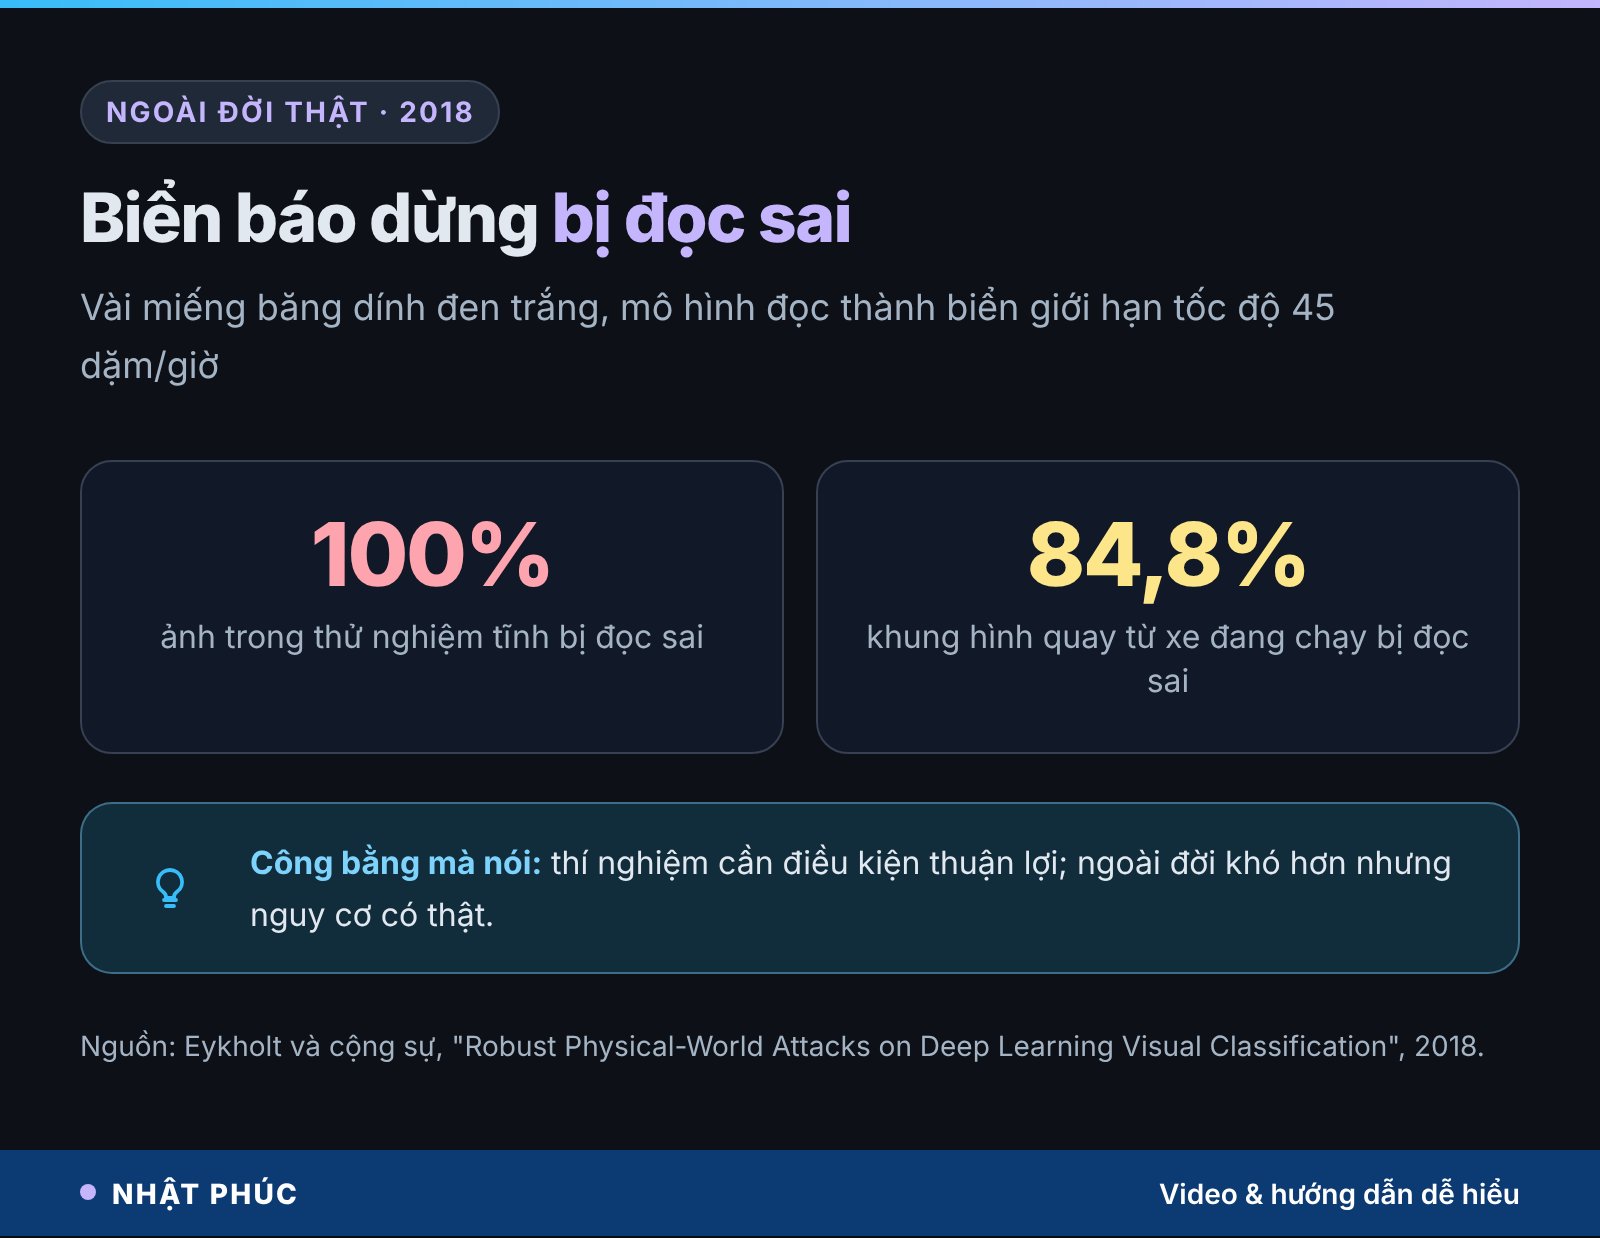
Cần nói cho công bằng: phần lớn thí nghiệm như vậy cần điều kiện thuận lợi, ví dụ biết rõ mô hình hoặc đặt miếng dán đúng góc, đúng ánh sáng. Ngoài đời, đánh lừa một hệ thống thật khó hơn. Nhưng bài học vẫn nguyên giá trị: máy nhìn đúng hàng triệu lần không có nghĩa là máy nhìn giống ta, và chỉ có cách đi tìm điểm yếu một cách có chủ đích mới thấy được chúng.
4 kiểu tấn công đội đỏ AI hay thử
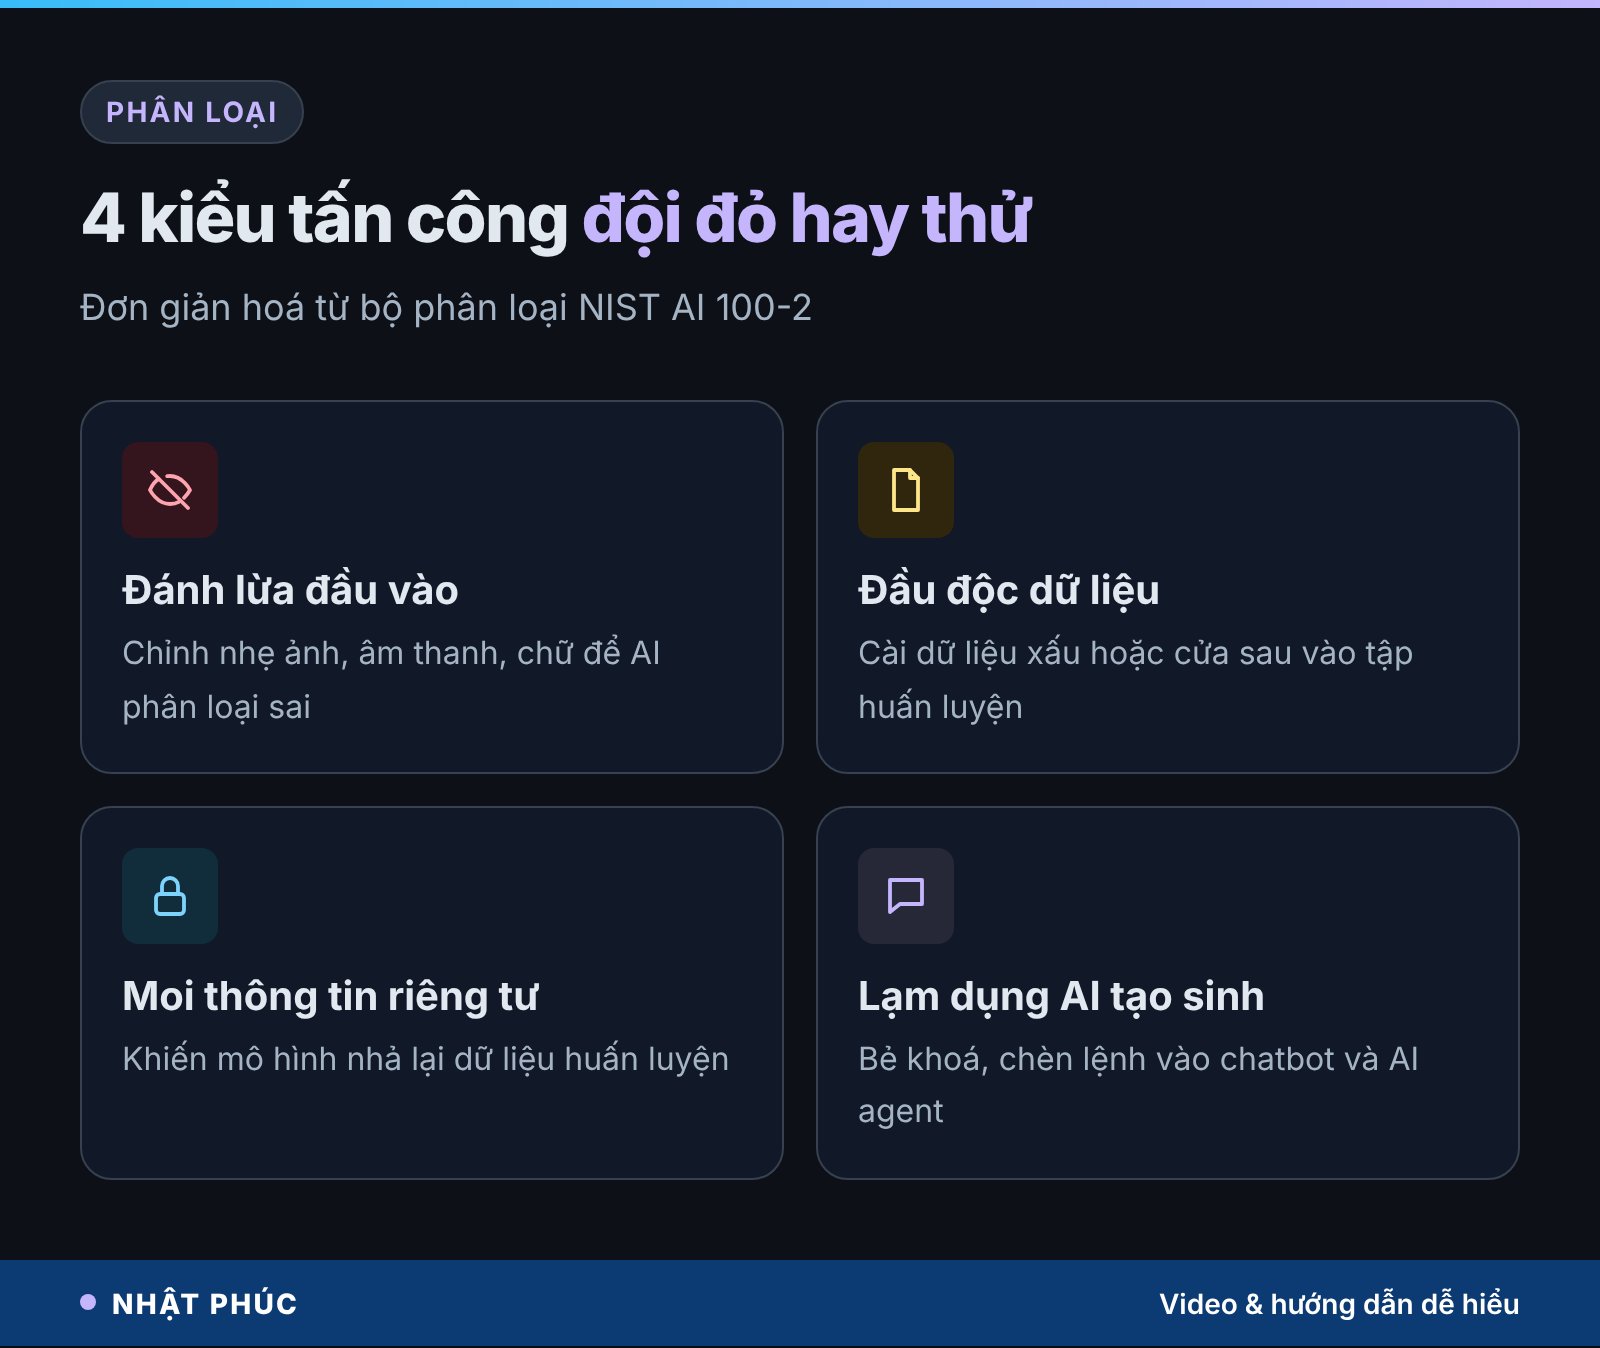
Viện Tiêu chuẩn và Công nghệ Mỹ (NIST) có hẳn một bộ phân loại về học máy đối kháng, mã NIST AI 100-2. Đơn giản hoá, đội đỏ thường thử bốn nhóm tấn công sau.
1. Đánh lừa đầu vào (né tránh)
Đây là nhóm ví dụ đối kháng ở trên: chỉnh ảnh, âm thanh hay văn bản để mô hình phân loại sai lúc đang chạy. Với bộ lọc thư rác, đó có thể là cố tình viết sai chính tả hoặc chèn chữ ẩn để thư lừa đảo lọt qua.
2. Đầu độc dữ liệu
Kẻ tấn công cài dữ liệu xấu vào tập huấn luyện để mô hình học sai từ gốc, hoặc cài “cửa sau”: mô hình hoạt động bình thường, chỉ sai khi gặp một dấu hiệu bí mật. Mô hình càng học từ dữ liệu thu thập trên mạng, rủi ro này càng đáng lo.
3. Moi thông tin riêng tư
Đội đỏ thử xem có thể khiến mô hình nhả lại dữ liệu huấn luyện (số điện thoại, đoạn tài liệu nội bộ) hay đoán được một người có nằm trong dữ liệu huấn luyện hay không.
4. Lạm dụng mô hình tạo sinh
Với chatbot và AI agent, nhóm này gồm bẻ khoá (jailbreak) để vượt rào an toàn và chèn lệnh (prompt injection) để mô hình làm theo lệnh giấu trong email hay trang web. Nhật Phúc đã có bài riêng về chèn lệnh, nên ở đây chỉ nhắc như một hạng mục trong danh sách thử.
Red teaming khác kiểm thử thông thường ở đâu
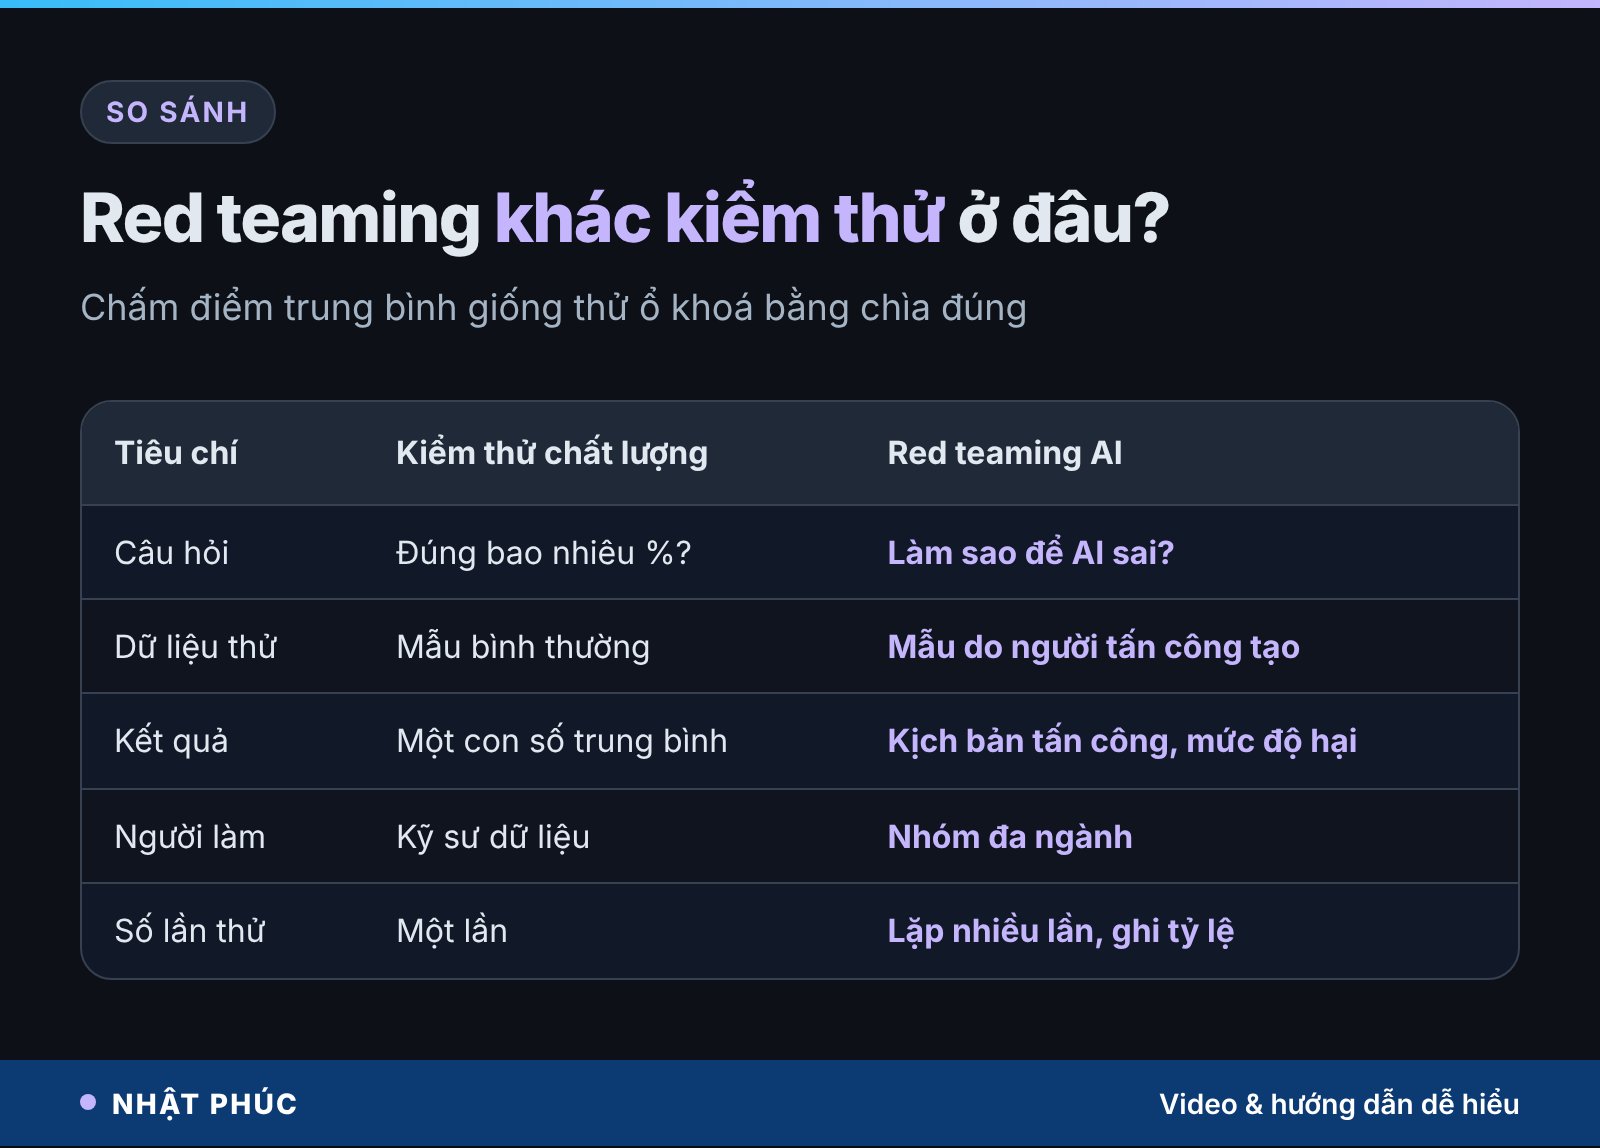
Nhiều người nghĩ đã có bộ dữ liệu kiểm tra với độ chính xác 98% là đủ. Vấn đề là bộ dữ liệu ấy gồm những mẫu “bình thường”, còn kẻ tấn công không bao giờ gửi mẫu bình thường. Chấm điểm trung bình giống như kiểm tra ổ khoá bằng chìa đúng: luôn mở được, nhưng không cho biết kẻ trộm cạy được hay không.
| Tiêu chí | Kiểm thử chất lượng | Kiểm thử bảo mật truyền thống | Red teaming AI |
|---|---|---|---|
| Câu hỏi chính | Đúng bao nhiêu phần trăm? | Có lỗ hổng phần mềm nào? | Làm sao để AI sai hoặc gây hại? |
| Dữ liệu thử | Mẫu bình thường, cố định | Danh sách lỗ hổng đã biết | Mẫu do người tấn công sáng tạo |
| Kết quả | Một con số trung bình | Danh sách lỗi bảo mật | Kịch bản tấn công và mức độ hại |
| Người làm | Kỹ sư dữ liệu | Chuyên gia bảo mật | Nhóm đa ngành: bảo mật, AI, chuyên gia lĩnh vực |
Một điểm khác quan trọng: kết quả của mô hình AI mang tính xác suất. Cùng một câu hỏi bẻ khoá có thể thất bại lần đầu và thành công lần thứ năm. Vì vậy đội đỏ thường lặp một kịch bản nhiều lần và ghi lại tỷ lệ thành công, thay vì kết luận “đã thử, không sao”.
Quy trình red teaming AI 6 bước
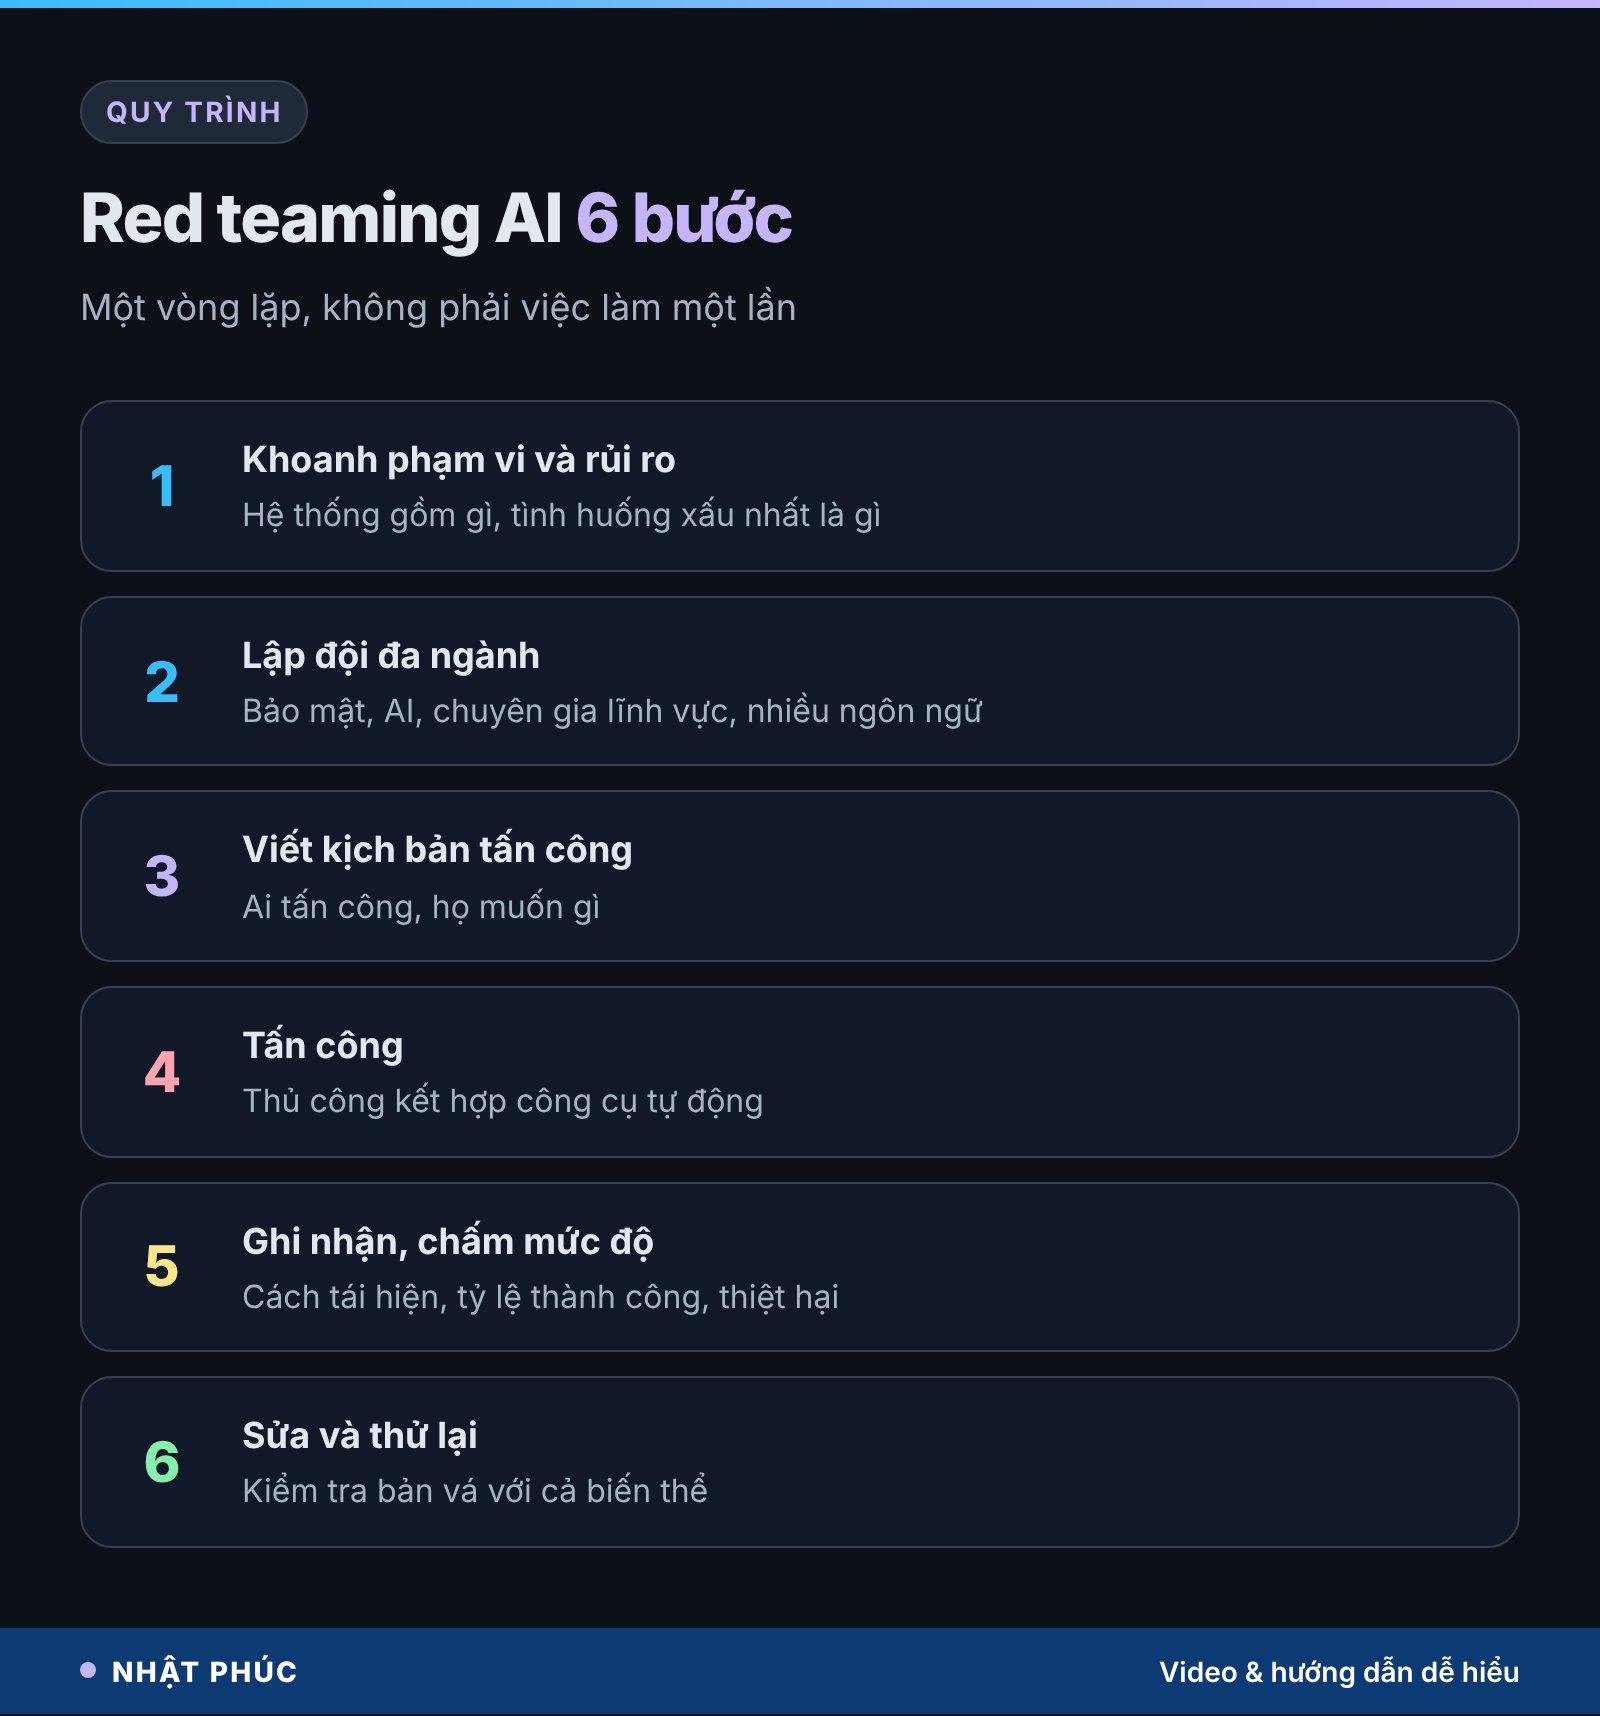
Mỗi tổ chức có cách làm riêng, nhưng một đợt red teaming AI bài bản thường đi qua sáu bước dưới đây.
Bước 1. Khoanh phạm vi và rủi ro
Xác định hệ thống gồm những gì (mô hình, dữ liệu, công cụ mà AI được gọi), ai dùng, và tình huống xấu nhất là gì. Một chatbot tư vấn món ăn và một AI hỗ trợ đọc phim y tế có mức rủi ro rất khác nhau.
Bước 2. Lập đội đa ngành
Ngoài chuyên gia bảo mật và kỹ sư AI, nên có người hiểu lĩnh vực (bác sĩ, luật sư, nhân viên chăm sóc khách hàng) và người dùng thử với văn hoá, ngôn ngữ khác nhau. Nhiều lỗ hổng chỉ lộ ra khi hỏi bằng tiếng Việt, tiếng địa phương hay tiếng lóng.
Bước 3. Viết kịch bản tấn công
Liệt kê kẻ tấn công có thể là ai (người dùng tò mò, đối thủ, kẻ lừa đảo) và họ muốn gì. Mỗi kịch bản là một giả thuyết cụ thể: “khách hàng có thể dụ bot đổi chính sách hoàn tiền không?”.
Bước 4. Tấn công: thủ công kết hợp tự động
Con người giỏi sáng tạo kiểu tấn công mới, còn công cụ tự động giỏi thử hàng nghìn biến thể. Kết hợp cả hai mới phủ được nhiều điểm yếu.
Bước 5. Ghi nhận và chấm mức độ
Mỗi lỗi được ghi lại cách tái hiện, tỷ lệ thành công và mức độ thiệt hại nếu xảy ra thật, để đội phát triển ưu tiên sửa cái nguy hiểm trước.
Bước 6. Sửa và thử lại
Vá xong phải tấn công lại, vì bản vá có thể chỉ chặn đúng câu chữ cũ mà không chặn biến thể. Red teaming là vòng lặp liên tục, mỗi khi mô hình hay tính năng thay đổi.
Khung tham chiếu và công cụ phổ biến
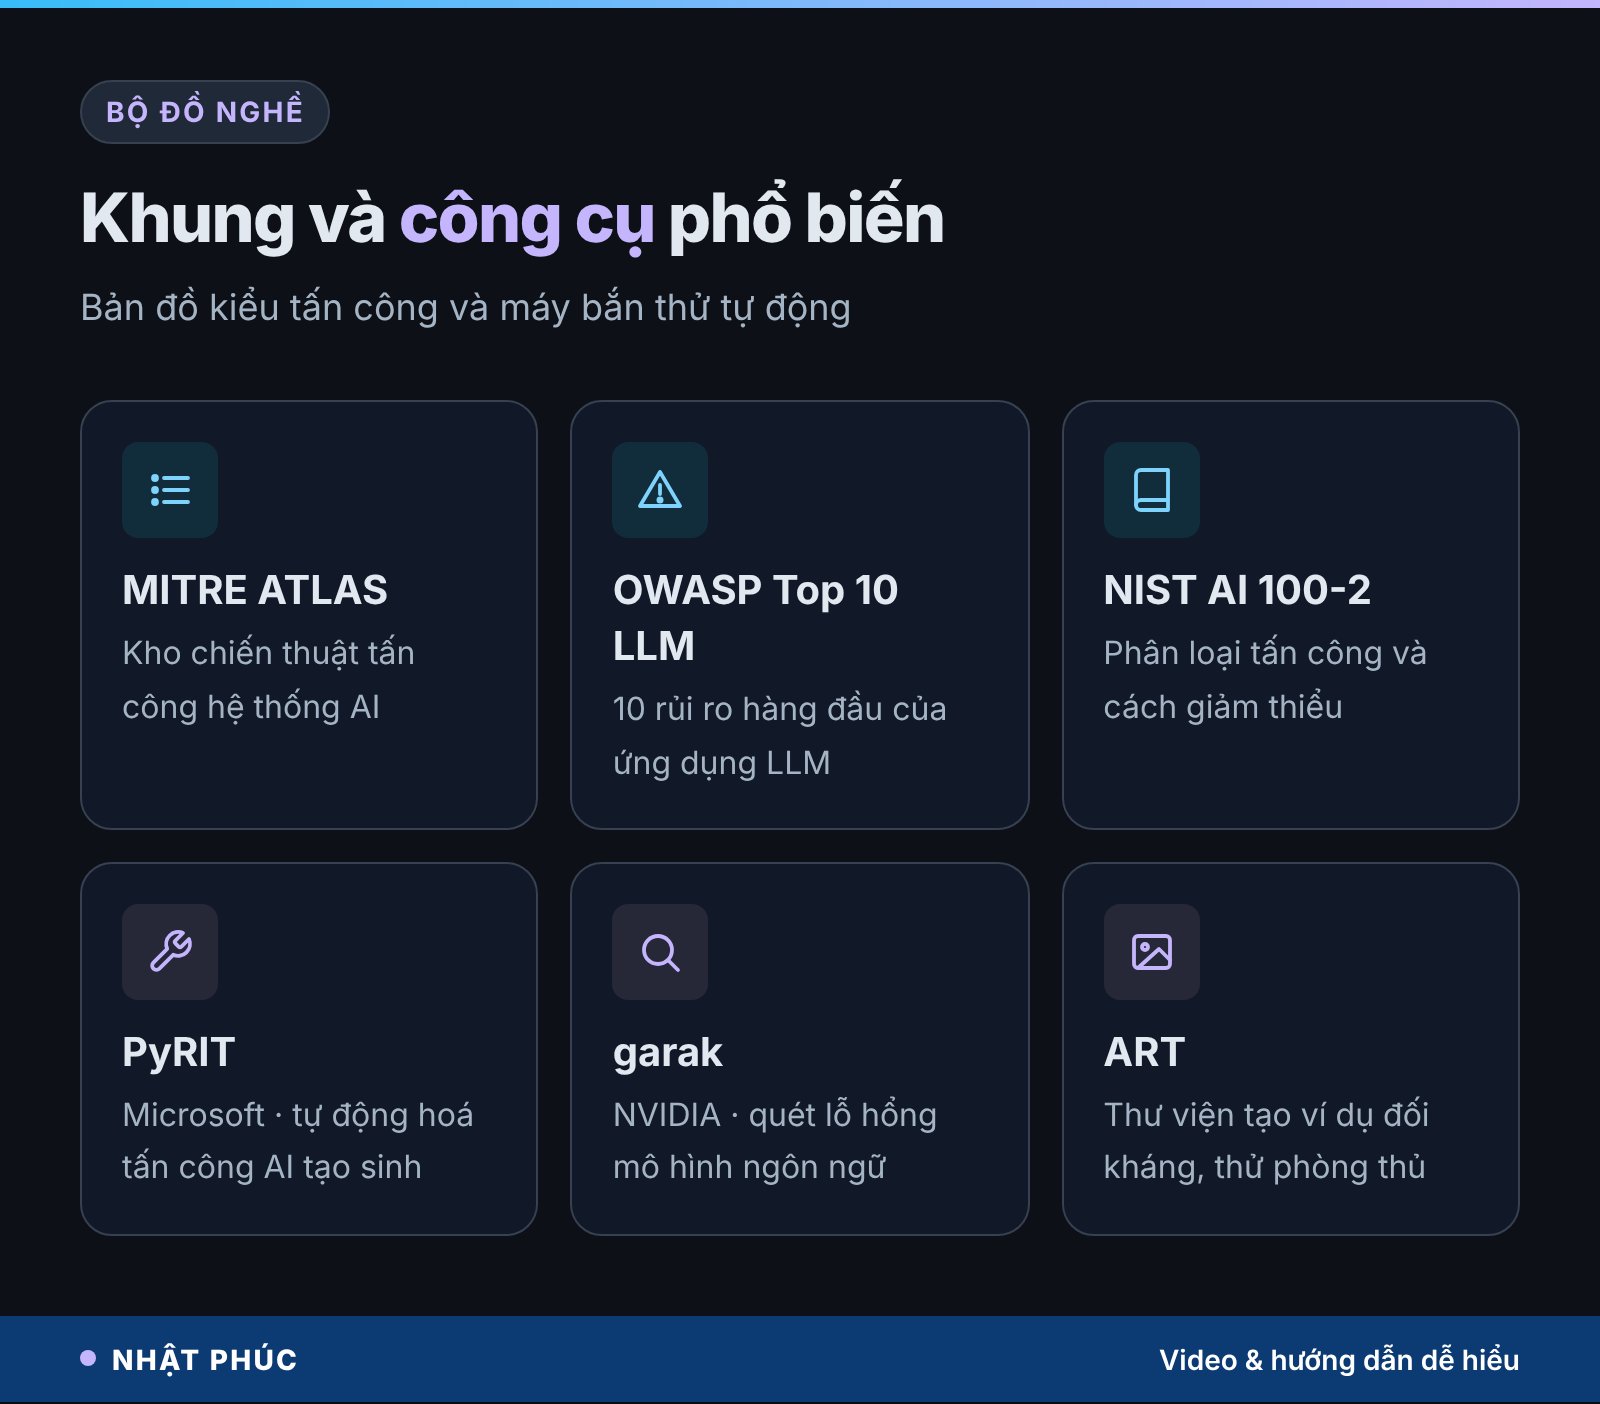
Bạn không phải bắt đầu từ con số không. Cộng đồng bảo mật đã xây sẵn nhiều “bản đồ” các kiểu tấn công và công cụ tự động hoá, phần lớn miễn phí.
Khung tham chiếu
- MITRE ATLAS: kho chiến thuật và kỹ thuật tấn công nhắm vào hệ thống AI, xây theo kiểu bộ khung ATT&CK nổi tiếng của giới an ninh mạng, kèm các tình huống có thật.
- OWASP Top 10 cho ứng dụng LLM: danh sách mười rủi ro hàng đầu của ứng dụng dùng mô hình ngôn ngữ lớn, ra mắt năm 2023, trong đó chèn lệnh đứng đầu.
- NIST AI 100-2: bộ phân loại tấn công và cách giảm thiểu cho học máy đối kháng, bản cập nhật năm 2025 bổ sung nhiều nội dung về AI tạo sinh.
Công cụ tự động
- PyRIT (Microsoft): thư viện mã nguồn mở giúp tự động gửi hàng loạt câu hỏi tấn công tới mô hình tạo sinh và chấm kết quả.
- garak (NVIDIA): công cụ quét lỗ hổng cho mô hình ngôn ngữ, chạy sẵn nhiều bài thử bẻ khoá, rò rỉ dữ liệu, bịa thông tin.
- Adversarial Robustness Toolbox (IBM, nay thuộc LF AI & Data): thư viện tạo ví dụ đối kháng và thử phòng thủ cho mô hình ảnh, âm thanh, bảng số liệu.
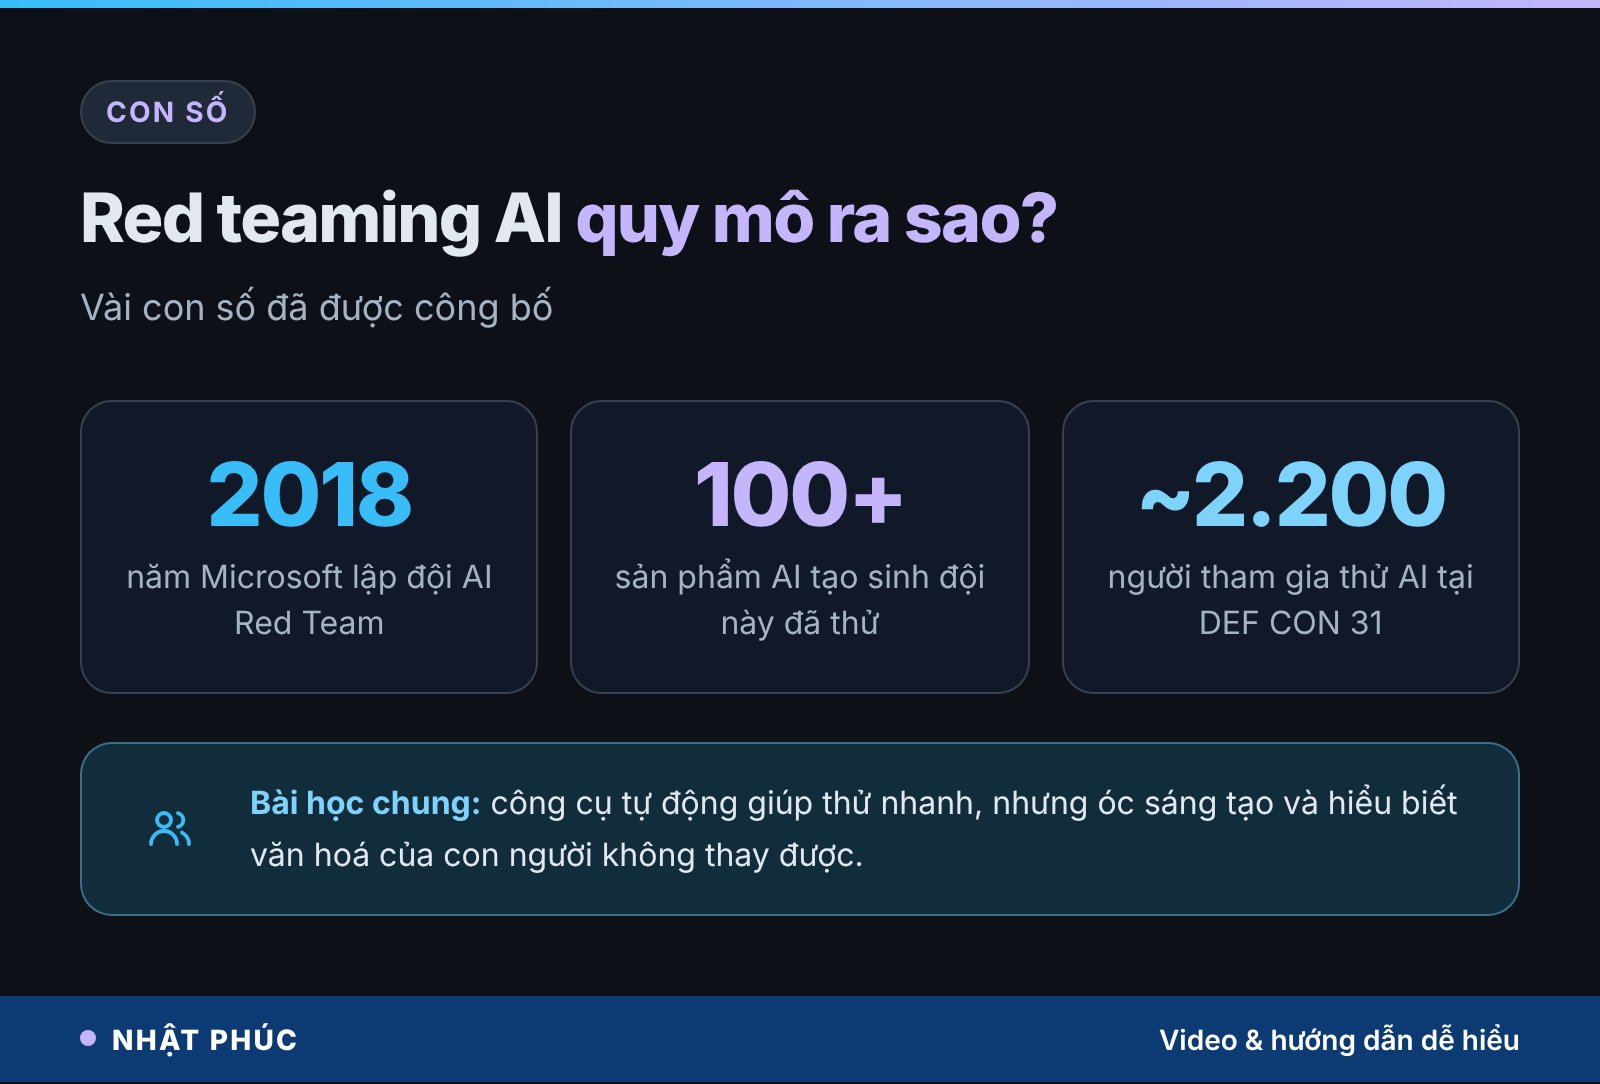
Lưu ý: công cụ chỉ là máy bắn thử. Báo cáo từ đội red team AI của Microsoft sau khi thử hơn 100 sản phẩm AI tạo sinh nhấn mạnh rằng yếu tố con người, gồm óc sáng tạo và hiểu biết văn hoá, vẫn không thể thay thế.
Ai đang làm red teaming AI?
Red teaming AI đã chuyển từ đề tài nghiên cứu thành việc làm thường xuyên của các công ty lớn và cả cơ quan quản lý.
- Microsoft thành lập đội AI Red Team từ năm 2018. Đầu năm 2025, đội công bố bài học rút ra sau khi thử hơn 100 sản phẩm AI tạo sinh.
- DEF CON 31 (năm 2023): sự kiện red teaming AI tạo sinh công khai lớn với khoảng 2.200 người tham gia, thử mô hình của các công ty như Anthropic, Google, Hugging Face, NVIDIA, OpenAI, Stability, Cohere và Meta, với sự hỗ trợ của Văn phòng Chính sách Khoa học và Công nghệ Nhà Trắng.
- Các phòng thí nghiệm AI thường mời chuyên gia bên ngoài thử mô hình trước khi phát hành và công bố kết quả trong “thẻ hệ thống” (system card) đi kèm.
- Quy định: Đạo luật AI của Liên minh châu Âu yêu cầu nhà cung cấp mô hình đa dụng có rủi ro hệ thống phải kiểm thử đối kháng mô hình của mình.
Phòng thủ sau khi bị đánh: làm gì tiếp?
Tìm ra lỗ hổng mới là nửa đường. Lỗi đối kháng khó chữa vì nó không phải một con bọ nằm ở một dòng mã nào đó, mà đến từ chính cách mô hình nhìn thế giới bằng các mẫu thống kê. Con người nhận ra gấu trúc nhờ hình dạng, ý nghĩa, ngữ cảnh; máy nhận ra nhờ những mẫu điểm ảnh mà ta không bao giờ để ý.
Các lớp phòng thủ thường dùng
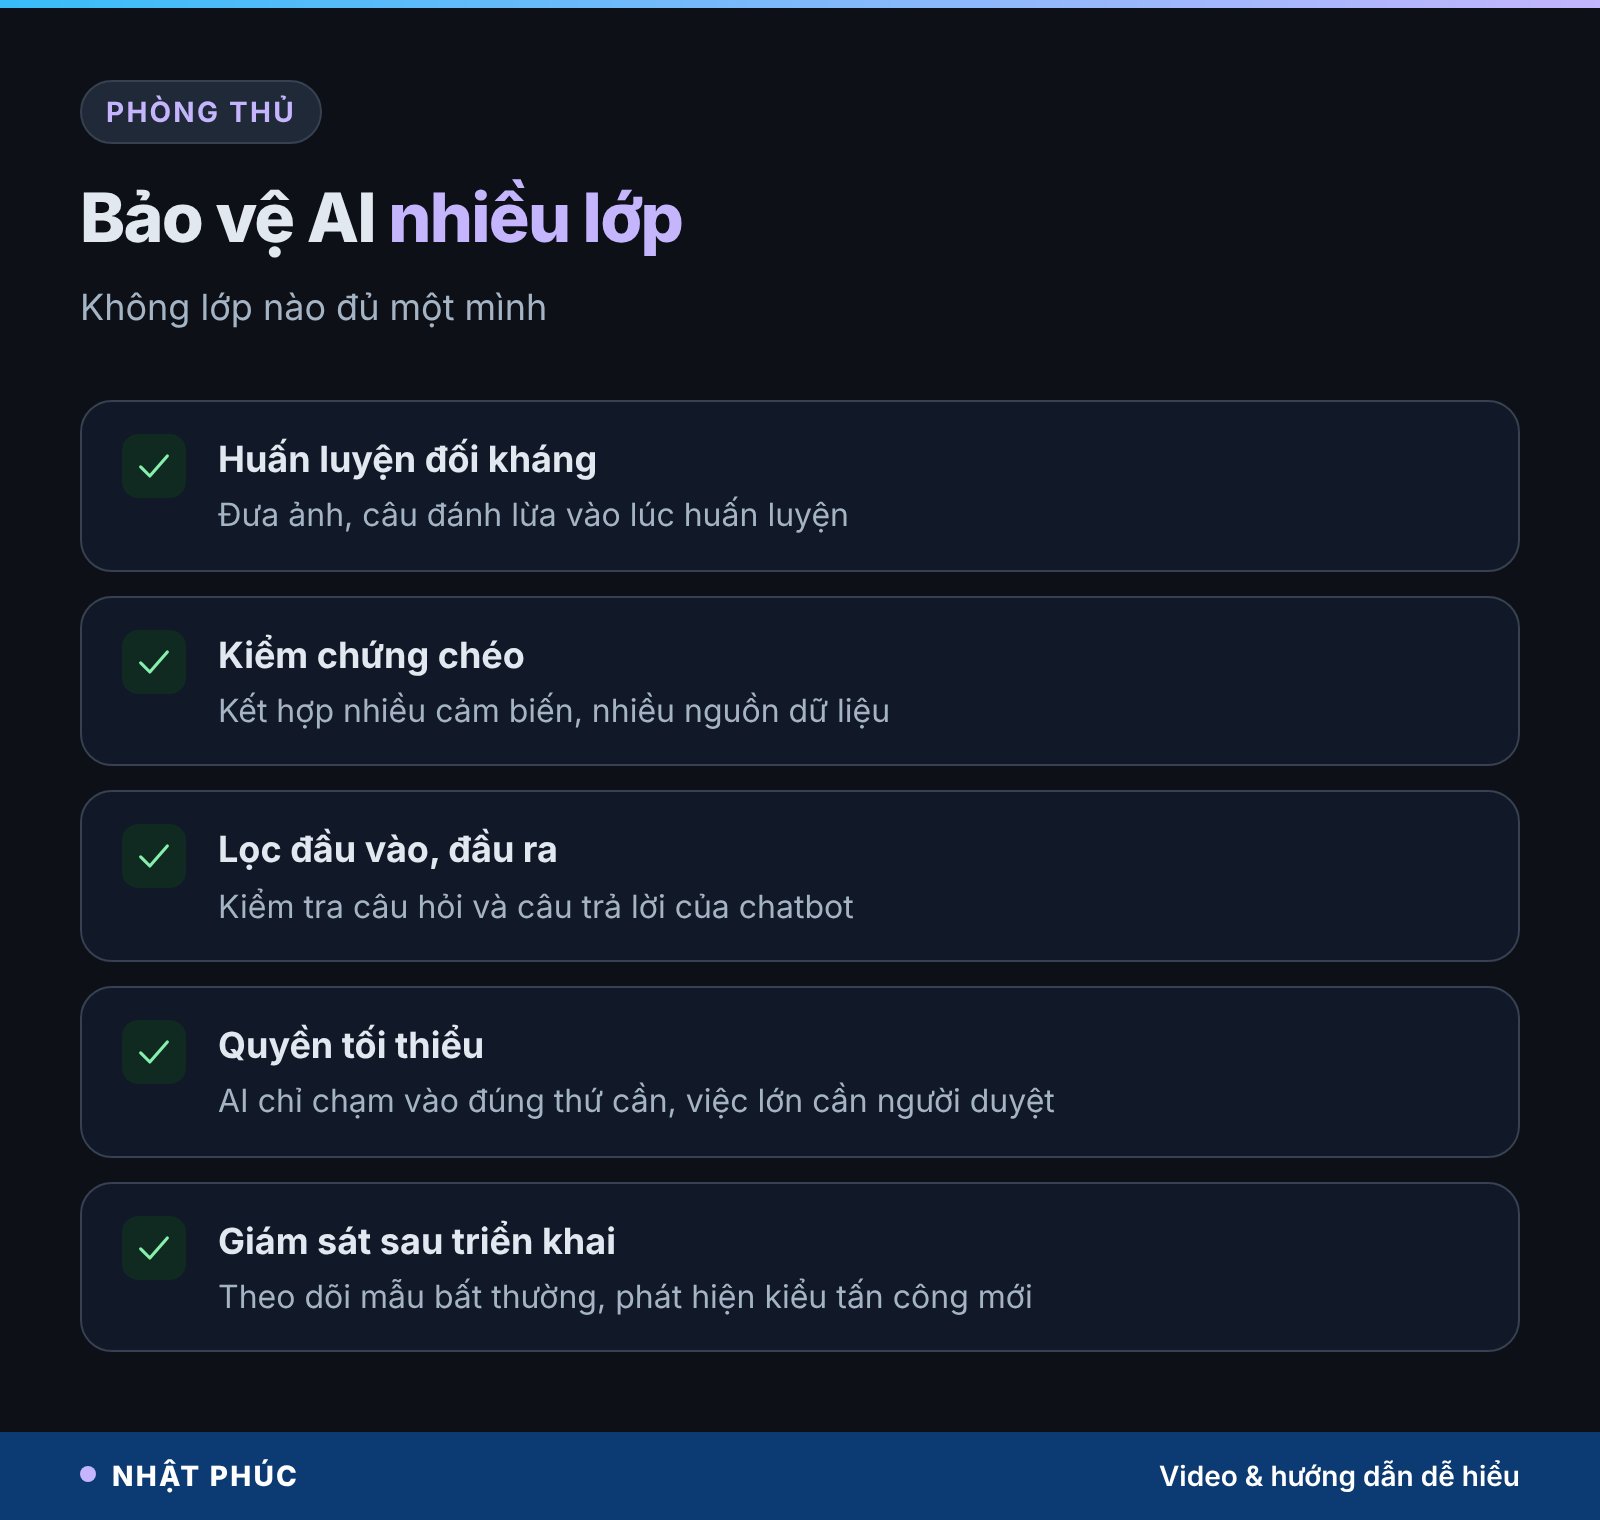
- Huấn luyện đối kháng (adversarial training): tự tạo dữ liệu đánh lừa rồi đưa vào lúc huấn luyện, giống cho võ sĩ tập với đối thủ chuyên đánh vào điểm yếu.
- Nhiều nguồn kiểm chứng chéo: xe tự hành không chỉ dựa vào một camera mà kết hợp bản đồ, radar hoặc cảm biến khác; một miếng dán khó lừa tất cả cùng lúc.
- Lọc đầu vào và đầu ra: với chatbot, thêm lớp kiểm tra câu hỏi và câu trả lời trước khi hiển thị hoặc thực thi.
- Quyền tối thiểu: AI agent chỉ được truy cập đúng những gì cần, việc quan trọng phải có người xác nhận.
- Giám sát sau triển khai: theo dõi các mẫu bất thường để phát hiện kiểu tấn công mới.
Giới hạn cần biết: huấn luyện đối kháng giúp mô hình cứng cáp hơn với kiểu tấn công đã biết, nhưng thường làm giảm chút độ chính xác và chưa chặn được mọi kiểu mới. Cho tới nay chưa có cách nào được xem là giải quyết trọn vẹn. Vì vậy với những việc liên quan đến an toàn như xe cộ, kiểm soát ra vào hay y tế, cần giữ con người trong vòng kiểm soát khi cái giá của một lần nhầm quá lớn.
Tự red team chatbot của bạn: 7 bước
Nếu cửa hàng, trường học hay công ty bạn đang dùng chatbot AI trả lời khách hoặc trợ lý AI nội bộ, bạn có thể tự làm một đợt red teaming nhỏ. Nguyên tắc số một: chỉ thử trên hệ thống mình sở hữu hoặc được cho phép bằng văn bản.
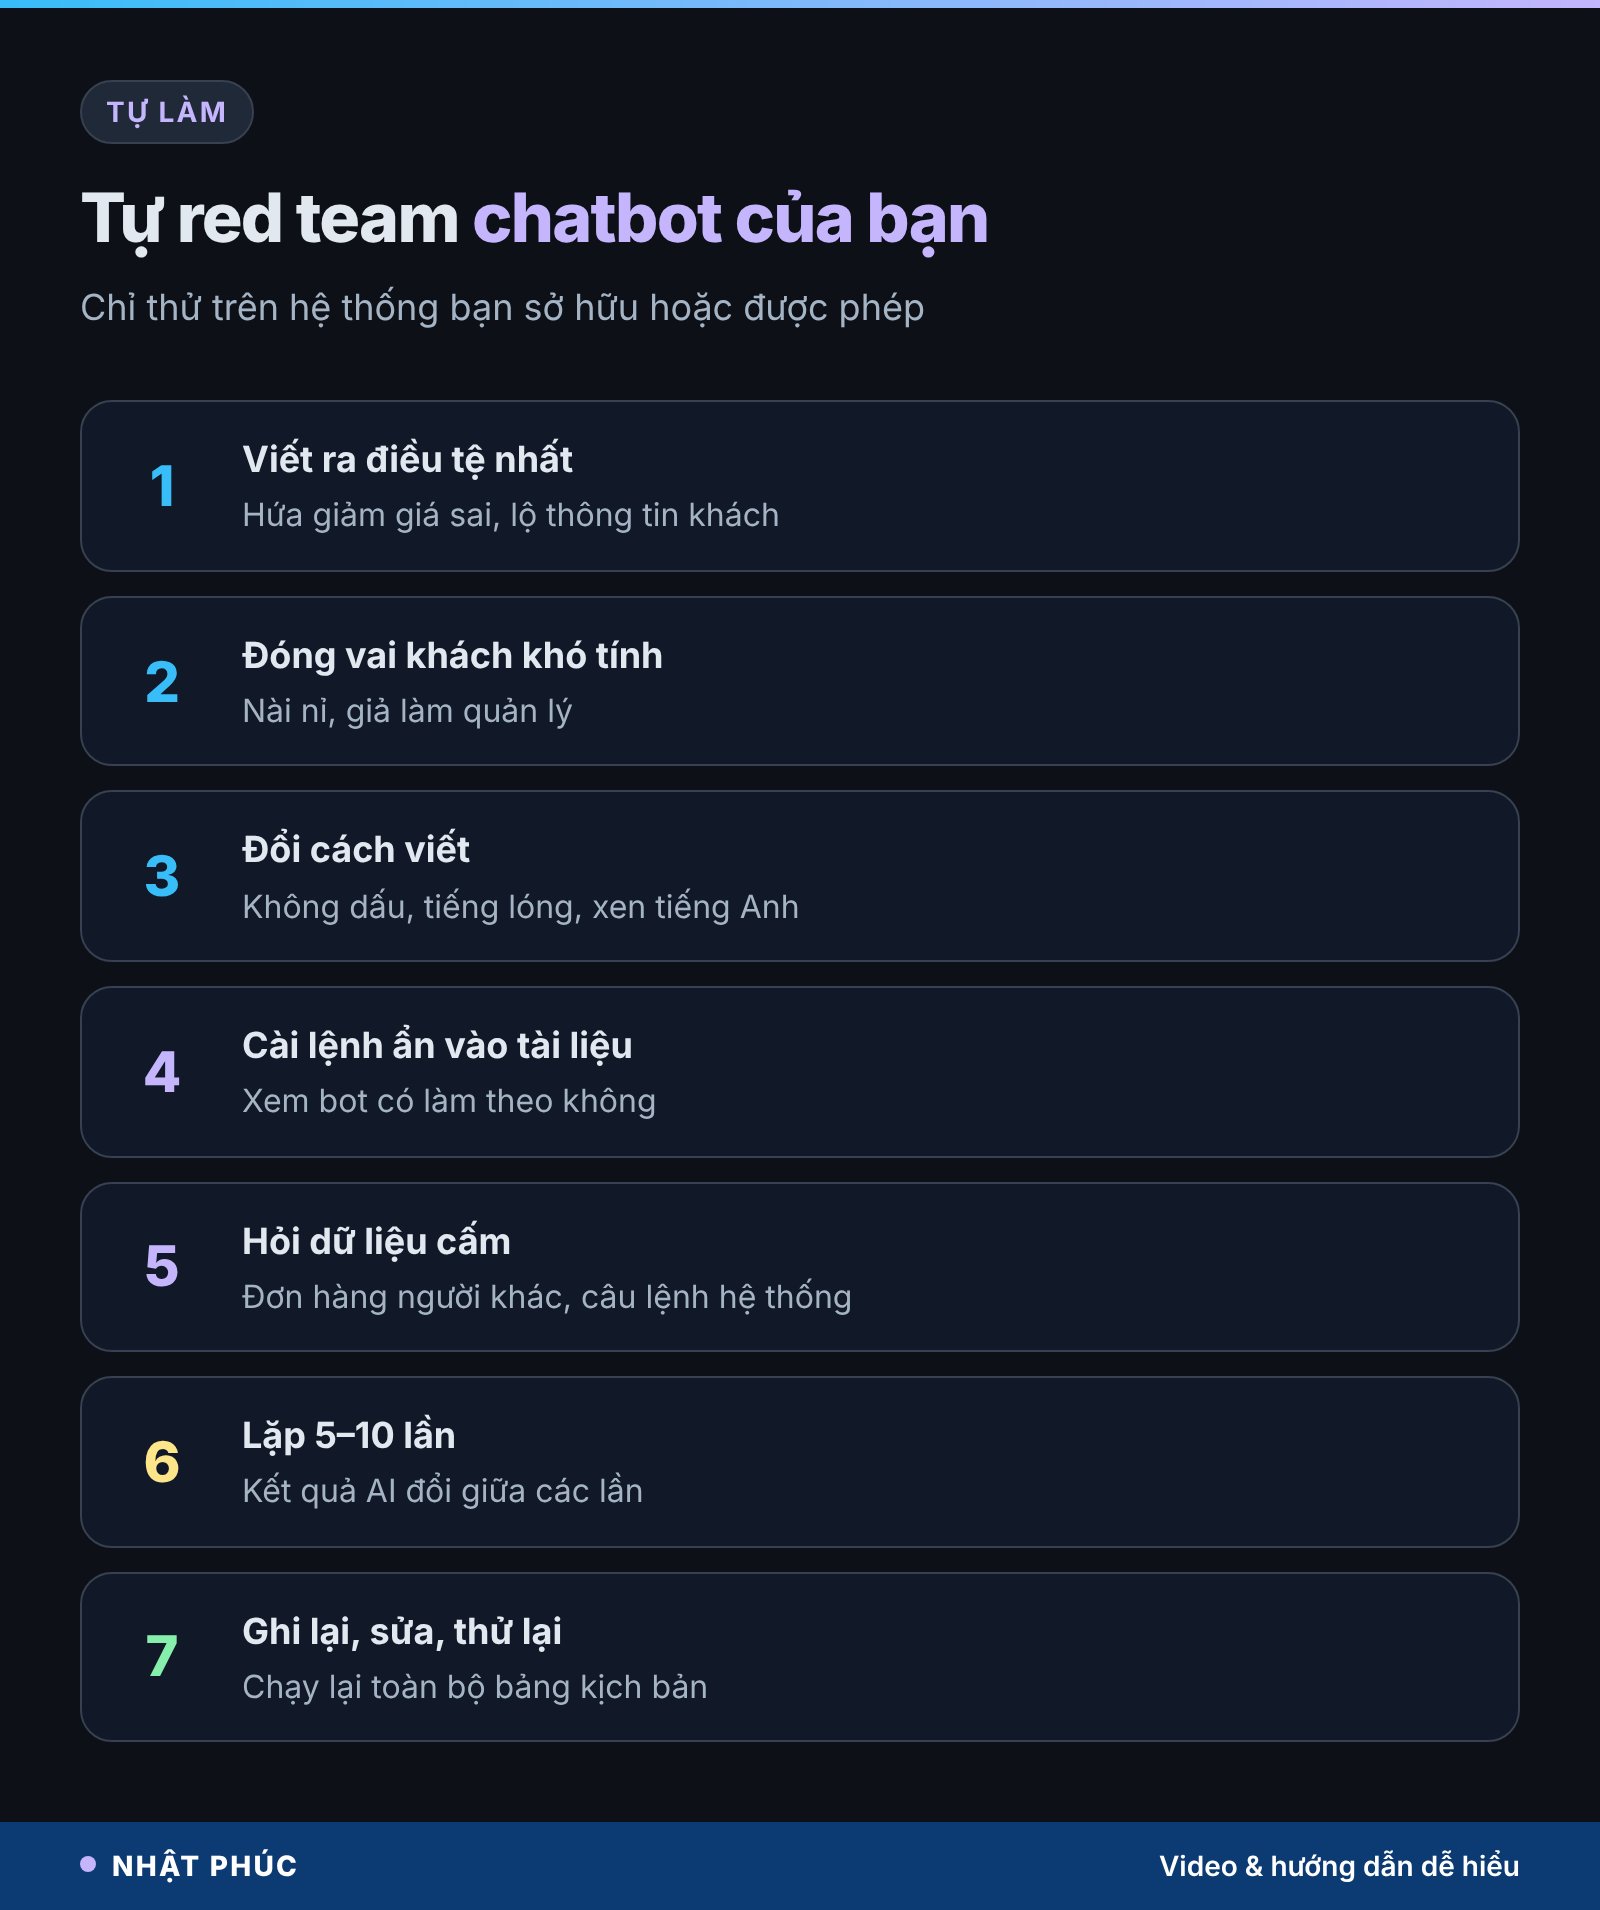
1. Viết ra điều tệ nhất có thể xảy ra
Ví dụ: bot hứa giảm giá sai, tiết lộ thông tin khách khác, trả lời sai chính sách bảo hành, nói lời xúc phạm.
2. Đóng vai khách khó tính
Hỏi vòng vo, nài nỉ, giả làm quản lý, đòi bot “bỏ qua quy định cũ”. Ghi lại câu nào khiến bot lung lay.
3. Thử bằng nhiều cách viết
Tiếng Việt không dấu, tiếng lóng, tiếng Anh xen kẽ, viết sai chính tả cố ý. Rào chắn hay yếu ở các biến thể này.
4. Cài lệnh ẩn vào tài liệu
Nếu bot đọc tài liệu hoặc trang web, thử thêm một dòng lệnh lạ vào tài liệu thử nghiệm xem bot có làm theo không.
5. Hỏi về dữ liệu không được phép
Hỏi đơn hàng của người khác, cấu hình hệ thống, nội dung câu lệnh hệ thống (system prompt).
6. Lặp lại nhiều lần
Mỗi kịch bản thử ít nhất 5–10 lần, vì kết quả AI thay đổi giữa các lần hỏi.
7. Ghi lại, sửa, thử lại
Lưu bảng gồm câu hỏi, kết quả, mức độ hại. Sửa câu lệnh hệ thống, thu hẹp quyền, thêm bước xác nhận, rồi chạy lại toàn bộ bảng.
Hiểu lầm phổ biến về red teaming AI
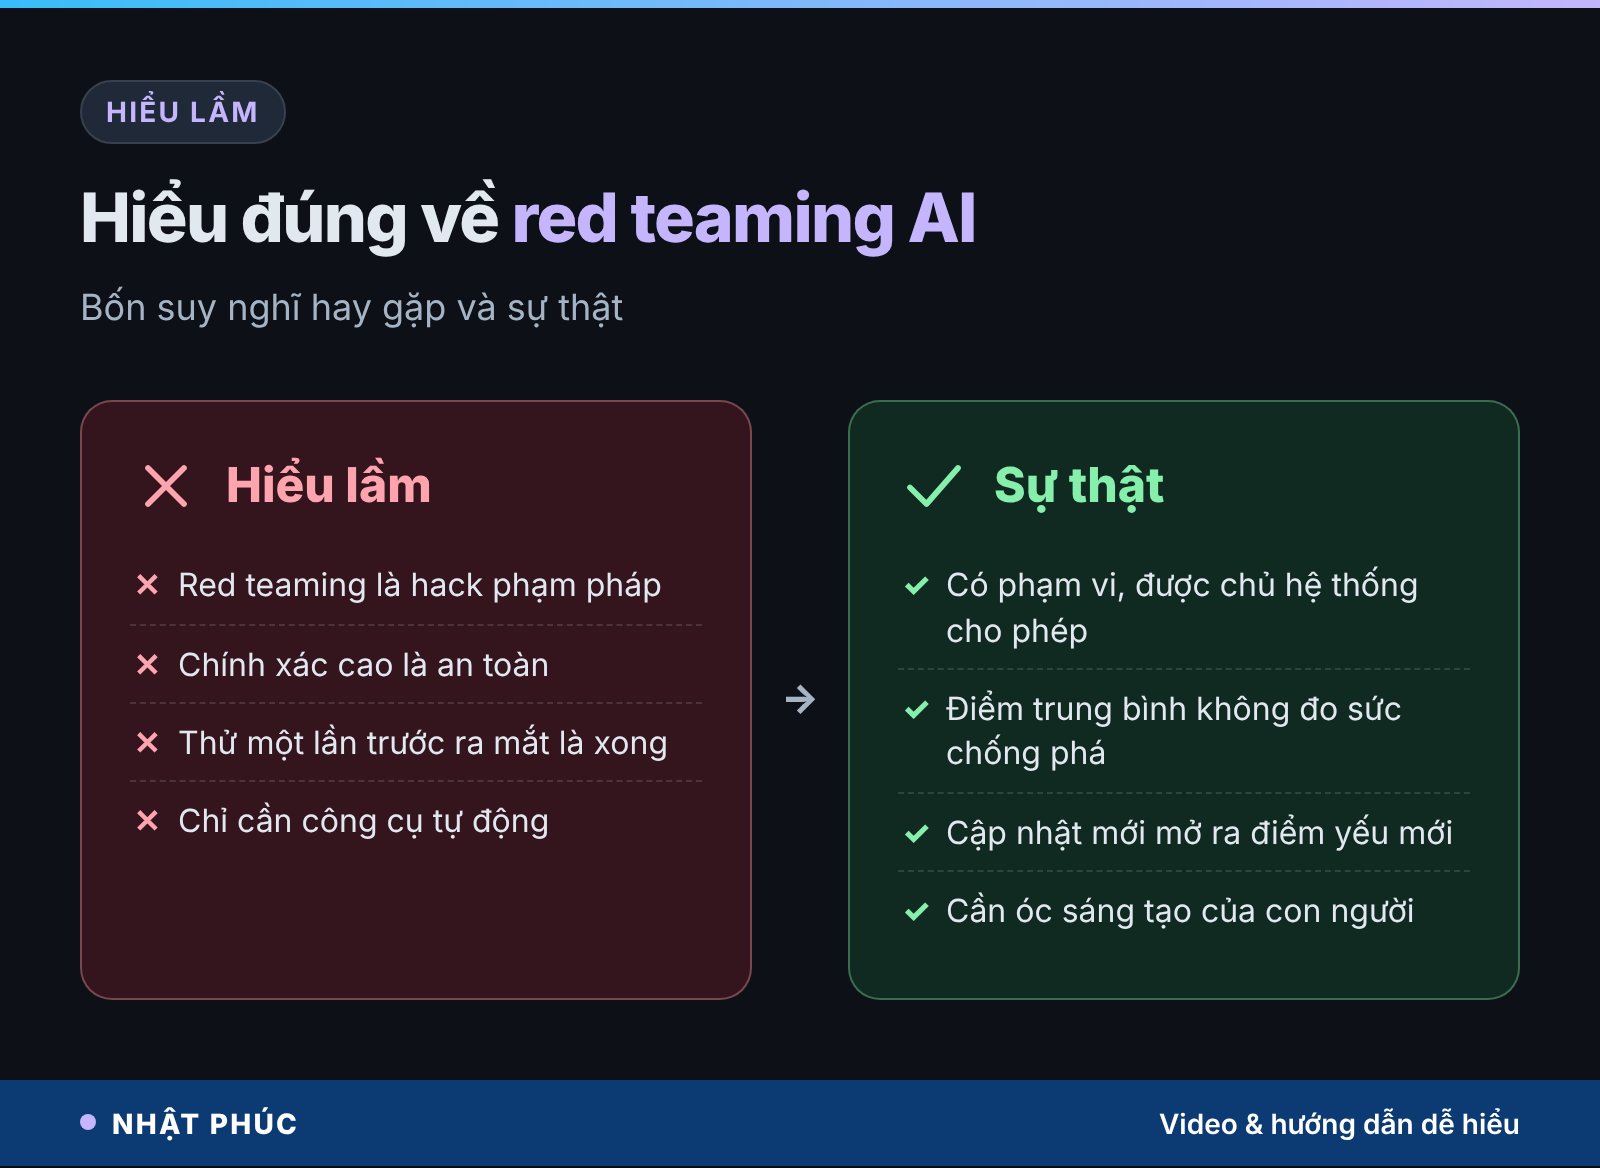
“Red teaming là hack, nên phạm pháp”
Red teaming được làm có phạm vi rõ ràng, có sự cho phép của chủ hệ thống và mục tiêu là vá lỗi. Thử tấn công hệ thống của người khác khi chưa được phép thì không phải red teaming.
“Mô hình đạt độ chính xác cao thì an toàn”
Ví dụ gấu trúc hoá vượn cho thấy điều ngược lại: độ chính xác cao trên dữ liệu bình thường không nói gì về khả năng chống người cố tình phá.
“Làm một lần trước khi ra mắt là xong”
Mỗi lần cập nhật mô hình, thêm tính năng hay kết nối công cụ mới đều mở ra điểm yếu mới, nên red teaming phải lặp lại.
“Chỉ cần công cụ tự động”
Công cụ giúp thử nhanh, nhưng kiểu tấn công sáng tạo và hiểu ngữ cảnh văn hoá vẫn cần con người.
Câu hỏi thường gặp về red teaming AI
Red teaming AI và ví dụ đối kháng khác nhau thế nào?
Ví dụ đối kháng là một loại “vũ khí”: dữ liệu bị chỉnh nhẹ để đánh lừa mô hình. Red teaming là cả quy trình tấn công thử, trong đó tạo ví dụ đối kháng chỉ là một kỹ thuật, bên cạnh đầu độc dữ liệu, moi thông tin riêng tư, bẻ khoá hay chèn lệnh vào chatbot.
Ai nên làm red teaming AI?
Bất kỳ ai đưa AI vào sản phẩm hoặc quy trình có ảnh hưởng tới khách hàng, tiền bạc, sức khoẻ hay an toàn. Công ty lớn có đội riêng; doanh nghiệp nhỏ có thể tự làm theo checklist hoặc thuê đơn vị bảo mật có kinh nghiệm với AI.
Red teaming có làm AI an toàn tuyệt đối không?
Không. Nó giảm rủi ro bằng cách tìm và vá những lỗ hổng tìm được, nhưng luôn có thể còn kiểu tấn công chưa ai nghĩ ra. Vì vậy cần thêm nhiều lớp phòng thủ, giám sát sau triển khai và con người kiểm soát ở các quyết định quan trọng.
Tấn công đối kháng ngoài đời có dễ không?
Khó hơn trong phòng thí nghiệm. Nhiều thí nghiệm cần biết rõ mô hình hoặc điều kiện góc nhìn, ánh sáng thuận lợi. Tuy vậy nguy cơ là có thật, nhất là với hệ thống công khai mà ai cũng có thể thử đi thử lại.
Người dùng bình thường có cần quan tâm không?
Có, ở mức hiểu giới hạn: đừng tin tuyệt đối vào kết quả nhận diện hay câu trả lời của AI trong việc quan trọng, kiểm chứng lại thông tin, và cảnh giác khi trợ lý AI có quyền thao tác thay bạn.
Kết luận
Máy không bị đánh lừa vì nó ngốc, mà vì nó nhìn thế giới bằng một cặp mắt khác. Red teaming AI là cách con người chủ động đi tìm những điểm mù ấy: đóng vai kẻ tấn công, thử đủ kiểu từ ảnh nhiễu đến câu hỏi khéo, rồi vá và thử lại. Một mô hình giỏi trong điều kiện bình thường chỉ thật sự đáng tin khi đã đứng vững trước người cố tình làm nó sai.
Bạn đã từng thấy AI nhìn nhầm hay trả lời sai điều gì đáng nhớ chưa? Hãy kể ở phần bình luận, và theo dõi Nhật Phúc cùng kênh Vọc Sĩ để không bỏ lỡ những bài giải thích công nghệ AI dễ hiểu tiếp theo.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.