Chỉ một tuần sau Gemini 4 Hydrogen, Google lại tung thêm một cái tên mới: Gemini 4 Neon. Nếu bạn đang thắc mắc “lại thêm một mô hình nữa thì khác gì”, bài này dành cho bạn. Chúng ta sẽ xem Neon đứng ở đâu trong dòng Gemini 4, các bảng điểm benchmark thực chất đo gì, giá API so với Claude Opus 5.5 và GPT-6.2 Sol ra sao, và người dùng ở Việt Nam nên chọn bản nào cho công việc của mình.
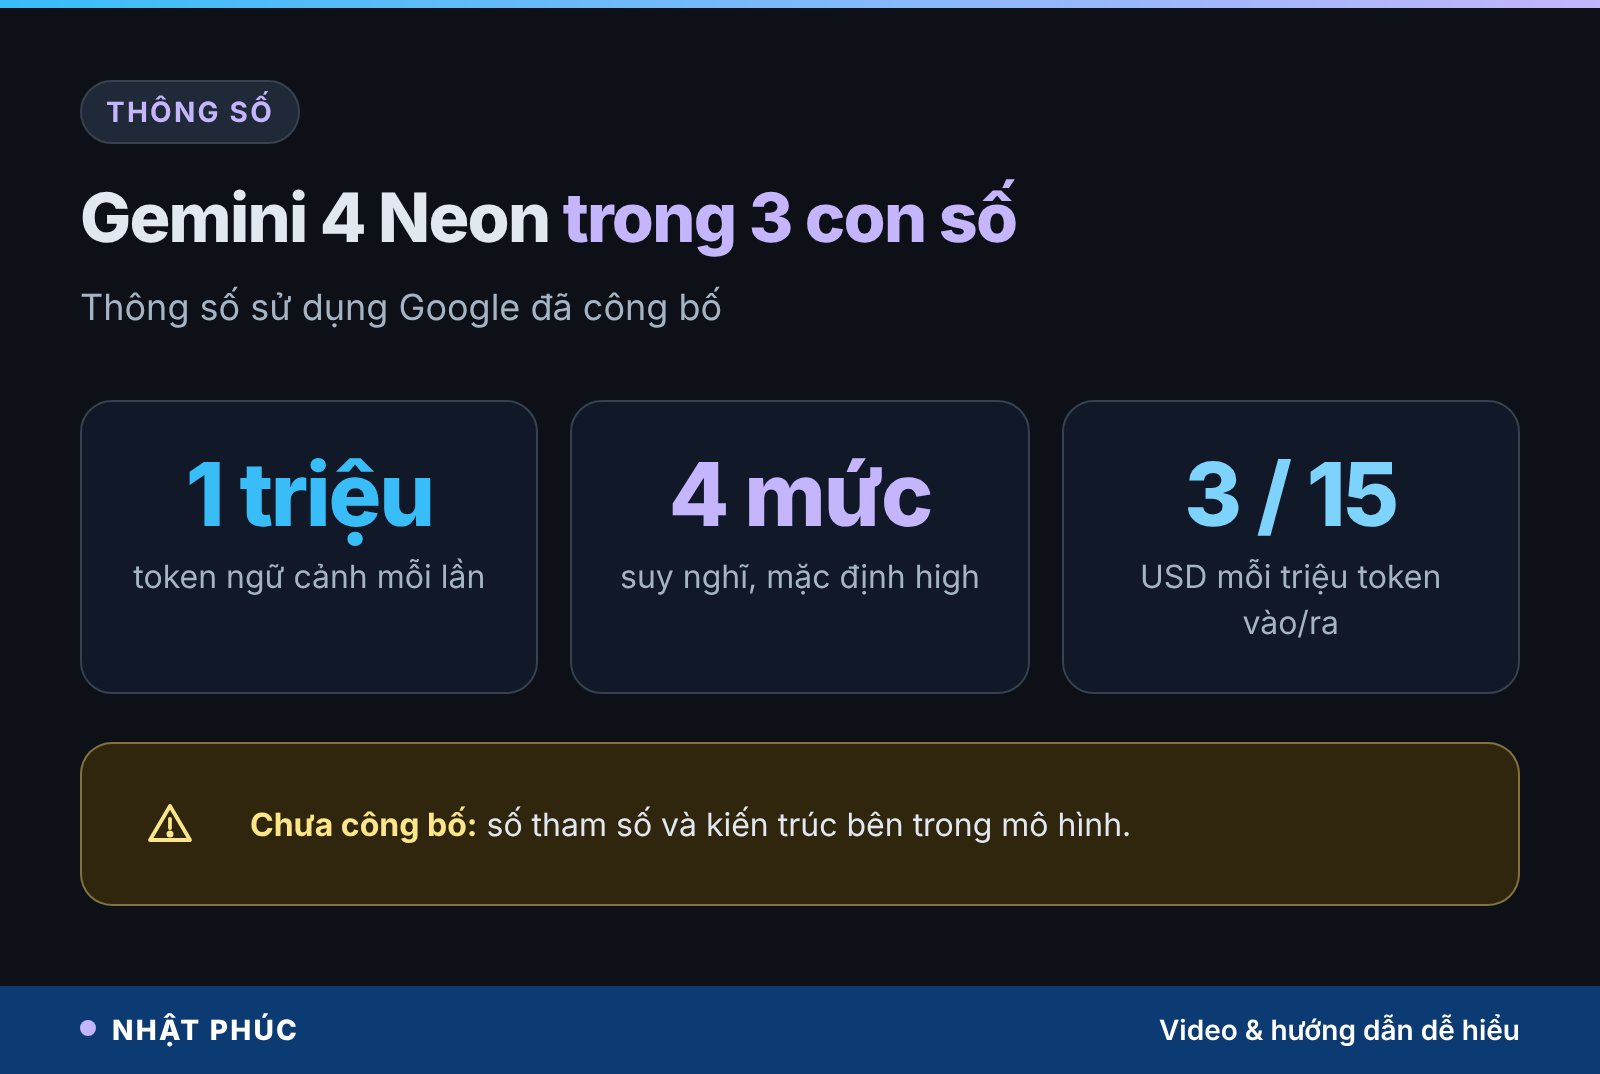
Câu trả lời ngắn: Gemini 4 Neon là mô hình “tầm trung” mới của Google, công bố lúc 4 giờ sáng 19/11/2026 (giờ Việt Nam). Neon có ngữ cảnh 1 triệu token, 4 mức suy nghĩ, giá API 3 USD cho 1 triệu token đầu vào và 15 USD cho 1 triệu token đầu ra. Google cho biết Neon đạt điểm gần các mô hình hàng đầu ở lập trình, phân tích và tự động hoá, nhưng chi phí mỗi tác vụ thấp hơn đáng kể.
Tóm tắt nhanh
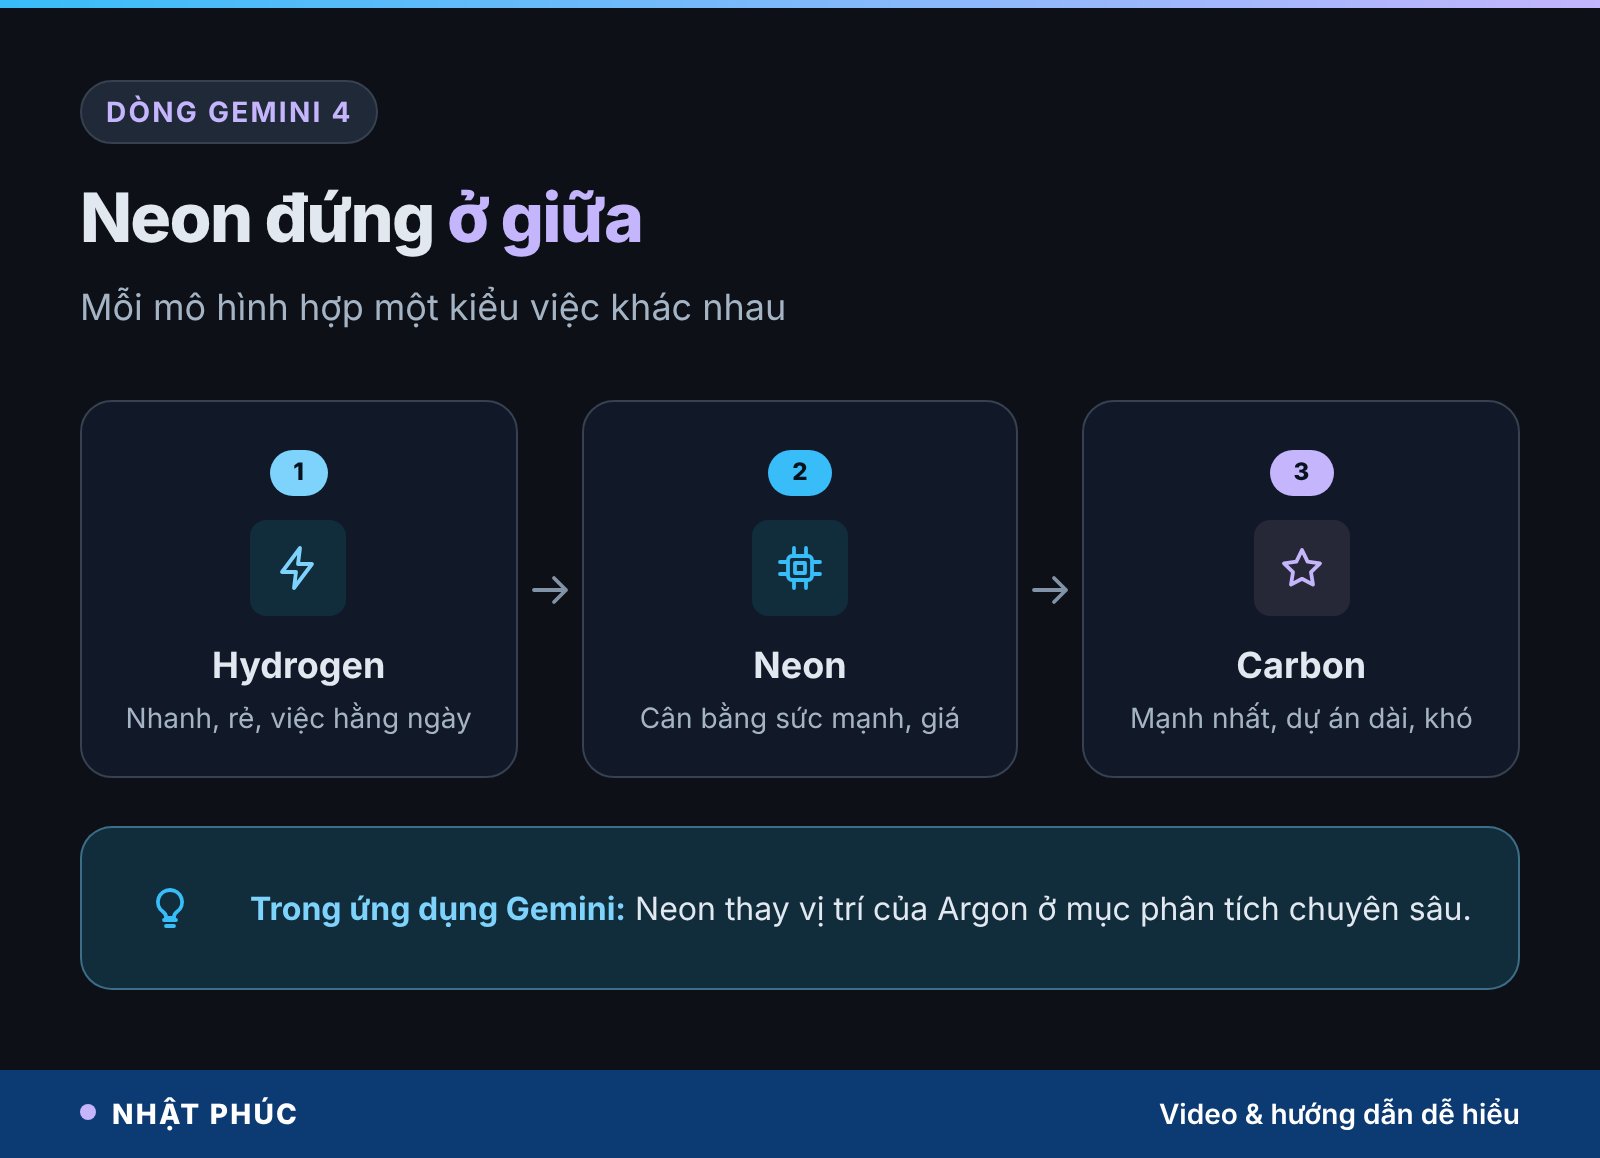
- Neon nằm giữa Hydrogen (nhanh, rẻ) và Carbon (mạnh nhất, cho dự án dài), nhắm vào lập trình, phân tích dữ liệu và quy trình doanh nghiệp.
- Giá API: 3 USD/15 USD mỗi 1 triệu token vào/ra, đầu vào đã lưu cache chỉ 0,15 USD (rẻ hơn 95%).
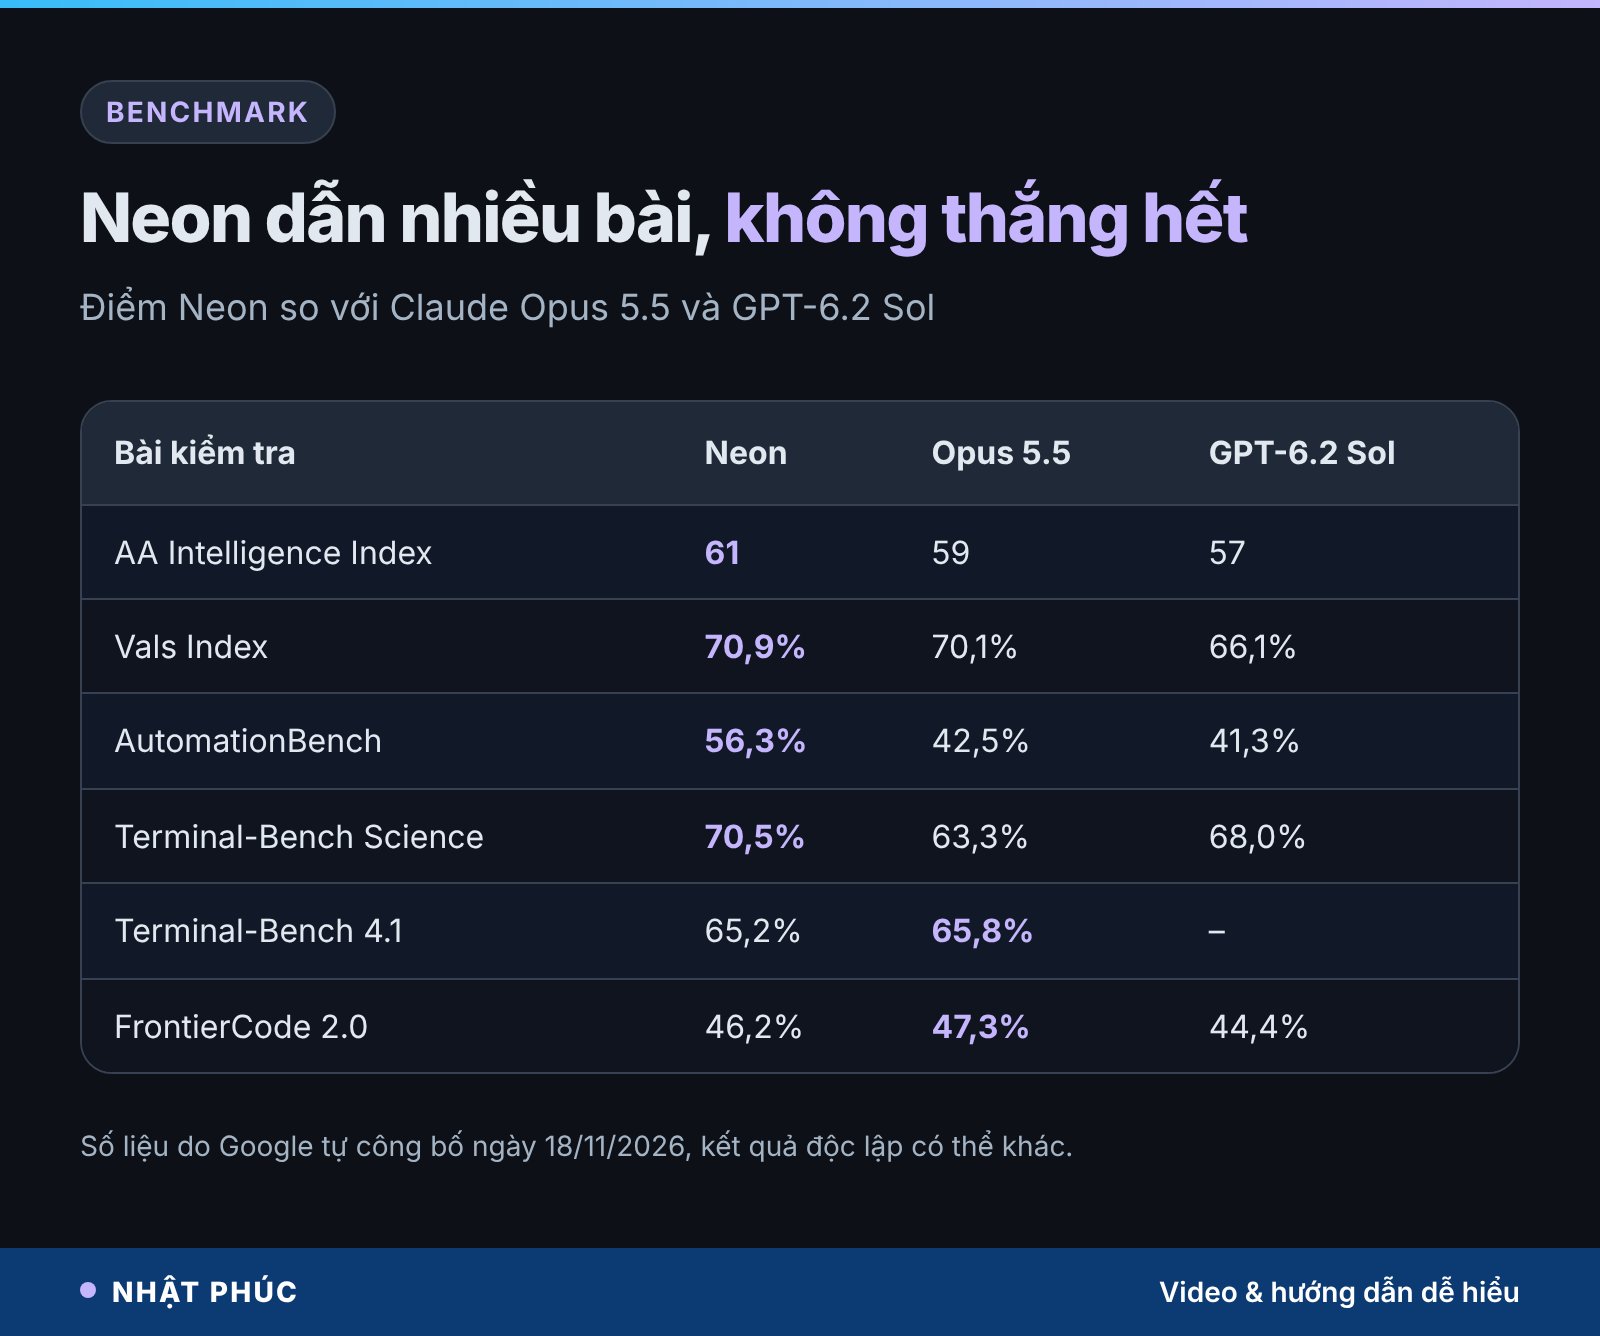
- Theo số Google công bố, Neon đạt 61 điểm Artificial Analysis Intelligence Index và 56,3% AutomationBench, nhưng vẫn thua Opus 5.5 ở Terminal-Bench 4.1 và FrontierCode 2.0.
- Cùng một mô hình, đổi “bộ khung chạy thử” (harness) có thể làm điểm lệch gấp 3 lần, nên đừng đọc benchmark như bảng xếp hạng tuyệt đối.
- Người dùng gói Google AI Pro và Ultra chọn được Neon trong ứng dụng Gemini; lập trình viên dùng qua Gemini API bản trả phí.
Nội dung chính:
- Gemini 4 Neon là gì, đứng ở đâu trong dòng Gemini 4
- Thông số chính của Gemini 4 Neon
- Benchmark của Gemini 4 Neon thực chất đo gì
- Vì sao cùng một bài test mà điểm lệch gấp 3 lần
- Giá Gemini 4 Neon so với Opus 5.5 và GPT-6.2 Sol
- Cached input là gì, vì sao rẻ hơn 95%
- Chọn Hydrogen, Neon hay Carbon cho việc gì
- Dùng Gemini 4 Neon ở Việt Nam
- An toàn, rủi ro và giới hạn cần biết
- Hiểu lầm phổ biến
- Câu hỏi thường gặp
Gemini 4 Neon là gì, đứng ở đâu trong dòng Gemini 4
Gemini 4 Neon là mô hình ngôn ngữ lớn mới nhất của Google DeepMind, được giới thiệu trên blog chính thức của Google ngày 18/11/2026 theo giờ quốc tế. Google mô tả Neon là mô hình cân bằng giữa độ sâu và hiệu quả: đủ thông minh để làm việc khó, nhưng nhanh và rẻ hơn mô hình cao cấp nhất.
Để dễ hình dung, hãy coi dòng Gemini 4 như đội ngũ của một văn phòng:
- Hydrogen là nhân viên nhanh nhẹn, xử lý việc hằng ngày như trả lời câu hỏi, tóm tắt, phân loại.
- Neon là chuyên viên chính, làm việc cần suy nghĩ kỹ như viết code phức tạp, phân tích số liệu, chạy quy trình nhiều bước.
- Carbon là chuyên gia cấp cao, dành cho dự án dài hơi, khó nhất.
Trong ứng dụng Gemini, Neon thay vị trí của Argon (mô hình suy luận đầu tiên của dòng Gemini 4) ở mục phân tích chuyên sâu. Nếu bạn muốn hiểu lịch sử ra mắt các bản Argon, Carbon, Hydrogen và các mức suy nghĩ, xem bài Gemini 4 Hydrogen là gì và khác Argon, Carbon thế nào. Bài này đi tiếp phần còn thiếu: Neon mạnh cỡ nào, tốn bao nhiêu, và khi nào nên dùng.
Thông số chính của Gemini 4 Neon
Google không công bố kích thước hay kiến trúc bên trong của Neon (số tham số, có dùng kiểu chuyên gia hỗn hợp hay không). Những gì đã công bố chủ yếu là thông số sử dụng:
- Cửa sổ ngữ cảnh 1 triệu token: một lần có thể đưa vào lượng chữ tương đương vài cuốn sách hoặc cả một kho mã nguồn vừa phải. Token là đơn vị chữ mà AI đọc, thường ngắn hơn một từ.
- 4 mức suy nghĩ (thinking levels), mặc định là mức high. Mức cao nhất là xhigh: suy nghĩ lâu hơn, tốn token hơn, nhưng làm bài khó tốt hơn.
- Giá API: 3 USD cho 1 triệu token đầu vào, 15 USD cho 1 triệu token đầu ra, 0,15 USD cho 1 triệu token đầu vào đã lưu cache.
- Mã mô hình trên Gemini API: gemini-4-neon.
Về tốc độ, trang đo độc lập Artificial Analysis ghi nhận Neon xuất khoảng 110 token mỗi giây ở mức xhigh trong ngày ra mắt (theo VentureBeat). Đây là con số đo sớm, có thể thay đổi khi hạ tầng ổn định.
Vì sao một mô hình lớn có thể chạy nhanh và rẻ? Một hướng phổ biến hiện nay là chỉ “đánh thức” một phần mô hình cho mỗi câu hỏi, bạn có thể đọc thêm trong bài MoE là gì và vì sao AI nghìn tỷ tham số vẫn chạy rẻ. Lưu ý Google chưa xác nhận Neon dùng cách này.
Benchmark của Gemini 4 Neon thực chất đo gì
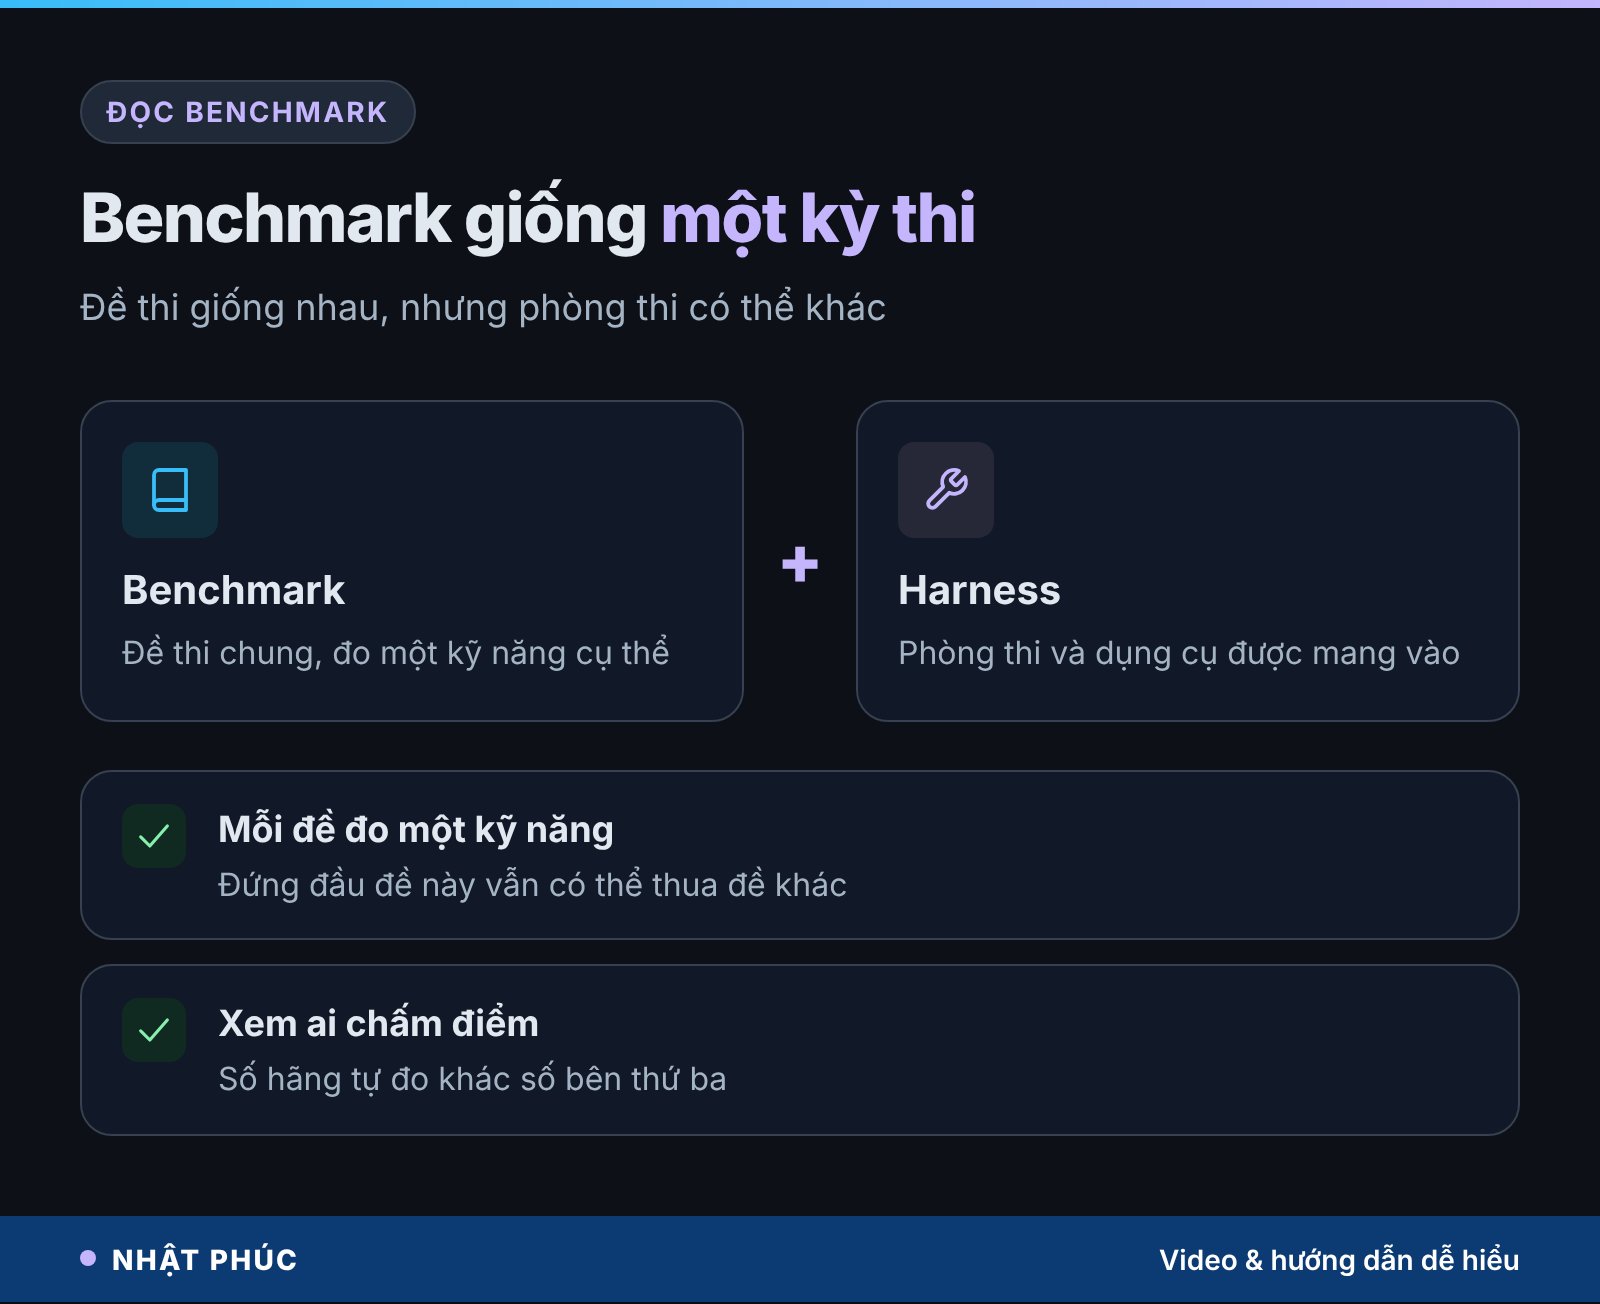
Benchmark là bộ bài kiểm tra chuẩn để so sánh các mô hình AI, giống đề thi chung cho mọi thí sinh. Vấn đề là mỗi đề đo một kỹ năng khác nhau, nên một mô hình có thể đứng đầu đề này mà thua ở đề khác. Lưu ý quan trọng: toàn bộ số liệu dưới đây do Google tự công bố trong bài ra mắt, kết quả kiểm tra độc lập có thể khác.
Các bài kiểm tra tổng hợp
Artificial Analysis Intelligence Index gộp nhiều bài test về suy luận, kiến thức, toán và lập trình thành một điểm chung. Neon đạt 61 điểm ở mức xhigh, Claude Opus 5.5 đạt 59, GPT-6.2 Sol đạt 57. Google cho biết điểm này xếp Neon thứ 3 tổng thể, sau các mô hình lớn hơn và chậm hơn.
Vals Index đo công việc chuyên môn như pháp lý, tài chính, thuế. Neon đạt 70,9%, Opus 5.5 khoảng 70,1%, GPT-6.2 Sol khoảng 66,1%. Khoảng cách giữa Neon và Opus ở đây rất nhỏ, gần như ngang nhau.
Bài kiểm tra tự động hoá: AutomationBench
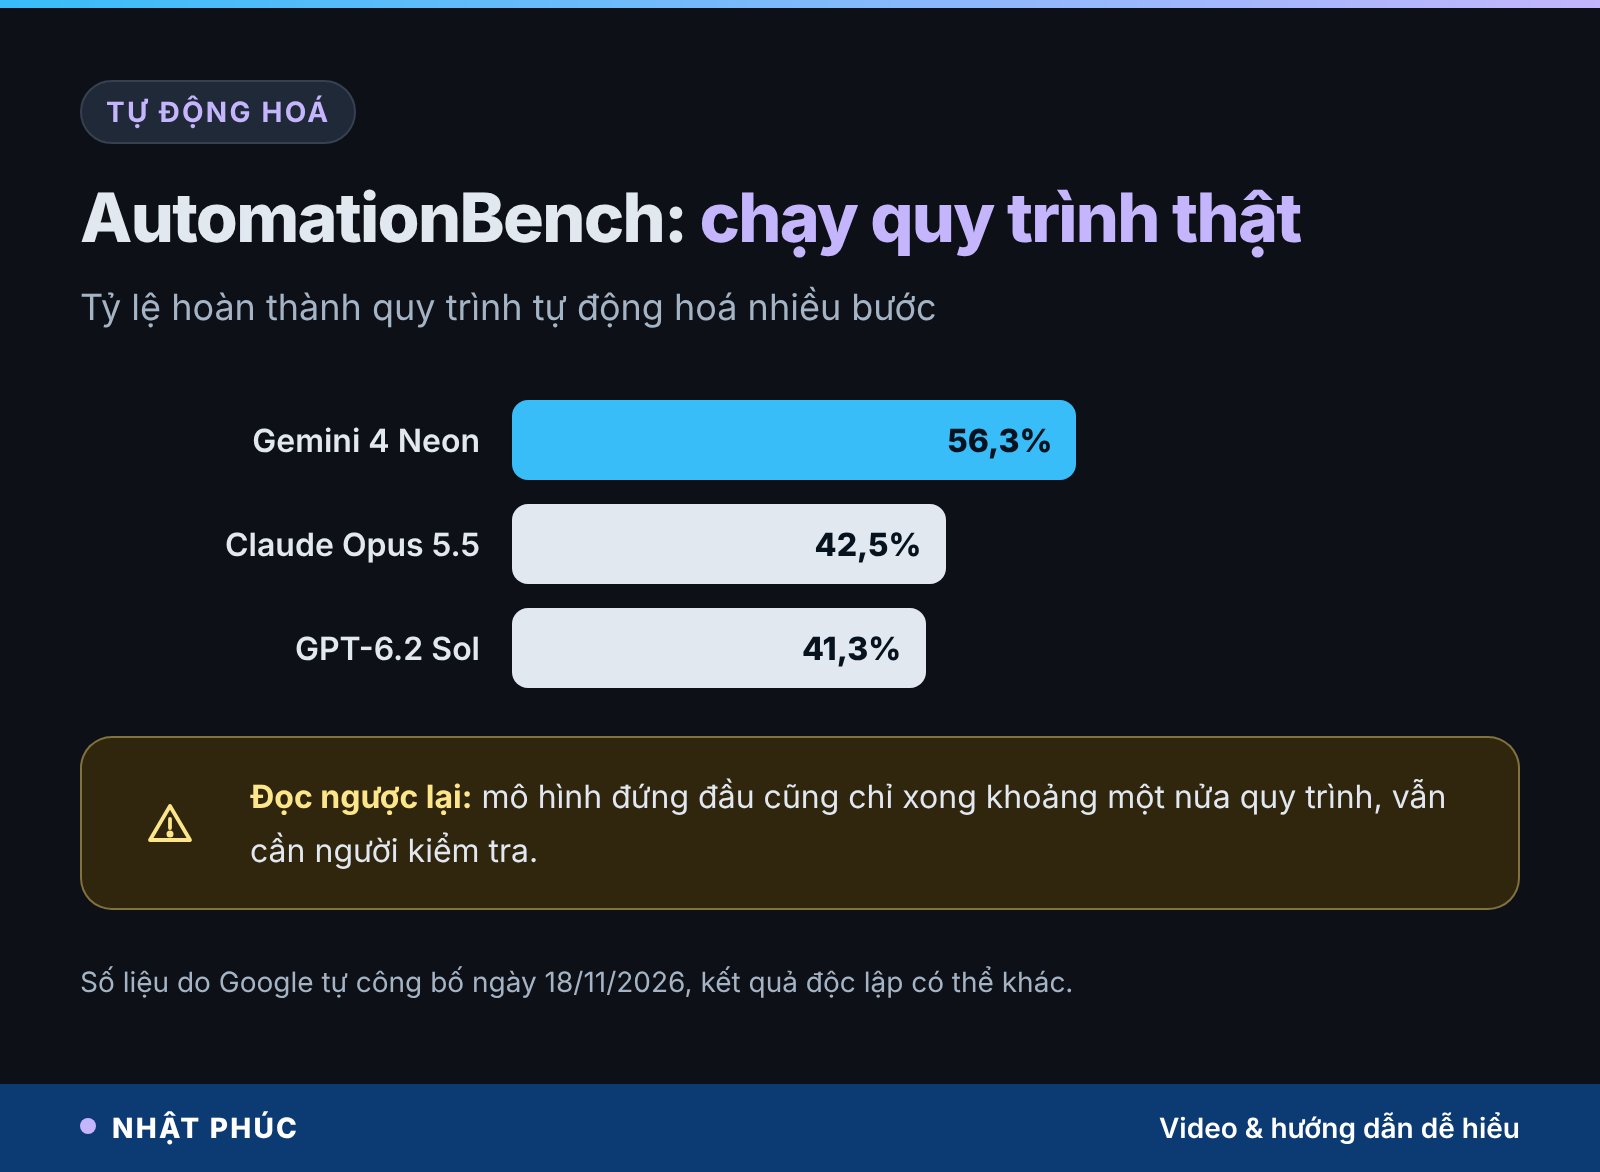
Zapier AutomationBench kiểm tra khả năng AI thực hiện quy trình tự động hoá thật: đọc yêu cầu, gọi đúng ứng dụng, chuyển dữ liệu giữa các bước. Đây là kỹ năng cốt lõi của AI agent (tác tử AI tự làm việc nhiều bước). Neon đạt 56,3%, cao hơn rõ rệt so với Opus 5.5 (42,5%) và GPT-6.2 Sol (41,3%). Nhưng cũng nên đọc ngược lại: ngay cả mô hình đứng đầu cũng chỉ hoàn thành khoảng một nửa số quy trình, nghĩa là tự động hoá bằng AI vẫn cần người kiểm tra.
Bài kiểm tra lập trình và khoa học
Terminal-Bench 4.1 giao cho AI làm việc trong cửa sổ dòng lệnh như một kỹ sư thật. Ở đây Opus 5.5 nhỉnh hơn (65,8% so với 65,2%). FrontierCode 2.0 là bài lập trình khó, Opus 5.5 cũng dẫn (47,3% so với 46,2%). Ngược lại, ở Terminal-Bench Science (làm việc khoa học qua dòng lệnh), Neon đạt 70,5%, trên GPT-6.2 Sol (68,0%) và Opus 5.5 (63,3%). Ở bài đọc biểu đồ Chartography, GPT-6.2 Sol dẫn với 75,1%, Neon 73,5%.
Vì sao cùng một bài test mà điểm lệch gấp 3 lần
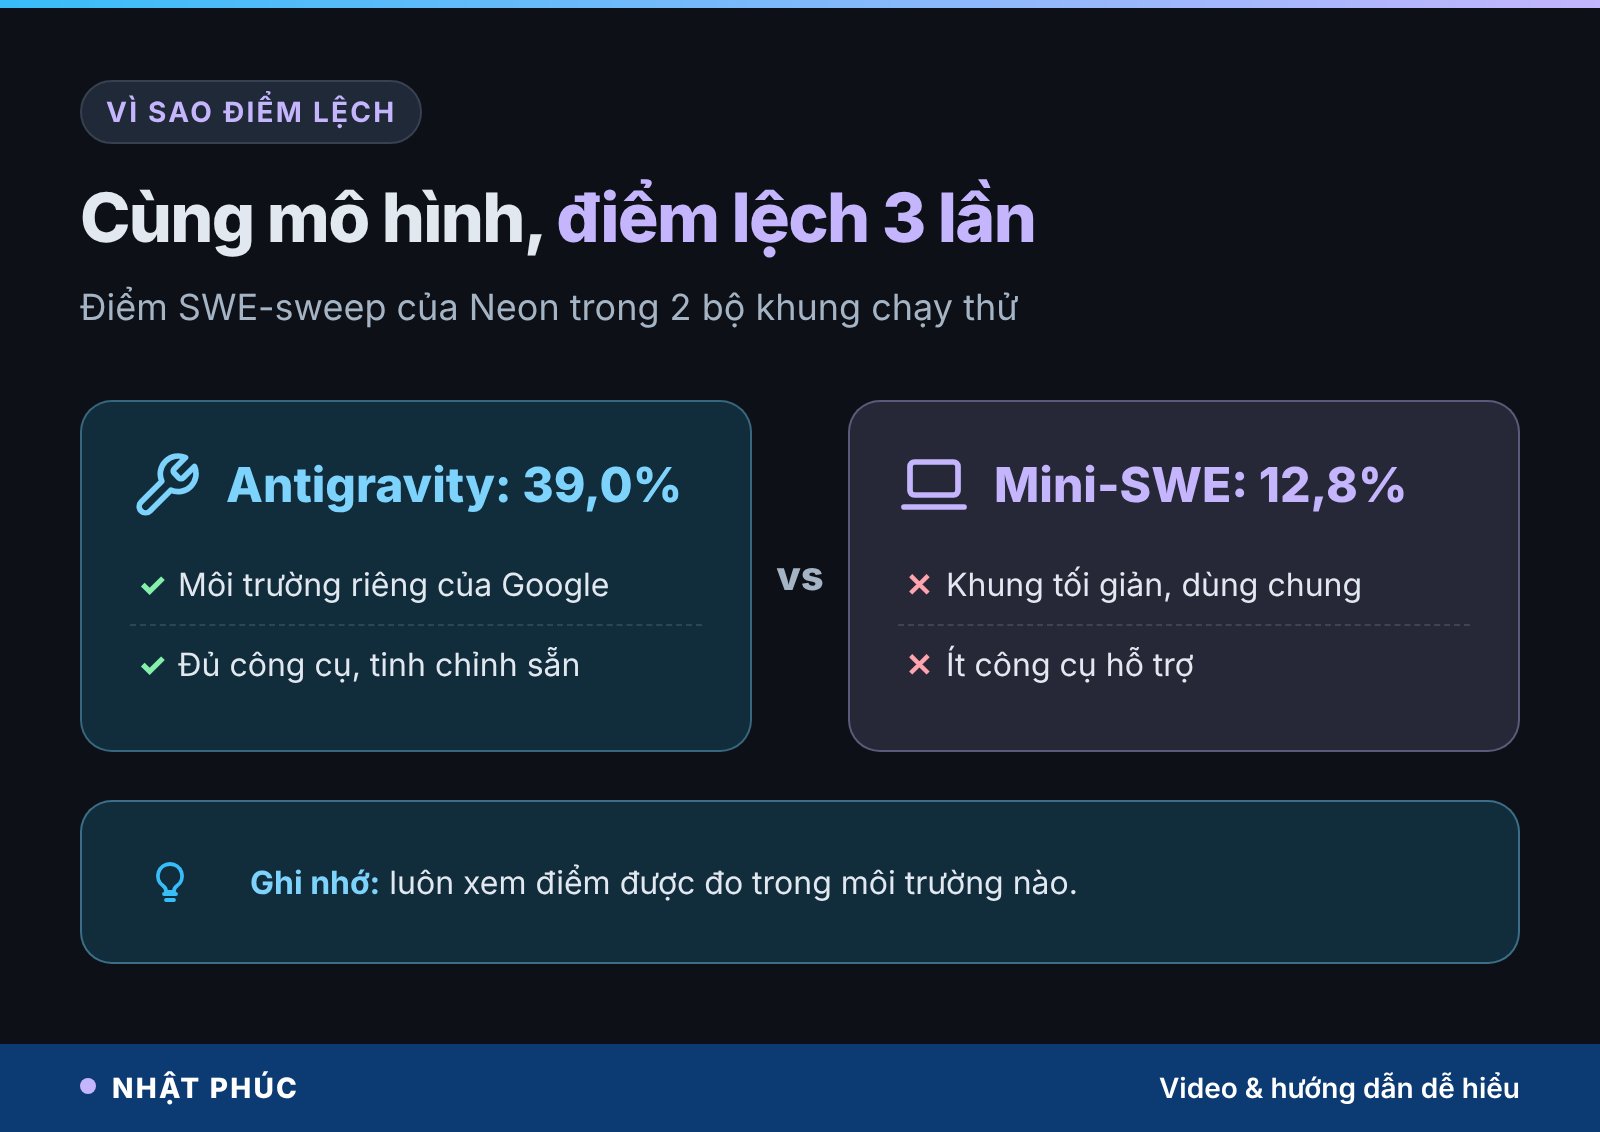
Chi tiết thú vị nhất trong bài ra mắt của Google nằm ở bài kiểm tra SWE-sweep (sửa lỗi phần mềm thật). Neon đạt 39,0% khi chạy trong Google Antigravity, nhưng chỉ 12,8% khi chạy với mini-SWE, một bộ khung chạy thử đơn giản dùng chung cho mọi mô hình. Cùng một mô hình, cùng một đề, điểm lệch hơn 3 lần.
Lý do nằm ở harness, tạm hiểu là “bộ khung” bao quanh mô hình khi làm bài. Harness quyết định AI được dùng công cụ gì, đọc file ra sao, được thử lại bao nhiêu lần, nhận gợi ý gì từ hệ thống. Antigravity là môi trường lập trình của chính Google, được tinh chỉnh để Neon làm việc tốt nhất. Mini-SWE thì tối giản, như bắt thí sinh làm bài chỉ với giấy bút.
Ví von đời thường: cùng một đầu bếp, nấu trong bếp nhà hàng quen tay với đủ dao, nồi, phụ bếp sẽ ra món ngon hơn nhiều so với khi nấu bằng bếp ga mini ngoài trời. Tài nghệ không đổi, nhưng “bếp” đổi.
Bài học khi đọc benchmark của bất kỳ hãng AI nào:
- Xem điểm được đo trong môi trường nào. Điểm trong công cụ riêng của hãng thường cao hơn môi trường chung.
- Xem mức suy nghĩ. Mỗi hãng định nghĩa “mức cao nhất” khác nhau về thời gian và chi phí.
- Ưu tiên số liệu từ bên thứ ba và tự thử trên chính công việc của bạn.
Giá Gemini 4 Neon so với Opus 5.5 và GPT-6.2 Sol
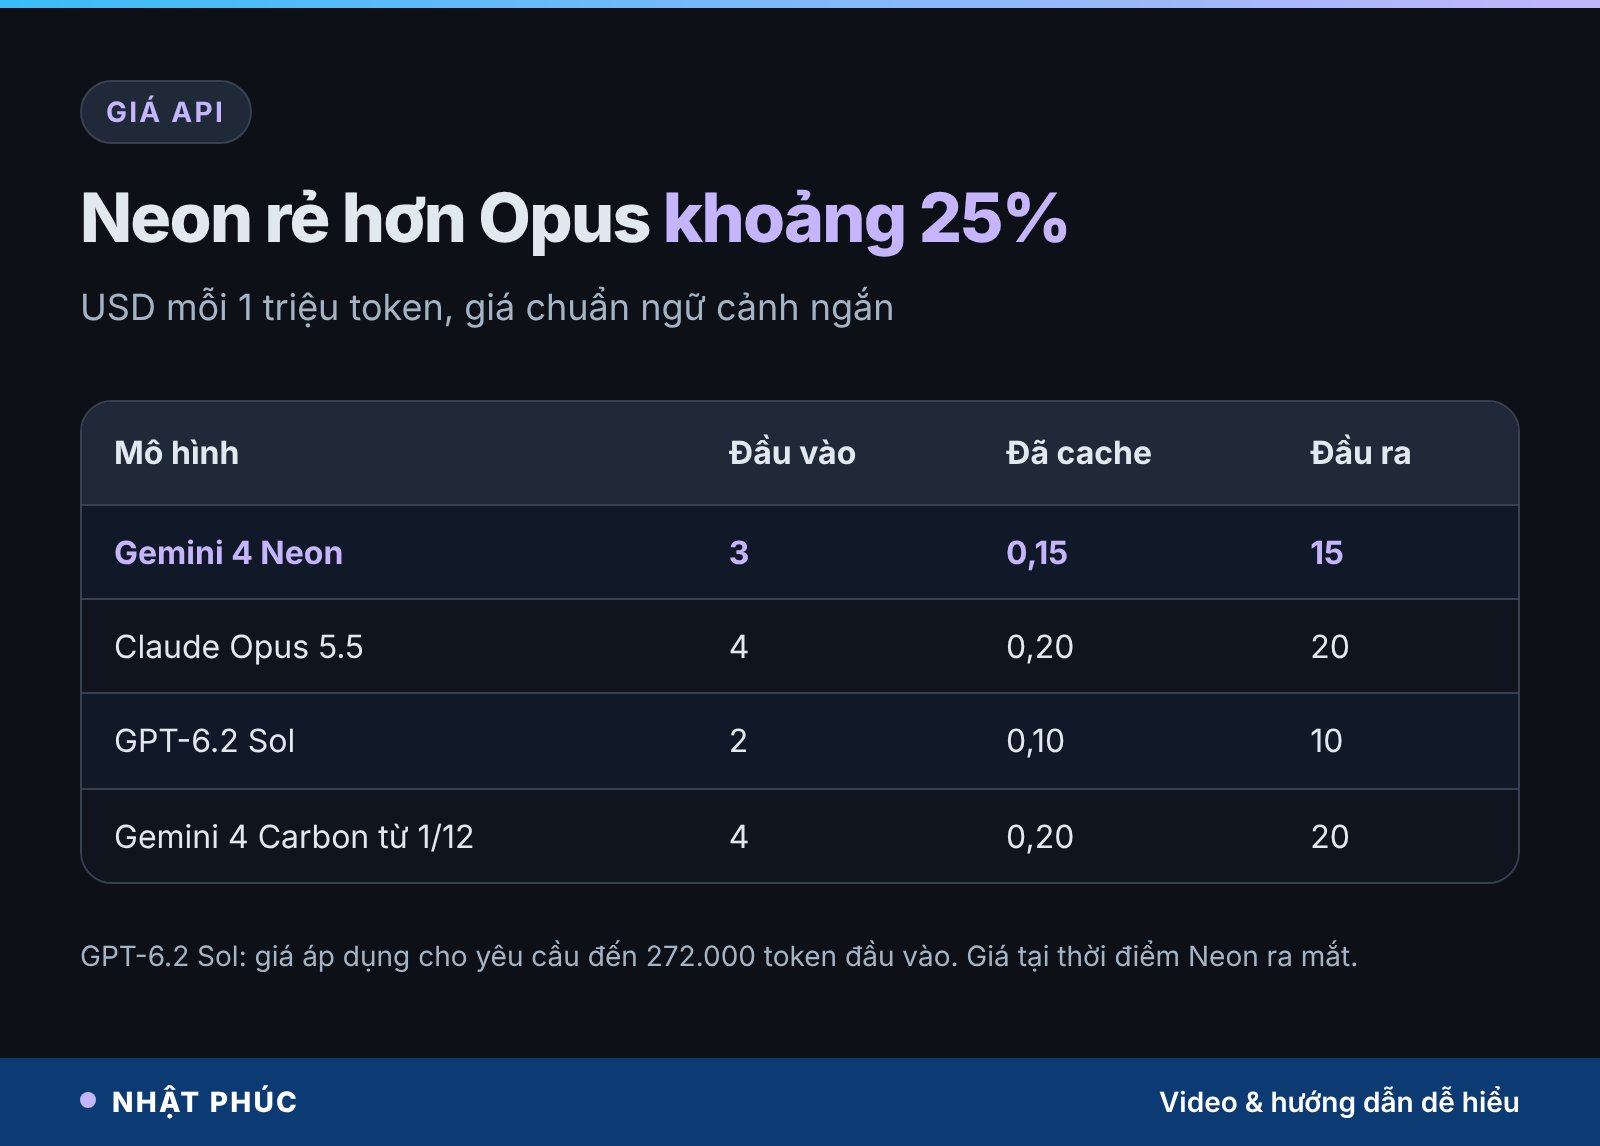
Giá API của các mô hình AI tính theo triệu token, chia làm đầu vào (bạn gửi cho AI), đầu ra (AI viết ra) và đầu vào đã lưu cache. Dưới đây là giá niêm yết chuẩn tại thời điểm Neon ra mắt, theo bài công bố của Google và VentureBeat.
| Mô hình | Đầu vào | Đầu vào đã cache | Đầu ra |
|---|---|---|---|
| Gemini 4 Neon | 3 | 0,15 | 15 |
| Claude Opus 5.5 | 4 | 0,20 | 20 |
| GPT-6.2 Sol (đến 272.000 token) | 2 | 0,10 | 10 |
| Gemini 4 Carbon (từ 1/12/2026) | 4 | 0,20 | 20 |
Như vậy Neon rẻ hơn Opus 5.5 khoảng 25% ở mọi hạng mục, nhưng đắt hơn GPT-6.2 Sol 50%. Với GPT-6.2 Sol, nếu một yêu cầu vượt 272.000 token đầu vào, giá toàn bộ yêu cầu đó tăng lên 4 USD đầu vào và 15 USD đầu ra. Gemini 4 Carbon đang ở giá giới thiệu 2 USD/10 USD đến hết 30/11/2026, sau đó lên 4 USD/20 USD. Về GPT-6.2 Sol, bạn có thể xem thêm bài GPT-6.2 Astra và Sol là gì.
Giá mỗi token chỉ là một nửa câu chuyện. Mô hình rẻ mà phải viết dài hơn, thử lại nhiều lần thì tổng chi phí vẫn cao. Google cho biết ở mức high mặc định, chi phí mỗi tác vụ của Neon thấp hơn Carbon 32%. Artificial Analysis đo ở mức xhigh thì con số này chỉ khoảng 17%. Khái niệm “chi phí mỗi tác vụ” được giải thích kỹ trong bài mô hình AI nhỏ và bài toán AI agent giá rẻ.
Cached input là gì, vì sao rẻ hơn 95%
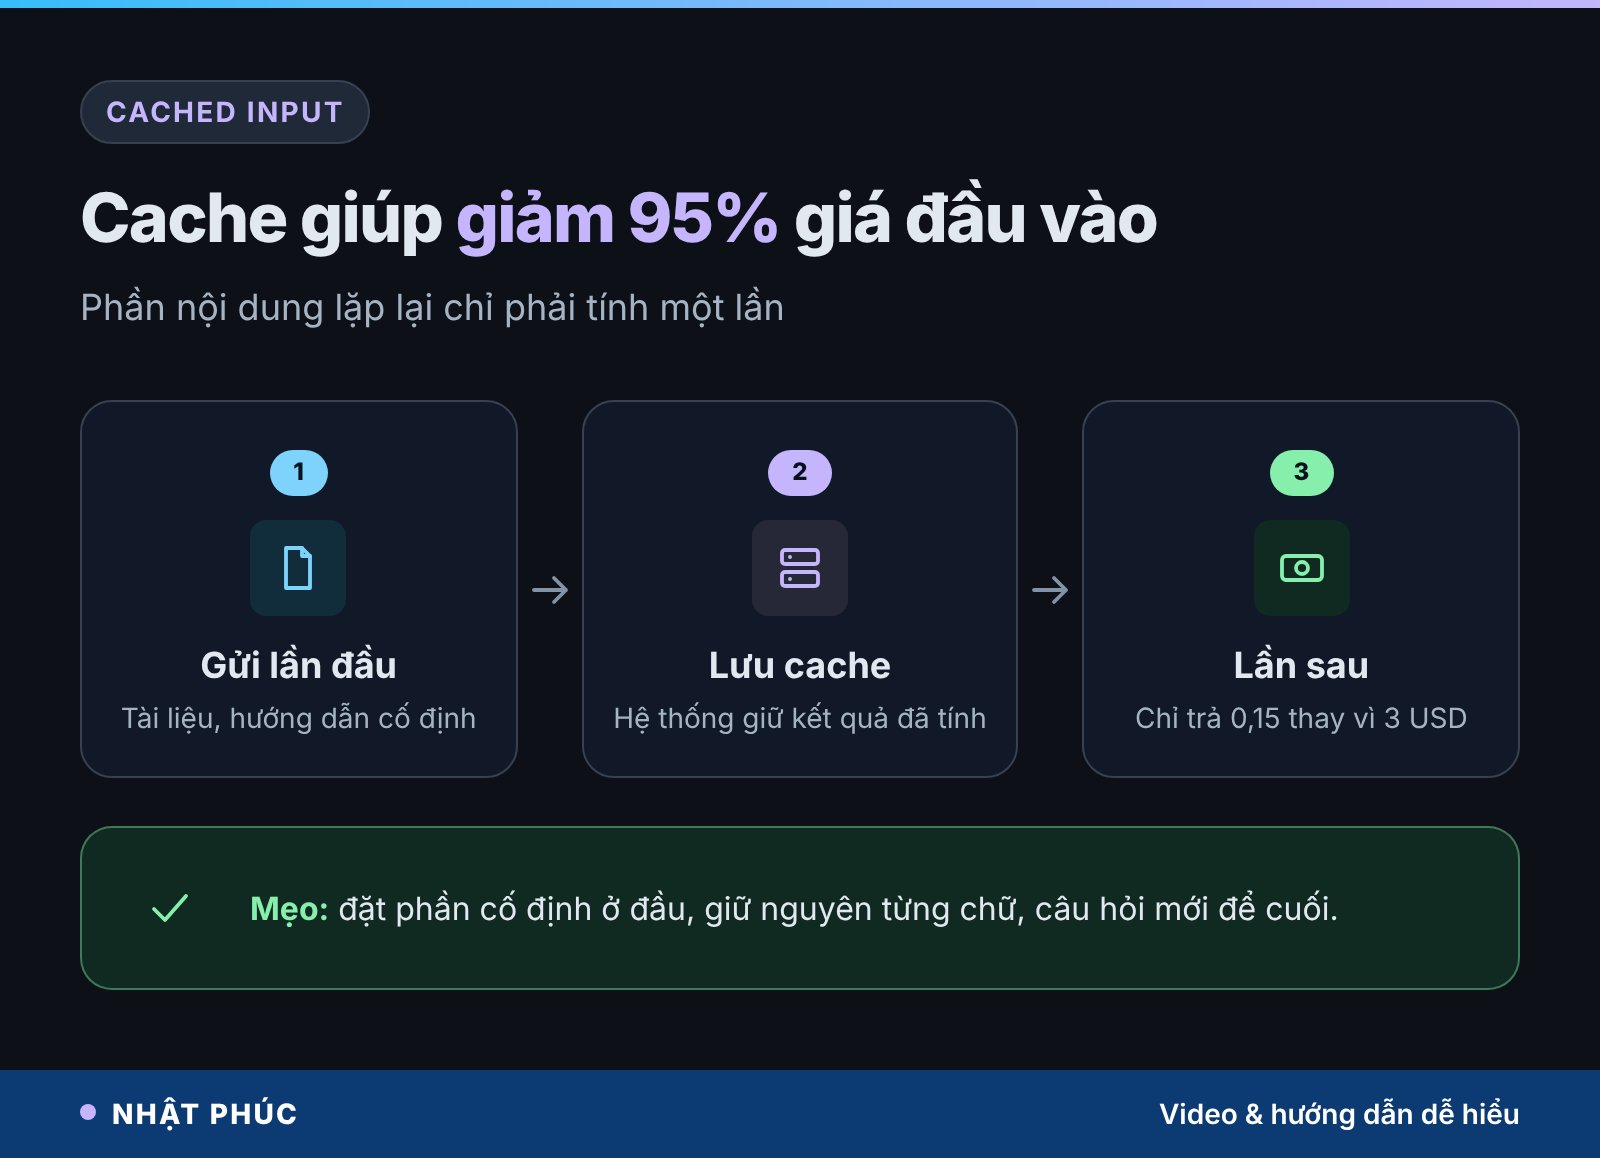
Cached input (đầu vào đã lưu bộ nhớ đệm) là phần nội dung bạn gửi lặp lại nhiều lần, ví dụ hướng dẫn hệ thống, tài liệu sản phẩm, quy định nội bộ. Lần đầu, hệ thống xử lý và lưu lại kết quả tính toán của phần này. Những lần sau, nếu phần mở đầu y hệt, mô hình không phải tính lại từ đầu nên nhà cung cấp tính giá rất thấp: với Neon chỉ 0,15 USD thay vì 3 USD, tức giảm 95%.
Hãy hình dung một nhân viên chăm sóc khách hàng mới. Ngày đầu phải đọc toàn bộ sổ tay chính sách. Từ ngày thứ hai, họ đã nhớ sổ tay, chỉ cần đọc câu hỏi mới của khách. Cache chính là “đã nhớ sổ tay”.
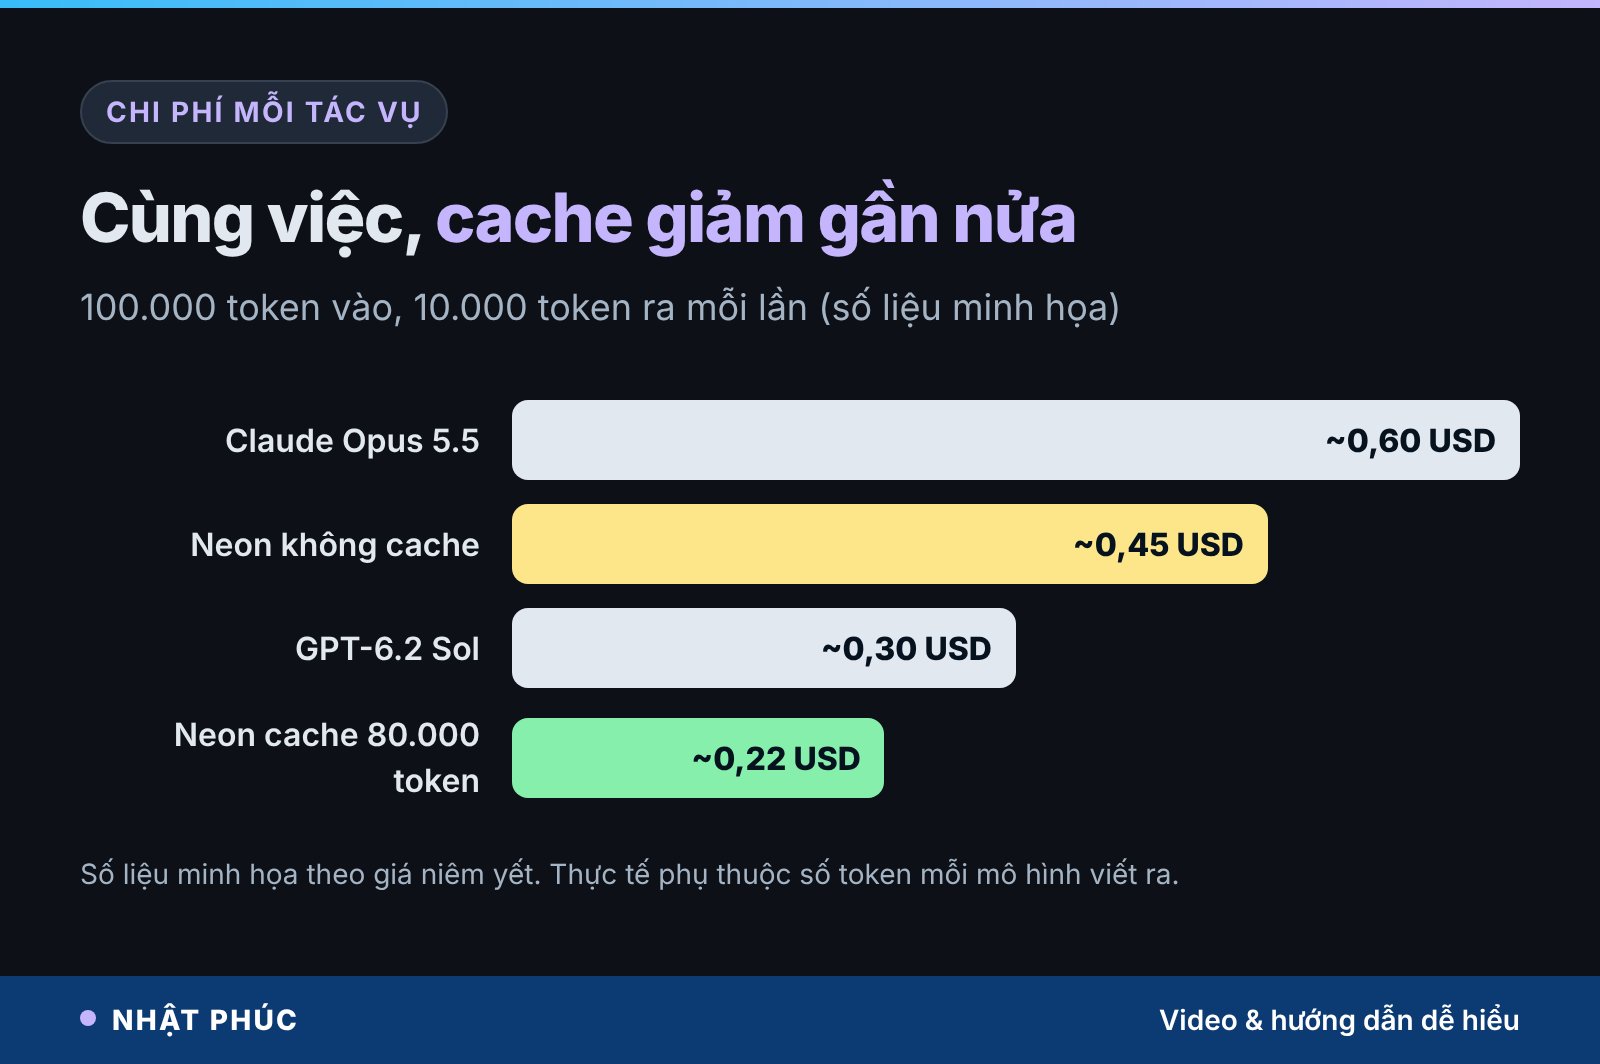
Ví dụ ở Việt Nam: một shop online dùng AI trả lời khách, mỗi lần gửi kèm 80.000 token gồm bảng giá, chính sách đổi trả, mô tả sản phẩm, cộng 20.000 token tin nhắn của khách và AI viết ra 10.000 token. Tính theo giá niêm yết (số liệu minh họa):
- Không dùng cache: 0,30 USD đầu vào + 0,15 USD đầu ra = khoảng 0,45 USD mỗi lần.
- Có cache phần 80.000 token cố định: 0,06 + 0,012 + 0,15 = khoảng 0,22 USD mỗi lần, giảm gần một nửa.
Mẹo để tận dụng cache: đặt phần cố định (hướng dẫn, tài liệu) ở đầu yêu cầu và giữ nguyên từng chữ, phần thay đổi (câu hỏi mới) để cuối. Chỉ cần sửa một dấu cách ở phần đầu là cache không còn khớp.
Chọn Hydrogen, Neon hay Carbon cho việc gì
Với người làm tự động hoá, câu hỏi thực tế không phải “mô hình nào mạnh nhất” mà là “việc này cần mô hình mạnh đến đâu”. Dùng mô hình đắt cho việc đơn giản là phí tiền, dùng mô hình rẻ cho việc khó thì phải sửa lại nhiều.
Khi nào dùng Hydrogen
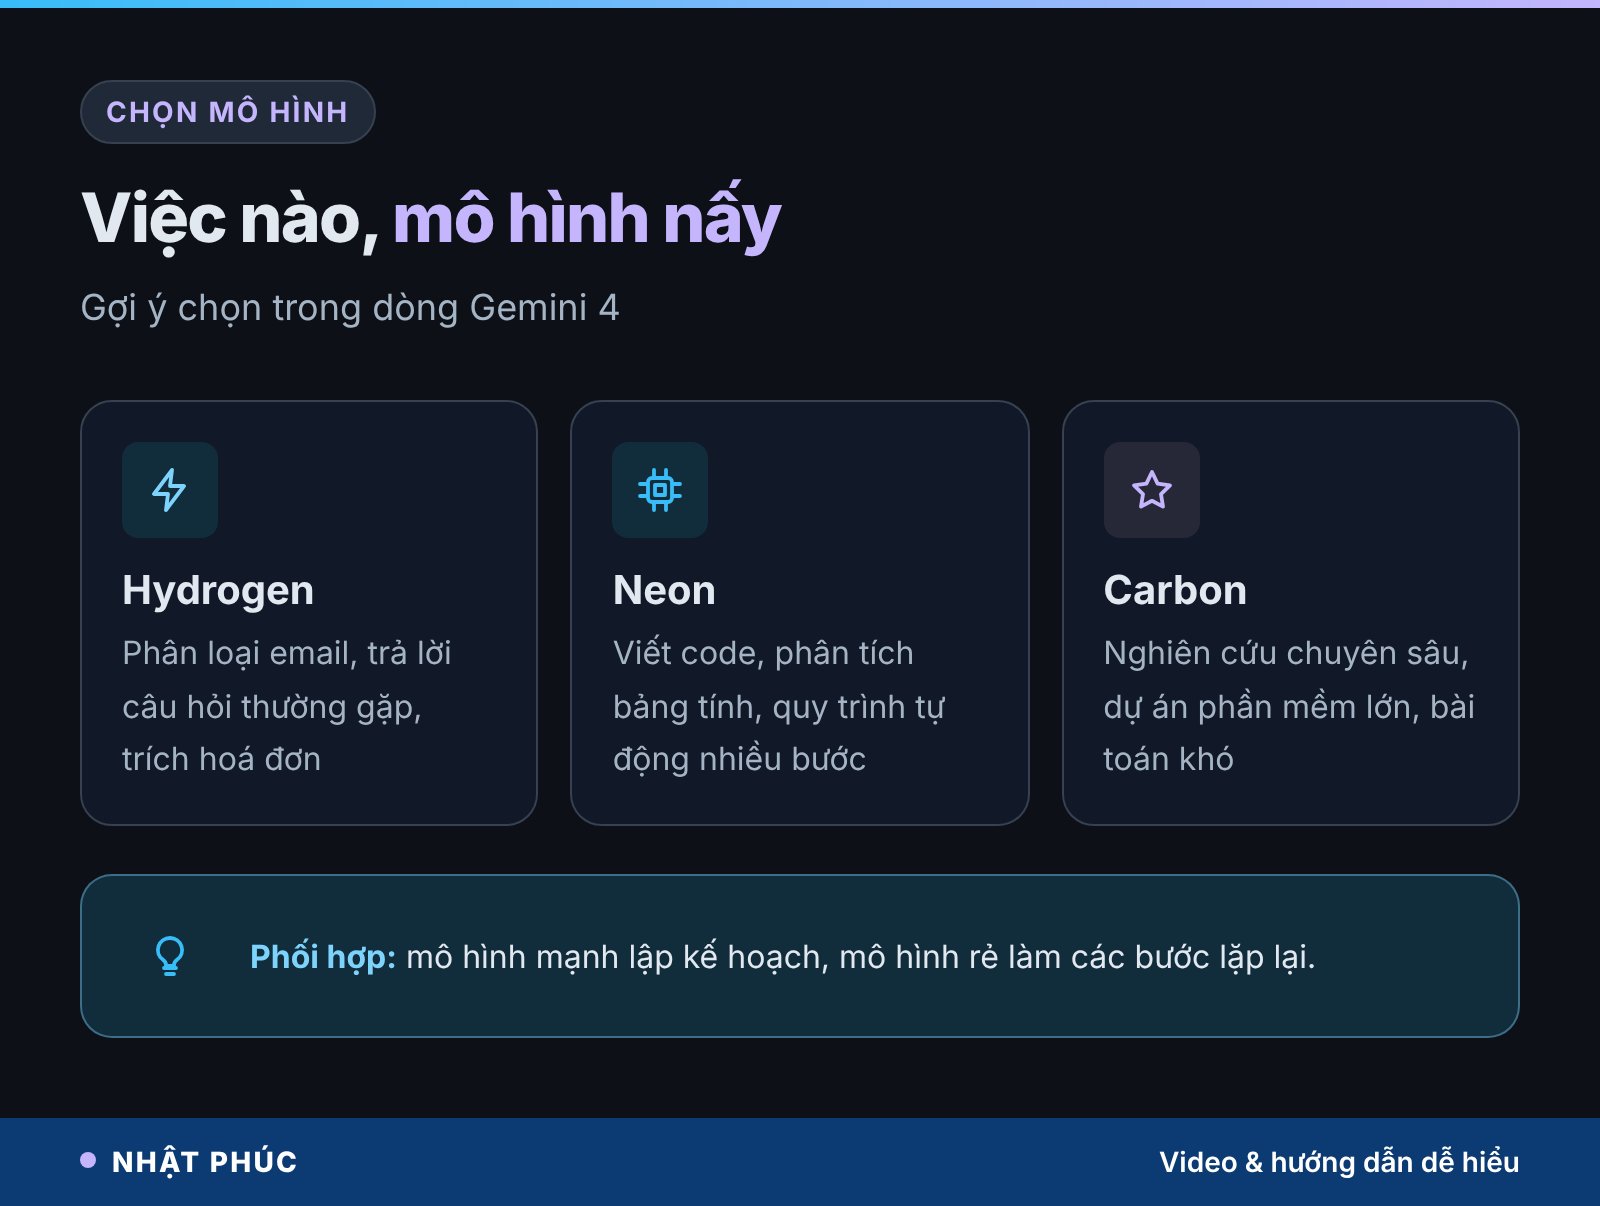
Việc lặp lại, cần trả lời nhanh, khối lượng lớn: phân loại email, trả lời câu hỏi thường gặp của khách, tóm tắt tin nhắn, trích thông tin từ hoá đơn. Ví dụ một văn phòng kế toán cần đọc hàng trăm hoá đơn mỗi ngày để lấy mã số thuế và số tiền.
Khi nào dùng Neon
Việc cần suy nghĩ nhiều bước và độ chính xác cao: viết và sửa code, phân tích bảng tính bán hàng, lập báo cáo từ nhiều nguồn, chạy quy trình tự động gọi nhiều ứng dụng. Điểm AutomationBench cao cho thấy Neon hợp làm “bộ não” cho các AI agent tự động hoá ở văn phòng.
Khi nào dùng Carbon
Dự án dài hơi, khó nhất: nghiên cứu chuyên sâu, thiết kế hệ thống phần mềm lớn, bài toán khoa học phức tạp. Trong ứng dụng Gemini, Carbon cần gói Ultra.
Cách làm phổ biến trong các hệ AI agent hiện nay là phối hợp: mô hình mạnh lập kế hoạch, mô hình rẻ làm các bước lặp. Ví dụ Neon chia việc lập báo cáo tháng thành từng phần, Hydrogen đi đọc và trích số liệu từ từng file.
Dùng Gemini 4 Neon ở Việt Nam
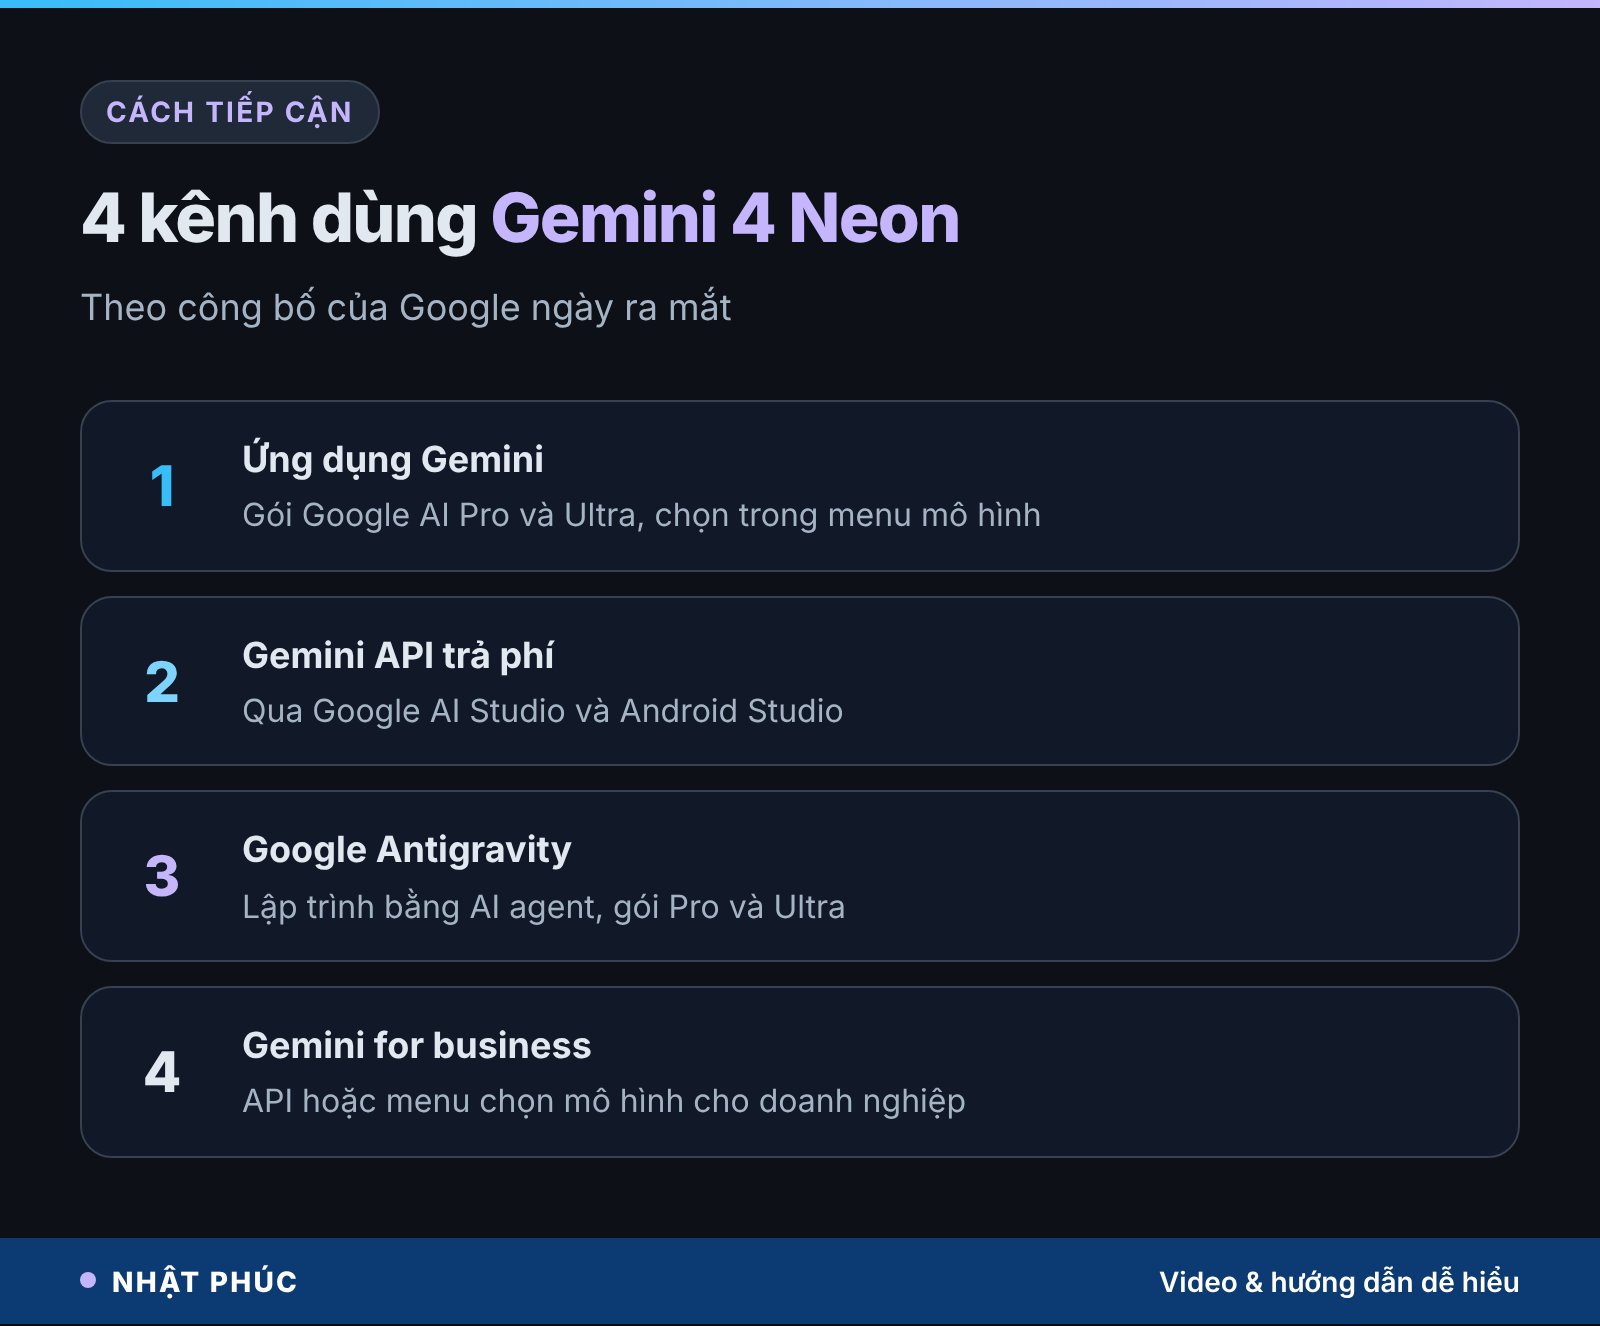
Google chưa công bố danh sách quốc gia riêng cho Neon. Theo bài ra mắt, Neon có ở các kênh sau:
- Ứng dụng Gemini: người dùng gói Google AI Pro và Ultra chọn Neon trong menu mô hình. Gói miễn phí chưa được nhắc đến.
- Gemini API bản trả phí trên Google AI Studio, và Android Studio cho lập trình viên Android.
- Google Antigravity (môi trường lập trình bằng AI agent) cho người dùng Pro và Ultra.
- Gemini for business qua API hoặc menu chọn mô hình cho doanh nghiệp.
Người dùng ở Việt Nam đã đăng ký được gói Google AI Pro và dùng được Gemini API, nên về nguyên tắc có thể tiếp cận Neon qua các kênh trên khi Google triển khai xong. Bạn có thể trò chuyện với Gemini bằng tiếng Việt, nhưng các điểm benchmark ở trên chủ yếu đo bằng tiếng Anh, nên chất lượng với nội dung tiếng Việt cần tự kiểm tra.
Thử Neon trong 5 bước
Bước 1: Xác định một việc cụ thể
Chọn một việc bạn làm lặp lại hằng tuần, ví dụ tổng hợp doanh số từ file Excel thành báo cáo ngắn.
Bước 2: Chạy cùng một yêu cầu trên 2 mô hình
Trong ứng dụng Gemini, chạy yêu cầu đó bằng Neon và bằng mô hình nhanh, so kết quả.
Bước 3: Kiểm tra kỹ từng con số
Đối chiếu số liệu AI đưa ra với file gốc. Đây là bước không được bỏ qua.
Bước 4: Tính chi phí nếu dùng API
Ước lượng token đầu vào, đầu ra mỗi lần, nhân với giá ở bảng trên, nhân với số lần chạy mỗi tháng.
Bước 5: Chỉ tự động hoá phần đã ổn định
Khi kết quả đúng nhiều lần liên tiếp, mới đưa vào quy trình tự động, và vẫn giữ một bước người duyệt cho việc quan trọng.
An toàn, rủi ro và giới hạn cần biết
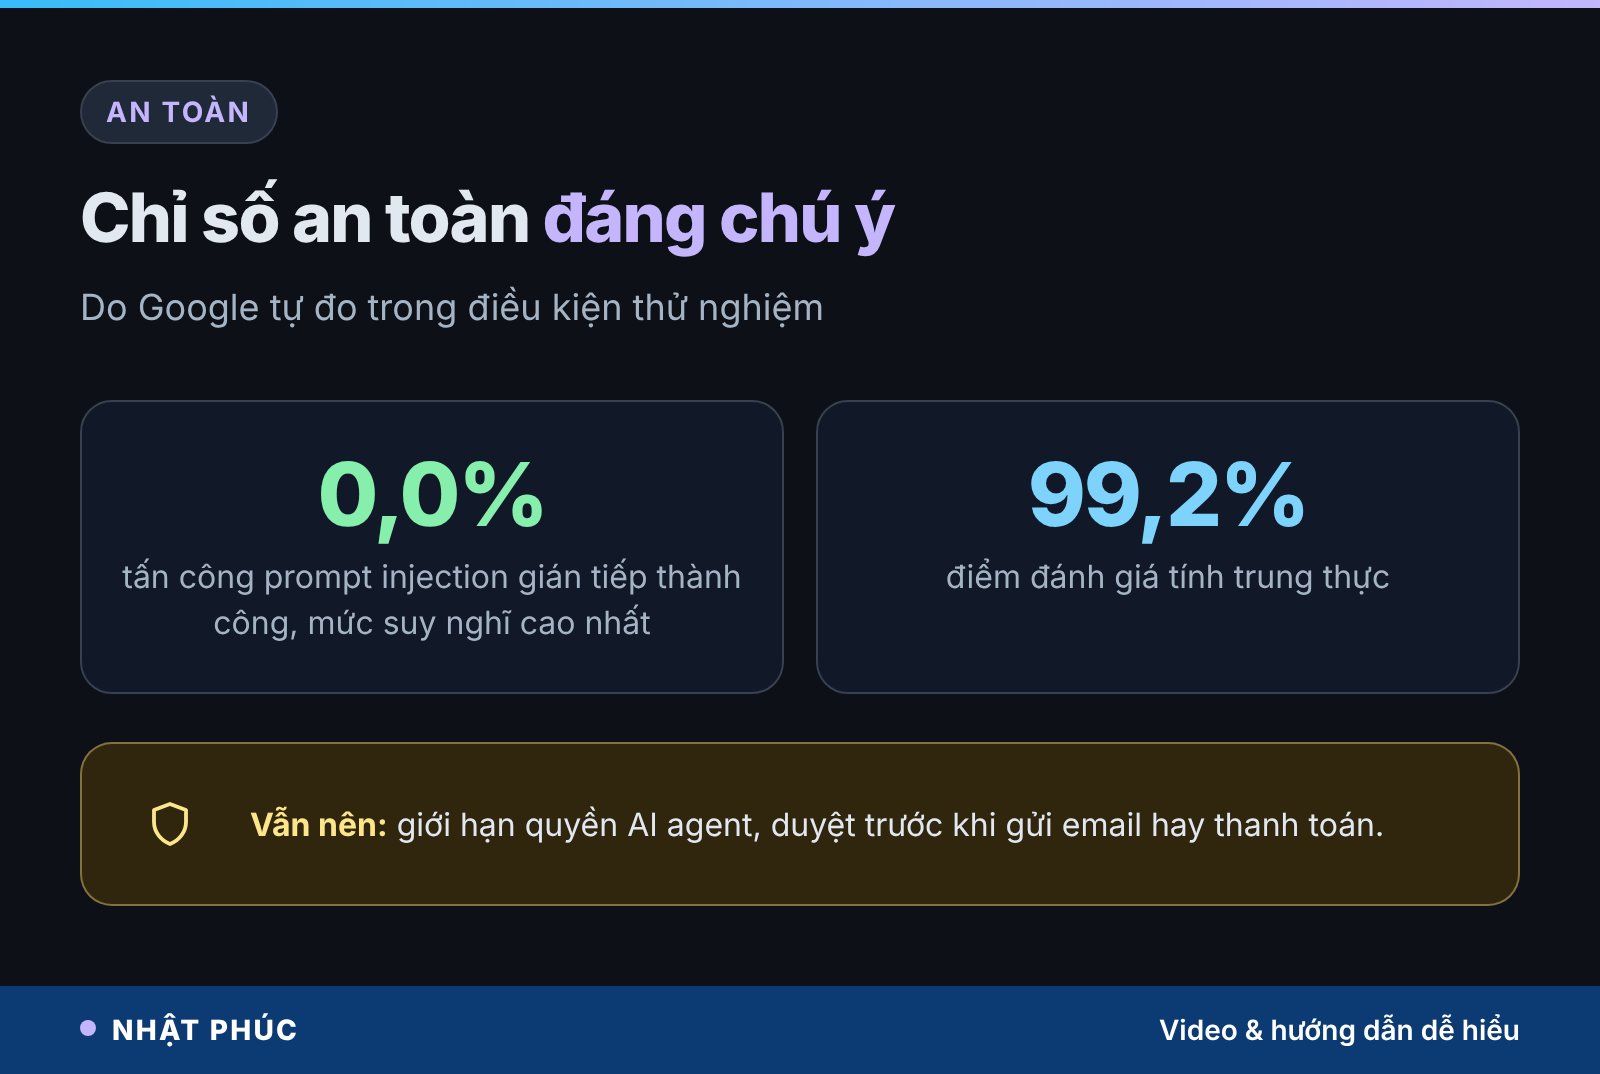
Google công bố một số chỉ số an toàn cho Neon. Đáng chú ý là bài kiểm tra prompt injection gián tiếp của Gray Swan: kiểu tấn công giấu mệnh lệnh độc hại trong email, trang web hoặc tài liệu mà AI agent đọc phải. Ở mức suy nghĩ cao nhất, tỷ lệ tấn công thành công là 0,0%. Neon cũng đạt 99,2% ở bài đánh giá tính trung thực. Tìm hiểu kỹ hơn về kiểu tấn công này trong bài prompt injection là gì.
Tuy vậy, cần nhớ mấy giới hạn:
- Các chỉ số đều do Google tự đo, trong điều kiện thử nghiệm. Thực tế với dữ liệu của bạn có thể khác.
- 0,0% ở mức cao nhất không có nghĩa là miễn nhiễm ở mọi mức, mọi kiểu tấn công. Vẫn nên giới hạn quyền của AI agent: chỉ đọc khi không cần ghi, phải duyệt trước khi gửi email hay thanh toán.
- Khi đưa dữ liệu khách hàng, nhân viên vào AI qua API, doanh nghiệp ở Việt Nam cần tuân thủ Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15: có căn cứ xử lý, thông báo cho người liên quan, hạn chế đưa thông tin nhạy cảm.
- Google còn có biến thể Neon cho an ninh mạng, chỉ cấp cho các đơn vị phòng thủ được xác minh qua chương trình Fairwind, không mở cho người dùng phổ thông.
Hiểu lầm phổ biến về Gemini 4 Neon
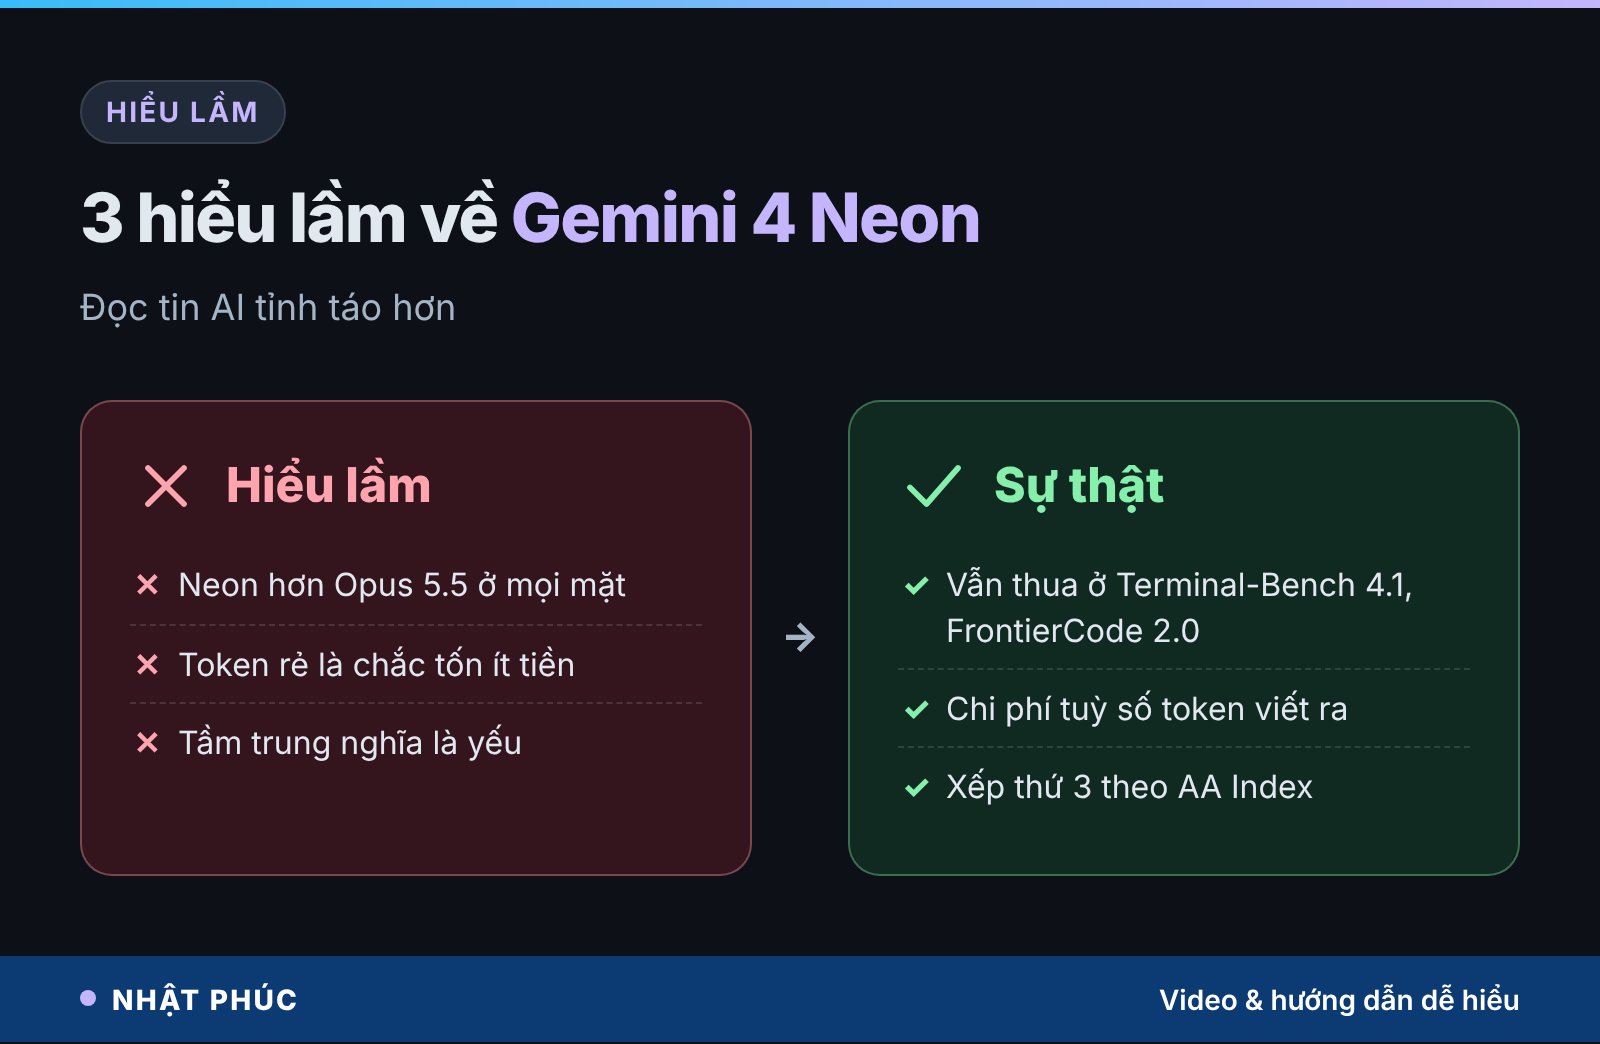
“Neon mạnh hơn Opus 5.5 ở mọi mặt”
Không đúng. Ngay trong số Google công bố, Neon thua Opus 5.5 ở Terminal-Bench 4.1 và FrontierCode 2.0, thua GPT-6.2 Sol ở Chartography. Khoảng cách ở nhiều bài chỉ vài phần trăm.
“Giá token rẻ hơn thì chắc chắn tốn ít tiền hơn”
Chưa chắc. Tổng chi phí phụ thuộc số token mô hình viết ra và số lần phải chạy lại. GPT-6.2 Sol rẻ hơn mỗi token, nhưng nếu phải viết dài hơn thì lợi thế giảm.
“Tầm trung nghĩa là yếu”
Tầm trung ở đây là về giá và tốc độ trong dòng Gemini 4. Theo Artificial Analysis Intelligence Index do Google dẫn, Neon vẫn đứng thứ 3 tổng thể.
Câu hỏi thường gặp về Gemini 4 Neon
Gemini 4 Neon có miễn phí không?
Theo công bố của Google, trong ứng dụng Gemini, Neon dành cho người dùng gói Google AI Pro và Ultra. Trên Gemini API, Neon nằm ở bản trả phí với giá 3 USD và 15 USD mỗi 1 triệu token đầu vào và đầu ra. Google chưa nhắc đến bản miễn phí cho Neon.
Gemini 4 Neon khác Gemini 4 Hydrogen thế nào?
Hydrogen là mô hình nhanh, rẻ cho việc hằng ngày. Neon suy nghĩ sâu hơn, dành cho lập trình, phân tích và quy trình tự động hoá nhiều bước, giá cao hơn. Có thể phối hợp: Neon lập kế hoạch, Hydrogen làm các bước lặp lại số lượng lớn.
Neon có hiểu tiếng Việt không?
Bạn có thể dùng tiếng Việt trong ứng dụng Gemini. Tuy nhiên Google không công bố điểm đánh giá riêng cho tiếng Việt, và các benchmark nổi bật chủ yếu bằng tiếng Anh. Với việc quan trọng như hợp đồng, số liệu tài chính, hãy kiểm tra kỹ kết quả.
Cửa sổ ngữ cảnh 1 triệu token có ý nghĩa gì?
Đó là lượng nội dung tối đa mô hình đọc được trong một lần, đủ cho nhiều tài liệu dài hoặc một kho mã nguồn vừa. Tuy vậy đưa càng nhiều vào thì càng tốn tiền đầu vào, nên chỉ đưa phần thật sự cần và tận dụng cache cho phần lặp lại.
Doanh nghiệp nhỏ có nên chuyển sang Neon ngay?
Không cần vội. Hãy chạy thử Neon trên vài việc thật, so chất lượng và chi phí với mô hình đang dùng. Nếu Neon làm đúng hơn và tổng chi phí mỗi tác vụ không cao hơn, lúc đó mới chuyển dần từng quy trình.
Kết luận
Gemini 4 Neon là lời đáp của Google cho nhu cầu “đủ mạnh mà không quá đắt”: điểm số gần nhóm dẫn đầu, giá thấp hơn Opus 5.5 khoảng 25%, cache giảm 95% cho phần nội dung lặp lại. Nhưng bài học lớn nhất từ đợt ra mắt này là cách đọc benchmark: cùng một mô hình, đổi môi trường chạy thử là điểm thay đổi gấp 3 lần. Cách chọn mô hình tốt nhất vẫn là thử trên chính công việc của bạn.
Bạn định dùng Neon cho việc gì, lập trình, phân tích số liệu hay tự động hoá văn phòng? Hãy để lại bình luận và theo dõi Nhật Phúc để cập nhật các bài giải thích AI dễ hiểu tiếp theo.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.