Bạn hỏi chatbot về quy định nghỉ phép của công ty, và nó trả lời rất tự tin… nhưng sai bét, vì nó chưa từng đọc sổ tay nhân sự của bạn. Đây là giới hạn cố hữu của mọi mô hình ngôn ngữ: chúng chỉ biết những gì đã học, và kiến thức ấy đóng băng ở một thời điểm. Cách khắc phục được dùng nhiều nhất hiện nay có cái tên ngắn gọn: RAG.
Câu trả lời ngắn: RAG (Retrieval-Augmented Generation, tạm dịch là sinh văn bản có tra cứu) là cách cho AI tìm đoạn tài liệu liên quan trước, rồi mới viết câu trả lời dựa trên đoạn đó. Nhờ embedding biến chữ thành tọa độ nghĩa, máy tìm được đoạn đúng ý dù câu hỏi không trùng chữ nào, nên trả lời sát tài liệu hơn và ít bịa hơn.
Bài này đi từ nền móng là embedding, tới cách RAG vận hành từng bước, khi nào nên dùng, giới hạn cần biết và cách tự dựng một hệ thống RAG nhỏ cho tài liệu của riêng bạn.
Nếu bạn muốn hiểu thật nhanh phần nền móng, hãy xem video Embedding là gì của kênh Vọc Sĩ: chỉ gần 4 phút, video giải thích vì sao máy biết “vua” gần “nữ hoàng” hơn “cái bàn”.
Tóm tắt nhanh
- Embedding biến chữ, câu, ảnh thành một dãy số; thứ gì gần nghĩa thì có tọa độ gần nhau.
- RAG = tìm kiếm theo nghĩa + mô hình ngôn ngữ: tra đoạn tài liệu liên quan rồi mới trả lời.
- Quy trình gồm hai giai đoạn: chuẩn bị kho (chia nhỏ, nhúng, lưu) và hỏi đáp (nhúng câu hỏi, tìm, ghép, trả lời).
- RAG hợp với kiến thức hay thay đổi, tài liệu nội bộ, câu trả lời cần trích nguồn.
- Giới hạn lớn nhất: tìm sai đoạn thì trả lời sai; tài liệu cũ hoặc thiếu thì AI vẫn có thể bịa.
Nội dung chính:
- Embedding là gì: khi chữ có tọa độ
- RAG là gì và vì sao chatbot cần tra tài liệu
- RAG hoạt động thế nào: 2 giai đoạn, 6 bước
- Chia nhỏ tài liệu và cơ sở dữ liệu vector
- Tìm kiếm ngữ nghĩa khác tìm theo từ khóa ra sao
- Ứng dụng RAG trong đời thực
- RAG, fine-tuning hay ngữ cảnh dài: chọn cách nào
- Giới hạn và rủi ro của RAG
- Hiểu lầm phổ biến về RAG
- Tự dựng RAG đơn giản trong 7 bước
- Câu hỏi thường gặp
Embedding là gì: khi chữ có tọa độ trên bản đồ nghĩa
Máy tính chỉ làm việc với con số. Muốn máy “hiểu” chữ, người ta phải đổi chữ thành số, và embedding (phép nhúng) là cách đổi thông minh nhất hiện nay. Mỗi chữ, mỗi câu, thậm chí mỗi bức ảnh được biến thành một dãy số gọi là vector. Điểm mấu chốt: dãy số không được gán bừa, mà được đặt sao cho những thứ có nghĩa gần nhau thì nằm gần nhau.
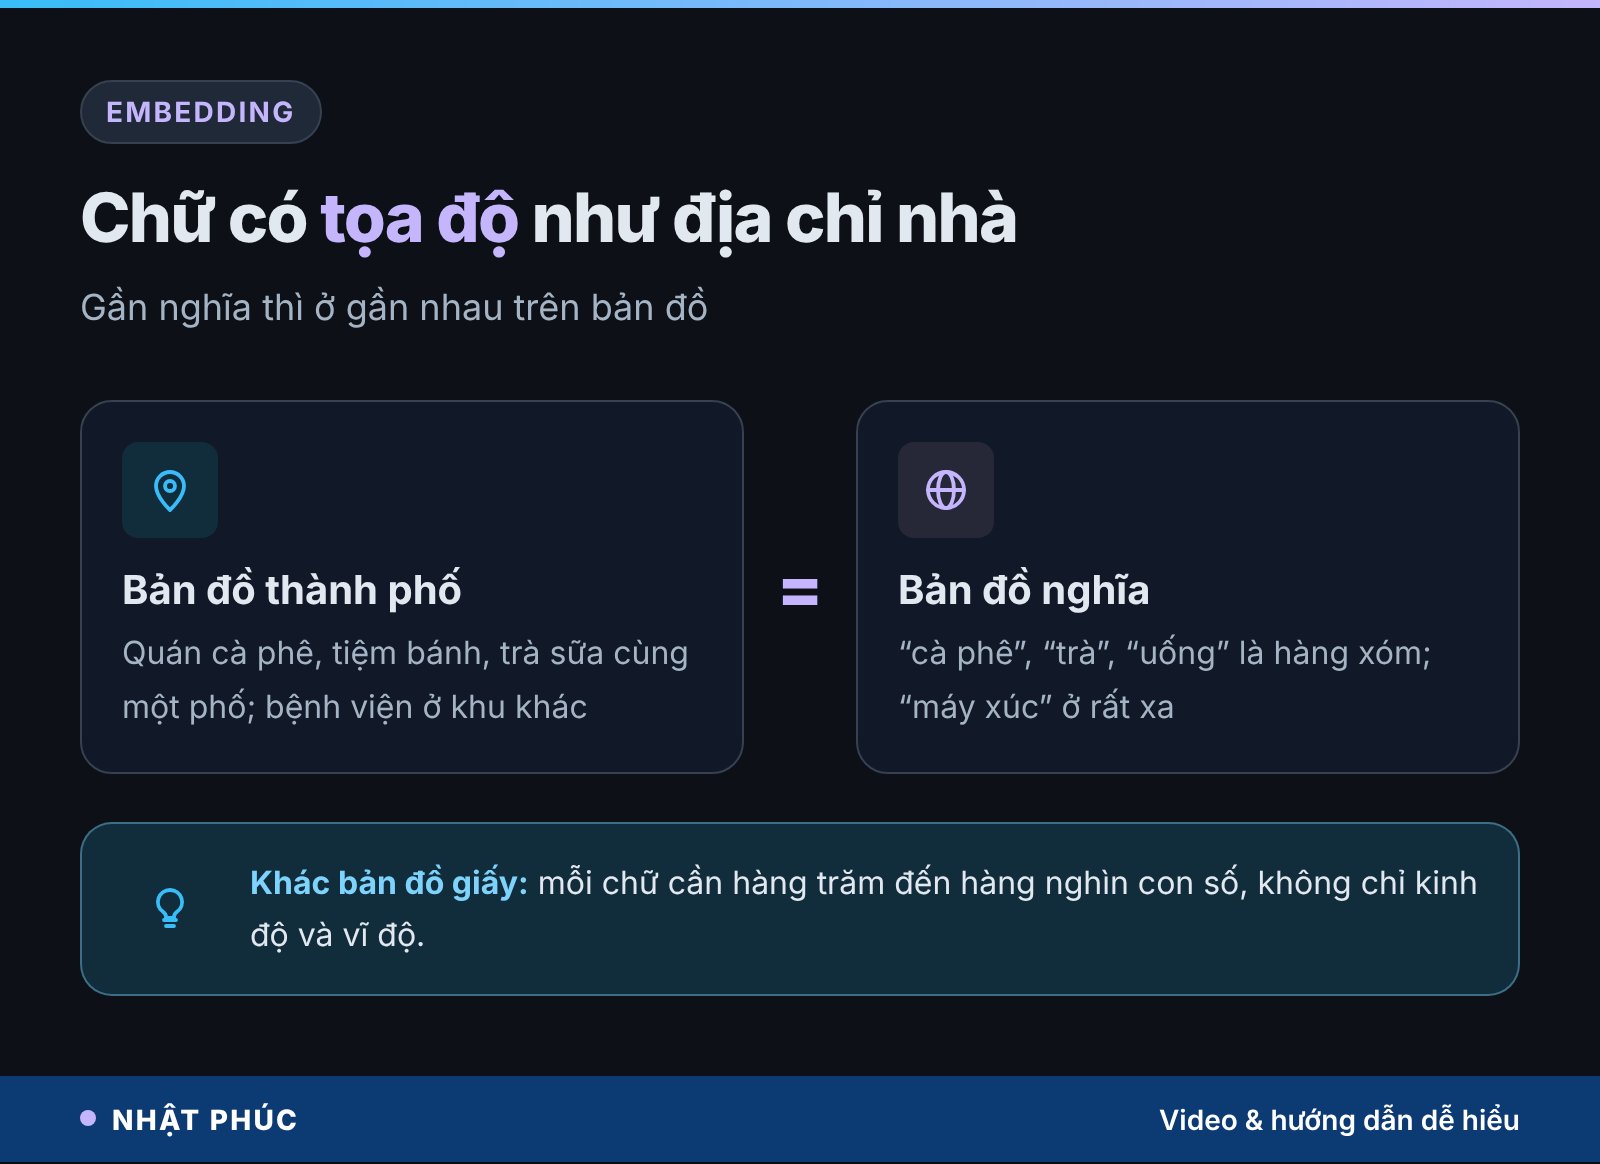
Hãy hình dung một thành phố. Quán cà phê, tiệm bánh và quán trà sữa thường mọc trên cùng một con phố; bệnh viện nằm ở khu khác. Chỉ cần nhìn tọa độ, bạn đoán được hai địa điểm có giống nhau không. Embedding làm đúng việc đó cho ngôn ngữ: “cà phê” và “trà” là hàng xóm, còn “cà phê” và “máy xúc” ở cách xa nhau.
Tọa độ có bao nhiêu con số?
Bản đồ giấy chỉ cần hai số: kinh độ và vĩ độ. Nghĩa của chữ phức tạp hơn nhiều, nên mỗi vector thường có hàng trăm đến hàng nghìn con số, mỗi số là một “trục” đo một sắc thái mờ của nghĩa. Ví dụ, hai mô hình embedding mà OpenAI công bố tháng 1/2024 cho ra vector dài 1.536 số (bản nhỏ) và 3.072 số (bản lớn). Ngay cả nhà nghiên cứu cũng thường không gọi tên được từng trục đo điều gì.
Ai đặt tọa độ? Máy tự học
Không ai ngồi gán tay. Mô hình được cho đọc lượng văn bản khổng lồ và chơi trò đoán chữ bị che. Những chữ hay xuất hiện trong cùng hoàn cảnh sẽ dần bị kéo lại gần nhau. Ý tưởng này gói gọn trong câu nổi tiếng của nhà ngôn ngữ học J. R. Firth (1957): muốn biết một chữ, hãy nhìn những chữ đi cùng nó.
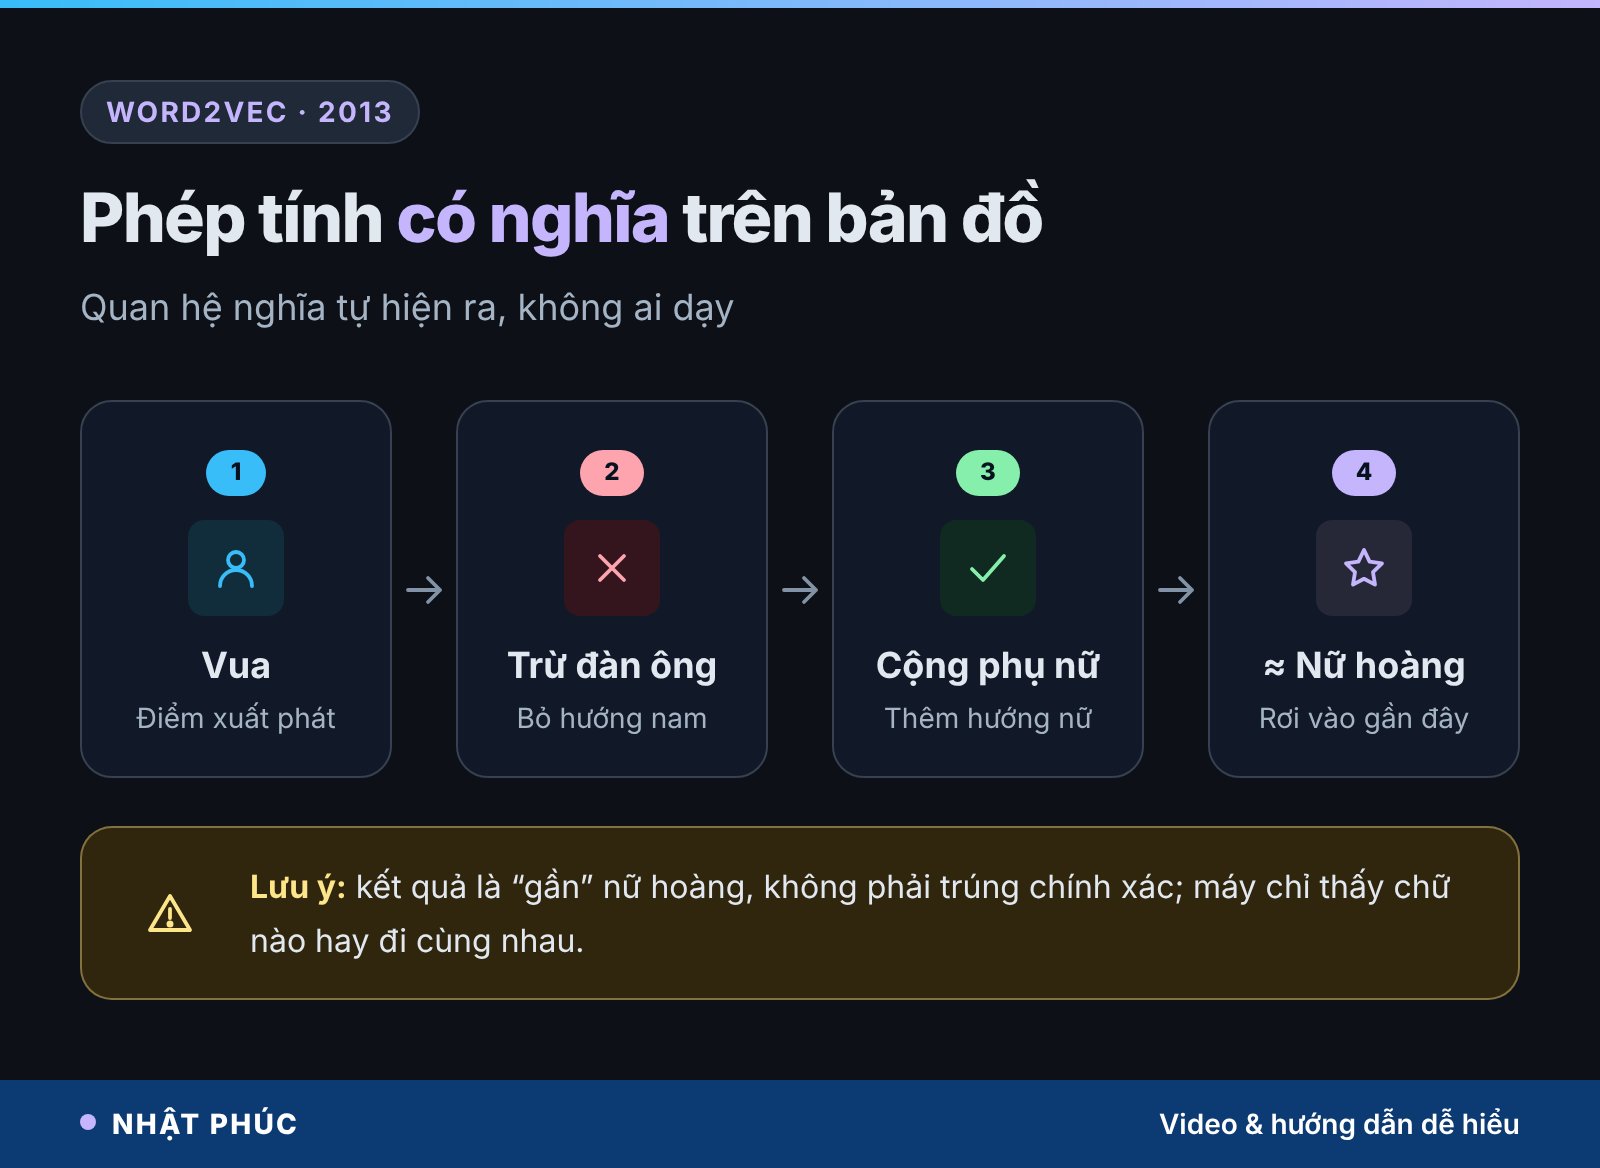
Kết quả thú vị nhất là các phép tính bắt đầu có nghĩa. Với mô hình word2vec do Google công bố năm 2013, lấy vector “vua” trừ “đàn ông”, cộng “phụ nữ”, bạn rơi vào gần “nữ hoàng”. Máy chưa từng được dạy khái niệm giới tính hay ngôi vị; quan hệ ấy tự hiện ra trong hình học của bản đồ.
RAG là gì và vì sao chatbot cần tra tài liệu
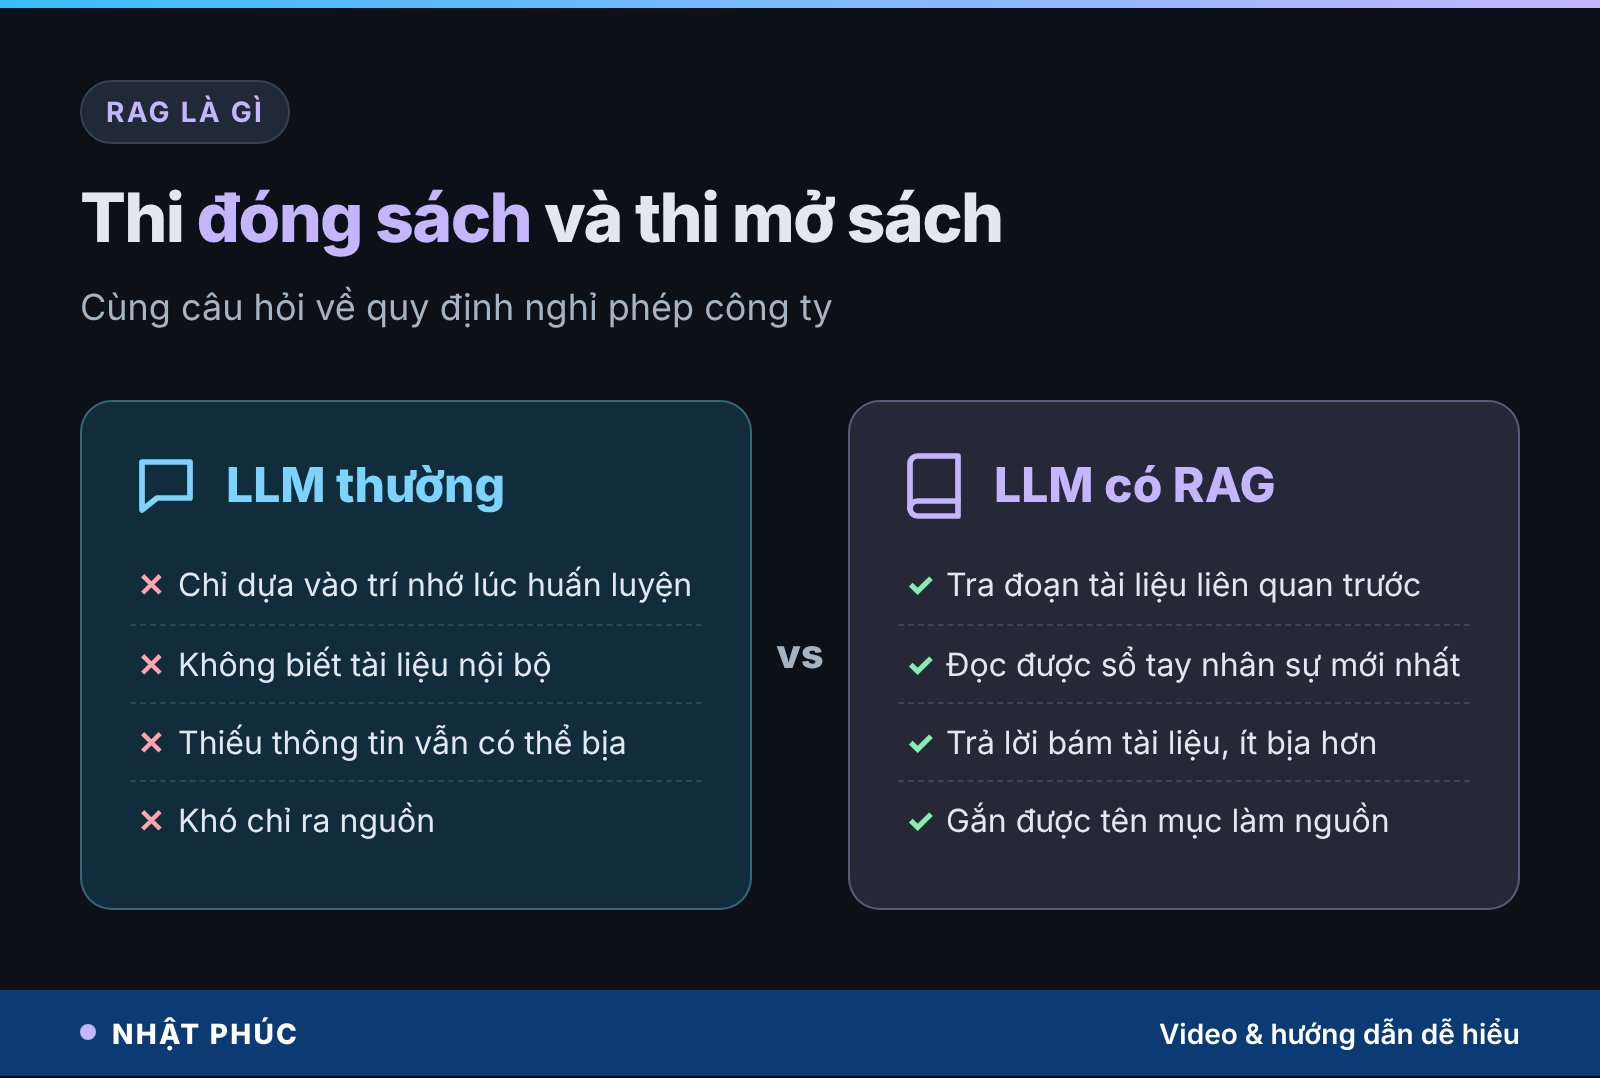
Mô hình ngôn ngữ lớn (LLM) giống một người đã đọc rất nhiều sách nhưng bị nhốt trong phòng kín từ ngày “tốt nghiệp”. Nó có ba điểm yếu cố hữu:
- Kiến thức đóng băng: chỉ biết dữ liệu tới thời điểm huấn luyện, không biết giá mới, quy định mới.
- Không biết chuyện riêng của bạn: hợp đồng, sổ tay nhân sự, tài liệu sản phẩm nội bộ chưa bao giờ nằm trong dữ liệu học.
- Dễ bịa khi không chắc: mô hình được huấn luyện để viết trôi chảy, nên thiếu thông tin vẫn có thể “chế” ra câu trả lời nghe rất thuyết phục (hiện tượng ảo giác).
RAG giải quyết bằng một ý rất đời thường: trước khi trả lời, hãy tra sách. Thay vì bắt AI nhớ mọi thứ, ta cho nó một “thủ thư” biết tìm đúng trang tài liệu, rồi đưa trang đó vào câu lệnh để AI đọc và trả lời. Thuật ngữ này xuất hiện trong bài báo “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” của nhóm Patrick Lewis tại Facebook AI Research, đăng tháng 5/2020 và trình bày ở hội nghị NeurIPS 2020.
Ví von dễ nhớ: AI không có RAG giống học sinh thi đóng sách, chỉ dựa vào trí nhớ. AI có RAG giống thi mở sách: vẫn cần biết đọc hiểu và viết, nhưng câu trả lời bám vào tài liệu trước mặt.
RAG hoạt động thế nào: 2 giai đoạn, 6 bước
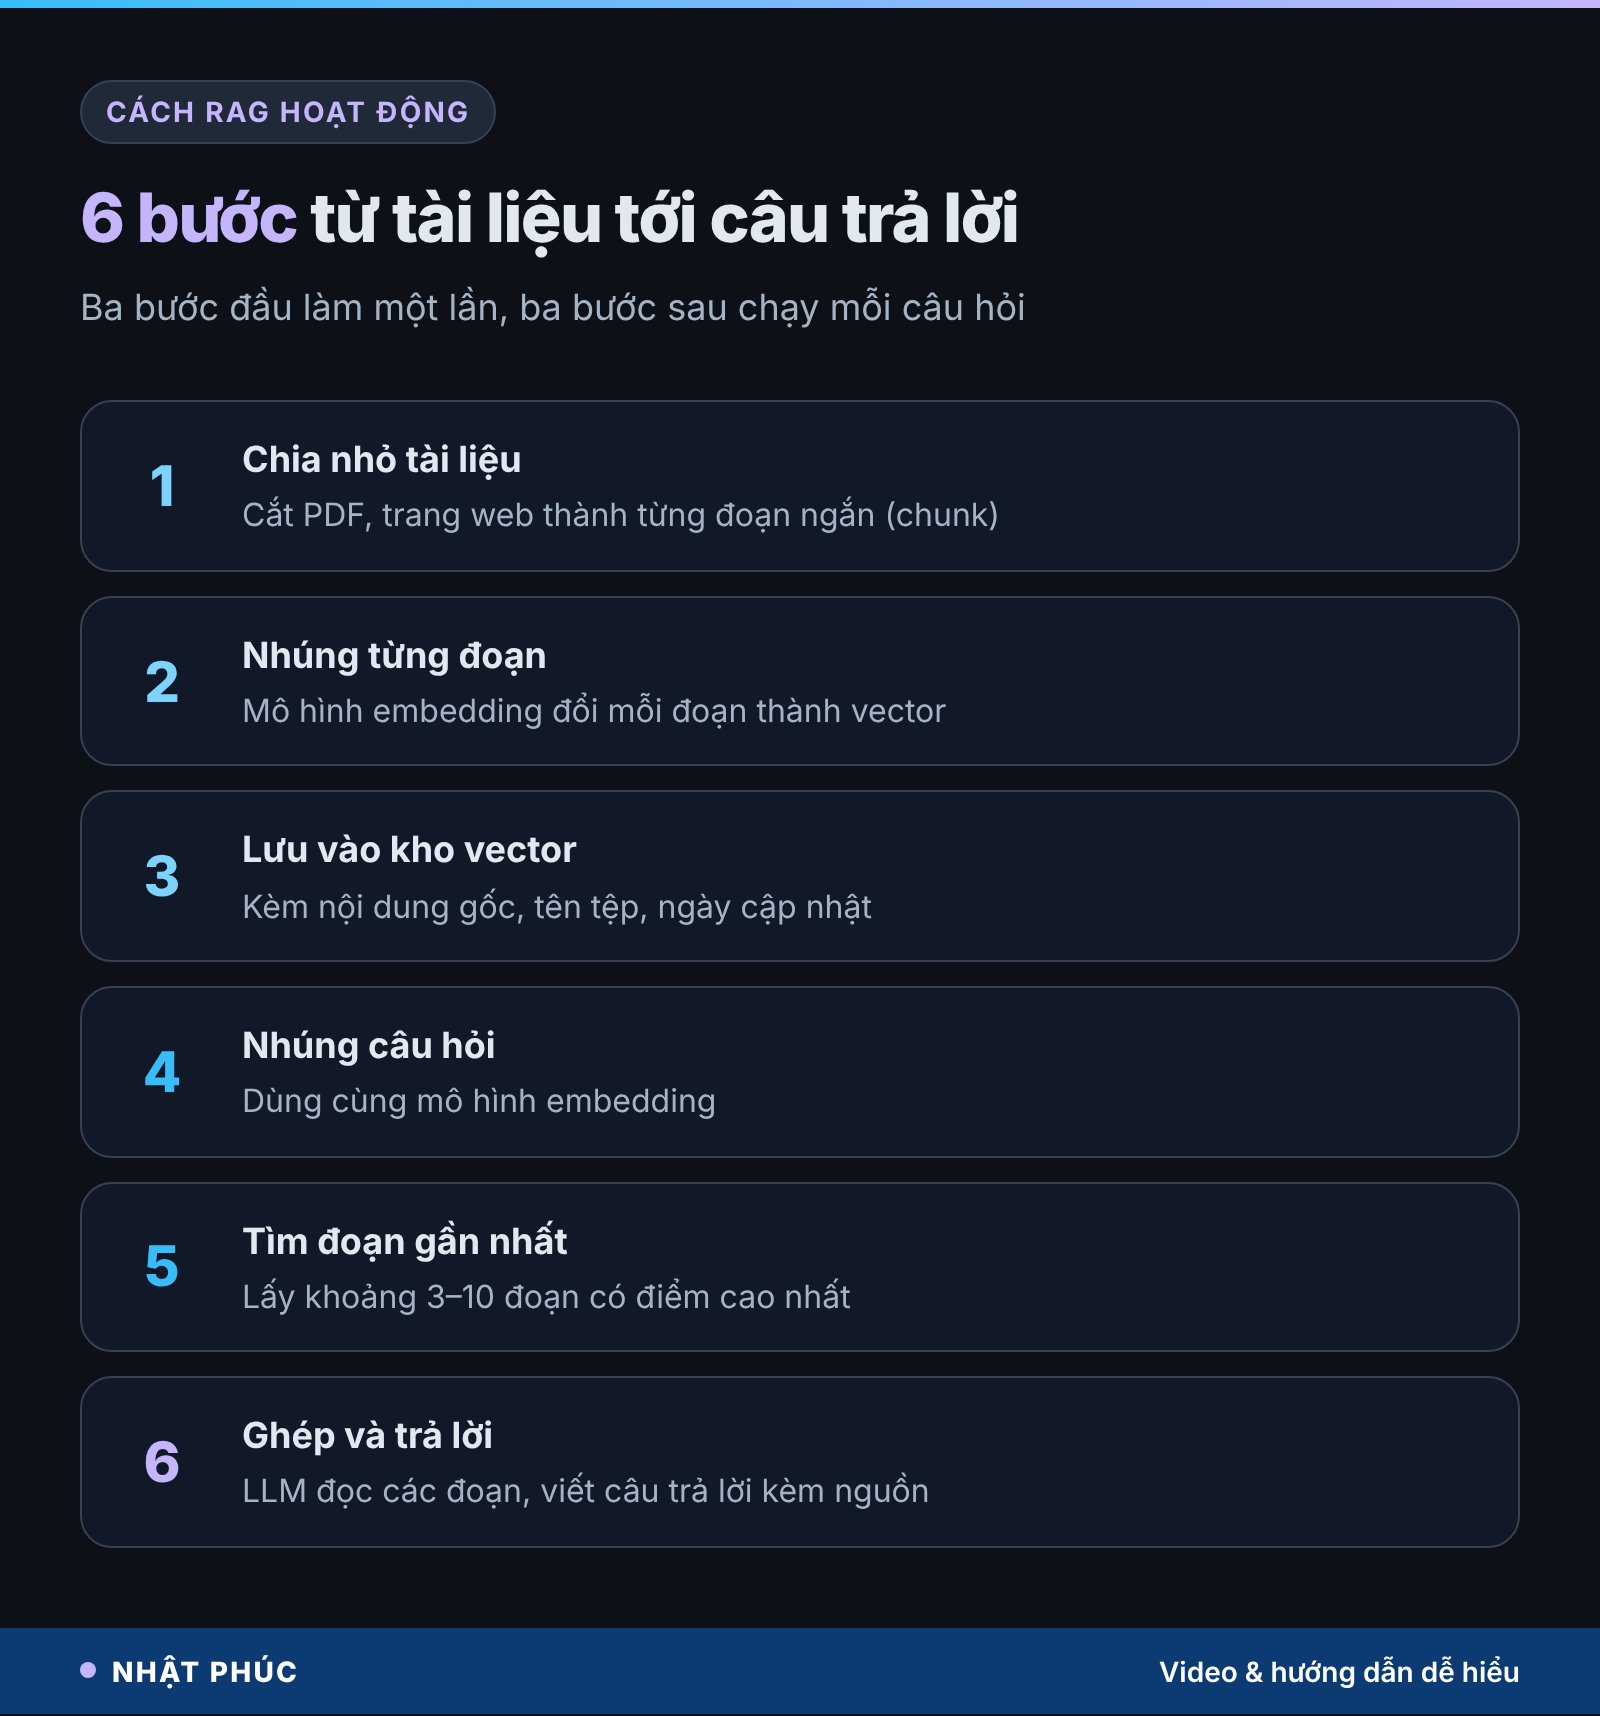
Một hệ thống RAG gồm hai giai đoạn tách biệt. Giai đoạn chuẩn bị làm một lần (và cập nhật khi tài liệu đổi); giai đoạn hỏi đáp chạy mỗi khi có người đặt câu hỏi.
Giai đoạn 1: chuẩn bị kho kiến thức
- Thu thập và chia nhỏ: tài liệu (PDF, trang web, tệp Word…) được cắt thành từng đoạn ngắn gọi là chunk.
- Nhúng: mỗi đoạn được mô hình embedding đổi thành một vector.
- Lưu: vector cùng nội dung gốc được cất vào cơ sở dữ liệu vector, kèm thông tin phụ như tên tệp, ngày cập nhật.
Giai đoạn 2: hỏi và trả lời
- Nhúng câu hỏi: câu hỏi của người dùng cũng được đổi thành vector bằng cùng mô hình embedding.
- Tìm hàng xóm: hệ thống tìm vài đoạn có vector gần câu hỏi nhất (thường 3–10 đoạn).
- Ghép và trả lời: các đoạn tìm được được dán vào câu lệnh kèm chỉ dẫn kiểu “chỉ trả lời dựa trên tài liệu sau, ghi rõ nguồn”. LLM đọc và viết câu trả lời.
Điều quan trọng: LLM không hề được huấn luyện lại. Nó chỉ nhận thêm “tài liệu tham khảo” trong câu lệnh. Vì vậy, đổi tài liệu là kiến thức đổi theo ngay, không tốn công huấn luyện.
Chia nhỏ tài liệu và cơ sở dữ liệu vector
Vì sao phải chia nhỏ (chunking)?
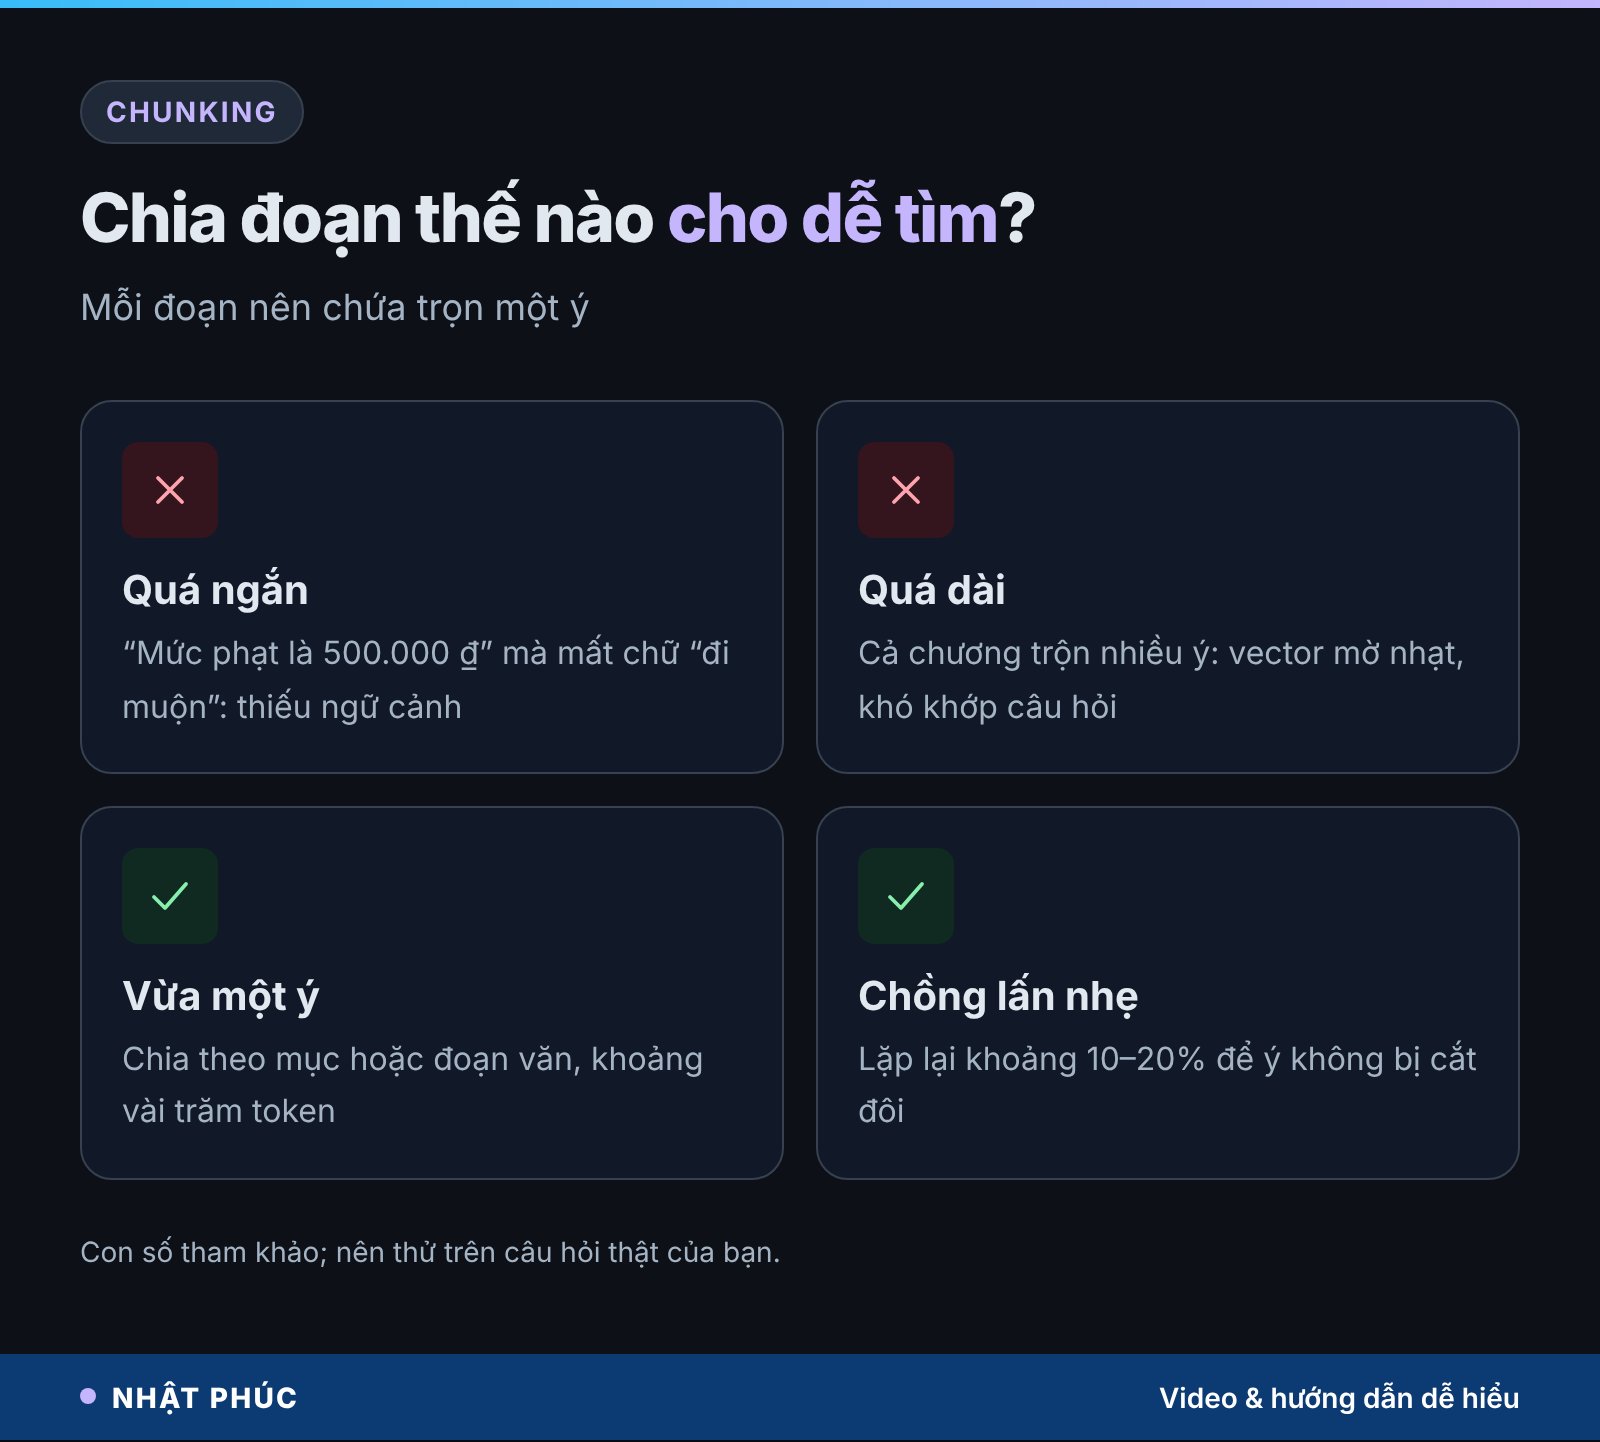
Một vector đại diện cho “ý chính” của cả đoạn. Đoạn càng dài thì càng nhiều ý trộn lẫn, vector càng mờ nhạt, giống như lấy trung bình màu của cả bức tranh. Ngược lại, đoạn quá ngắn thì mất ngữ cảnh: câu “mức phạt là 500.000 ₫” mà không kèm “đi muộn” thì vô nghĩa.
Trong thực tế, người ta thường chia theo đoạn văn hoặc mục, mỗi chunk khoảng vài trăm token, và cho các đoạn chồng lấn một phần (ví dụ 10–20%) để ý không bị cắt đôi ở ranh giới. Không có con số vàng: tài liệu pháp lý, hướng dẫn kỹ thuật hay hội thoại CSKH cần cách chia khác nhau, và nên thử trên câu hỏi thật.
Cơ sở dữ liệu vector là gì?
Cơ sở dữ liệu vector (vector database) là nơi lưu hàng nghìn tới hàng tỷ vector và tìm nhanh những vector gần một vector cho trước. So từng cặp một thì quá chậm, nên chúng dùng thuật toán tìm láng giềng gần đúng (approximate nearest neighbor), chấp nhận sai số rất nhỏ để đổi lấy tốc độ. Một số cái tên phổ biến: thư viện FAISS của Meta, tiện ích pgvector cho PostgreSQL, Chroma, Qdrant, Milvus, Weaviate hay dịch vụ Pinecone.
Đo “gần” bằng cách nào?
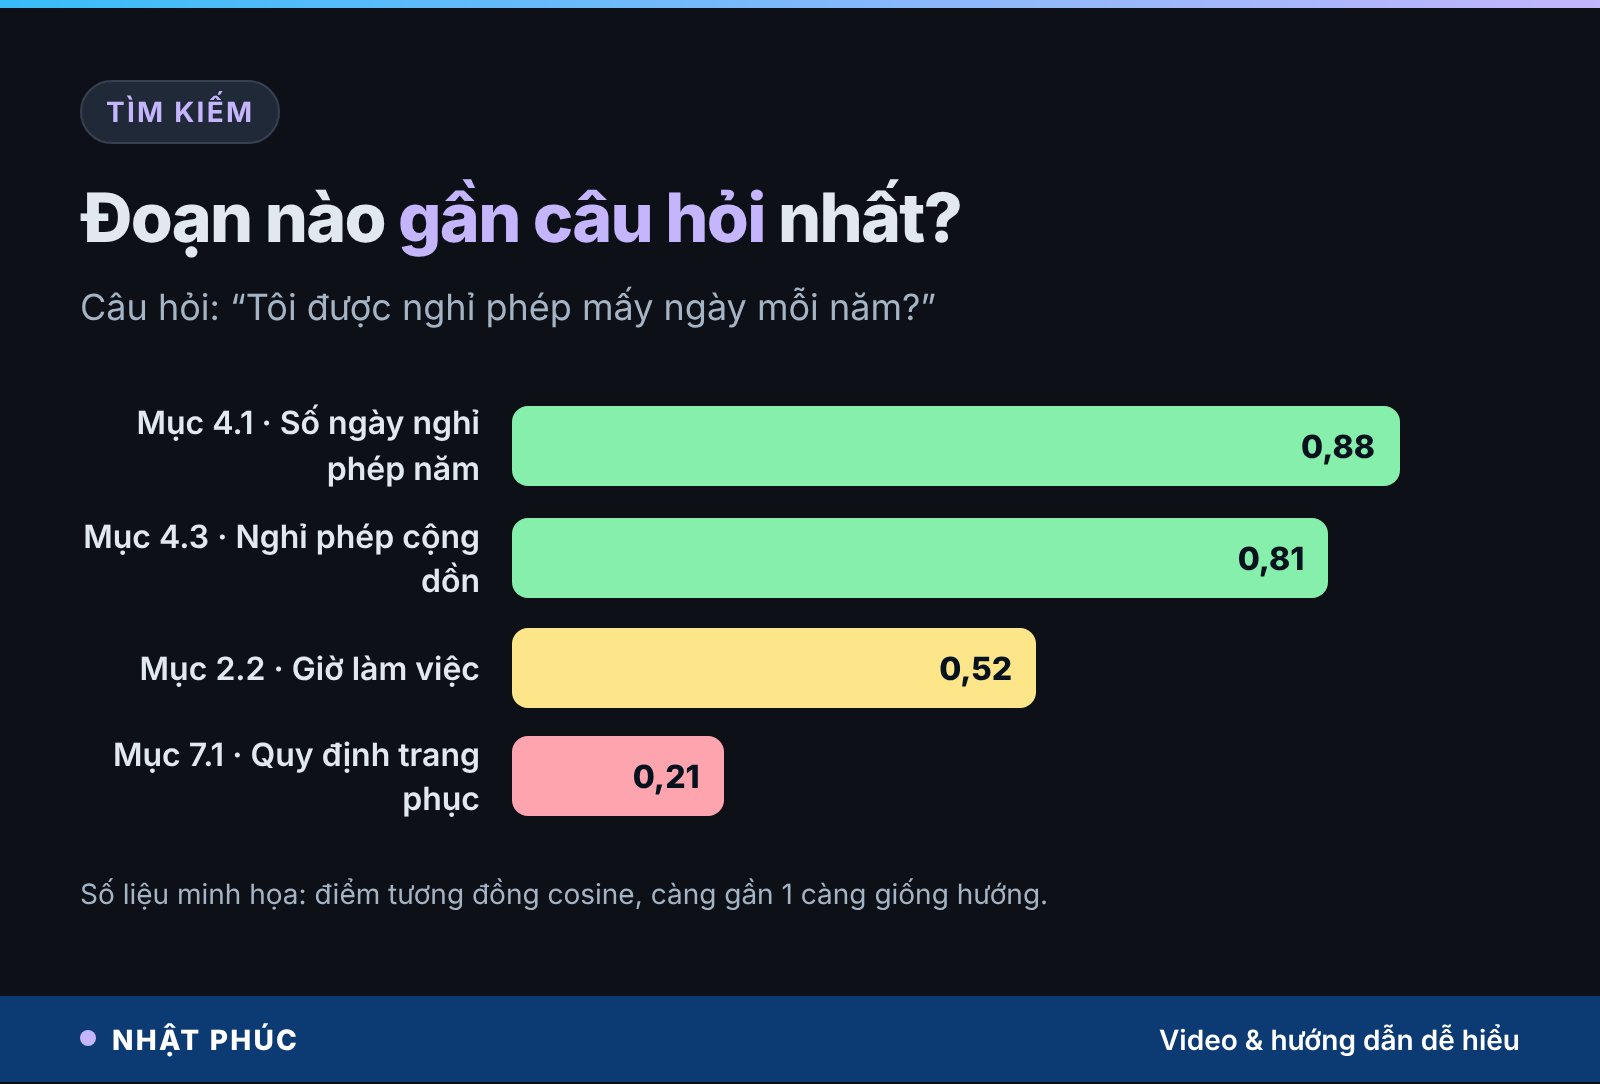
Cách thông dụng là độ tương đồng cosine: đo góc giữa hai vector. Hai vector cùng hướng cho điểm gần 1, càng lệch hướng điểm càng thấp. Hệ thống sắp xếp các đoạn theo điểm này và lấy những đoạn đứng đầu.
Tìm kiếm ngữ nghĩa khác tìm theo từ khóa ra sao
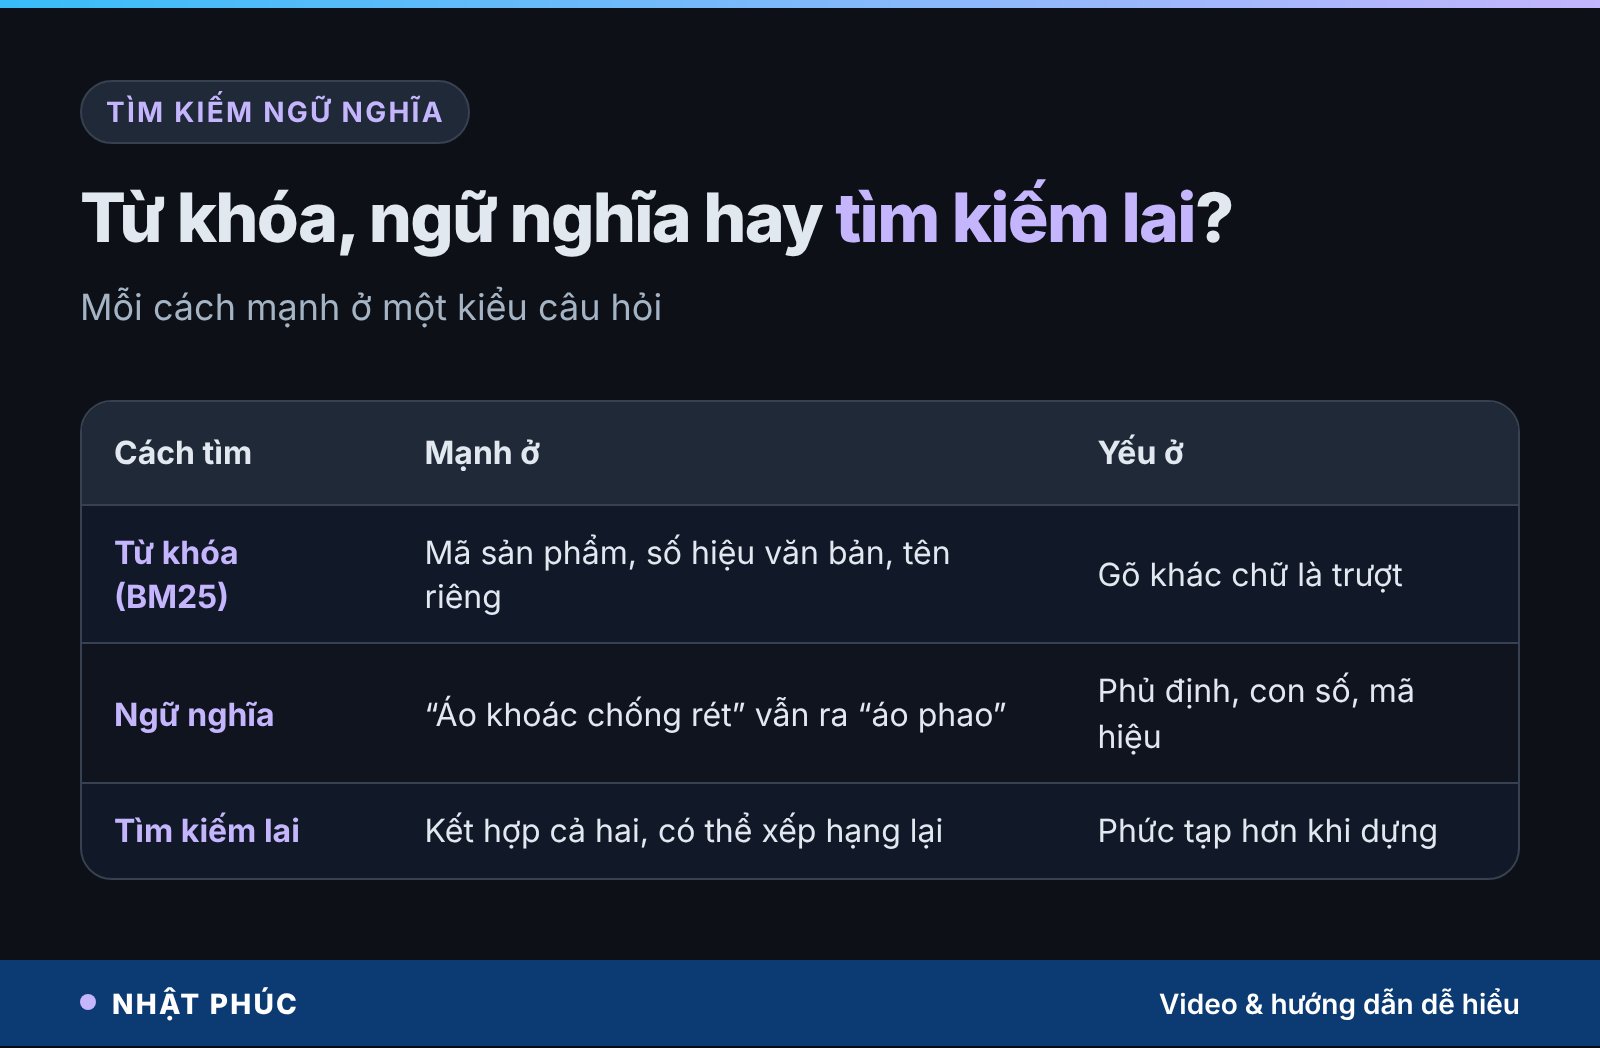
Tìm theo từ khóa (kiểu Ctrl + F, hay thuật toán BM25 của các công cụ tìm kiếm cổ điển) chỉ đếm chữ trùng. Bạn gõ “áo khoác chống rét” thì món hàng tên “áo phao” có thể bị bỏ qua vì không trùng chữ nào.
Tìm kiếm ngữ nghĩa (semantic search) so tọa độ nghĩa thay vì so chữ. “Áo khoác chống rét” và “áo phao” nằm gần nhau trên bản đồ nghĩa, nên vẫn khớp. Đây chính là ví dụ trong video: cửa hàng hiện áo phao dù bạn không gõ chữ “phao”.
Nhưng tìm theo nghĩa cũng có điểm yếu: nó kém với mã sản phẩm, số hiệu văn bản, tên riêng hiếm, như “Nghị định 100/2019”. Vì vậy nhiều hệ thống dùng tìm kiếm lai (hybrid search): chạy song song cả hai cách rồi trộn kết quả, sau đó có thể thêm bước xếp hạng lại (rerank) bằng một mô hình chấm điểm kỹ hơn.
Ứng dụng RAG trong đời thực
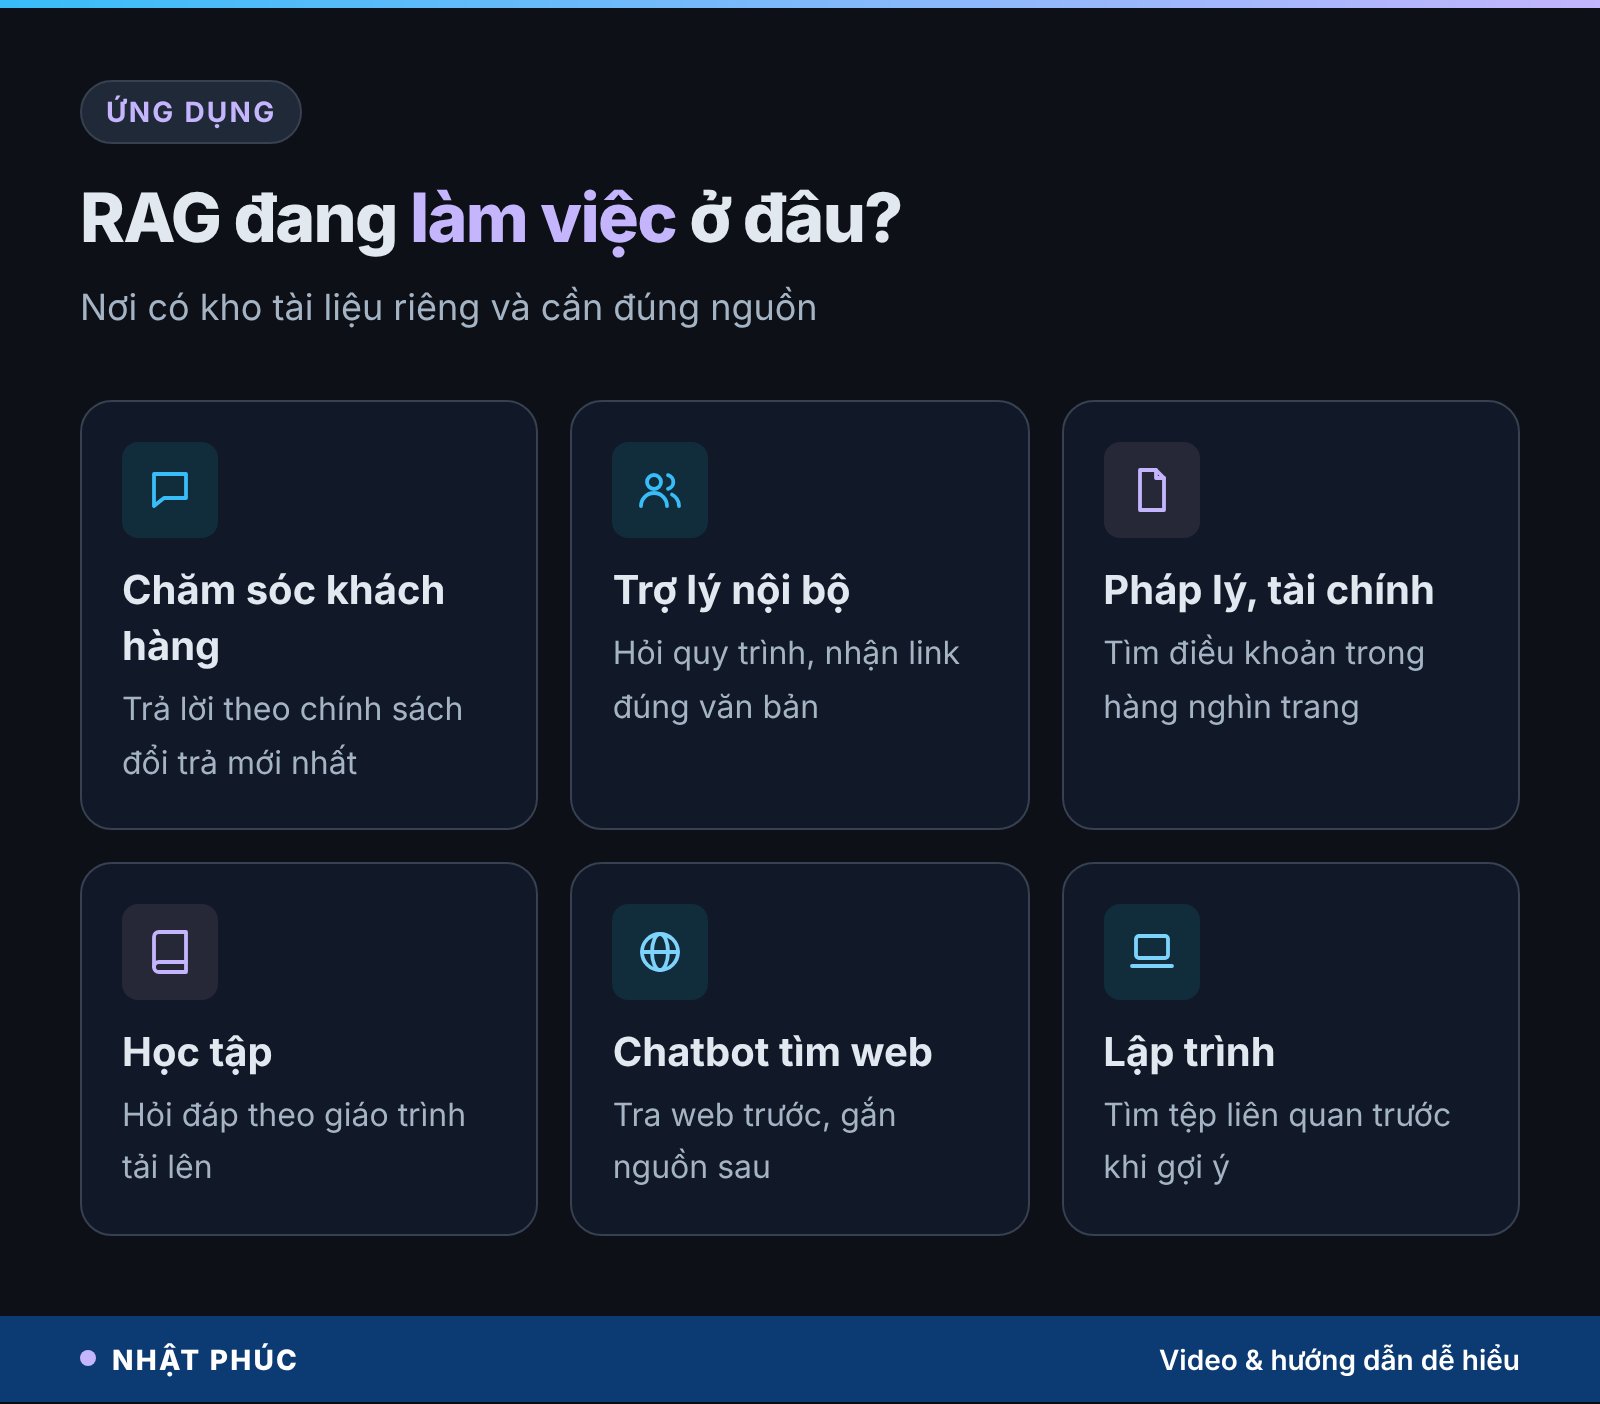
Nhiều thứ bạn dùng hằng ngày đã có bóng dáng RAG hoặc tìm kiếm ngữ nghĩa phía sau:
- Chăm sóc khách hàng: chatbot trả lời theo chính sách đổi trả, bảo hành mới nhất của cửa hàng thay vì kiến thức chung chung.
- Trợ lý nội bộ doanh nghiệp: nhân viên hỏi “quy trình xin tạm ứng thế nào” và nhận câu trả lời kèm đường dẫn tới đúng văn bản.
- Tra cứu pháp lý, tài chính: tìm điều khoản liên quan trong hàng nghìn trang hợp đồng, văn bản.
- Học tập: các công cụ cho phép tải giáo trình, bài giảng lên rồi hỏi đáp, tóm tắt theo đúng tài liệu đó (NotebookLM hay tính năng đính kèm tệp của các chatbot hoạt động theo tinh thần này).
- Chatbot có tìm kiếm web: trợ lý AI tra web trước khi trả lời và gắn nguồn là một dạng RAG, chỉ khác “kho tài liệu” là cả Internet.
- Lập trình: trợ lý code tìm các tệp liên quan trong dự án trước khi gợi ý sửa.
Ngoài RAG, embedding còn là nền của hệ thống gợi ý (đặt bài hát và người nghe trên cùng một bản đồ), phát hiện nội dung trùng lặp, phân nhóm phản hồi khách hàng và tìm ảnh bằng câu mô tả.
RAG, fine-tuning hay ngữ cảnh dài: chọn cách nào
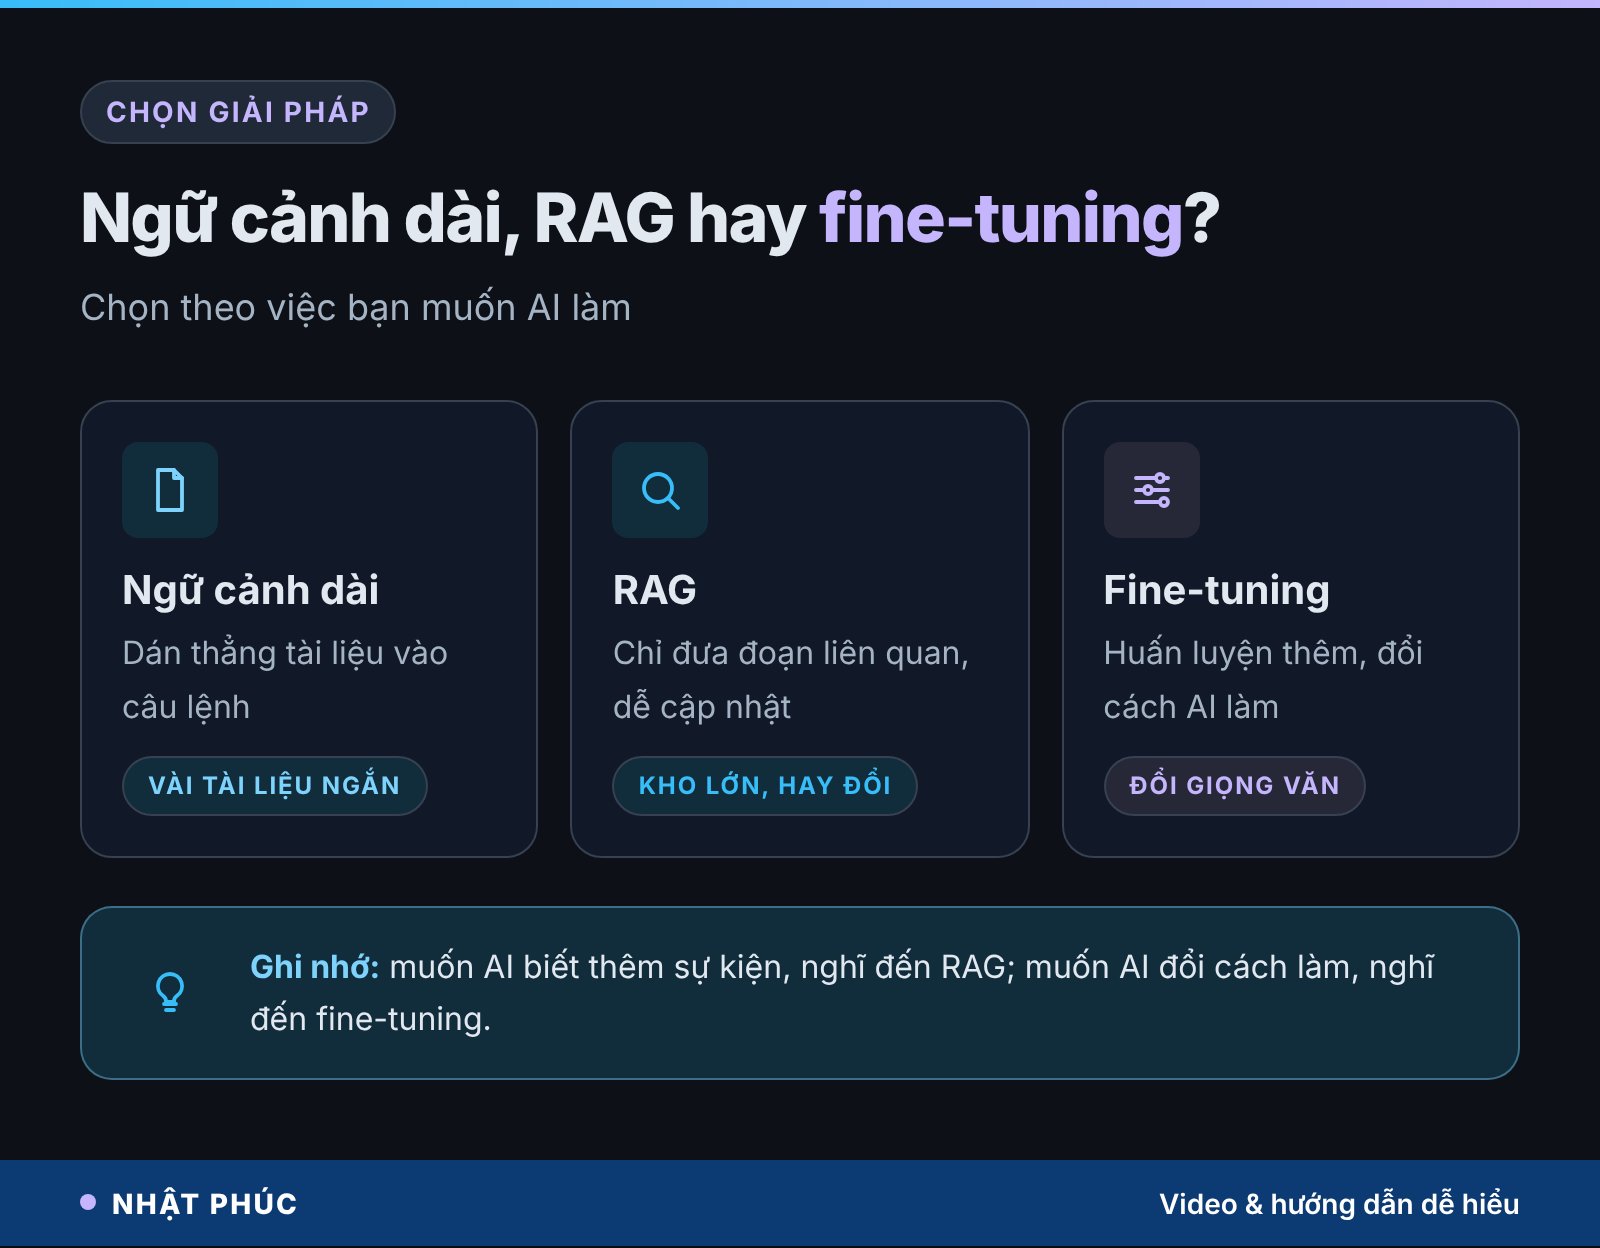
Có ba cách chính để AI “biết” thêm về chuyện của bạn. Chúng không loại trừ nhau, nhưng mỗi cách hợp một loại việc.
- Nhồi thẳng vào ngữ cảnh: dán cả tài liệu vào câu lệnh. Đơn giản nhất, hợp khi tài liệu ngắn và chỉ dùng vài lần. Tài liệu dài thì tốn token, chậm và mô hình dễ bỏ sót thông tin nằm giữa.
- RAG: chỉ đưa những đoạn liên quan. Hợp với kho tài liệu lớn, hay thay đổi, cần trích nguồn.
- Fine-tuning: huấn luyện thêm mô hình trên dữ liệu của bạn. Hợp để dạy phong cách, định dạng, kỹ năng lặp lại; không phải cách tốt để nạp sự kiện hay đổi, vì mỗi lần cập nhật phải huấn luyện lại.
| Tiêu chí | Ngữ cảnh dài | RAG | Fine-tuning |
|---|---|---|---|
| Cập nhật kiến thức | Dán lại tài liệu mới | Thêm, sửa tài liệu trong kho | Phải huấn luyện lại |
| Quy mô tài liệu | Nhỏ, vừa cửa sổ ngữ cảnh | Rất lớn | Không giới hạn nhưng tốn công |
| Trích nguồn | Có thể | Dễ, gắn sẵn tên tệp | Khó |
| Hợp nhất với | Hỏi nhanh vài tài liệu | Sự kiện, quy định, kho tri thức | Giọng văn, định dạng, kỹ năng |
Giới hạn và rủi ro của RAG
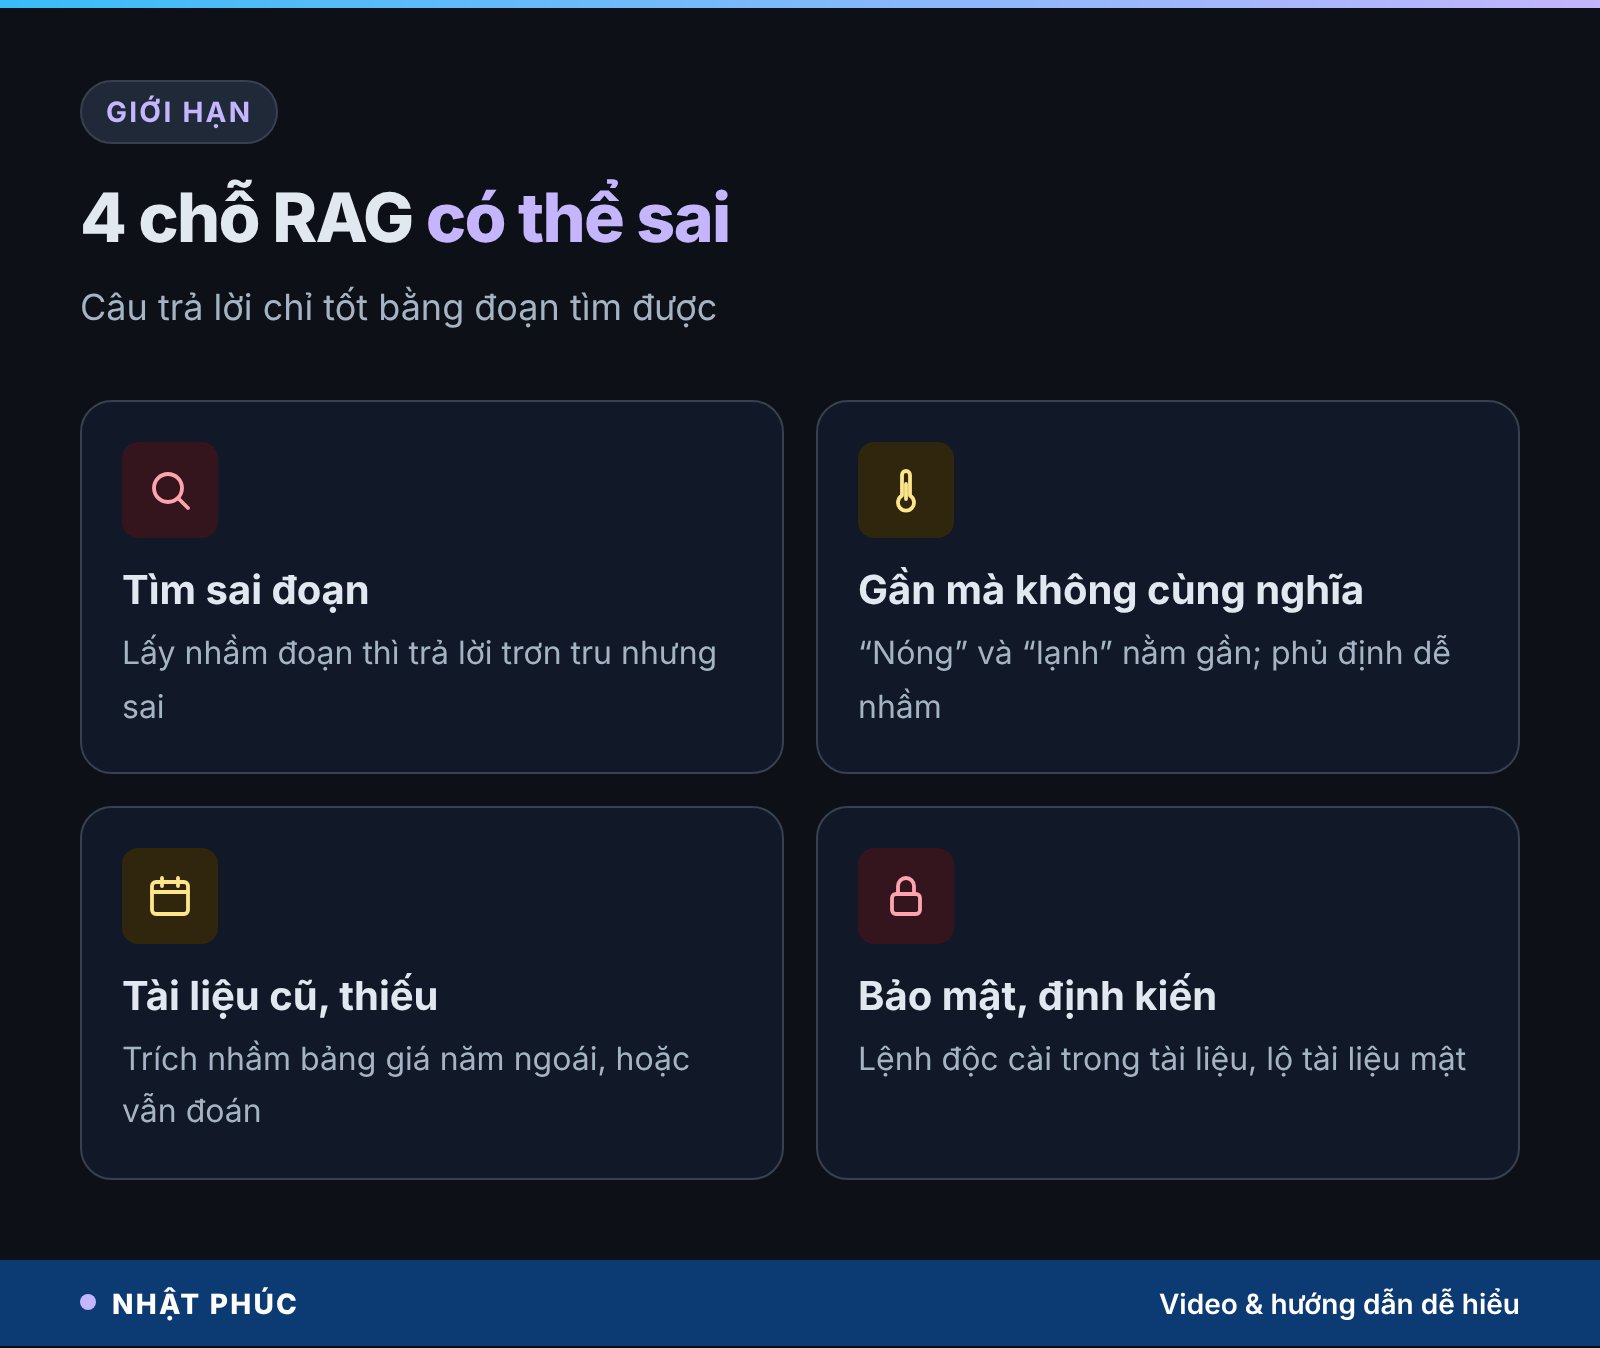
RAG giảm bịa, nhưng không xoá được bịa. Câu trả lời chỉ tốt bằng đoạn tài liệu được tìm thấy, và có nhiều chỗ có thể trục trặc.
Tìm sai đoạn thì trả lời sai
Nếu bước tìm kiếm lấy nhầm đoạn, LLM sẽ trả lời rất trơn tru… dựa trên thông tin sai. Đây là lỗi phổ biến nhất, và thường nằm ở cách chia đoạn hoặc chọn mô hình embedding chưa hợp với ngôn ngữ, lĩnh vực.
Gần trên bản đồ chưa chắc cùng nghĩa
Như video nhắc, “nóng” và “lạnh” nằm khá gần nhau vì xuất hiện trong những câu rất giống nhau. Câu hỏi “khi nào không được hoàn tiền” có thể kéo về đoạn nói về “được hoàn tiền”. Phủ định, so sánh, con số là những chỗ embedding hay nhầm.
Tài liệu cũ, mâu thuẫn hoặc thiếu
Kho chứa cả bảng giá năm ngoái lẫn năm nay thì AI có thể trích nhầm bản cũ. Câu hỏi nằm ngoài kho thì một số hệ thống vẫn “đoán”. Cần gắn ngày cập nhật, xoá bản lỗi thời và dặn rõ “không có trong tài liệu thì nói không biết”.
Định kiến và bảo mật
Bản đồ nghĩa học từ văn bản nên mang theo định kiến của văn bản. Ngoài ra, tài liệu đưa vào kho có thể chứa câu lệnh độc hại cài cắm (prompt injection gián tiếp), và nếu không phân quyền, nhân viên này có thể hỏi ra tài liệu mật mà lẽ ra chỉ phòng khác được xem.
Hiểu lầm phổ biến về RAG
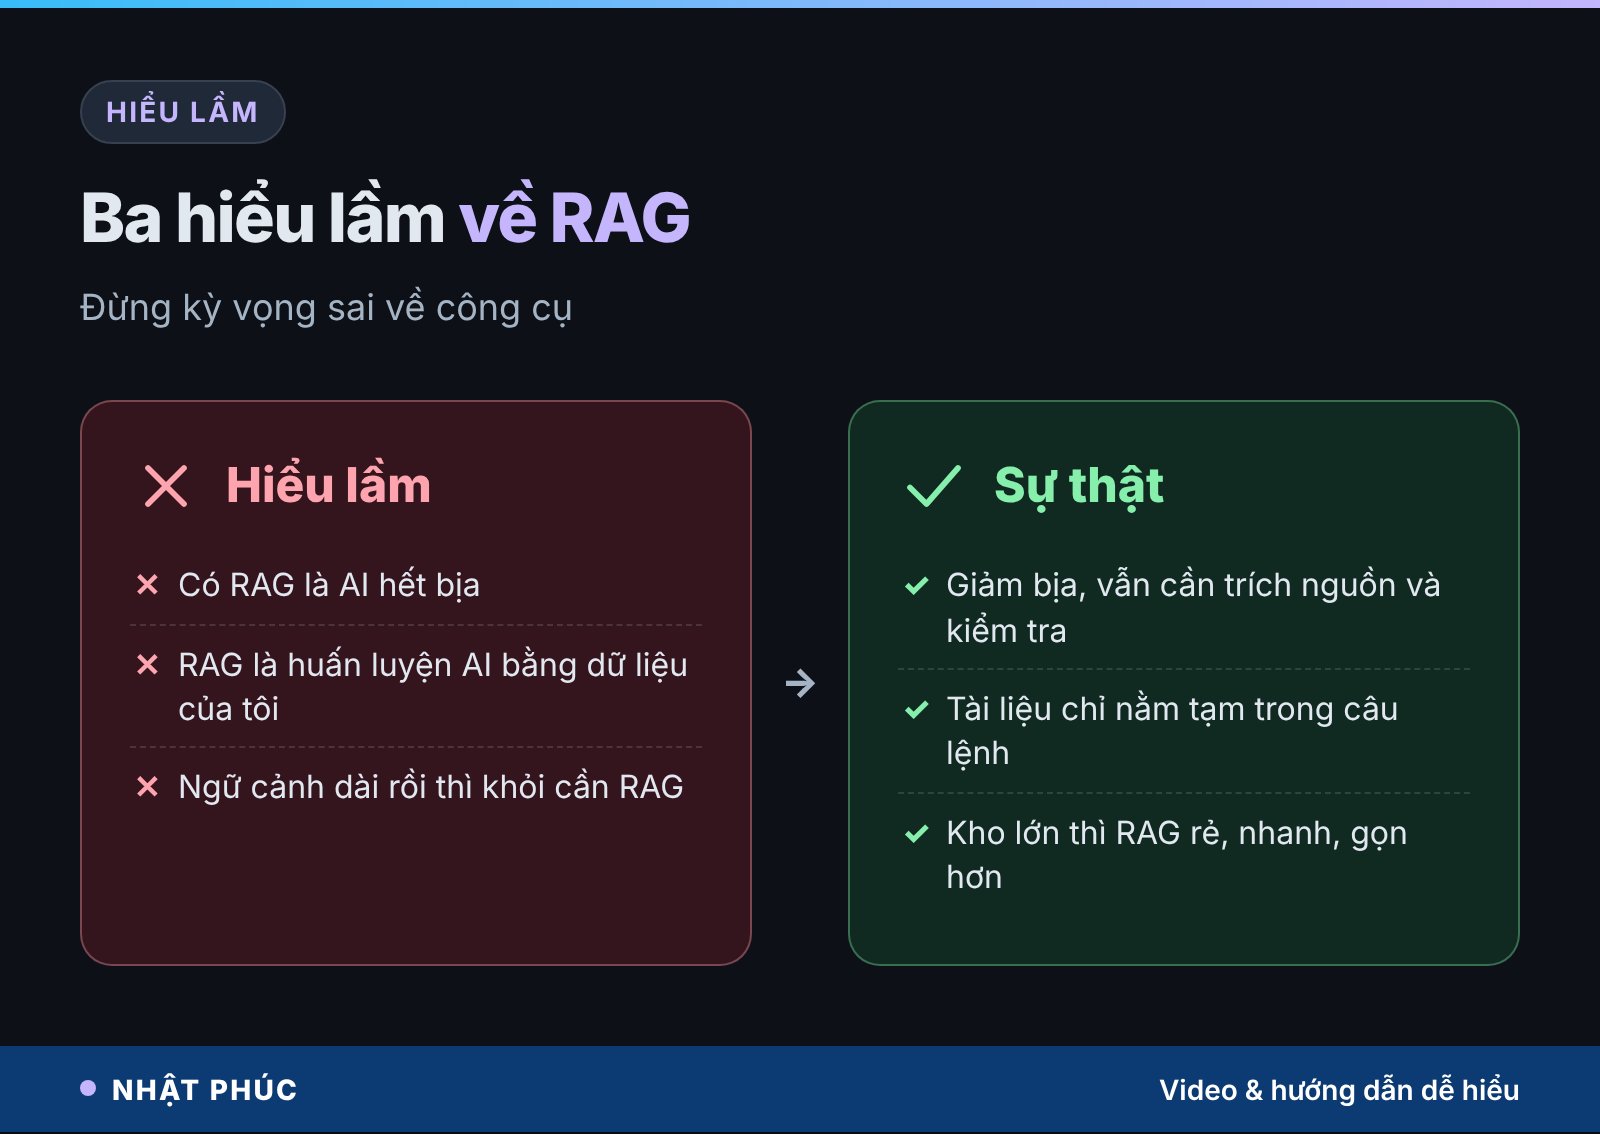
“Có RAG là AI hết bịa”
Sai. RAG giảm đáng kể việc bịa khi tài liệu đúng và được tìm đúng, nhưng mô hình vẫn có thể hiểu sai, ghép sai hoặc tự thêm chi tiết. Hãy luôn yêu cầu trích nguồn và kiểm tra các con số quan trọng.
“RAG là huấn luyện AI bằng dữ liệu của tôi”
Không. Mô hình không học thêm gì cả; tài liệu chỉ được đưa vào câu lệnh tạm thời. Xoá tài liệu khỏi kho là AI không còn “biết” nữa.
“Cửa sổ ngữ cảnh dài rồi thì không cần RAG”
Chưa hẳn. Cửa sổ dài giúp đọc được nhiều hơn, nhưng nhồi hàng nghìn trang mỗi lần hỏi thì tốn chi phí, chậm và dễ bỏ sót thông tin nằm giữa. Với kho tài liệu lớn, RAG vẫn rẻ và gọn hơn; hai cách thường được dùng kết hợp.
“Embedding hiểu nghĩa như con người”
Embedding chỉ biết chữ nào hay đi cùng chữ nào. Như video ví von, người lái taxi thuộc đường không có nghĩa là hiểu vì sao khách muốn tới đó.
Tự dựng RAG đơn giản trong 7 bước
Bạn không cần là kỹ sư AI để thử. Nhiều nền tảng không cần viết mã (công cụ tải tệp lên chatbot, trình tạo trợ lý tùy chỉnh) đã làm sẵn phần RAG. Nếu biết chút Python, bạn có thể tự dựng để hiểu rõ từng khâu.
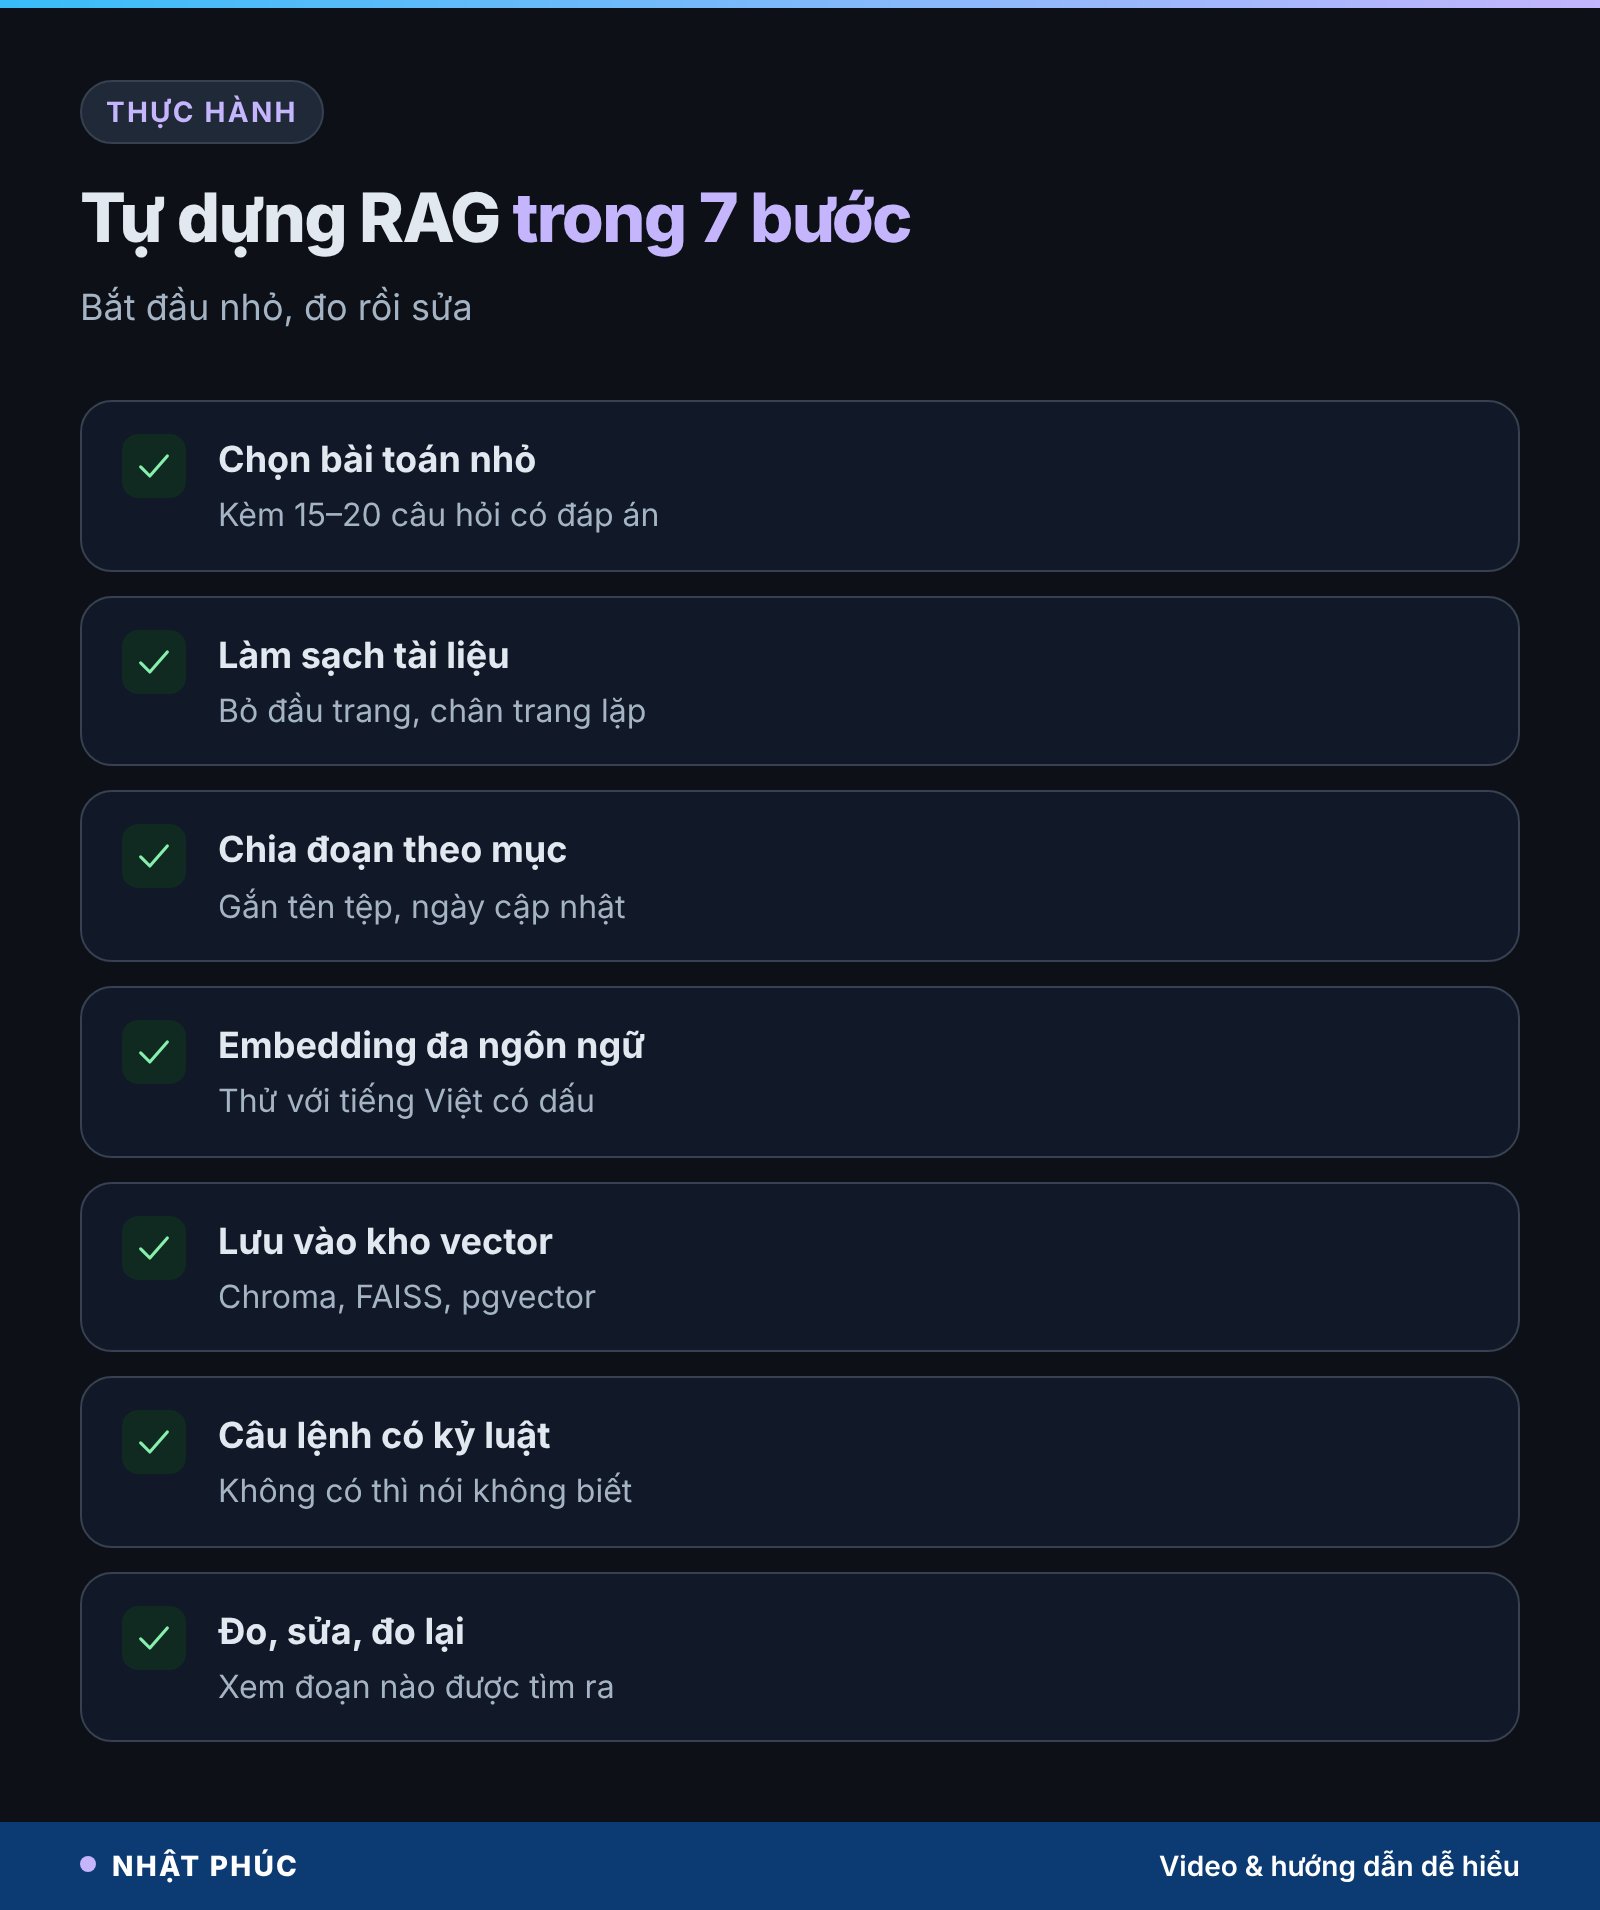
1. Chọn một bài toán nhỏ, rõ ràng
Ví dụ: hỏi đáp về sổ tay nhân sự 30 trang. Viết sẵn 15–20 câu hỏi thật kèm đáp án đúng để làm bộ chấm điểm.
2. Làm sạch tài liệu
Chuyển PDF sang văn bản, bỏ đầu trang, chân trang, số trang lặp lại; giữ tiêu đề mục vì chúng là ngữ cảnh quý.
3. Chia đoạn theo cấu trúc
Chia theo mục hoặc đoạn văn, có chồng lấn nhẹ. Gắn kèm tên tệp, tên mục, ngày cập nhật cho mỗi đoạn.
4. Chọn mô hình embedding hỗ trợ tiếng Việt
Ưu tiên mô hình đa ngôn ngữ và thử trên bộ câu hỏi của bạn; mô hình chỉ giỏi tiếng Anh có thể tìm kém với tiếng Việt có dấu.
5. Lưu vào kho vector
Với dự án nhỏ, Chroma hoặc FAISS chạy ngay trên máy là đủ; dữ liệu đã nằm trong PostgreSQL thì cân nhắc pgvector.
6. Viết câu lệnh có kỷ luật
Ví dụ: “Chỉ trả lời dựa trên các đoạn tài liệu bên dưới. Ghi tên mục làm nguồn. Nếu tài liệu không có thông tin, hãy nói: Tài liệu không đề cập.”
7. Đo, sửa, đo lại
Chạy bộ câu hỏi, xem đoạn nào được tìm ra cho mỗi câu. Sai ở bước tìm thì chỉnh cách chia hoặc thêm tìm kiếm lai; tìm đúng mà trả lời sai thì chỉnh câu lệnh.
Mẹo cho người dùng thường: khi tải tài liệu lên chatbot, hãy hỏi cụ thể, yêu cầu “trích nguyên văn đoạn liên quan” và đối chiếu với tài liệu gốc trước khi dùng con số.
Câu hỏi thường gặp về RAG và embedding
RAG viết tắt của gì?
RAG là Retrieval-Augmented Generation, nghĩa là sinh văn bản được tăng cường bằng truy xuất. Nói gọn: AI tìm tài liệu liên quan trước, rồi mới viết câu trả lời dựa trên tài liệu đó. Thuật ngữ được phổ biến từ bài báo của nhóm Facebook AI Research năm 2020.
Embedding và RAG khác nhau thế nào?
Embedding là kỹ thuật biến chữ thành vector để đo độ gần nghĩa. RAG là cả một quy trình dùng embedding để tìm đoạn tài liệu, rồi giao cho mô hình ngôn ngữ viết câu trả lời. Embedding là chiếc la bàn; RAG là cả chuyến đi tìm và trả lời.
Cơ sở dữ liệu vector có bắt buộc không?
Không bắt buộc. Với vài trăm đoạn văn, bạn có thể lưu vector trong một tệp và so trực tiếp. Cơ sở dữ liệu vector cần khi kho lớn tới hàng trăm nghìn đoạn trở lên, cần tìm nhanh, lọc theo thông tin phụ và cập nhật thường xuyên.
RAG có dùng được với tiếng Việt không?
Dùng được, nhưng chất lượng phụ thuộc nhiều vào mô hình embedding. Hãy chọn mô hình đa ngôn ngữ, giữ nguyên dấu, chuẩn hoá Unicode trước khi nhúng và thử bằng câu hỏi tiếng Việt thật. Tìm kiếm lai giúp ích nhiều với tên riêng, số hiệu văn bản.
Đưa tài liệu công ty vào RAG có an toàn không?
Tùy cách triển khai. Cần biết tài liệu và vector được lưu ở đâu, nhà cung cấp có dùng dữ liệu để huấn luyện không, và hệ thống có phân quyền theo người hỏi không. Tài liệu nhạy cảm nên dùng giải pháp chạy nội bộ hoặc gói doanh nghiệp có cam kết rõ.
Vì sao AI có RAG vẫn trả lời sai?
Thường do tìm nhầm đoạn, tài liệu lỗi thời hoặc mâu thuẫn, câu hỏi có phủ định hay con số mà embedding xử lý kém, hoặc câu lệnh không cấm AI tự suy đoán. Kiểm tra đoạn được tìm thấy là cách nhanh nhất để biết lỗi nằm ở đâu.
Kết luận: bản đồ nghĩa và chiếc thẻ thư viện
Embedding biến ý nghĩa thành vị trí: gần nghĩa thì gần nhau. RAG tận dụng tấm bản đồ đó như một chiếc thẻ thư viện, giúp AI tìm đúng trang tài liệu trước khi mở lời. Nhờ vậy chatbot biết chuyện mới, biết chuyện riêng của bạn và có thể chỉ ra nguồn. Nhưng hãy nhớ: máy chỉ đang nhìn bản đồ, chưa từng thật sự hiểu. Tài liệu tốt, cách tìm tốt và một người dùng biết kiểm chứng vẫn là ba thứ không thể thiếu.
Bạn đã từng thử tải tài liệu lên chatbot để hỏi đáp chưa, và kết quả có đúng ý không? Hãy chia sẻ trong phần bình luận, và theo dõi Nhật Phúc cùng kênh Vọc Sĩ để hiểu thêm về AI theo cách dễ hiểu nhất.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.