Bạn có để ý rằng các AI agent ngày càng làm được nhiều việc, nhưng hoá đơn API cũng phình ra theo? Một agent chăm sóc khách hàng có thể gọi mô hình hàng chục lần chỉ để xử lý một yêu cầu. Nếu lần nào cũng dùng mô hình đắt nhất, chi phí sẽ nhanh chóng vượt khỏi tầm kiểm soát. Đó là lý do mô hình AI nhỏ đang trở thành “nhân vật chính” mới của cuộc đua AI.
Ngày 9/11/2026, Meta giới thiệu Muse Ember, mô hình nhỏ nhất và tiết kiệm nhất trong dòng Muse, được thiết kế riêng cho phần việc lặp đi lặp lại của AI agent. Bài viết này dùng Muse Ember làm ví dụ để giải thích: mô hình nhỏ được tạo ra thế nào, vì sao “giá mỗi token” chưa nói lên tất cả, và cách chọn một mô hình nhỏ cho bài toán tự động hoá của riêng bạn.
Câu trả lời ngắn: Mô hình AI nhỏ là mô hình ngôn ngữ có quy mô và chi phí vận hành thấp hơn nhiều so với mô hình “cờ hiệu”, đổi lại kiến thức rộng kém hơn. Nó hợp với việc khối lượng lớn, lặp lại như phân loại, trích xuất, gọi công cụ. Muse Ember của Meta là ví dụ mới: điểm trí tuệ ngang Claude Haiku 5.5 nhưng chi phí mỗi tác vụ chỉ bằng khoảng một phần ba.
Tóm tắt nhanh
- Muse Ember (mã API muse-ember-1.0) ra mắt ngày 9/11/2026, là mô hình nhỏ nhất của Meta, chỉ dùng qua API, không công bố trọng số.
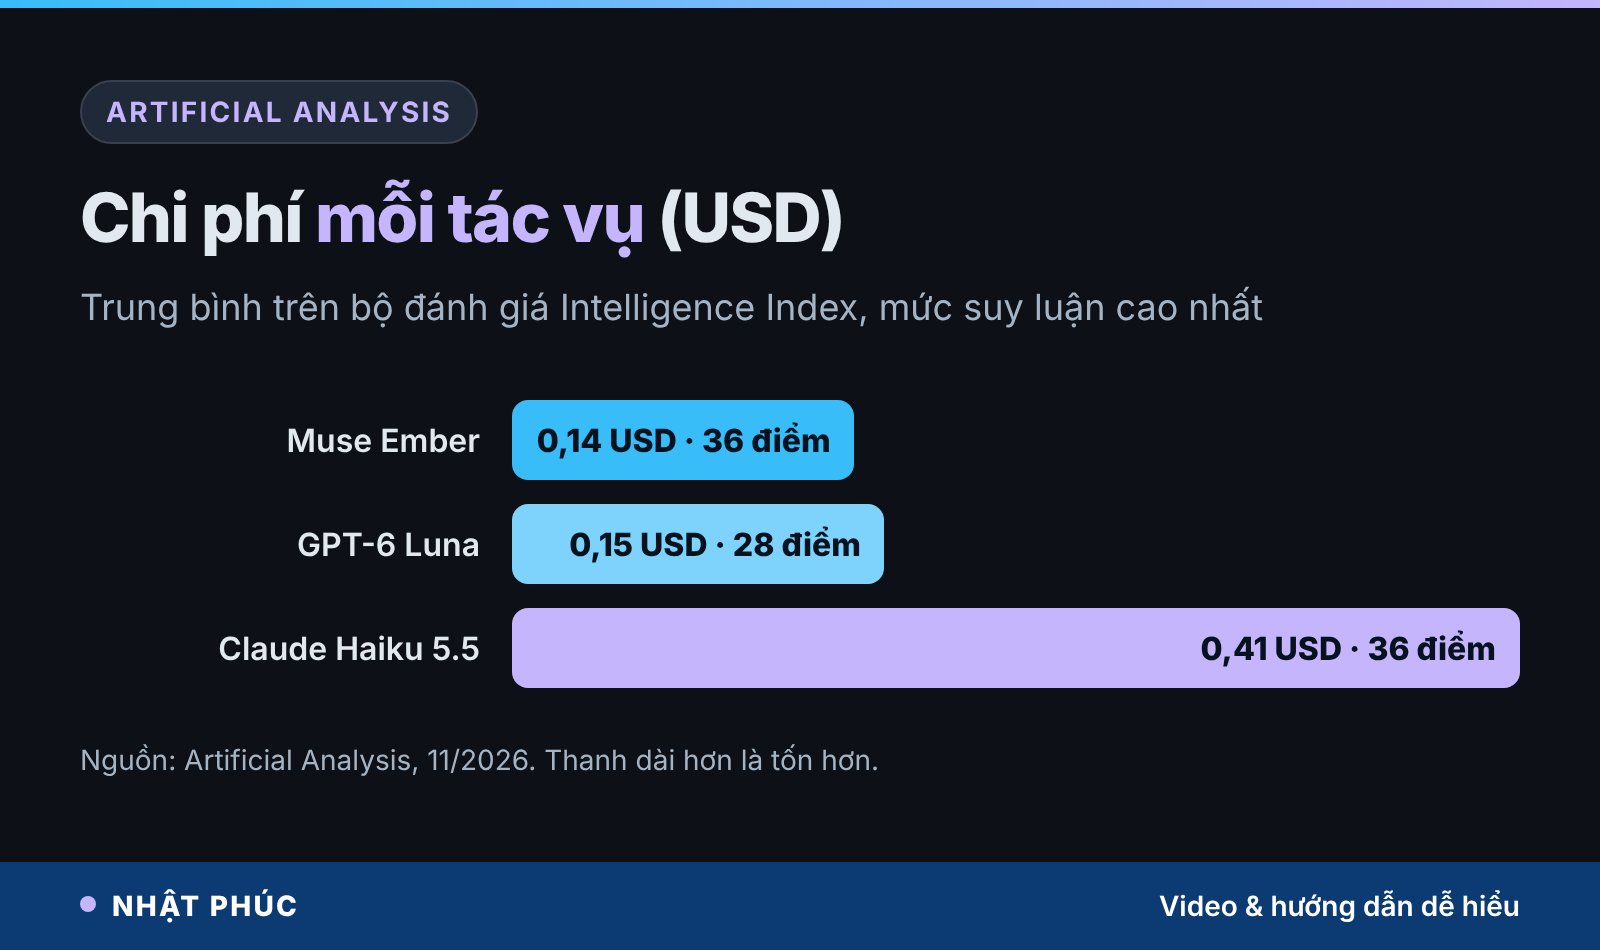
- Theo Artificial Analysis, Ember đạt 36 điểm Intelligence Index, chi phí khoảng 0,14 USD mỗi tác vụ, so với 0,41 USD của Claude Haiku 5.5 cùng điểm.
- Giá niêm yết: 0,10 USD/1 triệu token đầu vào, 0,50 USD/1 triệu token đầu ra; ngữ cảnh 1.048.576 token.
- Điểm yếu: kiến thức tra cứu thấp (độ chính xác 21,1% trên AA-Omniscience) và hay từ chối trả lời.
- Cách dùng hợp lý: để mô hình lớn lập kế hoạch, mô hình nhỏ xử lý phần việc lặp lại.
Nội dung chính:
- Muse Ember là gì?
- Vì sao AI agent cần mô hình AI nhỏ?
- Mô hình AI nhỏ được tạo ra thế nào?
- Giá mỗi token khác chi phí mỗi tác vụ ra sao?
- Muse Ember mạnh, yếu ở đâu?
- Bậc giá 200.000 token: cái bẫy của ngữ cảnh dài
- Ứng dụng mô hình AI nhỏ trong tự động hoá
- Người Việt có dùng được Muse Ember không?
- 6 bước chọn mô hình AI nhỏ cho tự động hoá
- Rủi ro và hiểu lầm phổ biến
- Câu hỏi thường gặp
Muse Ember là gì?
Muse Ember là mô hình ngôn ngữ do Meta Superintelligence Labs phát triển, công bố ngày 9/11/2026. Meta mô tả đây là mô hình “nhỏ nhất và hiệu quả nhất” của hãng, xây dựng cho việc thực thi suy luận phức tạp và phần việc hằng ngày của agent: chuyển tiếp quy trình qua nhiều ứng dụng, gọi công cụ theo trình tự, chạy kiểm thử và sửa mã có mục tiêu.
Ember là mô hình đầu tiên Meta huấn luyện dựa trên Muse Wonder, mô hình lớn hàng đầu của hãng. Nếu bạn đã đọc bài về Meta Muse Spaces và cách tạo app bằng AI không cần code, thì Muse là tên chung cho cả một họ sản phẩm; Ember là “người em út” của họ mô hình đó.
Thông số chính
- Cửa sổ ngữ cảnh: 1.048.576 token (khoảng 1 triệu), đầu ra tối đa 524.288 token.
- Giá (yêu cầu dưới 200.000 token đầu vào): 0,10 USD/1 triệu token đầu vào, 0,004 USD/1 triệu token đầu vào đã lưu đệm (cache), 0,50 USD/1 triệu token đầu ra.
- Nơi dùng: Meta Model API và công cụ lập trình Muse Code. Ember không có trong ứng dụng Meta AI hay WhatsApp.
- Giấy phép: mô hình đóng, không phát hành trọng số để tải về, nên không tự chạy trên máy được.
Điểm đáng chú ý là Meta không định vị Ember như một chatbot để trò chuyện, mà như “công nhân” chạy phía sau các hệ thống tự động. Để hiểu vì sao điều này quan trọng, cần nhìn vào cách một AI agent thực sự làm việc.
Vì sao AI agent cần mô hình AI nhỏ?
Một AI agent không trả lời một lần là xong. Nó nhận mục tiêu, chia nhỏ thành các bước, gọi công cụ (tìm kiếm, đọc file, gửi email), kiểm tra kết quả rồi lặp lại. Mỗi vòng như vậy là một lần gọi mô hình, và mỗi lần gọi đều tốn token. Bạn có thể đọc thêm về đơn vị tính này trong bài tiếng Việt tốn token hơn tiếng Anh.
Hãy hình dung một nhà hàng. Bếp trưởng lên thực đơn, quyết định món nào nấu trước, món nào cần nêm lại. Nhưng việc nhặt rau, thái thịt, rửa bát do phụ bếp làm. Không nhà hàng nào để bếp trưởng lương cao đi rửa hàng trăm cái bát mỗi tối.
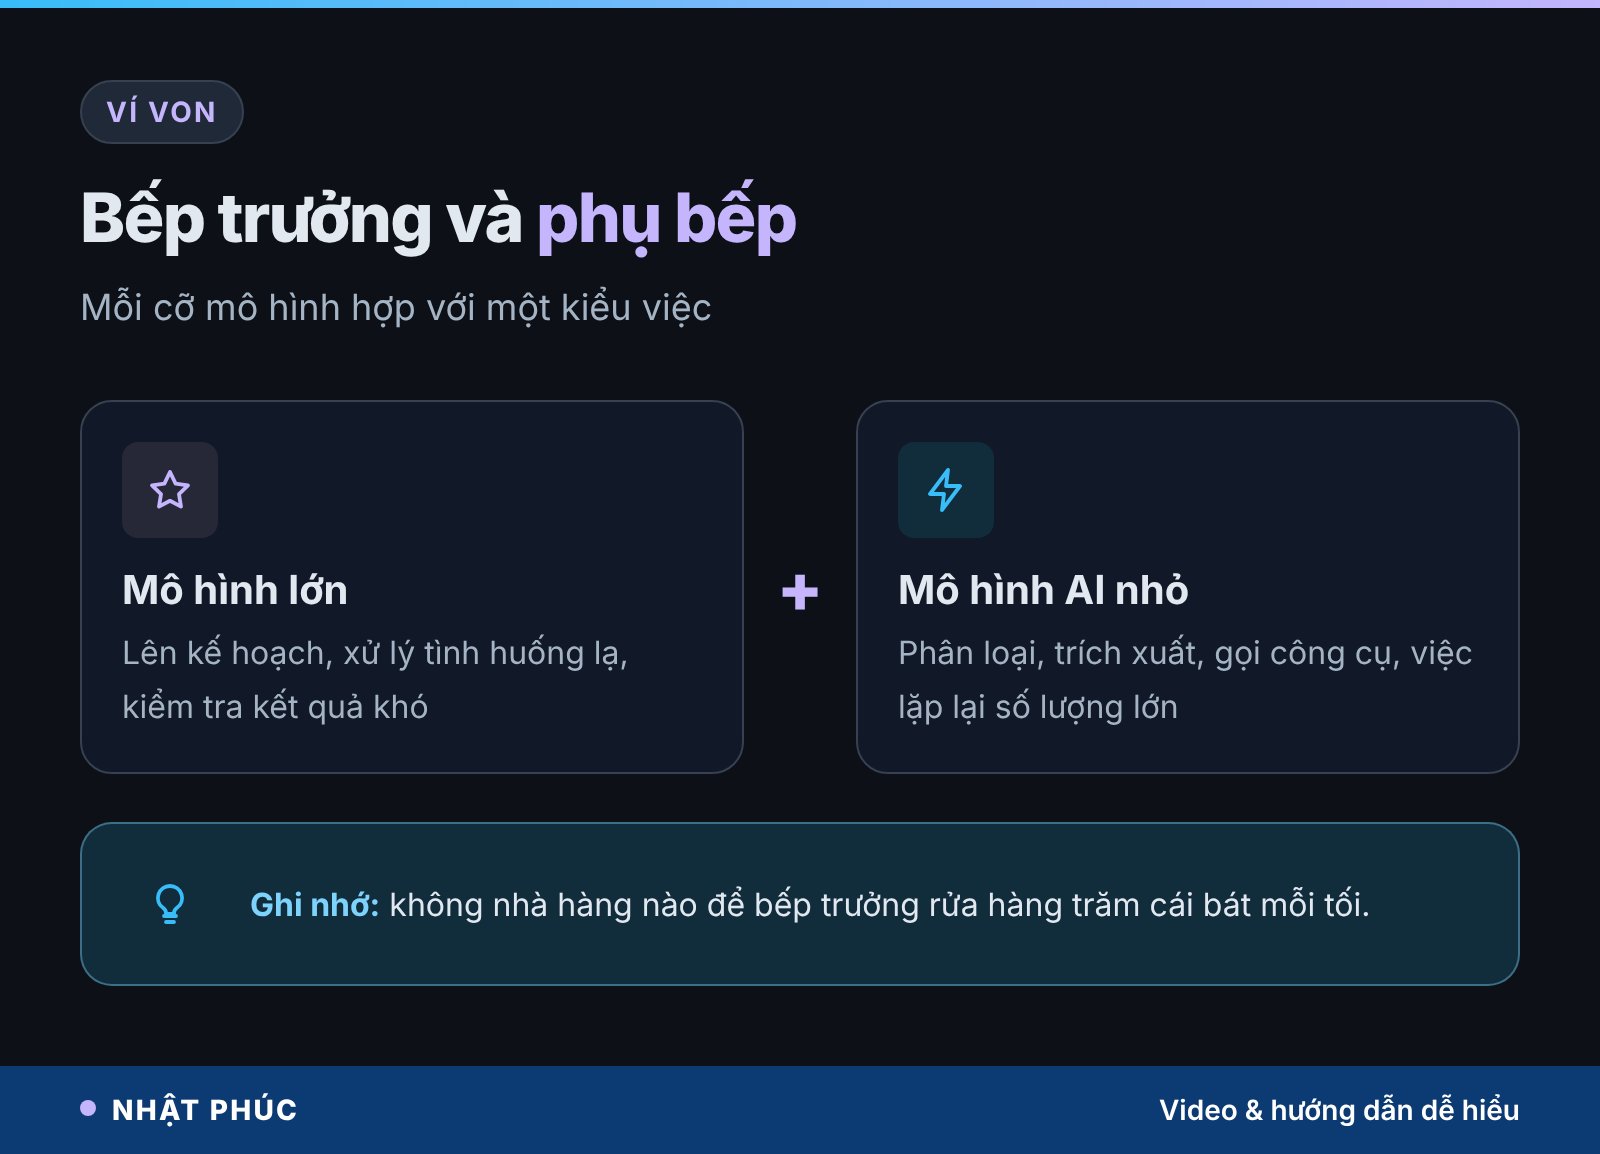
AI agent cũng vậy. Phần lập kế hoạch, xử lý tình huống lạ cần mô hình lớn. Còn phân loại một email, trích một con số từ hoá đơn, chọn công cụ phù hợp thì mô hình nhỏ làm đủ tốt với giá rẻ hơn nhiều. Đây cũng chính là cách Meta định vị Ember: mô hình dành cho phần việc agent lặp lại với khối lượng lớn, như gọi công cụ, trích xuất dữ liệu, đọc tài liệu dài.
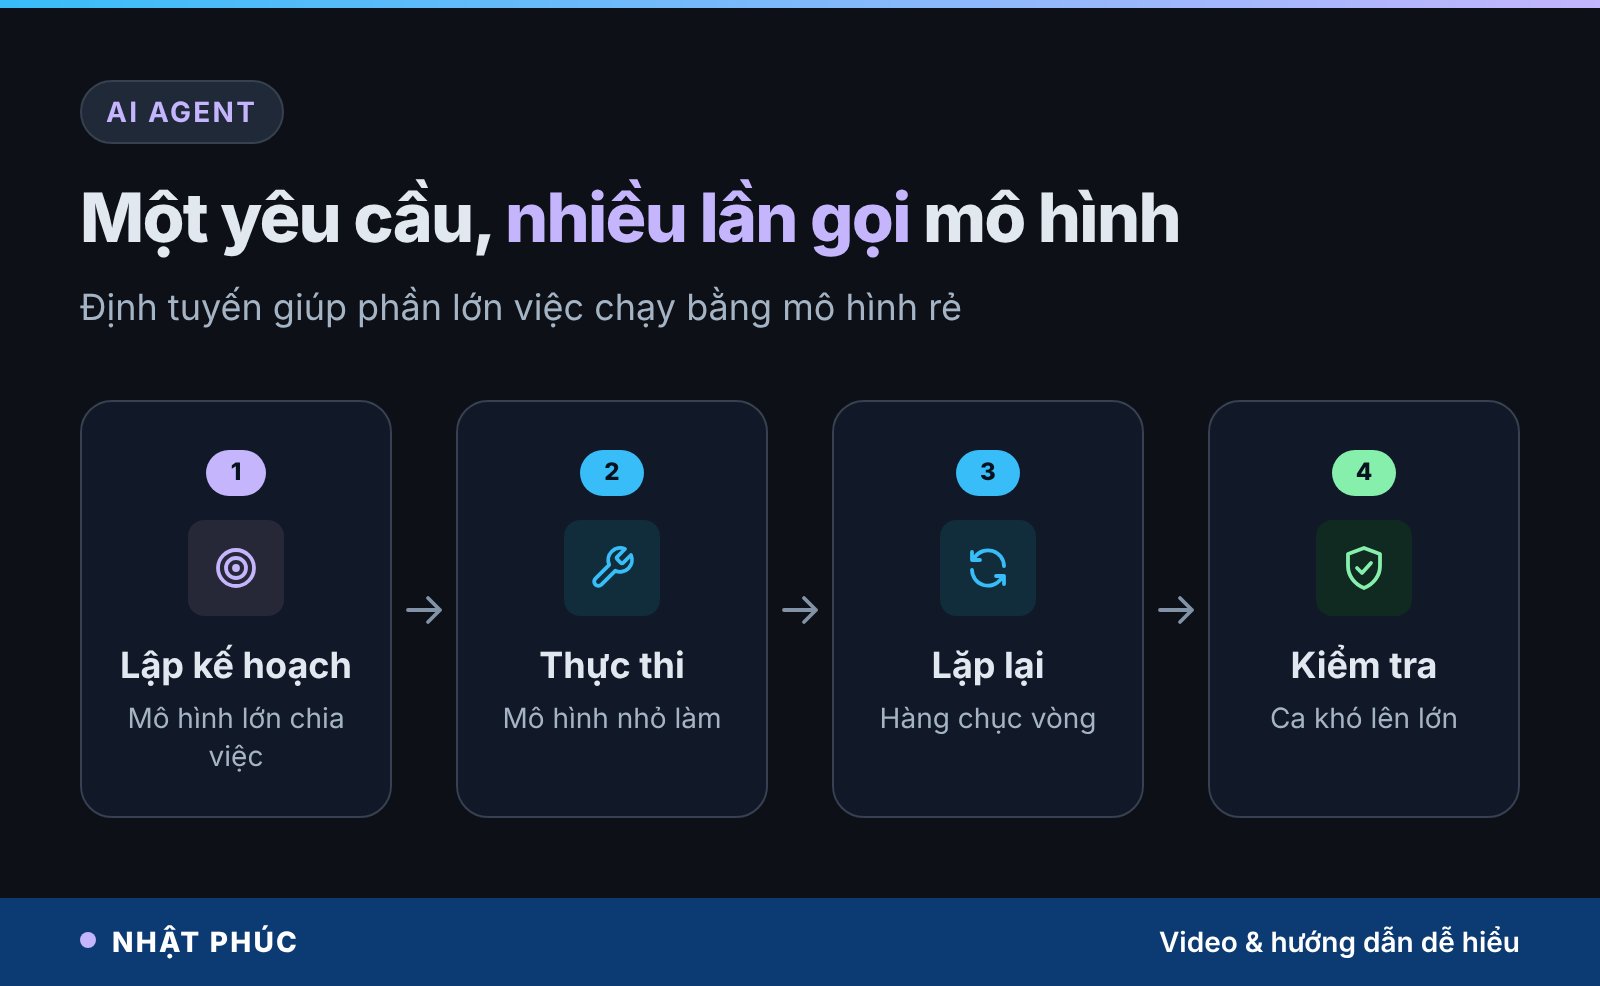
Cách chia việc này có tên gọi phổ biến là model routing (định tuyến mô hình): một lớp điều phối quyết định yêu cầu nào đi tới mô hình nào. Khi phần lớn yêu cầu là việc dễ, tổng chi phí giảm mạnh mà chất lượng chung gần như giữ nguyên.
Mô hình AI nhỏ được tạo ra thế nào?
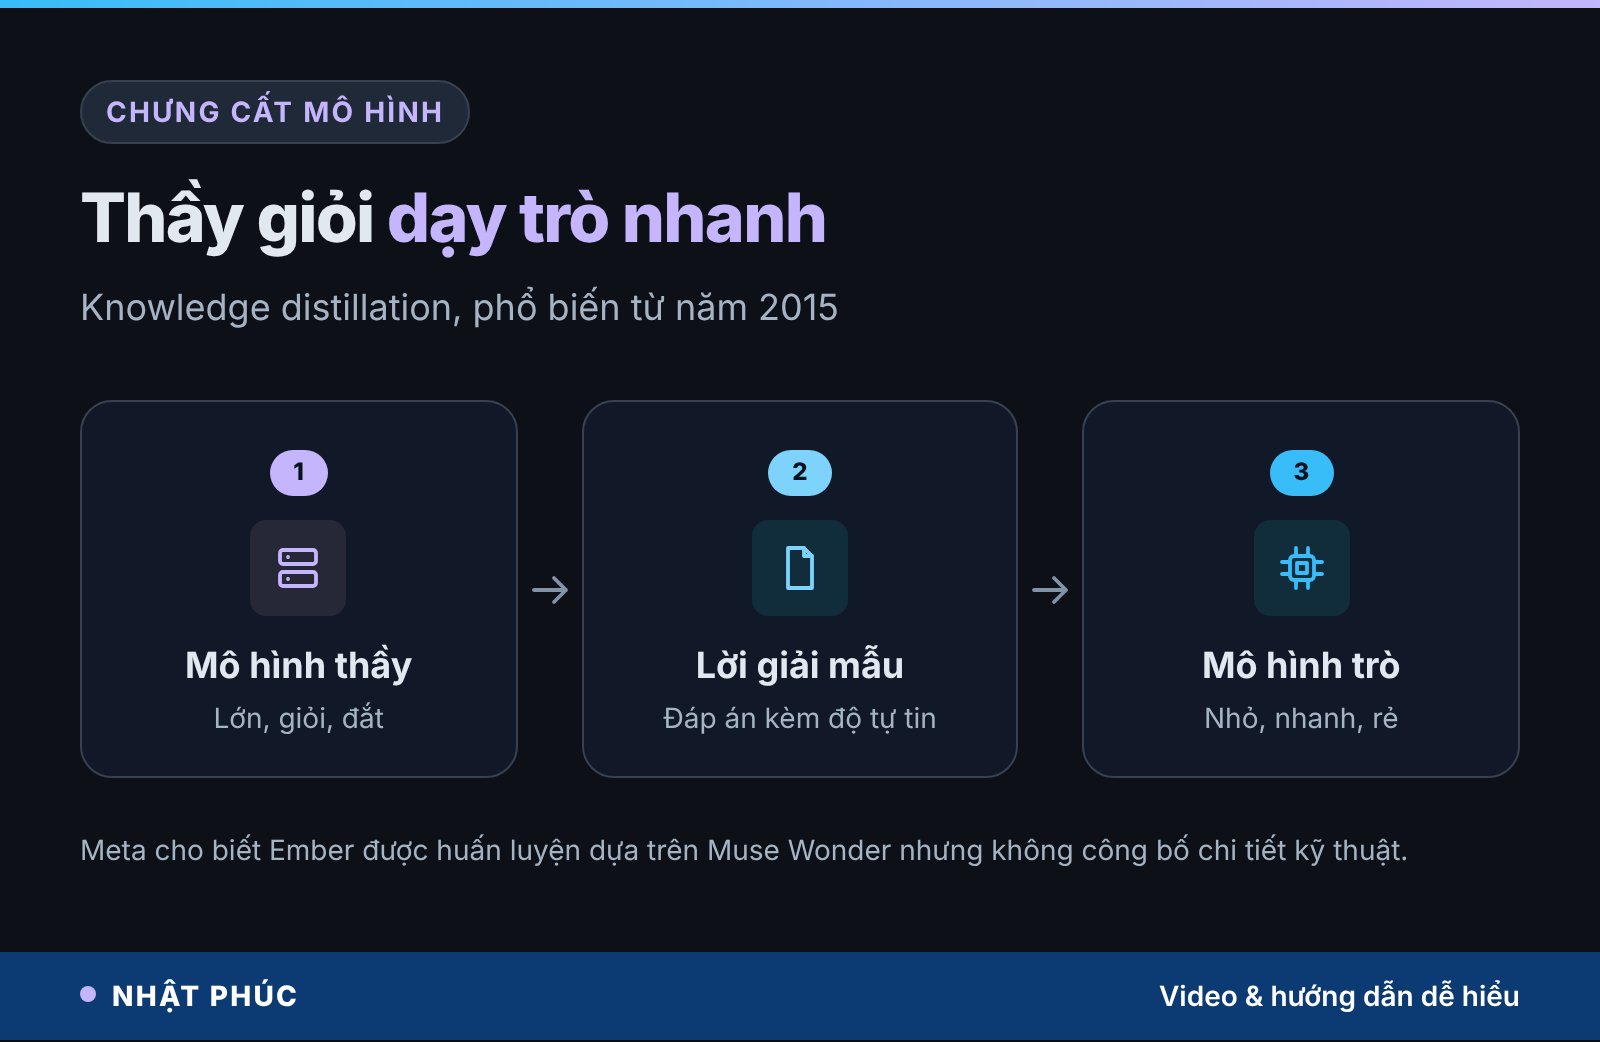
Có nhiều cách để có một mô hình nhỏ mà vẫn “khôn”. Meta chỉ cho biết Ember được huấn luyện dựa trên Muse Wonder, không công bố chi tiết kỹ thuật. Tuy vậy, cách dùng mô hình lớn để dạy mô hình nhỏ là một kỹ thuật kinh điển trong ngành, gọi là chưng cất mô hình (knowledge distillation).
Chưng cất: thầy giỏi dạy trò nhanh
Ý tưởng chưng cất được Geoffrey Hinton và cộng sự phổ biến trong một bài báo năm 2015. Thay vì để mô hình nhỏ tự học từ dữ liệu thô, người ta cho mô hình lớn (thầy) giải rất nhiều bài, rồi dùng các lời giải đó, kể cả mức độ tự tin của thầy với từng đáp án, để huấn luyện mô hình nhỏ (trò). Trò không cần biết mọi thứ thầy biết, chỉ cần bắt chước tốt cách thầy xử lý loại việc cụ thể.
Hai cách thu nhỏ khác
Ngoài chưng cất, ngành AI còn hai kỹ thuật thu nhỏ quen thuộc. Lượng tử hoá (quantization) lưu mỗi tham số bằng ít bit hơn, giống nén ảnh từ chất lượng cao xuống vừa phải. Cắt tỉa (pruning) bỏ bớt những kết nối ít đóng góp, như tỉa cành cây cho gọn. Các mô hình chạy offline trên máy tính thường dùng lượng tử hoá, như bạn có thể thấy trong bài chạy AI offline trên máy tính.
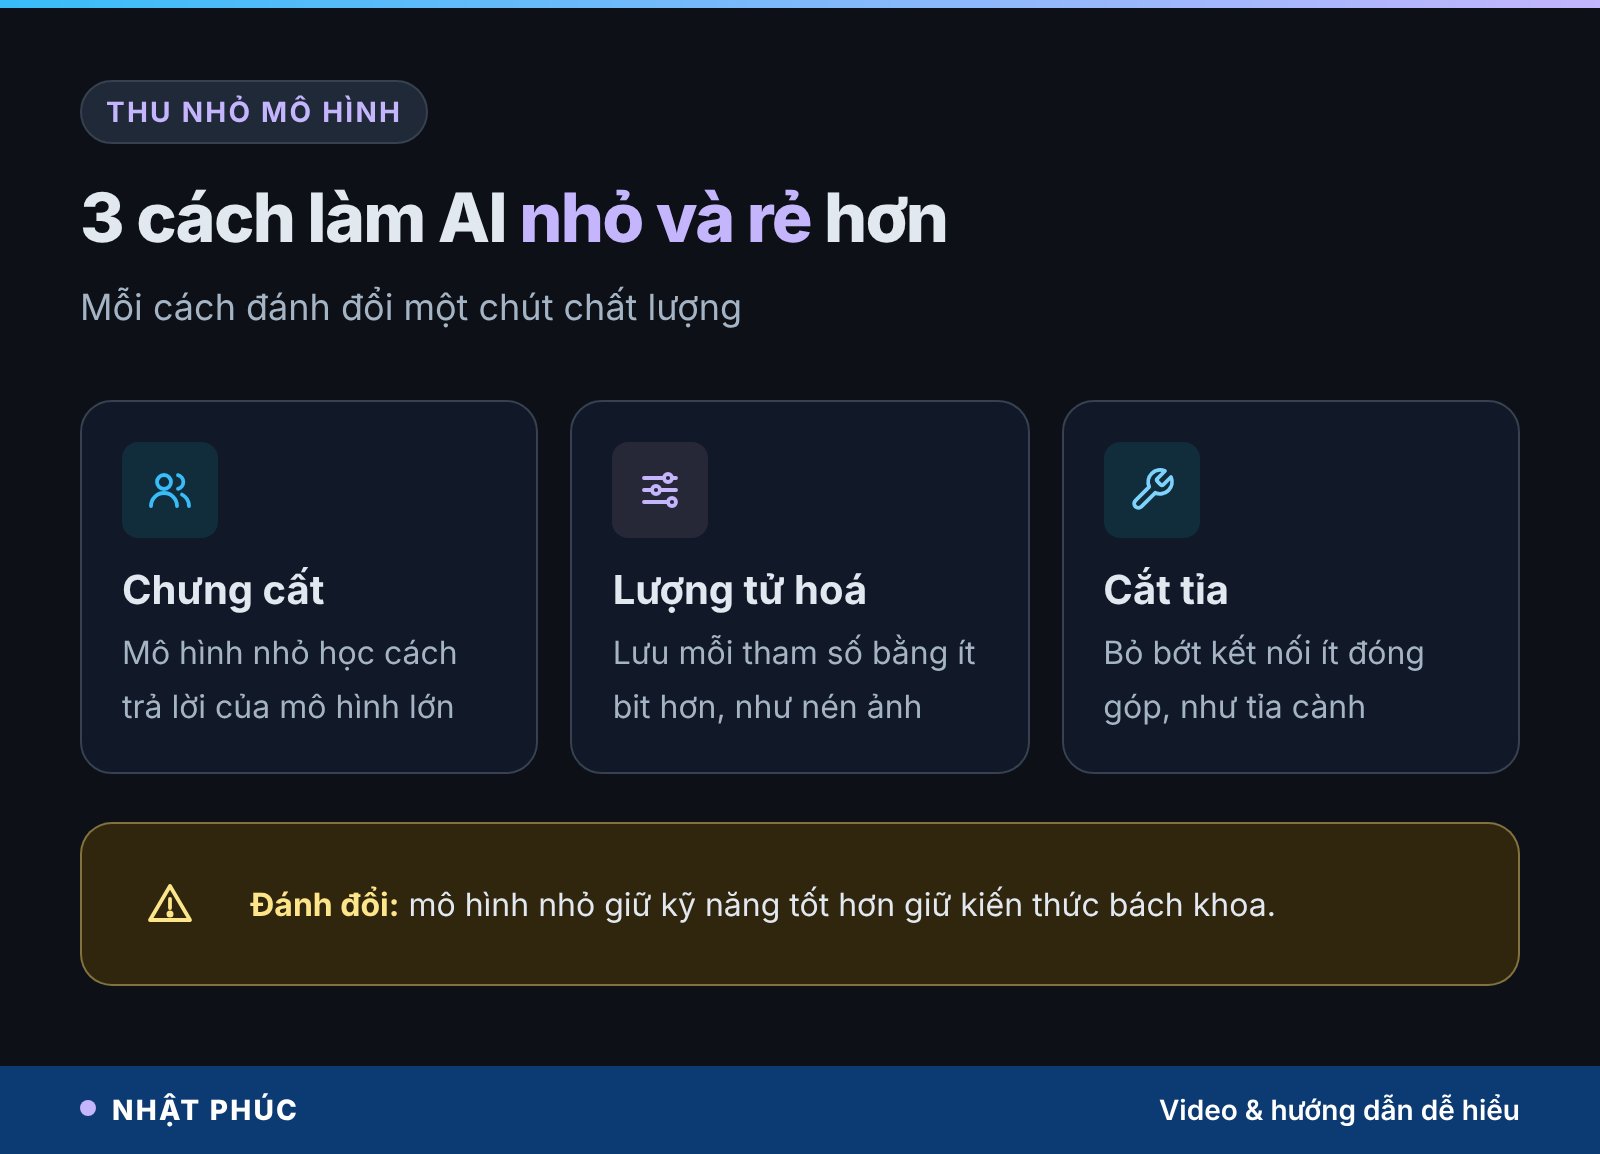
Cái giá phải trả là kiến thức “bách khoa”. Mô hình nhỏ có ít chỗ chứa hơn, nên nó thường giữ được kỹ năng (làm theo hướng dẫn, gọi công cụ) tốt hơn là giữ được dữ kiện (năm sinh của một nhân vật, tên một điều luật). Muse Ember là minh chứng rõ cho đặc điểm này, như bạn sẽ thấy ở phần đánh giá bên dưới.
Giá mỗi token khác chi phí mỗi tác vụ ra sao?
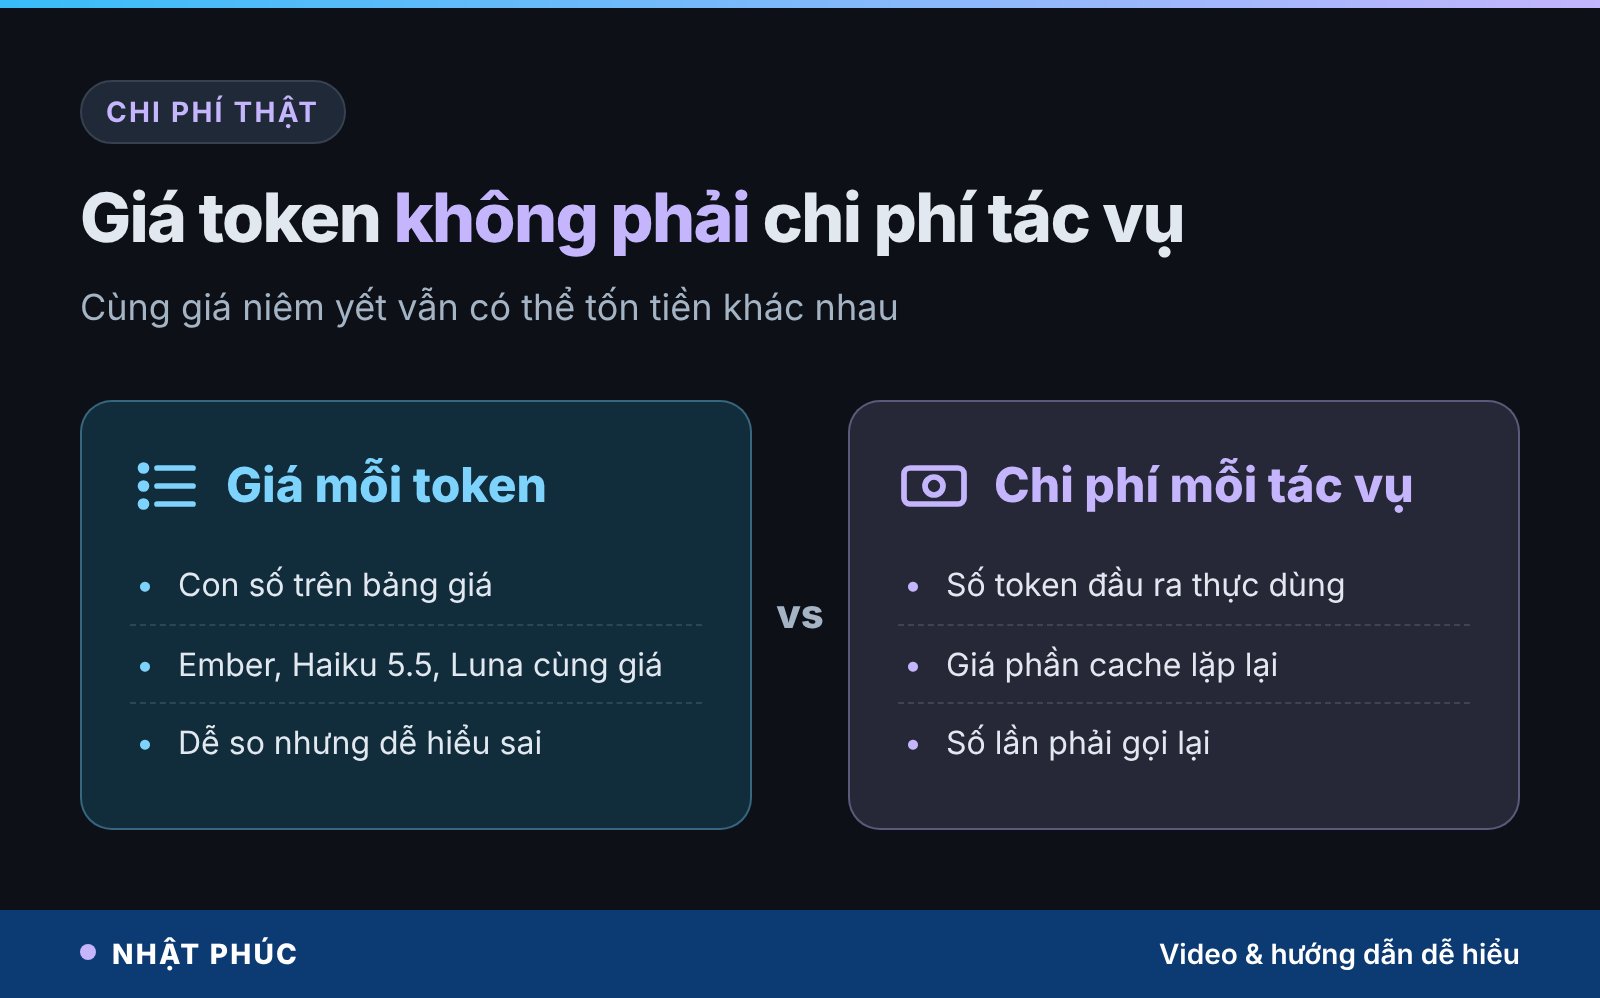
Đây là điểm nhiều người mới tìm hiểu bỏ qua. Muse Ember, Claude Haiku 5.5 và GPT-6 Luna có cùng giá niêm yết cho token đầu vào và đầu ra (0,10 và 0,50 USD mỗi triệu token). Nhìn bảng giá, bạn sẽ tưởng ba mô hình tốn tiền như nhau. Thực tế không phải vậy.
Chi phí thật của một tác vụ phụ thuộc ba yếu tố:
- Số token đầu ra: mô hình “suy nghĩ” dài dòng sẽ tốn nhiều token hơn để ra cùng một đáp án. Theo Artificial Analysis, Ember dùng lượng token đầu ra chỉ khoảng một phần ba so với Haiku 5.5 ở mức suy luận cao nhất.
- Giá token đã lưu đệm: agent thường gửi lại cùng một đoạn hướng dẫn hệ thống mỗi lần gọi. Phần lặp lại này được tính giá cache. Giá cache của Ember (0,004 USD/1 triệu token) rẻ hơn khoảng 60% so với hai đối thủ.
- Số lần gọi: mô hình làm sai phải gọi lại, mô hình hiểu ý ngay từ đầu thì ít vòng hơn.
Một phép tính minh hoạ
Giả sử một tác vụ có 20.000 token đầu vào, trong đó 15.000 token là phần hướng dẫn lặp lại đã được cache (số liệu minh họa). Với Ember, nếu tác vụ cần 2.000 token đầu ra, chi phí khoảng 0,0016 USD. Một mô hình cùng giá niêm yết nhưng giá cache 0,01 USD và dùng gấp ba token đầu ra (6.000 token) sẽ tốn khoảng 0,0037 USD, gấp hơn hai lần. Nhân lên 10.000 tác vụ mỗi ngày, chênh lệch là khoảng 16 USD so với 37 USD mỗi ngày.
Vì vậy, khi so sánh mô hình cho agent, chỉ số đáng tin hơn là chi phí mỗi tác vụ đo trên chính công việc của bạn, chứ không phải giá trên trang bảng giá.
Muse Ember mạnh, yếu ở đâu?
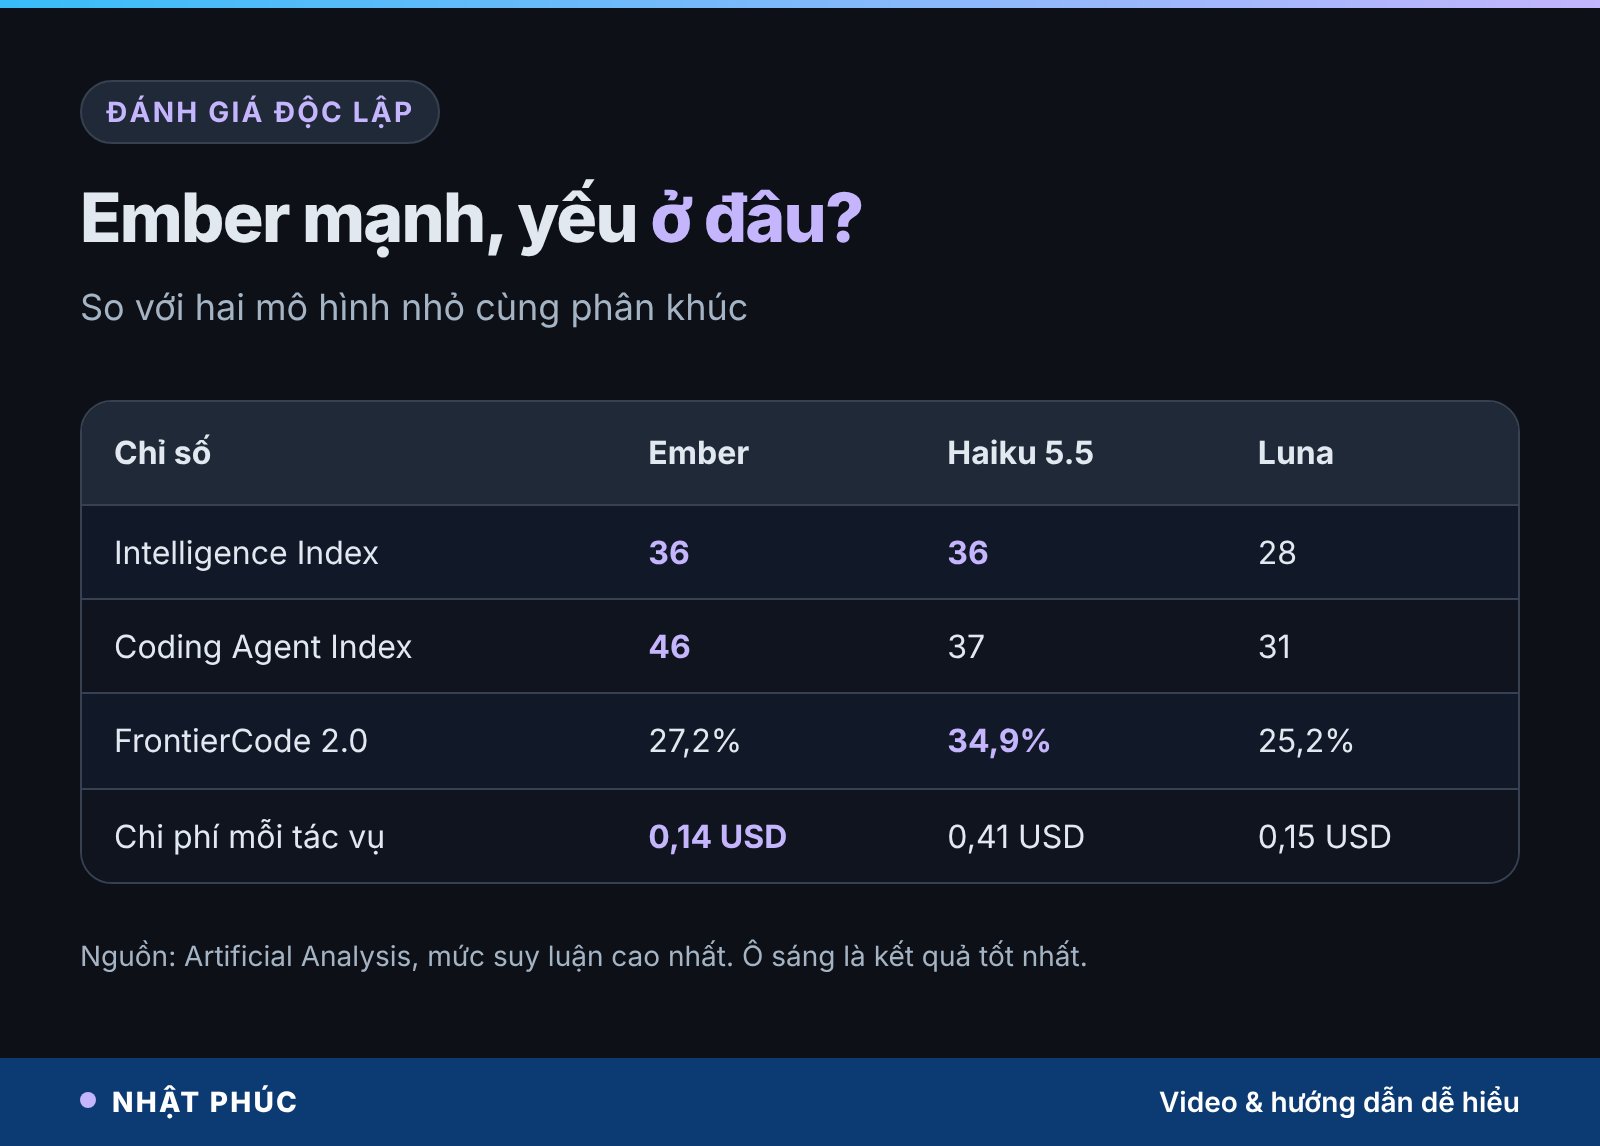
Các con số dưới đây lấy từ Artificial Analysis, tổ chức độc lập chuyên đo và so sánh mô hình AI, ở thiết lập suy luận cao nhất. Intelligence Index là điểm tổng hợp từ nhiều bài kiểm tra khác nhau, dùng để xếp hạng sơ bộ “độ thông minh” chung.
| Chỉ số | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Intelligence Index | 36 | 36 | 28 |
| Chi phí mỗi tác vụ | 0,14 USD | 0,41 USD | 0,15 USD |
| Coding Agent Index | 46 | 37 | 31 |
| FrontierCode 2.0 | 27,2% | 34,9% | 25,2% |
Điểm mạnh: làm việc của agent
Ở Coding Agent Index (đo khả năng làm agent lập trình, Ember chạy trong Muse Code), Ember đạt 46 điểm, cao hơn Haiku 5.5 trong Claude Code (37) và GPT-6 Luna trong Codex (31). Nghĩa là trong vai trò “người làm thuê” chạy nhiều bước, Ember tỏ ra rất đáng giá đồng tiền.
Điểm yếu: kiến thức và lập trình sát thực tế
Ở FrontierCode 2.0, bài kiểm tra gần với công việc phát triển phần mềm thực tế, Ember thua Haiku 5.5 (27,2% so với 34,9%). Đáng chú ý hơn là bài kiểm tra kiến thức AA-Omniscience: Ember chỉ trả lời đúng 21,1%, thấp nhất trong nhóm có độ thông minh tương đương, và từ chối trả lời khoảng 64% câu hỏi.
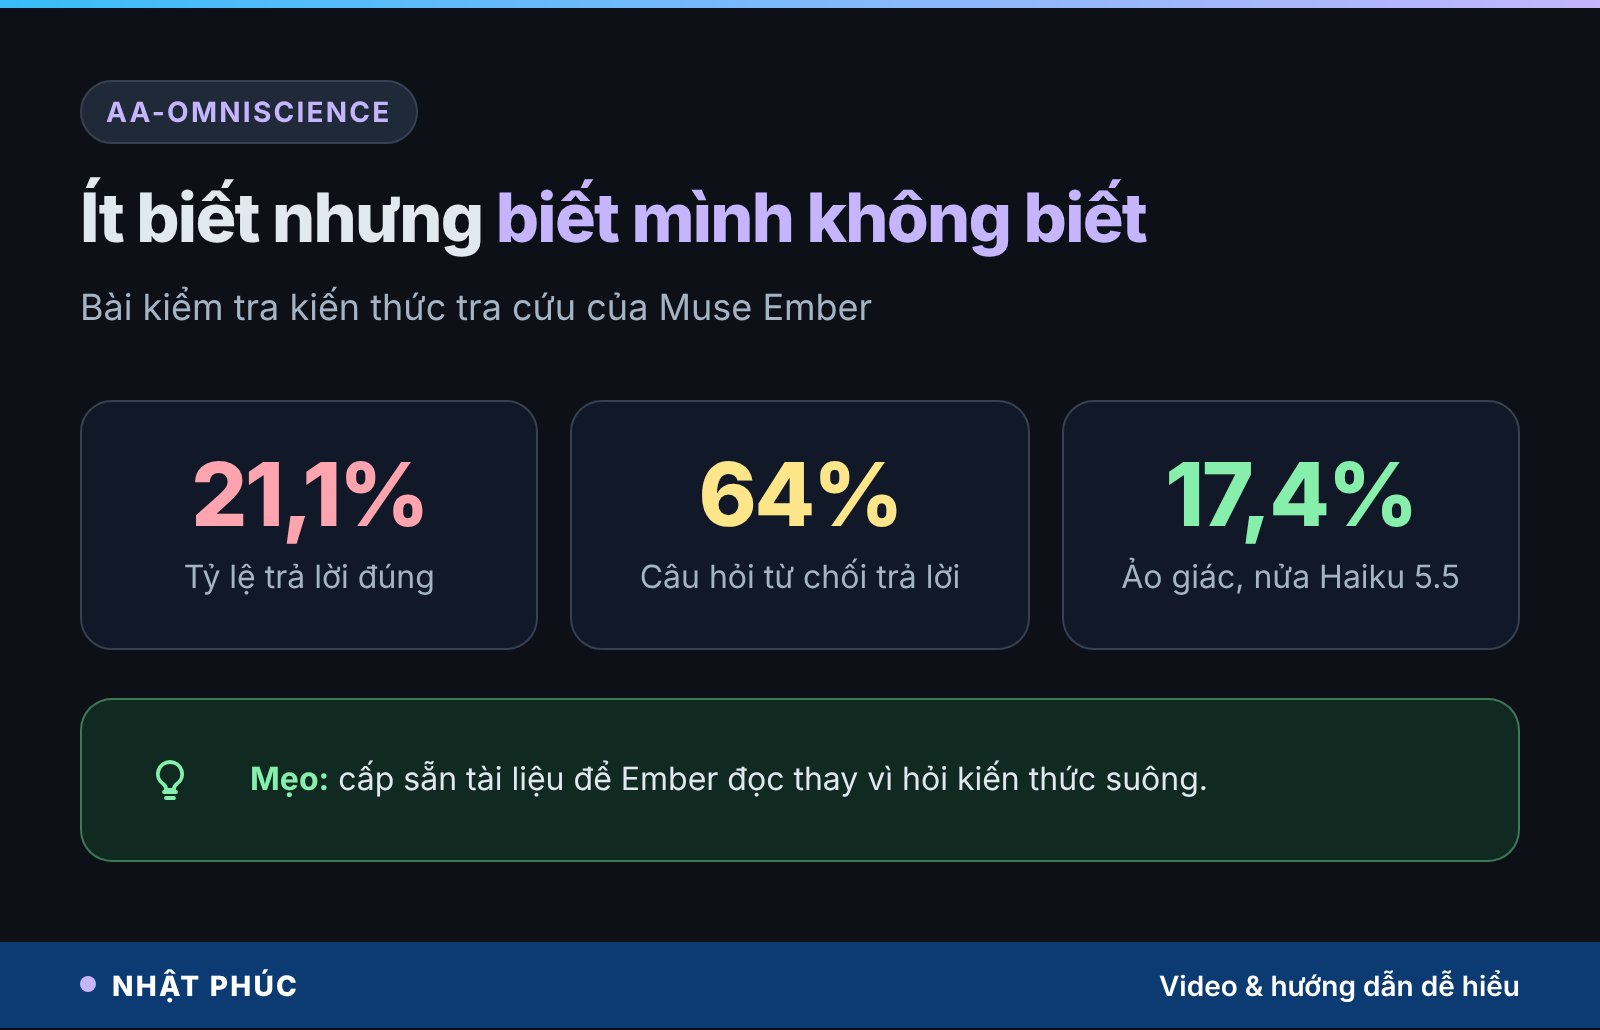
Mặt tích cực là tỷ lệ ảo giác (hallucination, tức bịa ra câu trả lời sai một cách tự tin) của Ember chỉ 17,4%, khoảng một nửa của Haiku 5.5. Ember thà nói “không biết” còn hơn đoán bừa. Với hệ thống tự động, đó là tính cách đáng quý: một câu “không biết” có thể chuyển lên người hoặc mô hình lớn, còn một câu bịa thì có thể lọt thẳng tới khách hàng.
Để so sánh, mô hình lớn Muse Wonder đạt 44 điểm Intelligence Index nhưng tốn khoảng 6,95 USD mỗi tác vụ, tức gần 50 lần Ember. Khoảng cách đó chính là lý do người ta kết hợp hai cỡ mô hình thay vì chọn một.
Bậc giá 200.000 token: cái bẫy của ngữ cảnh dài
Ember có cửa sổ ngữ cảnh khoảng 1 triệu token, đủ để nạp cả một bộ hợp đồng dài. Nhưng bảng giá có hai bậc. Khi một yêu cầu vượt 200.000 token đầu vào, toàn bộ yêu cầu đó, kể cả phần đầu ra, bị tính theo giá gấp ba.
| Loại token | Yêu cầu tới 200.000 token | Yêu cầu trên 200.000 token |
|---|---|---|
| Đầu vào | 0,10 USD | 0,30 USD |
| Đầu vào đã cache | 0,004 USD | 0,012 USD |
| Đầu ra | 0,50 USD | 1,50 USD |
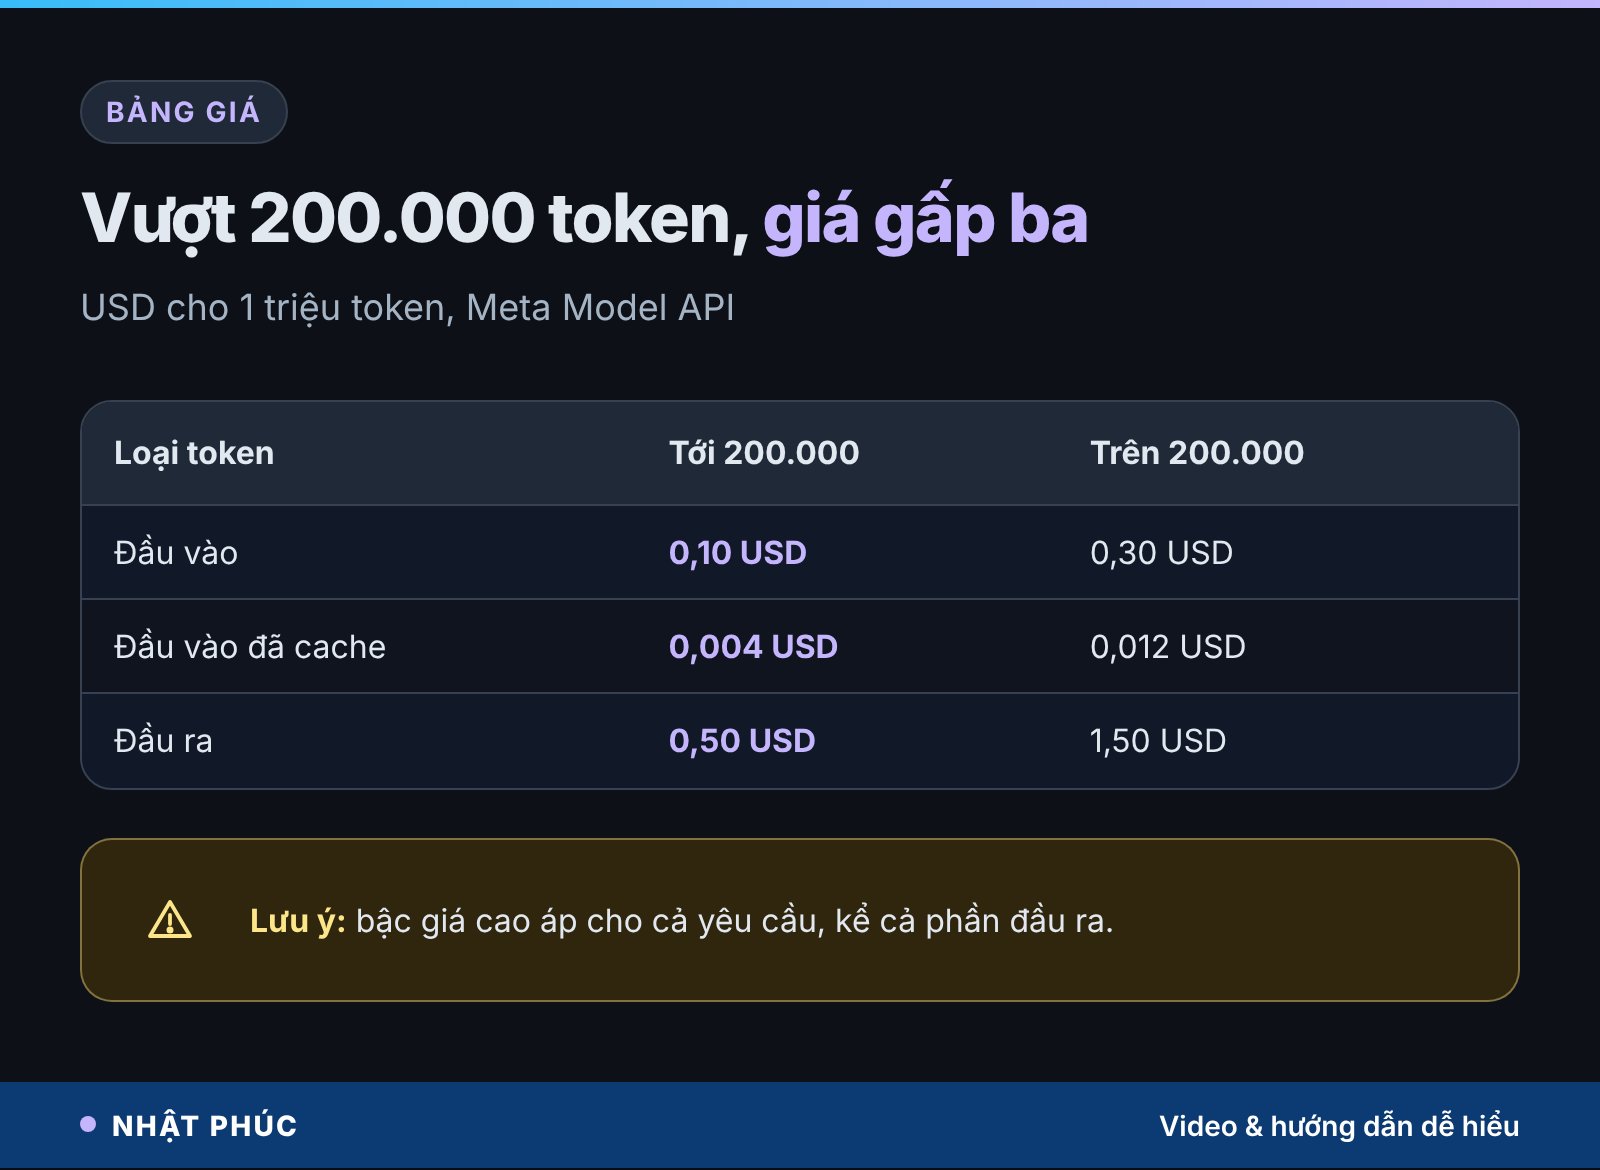
Ví dụ minh hoạ: một yêu cầu 300.000 token đầu vào và 5.000 token đầu ra tốn khoảng 0,0975 USD. Nếu chia tài liệu thành hai yêu cầu 150.000 token, mỗi yêu cầu sinh 2.500 token đầu ra, tổng chỉ còn khoảng 0,0325 USD (số liệu minh họa). Bài học: ngữ cảnh dài là khả năng, không phải lời mời nhồi hết mọi thứ vào một lần gọi.
Ứng dụng mô hình AI nhỏ trong tự động hoá
Những việc “phụ bếp” mà mô hình nhỏ làm tốt có mặt ở hầu hết doanh nghiệp Việt Nam, từ cửa hàng online đến văn phòng kế toán:
- Phân loại yêu cầu khách hàng: tin nhắn hỏi giá, khiếu nại, đổi trả được gắn nhãn và chuyển đúng bộ phận.
- Trích xuất dữ liệu: lấy mã số thuế, số tiền, ngày tháng từ hoá đơn, đơn hàng, chứng từ dạng PDF hoặc ảnh chụp.
- Tóm tắt chuỗi email, biên bản họp: rút ra việc cần làm, người phụ trách, hạn chót.
- Định tuyến trong agent: quyết định yêu cầu nào cần mô hình lớn, yêu cầu nào tự xử lý được.
- Việc phụ trong lập trình: chạy kiểm thử, sửa lỗi nhỏ, viết mô tả thay đổi.
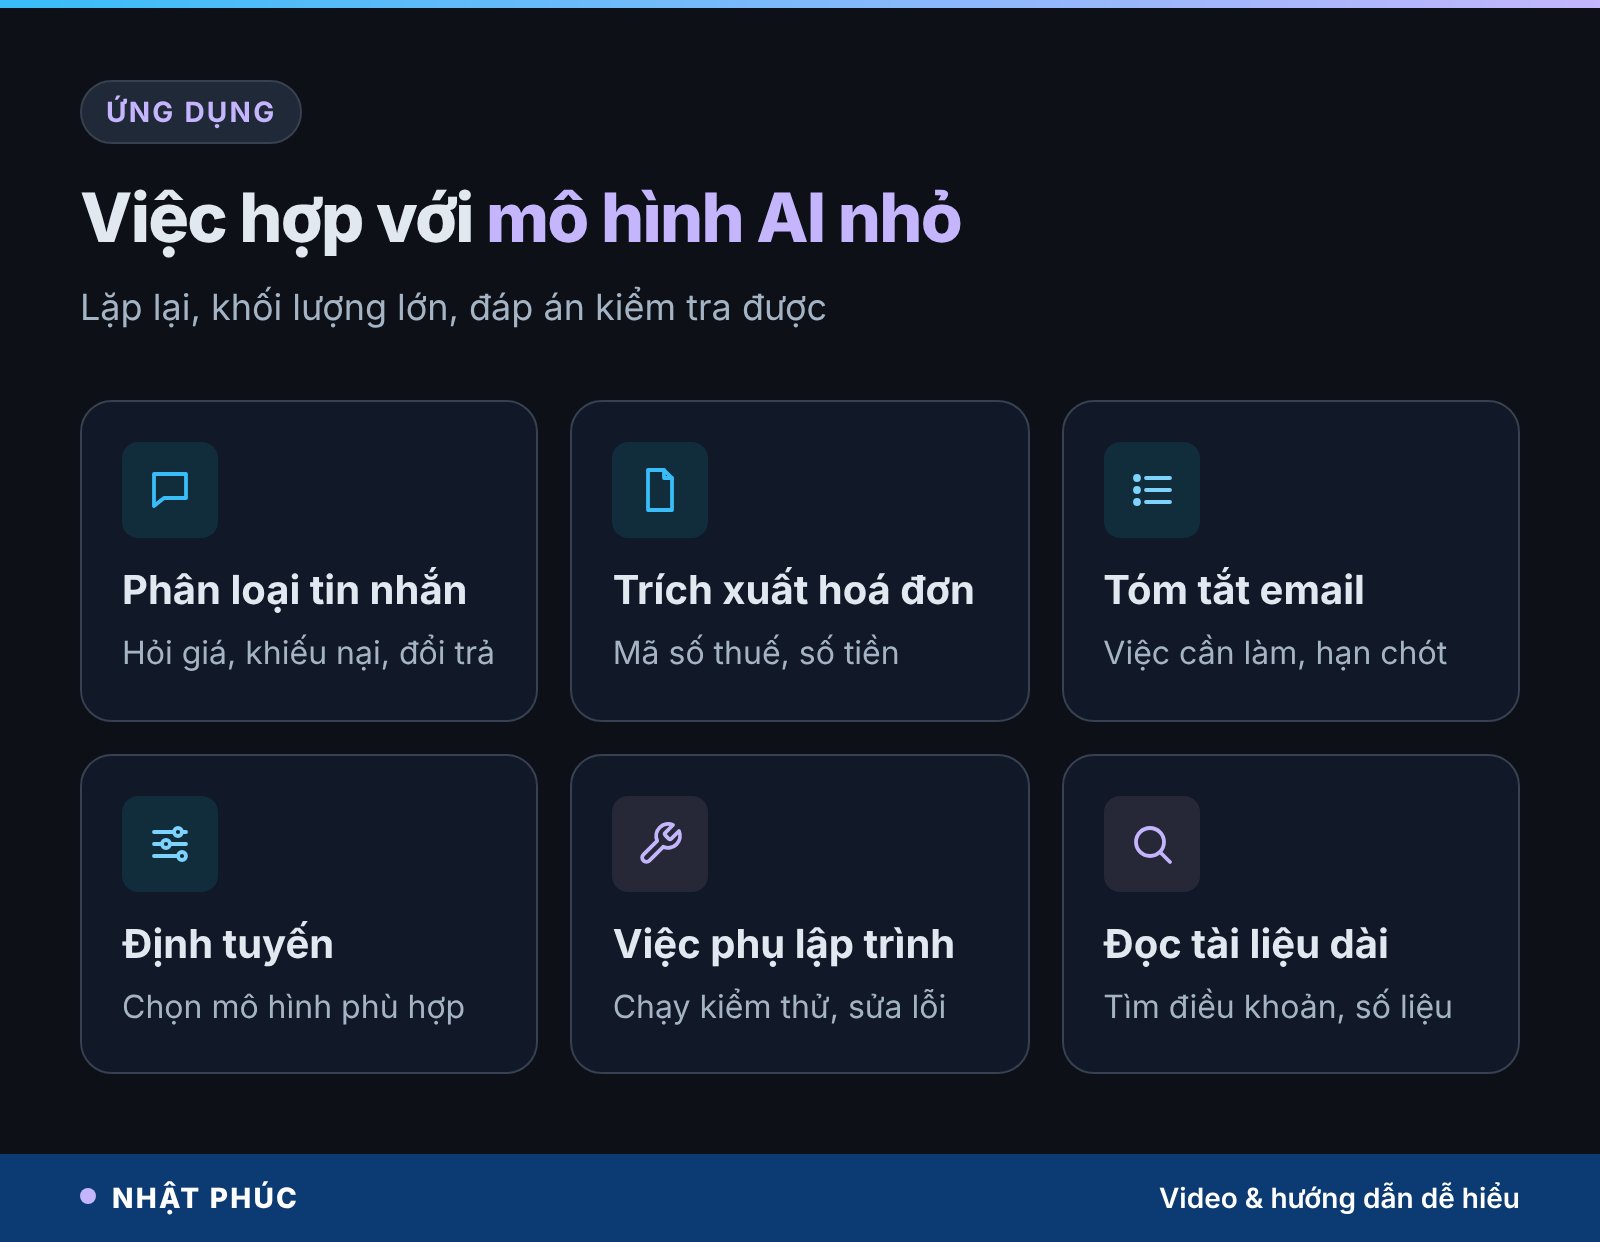
Điểm chung của các việc này là có đáp án kiểm tra được: một hoá đơn có đúng một con số tổng tiền, một tin nhắn thuộc một nhóm nhất định. Khi đầu ra kiểm chứng được, bạn có thể đo chính xác mô hình nhỏ làm đúng bao nhiêu phần trăm, và quyết định có dùng hay không dựa trên số liệu thật.
Về tiếng Việt, Meta chưa công bố riêng mức hỗ trợ tiếng Việt của Ember. Các mô hình nhỏ thường kém hơn mô hình lớn ở ngôn ngữ ít dữ liệu, nên với nội dung tiếng Việt (nhất là chữ viết tay trên hoá đơn, từ lóng trong tin nhắn), bạn nên tự thử trên dữ liệu của mình trước khi tin vào điểm benchmark vốn chủ yếu đo bằng tiếng Anh.
Người Việt có dùng được Muse Ember không?
Muse Ember chỉ có qua hai đường: Meta Model API (cho lập trình viên tích hợp vào sản phẩm) và Muse Code (công cụ lập trình của Meta). Người dùng phổ thông sẽ không thấy Ember trong ứng dụng Meta AI, Facebook Messenger hay WhatsApp.
Meta chưa công bố danh sách quốc gia được dùng Meta Model API tại thời điểm Ember ra mắt. Trước đó, trợ lý Muse dành cho người dùng cuối của Meta mới chỉ mở ở một số thị trường. Vì vậy, nếu bạn ở Việt Nam và muốn thử, hãy kiểm tra trực tiếp khi đăng ký tài khoản nhà phát triển. Giá tính bằng USD, thanh toán theo lượng dùng.
Ember không phải lựa chọn duy nhất. Các nhà cung cấp lớn đều có mô hình nhỏ cùng phân khúc (như Claude Haiku 5.5, GPT-6 Luna), và nhiều nền tảng trung gian cho phép gọi nhiều mô hình qua một tài khoản. Lời khuyên thực tế: đừng chọn theo tên tuổi, hãy chọn theo kết quả trên bộ dữ liệu thử của chính bạn.
6 bước chọn mô hình AI nhỏ cho tự động hoá
Dù bạn chọn Ember hay mô hình khác, quy trình dưới đây giúp tránh cảm tính:
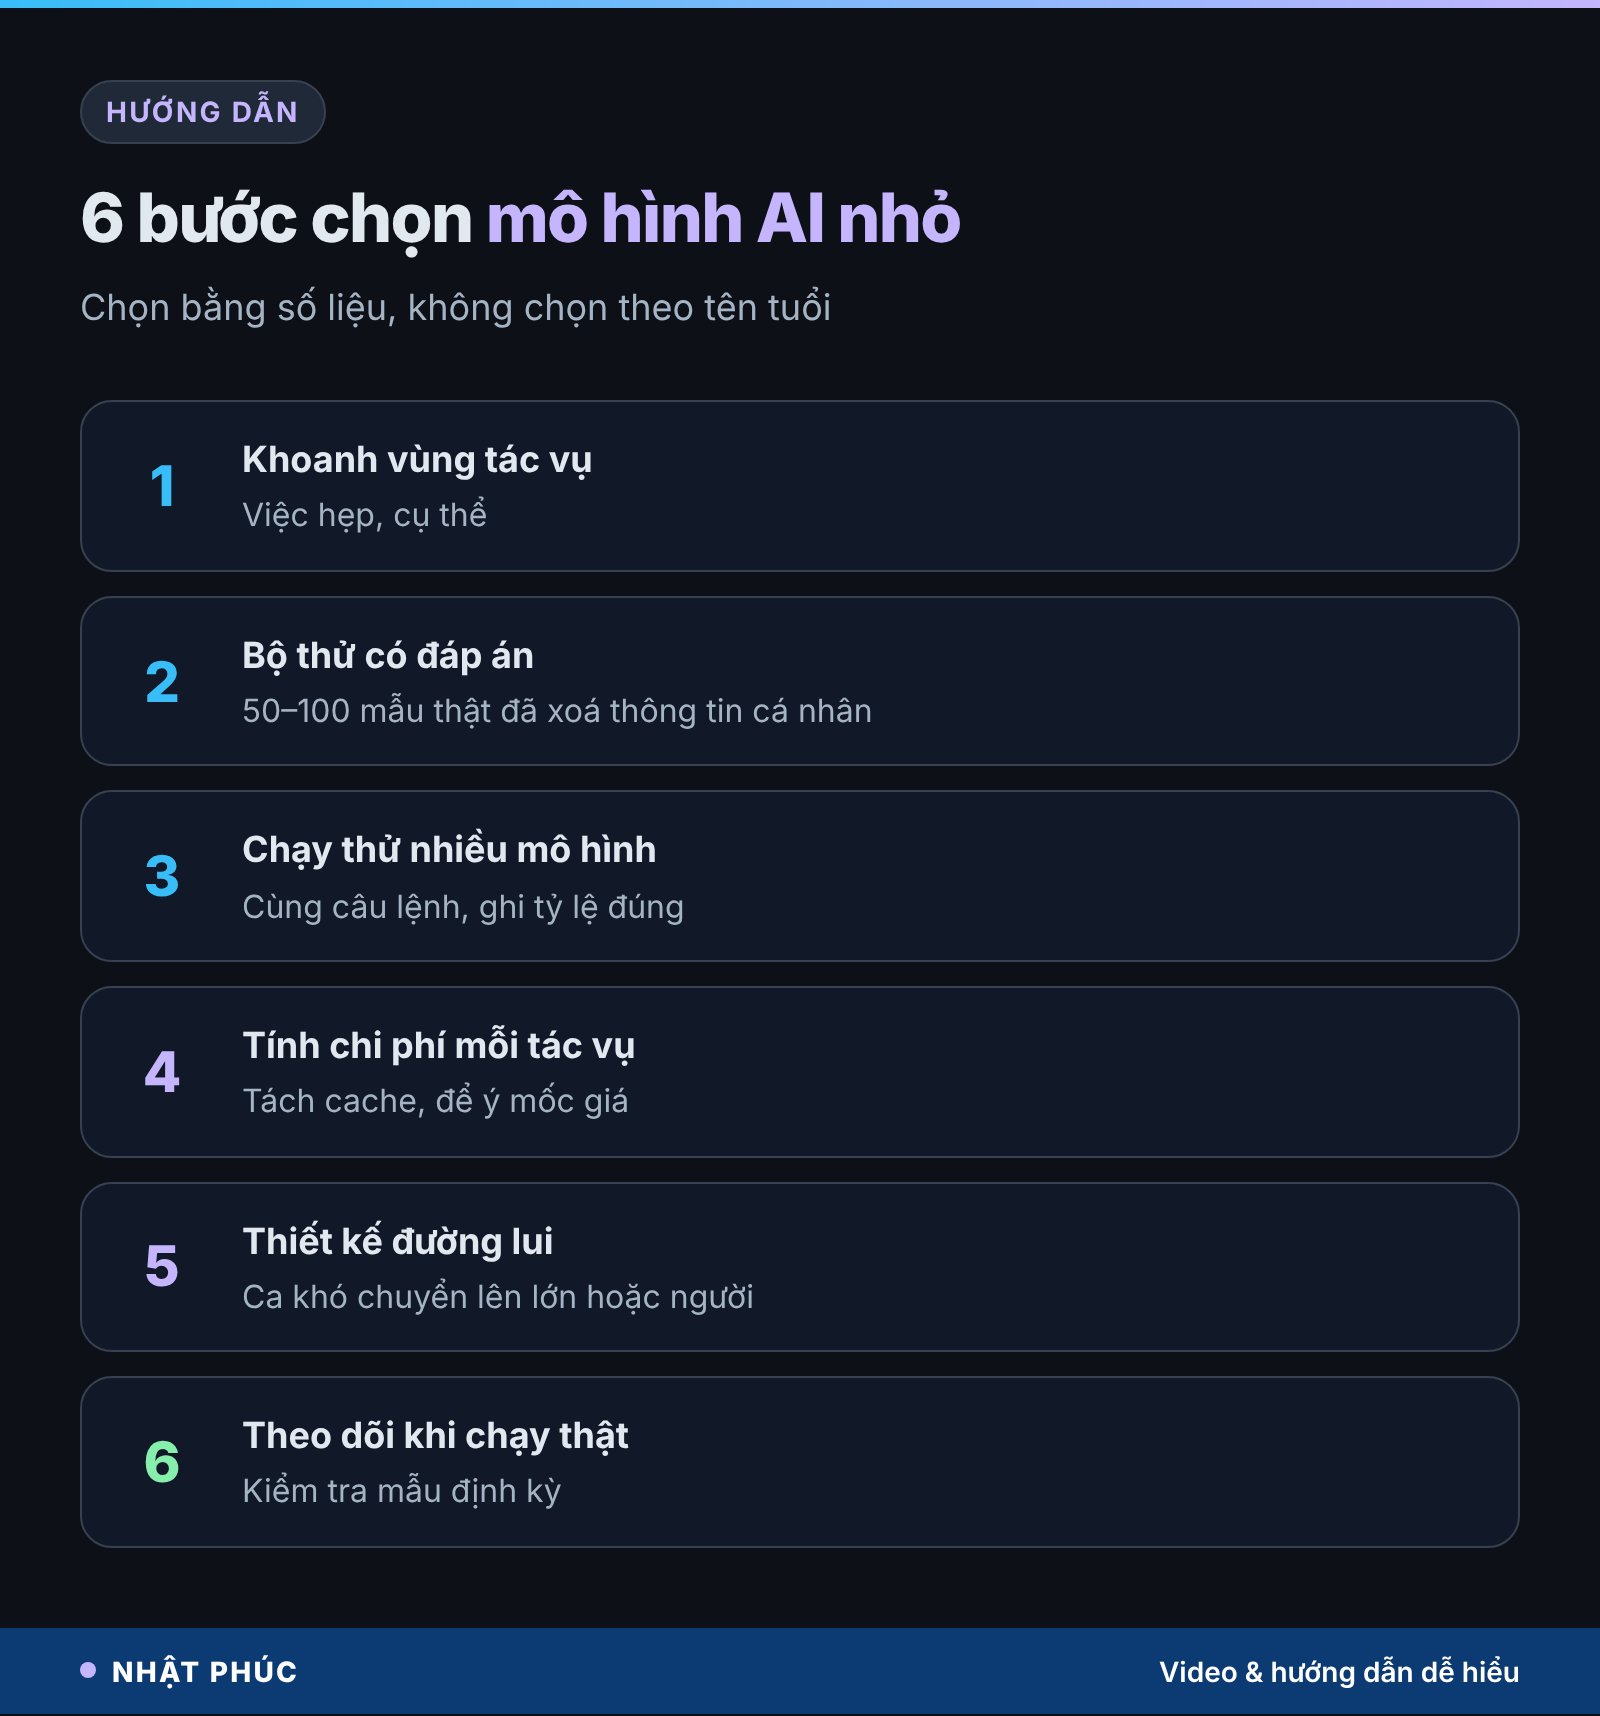
1. Khoanh vùng tác vụ
Liệt kê việc cụ thể: “phân loại tin nhắn Fanpage thành 5 nhóm”, không phải “chăm sóc khách hàng bằng AI”. Tác vụ càng hẹp, mô hình nhỏ càng dễ làm tốt.
2. Chuẩn bị bộ thử có đáp án
Gom khoảng 50–100 mẫu thật (đã xoá thông tin cá nhân) kèm đáp án đúng. Đây là “đề thi” để chấm mọi mô hình như nhau.
3. Chạy thử nhiều mô hình
Dùng cùng câu lệnh cho 2–3 mô hình nhỏ và 1 mô hình lớn làm mốc. Ghi lại tỷ lệ đúng, thời gian phản hồi và số token đầu vào, đầu ra.
4. Tính chi phí mỗi tác vụ
Nhân số token với bảng giá, nhớ tách phần cache và để ý mốc giá theo độ dài. So sánh “tiền cho 1.000 tác vụ làm đúng”, không chỉ tiền cho 1.000 tác vụ.
5. Thiết kế đường lui
Khi mô hình nhỏ từ chối, không chắc chắn hoặc đầu ra sai định dạng, tự động chuyển lên mô hình lớn hoặc nhân viên. Đây là cách tận dụng đặc điểm “biết nói không biết” của mô hình như Ember.
6. Theo dõi sau khi chạy thật
Lấy mẫu kiểm tra định kỳ, vì dữ liệu thực tế thay đổi (sản phẩm mới, cách khách hỏi mới). Nhà cung cấp cũng có thể cập nhật mô hình, nên hãy chạy lại bộ thử khi có phiên bản mới.
Rủi ro và hiểu lầm phổ biến về mô hình AI nhỏ
Rủi ro cần tính trước
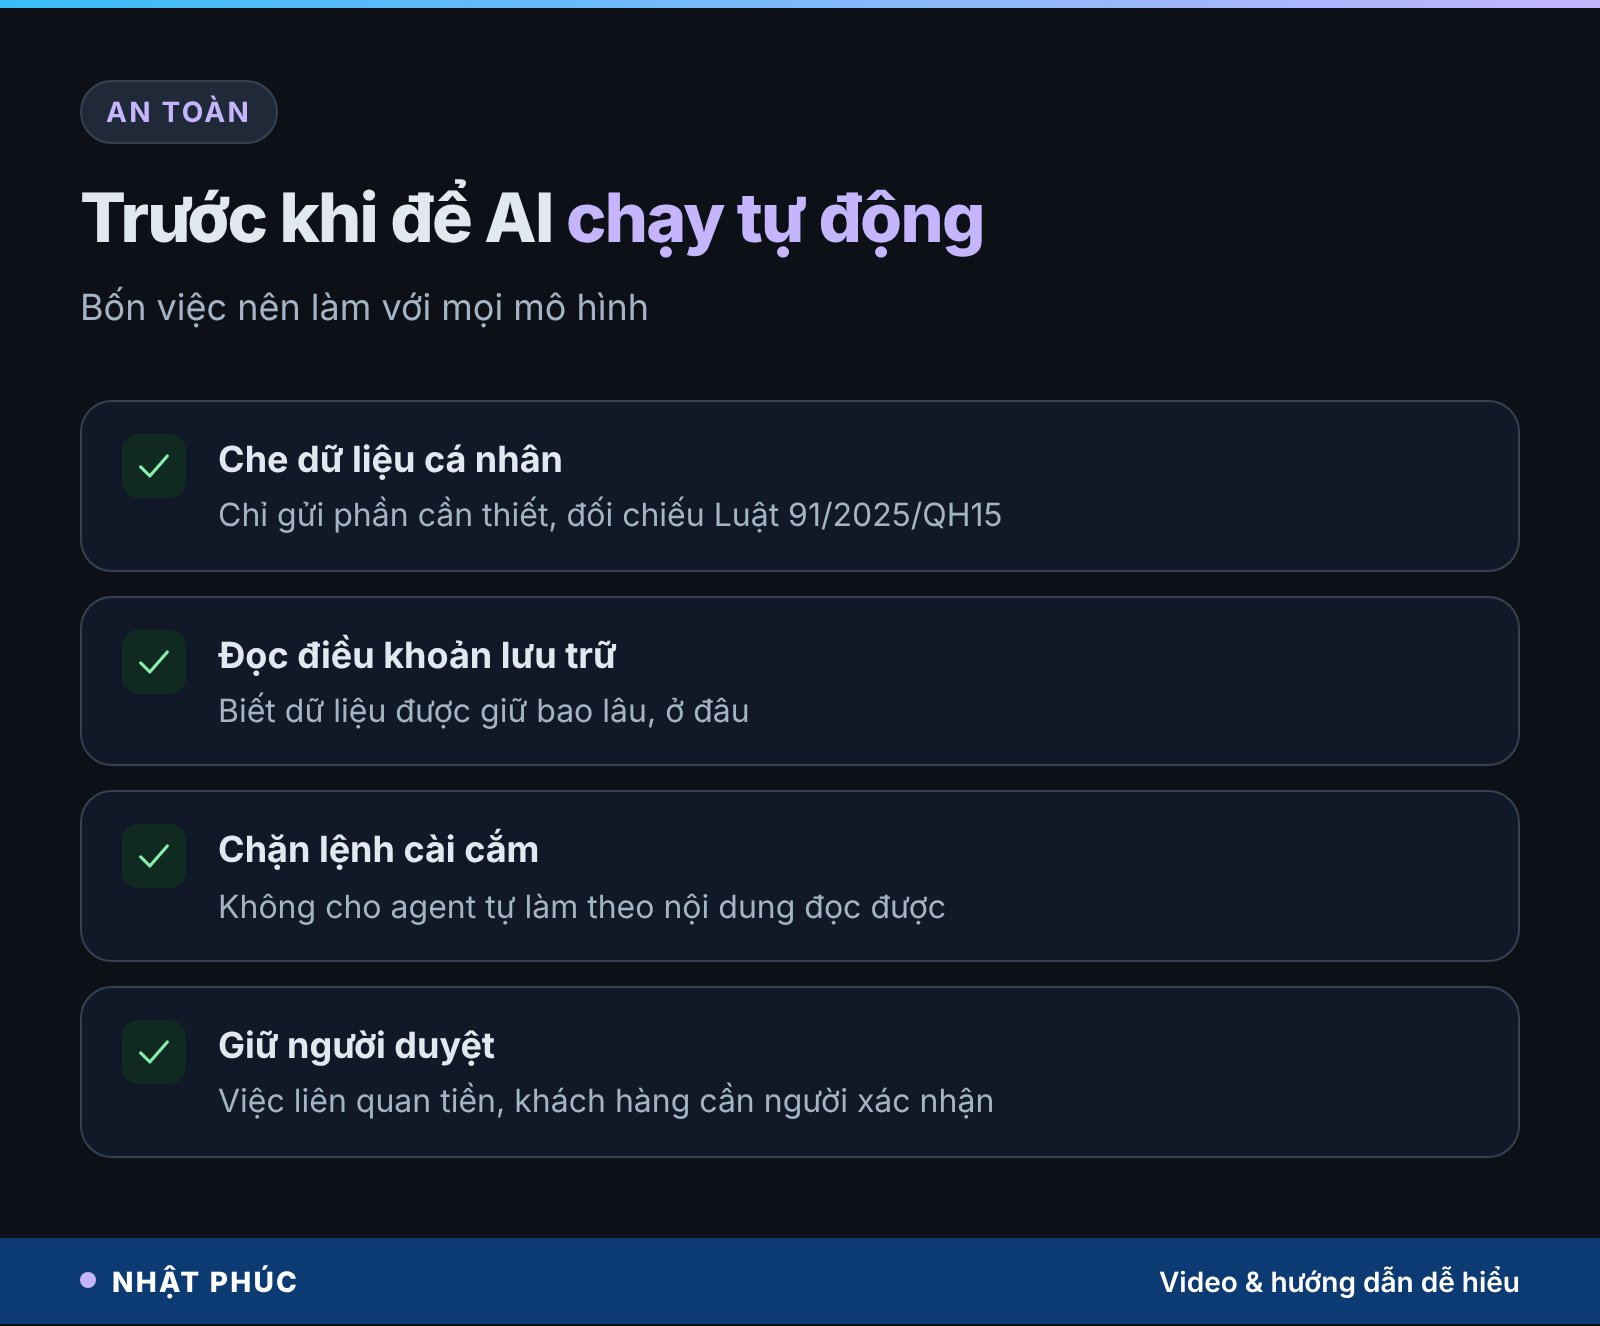
Thứ nhất, dữ liệu cá nhân: gửi hoá đơn, tin nhắn khách hàng lên API nước ngoài nghĩa là dữ liệu rời khỏi hệ thống của bạn. Hãy xoá hoặc che thông tin không cần thiết, đọc kỹ điều khoản lưu trữ của nhà cung cấp, và đối chiếu với Luật Bảo vệ dữ liệu cá nhân 91/2025/QH15. Thứ hai, bị lừa bởi nội dung đầu vào: agent đọc email, trang web có thể gặp câu lệnh cài cắm; mô hình nhỏ không miễn nhiễm, xem thêm bài prompt injection là gì. Thứ ba, benchmark không phải bảo hành: một phần số liệu do hãng tự công bố, còn số liệu độc lập cũng chủ yếu đo bằng tiếng Anh.
Hiểu lầm phổ biến
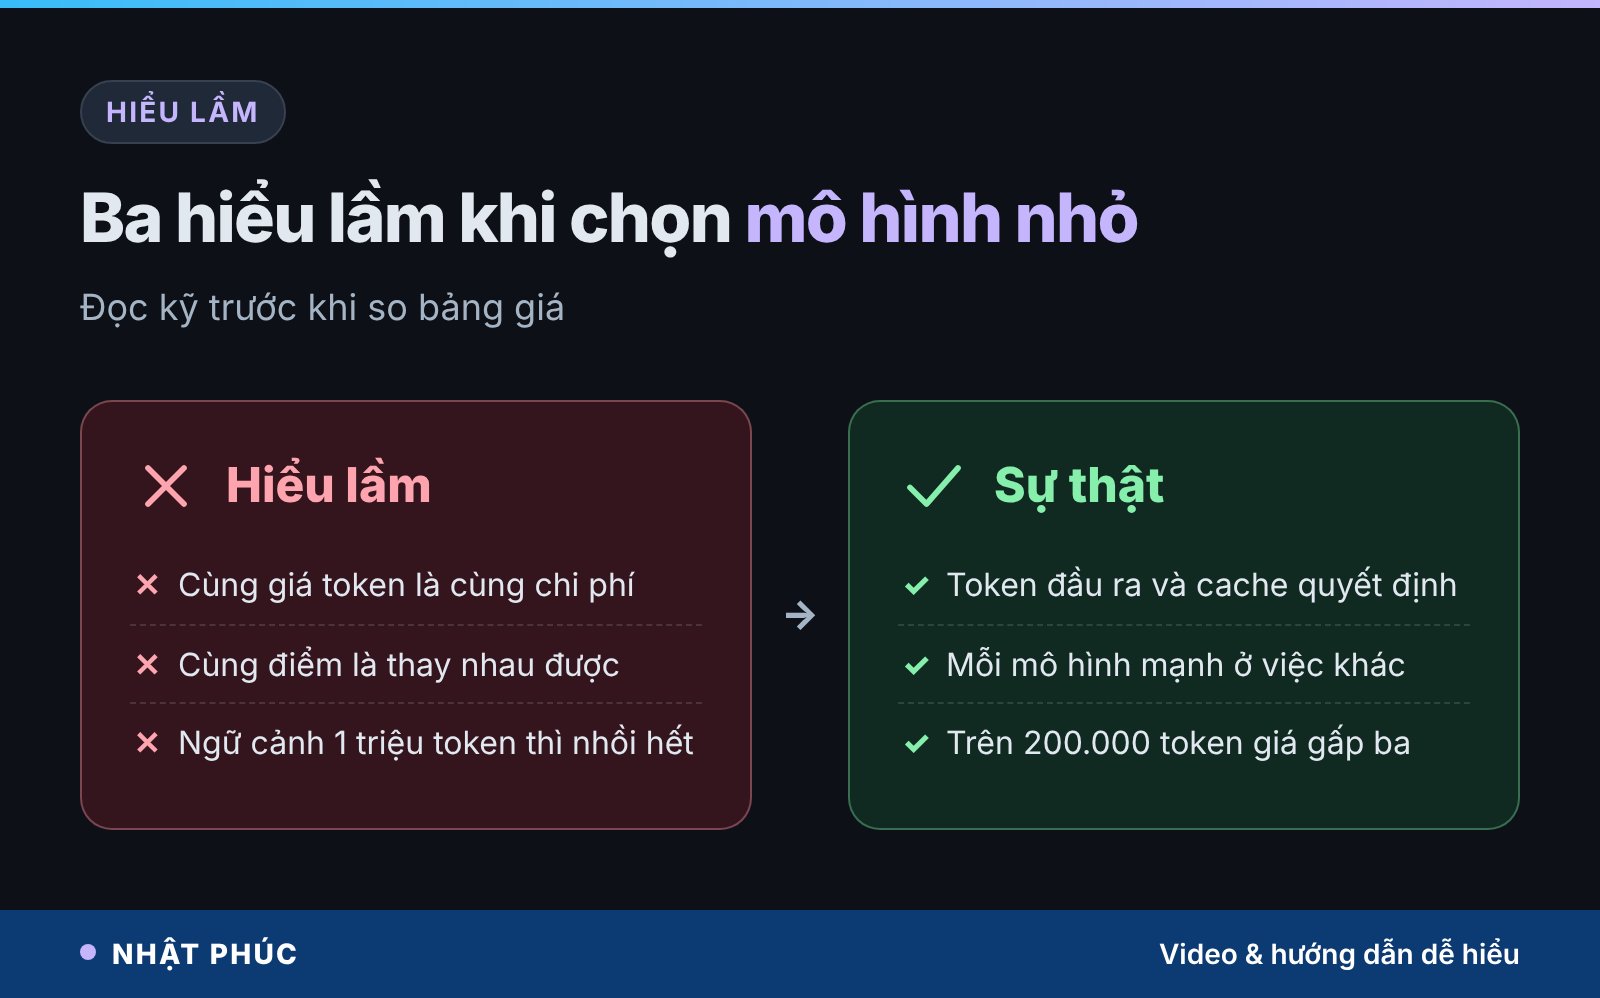
- “Cùng giá token là cùng chi phí”: sai, vì số token đầu ra và giá cache khác nhau, như ví dụ ở trên.
- “Điểm thông minh bằng nhau là dùng thay nhau được”: sai, vì Ember và Haiku 5.5 cùng 36 điểm nhưng mạnh yếu ở những việc khác nhau.
- “Ngữ cảnh 1 triệu token thì cứ nhồi hết vào”: vừa tốn tiền (bậc giá gấp ba) vừa dễ làm mô hình bỏ sót chi tiết.
- “Mô hình nhỏ chạy được trên máy tôi”: không đúng với Ember, vì Meta không phát hành trọng số; nhỏ ở đây là nhỏ so với mô hình cờ hiệu trên máy chủ.
Câu hỏi thường gặp về mô hình AI nhỏ và Muse Ember
Mô hình AI nhỏ khác mô hình lớn ở điểm nào?
Mô hình nhỏ có ít tham số hơn, chạy nhanh hơn và rẻ hơn, nhưng chứa ít kiến thức hơn và kém hơn ở bài toán mới lạ. Nó phù hợp với việc lặp lại có quy tắc rõ, còn mô hình lớn hợp với lập kế hoạch, phân tích sâu và tình huống chưa gặp. Xem thêm nền tảng trong bài LLM là gì.
Muse Ember có miễn phí không?
Không có gói miễn phí được công bố cho Ember. Bạn trả theo lượng token qua Meta Model API: 0,10 USD cho 1 triệu token đầu vào và 0,50 USD cho 1 triệu token đầu ra với yêu cầu dưới 200.000 token. Muse Code là gói thuê bao riêng, tính phí theo tháng.
Muse Ember có tải về chạy offline được không?
Không. Ember là mô hình đóng, Meta không phát hành trọng số, nên bạn chỉ dùng được qua API trên máy chủ của Meta. Nếu cần AI chạy hoàn toàn trên máy để giữ dữ liệu nội bộ, bạn phải chọn mô hình có trọng số mở và chấp nhận chất lượng, tốc độ phụ thuộc phần cứng.
Chưng cất mô hình có phải là sao chép mô hình khác?
Về kỹ thuật, chưng cất là dùng đầu ra của mô hình lớn để dạy mô hình nhỏ. Khi một hãng chưng cất từ mô hình của chính mình như Meta dùng Muse Wonder, đó là cách làm hợp lệ. Còn dùng đầu ra mô hình của hãng khác để huấn luyện thường vi phạm điều khoản sử dụng của hãng đó.
Vì sao Muse Ember hay từ chối trả lời?
Theo Artificial Analysis, Ember từ chối khoảng 64% câu hỏi kiến thức mà nó không chắc. Đây là đặc điểm thiết kế hợp với vai trò agent: thay vì đoán bừa, mô hình báo không biết để hệ thống chuyển yêu cầu lên mô hình lớn hoặc người. Với câu hỏi tra cứu, bạn nên cấp sẵn tài liệu để Ember đọc.
Doanh nghiệp nhỏ có nên dùng mô hình AI nhỏ không?
Có, nếu bạn có việc lặp lại số lượng lớn như phân loại tin nhắn, nhập liệu từ chứng từ. Hãy bắt đầu với một tác vụ hẹp, bộ thử 50–100 mẫu và đường lui sang người. Khi tỷ lệ đúng ổn định, mở rộng dần thay vì tự động hoá toàn bộ ngay.
Kết luận: chọn đúng cỡ mô hình cho đúng việc
Muse Ember cho thấy cuộc đua AI không chỉ là ai có mô hình lớn nhất, mà còn là ai làm được mô hình nhỏ đủ khôn với chi phí thấp nhất. Với AI agent, nơi một yêu cầu có thể kéo theo hàng chục lần gọi, mô hình AI nhỏ chính là thứ quyết định bài toán có lời hay không. Bí quyết không nằm ở việc chọn một mô hình “tốt nhất”, mà ở cách chia việc: lớn lập kế hoạch, nhỏ thực thi, và luôn có đường lui khi mô hình không chắc chắn.
Bạn đang muốn tự động hoá việc gì trong công việc của mình bằng AI? Hãy để lại bình luận để Nhật Phúc gợi ý cách chia việc giữa mô hình lớn và nhỏ, và theo dõi kênh Nhật Phúc để không bỏ lỡ các bài giải thích công nghệ AI dễ hiểu tiếp theo.