Bạn muốn cài DeepSeek R1 trên máy tính để hỏi đáp, tóm tắt tài liệu hay nhờ viết mã mà không cần gửi dữ liệu lên mạng? Điều này hoàn toàn làm được với một chiếc PC hay laptop bình thường, miễn là bạn chọn đúng phiên bản. Bài viết giải thích DeepSeek R1 “bản chưng cất” là gì, máy cần cấu hình ra sao và hướng dẫn từng bước với LM Studio, ứng dụng miễn phí để chạy mô hình AI ngay trên máy.
Điểm quan trọng nhất cần biết trước: thứ bạn tải về không phải mô hình DeepSeek-R1 khổng lồ mà là những mô hình nhỏ được R1 “dạy lại”. Hiểu đúng điều này giúp bạn đặt kỳ vọng hợp lý và chọn bản phù hợp với máy.
Câu trả lời ngắn: Cài LM Studio, vào mục Discover tìm “DeepSeek R1”, tải bản 7B hoặc 8B ở mức nén Q4 (khoảng 5 GB), nạp mô hình rồi trò chuyện trong tab Chat. Máy x64 cần CPU hỗ trợ AVX2, nên có từ 16 GB RAM. Mọi câu hỏi được xử lý trên máy, không cần Internet sau khi tải xong.
Tóm tắt nhanh
- DeepSeek-R1 bản đầy đủ có 671 tỷ tham số, không chạy nổi trên PC; bản dùng tại nhà là các mô hình chưng cất 1,5–70 tỷ tham số.
- Bản mới đáng thử là DeepSeek-R1-0528-Qwen3-8B (tháng 5/2025), điểm AIME 2024 đạt 86,0 theo DeepSeek.
- LM Studio miễn phí cho cả cá nhân và doanh nghiệp từ tháng 7/2025, chạy trên Windows, macOS (chip Apple) và Linux.
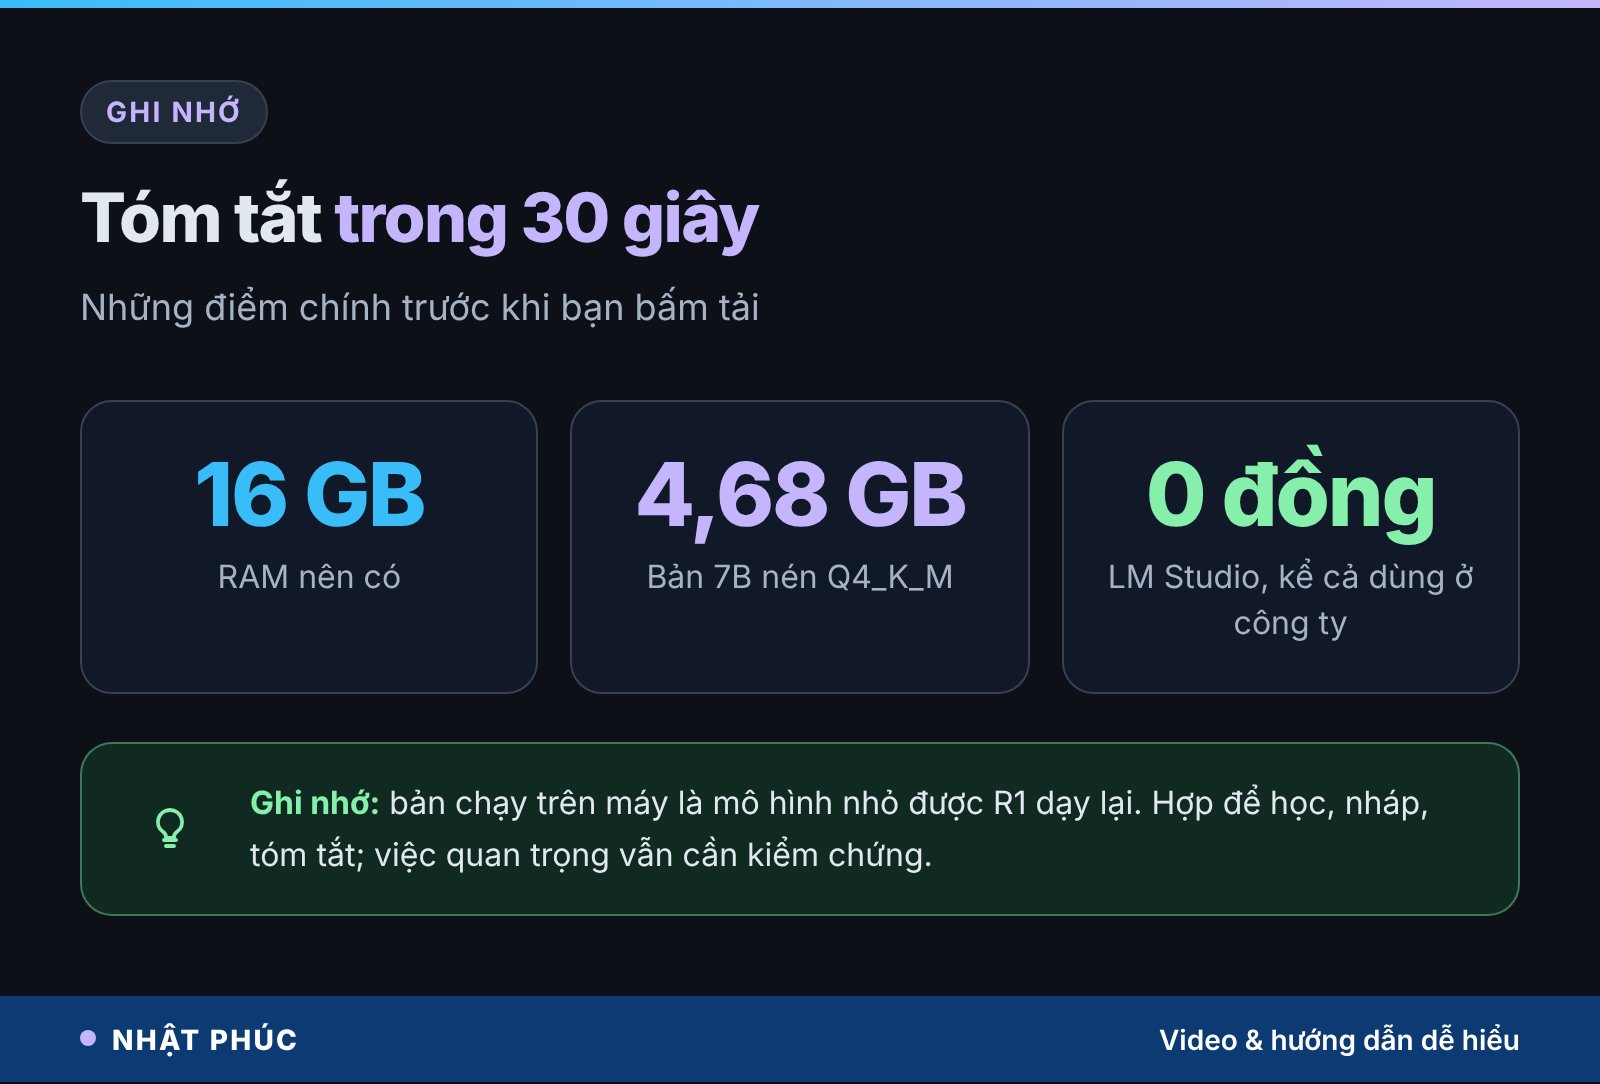
- Bản 7B nén Q4_K_M nặng khoảng 4,68 GB, là lựa chọn cân bằng cho máy 16 GB RAM.
- Chạy trên máy giúp dữ liệu không rời máy, nhưng mô hình nhỏ vẫn có thể trả lời sai.
Mục lục
- DeepSeek R1 là gì và vì sao gây chú ý
- “Chưng cất” mô hình hoạt động thế nào
- Các phiên bản R1 Distill và điểm chuẩn
- Máy tính cần cấu hình thế nào
- Lượng tử hóa GGUF: chọn bản nén nào
- Cách cài DeepSeek R1 bằng LM Studio
- Chạy trên máy hay dùng app DeepSeek
- Dùng vào việc gì, tiếng Việt ra sao
- Hiểu lầm phổ biến
- Mẹo dùng hiệu quả
- Câu hỏi thường gặp
DeepSeek R1 là gì và vì sao gây chú ý
DeepSeek-R1 là mô hình ngôn ngữ lớn chuyên về suy luận (reasoning) do công ty DeepSeek của Trung Quốc phát hành vào tháng 1/2025, kèm bài báo khoa học công bố ngày 22/1/2025. Khác với chatbot trả lời ngay, mô hình suy luận “nghĩ thành tiếng” trước: nó viết ra chuỗi lập luận, tự kiểm tra rồi mới đưa đáp án. Nếu bạn từng thấy chế độ “suy nghĩ” trên các chatbot, đó cũng là ý tưởng này; Nhật Phúc có bài riêng về khi nào nên bật chế độ suy nghĩ của AI.
Điều khiến R1 nổi tiếng là nó được phát hành theo giấy phép MIT: ai cũng có thể tải trọng số, dùng cho mục đích thương mại, thậm chí dùng để huấn luyện mô hình khác. Theo trang mô hình chính thức trên Hugging Face, bản đầy đủ dùng kiến trúc Mixture of Experts với 671 tỷ tham số, mỗi lần xử lý chỉ kích hoạt 37 tỷ, ngữ cảnh dài 128.000 token.
671 tỷ tham số nghĩa là riêng tệp mô hình đã nặng hàng trăm GB, cần cụm máy chủ nhiều GPU. Vì vậy DeepSeek phát hành thêm một “gia đình” mô hình nhỏ gọi là R1 Distill, và đây mới là thứ người dùng phổ thông có thể chạy tại nhà.
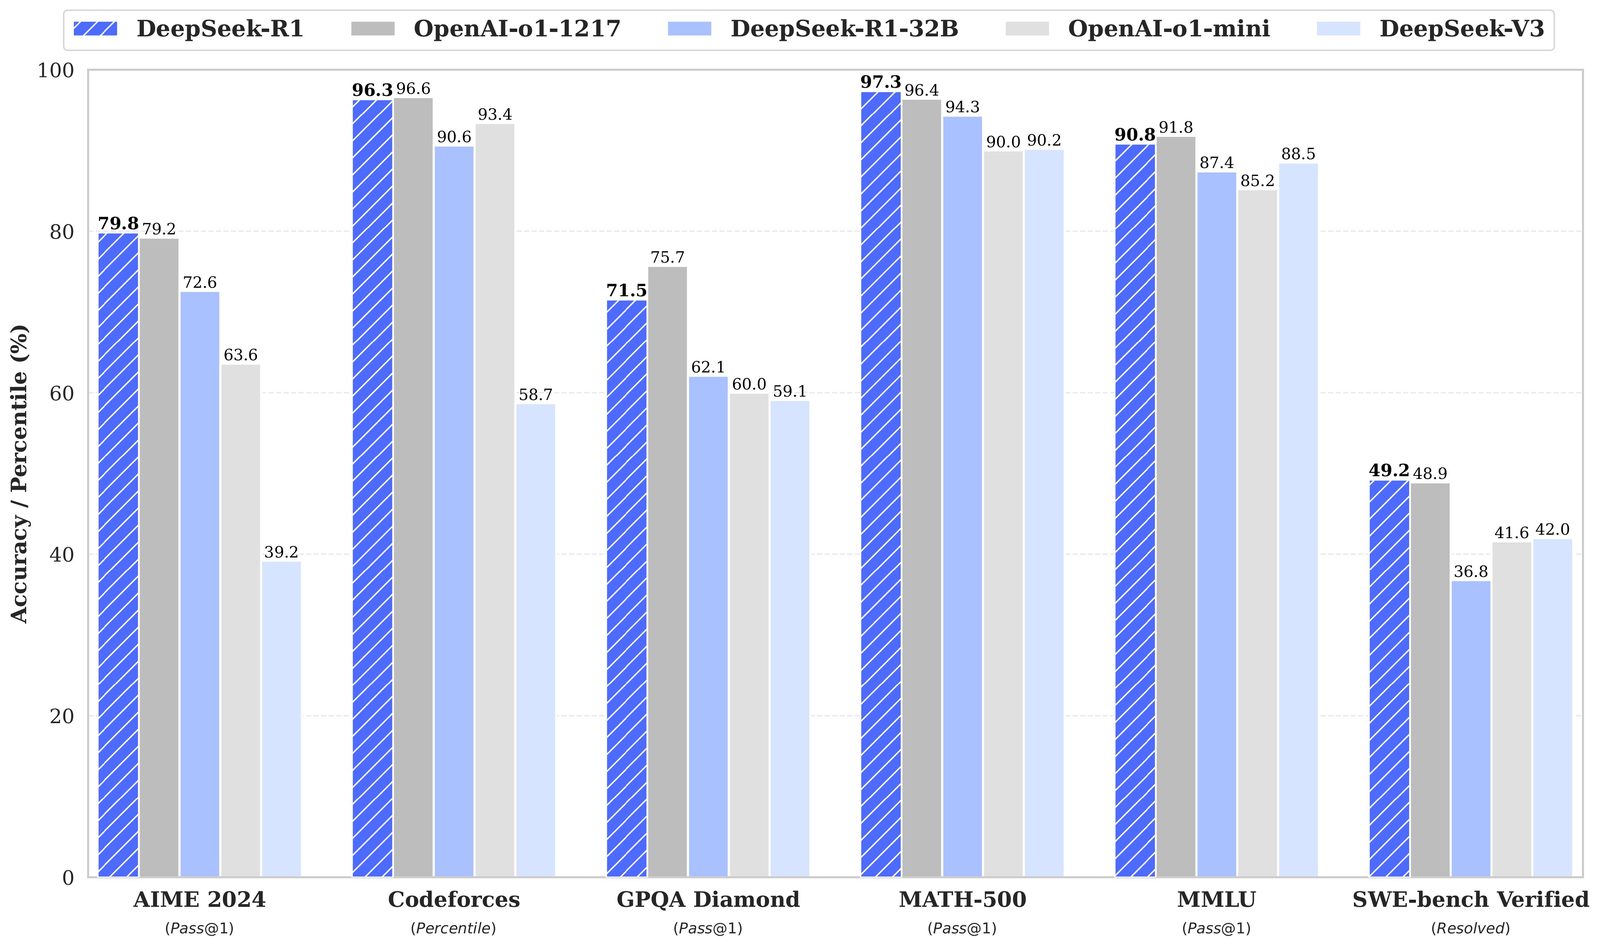
Đến nay DeepSeek đã có các thế hệ mới hơn, ví dụ dòng V4 ra mắt ngày 24/4/2026 với ngữ cảnh 1 triệu token. Tuy vậy, các bản R1 Distill vẫn là điểm khởi đầu phổ biến cho ai muốn tự chạy một mô hình biết suy luận trên máy cá nhân, vì nhẹ và có sẵn trong hầu hết công cụ.
“Chưng cất” mô hình hoạt động thế nào
Chưng cất tri thức (knowledge distillation) là kỹ thuật cho một mô hình nhỏ học theo cách làm bài của một mô hình lớn. Hãy hình dung một giáo sư giải hàng trăm nghìn bài tập, ghi rõ từng bước suy nghĩ. Một sinh viên chăm chỉ đọc hết lời giải mẫu đó và tập làm theo. Sinh viên không giỏi bằng thầy, nhưng học được “lối tư duy” nhanh hơn nhiều so với tự mày mò.
Với R1, “thầy” là DeepSeek-R1 bản đầy đủ, “trò” là các mô hình mã nguồn mở sẵn có như Qwen 2.5 của Alibaba hay Llama 3 của Meta. DeepSeek dùng R1 tạo ra khối lượng lớn lời giải có chuỗi suy luận, rồi tinh chỉnh các mô hình trò trên dữ liệu đó.
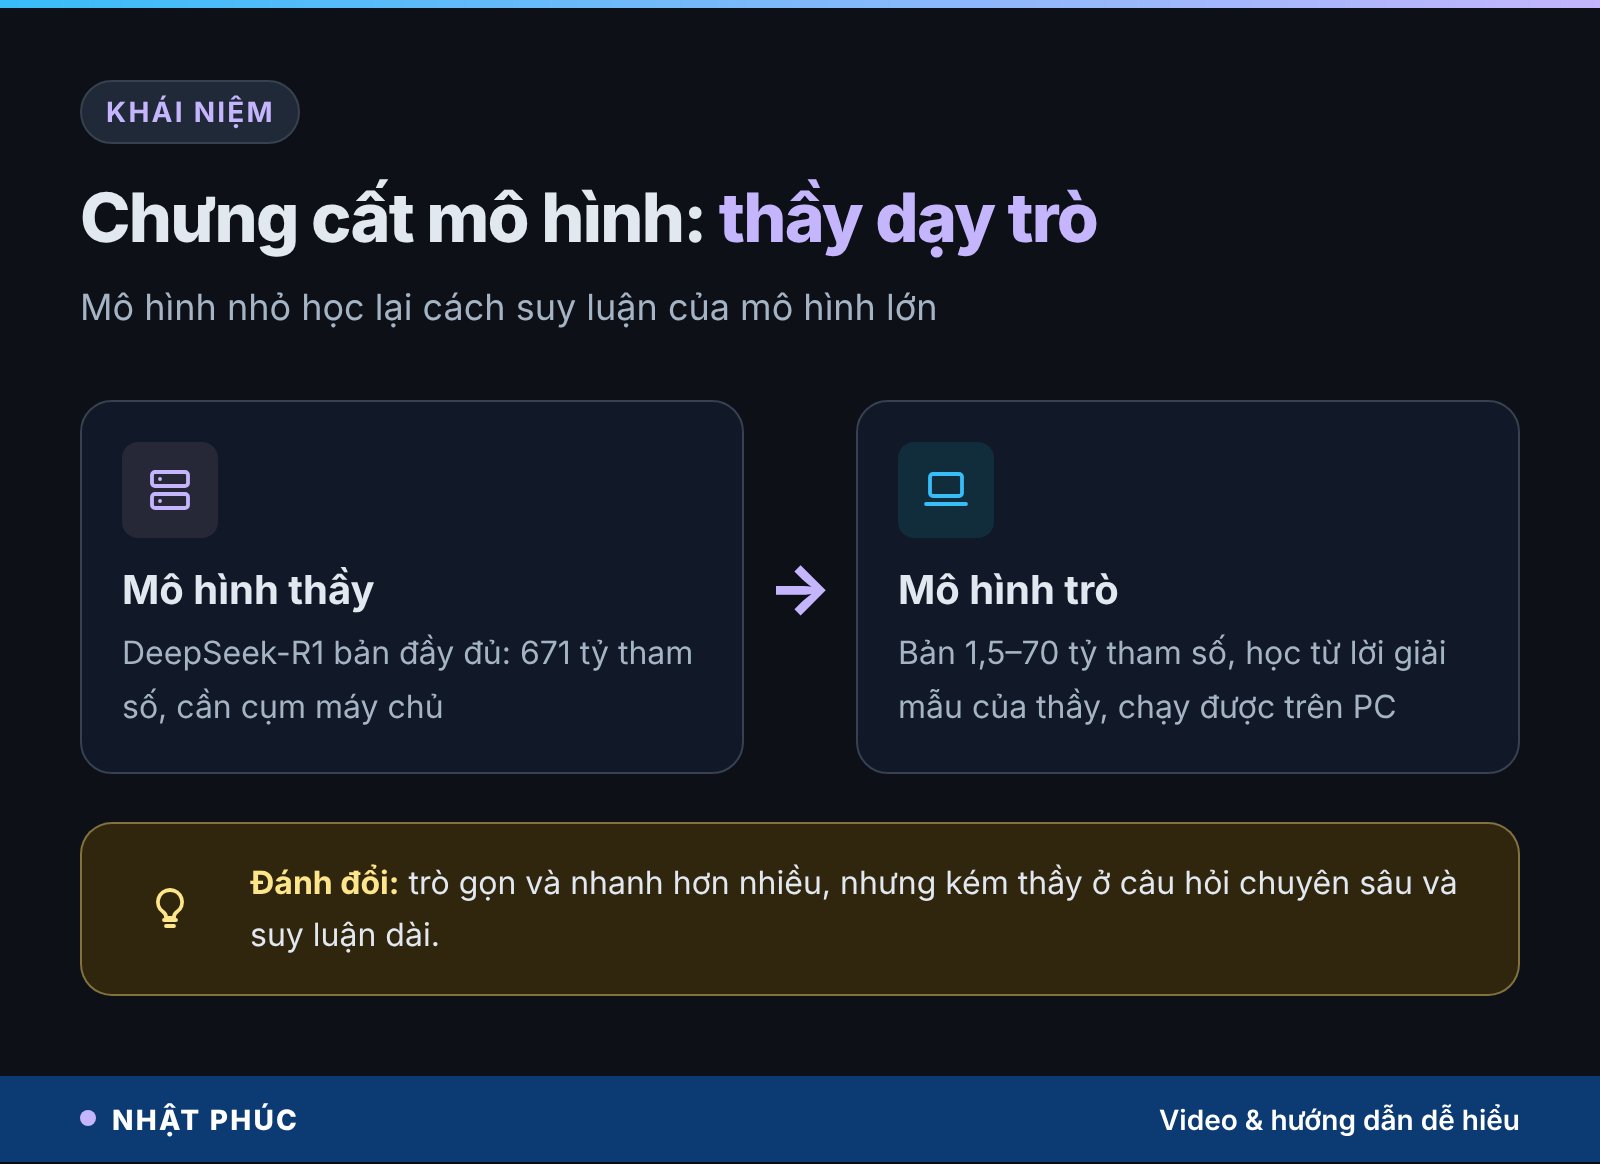
Kết quả là những mô hình chỉ vài tỷ tham số nhưng có thói quen “suy nghĩ trước khi trả lời” giống R1. Cái giá phải trả là mất bớt chi tiết: kiến thức chuyên ngành hẹp, bài toán nhiều bước dài hay câu hỏi cần hiểu biết rộng sẽ kém hơn bản gốc rõ rệt. Đó là lý do bạn nên coi bản chạy trên máy là trợ lý nháp, không phải “DeepSeek thu nhỏ hoàn hảo”.
Các phiên bản R1 Distill và điểm chuẩn
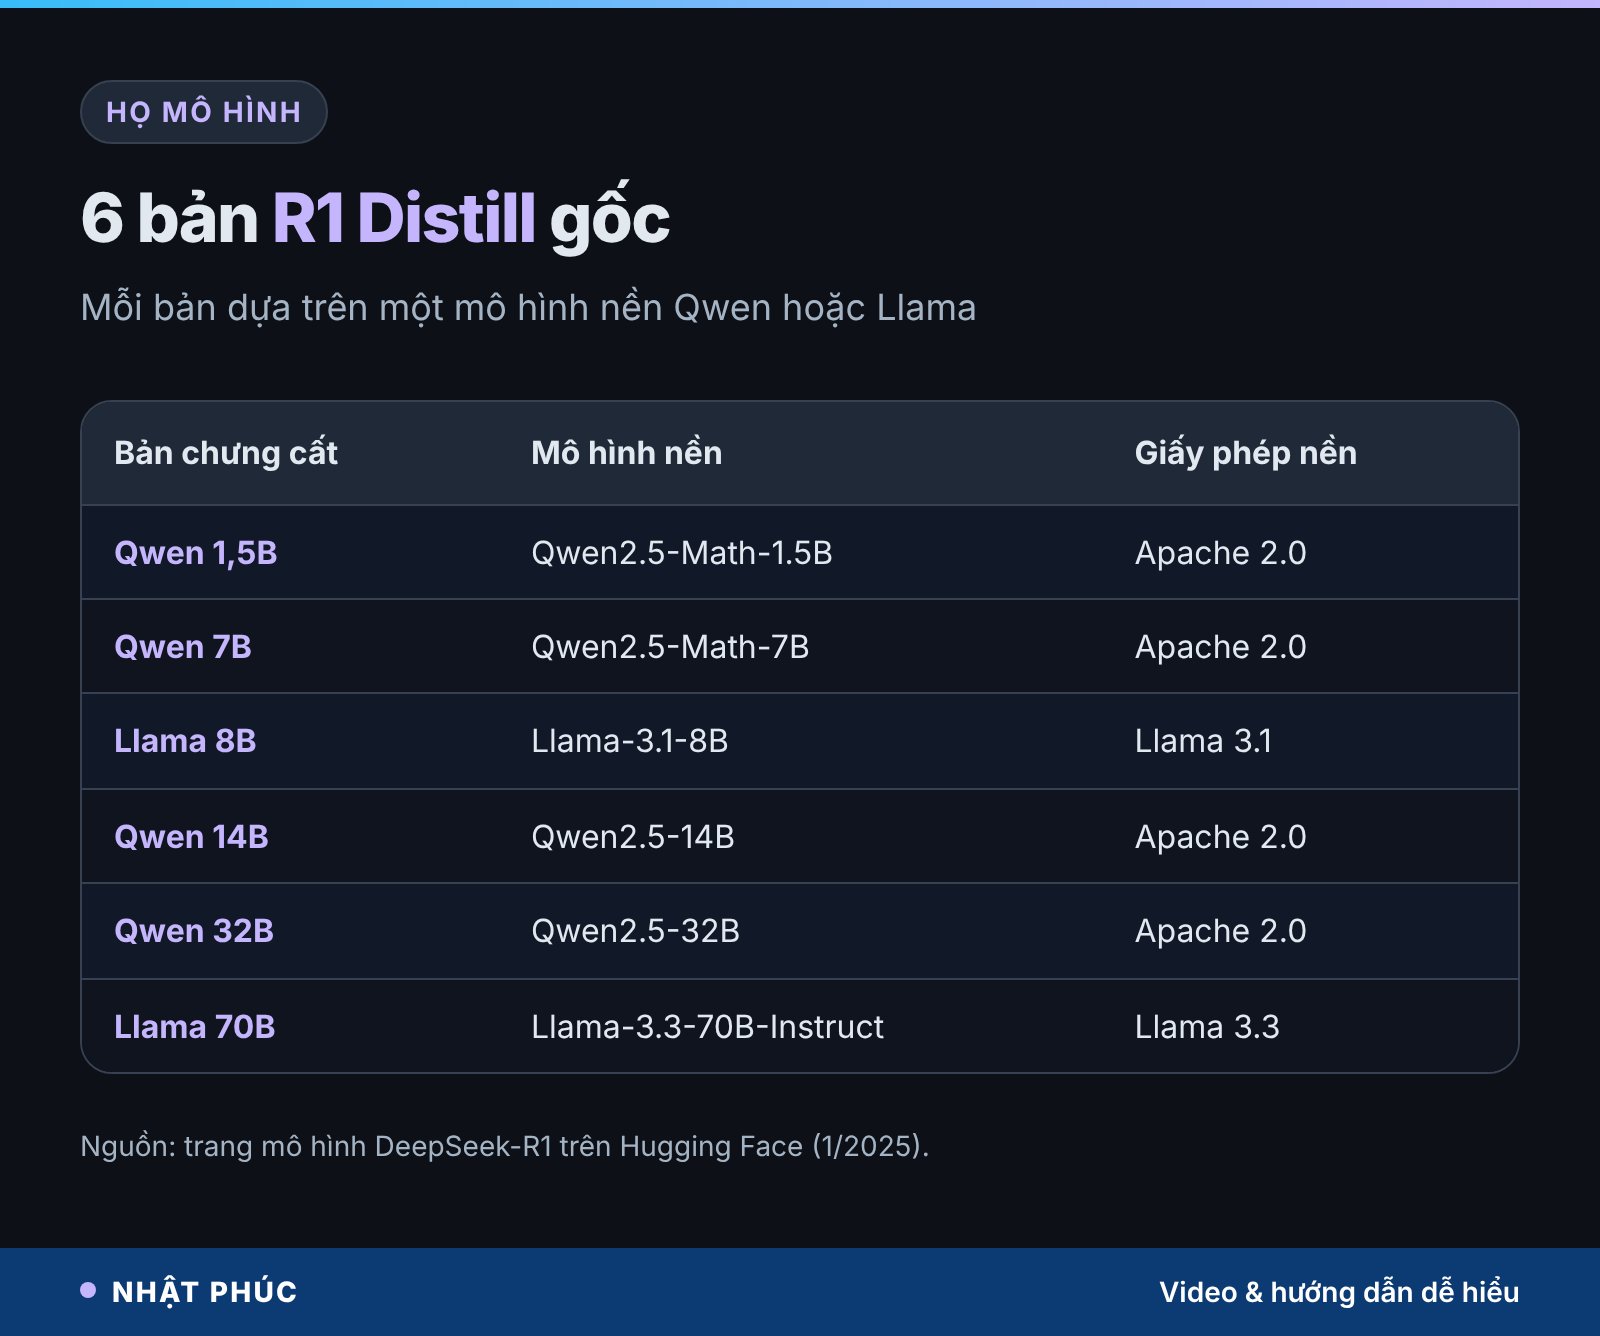
Đợt đầu, DeepSeek phát hành 6 bản chưng cất. Tên mỗi bản cho biết mô hình nền và kích thước, ví dụ DeepSeek-R1-Distill-Qwen-7B là Qwen 2.5 Math 7B đã được R1 dạy lại. Giấy phép của từng bản đi theo mô hình nền: Apache 2.0 với nhóm Qwen, giấy phép Llama 3.1/3.3 với nhóm Llama.
Về năng lực, điểm toán AIME 2024 (pass@1) do DeepSeek công bố tăng theo kích thước: bản Qwen 1,5B đạt 28,9; Qwen 7B đạt 55,5; Llama 8B đạt 50,4; Qwen 14B đạt 69,7 và Qwen 32B đạt 72,6. Với bài toán phổ thông MATH-500, bản 7B đã đạt 92,8, cho thấy mô hình nhỏ vẫn làm tốt dạng bài quen thuộc.
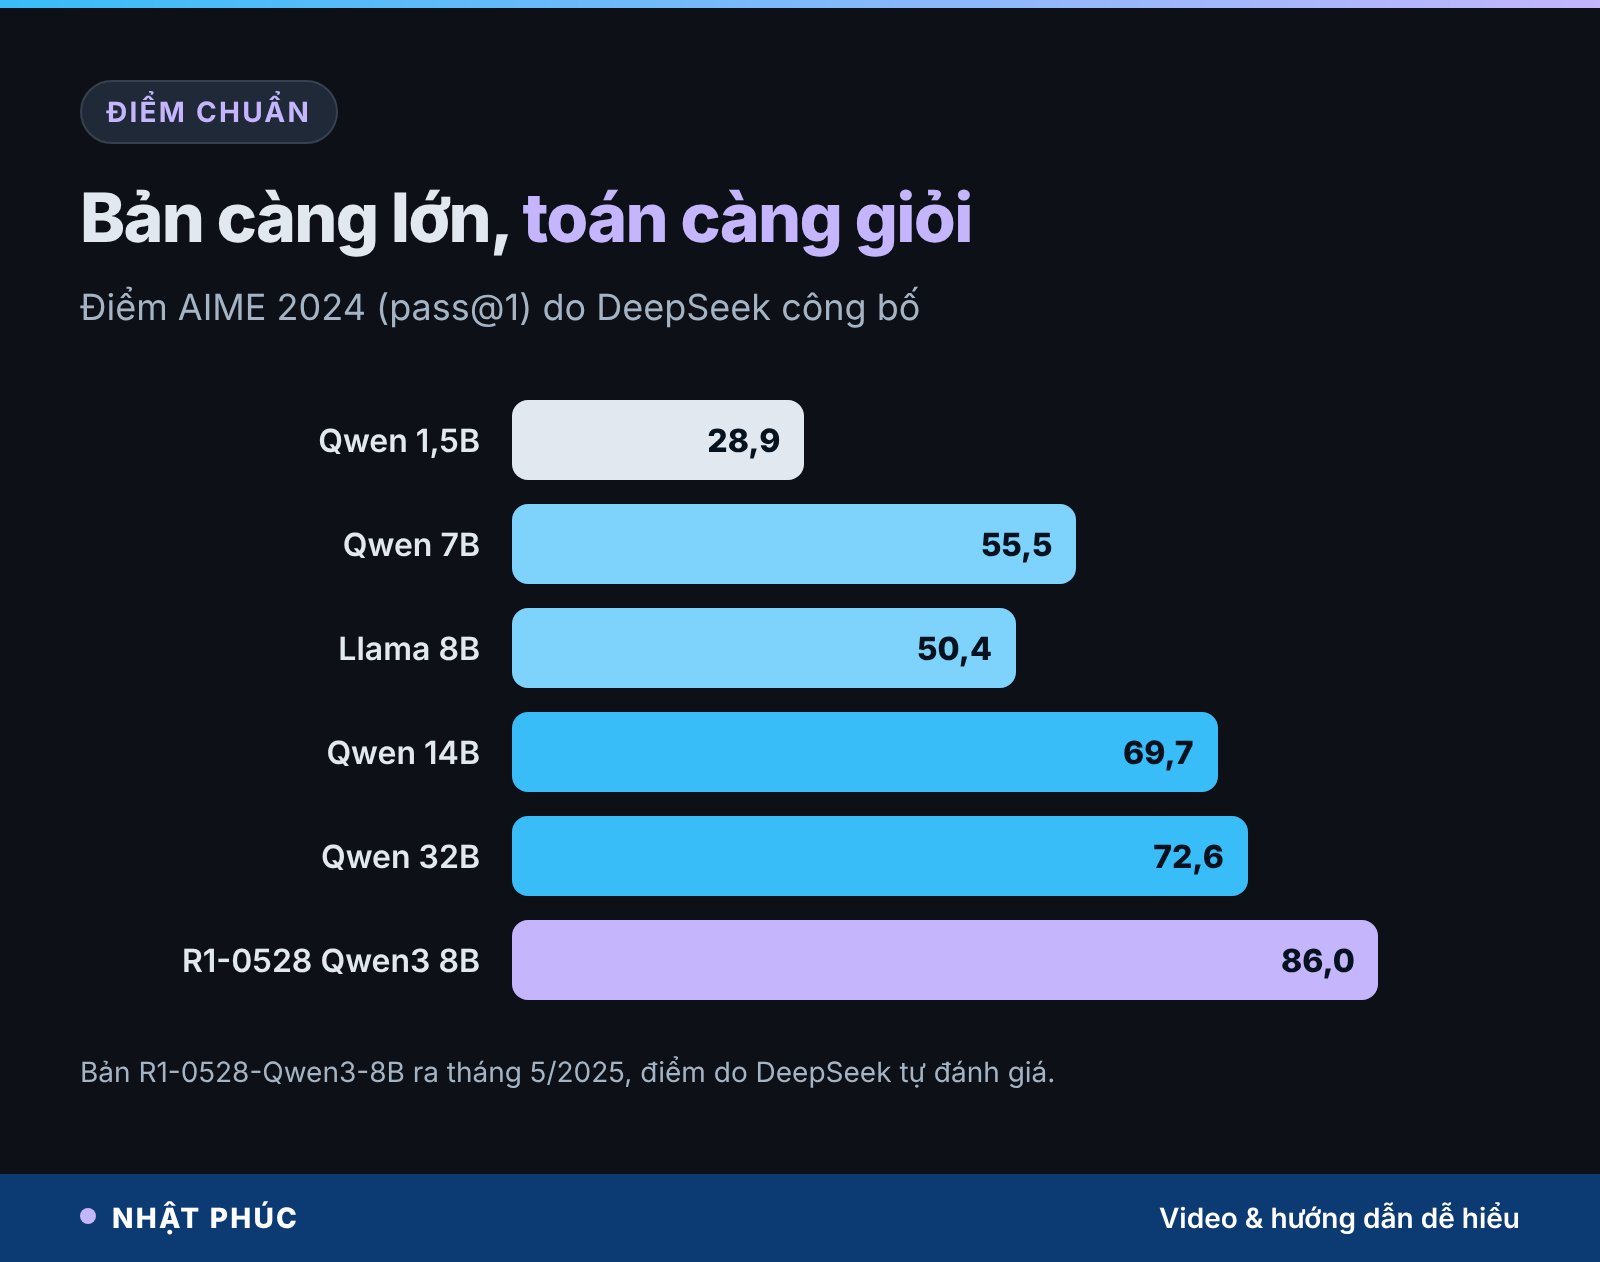
Ngày 28/5/2025, DeepSeek cập nhật R1 lên bản R1-0528 và phát hành thêm DeepSeek-R1-0528-Qwen3-8B, chưng cất trên nền Qwen3 8B. Theo DeepSeek, bản này đạt 86,0 điểm AIME 2024, cao hơn Qwen3 8B gốc khoảng 10 điểm, và hỗ trợ cả system prompt lẫn gọi công cụ. LM Studio cho biết cần bản 0.3.16 trở lên để chạy mô hình này.
Lưu ý các con số trên đều do DeepSeek tự đánh giá. Chúng hữu ích để so sánh các bản với nhau, nhưng không thay được việc bạn tự thử với câu hỏi của chính mình.
Máy tính cần cấu hình thế nào
Theo trang yêu cầu hệ thống của LM Studio, máy Windows x64 cần CPU hỗ trợ tập lệnh AVX2 (hầu hết CPU Intel, AMD từ khoảng năm 2013–2015 trở đi đều có), nên có ít nhất 16 GB RAM và nếu có GPU rời thì nên từ 4 GB VRAM. Windows trên chip Snapdragon X cũng được hỗ trợ. Trên Mac, LM Studio chỉ chạy với chip Apple M1 trở lên và macOS 14 trở lên; Linux cần Ubuntu 20.04 trở lên.
Card đồ họa không bắt buộc nhưng giúp tăng tốc rõ. Nguyên tắc đơn giản: mô hình nạp hết vào VRAM thì trả lời nhanh nhất; không đủ thì LM Studio chia một phần cho CPU và RAM, chậm hơn nhưng vẫn chạy.
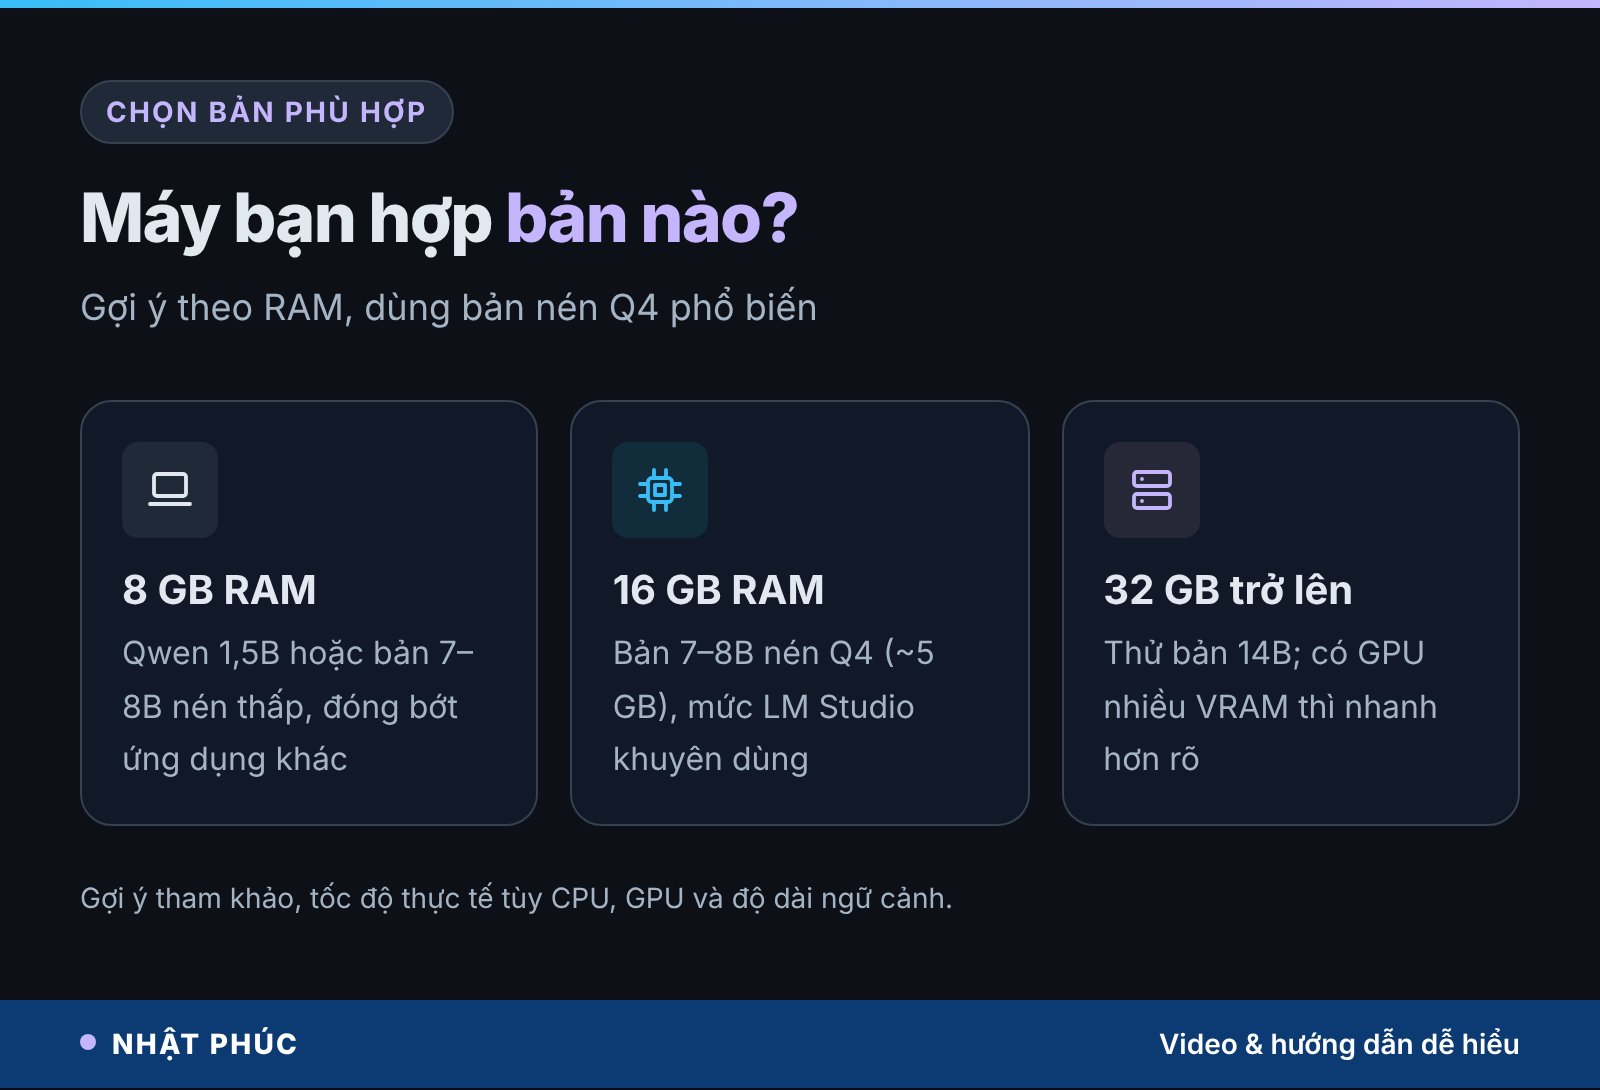
- Máy 8 GB RAM: thử bản Qwen 1,5B, hoặc bản 7–8B ở mức nén thấp và đóng bớt trình duyệt, ứng dụng nặng.
- Máy 16 GB RAM: bản 7B hoặc 8B nén Q4 là điểm cân bằng giữa chất lượng và tốc độ.
- Máy 32 GB trở lên hoặc GPU nhiều VRAM: có thể thử bản 14B để câu trả lời chắc tay hơn.
Nếu bạn dùng máy Copilot+ PC, Microsoft từ đầu năm 2025 đã đưa bản DeepSeek-R1-Distill-Qwen-1.5B tối ưu cho NPU vào tiện ích AI Toolkit của VS Code, trước tiên trên chip Snapdragon X. Bạn có thể đọc thêm tin Microsoft đưa thêm mô hình DeepSeek chạy cục bộ lên Copilot+ PC.
Lượng tử hóa GGUF: chọn bản nén nào
Khi tìm mô hình trong LM Studio, bạn sẽ thấy các ký hiệu như Q4_K_M, Q6_K, Q8_0. Đây là mức lượng tử hóa (quantization): thay vì lưu mỗi trọng số bằng số 16 bit, người ta làm tròn xuống 8, 6, 4 hay thậm chí 2 bit. Giống như nén ảnh JPEG, nén càng mạnh tệp càng nhẹ, nhưng chi tiết mất dần.
Định dạng tệp phổ biến nhất là GGUF, dùng cho bộ máy llama.cpp mà LM Studio chạy bên dưới. Trên máy Mac, LM Studio còn hỗ trợ định dạng MLX tối ưu cho chip Apple.
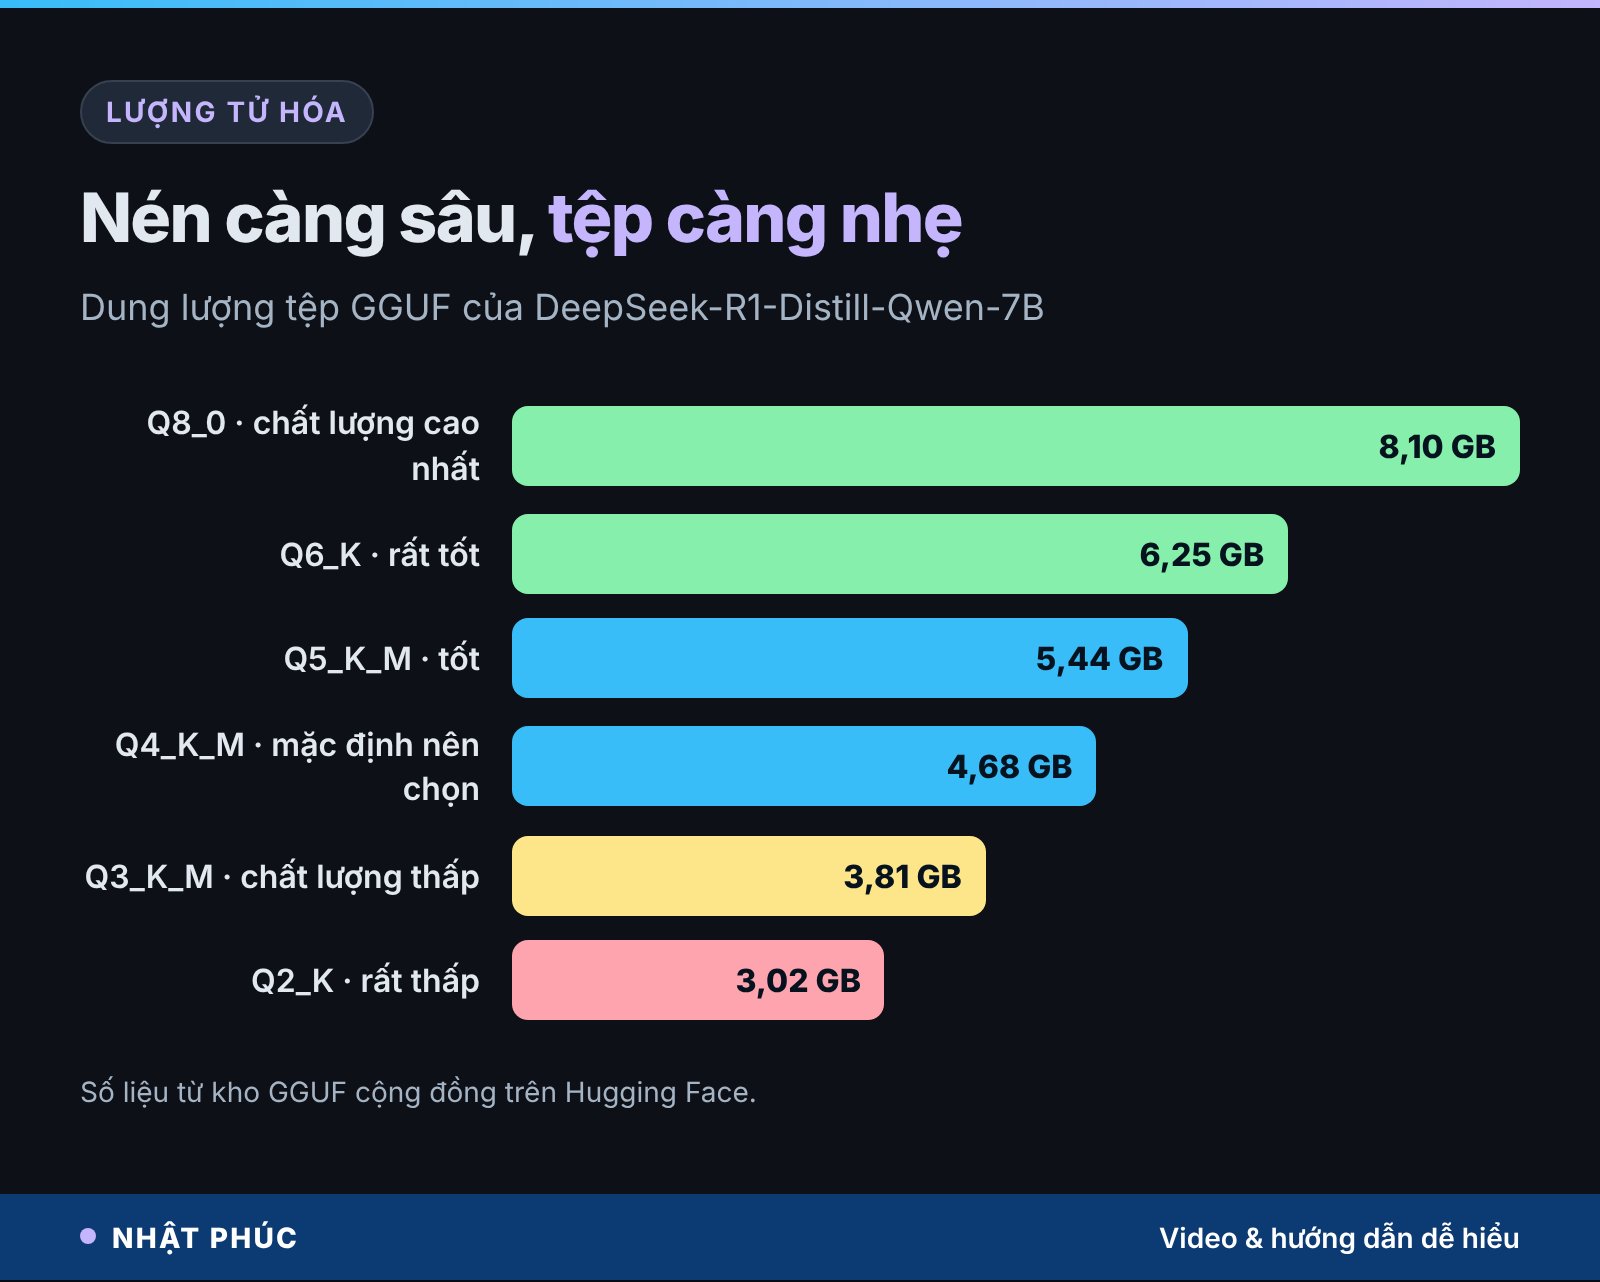
| Mức nén | Dung lượng | Nhận xét |
|---|---|---|
| Q8_0 | 8,10 GB | Gần như nguyên bản, nặng nhất |
| Q6_K | 6,25 GB | Chất lượng rất cao |
| Q4_K_M | 4,68 GB | Mặc định nên chọn cho đa số máy |
| Q2_K | 3,02 GB | Rất nhẹ, chất lượng giảm rõ |
Lời khuyên: bắt đầu với Q4_K_M. Nếu máy dư sức, lên Q5 hoặc Q6; nếu máy đuối, giảm kích thước mô hình (từ 7B xuống 1,5B) thường tốt hơn là nén xuống Q2.
Cách cài DeepSeek R1 bằng LM Studio
LM Studio là ứng dụng có giao diện đồ họa để tải và chạy mô hình AI cục bộ. Từ ngày 8/7/2025, ứng dụng miễn phí cho cả mục đích công việc, không cần xin giấy phép thương mại riêng. Phiên bản hiện tại còn tích hợp trợ lý Bionic, nhưng phần chạy mô hình trên máy vẫn hoạt động như trước.
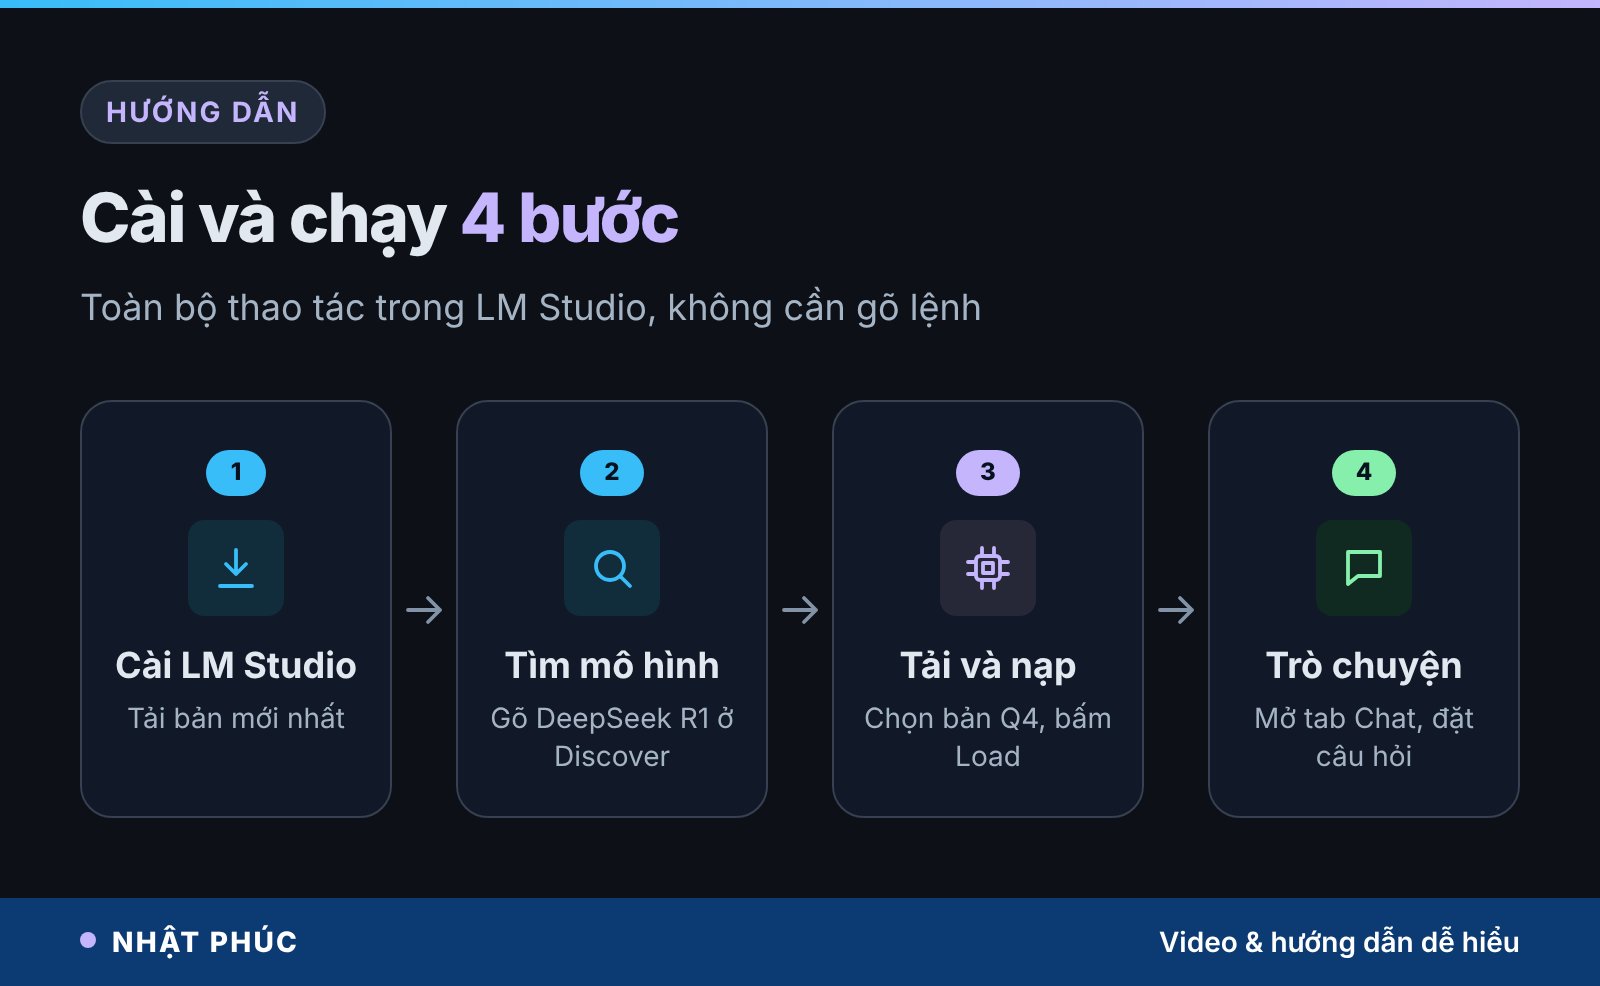
1. Cài LM Studio
Tải bộ cài từ trang chủ lmstudio.ai, chọn đúng hệ điều hành. Nếu đã cài từ trước, hãy cập nhật lên bản mới nhất để nhận mô hình mới.
2. Tìm mô hình DeepSeek R1
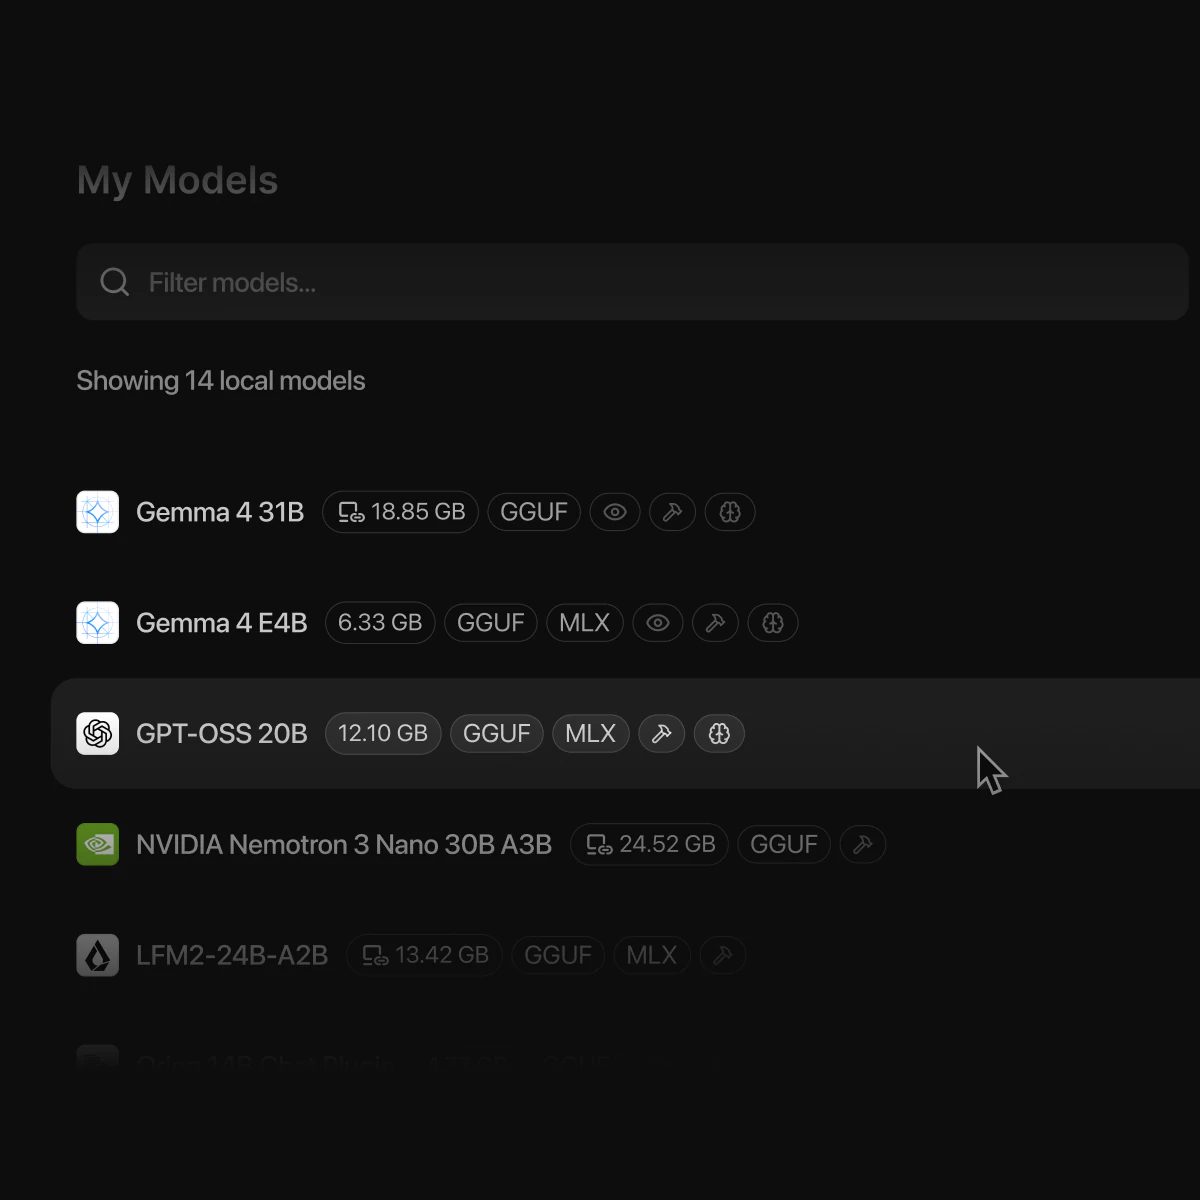
Mở tab Discover (biểu tượng kính lúp), gõ “DeepSeek R1”. Danh sách sẽ hiện các bản như deepseek-r1-0528-qwen3-8b hay deepseek-r1-distill-qwen-7b. LM Studio thường gợi ý mức nén phù hợp với máy, bạn có thể đổi trong danh sách tệp.
3. Tải và nạp mô hình
Bấm Download, chờ tải xong vài GB. Sang tab Chat, mở ô chọn mô hình ở trên cùng và chọn bản vừa tải. Lúc này LM Studio nạp trọng số vào RAM hoặc VRAM; mất vài giây đến một phút.
4. Trò chuyện và xem phần suy nghĩ
Gõ câu hỏi như với chatbot bình thường. Mô hình sẽ hiện phần suy luận (thường gói trong khối “think”) trước câu trả lời cuối. Bạn có thể ngắt mạng để tự kiểm chứng: sau khi tải xong, mọi thứ vẫn chạy.
5. Cách dùng bằng dòng lệnh (tuỳ chọn)
Người quen dòng lệnh có thể dùng công cụ lms đi kèm: lệnh lms get tải mô hình, lms load nạp mô hình và lms server start mở máy chủ cục bộ tại địa chỉ localhost cổng 1234, tương thích chuẩn API của OpenAI. Nhờ vậy các ứng dụng khác trên máy có thể gọi DeepSeek R1 mà không cần Internet.
Chạy trên máy hay dùng app DeepSeek
Cùng mang tên DeepSeek nhưng hai cách dùng khác nhau hoàn toàn. Khi dùng app, web hay API của DeepSeek, câu hỏi và tài liệu bạn gửi đi được xử lý trên máy chủ của hãng, đổi lại bạn có mô hình mạnh và mới nhất. Khi chạy bằng LM Studio, dữ liệu nằm yên trên máy, phù hợp với tài liệu nội bộ, hồ sơ cá nhân hay khi mạng chập chờn.
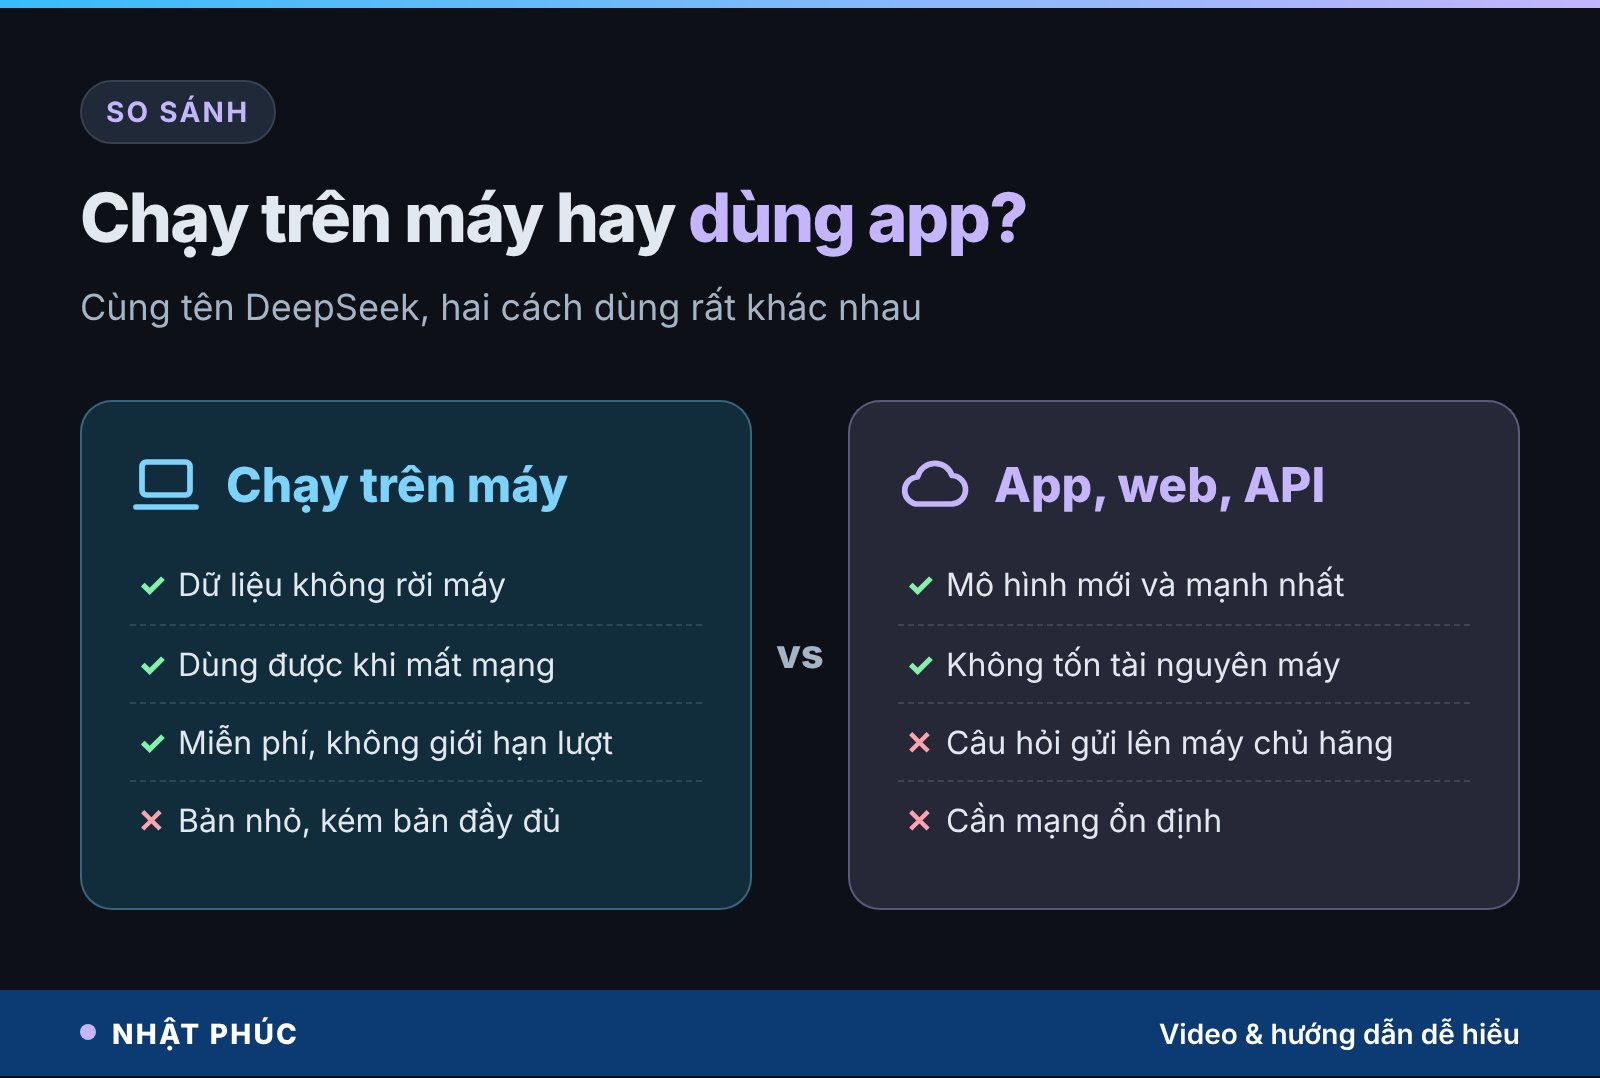
Với doanh nghiệp tại Việt Nam, chạy cục bộ còn giúp chủ động kiểm soát dữ liệu theo các quy định về bảo vệ dữ liệu cá nhân, vì thông tin không bị chuyển ra nước ngoài. Tuy nhiên, “cục bộ” không có nghĩa là an toàn tuyệt đối: bạn vẫn nên tải mô hình từ nguồn rõ ràng (danh mục của LM Studio, trang chính thức của DeepSeek trên Hugging Face) và cập nhật ứng dụng thường xuyên.
Nếu bạn quan tâm cách chạy cả bộ công cụ AI (chat, vẽ ảnh, chuyển giọng nói) không cần mạng, xem thêm bài chạy AI offline trên máy tính của Nhật Phúc.
Dùng vào việc gì, tiếng Việt ra sao
Bản chưng cất phát huy tốt nhất ở các việc có cấu trúc rõ, nơi khả năng suy luận từng bước có ích:
- Học tập: giải và giải thích bài toán, logic, lập trình cơ bản; phần “think” cho bạn xem cách lập luận.
- Văn phòng: tóm tắt văn bản, lập dàn ý, viết nháp email, chuyển dữ liệu sang bảng.
- Lập trình: đọc và giải thích đoạn mã, gợi ý sửa lỗi, viết hàm nhỏ; kết hợp máy chủ cổng 1234 để nối với trình soạn mã.
- Nghiên cứu và giảng dạy: tìm hiểu cách mô hình suy luận, thử nghiệm giới hạn của AI mà không tốn phí API.
Về tiếng Việt, cần thực tế: các bản R1 Distill đời đầu dựa trên Qwen 2.5 Math vốn thiên về toán và tiếng Anh, nên thường “nghĩ” bằng tiếng Anh hoặc tiếng Trung rồi mới trả lời tiếng Việt, đôi khi lẫn từ. Bản mới dựa trên Qwen3, dòng mô hình được Alibaba công bố hỗ trợ 119 ngôn ngữ và phương ngữ, nên dễ chịu hơn với tiếng Việt. Mẹo nhỏ: ghi rõ “Hãy trả lời bằng tiếng Việt” ở cuối câu hỏi.
Hiểu lầm phổ biến
Nhiều người thất vọng sau khi cài vì kỳ vọng sai ngay từ đầu. Ba hiểu lầm hay gặp nhất:
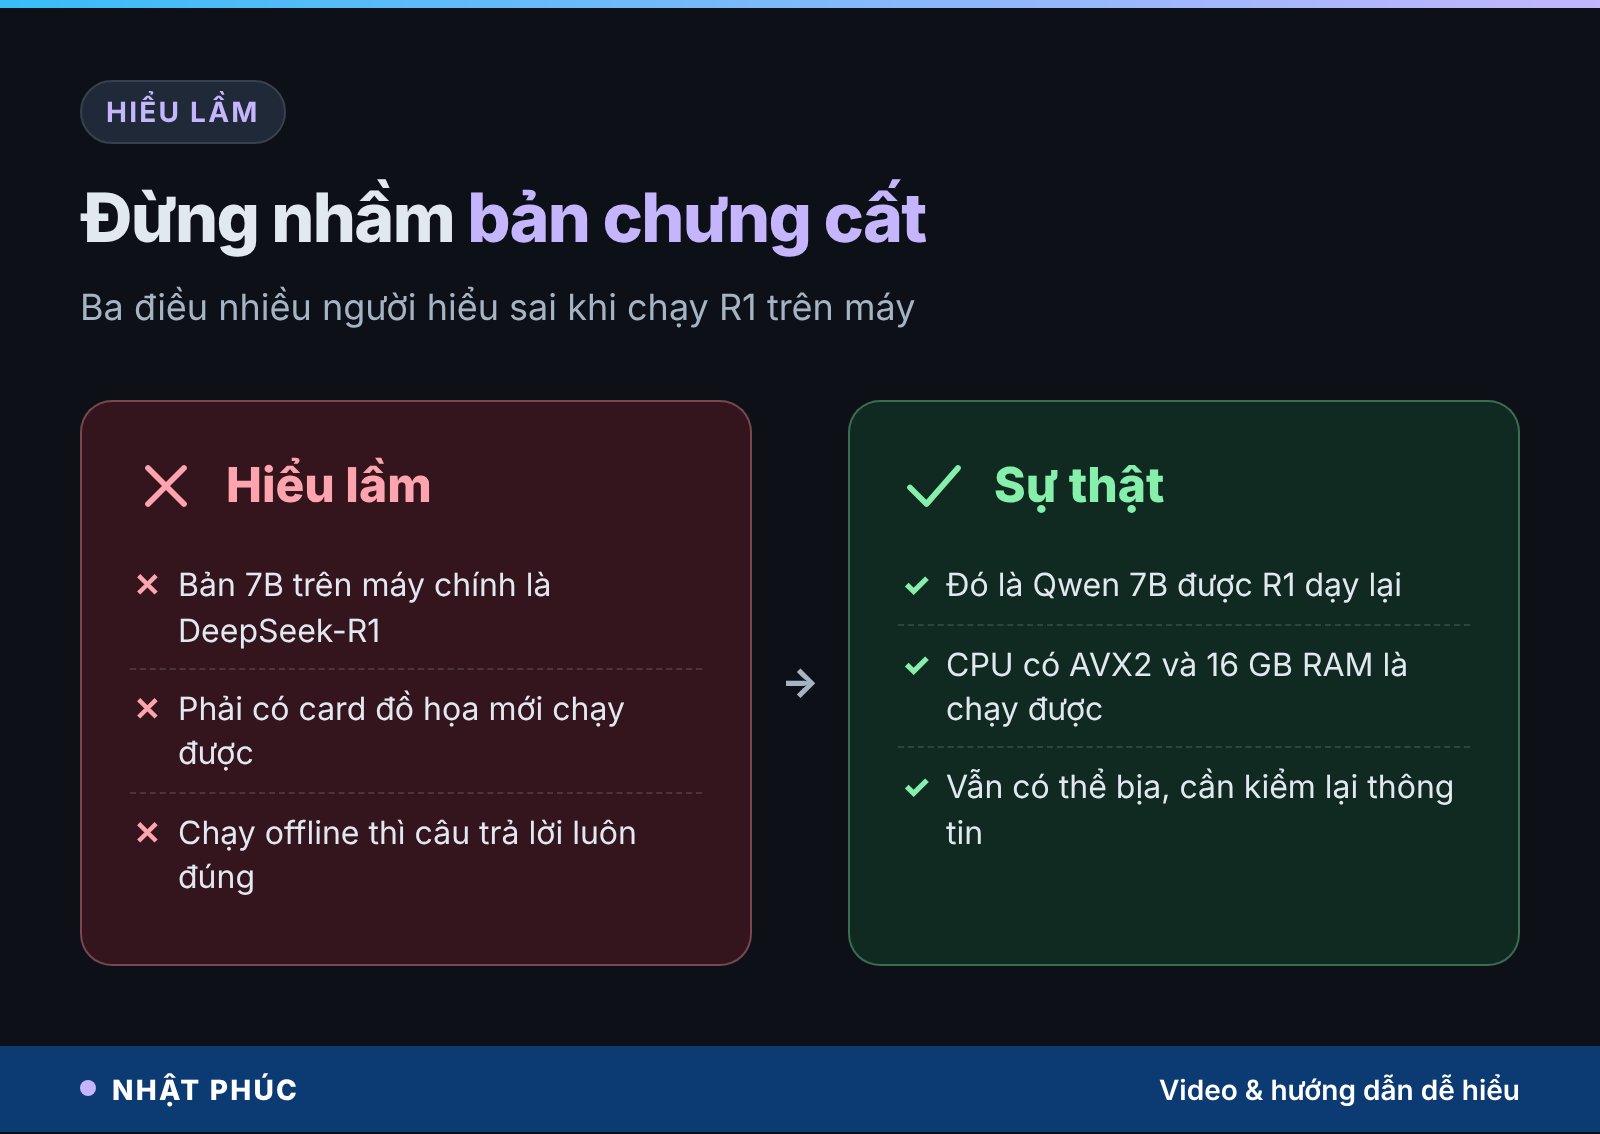
- “Bản 7B chính là DeepSeek-R1”: thực chất là Qwen 7B được R1 dạy lại, năng lực thấp hơn bản 671 tỷ tham số nhiều.
- “Phải có card đồ họa”: CPU hỗ trợ AVX2 cùng 16 GB RAM đã chạy được, GPU chỉ giúp nhanh hơn.
- “Offline nên luôn đúng”: mô hình nhỏ vẫn có thể “ảo giác”, bịa số liệu hay trích dẫn. Việc chạy offline chỉ thay đổi nơi xử lý, không thay đổi độ chính xác.
Mẹo dùng hiệu quả
DeepSeek ghi rõ một số khuyến nghị trên trang mô hình. Áp dụng đúng giúp câu trả lời ổn định hơn hẳn.
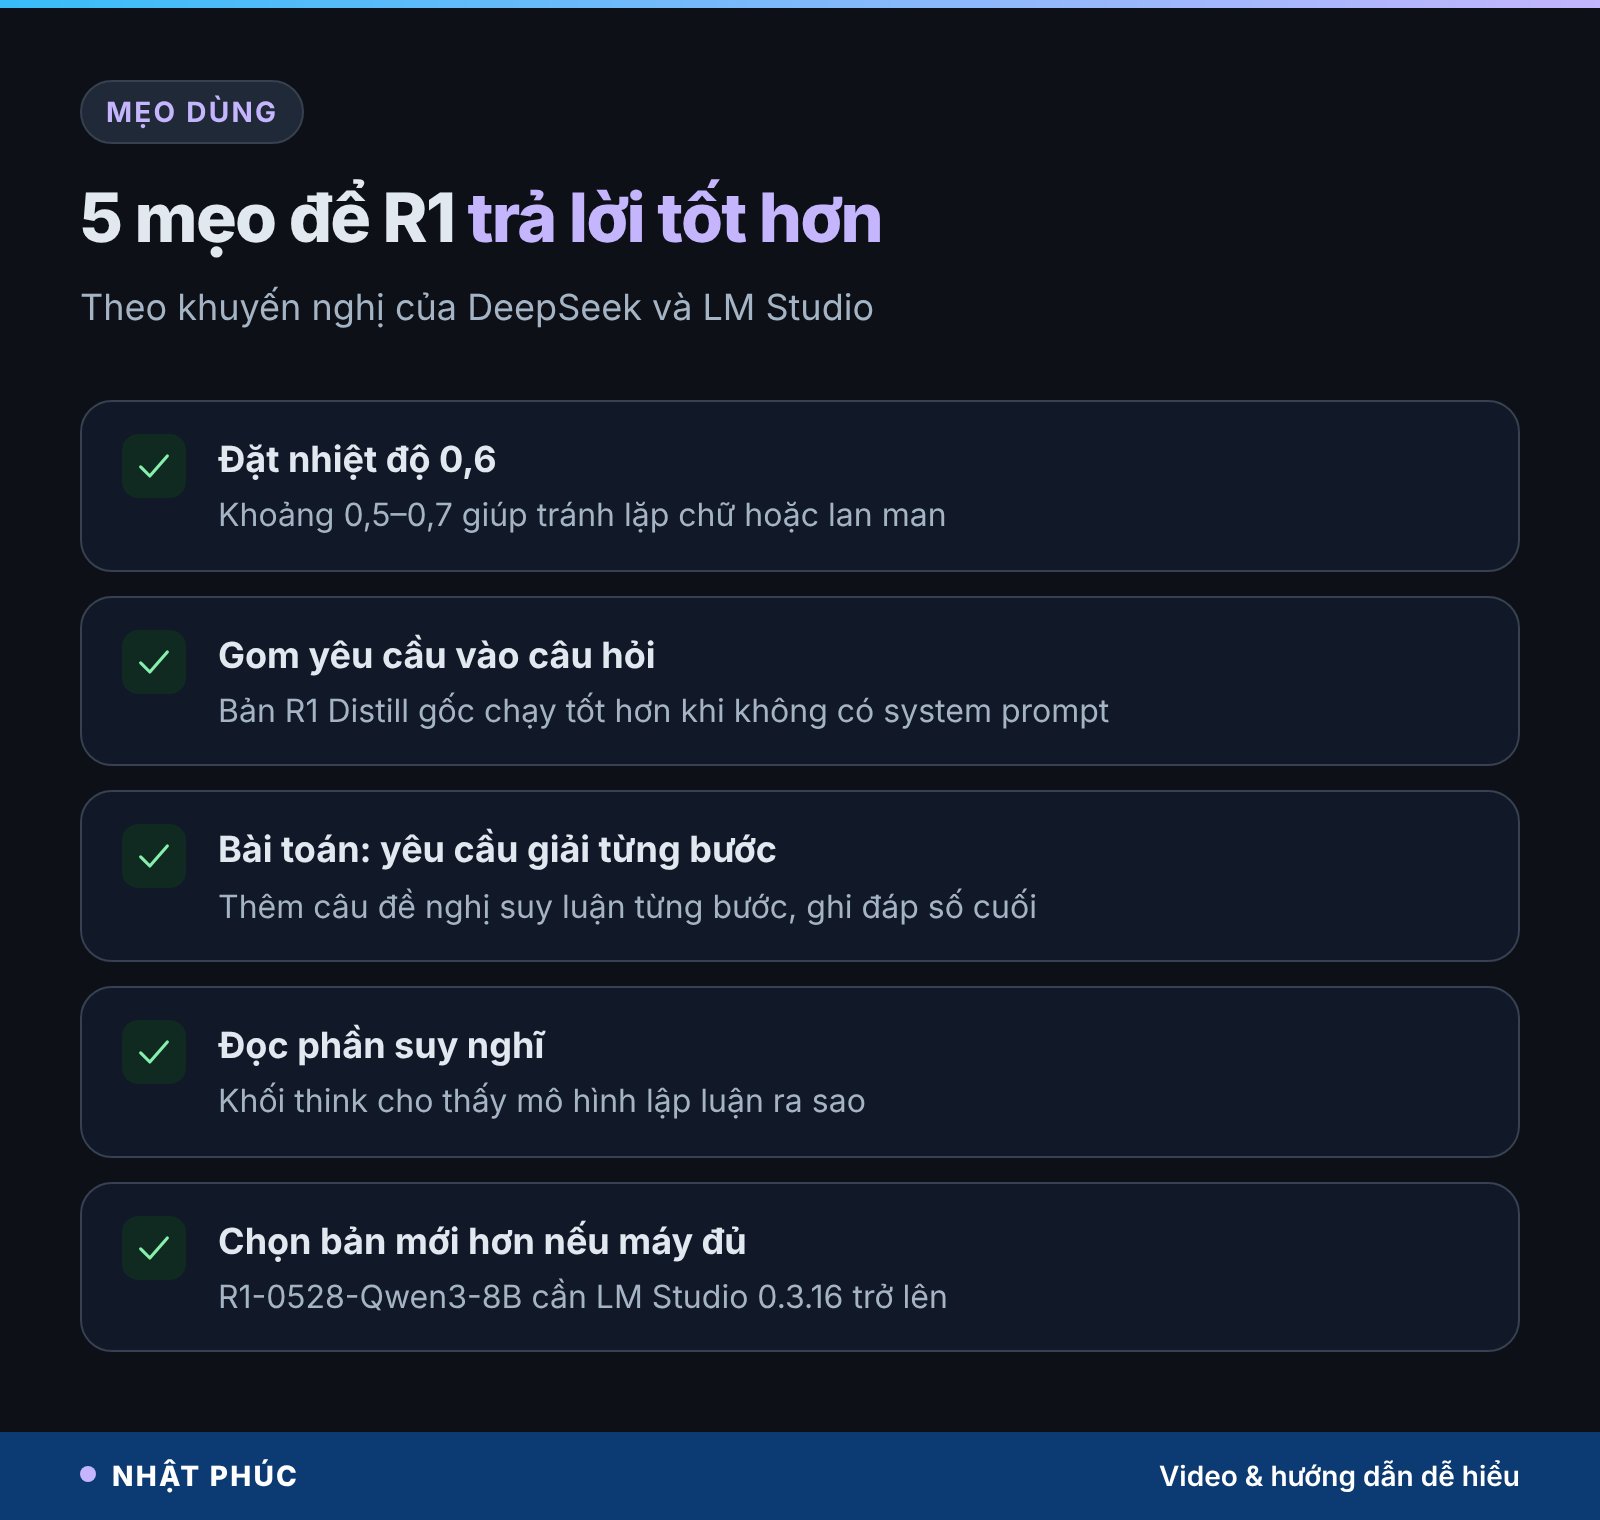
1. Đặt nhiệt độ khoảng 0,6
Nhiệt độ (temperature) điều khiển độ “ngẫu hứng”. DeepSeek khuyên 0,5–0,7, tốt nhất 0,6, để tránh lặp vô tận hoặc lan man. Trong LM Studio, chỉnh ở bảng cài đặt bên phải khung chat.
2. Bỏ system prompt với bản Distill đời đầu
Với các bản R1 Distill gốc, DeepSeek khuyên không dùng system prompt mà gom mọi chỉ dẫn vào câu hỏi. Bản R1-0528-Qwen3-8B thì đã hỗ trợ system prompt.
3. Với bài toán, yêu cầu giải từng bước
Thêm câu như “Hãy suy luận từng bước và ghi đáp số cuối cùng” để mô hình trình bày rõ ràng, dễ kiểm tra.
4. Kiểm tra phần suy nghĩ
Đọc lướt khối suy luận giúp bạn phát hiện chỗ mô hình hiểu sai đề trước khi tin vào kết quả.
5. Thử bản mới nếu máy đủ sức
Nếu máy có 16 GB RAM, bản R1-0528-Qwen3-8B thường là lựa chọn tốt hơn bản 7B đời đầu.
Câu hỏi thường gặp
Cài DeepSeek R1 trên máy tính có mất phí không?
Không. Các bản R1 Distill được phát hành công khai, bản R1 gốc theo giấy phép MIT, còn LM Studio miễn phí cho cả cá nhân và doanh nghiệp từ tháng 7/2025. Chi phí duy nhất là dung lượng ổ cứng và điện năng khi máy chạy mô hình.
Máy 8 GB RAM có chạy được không?
Có thể, nhưng nên chọn bản nhỏ như Qwen 1,5B hoặc bản 7–8B ở mức nén thấp, và đóng bớt trình duyệt. LM Studio khuyên dùng từ 16 GB RAM để trải nghiệm mượt; trên Mac 8 GB vẫn chạy được với mô hình nhỏ và ngữ cảnh ngắn.
Chạy offline có an toàn dữ liệu hơn không?
Có, vì câu hỏi và tài liệu được xử lý ngay trên máy, không gửi lên máy chủ nào. Tuy vậy, bạn vẫn nên tải mô hình từ nguồn chính thức, cập nhật ứng dụng, và không coi câu trả lời là chính xác tuyệt đối.
DeepSeek R1 trên máy có trả lời tiếng Việt tốt không?
Ở mức dùng được. Bản dựa trên Qwen3 xử lý tiếng Việt tốt hơn bản dựa trên Qwen 2.5 Math. Phần suy nghĩ có thể bằng tiếng Anh; hãy yêu cầu rõ “trả lời bằng tiếng Việt” để kết quả gọn gàng.
Có cách nào khác ngoài LM Studio?
Có. Bạn có thể dùng các công cụ chạy mô hình cục bộ khác như Ollama, hoặc với Copilot+ PC thì dùng AI Toolkit trong VS Code của Microsoft. LM Studio được chọn trong bài vì có giao diện đồ họa, dễ cho người mới.
Kết luận
Cài DeepSeek R1 trên máy tính không còn là việc của dân chuyên. Với LM Studio, một chiếc PC 16 GB RAM và khoảng 5 GB trống, bạn đã có một trợ lý biết suy luận chạy hoàn toàn offline. Điều cần nhớ là đây là mô hình nhỏ được R1 dạy lại: rất hợp để học, nháp và xử lý tài liệu riêng tư, nhưng việc quan trọng vẫn cần bạn kiểm chứng.
Bạn đã thử chạy AI trên máy chưa, và máy bạn dùng bản nào thì mượt? Hãy chia sẻ trong phần bình luận, và theo dõi Nhật Phúc để nhận thêm hướng dẫn công nghệ dễ hiểu.