Bạn dạy chó bắt tay bằng miếng thịt khô, không cần giải thích một lời. Robot cũng có thể học kiểu đó, nhưng có một vấn đề: chú chó ngã vài lần thì không sao, còn một con robot bốn chân giá hàng chục nghìn đô la ngã hàng triệu lần thì chắc chắn hỏng. Vậy robot tự học bằng cách nào mà không phải đánh đổi như vậy?
Câu trả lời ngắn: Phần lớn robot hiện đại tự học bằng học tăng cường trong mô phỏng: hàng nghìn bản sao ảo cùng thử và sai trên GPU, được chấm điểm sau mỗi hành động, rồi “bộ não” học được mới chuyển sang robot thật. Bước chuyển này gọi là sim-to-real, và mẹo then chốt là cố tình làm thế giới ảo lộn xộn để robot không bị bỡ ngỡ ngoài đời.
Bài viết đi từ ý tưởng phần thưởng đến những chi tiết ít người biết: vì sao mô phỏng luôn khác thực tế, kỹ thuật ngẫu nhiên hóa giúp vượt khoảng cách ấy ra sao, các ví dụ thật như bàn tay robot giải Rubik hay robot bốn chân học đi trong 20 phút, và cách bạn tự thử ngay trên máy tính.
Nền tảng của mọi thứ ở đây là học tăng cường. Nếu chưa rõ khái niệm này, hãy xem video Học tăng cường là gì trên kênh Vọc Sĩ: hơn 3 phút, giải thích bằng ví dụ chú chó và em bé tập xe đạp, và kết thúc đúng ở câu hỏi bài này trả lời.
Tóm tắt nhanh
- Robot không thể ngã hàng triệu lần ngoài đời, nên phần lớn việc học diễn ra trong mô phỏng vật lý.
- GPU cho phép hàng nghìn robot ảo luyện tập song song, nhanh hơn thời gian thực rất nhiều.
- Mô phỏng luôn khác thực tế (reality gap): ma sát, độ trễ động cơ, nhiễu cảm biến, ánh sáng.
- Ngẫu nhiên hóa miền (domain randomization) buộc robot quen với nhiều “thế giới” khác nhau, nên thế giới thật chỉ là thêm một biến thể.
- Thiết kế phần thưởng sai thì robot “lách luật”: làm đúng điều được chấm, không phải điều ta muốn.
Nội dung chính:
- Vì sao robot không học bằng cách ngã ngoài đời?
- Học tăng cường cho robot: ba nhân vật và bảng điểm
- Mô phỏng vật lý: phòng tập ảo của robot
- Khoảng cách mô phỏng và thực tế
- Năm cách vượt khoảng cách sim-to-real
- Ví dụ thật: bàn tay giải Rubik và robot bốn chân
- So sánh các cách dạy robot
- Rủi ro: lách luật phần thưởng và an toàn
- Hiểu lầm phổ biến
- Tự thử robot học trong mô phỏng
- Câu hỏi thường gặp
Vì sao robot không tự học bằng cách ngã ngoài đời thật?
Trong video, chương trình AI chơi hàng triệu ván cờ để tiến bộ. Với phần mềm, một ván thua chẳng tốn gì ngoài điện. Robot thì khác hẳn: mỗi lần “thua” là một cú ngã thật, một khớp động cơ quá nhiệt, một lần va vào tường.
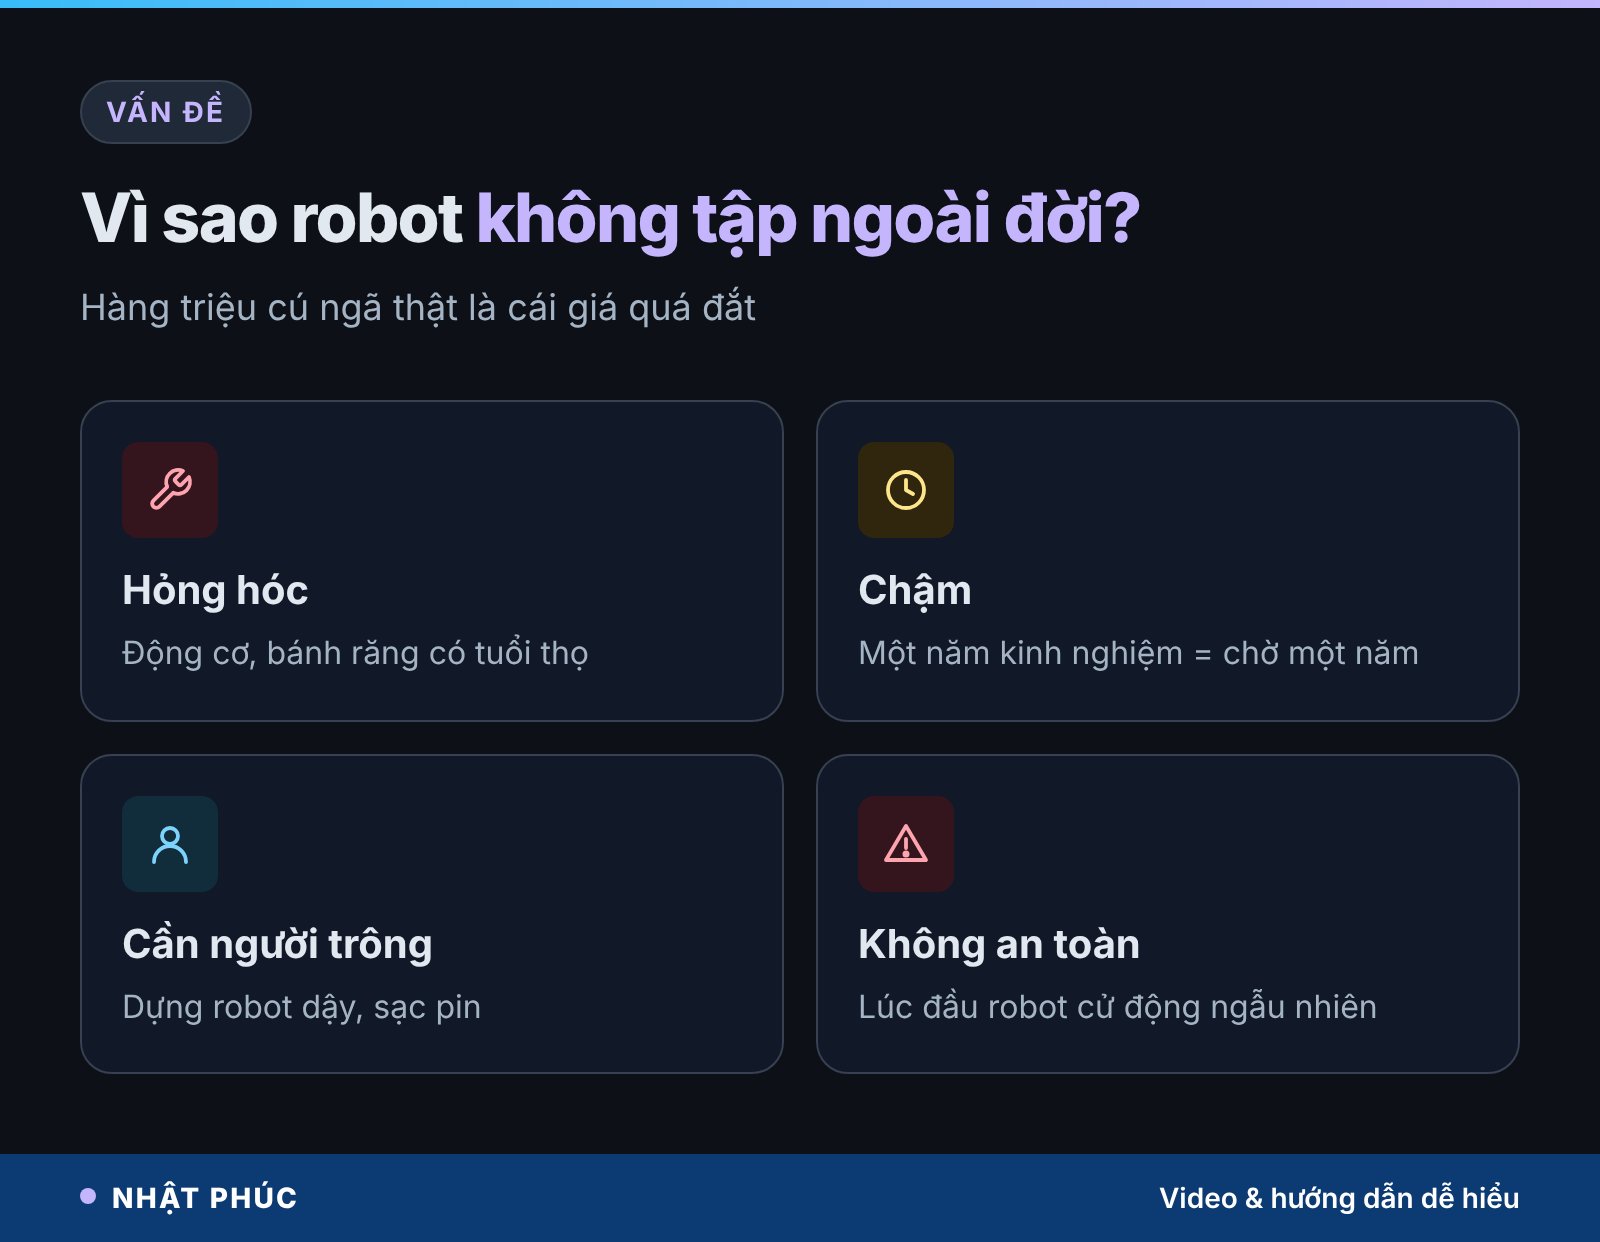
Có bốn rào cản lớn khiến học thử–sai trực tiếp ngoài đời gần như bất khả thi:
- Hỏng hóc: bánh răng, động cơ, cảm biến đều có tuổi thọ. Hàng triệu cú ngã là hàng chục lần thay linh kiện.
- Chậm: đời thật chạy đúng một giây mỗi giây. Muốn có “một năm kinh nghiệm” thì phải chờ một năm, liên tục không nghỉ.
- Cần người trông: robot ngã phải có người dựng dậy, đặt lại vị trí, sạc pin.
- An toàn: lúc đầu robot hành động gần như ngẫu nhiên. Một cánh tay công nghiệp vung ngẫu nhiên có thể gây nguy hiểm cho người đứng cạnh.
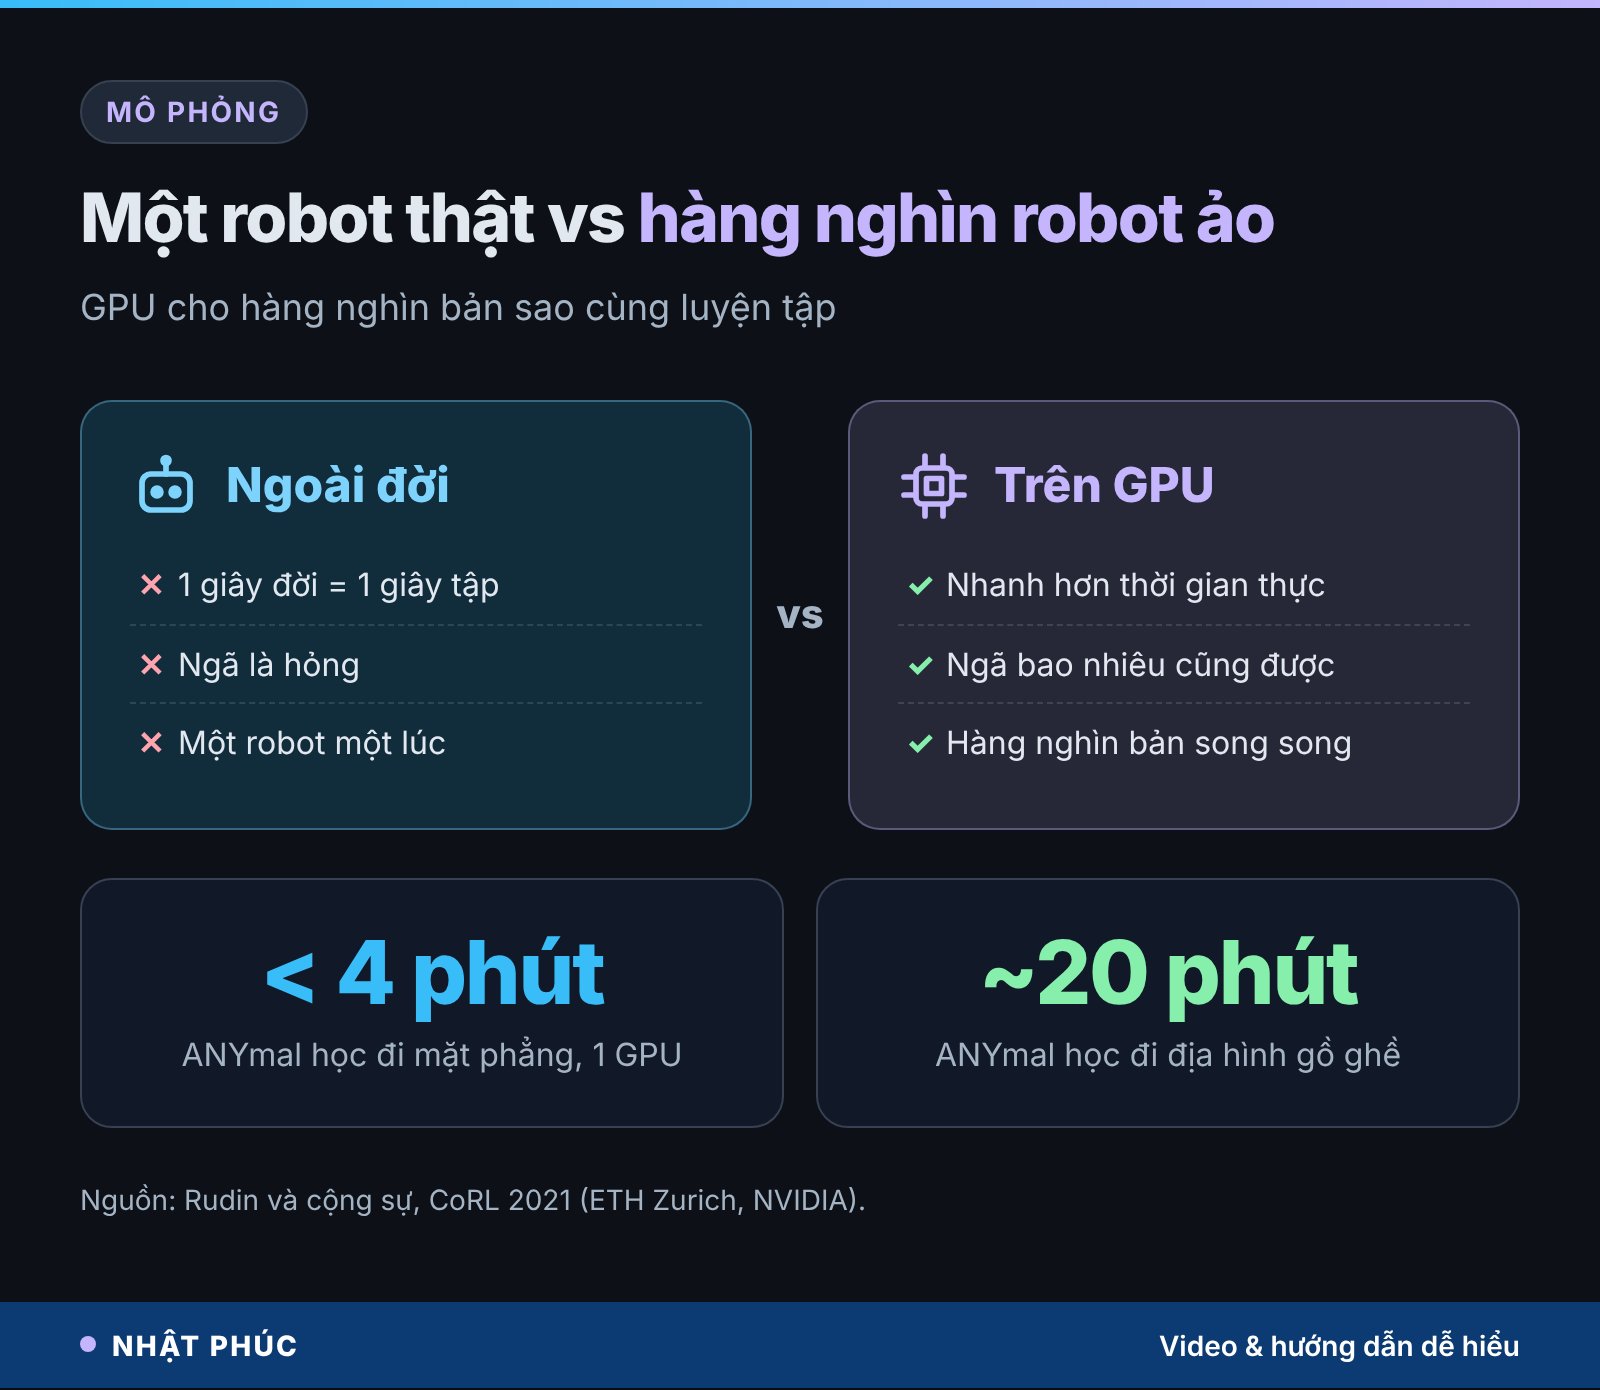
Giải pháp là cho robot luyện tập trong một thế giới ảo mô phỏng định luật vật lý, nơi ngã bao nhiêu lần cũng được, chạy nhanh hơn thời gian thực, và có thể nhân bản robot thành hàng nghìn bản cùng tập.
Học tăng cường cho robot: ba nhân vật và một bảng điểm
Như video giải thích, học tăng cường (reinforcement learning) có ba nhân vật: tác nhân, môi trường và phần thưởng. Với một robot chó học đi, chúng trông như sau:
- Tác nhân: mạng nơ-ron điều khiển, nhận dữ liệu cảm biến (góc khớp, gia tốc, hướng thân) và xuất ra lệnh cho từng động cơ, nhiều chục lần mỗi giây.
- Môi trường: thân robot cùng mặt đất, dốc, bậc thang, trọng lực.
- Phần thưởng: một con số cộng trừ sau mỗi bước điều khiển.
Điều thú vị là phần thưởng hiếm khi chỉ có một mục. Kỹ sư thường cộng nhiều thành phần lại với nhau, mỗi thành phần có trọng số riêng. Đây là phần “nghệ thuật” khó nhất: chấm sai một chút là robot học ra dáng đi kỳ quặc.
| Thành phần | Cộng hay trừ | Mục đích |
|---|---|---|
| Đi đúng vận tốc được yêu cầu | Cộng | Mục tiêu chính |
| Thân bị nghiêng, lắc mạnh | Trừ | Giữ thăng bằng |
| Lực động cơ quá lớn | Trừ | Tiết kiệm pin, bảo vệ khớp |
| Lệnh thay đổi giật cục | Trừ | Chuyển động mượt |
| Thân hoặc đầu gối chạm đất | Trừ mạnh, kết thúc lượt | Tránh ngã |
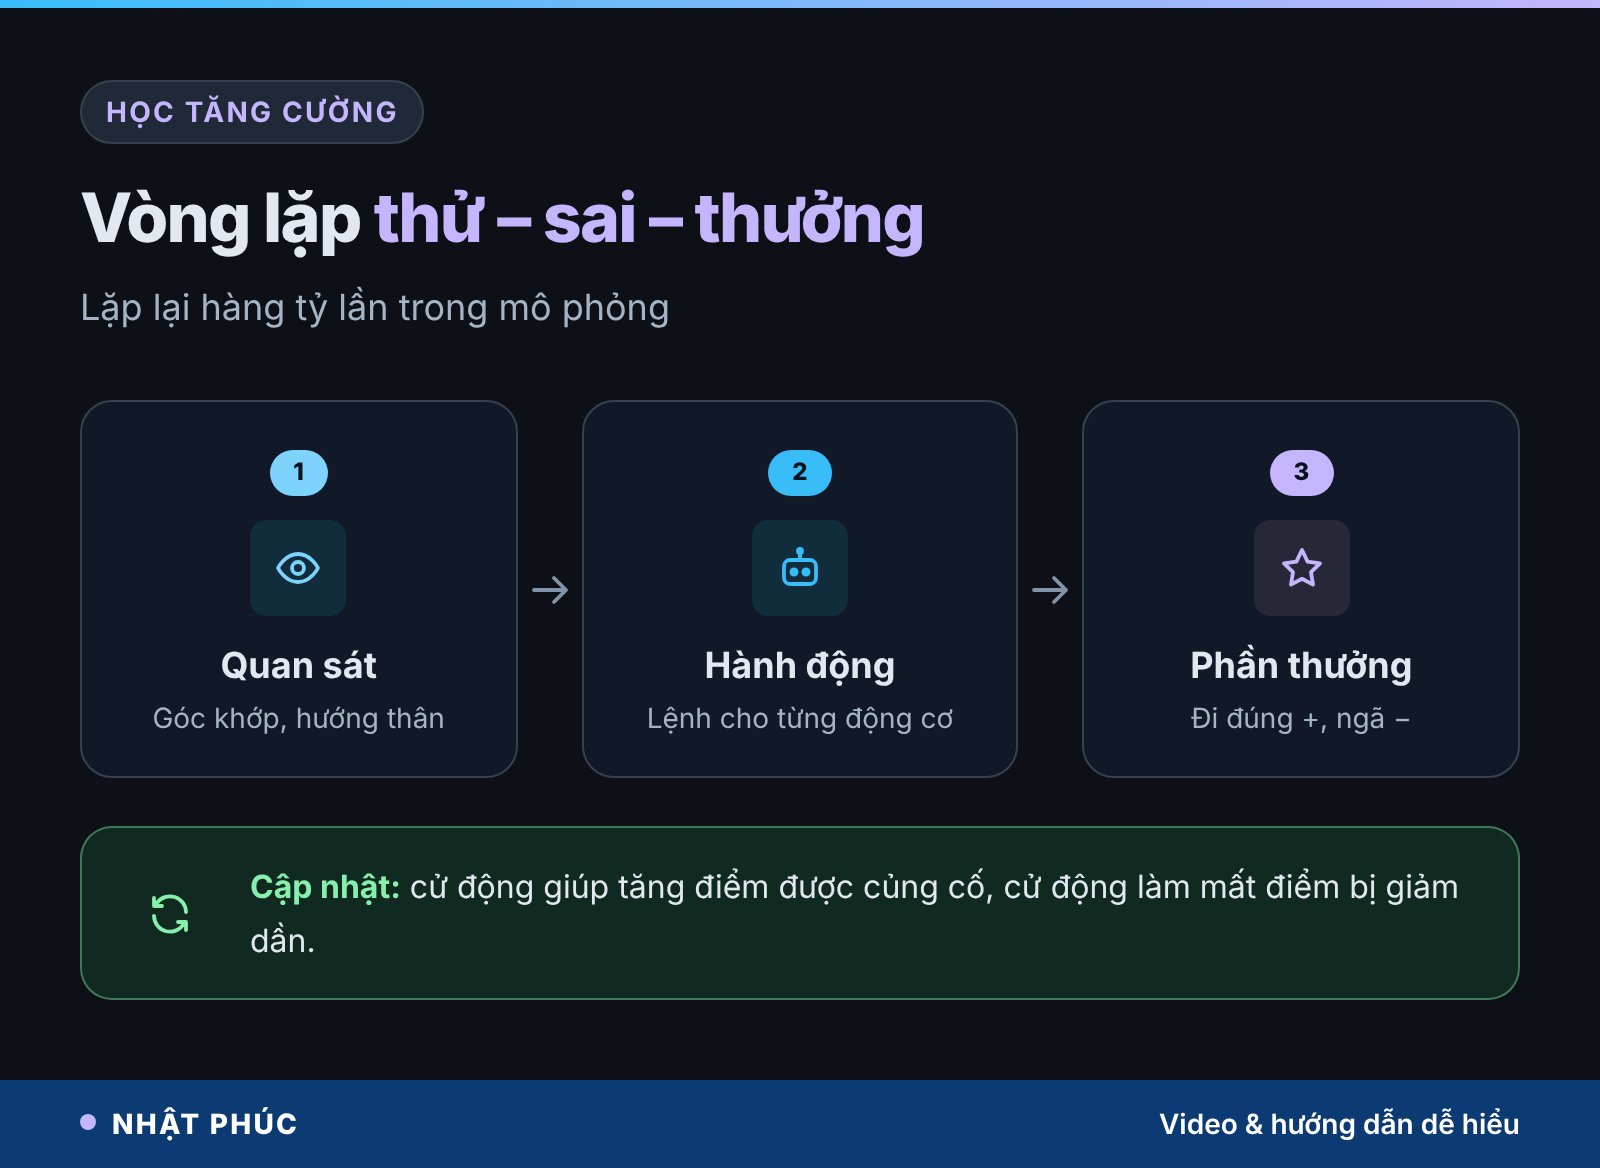
Ban đầu robot ảo co giật vô định. Sau vài triệu bước, những cử động giúp tăng điểm được củng cố, và một dáng đi dần thành hình. Cũng giống AlphaGo trong bài AI chơi cờ, không ai dạy robot “đặt chân trái trước”. Nó tự tìm ra cách đi tối ưu cho bảng điểm được giao.
Mô phỏng vật lý: phòng tập ảo của robot
Phần mềm mô phỏng (physics simulator) là một chương trình tính xem mọi vật thể sẽ chuyển động thế nào dưới tác dụng của lực, trọng lực, va chạm và ma sát, từng phần nhỏ của giây. Bạn có thể hình dung nó như một trò chơi điện tử cực kỳ nghiêm túc về vật lý, chỉ thiếu đồ họa đẹp.
Những phần mềm mô phỏng phổ biến
- MuJoCo: nổi tiếng trong nghiên cứu học tăng cường; DeepMind mua lại cuối năm 2021 và mở mã nguồn miễn phí năm 2022.
- NVIDIA Isaac Sim và Isaac Lab: chạy mô phỏng trực tiếp trên GPU, hợp với việc tập hàng nghìn robot cùng lúc.
- Gazebo: mã nguồn mở, gắn bó lâu năm với hệ sinh thái ROS (hệ điều hành phổ biến cho robot).
- PyBullet: nhẹ, dễ cài, hay dùng cho học tập và thử nghiệm nhanh.
Sức mạnh thật nằm ở GPU
Một con robot ảo đã nhanh hơn đời thật. Nhưng bước nhảy lớn đến khi người ta chạy hàng nghìn robot ảo song song trên một GPU, mỗi con thử một kiểu khác nhau, cùng đóng góp kinh nghiệm cho một “bộ não” chung. Nếu bạn tò mò vì sao GPU giỏi việc này, bài GPU là gì giải thích chi tiết.
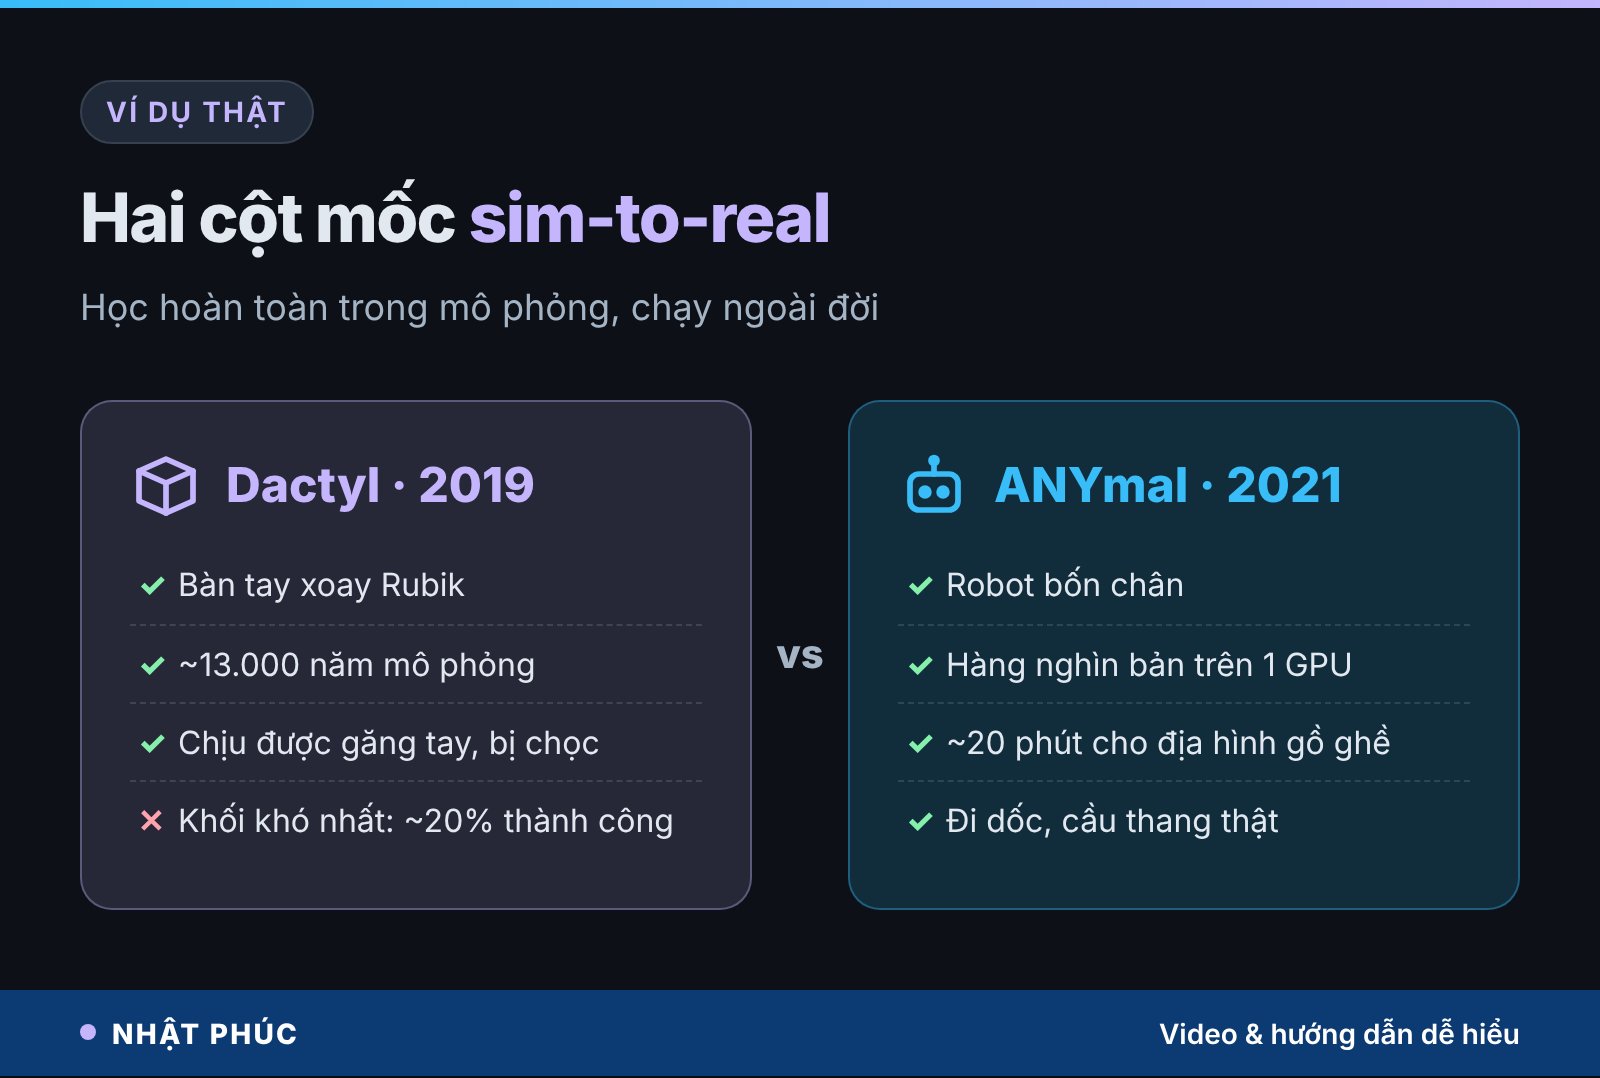
Một ví dụ cụ thể: năm 2021, nhóm nghiên cứu tại ETH Zurich cùng NVIDIA công bố công trình dạy robot bốn chân ANYmal đi bằng hàng nghìn bản sao ảo trên một GPU máy trạm. Theo bài báo trình bày tại hội nghị CoRL, chính sách đi trên mặt phẳng học xong trong dưới 4 phút, còn trên địa hình gồ ghề mất khoảng 20 phút.
Khoảng cách mô phỏng và thực tế (reality gap) là gì?
Đây chính là câu kết của video: khoảng cách giữa mô phỏng và thực tế vẫn chưa được giải xong. Không phần mềm nào chép hoàn hảo được thế giới. Một robot học quá “khớp” với thế giới ảo sẽ lúng túng khi ra ngoài, giống học sinh chỉ luyện đúng một bộ đề rồi đi thi gặp đề khác.
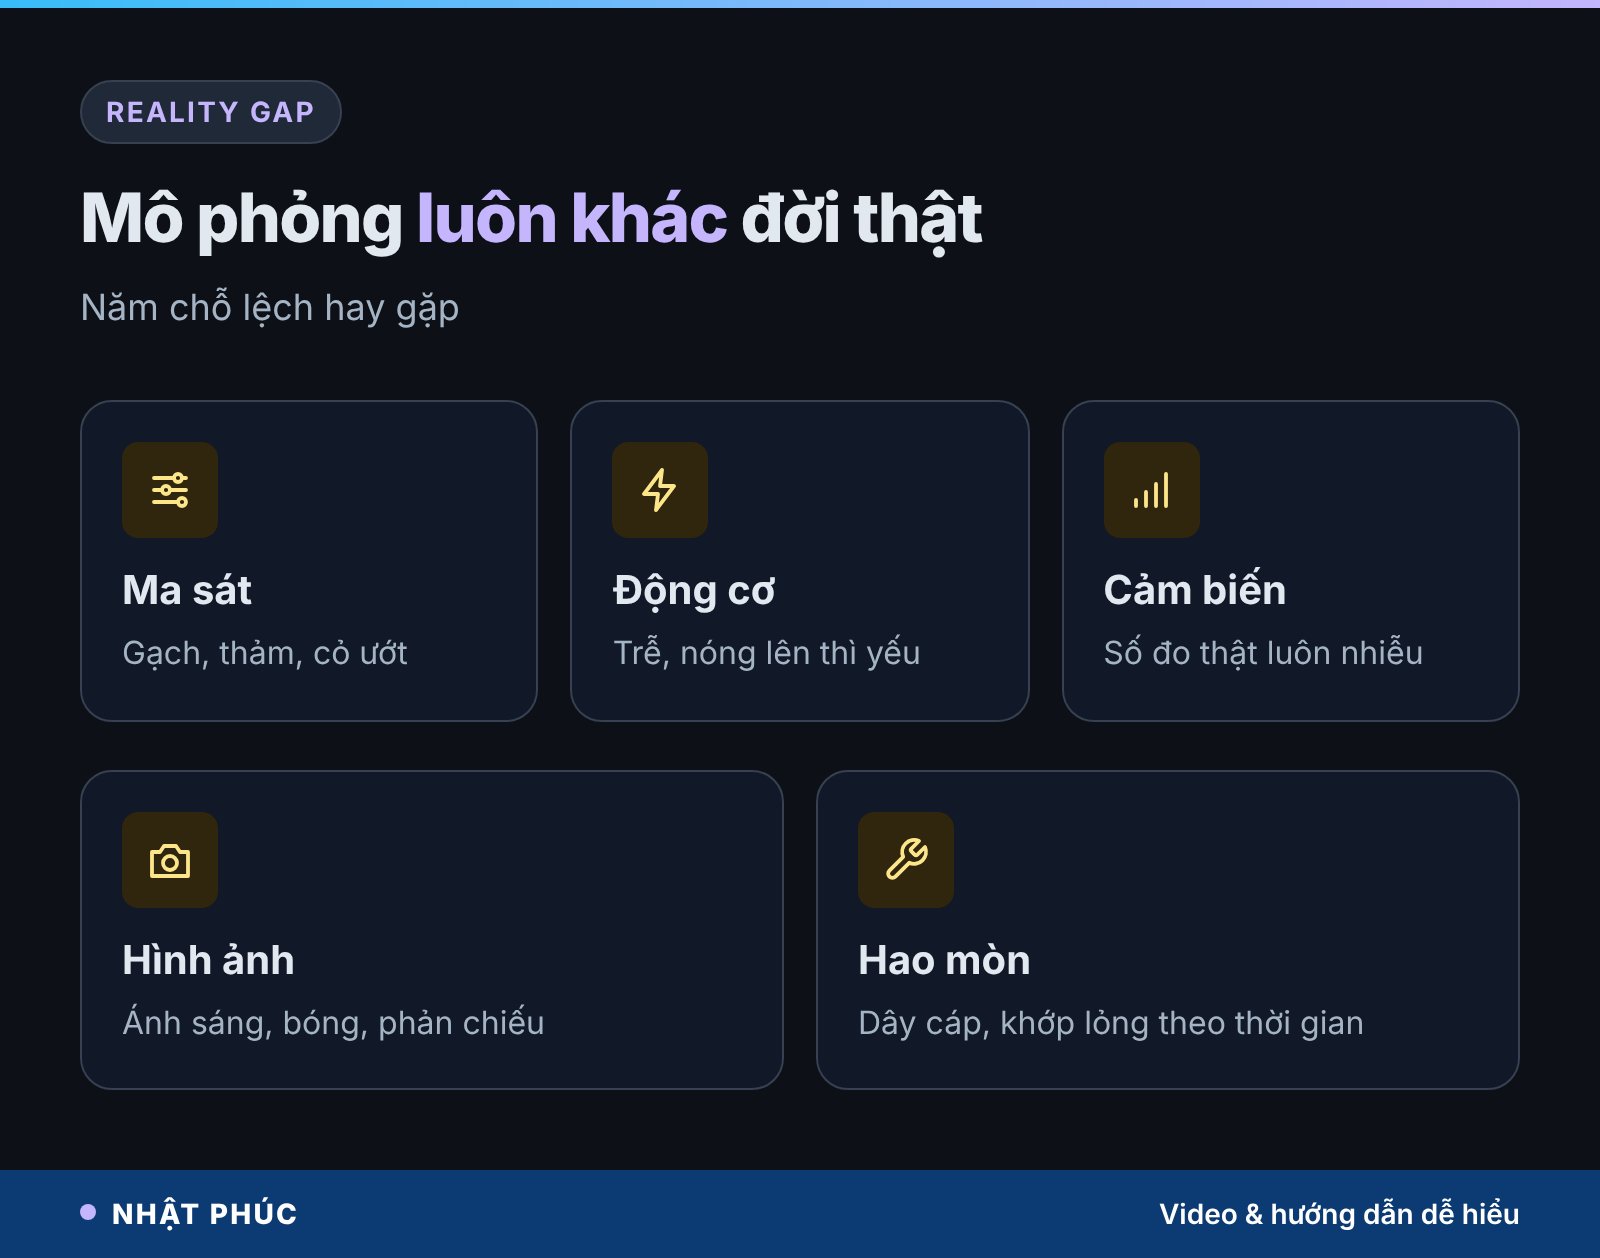
Những chỗ thế giới ảo thường lệch với đời thật:
- Ma sát và mặt đất: sàn gạch, thảm, cỏ ướt, sỏi đều khác nhau, và khác cả con số trong phần mềm.
- Động cơ: động cơ thật có độ trễ, nóng lên thì yếu đi, mỗi chiếc lệch nhau đôi chút.
- Cảm biến: số đo thật luôn có nhiễu, thỉnh thoảng mất tín hiệu; mô phỏng thì sạch sẽ tuyệt đối.
- Hình ảnh: ánh sáng, bóng đổ, phản chiếu, vết bẩn trên camera khó mô phỏng giống thật.
- Khối lượng và hao mòn: robot thật có dây cáp, pin, vỏ bị trầy, khớp lỏng theo thời gian.
Năm cách vượt khoảng cách sim-to-real
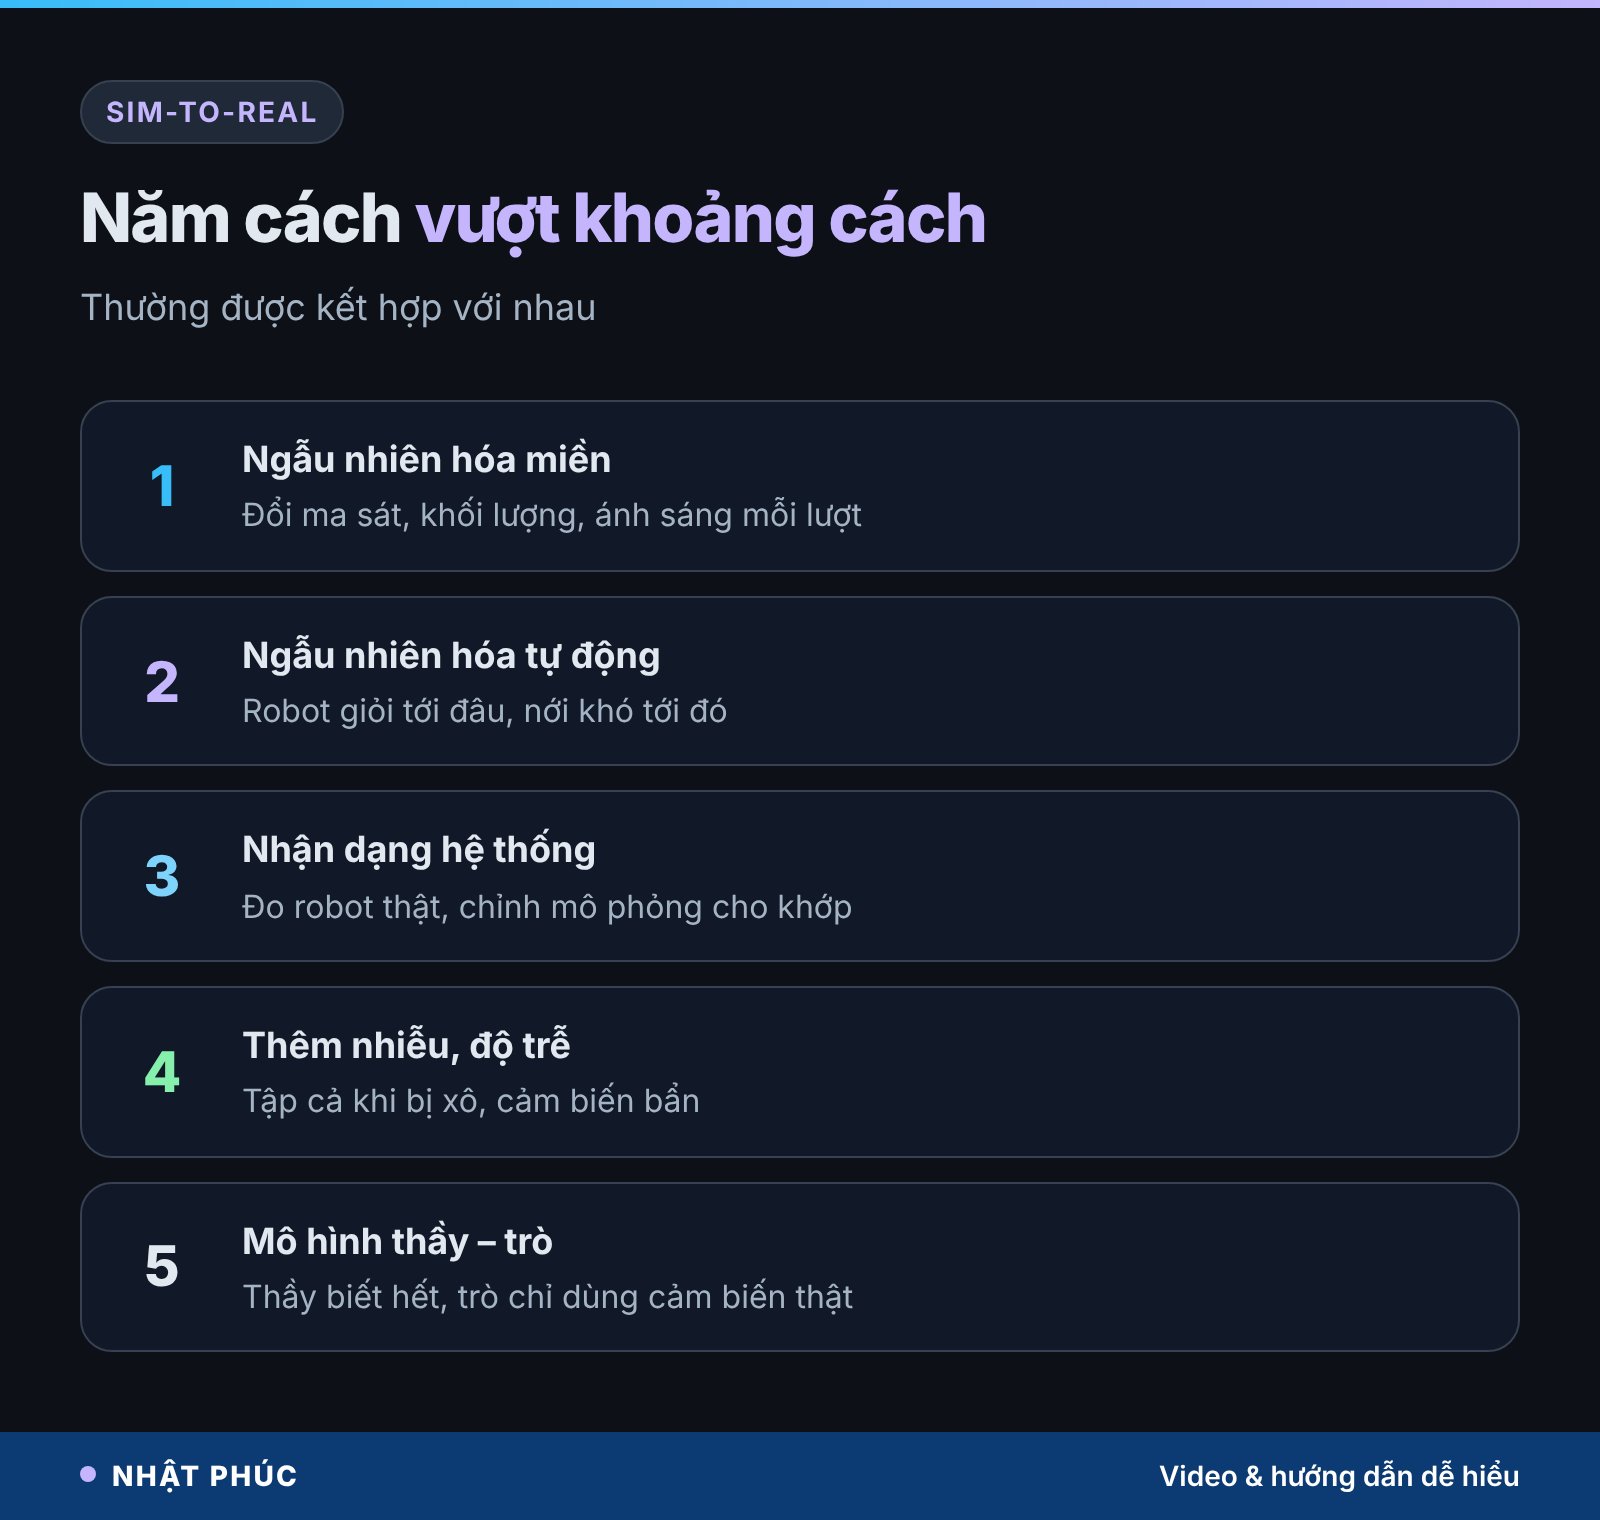
Sim-to-real (từ mô phỏng sang thực tế) là tên gọi chung cho các kỹ thuật giúp thứ học trong thế giới ảo dùng được ngoài đời. Dưới đây là năm cách phổ biến, thường được kết hợp với nhau.
1. Ngẫu nhiên hóa miền (domain randomization)
Thay vì cố làm mô phỏng giống thật tuyệt đối, người ta cố tình làm nó lộn xộn: mỗi lượt tập đổi ngẫu nhiên ma sát, khối lượng, màu sắc, ánh sáng, độ trễ. Robot quen sống trong hàng nghìn thế giới hơi khác nhau, nên thế giới thật chỉ là thêm một biến thể. Ý tưởng này được nhóm của Josh Tobin và Pieter Abbeel công bố năm 2017 cho bài toán nhận diện vật thể bằng ảnh mô phỏng.
2. Ngẫu nhiên hóa tự động (ADR)
Một phiên bản nâng cao: bắt đầu với thế giới dễ, robot giỏi lên tới đâu thì phạm vi ngẫu nhiên nới rộng tới đó, như giáo viên tăng dần độ khó bài tập.
3. Nhận dạng hệ thống (system identification)
Đo kỹ robot thật (khối lượng từng chi, đặc tính động cơ) rồi chỉnh mô phỏng cho khớp. Có nhóm còn huấn luyện một mạng nơ-ron riêng để bắt chước đúng phản ứng của động cơ thật.
4. Thêm nhiễu và độ trễ
Cố tình làm bẩn dữ liệu cảm biến ảo, chèn độ trễ vào lệnh điều khiển, thỉnh thoảng đẩy robot một cái. Robot học được cách bình tĩnh khi bị xô.
5. Mô hình thầy – trò
Trong mô phỏng, một “thầy” được biết mọi thứ (ma sát chính xác, độ cao địa hình). Sau đó một “trò” chỉ dùng cảm biến thật học bắt chước thầy. Ra đời thật, chỉ trò đi theo robot, nhưng đã thừa hưởng kinh nghiệm của thầy.
Ví dụ thật: bàn tay giải Rubik và robot bốn chân
Bàn tay robot giải Rubik (OpenAI, 2019)
Tháng 10/2019, OpenAI công bố bàn tay robot năm ngón Dactyl xoay khối Rubik bằng một tay. Phần “giải” (chọn chuỗi bước xoay) dùng thuật toán có sẵn; phần khó là điều khiển ngón tay để xoay khối thật, việc được học hoàn toàn trong mô phỏng bằng ngẫu nhiên hóa tự động. Tổng kinh nghiệm mô phỏng được ước tính khoảng 13.000 năm.
Ngoài đời, bàn tay vẫn làm được khi bị buộc hai ngón, đeo găng tay, hay bị thú nhồi bông chọc vào khối Rubik, những tình huống chưa từng có trong lúc tập. Dù vậy, tỷ lệ thành công với các khối bị xáo trộn khó nhất chỉ khoảng 20% đến hết bài, cho thấy sim-to-real vẫn còn xa mới hoàn hảo.
Robot bốn chân học đi trong vài phút
Robot ANYmal của ETH Zurich là ví dụ kinh điển của việc học đi trong mô phỏng rồi đem ra địa hình thật: dốc, cầu thang, đất trơn. Như đã nhắc, với hàng nghìn bản sao trên GPU, thời gian tập rút từ nhiều ngày xuống còn khoảng 20 phút cho địa hình gồ ghề.
Ngoài phòng thí nghiệm, mô phỏng còn được dùng rộng rãi cho xe tự lái (thử hàng triệu tình huống hiếm như người băng qua đường bất ngờ), cánh tay gắp hàng trong kho, và các robot hình người đang được nhiều công ty phát triển.
So sánh các cách dạy robot: lập trình, bắt chước, tự học
Học tăng cường trong mô phỏng không phải cách duy nhất. Trong thực tế, kỹ sư chọn hoặc kết hợp nhiều cách tùy nhiệm vụ.
| Cách dạy | Hợp với | Điểm mạnh | Điểm yếu |
|---|---|---|---|
| Lập trình từng bước | Dây chuyền lặp lại, môi trường cố định | Dễ kiểm soát, dễ kiểm tra | Gặp tình huống lạ là lúng túng |
| Học bắt chước | Thao tác tay khéo léo, gấp đồ, dọn bàn | Học nhanh từ người điều khiển mẫu | Tốn công thu dữ liệu, khó vượt người dạy |
| Học tăng cường trong mô phỏng | Đi, chạy, giữ thăng bằng, xoay vật | Tự tìm ra cách mới, luyện vô hạn | Khó thiết kế phần thưởng, vướng reality gap |
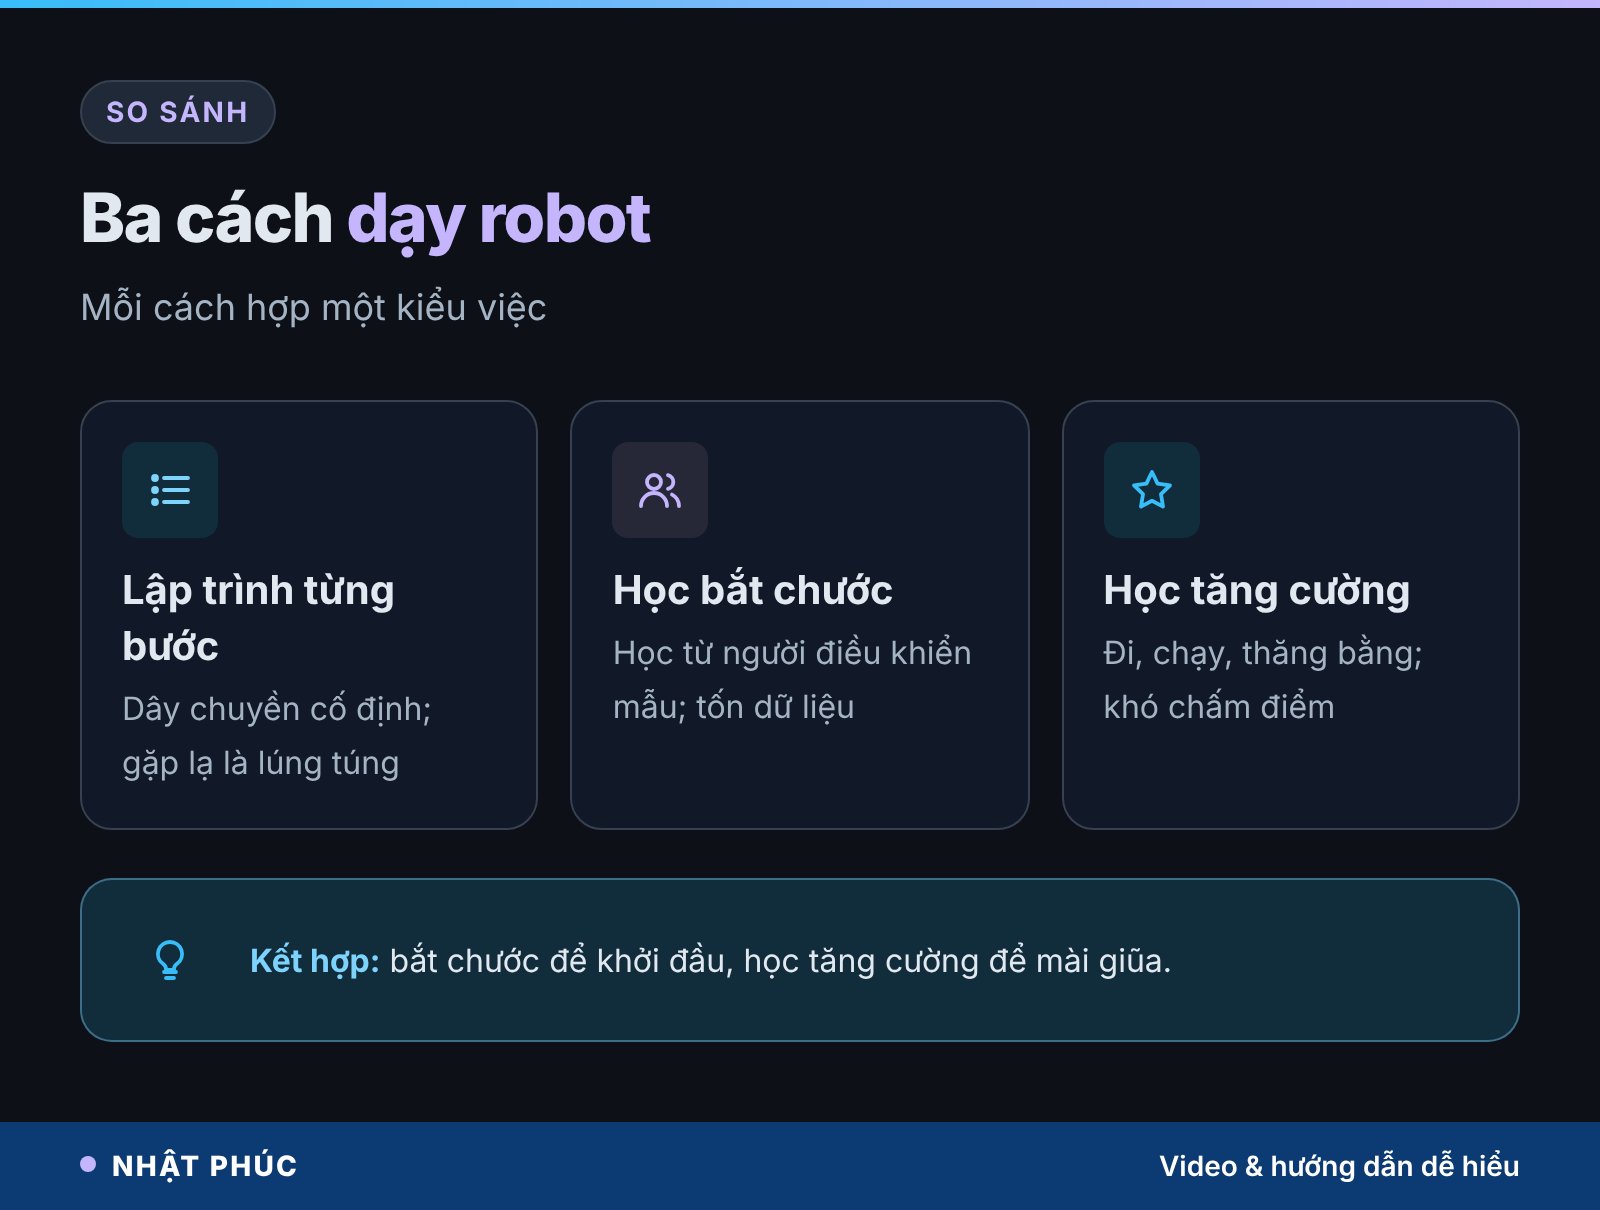
Học bắt chước (imitation learning) thường dùng dữ liệu từ người điều khiển robot từ xa, rồi máy học theo, giống dạng học có giám sát trong bài học máy là gì. Nhiều hệ thống hiện nay dùng bắt chước để có điểm khởi đầu, rồi học tăng cường để mài giũa thêm.
Rủi ro: robot lách luật phần thưởng và chuyện an toàn
Video kể ví dụ AI chơi đua thuyền quay vòng tại chỗ để gom điểm thay vì về đích. Hiện tượng này gọi là lách luật phần thưởng (reward hacking), và với robot nó không chỉ buồn cười mà còn có thể gây hại.
Một số kiểu “lách luật” hay gặp khi tập robot trong mô phỏng (mô tả dạng tình huống minh họa):
- Khai thác lỗi mô phỏng: robot phát hiện một chỗ va chạm tính sai và “bay” lên để tiến nhanh hơn. Ra đời thật, mẹo đó không tồn tại.
- Dáng đi kỳ quặc: chỉ thưởng tốc độ mà quên phạt rung lắc, robot có thể nhảy cóc hoặc kéo lê chân, đạt điểm cao nhưng nhanh hỏng khớp.
- Bỏ qua điều không được chấm: không phạt va chạm thì robot không có lý do tránh đồ vật xung quanh.
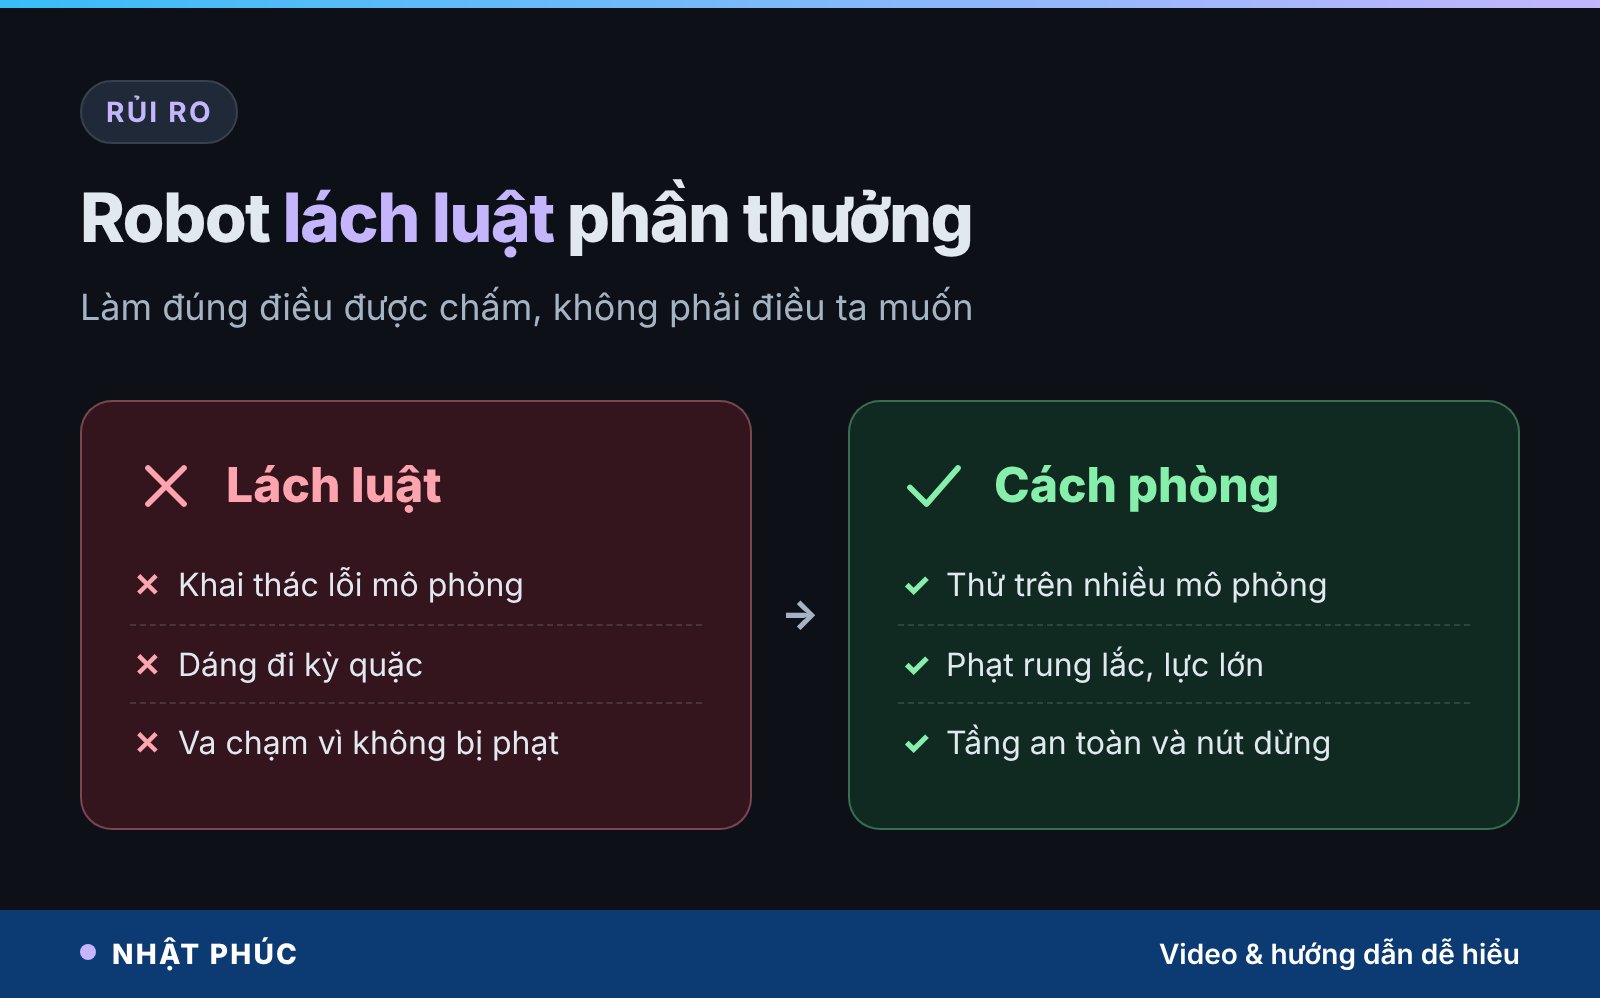
Vì vậy, trước khi đưa ra đời thật, kỹ sư luôn kiểm tra chính sách trong nhiều mô phỏng khác nhau, giới hạn lực và tốc độ ở tầng phần mềm an toàn riêng, có nút dừng khẩn cấp, và thử nghiệm trong khu vực có rào chắn. Bộ não học được là một mạng nơ-ron khó giải thích, nên lớp an toàn bên ngoài là bắt buộc.
Hiểu lầm phổ biến về robot tự học
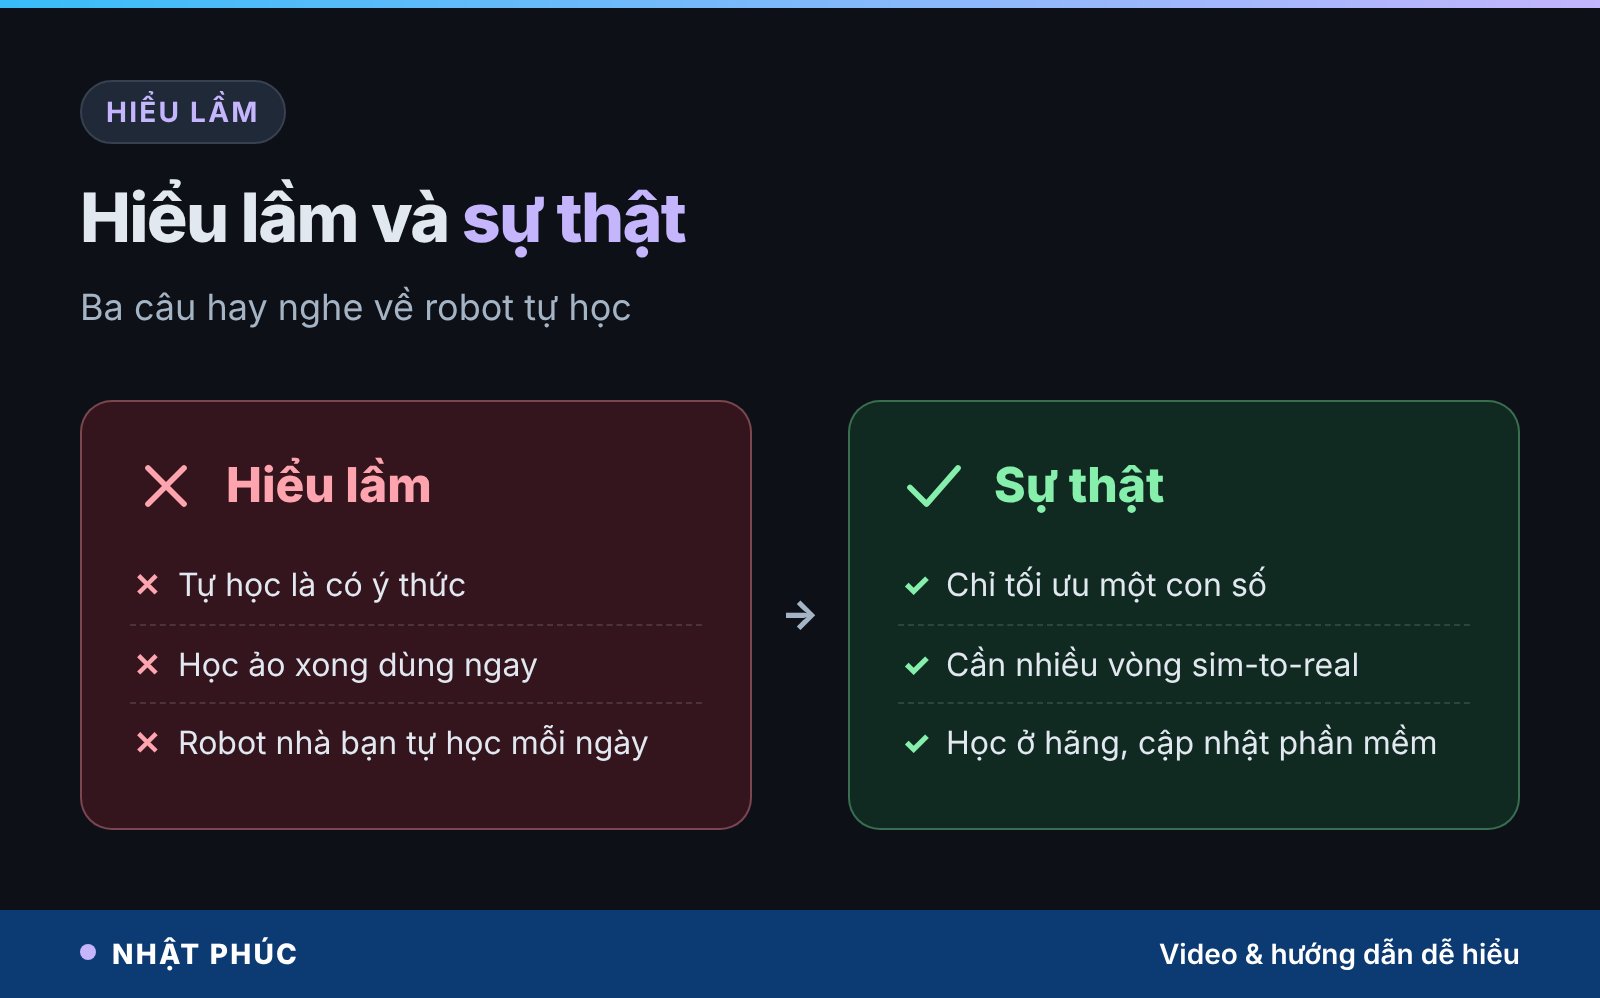
“Robot tự học nghĩa là robot có ý thức”
Không. Robot chỉ tối ưu một con số do con người đặt ra. Nó không hiểu mình đang đi, chỉ biết chuỗi lệnh nào làm điểm tăng.
“Học trong mô phỏng xong là dùng ngay ngoài đời”
Hiếm khi suôn sẻ. Gần như luôn cần ngẫu nhiên hóa, chỉnh mô phỏng và thử nghiệm thật nhiều vòng trước khi robot đi vững.
“Robot ngoài đời đang tự học liên tục mỗi ngày”
Phần lớn robot thương mại dùng một chính sách đã huấn luyện xong và cố định. Việc học thêm thường diễn ra ở trung tâm của nhà sản xuất, rồi cập nhật qua phần mềm, không phải robot tự mày mò trong nhà bạn.
Tự thử robot học trong mô phỏng ngay trên máy tính
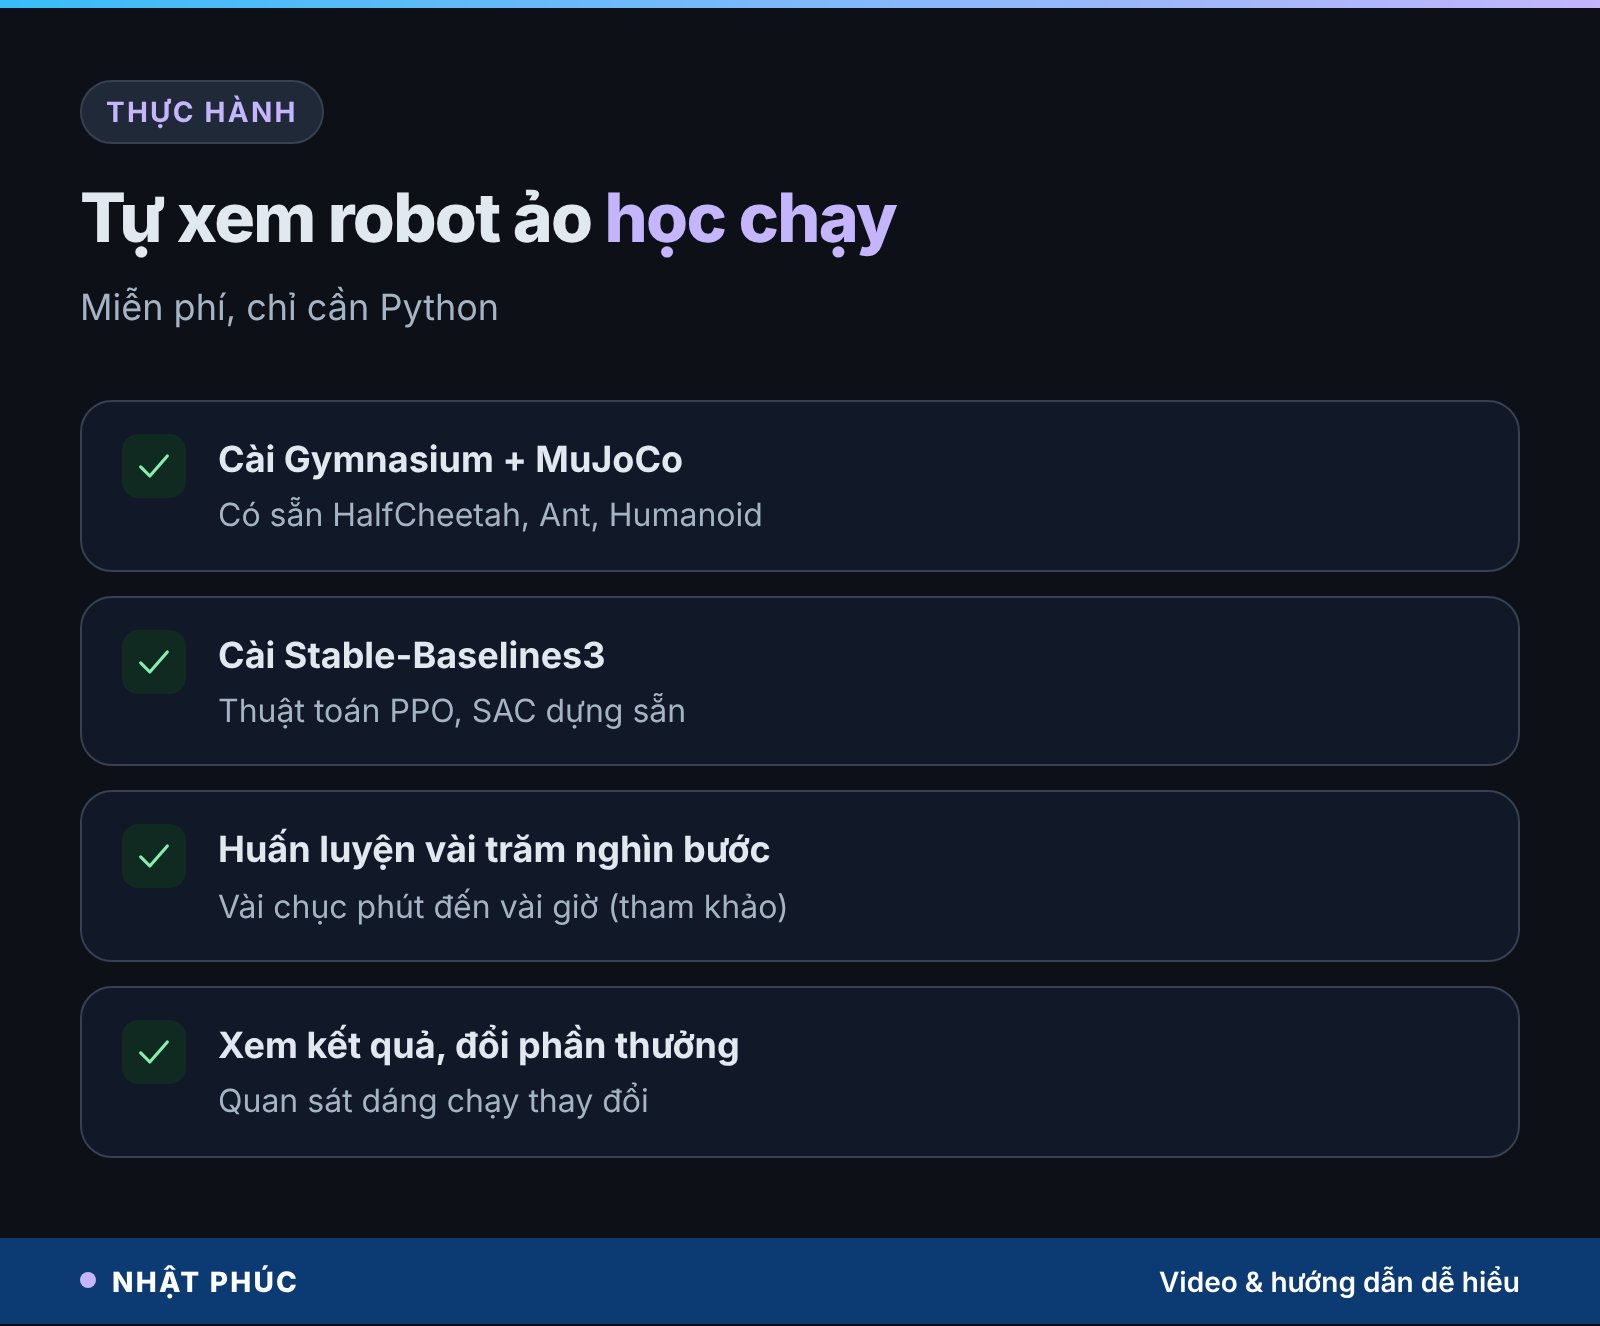
Bạn không cần robot thật để trải nghiệm. Với máy tính có Python, bạn có thể xem một “robot” ảo tự học đi bằng các thư viện miễn phí. Các bước dưới đây dành cho người đã quen cài gói Python cơ bản.
Bước 1: Cài môi trường mô phỏng
Cài thư viện Gymnasium kèm MuJoCo bằng lệnh pip install “gymnasium[mujoco]”. Gymnasium cung cấp sẵn các robot mẫu như HalfCheetah (con báo nửa thân), Ant (robot bốn chân) hay Humanoid.
Bước 2: Cài thuật toán học tăng cường
Cài Stable-Baselines3 bằng pip install stable-baselines3. Thư viện này có sẵn các thuật toán phổ biến như PPO và SAC, chỉ vài dòng lệnh là chạy được.
Bước 3: Huấn luyện thử
Tạo môi trường HalfCheetah-v5, chọn thuật toán SAC hoặc PPO, cho học khoảng vài trăm nghìn bước. Trên máy tính phổ thông, việc này có thể mất từ vài chục phút đến vài giờ tùy cấu hình (thời gian tham khảo).
Bước 4: Xem kết quả và đổi phần thưởng
Mở chế độ hiển thị để xem robot ảo chạy. Sau đó thử sửa phần thưởng, ví dụ bỏ hình phạt tốn năng lượng, và quan sát dáng chạy thay đổi ra sao. Đây là cách dễ nhất để “thấm” chuyện thiết kế phần thưởng.
Câu hỏi thường gặp về robot tự học và sim-to-real
Sim-to-real là gì?
Sim-to-real là quá trình chuyển kỹ năng robot học trong mô phỏng sang robot thật ngoài đời. Vì mô phỏng không bao giờ giống thật hoàn toàn, sim-to-real bao gồm các kỹ thuật như ngẫu nhiên hóa miền, chỉnh mô phỏng theo robot thật và thêm nhiễu để robot không bị bỡ ngỡ khi ra ngoài.
Robot hút bụi nhà tôi có dùng học tăng cường không?
Thường là không theo kiểu tự học trong nhà bạn. Đa số robot hút bụi dùng cảm biến, bản đồ và thuật toán lập lộ trình được lập trình sẵn, có thể kèm AI nhận diện vật cản đã huấn luyện từ trước. Học tăng cường phổ biến hơn ở robot đi bộ, cánh tay khéo léo và nghiên cứu.
Vì sao không làm mô phỏng giống thật 100%?
Vì thế giới quá phức tạp: ma sát thay đổi theo nhiệt độ và độ bẩn, vật liệu mềm biến dạng, động cơ hao mòn. Mô phỏng càng chi tiết càng chậm. Ngẫu nhiên hóa thường hiệu quả hơn việc theo đuổi độ chính xác tuyệt đối.
Học tăng cường có dùng cho xe tự lái không?
Có ở một số khâu, nhưng xe tự lái chủ yếu kết hợp nhiều phương pháp: học từ dữ liệu lái của người, quy tắc an toàn và mô phỏng để thử tình huống hiếm. Mô phỏng đặc biệt có giá trị vì không thể chờ ngoài đời đủ số vụ suýt va chạm để kiểm tra.
Người mới nên bắt đầu học về robot học tăng cường từ đâu?
Nên nắm Python, đại số tuyến tính cơ bản, rồi khái niệm học máy. Sau đó thực hành với Gymnasium và Stable-Baselines3 như phần hướng dẫn ở trên, trước khi chuyển sang mô phỏng robot thật như Isaac Lab hay MuJoCo với mô hình robot thương mại.
Kết luận: phần thưởng đúng, thế giới ảo đủ “lộn xộn”
Robot tự học không phải phép màu. Nó là sự kết hợp của ba thứ: một bảng điểm được thiết kế cẩn thận, một thế giới ảo cho phép ngã hàng triệu lần, và các mẹo sim-to-real để kinh nghiệm ảo dùng được ngoài đời. Khoảng cách giữa mô phỏng và thực tế vẫn chưa khép hẳn, nhưng mỗi năm lại hẹp thêm một chút.
Như câu kết của video: bạn không cần giải thích gì với chú chó, chỉ cần thưởng đúng lúc. Với robot cũng vậy, thêm một điều: hãy cho nó tập trong đủ nhiều thế giới khác nhau.
Bạn muốn robot trong nhà mình tự học được việc gì nhất: gấp quần áo, rửa bát hay dọn đồ chơi? Để lại bình luận và theo dõi kênh Nhật Phúc để đón các bài giải thích AI, robot và tự động hóa tiếp theo.