Một đứa trẻ học nhận ra con mèo sau khi được người lớn chỉ vào một con mèo thật. Nhưng cũng chính đứa trẻ ấy tự học cách đi, cách nói, cách đoán nét mặt của mẹ mà chẳng ai đưa cho nó một tấm thẻ đáp án nào. Vậy học máy là gì, và máy học theo kiểu nào trong hai kiểu đó?
Câu trả lời ngắn: học máy (machine learning) là cách cho máy xem thật nhiều dữ liệu để nó tự rút ra quy luật, thay vì lập trình từng quy tắc. Có ba cách máy học chính: học có giám sát (có đáp án do người dán nhãn), học không giám sát (máy tự gom nhóm) và học tự giám sát (máy tự ra đề cho mình).
Cách thứ ba chính là nền móng của các chatbot bạn dùng mỗi ngày. Bài viết này giải thích từng cách bằng ví dụ đời thường, chỉ ra chúng nối với nhau ra sao và giới hạn thật sự của mỗi cách.
Nếu bạn thích nghe kể hơn đọc, hãy xem video giải thích ba cách máy học trong hơn 3 phút của kênh Vọc Sĩ ngay bên dưới, rồi quay lại đây để đọc phần mở rộng chi tiết.
Tóm tắt nhanh
- Học máy là cho máy xem dữ liệu để tự tìm quy luật, không cần viết sẵn từng quy tắc.
- Học có giám sát dùng dữ liệu đã dán nhãn, như bộ lọc thư rác học từ email đã phân loại.
- Học không giám sát tự gom dữ liệu thành nhóm, nhưng không biết nhóm đó có nghĩa gì.
- Học tự giám sát để máy tự ra đề, ví dụ giấu một từ rồi đoán lại, nhờ vậy học được từ kho chữ khổng lồ.
- Ba cách thường nối thành dây chuyền, và cách nào cũng có giới hạn riêng.
Nội dung chính:
- Học máy là gì? Khác gì lập trình thông thường
- Ba cách máy học: phân biệt bằng một câu hỏi
- Học có giám sát: máy học với người thầy
- Học không giám sát: máy tự gom nhóm
- Vì sao cần cách học thứ ba?
- Học tự giám sát: máy tự ra đề cho mình
- Ba cách học nối thành dây chuyền như thế nào
- Giới hạn thật sự của từng cách học máy
- Những hiểu lầm phổ biến về học máy
- Cách nhận ra học máy trong đời sống hằng ngày
- Câu hỏi thường gặp
- Kết luận
Học máy là gì? Khác gì lập trình thông thường
Hãy bắt đầu bằng cách máy tính làm việc “kiểu cũ”. Một lập trình viên muốn máy làm gì thì phải viết ra từng quy tắc: nếu nhiệt độ trên 30 độ thì bật quạt, nếu số dư dưới mức tối thiểu thì gửi cảnh báo. Máy chỉ làm đúng những gì được dặn, không hơn không kém.
Cách đó rất ổn với việc rõ ràng. Nhưng thử viết quy tắc để nhận ra một con mèo trong ảnh xem. Mèo có thể nằm, ngồi, quay lưng, bị che một nửa, lông vằn hay lông trắng. Bạn sẽ không bao giờ liệt kê hết được mọi trường hợp.
Học máy đảo ngược cách làm: thay vì viết quy tắc, ta cho máy xem thật nhiều ví dụ để nó tự rút ra quy luật. Máy không “hiểu” con mèo như ta, nhưng nó tìm được những đặc điểm thường đi cùng nhau trong ảnh có mèo: hình tai, tỷ lệ mắt, kết cấu lông.
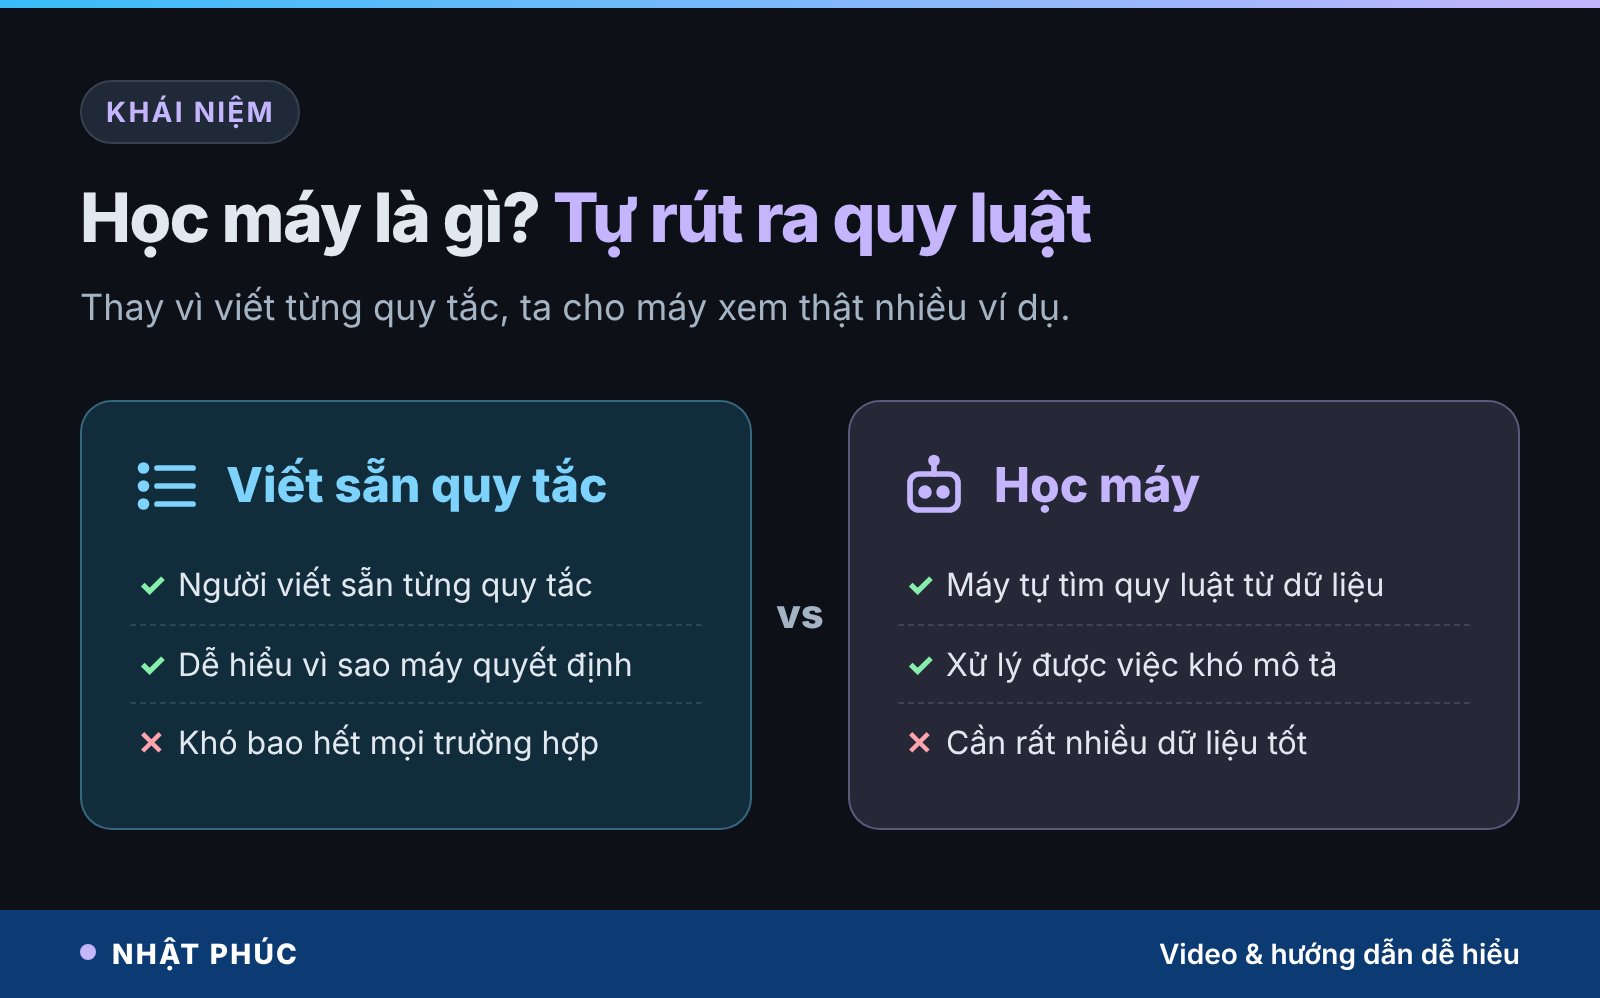
Đổi lại, học máy cần rất nhiều dữ liệu tốt, và đôi khi khó giải thích vì sao máy đưa ra một quyết định cụ thể. Đây là sự đánh đổi bạn sẽ gặp lại nhiều lần trong bài.
Học máy, AI và học sâu liên quan thế nào?
Trí tuệ nhân tạo (AI) là khái niệm rộng nhất, chỉ mọi cách làm cho máy có hành vi trông “thông minh”. Học máy là một nhánh của AI, tập trung vào việc học từ dữ liệu. Học sâu (deep learning) lại là một nhánh của học máy, dùng mạng nơ-ron nhiều lớp. Ba cách học trong bài này áp dụng cho cả học máy nói chung lẫn học sâu.
Ba cách máy học: phân biệt bằng một câu hỏi
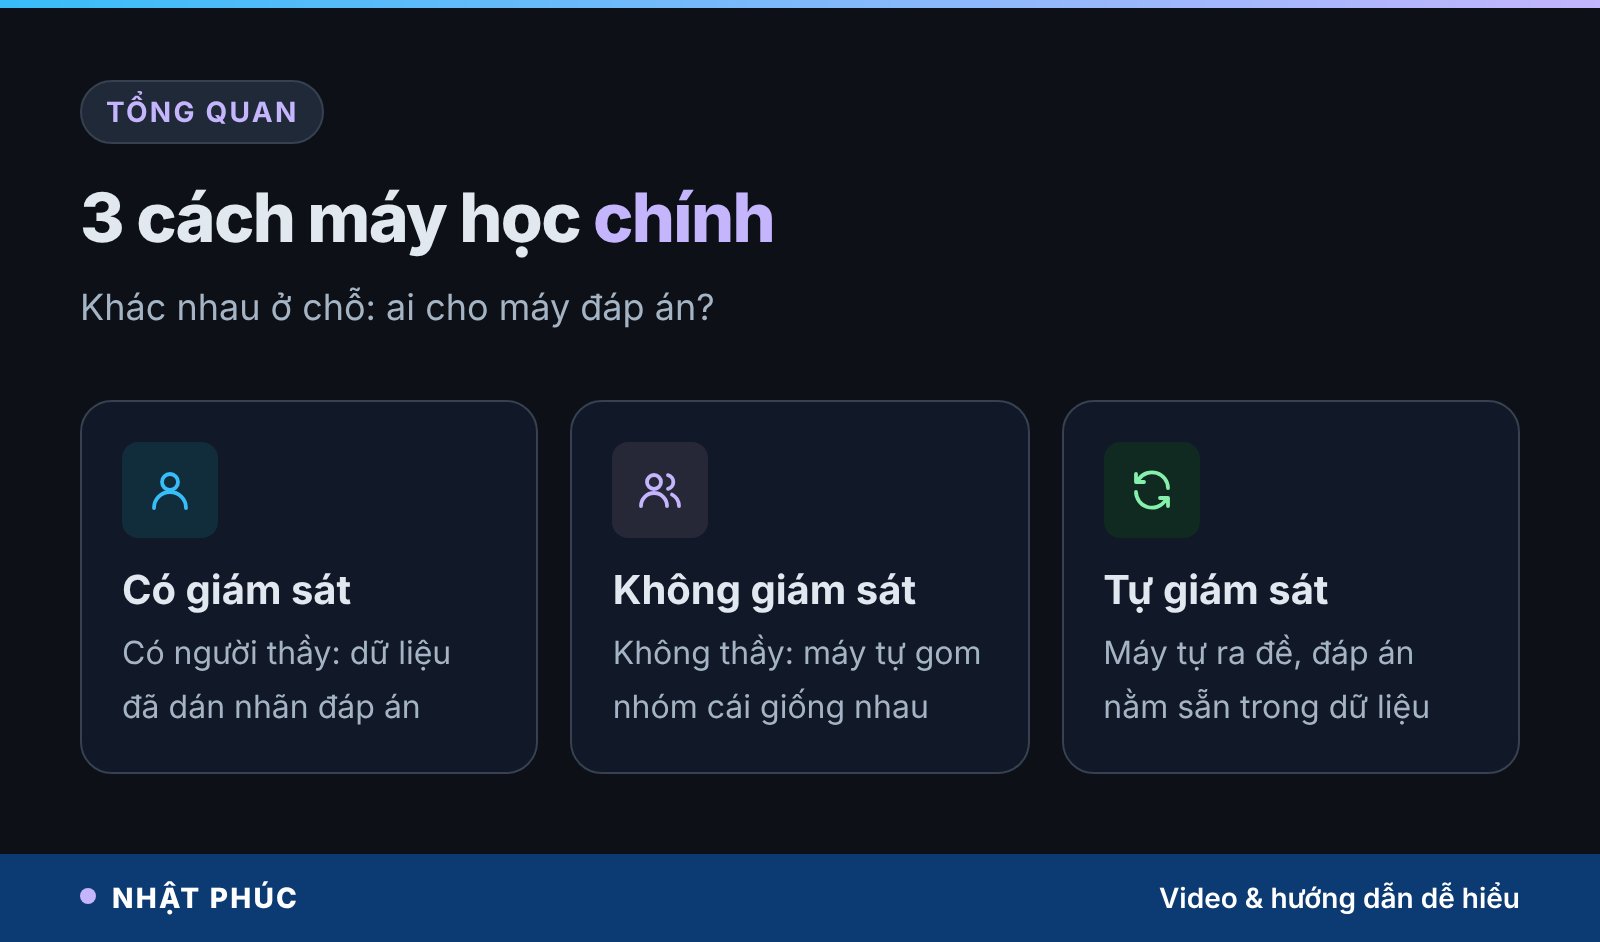
Có nhiều cách chia nhỏ học máy, nhưng để dễ nhớ, bạn chỉ cần một câu hỏi: ai cho máy đáp án?
- Học có giám sát (supervised learning): con người cho đáp án. Mỗi mẫu dữ liệu đã được dán nhãn sẵn.
- Học không giám sát (unsupervised learning): không ai cho đáp án. Máy tự tìm ra các nhóm, các khuôn mẫu ẩn.
- Học tự giám sát (self-supervised learning): đáp án nằm sẵn trong dữ liệu. Máy tự che một phần rồi đoán lại.
Ngoài ba cách này còn có học tăng cường (reinforcement learning), nơi máy học qua thử và sai với phần thưởng. Video và bài viết này tập trung vào ba cách liên quan trực tiếp đến dữ liệu, vì đó là nền tảng để hiểu các mô hình AI hiện nay.
Học có giám sát: máy học với người thầy
Học có giám sát giống như đi học có thầy kèm cặp. Ví dụ quen thuộc nhất nằm ngay trong hộp thư của bạn: bộ lọc thư rác.
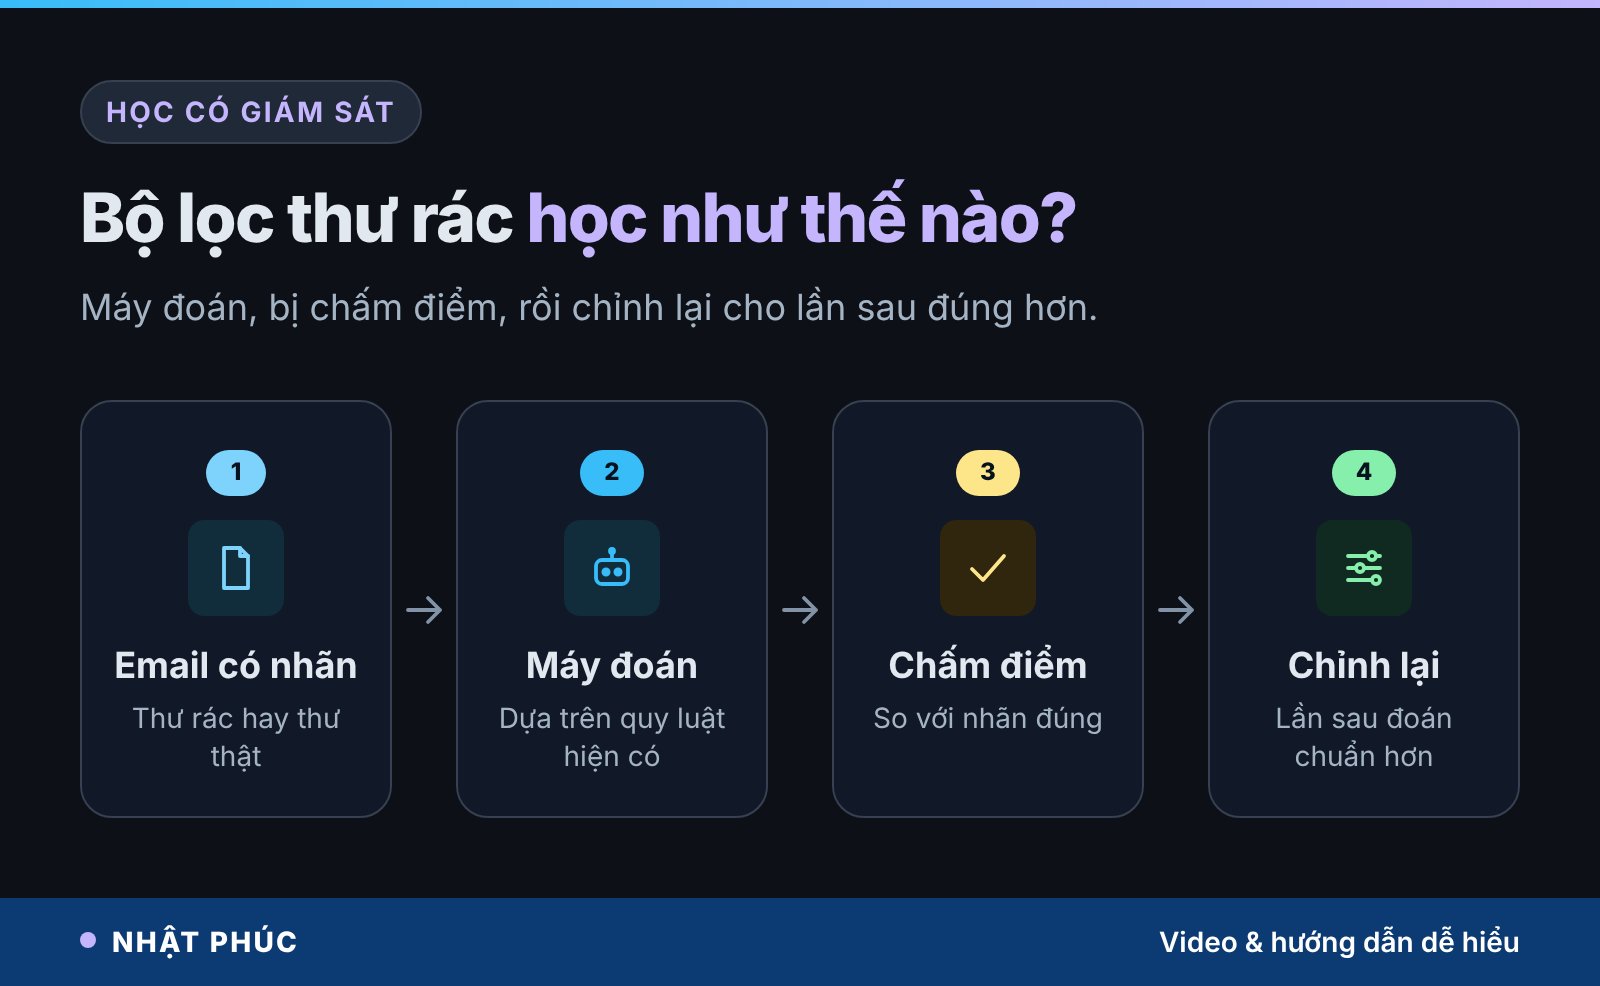
Mỗi email gửi đến, bộ lọc phải quyết định giữ lại hay đẩy vào mục spam. Để dạy nó, người ta đưa cho máy rất nhiều email đã được dán nhãn sẵn: cái này là thư rác, cái kia là thư thật. Máy xem từng email, đoán, rồi so với nhãn đúng.
Vòng lặp đoán, chấm, sửa
Mỗi lần đoán sai, máy bị “chấm điểm” bằng một con số thể hiện mức sai, gọi là hàm mất mát (loss). Sau đó máy chỉnh lại các tham số bên trong để lần sau đoán gần đúng hơn. Lặp lại hàng triệu lần, máy dần nắm được những dấu hiệu hay gặp ở thư rác: cụm từ quảng cáo, đường link lạ, người gửi bất thường.
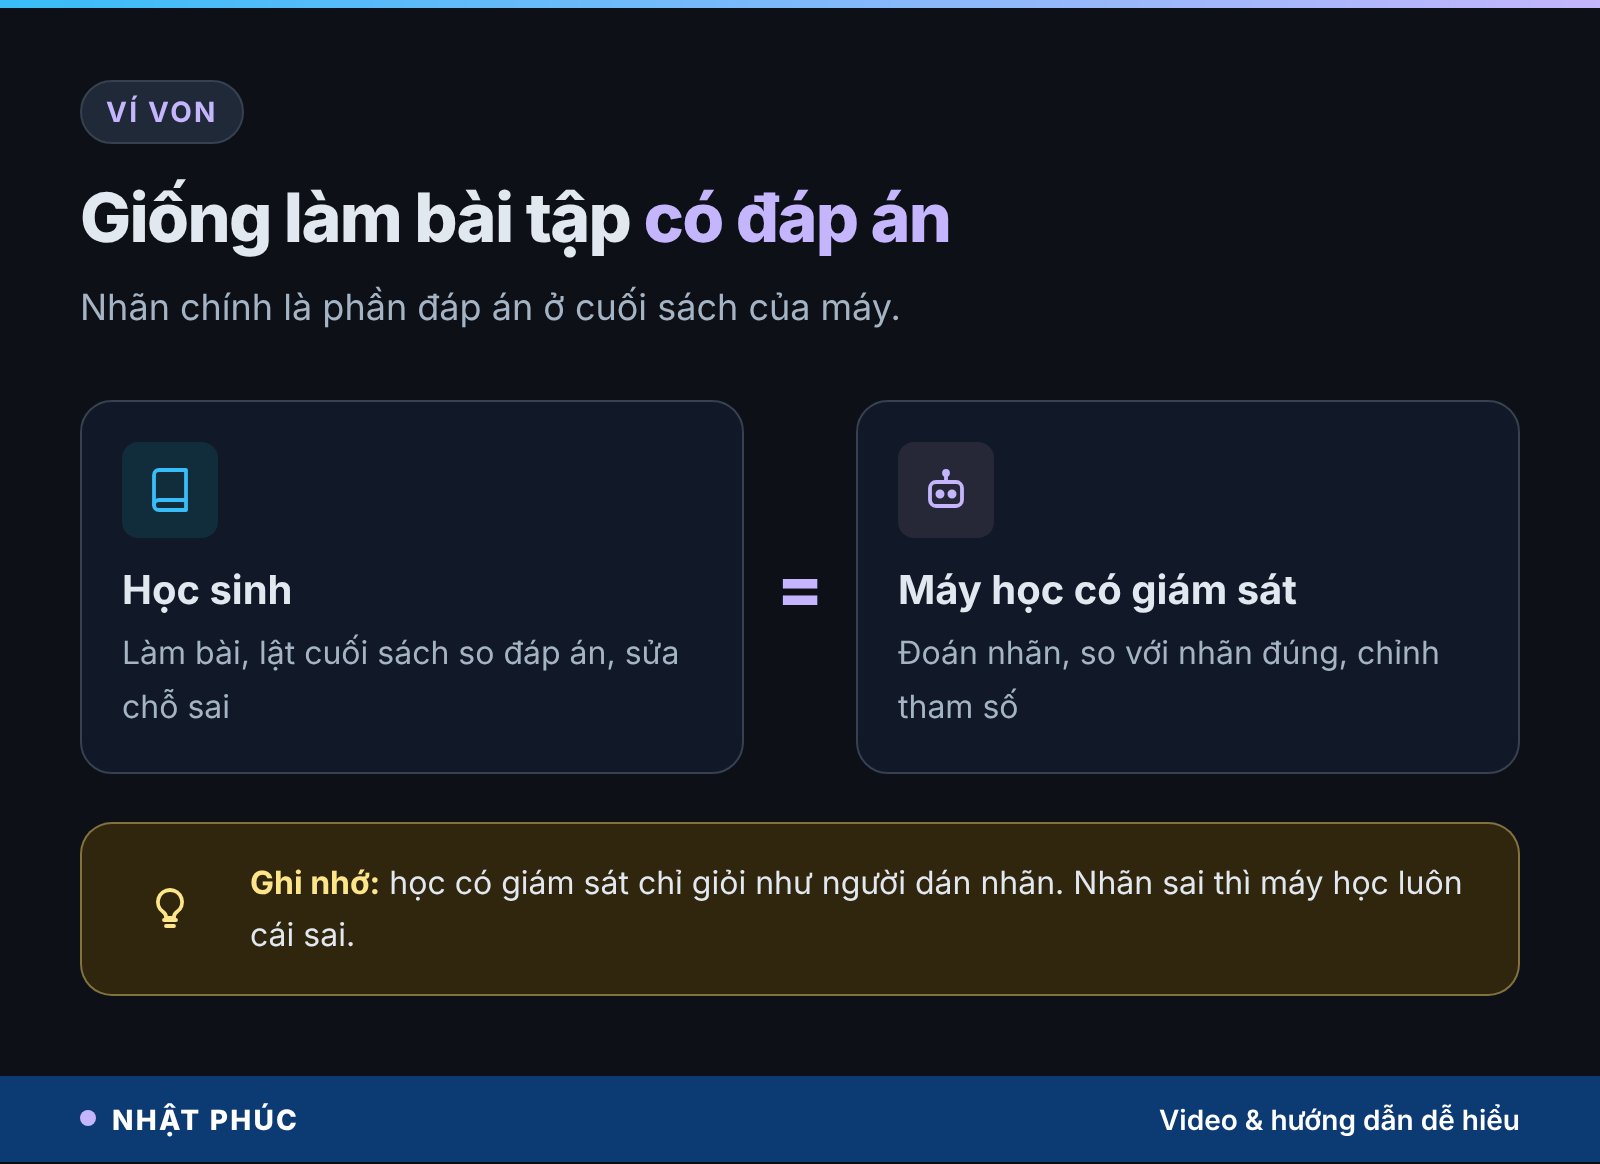
Giống như học sinh làm bài tập có đáp án ở cuối sách: làm xong, lật ra so, thấy sai thì sửa. Học có giám sát được dùng rất rộng: nhận diện khuôn mặt, chuyển giọng nói thành chữ, dự đoán giá nhà, phân loại ảnh. Điểm chung là ta biết trước “câu trả lời đúng” trông như thế nào và có dữ liệu mẫu để dạy.
Hai dạng bài toán thường gặp
Khi đáp án là một nhóm (thư rác hay không, mèo hay chó), ta gọi là bài toán phân loại. Khi đáp án là một con số (giá nhà, nhiệt độ ngày mai), ta gọi là bài toán hồi quy. Cả hai đều cần dữ liệu đã có đáp án đi kèm.
Học không giám sát: máy tự gom nhóm
Vậy chuyện gì xảy ra khi không có đáp án? Đó là lúc học không giám sát xuất hiện.
Hãy hình dung một hộp nút áo bị đổ ra sàn, lẫn lộn đủ loại, và không ai nói cho bạn biết phải xếp thế nào. Bạn vẫn tự gom được: nút to một chỗ, nút nhỏ một chỗ, nút màu đỏ nằm chung. Bạn không cần ai đặt tên cho nhóm, chỉ cần nhìn thấy cái gì giống cái gì.
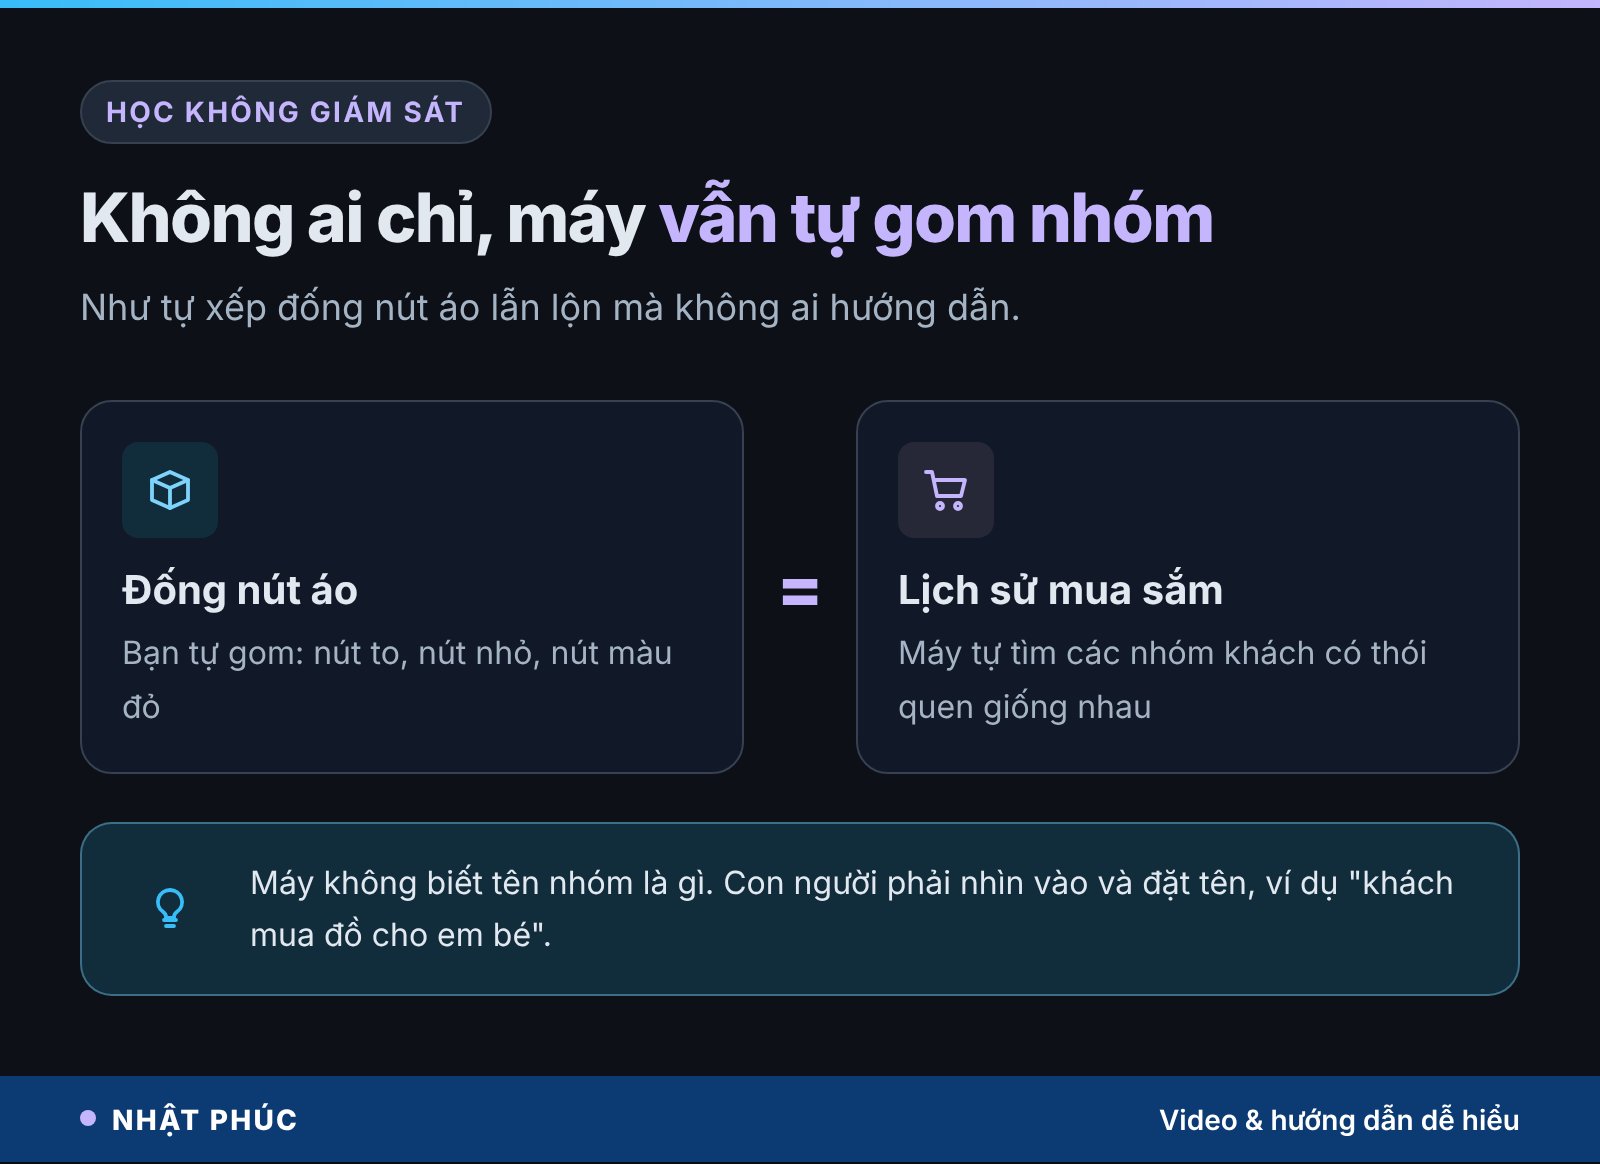
Máy làm điều tương tự. Một cửa hàng đưa cho máy lịch sử mua sắm của khách, không kèm nhãn gì cả. Máy tự tìm ra các nhóm khách có thói quen giống nhau. Chẳng ai dạy nó khái niệm “khách mua đồ cho em bé”. Nó chỉ thấy những người này hay mua những món giống nhau, nên xếp họ vào chung một nhóm.
Kỹ thuật phổ biến nhất cho việc này gọi là phân cụm (clustering): máy đo xem các điểm dữ liệu “gần” nhau đến đâu rồi gom những điểm gần nhau thành cụm.
Học không giám sát được dùng vào đâu?
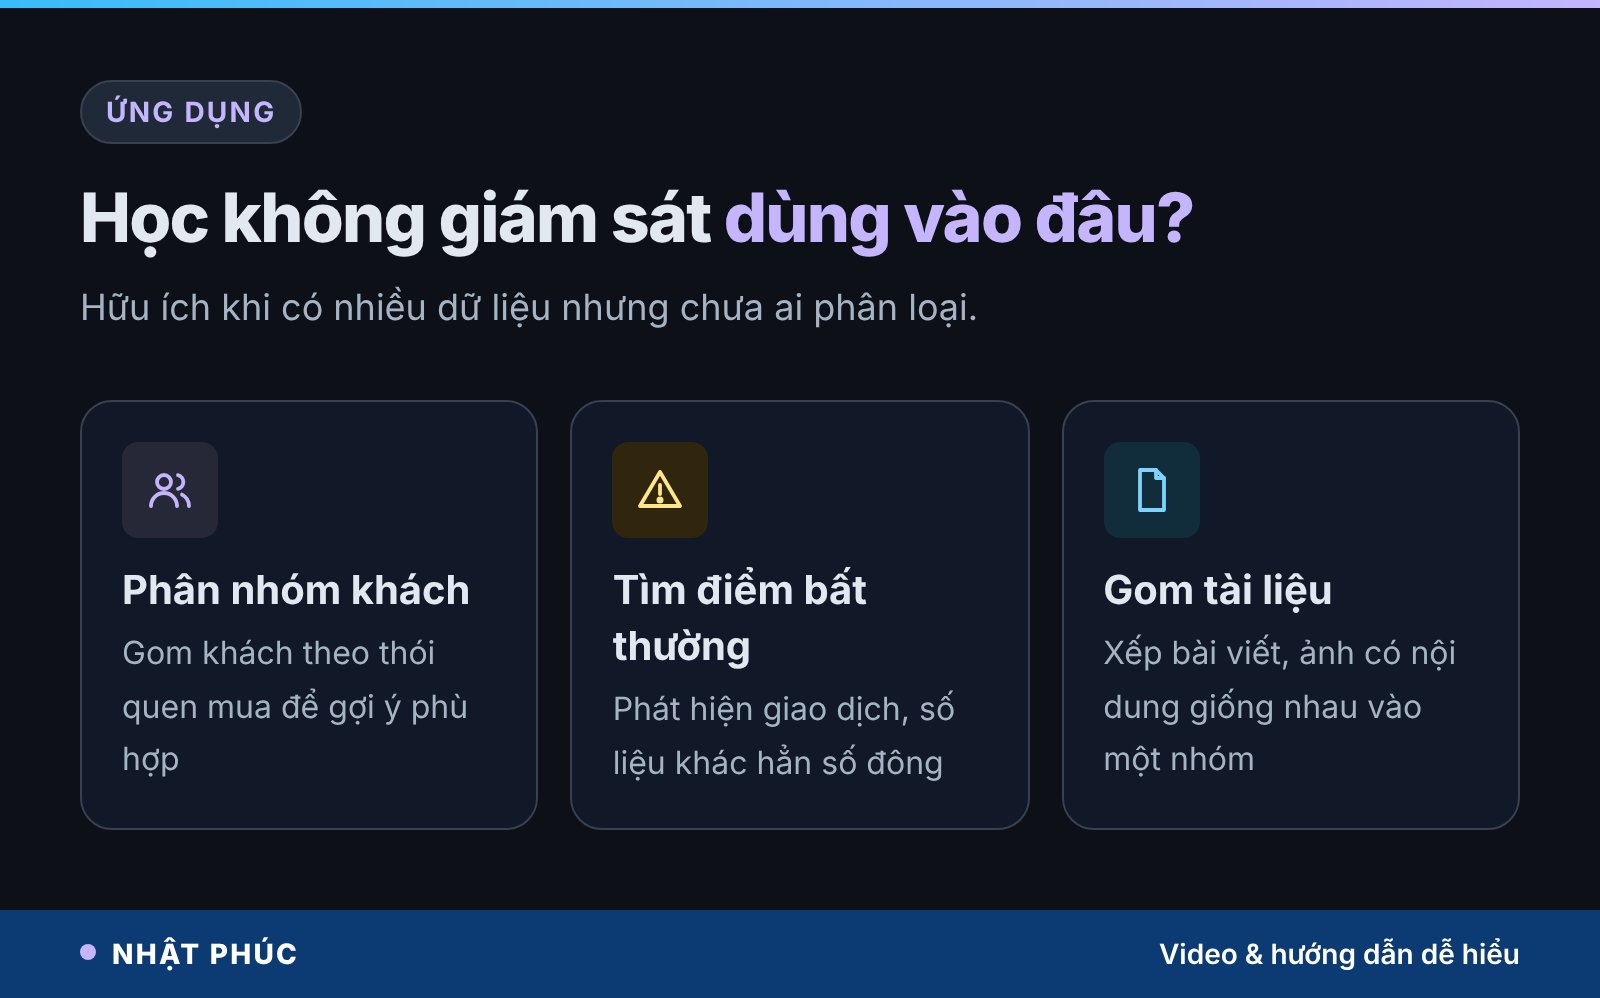
- Phân nhóm khách hàng để gợi ý sản phẩm hoặc chương trình phù hợp với từng nhóm.
- Tìm điểm bất thường: giao dịch, số liệu cảm biến khác hẳn số đông có thể là dấu hiệu lỗi hoặc gian lận.
- Gom tài liệu, hình ảnh có nội dung giống nhau để sắp xếp kho dữ liệu lớn.
Điều quan trọng cần nhớ: máy chỉ tìm ra nhóm. Nhóm đó có nghĩa là gì, đặt tên ra sao, vẫn cần con người nhìn vào và diễn giải.
Vì sao cần cách học thứ ba?
Học có giám sát rất mạnh, nhưng có một chỗ vướng lớn: nhãn do con người làm. Muốn dạy máy nhận ra khối u trên phim chụp, phải có bác sĩ đánh dấu từng tấm ảnh. Muốn dạy máy hiểu cảm xúc trong bình luận, phải có người đọc và gắn nhãn từng câu. Việc ấy tốn thời gian và tiền bạc, nhất là khi cần chuyên gia.
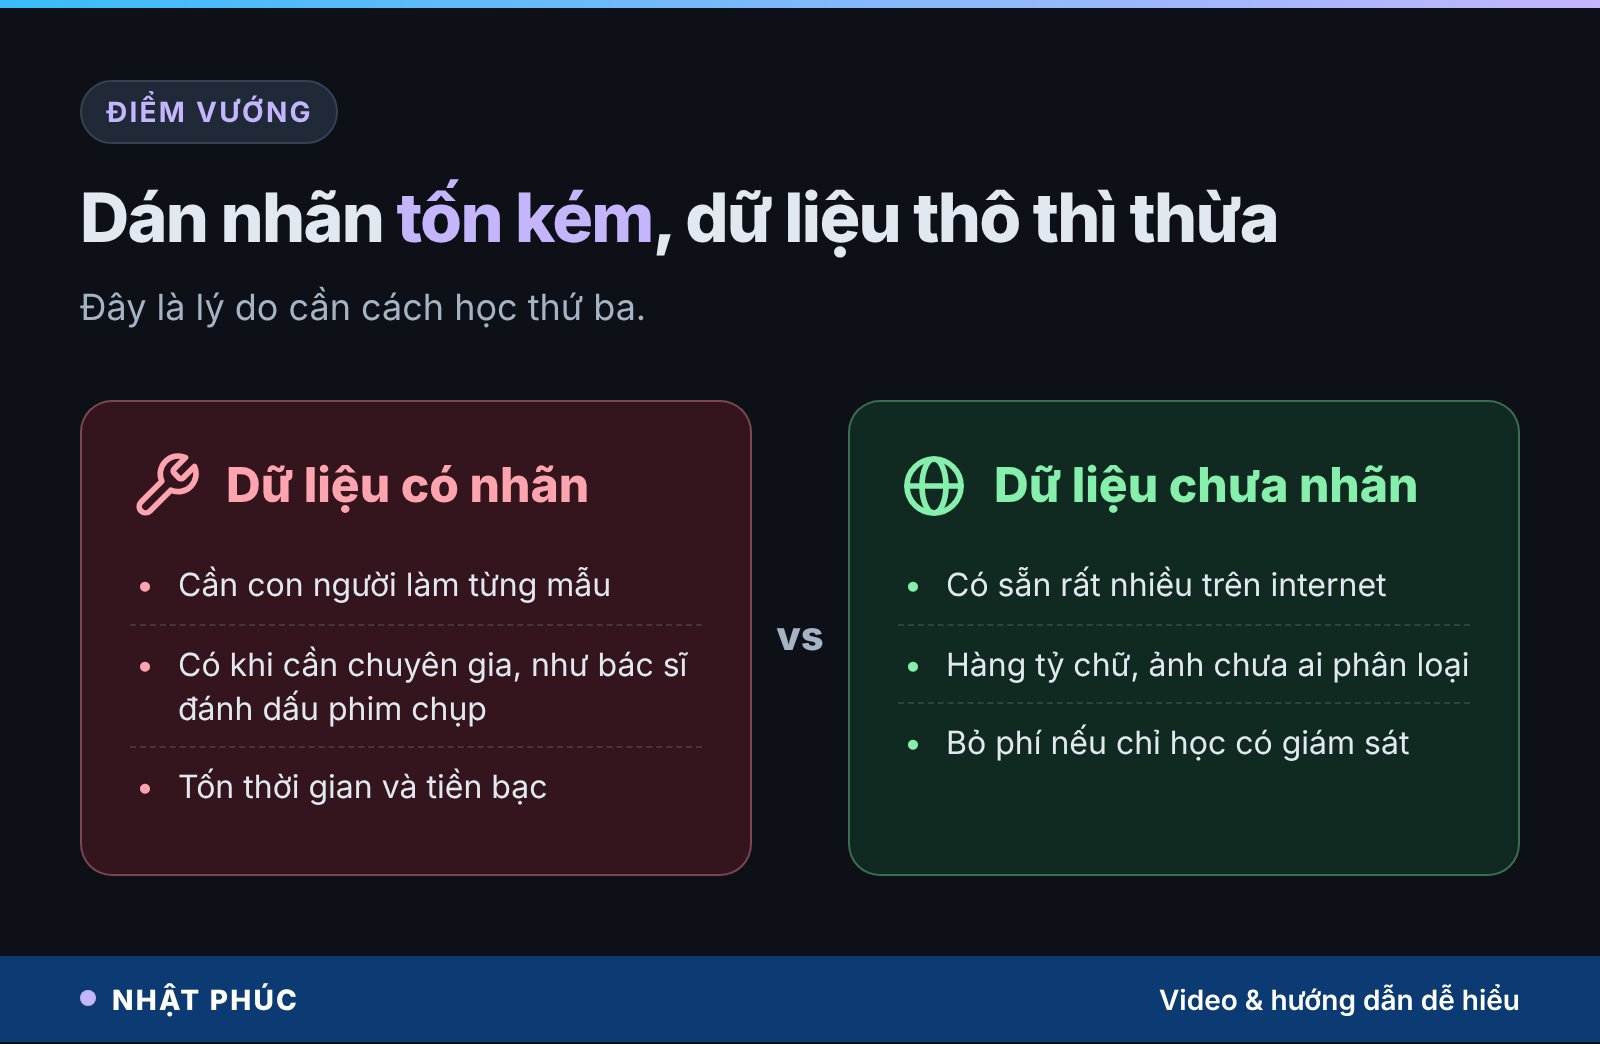
Trong khi đó, internet có hàng tỷ chữ, hàng tỷ tấm ảnh mà không ai dán nhãn. Nếu chỉ biết học có giám sát, ta sẽ bỏ phí gần như toàn bộ kho dữ liệu khổng lồ đó. Học không giám sát dùng được dữ liệu thô, nhưng chỉ dừng ở mức gom nhóm, chưa đủ để máy học được những điều phức tạp như ngôn ngữ.
Câu hỏi đặt ra là: có cách nào để máy học từ dữ liệu thô mà vẫn có “đáp án” để tự kiểm tra không? Câu trả lời là có, và đó chính là học tự giám sát.
Học tự giám sát: máy tự ra đề cho mình
Mẹo của học tự giám sát nằm ở chỗ để máy tự ra đề cho chính mình. Lấy một câu có sẵn, giấu đi một từ, rồi bắt máy đoán từ bị giấu. Đáp án chính là từ gốc nằm ngay trong câu, không cần ai dán nhãn.
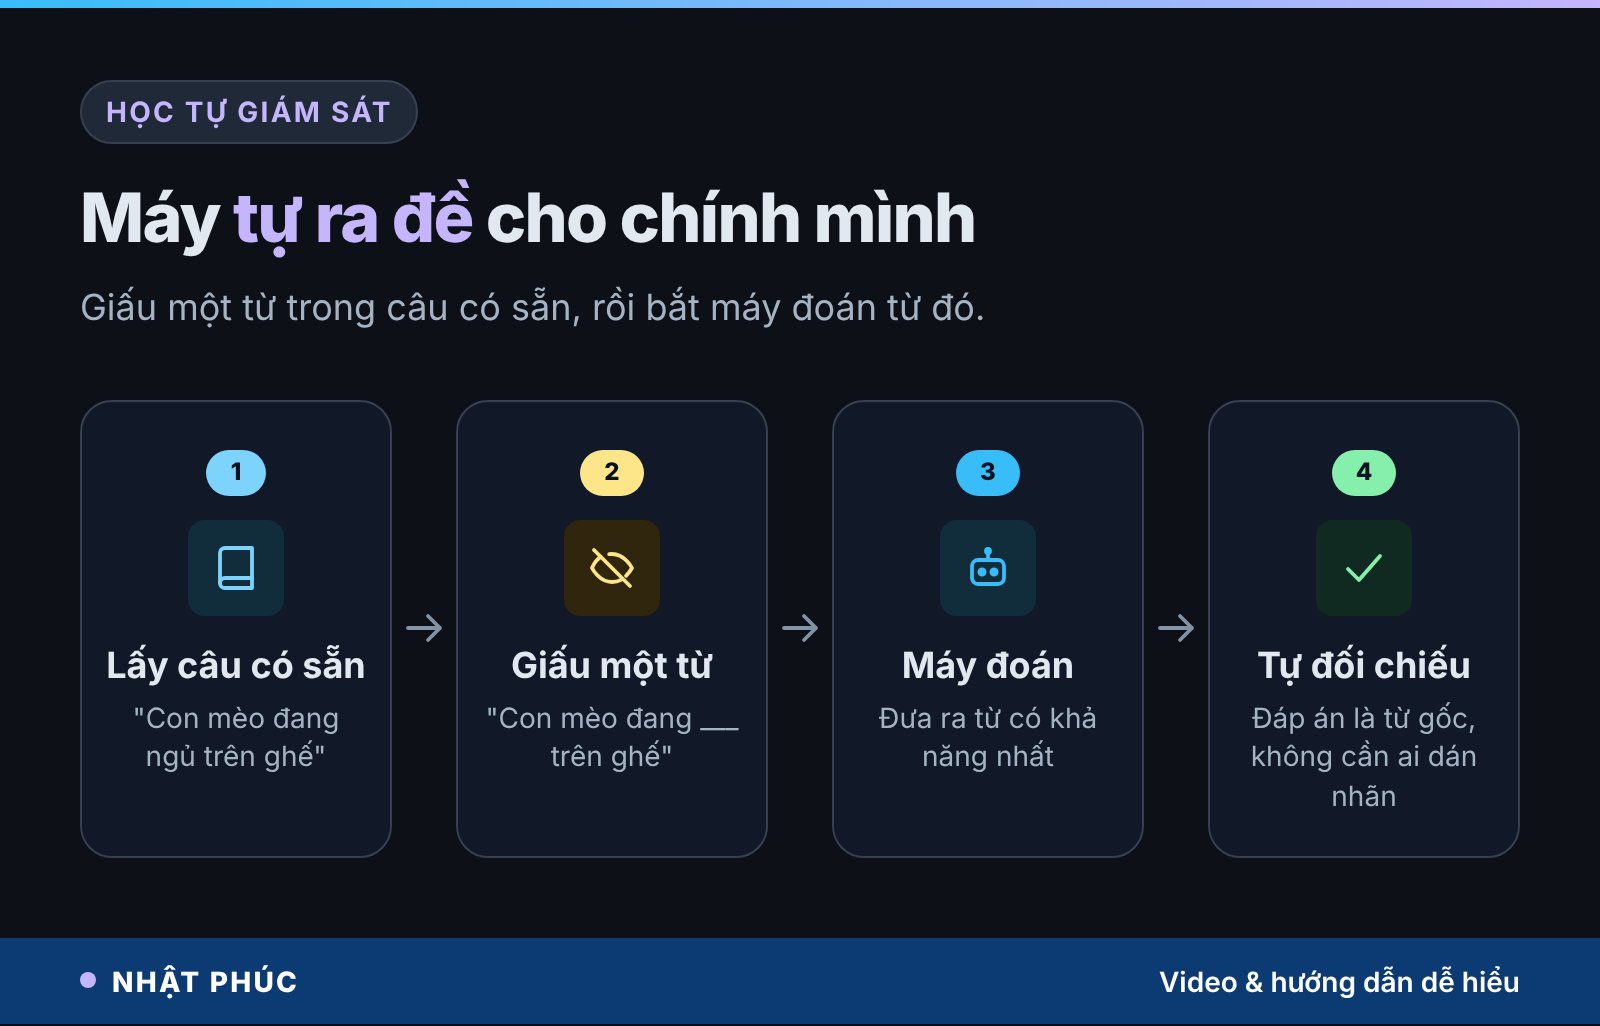
Giống như bạn che một chữ trong cuốn sách, đoán xem chữ đó là gì, rồi mở ra đối chiếu. Làm việc đó hàng tỷ lần với đủ loại văn bản, máy dần nắm được cách các từ đi cùng nhau, ngữ pháp, thậm chí cả kiến thức nằm trong câu chữ.
Mô hình ngôn ngữ lớn học theo cách này
Các mô hình ngôn ngữ lớn (LLM) đứng sau chatbot được xây trên ý tưởng này. Một biến thể phổ biến là đoán từ tiếp theo: cho máy đọc phần đầu câu, bắt nó đoán chữ kế tiếp, rồi đối chiếu với chữ thật trong văn bản. Vì đáp án luôn có sẵn, máy có thể luyện trên lượng chữ lớn hơn rất nhiều so với những gì con người kịp dán nhãn.
Ý tưởng tương tự cũng dùng cho ảnh: che một phần bức ảnh rồi bắt máy vẽ lại phần bị che. Vì thế, học tự giám sát đôi khi được xem là “cầu nối” giữa học có giám sát và không giám sát: dữ liệu không có nhãn, nhưng máy vẫn có bài để chấm.
Ba cách học nối thành dây chuyền như thế nào
Một điểm hay bị hiểu lầm: ba cách học này không loại trừ nhau. Chúng thường nối vào nhau như các công đoạn của một dây chuyền. Chatbot là ví dụ rõ nhất: tự học trước, rồi mới có người chấm điểm thêm.
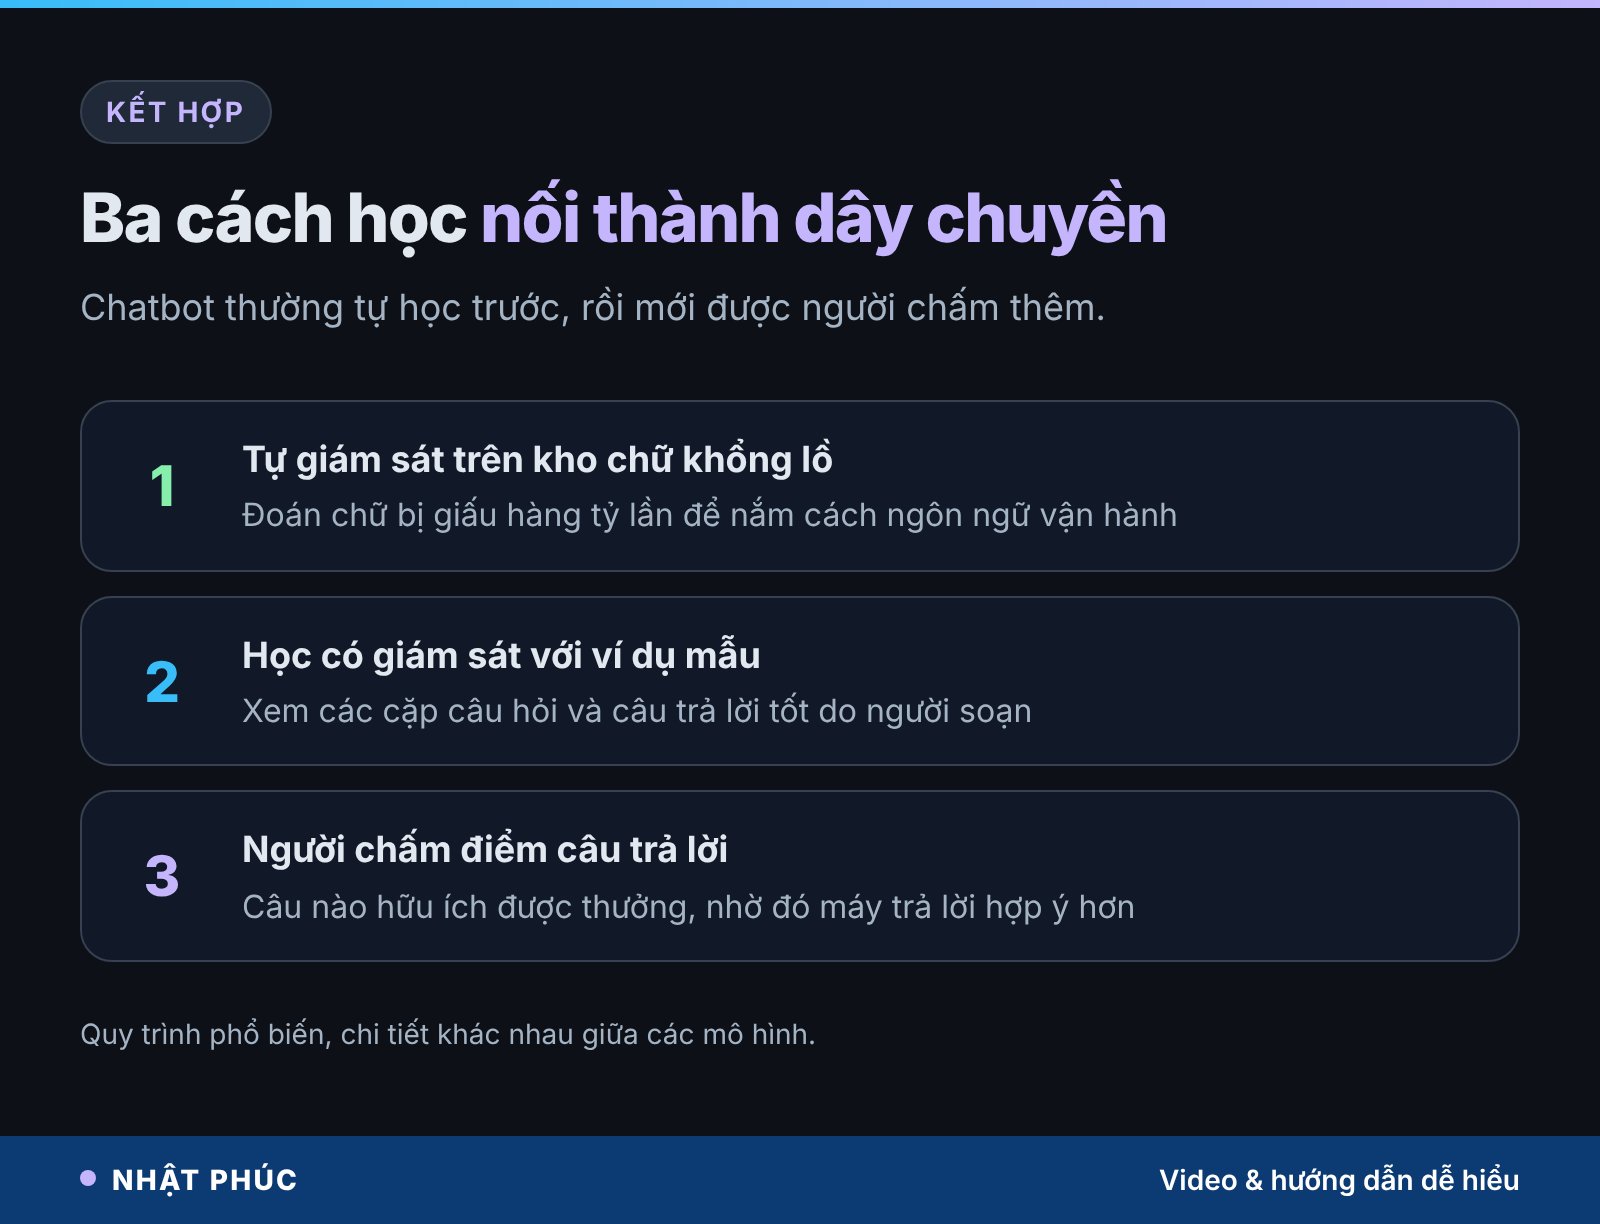
- Tự giám sát trên kho chữ khổng lồ: máy đoán chữ bị giấu hoặc chữ tiếp theo rất nhiều lần để nắm cách ngôn ngữ vận hành. Giai đoạn này thường gọi là tiền huấn luyện (pre-training).
- Học có giám sát với ví dụ mẫu: máy xem các cặp câu hỏi và câu trả lời tốt do người soạn để học cách trò chuyện, làm theo yêu cầu.
- Người chấm điểm câu trả lời: con người so sánh, đánh giá các câu trả lời; câu nào hữu ích được “thưởng”, nhờ đó máy trả lời hợp ý người dùng hơn.
Học không giám sát cũng góp mặt ở nhiều chỗ, chẳng hạn gom nhóm, lọc trùng lặp dữ liệu trước khi đưa vào huấn luyện. Nói cách khác, một hệ thống AI hiện đại thường là sự phối hợp của cả ba, mỗi cách đảm nhận phần việc nó làm tốt nhất.
Giới hạn thật sự của từng cách học máy
Hiểu cách máy học cũng là hiểu vì sao máy có thể sai. Mỗi cách học đều có giới hạn riêng.
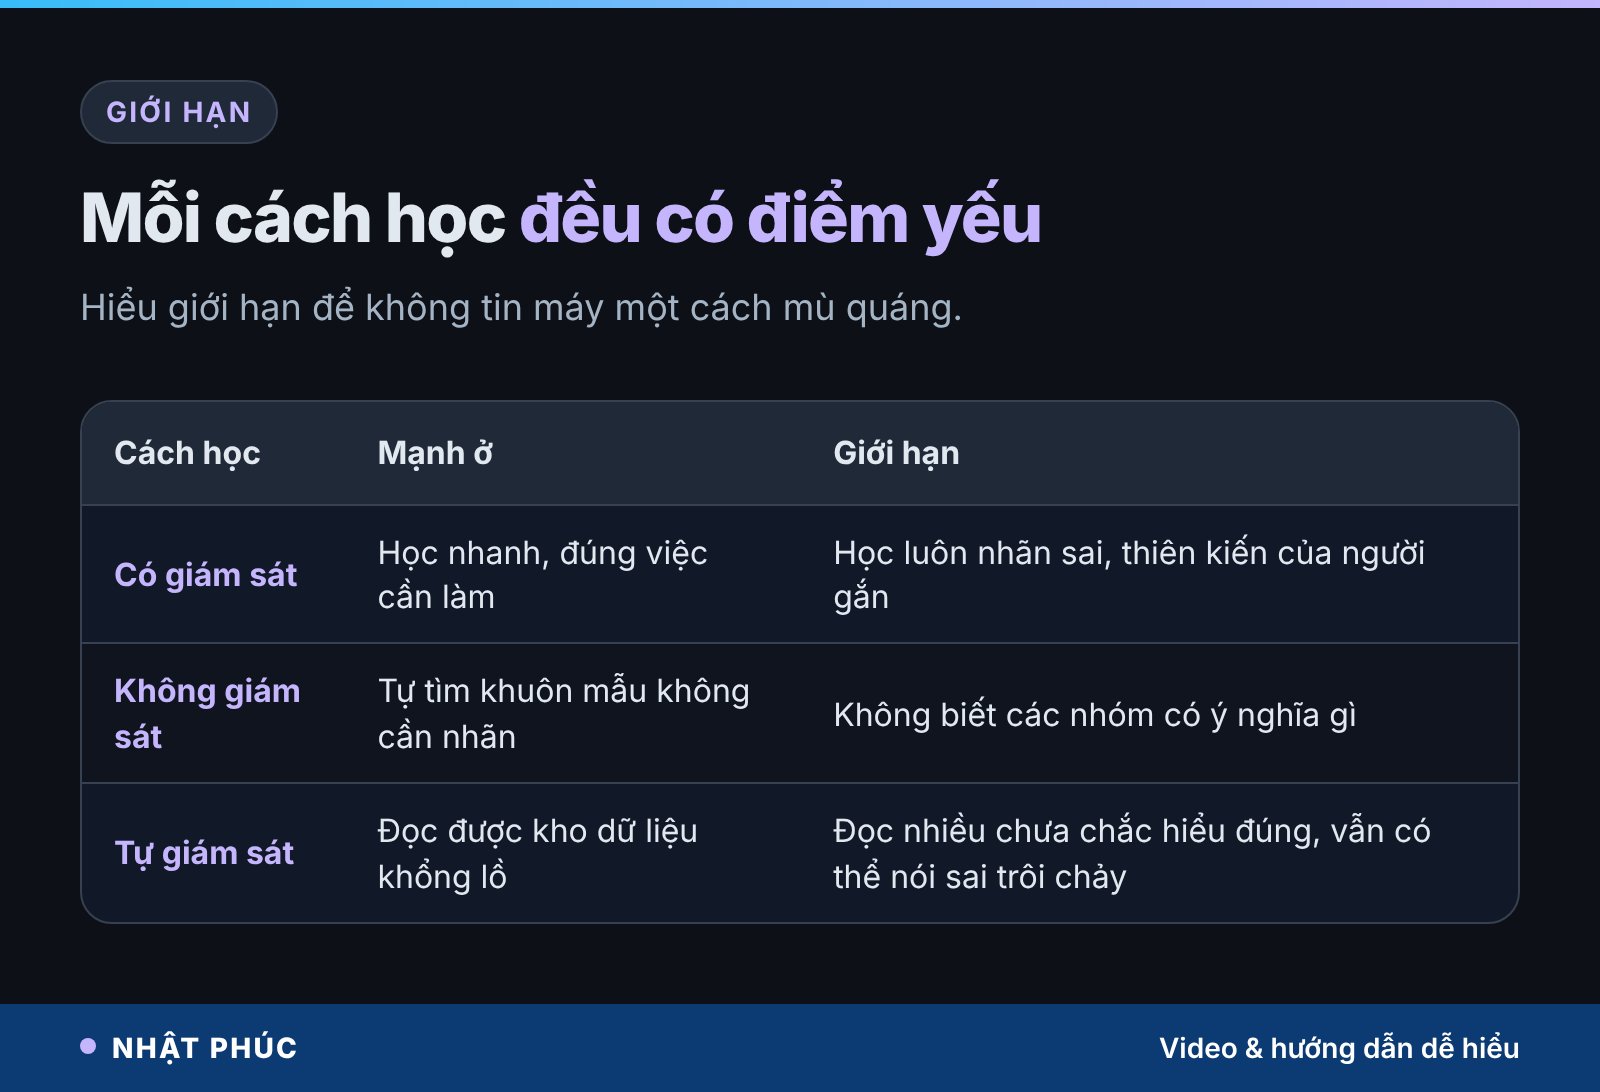
Học có giám sát chỉ giỏi như người thầy
Nếu nhãn bị gắn sai hoặc mang thiên kiến của người gắn, máy sẽ học luôn cái sai ấy mà không biết nghi ngờ. Ví dụ, nếu dữ liệu ảnh dùng để dạy chủ yếu chụp trong điều kiện đủ sáng, máy có thể làm kém hẳn khi gặp ảnh thiếu sáng.
Học không giám sát không biết nhóm có nghĩa gì
Máy tìm ra nhóm, nhưng nhóm đó có thể không như ta mong đợi. Có khi nó gom khách theo giờ mua hàng chứ không theo sở thích, và con người phải đứng ra diễn giải xem nhóm nào hữu ích.
Học tự giám sát: đọc nhiều chưa chắc hiểu đúng
Học tự giám sát giúp máy đọc được rất nhiều, nhưng đọc nhiều chưa chắc là hiểu đúng. Máy vẫn có thể nói sai một cách trôi chảy, hiện tượng thường gọi là “ảo giác AI”. Vì vậy, với thông tin quan trọng, bạn vẫn nên kiểm tra lại nguồn.
| Cách học | Dữ liệu cần | Ví dụ | Giới hạn chính |
|---|---|---|---|
| Có giám sát | Dữ liệu đã dán nhãn | Lọc thư rác, nhận diện giọng nói | Học luôn nhãn sai, tốn công dán nhãn |
| Không giám sát | Dữ liệu thô, không nhãn | Phân nhóm khách hàng | Không biết ý nghĩa của nhóm |
| Tự giám sát | Dữ liệu thô, máy tự tạo đề | Tiền huấn luyện mô hình ngôn ngữ | Có thể nói sai một cách trôi chảy |
Những hiểu lầm phổ biến về học máy
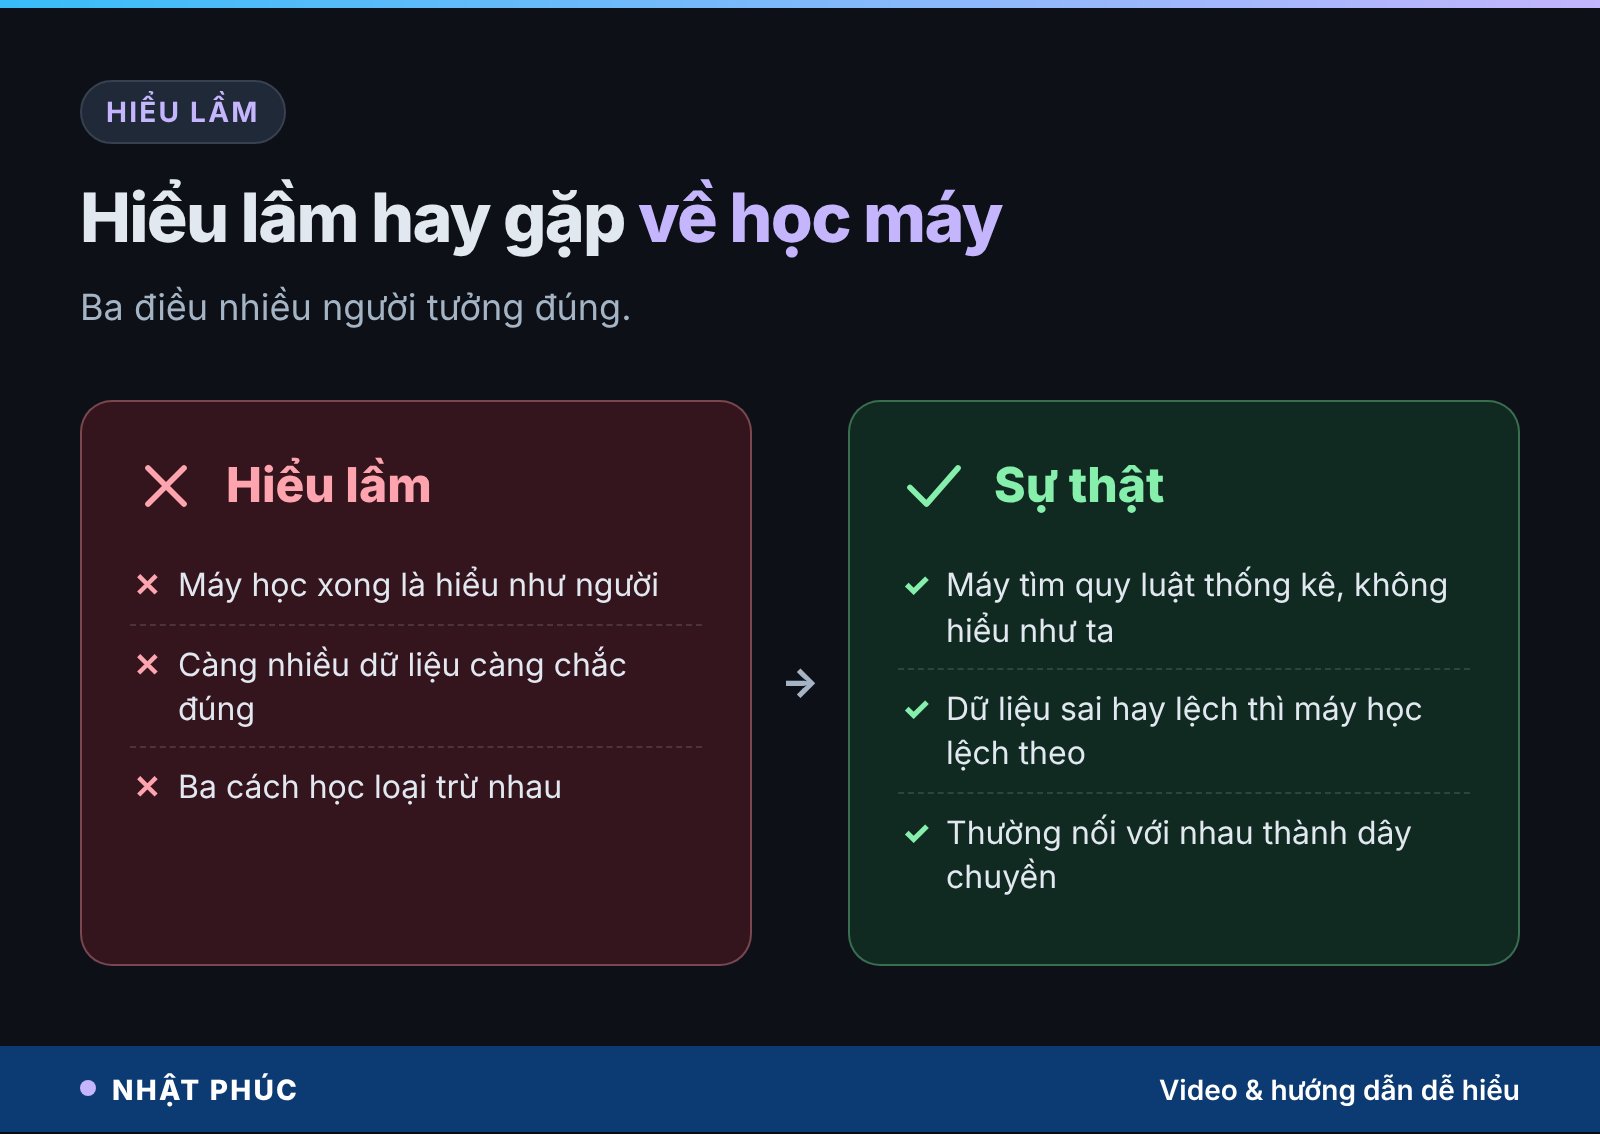
Hiểu lầm 1: Máy học xong là hiểu như người
Máy tìm ra quy luật thống kê trong dữ liệu. Nó có thể đưa ra kết quả rất ấn tượng, nhưng cách nó “biết” khác xa cách con người hiểu thế giới. Máy không có trải nghiệm, không tự kiểm chứng điều nó nói với thực tế.
Hiểu lầm 2: Càng nhiều dữ liệu càng chắc đúng
Số lượng giúp ích, nhưng chất lượng mới quyết định. Dữ liệu sai, lệch hay trùng lặp nhiều thì máy học lệch theo, dù kho dữ liệu lớn đến đâu.
Hiểu lầm 3: Mỗi hệ thống chỉ dùng một cách học
Như phần dây chuyền ở trên, các hệ thống hiện đại thường kết hợp nhiều cách. Gọi một mô hình là “học có giám sát” hay “tự giám sát” thường chỉ nói về một giai đoạn huấn luyện của nó.
Cách nhận ra học máy trong đời sống hằng ngày
Học máy không chỉ nằm trong phòng thí nghiệm. Bạn có thể tự nhận ra nó qua vài bước đơn giản.
1. Để ý những chỗ máy “đoán” thay vì làm theo lệnh
Bộ lọc thư rác, gợi ý từ khi gõ phím, gợi ý video hay sản phẩm, nhận diện khuôn mặt trong thư viện ảnh: tất cả đều là máy đoán dựa trên quy luật học từ dữ liệu.
2. Đặt câu hỏi: dữ liệu học đến từ đâu?
Nếu có người dán nhãn (ví dụ bạn bấm “đây là thư rác”), đó là học có giám sát. Nếu máy tự xếp nhóm (ví dụ album ảnh tự gom theo khuôn mặt), có phần học không giám sát. Nếu là chatbot trò chuyện, phần lớn nền tảng đến từ học tự giám sát.
3. Góp phần làm máy học tốt hơn
Mỗi lần bạn đánh dấu “không phải thư rác” hay bấm “không quan tâm” một gợi ý, bạn đang cung cấp nhãn. Phản hồi chính xác giúp hệ thống học đúng hơn cho chính bạn.
4. Giữ thói quen kiểm tra lại
Vì cách học nào cũng có giới hạn, hãy xem kết quả của máy là gợi ý, không phải chân lý. Với thông tin sức khoẻ, tài chính hay pháp lý, luôn đối chiếu với nguồn đáng tin cậy.
Câu hỏi thường gặp
Học máy và trí tuệ nhân tạo có giống nhau không?
Không hoàn toàn. Trí tuệ nhân tạo là khái niệm rộng, chỉ mọi cách làm cho máy hành xử thông minh. Học máy là một nhánh của AI, trong đó máy tự rút ra quy luật từ dữ liệu thay vì làm theo quy tắc viết sẵn. Hầu hết AI phổ biến hiện nay đều dựa trên học máy.
Học có giám sát và không giám sát khác nhau thế nào?
Khác nhau ở đáp án. Học có giám sát dùng dữ liệu đã được con người dán nhãn, nên máy biết đúng sai để tự sửa. Học không giám sát dùng dữ liệu không nhãn, máy chỉ tự gom những thứ giống nhau thành nhóm và không biết nhóm đó có ý nghĩa gì.
Học tự giám sát có phải là học không giám sát không?
Hai cách đều dùng dữ liệu không do người dán nhãn, nên đôi khi được xếp gần nhau. Điểm khác là học tự giám sát tự tạo ra bài toán có đáp án rõ ràng, ví dụ giấu một từ rồi đoán lại, nên máy vẫn được “chấm điểm” như học có giám sát.
Vì sao chatbot vẫn nói sai dù học từ rất nhiều dữ liệu?
Vì giai đoạn học tự giám sát dạy máy đoán chữ hợp lý, không dạy máy kiểm chứng sự thật. Máy có thể ghép ra câu nghe rất trôi chảy nhưng sai nội dung. Các bước học có giám sát và người chấm điểm giúp giảm lỗi, nhưng chưa loại bỏ hoàn toàn.
Người không biết lập trình có cần hiểu học máy không?
Nên hiểu ở mức cơ bản. Biết máy học từ đâu giúp bạn dùng AI tỉnh táo hơn: biết khi nào nên tin, khi nào nên kiểm tra lại, và hiểu vì sao phản hồi của mình (như đánh dấu thư rác) giúp hệ thống tốt lên.
Kết luận
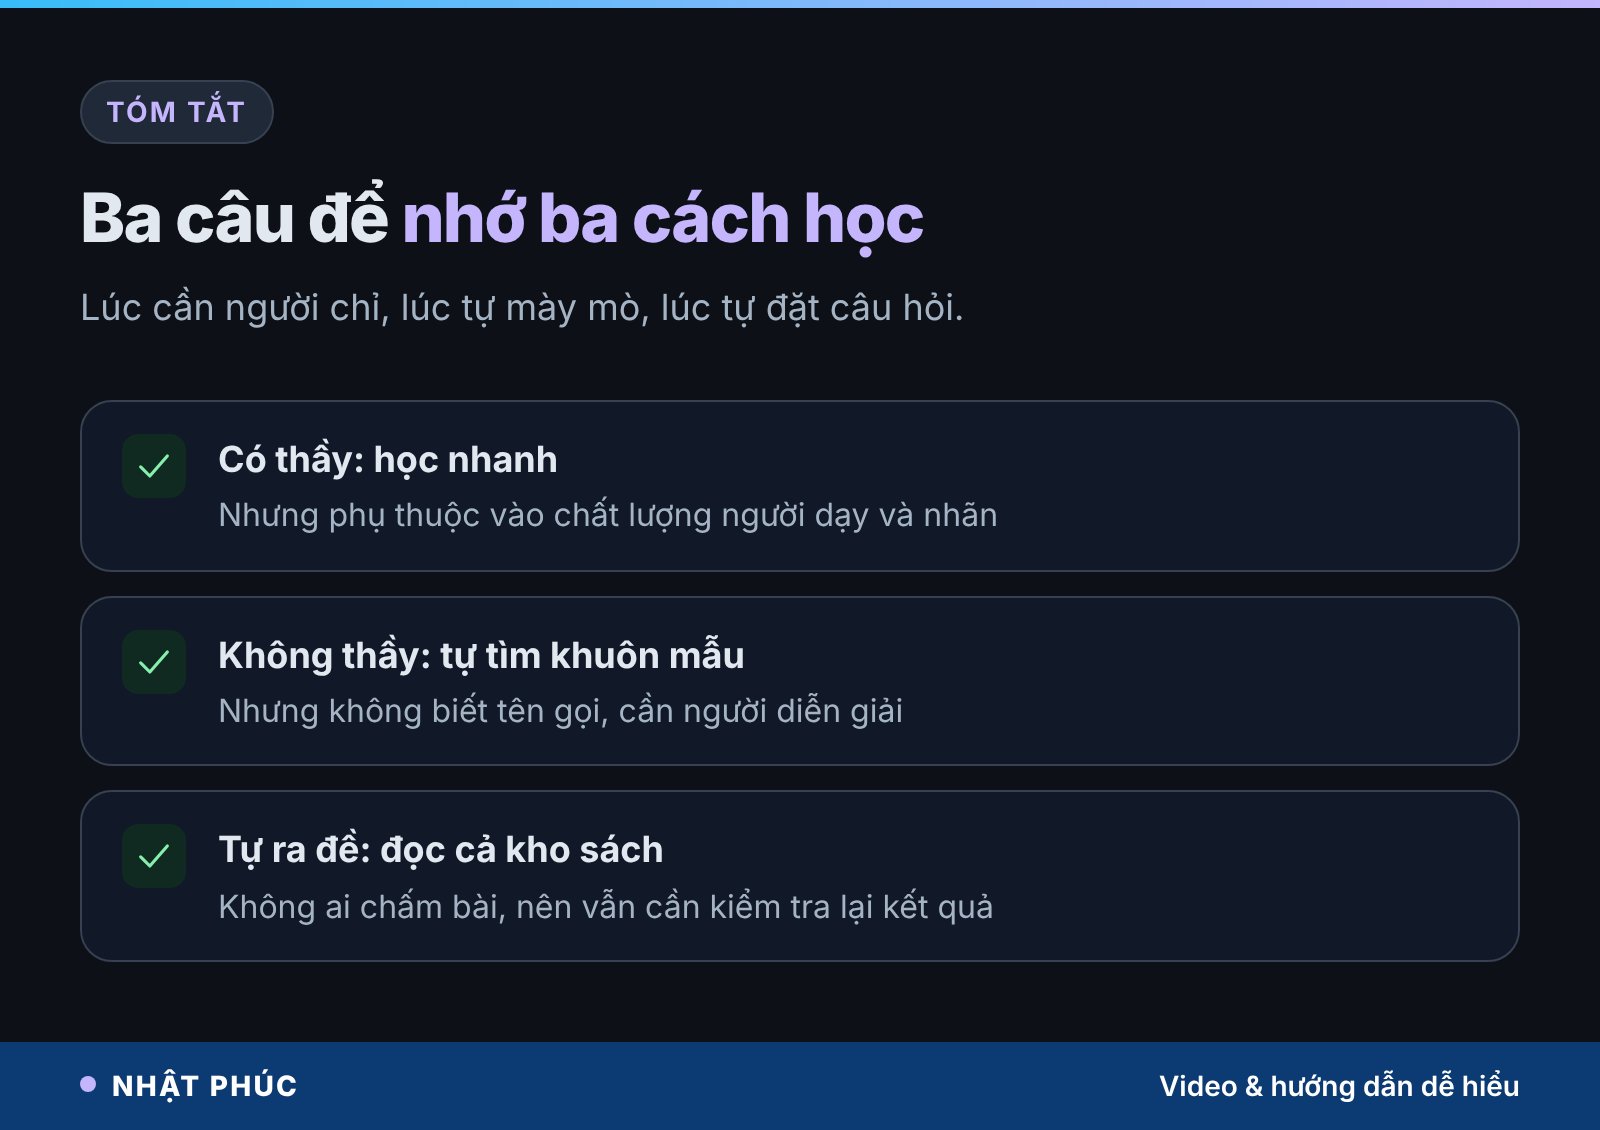
Tóm lại, học máy là gì? Là cách để máy tự rút ra quy luật từ dữ liệu, theo ba kiểu chính. Có thầy thì máy học nhanh, nhưng phụ thuộc vào người thầy. Không thầy thì máy tự tìm ra khuôn mẫu, nhưng không biết tên gọi. Tự ra đề thì máy đọc được cả kho sách của nhân loại mà không cần ai chấm bài.
Máy không học giống con người hoàn toàn, nhưng cách nó học gợi nhớ đến chính ta: lúc cần người chỉ, lúc tự mày mò, và lúc tự đặt câu hỏi cho mình. Đứa trẻ trong câu chuyện mở đầu học nhận ra con mèo nhờ người chỉ, nhưng phần lớn những gì nó biết là nhờ tự hỏi và tự kiểm tra. Máy có lẽ cũng vậy.
Bạn muốn Nhật Phúc giải thích chủ đề AI nào tiếp theo? Hãy để lại bình luận, và đừng quên theo dõi kênh YouTube Vọc Sĩ để không bỏ lỡ video mới.