Bạn hỏi một trợ lý AI ngay trên điện thoại, không cần mạng, mà câu trả lời vẫn khá mạch lạc. Phía sau sự tiện lợi đó thường có một kỹ thuật ít người để ý: chưng cất mô hình AI. Một mô hình khổng lồ chạy trên trung tâm dữ liệu đóng vai thầy giáo, kèm cặp một mô hình nhỏ hơn hàng chục lần cho tới khi trò trả lời gần giống thầy.
Câu trả lời ngắn: Chưng cất mô hình AI (knowledge distillation) là cách huấn luyện một mô hình nhỏ (học trò) bắt chước cách trả lời của một mô hình lớn (thầy giáo). Trò không học từ đáp án đúng/sai khô khan mà học cả mức độ tự tin của thầy với từng phương án, nhờ vậy nhỏ, nhanh, rẻ mà vẫn giữ phần lớn năng lực.
Bài viết này đi sâu vào riêng kỹ thuật chưng cất: nó hoạt động ra sao, vì sao các mô hình nhỏ nổi tiếng như Gemma, Llama 3.2 hay các bản DeepSeek-R1 Distill đều dùng nó, khác gì với lượng tử hóa và cắt tỉa, và vì sao nó đang trở thành chủ đề tranh cãi giữa các công ty AI.
Chưng cất là một trong ba cách nén mô hình được nhắc tới trong video “Lượng tử hóa là gì? Cách nén mô hình AI vừa túi điện thoại”. Nếu muốn nắm bức tranh chung trước, bạn có thể xem video giải thích ba cách nén mô hình AI (khoảng 3 phút rưỡi) rồi quay lại đọc phần mở rộng bên dưới.
Tóm tắt nhanh
- Chưng cất = mô hình lớn (thầy) dạy mô hình nhỏ (trò) bằng chính câu trả lời của nó.
- Bí quyết nằm ở “nhãn mềm”: trò học cả xác suất thầy gán cho các phương án sai, không chỉ đáp án đúng.
- Ý tưởng có từ năm 2006, được Geoffrey Hinton đặt tên phổ biến năm 2015; nay là nền của nhiều mô hình nhỏ.
- Chưng cất khác lượng tử hóa: nó tạo ra mô hình mới ít tham số hơn, còn lượng tử hóa chỉ lưu tham số gọn hơn. Hai cách thường dùng cùng nhau.
- Mặt trái: trò không vượt được thầy, kế thừa cả lỗi của thầy, và việc “chưng cất” mô hình của công ty khác qua API đang gây tranh cãi lớn.
Nội dung chính:
- Chưng cất mô hình AI là gì?
- Vì sao cần chưng cất khi đã có mô hình lớn?
- Chưng cất hoạt động thế nào: bí mật của nhãn mềm
- 3 kiểu chưng cất mô hình AI phổ biến
- Các cột mốc của kỹ thuật chưng cất
- Chưng cất, lượng tử hóa, cắt tỉa khác nhau thế nào?
- Ứng dụng thực tế của mô hình chưng cất
- Mặt trái: tranh cãi về “tấn công chưng cất”
- Hiểu lầm phổ biến và giới hạn
- Cách chọn và dùng mô hình chưng cất
- Câu hỏi thường gặp
Chưng cất mô hình AI là gì?
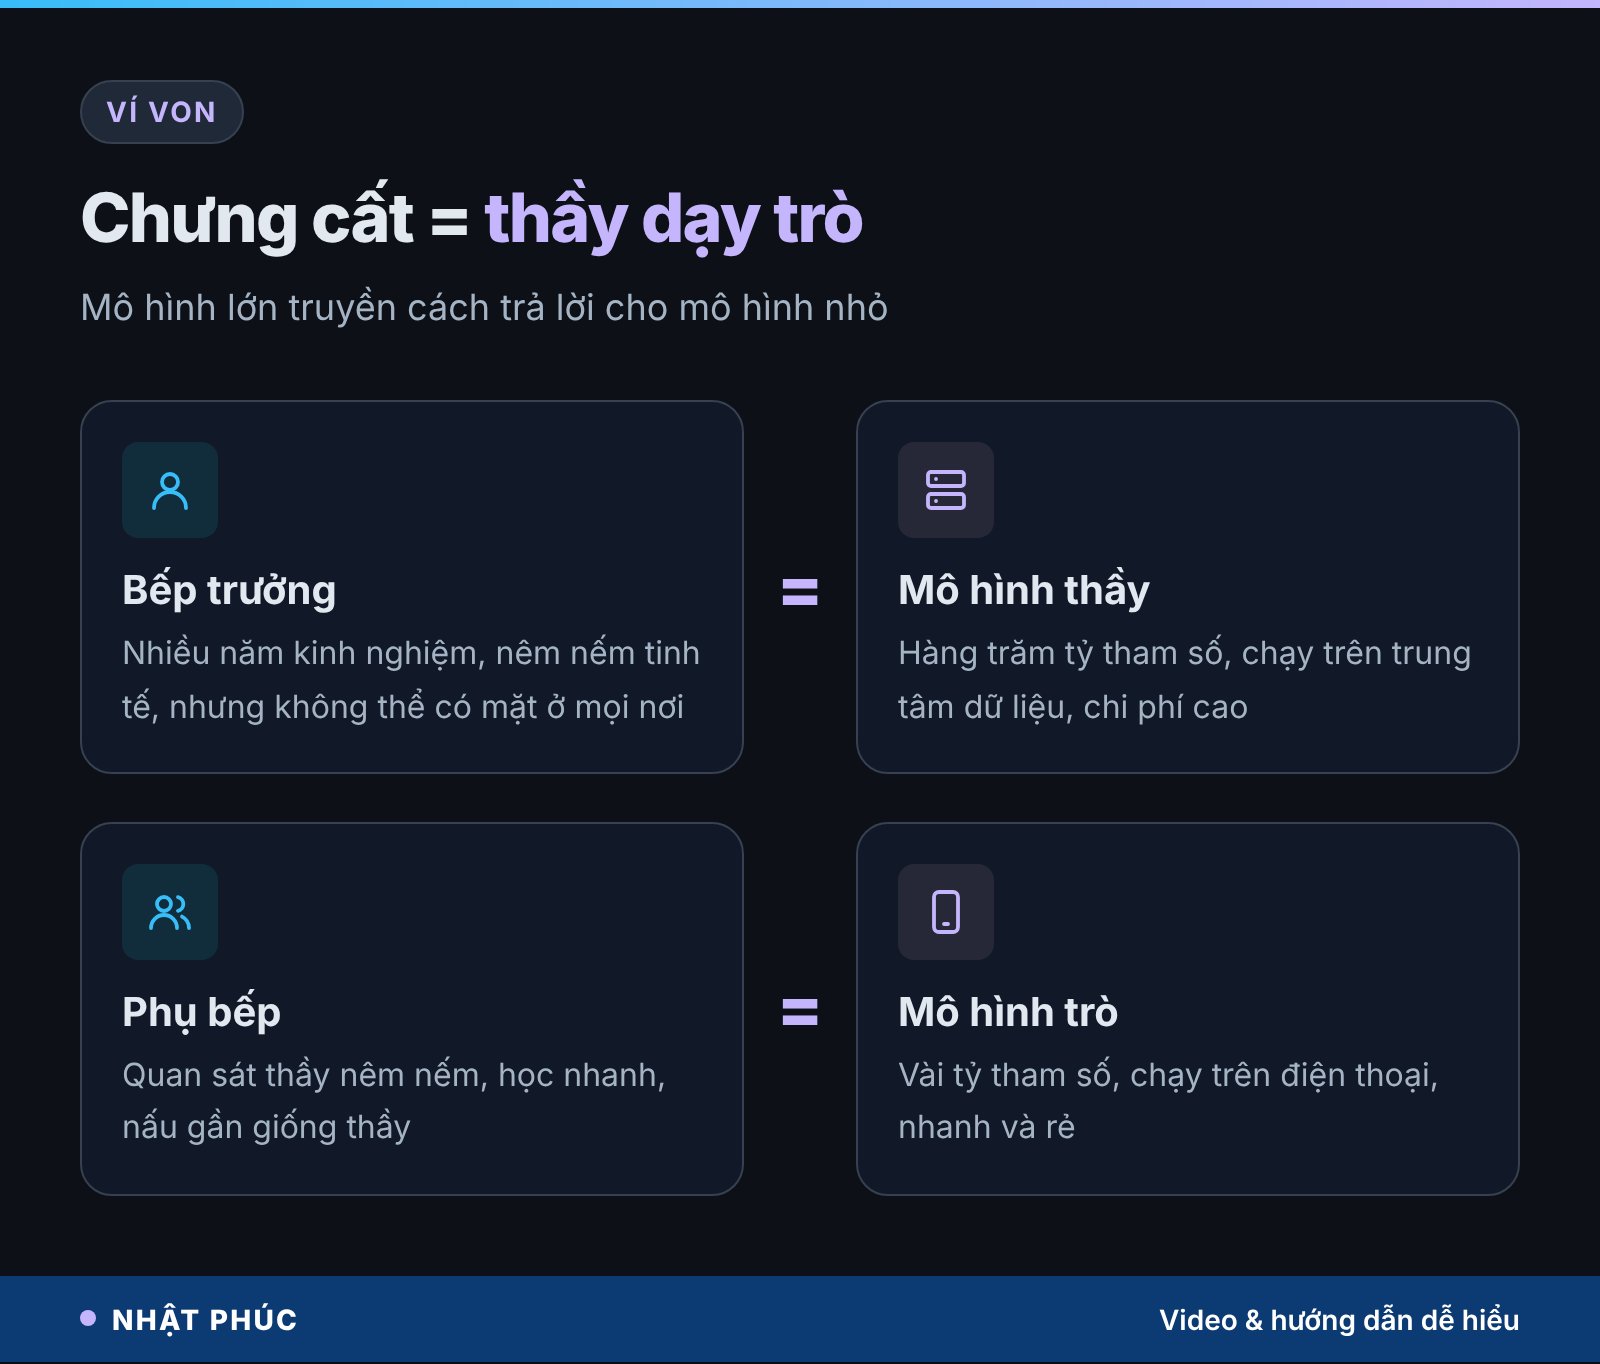
Hãy hình dung một bếp trưởng nhà hàng lớn có hàng chục năm kinh nghiệm. Ông không thể có mặt ở mọi chi nhánh, nên ông kèm một phụ bếp trẻ. Phụ bếp không cần đọc lại cả thư viện sách nấu ăn mà ông từng đọc. Cậu chỉ cần đứng cạnh, quan sát ông nêm nếm từng món, nghe ông giải thích “món này hơi mặn một chút thì được, nhưng chua là hỏng”. Sau vài tháng, cậu nấu được gần giống thầy với thời gian học ngắn hơn rất nhiều.
Chưng cất mô hình AI hoạt động đúng theo tinh thần ấy. Mô hình thầy (teacher model) là một mô hình lớn, đã được huấn luyện tốn kém trên lượng dữ liệu khổng lồ. Mô hình trò (student model) nhỏ hơn nhiều, có ít tham số hơn. Thay vì tự học lại từ đầu, trò được huấn luyện để bắt chước đầu ra của thầy.
Chữ “chưng cất” (distillation) được chọn rất khéo. Giống như chưng cất rượu hay tinh dầu: đun một lượng lớn nguyên liệu, giữ lại phần tinh tuý, bỏ phần nước thừa. Ở đây, “nguyên liệu” là hàng chục, hàng trăm tỷ tham số của thầy; “tinh dầu” là cách ra quyết định mà trò gói gọn được trong vài tỷ tham số.
Điểm cần nhớ: chưng cất không làm “co” mô hình thầy lại. Kết quả là một mô hình hoàn toàn mới, có kiến trúc nhỏ hơn, được dạy lại. Đây là điểm khác căn bản với lượng tử hóa mà video đã giải thích, nơi mô hình vẫn là mô hình cũ, chỉ có từng con số được lưu gọn hơn.
Vì sao cần chưng cất khi đã có mô hình lớn?
Mô hình lớn giỏi thật, nhưng đắt ở mọi khâu. Như video đã tính, chỉ một mô hình 7 tỷ tham số lưu ở 16 bit đã chiếm khoảng 14 GB bộ nhớ. Các mô hình hàng đầu còn lớn hơn thế hàng chục lần, cần cả cụm GPU để trả lời một câu hỏi. Mỗi lượt trả lời tiêu tốn điện, thời gian và tiền thuê máy chủ.
Trong khi đó, rất nhiều việc hằng ngày không cần tới “giáo sư”: phân loại email, tóm tắt tin nhắn, gợi ý trả lời nhanh, trích thông tin từ hoá đơn, trả lời câu hỏi thường gặp của khách hàng. Dùng mô hình khổng lồ cho các việc này giống như thuê bếp trưởng năm sao để luộc trứng.
Bốn lợi ích chính
- Nhanh hơn: ít tham số thì ít phép tính cho mỗi chữ sinh ra, phản hồi gần như tức thì.
- Rẻ hơn: chạy được trên GPU nhỏ, thậm chí CPU, nên chi phí mỗi lượt trả lời giảm mạnh.
- Chạy được trên thiết bị: điện thoại, laptop, camera, robot có thể tự xử lý mà không cần gửi dữ liệu lên mây, tốt hơn cho quyền riêng tư.
- Giữ phần lớn năng lực: nhờ học từ thầy, trò thường giỏi hơn hẳn một mô hình cùng kích cỡ tự học từ đầu.
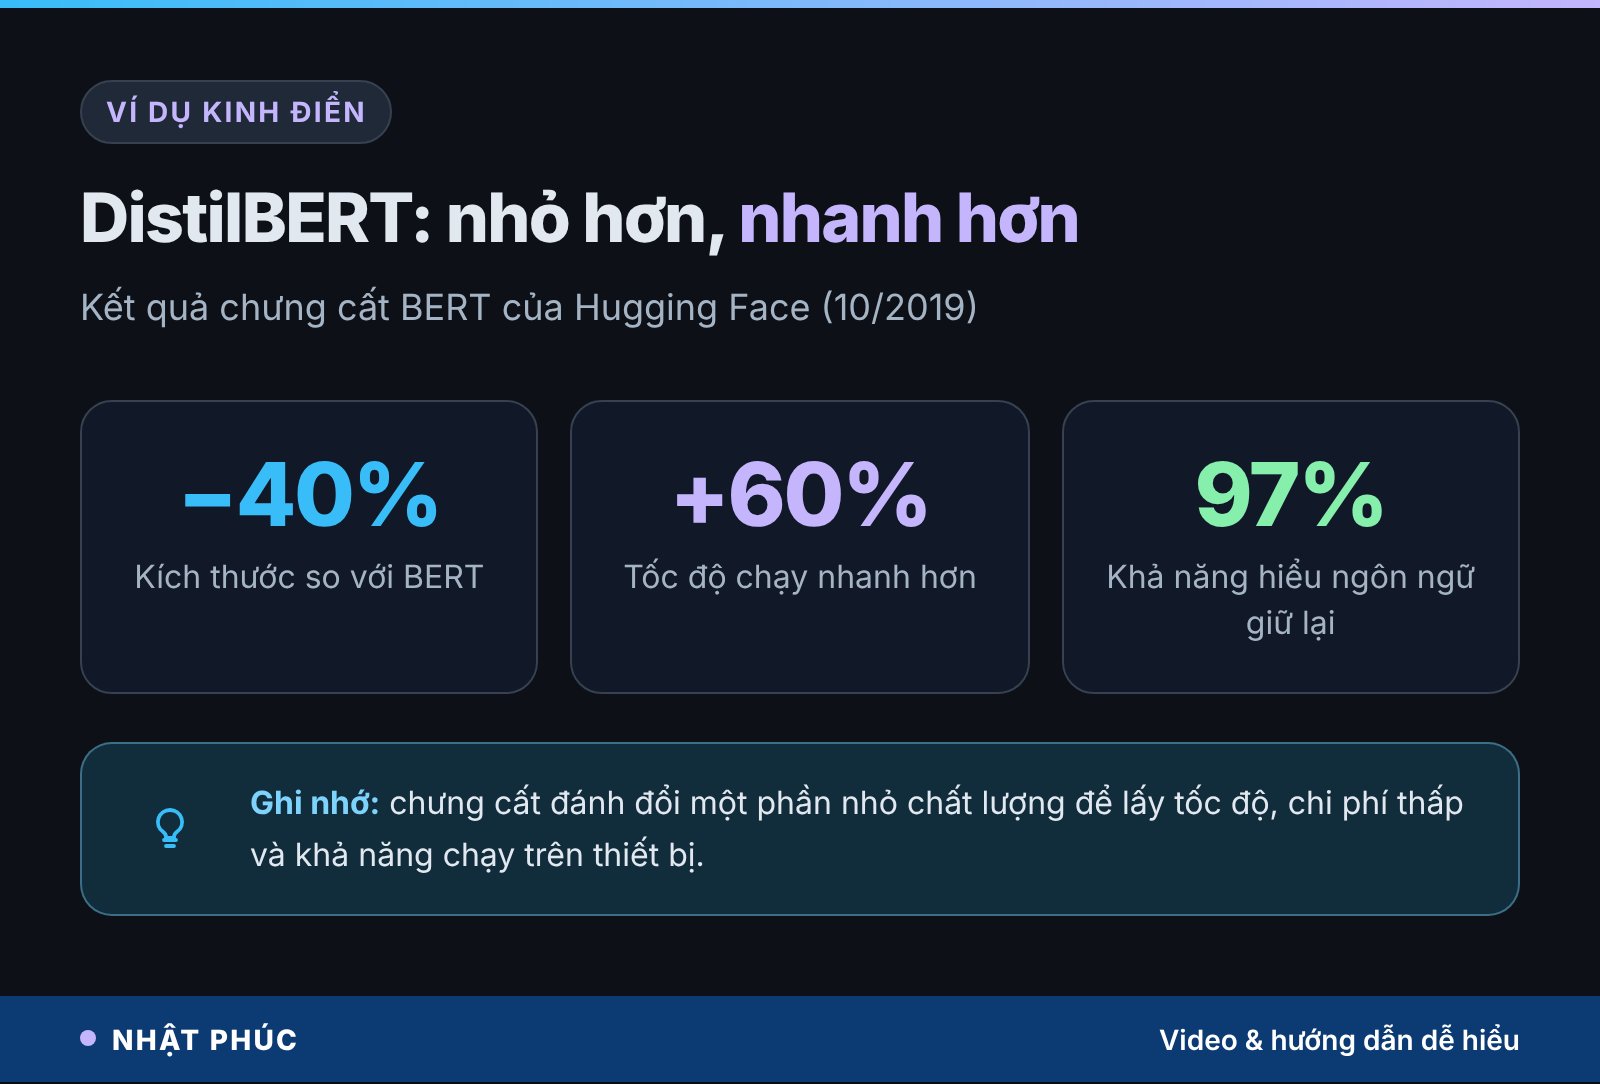
Ví dụ kinh điển là DistilBERT do Hugging Face công bố tháng 10/2019: mô hình trò nhỏ hơn BERT khoảng 40%, chạy nhanh hơn khoảng 60% nhưng giữ được khoảng 97% khả năng hiểu ngôn ngữ trên bộ bài kiểm tra chuẩn. Đó là lý do chưng cất trở thành công cụ quen thuộc mỗi khi cần đưa AI vào sản phẩm thật.
Chưng cất hoạt động thế nào: bí mật của nhãn mềm
Để hiểu vì sao trò học từ thầy lại hiệu quả hơn tự học, hãy xem cách một mô hình AI trả lời. Khi nhận diện một bức ảnh, mô hình không nói gọn “đây là con chó”. Nó đưa ra một danh sách xác suất cho mọi phương án mà nó biết.
Nhãn cứng và nhãn mềm
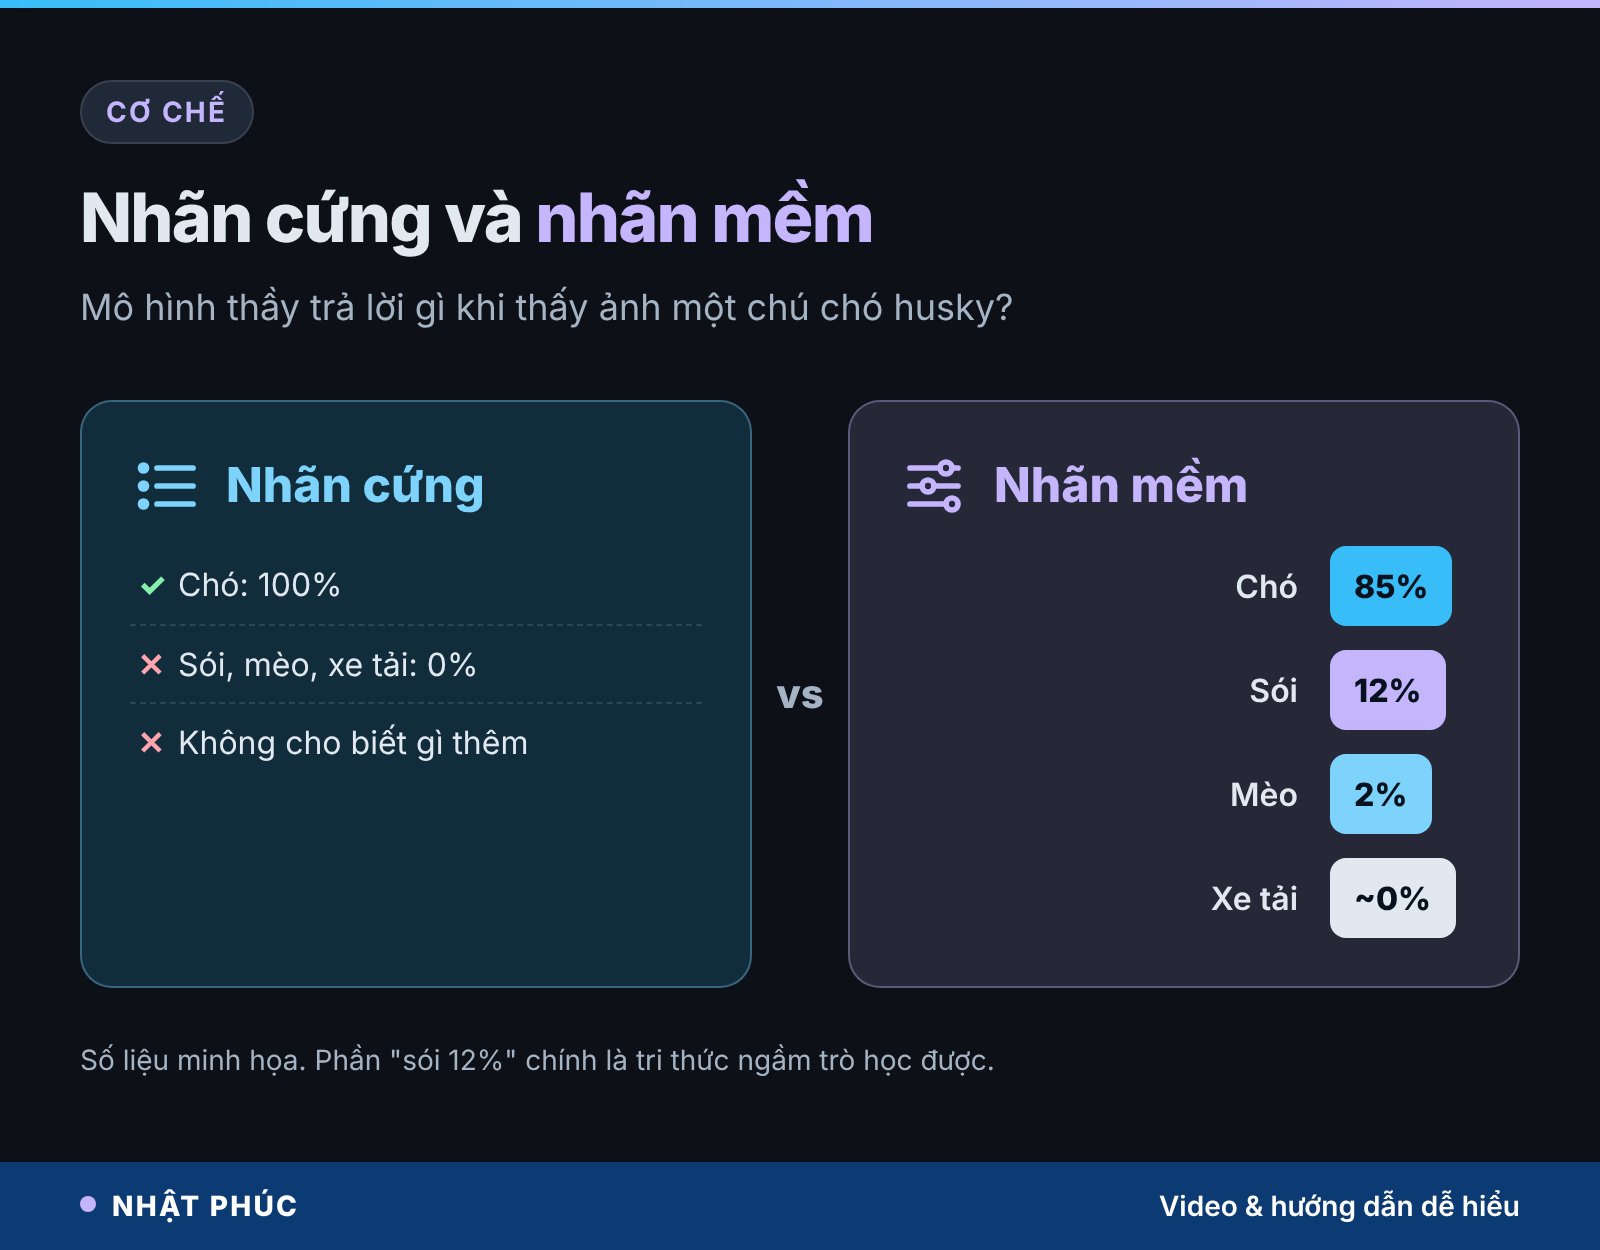
Giả sử ảnh là một chú chó husky. Dữ liệu huấn luyện thông thường chỉ ghi một nhãn cứng (hard label): “chó”. Mọi phương án khác bằng 0. Nhưng mô hình thầy đã học kỹ thì trả lời tinh tế hơn, ví dụ (số liệu minh họa): chó 85%, sói 12%, mèo 2%, xe tải gần như 0%.
Danh sách xác suất đó gọi là nhãn mềm (soft label). Nó chứa một lượng thông tin mà nhãn cứng không có: husky trông khá giống sói, hơi giống mèo, và chẳng liên quan gì tới xe tải. Hinton gọi phần thông tin ẩn này là “tri thức ngầm” (dark knowledge). Trò học theo nhãn mềm sẽ hiểu được cả mối quan hệ giữa các khái niệm, thay vì chỉ thuộc lòng đáp án.
Vai trò của “nhiệt độ”
Mô hình thầy thường rất tự tin, đáp án đúng chiếm gần 100% và các phương án khác chỉ còn vài phần nghìn. Khi đó tri thức ngầm bị chìm. Hinton và cộng sự đề xuất làm “mềm” phân bố xác suất bằng một tham số gọi là nhiệt độ (temperature). Nhiệt độ càng cao, các xác suất càng được dàn đều, phương án phụ hiện rõ hơn để trò học. Khi dùng thật, mô hình trò lại chạy ở nhiệt độ bình thường.
Quy trình 4 bước
- Chuẩn bị thầy: một mô hình lớn đã huấn luyện xong, chất lượng cao.
- Cho thầy trả lời: đưa một tập dữ liệu (có thể chưa gắn nhãn) qua thầy để lấy nhãn mềm hoặc câu trả lời đầy đủ.
- Huấn luyện trò: trò cố gắng cho ra đầu ra càng giống thầy càng tốt, thường kết hợp thêm nhãn cứng nếu có.
- Kiểm tra và tinh chỉnh: so trò với thầy trên bộ bài kiểm tra, điều chỉnh kích cỡ hoặc dữ liệu nếu khoảng cách còn lớn.
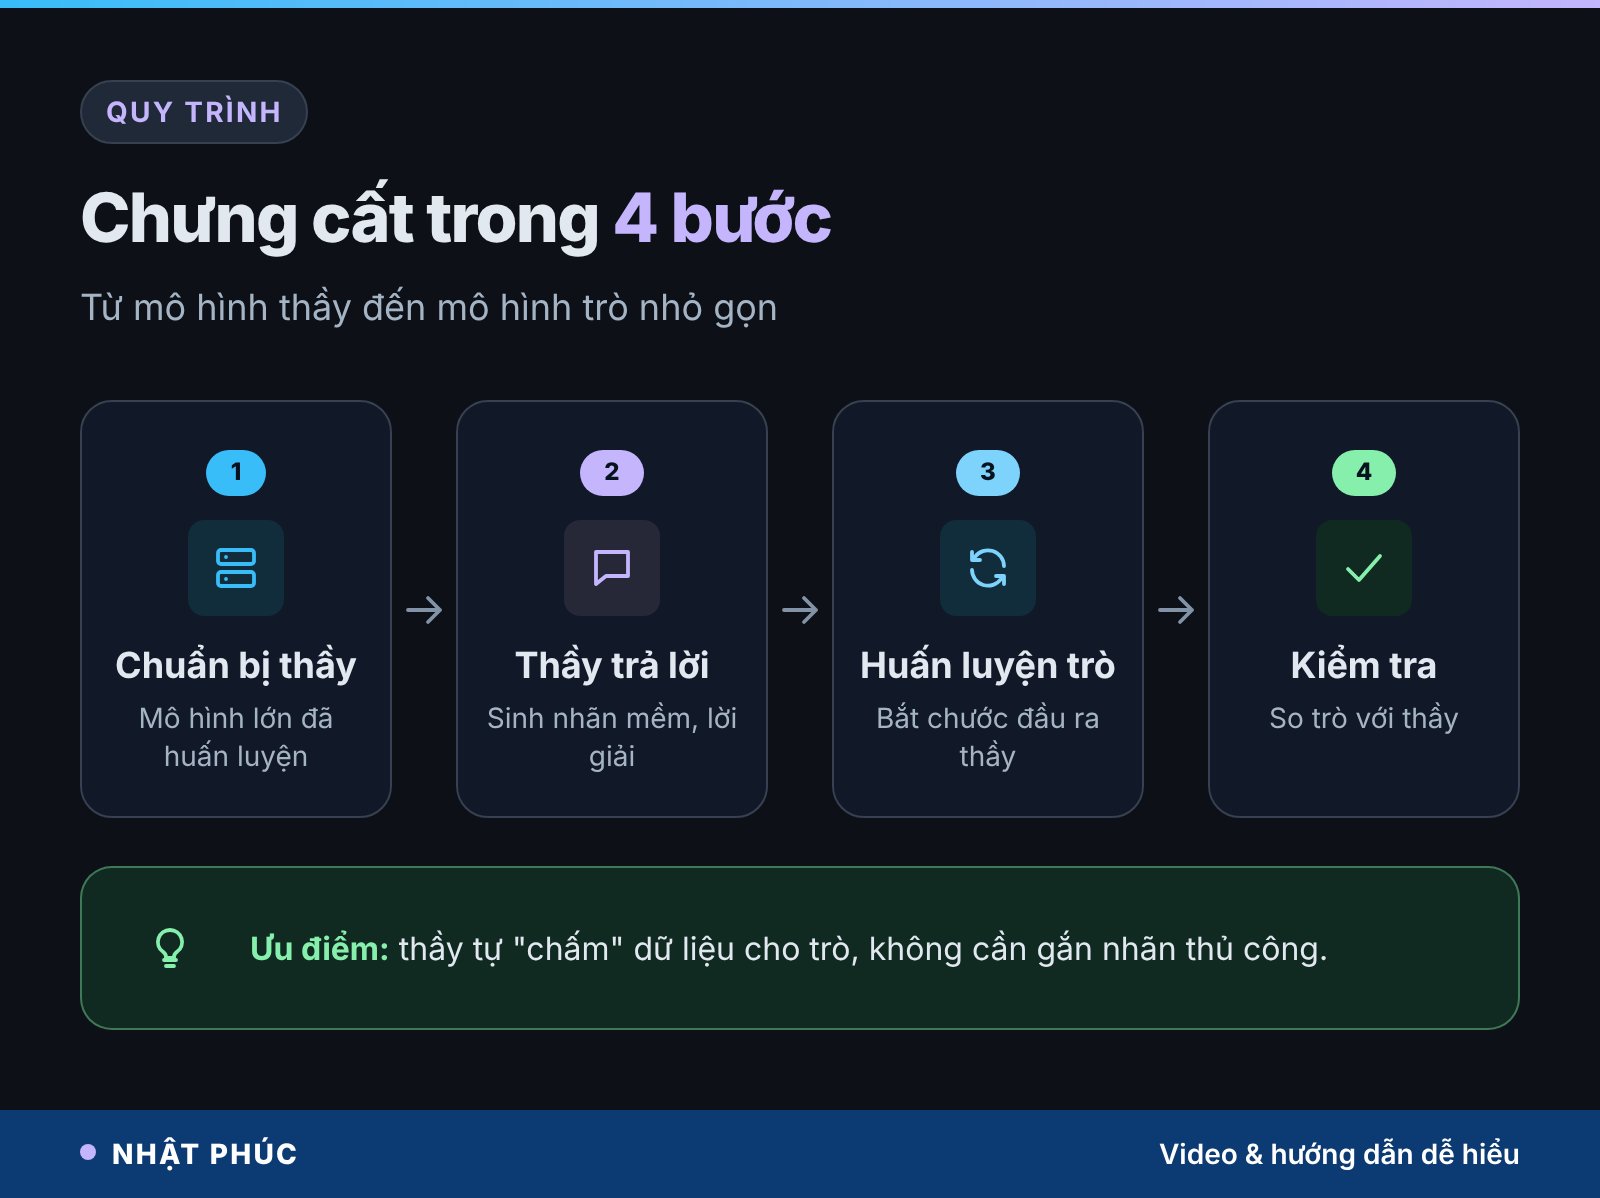
Một ưu điểm ít người để ý: bước 2 không bắt buộc phải có dữ liệu gắn nhãn sẵn. Thầy tự “chấm” cho trò, nên người làm có thể dùng văn bản thô số lượng lớn, tiết kiệm công gắn nhãn thủ công.
3 kiểu chưng cất mô hình AI phổ biến
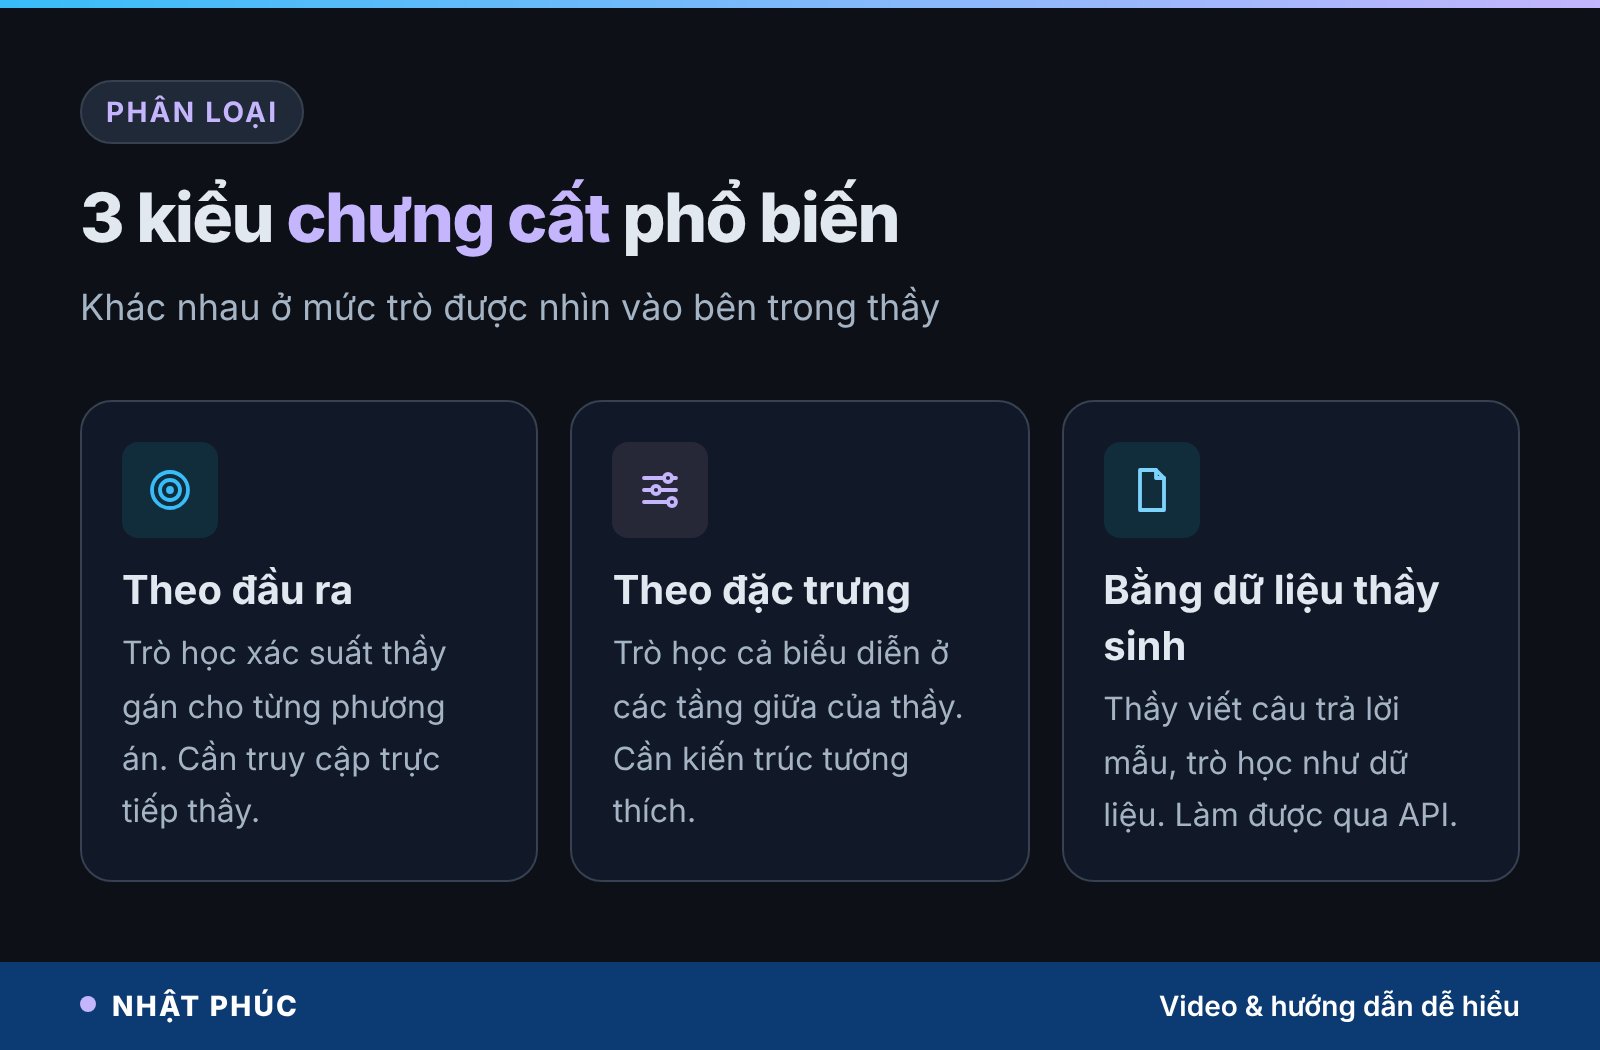
Tuỳ việc trò được nhìn thấy bao nhiêu “bên trong” thầy, người ta chia chưng cất thành vài kiểu chính.
1. Chưng cất theo đầu ra (logit)
Đây là kiểu gốc của Hinton: trò học theo phân bố xác suất cuối cùng của thầy. Với mô hình ngôn ngữ, điều này nghĩa là ở mỗi vị trí, trò học theo xác suất thầy gán cho từng token tiếp theo, không chỉ token được chọn. Cách này cần quyền truy cập trực tiếp vào mô hình thầy, nên thường do chính công ty sở hữu thầy thực hiện.
2. Chưng cất theo đặc trưng trung gian
Trò không chỉ học đáp án mà còn học cách thầy “suy nghĩ” ở các tầng giữa, ví dụ cố gắng tạo ra biểu diễn bên trong giống thầy. Giống phụ bếp không chỉ nếm món cuối mà còn quan sát cả cách thầy sơ chế. Kiểu này cho kết quả tốt nhưng đòi hỏi hai kiến trúc tương thích.
3. Chưng cất bằng dữ liệu do thầy sinh ra
Với mô hình ngôn ngữ lớn hiện nay, cách phổ biến nhất là cho thầy viết ra thật nhiều câu trả lời mẫu, kèm cả lời giải từng bước, rồi dùng chúng để huấn luyện trò như dữ liệu tinh chỉnh bình thường. Cách này chỉ cần đọc được văn bản đầu ra, nên có thể làm qua API, kể cả với mô hình của công ty khác. Đây cũng là gốc rễ của các tranh cãi ở phần sau.
Trên thực tế, các phòng thí nghiệm lớn thường trộn nhiều kiểu, và hay kết hợp chưng cất với cắt tỉa: cắt bớt một mô hình lớn thành khung nhỏ hơn, rồi dùng chính mô hình gốc làm thầy để “dạy lại” phần năng lực bị mất.
Các cột mốc của kỹ thuật chưng cất
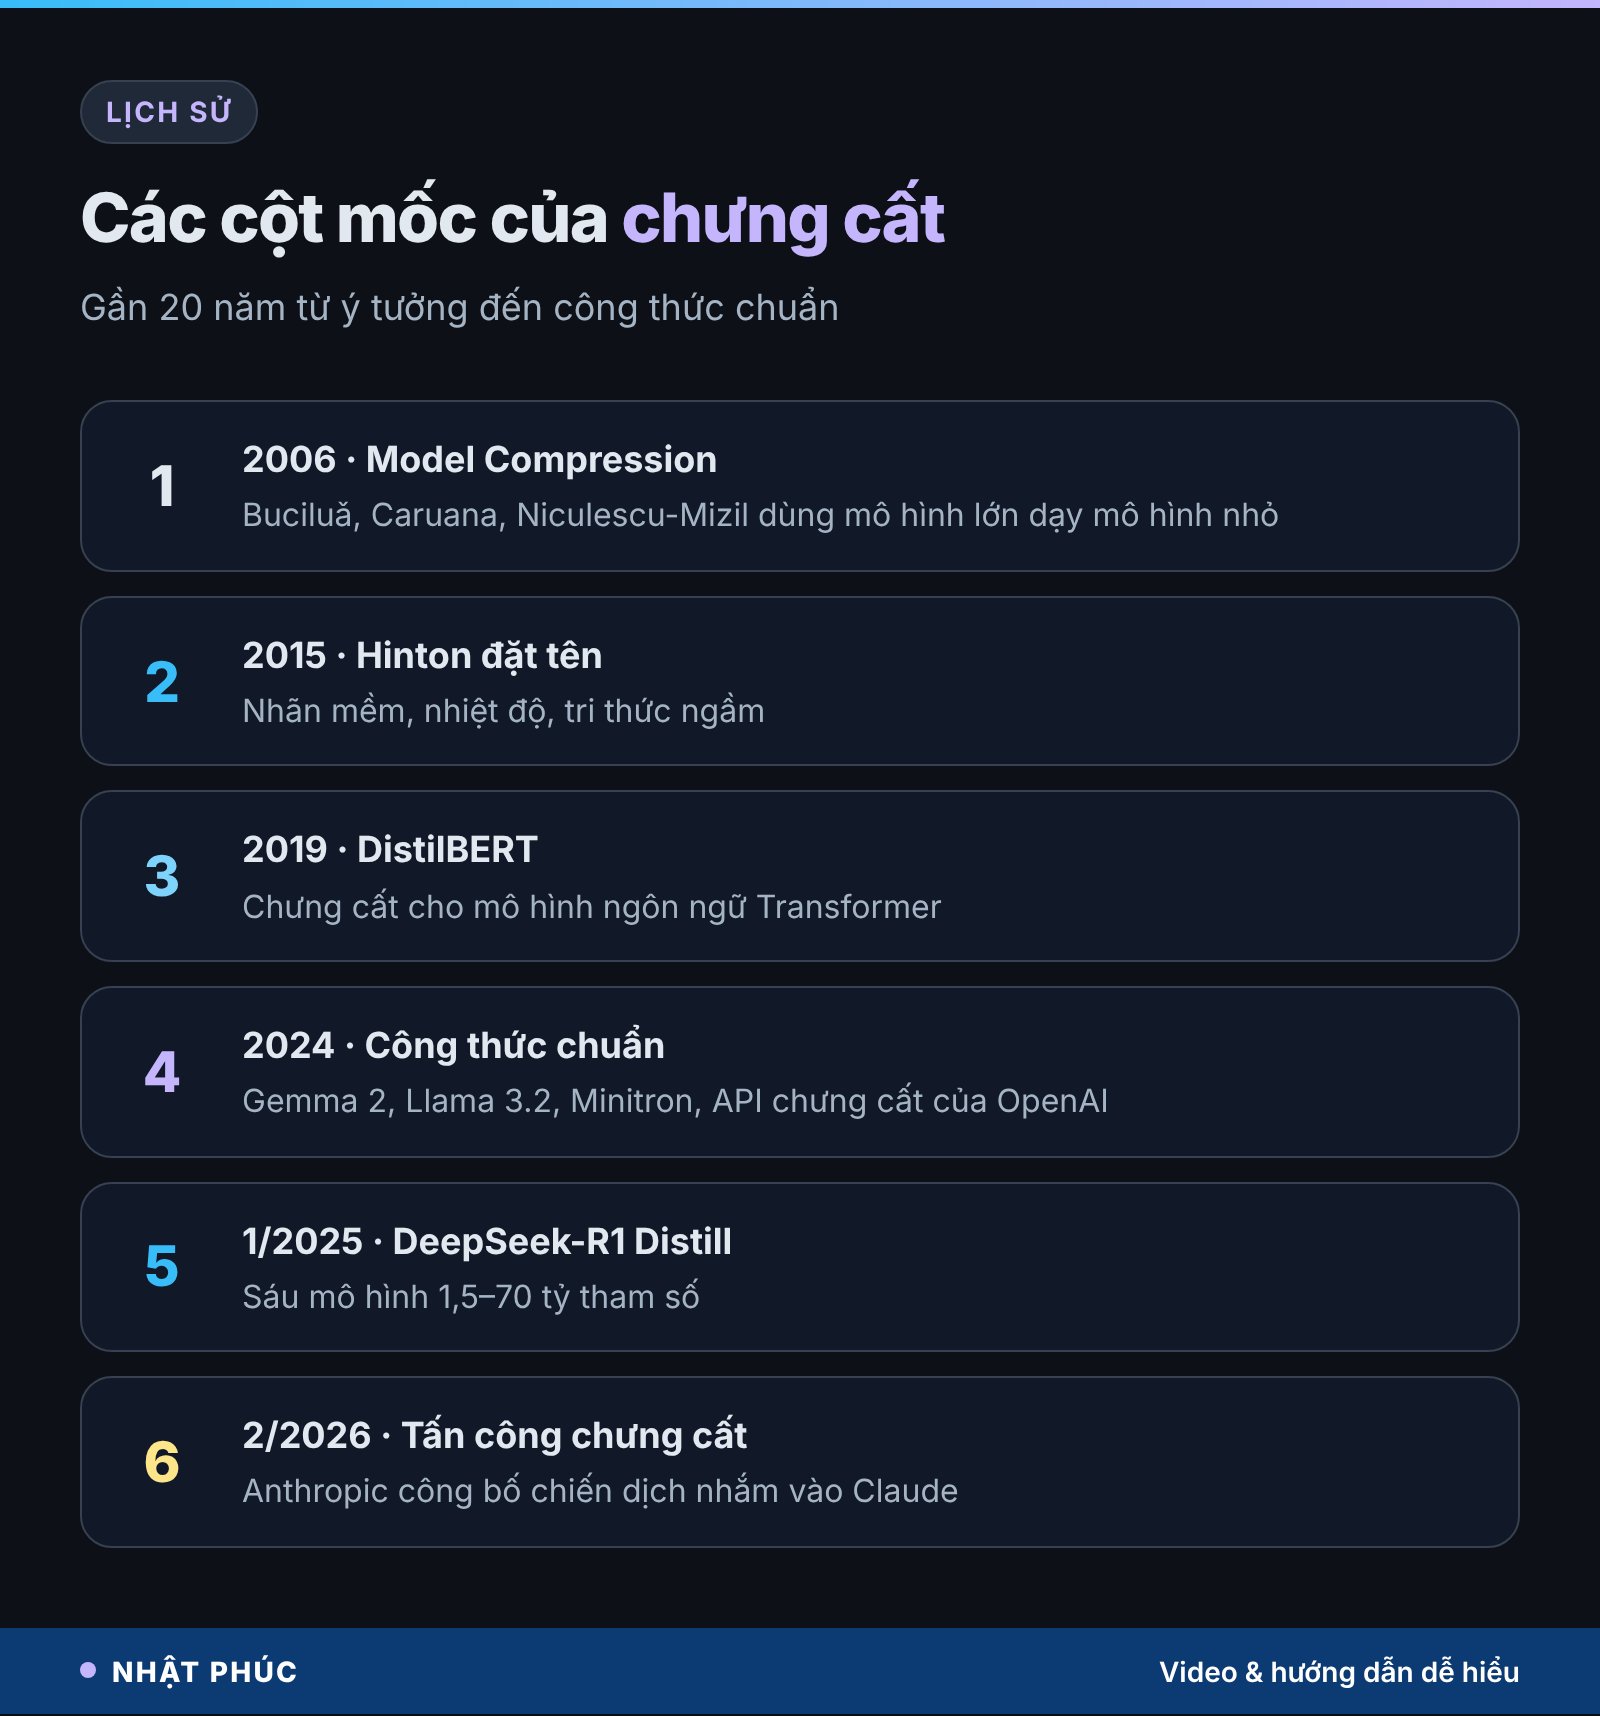
Chưng cất không phải phát minh của thời chatbot. Ý tưởng đã có gần 20 năm và lớn dần theo kích cỡ của chính các mô hình AI.
- 2006: Cristian Buciluǎ, Rich Caruana và Alexandru Niculescu-Mizil công bố bài “Model Compression”, dùng một mô hình lớn gắn nhãn dữ liệu để huấn luyện mô hình nhỏ, nhanh hơn.
- 2015: Geoffrey Hinton, Oriol Vinyals và Jeff Dean công bố “Distilling the Knowledge in a Neural Network”, đặt tên “chưng cất”, đưa ra nhãn mềm và nhiệt độ. Đây là bài được trích dẫn nhiều nhất về chủ đề này.
- 2019: DistilBERT (Hugging Face) cho thấy chưng cất áp dụng được cho mô hình ngôn ngữ dạng Transformer.
- 2024: chưng cất trở thành công thức chuẩn cho mô hình nhỏ. Google công bố các bản Gemma 2 cỡ nhỏ được huấn luyện bằng chưng cất; Meta dùng đầu ra của Llama 3.1 8B và 70B để dạy Llama 3.2 1B và 3B; NVIDIA cắt tỉa rồi chưng cất Llama 3.1 8B thành bản 4B (Minitron). Tháng 10/2024, OpenAI cũng đưa tính năng chưng cất vào nền tảng API của mình.
- 1/2025: DeepSeek phát hành R1 kèm sáu mô hình “R1-Distill” từ 1,5 đến 70 tỷ tham số, dạy từ khoảng 800.000 mẫu do R1 sinh ra, đưa khả năng suy luận từng bước xuống các mô hình chạy được trên máy cá nhân.
- 2/2026: Anthropic công bố phát hiện các chiến dịch chưng cất trái phép quy mô lớn nhắm vào Claude, đưa chủ đề này thành vấn đề an ninh của ngành.
Chưng cất, lượng tử hóa, cắt tỉa khác nhau thế nào?
Video đã giới thiệu ba cách nén mô hình. Chúng thường bị gộp chung là “làm mô hình nhỏ lại”, nhưng mỗi cách tác động vào một chỗ khác nhau. Hiểu đúng giúp bạn đọc tên mô hình trên các kho tải và chọn bản phù hợp.
- Lượng tử hóa giữ nguyên số tham số, chỉ lưu mỗi con số bằng ít bit hơn (16 bit xuống 8 hoặc 4 bit). Giống đổi thước chia milimét sang thước chia centimet.
- Cắt tỉa bỏ bớt những kết nối hoặc cả tầng ít quan trọng. Giống người làm vườn tỉa cành.
- Chưng cất dạy một mô hình mới, nhỏ hơn từ đầu, bằng câu trả lời của mô hình lớn.
- Tinh chỉnh (fine-tuning) thì không nhằm nén: nó dạy thêm cho mô hình kỹ năng hoặc kiến thức chuyên ngành, kích cỡ giữ nguyên.
| Kỹ thuật | Làm gì với mô hình | Cần huấn luyện lại? | Dùng khi |
|---|---|---|---|
| Chưng cất | Tạo mô hình mới ít tham số hơn | Có, khá tốn kém | Cần mô hình nhỏ, nhanh cho sản phẩm |
| Lượng tử hóa | Lưu tham số bằng ít bit hơn | Thường không | Muốn chạy nhanh mô hình có sẵn trên máy yếu |
| Cắt tỉa | Bỏ kết nối hoặc tầng ít dùng | Thường cần tinh chỉnh lại | Giảm tính toán, hay đi kèm chưng cất |
| Tinh chỉnh | Dạy thêm kỹ năng, giữ kích cỡ | Có, ít dữ liệu | Cần AI giỏi một việc chuyên biệt |
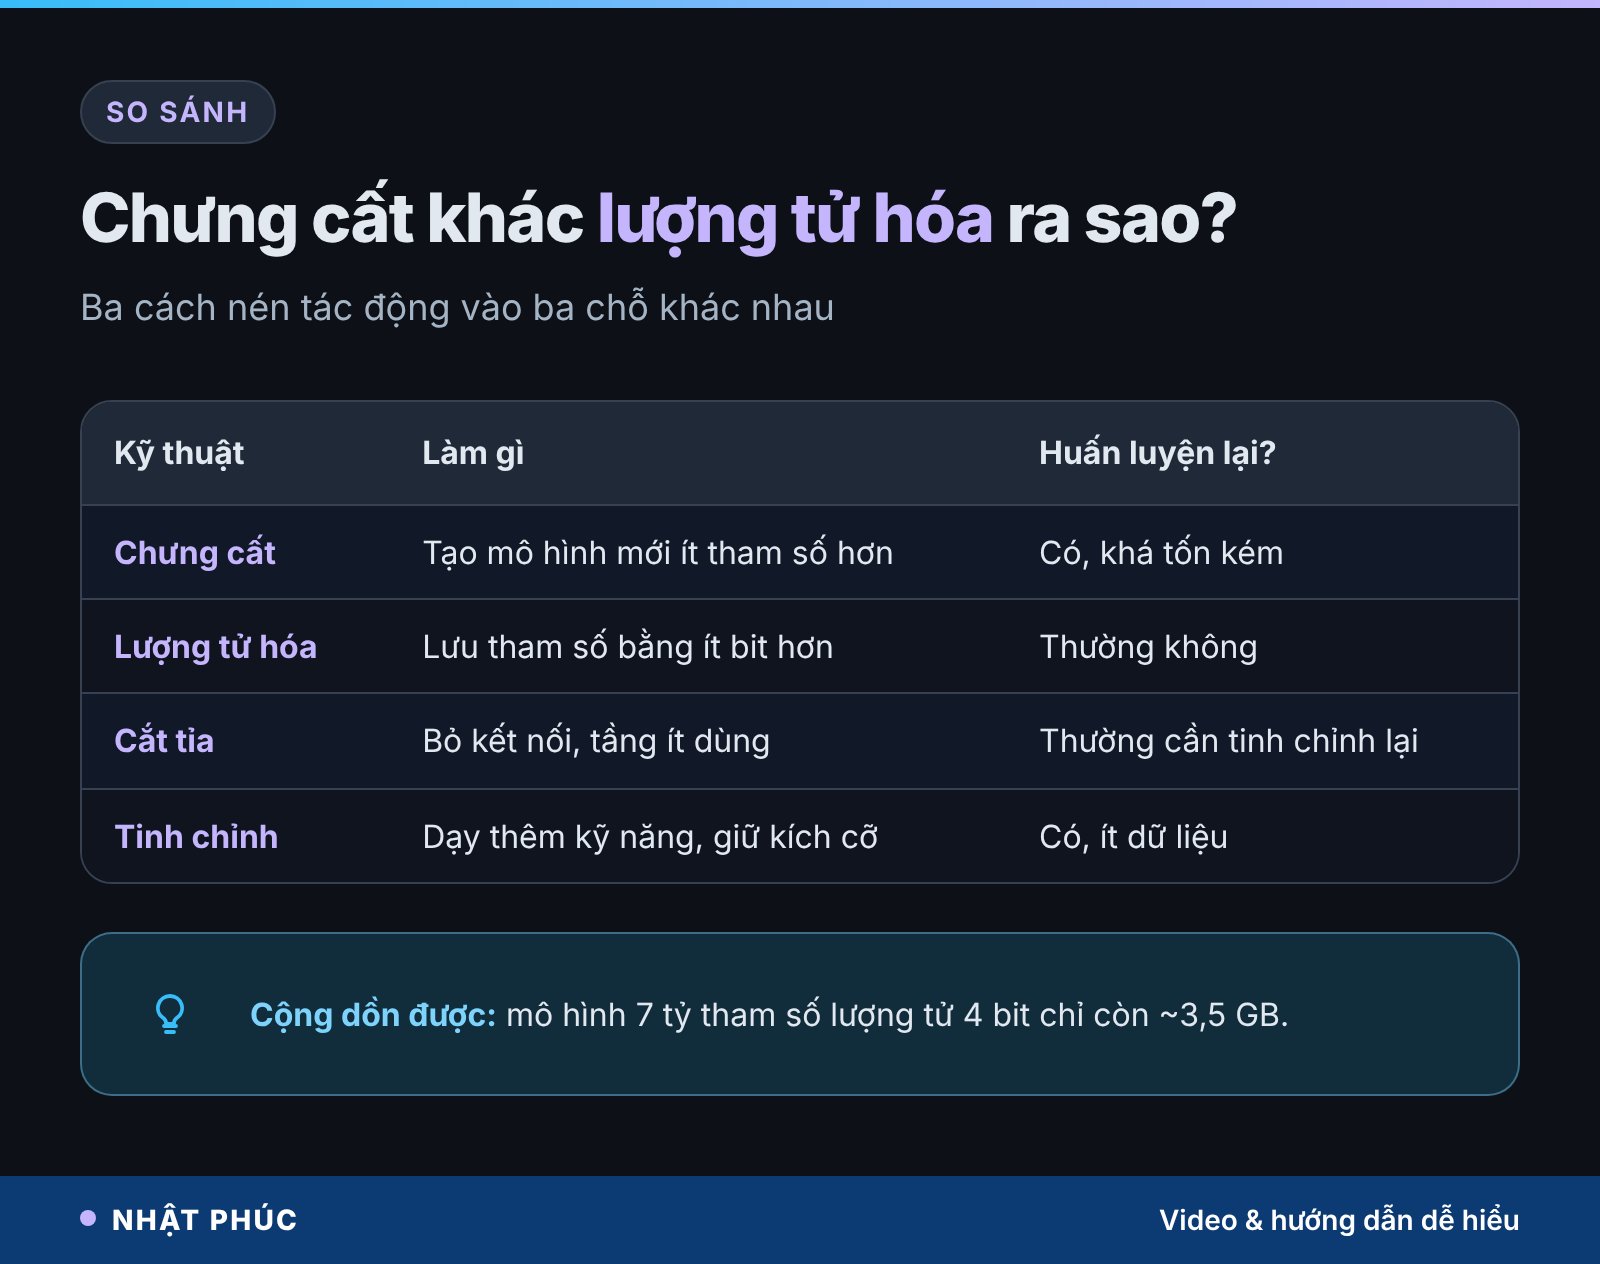
Điều thú vị là các cách này cộng dồn được. Một mô hình 7 tỷ tham số được chưng cất từ mô hình lớn, sau đó lượng tử hóa xuống 4 bit, chỉ còn khoảng 3,5 GB mà vẫn mang “dấu vân tay” năng lực của người thầy lớn hơn nhiều. Phần lớn mô hình nhỏ bạn tải về máy hôm nay đều đã đi qua cả hai bước. Nếu muốn tìm hiểu tinh chỉnh kỹ hơn, xem bài fine-tuning là gì trên Nhật Phúc.
Ứng dụng thực tế của mô hình chưng cất
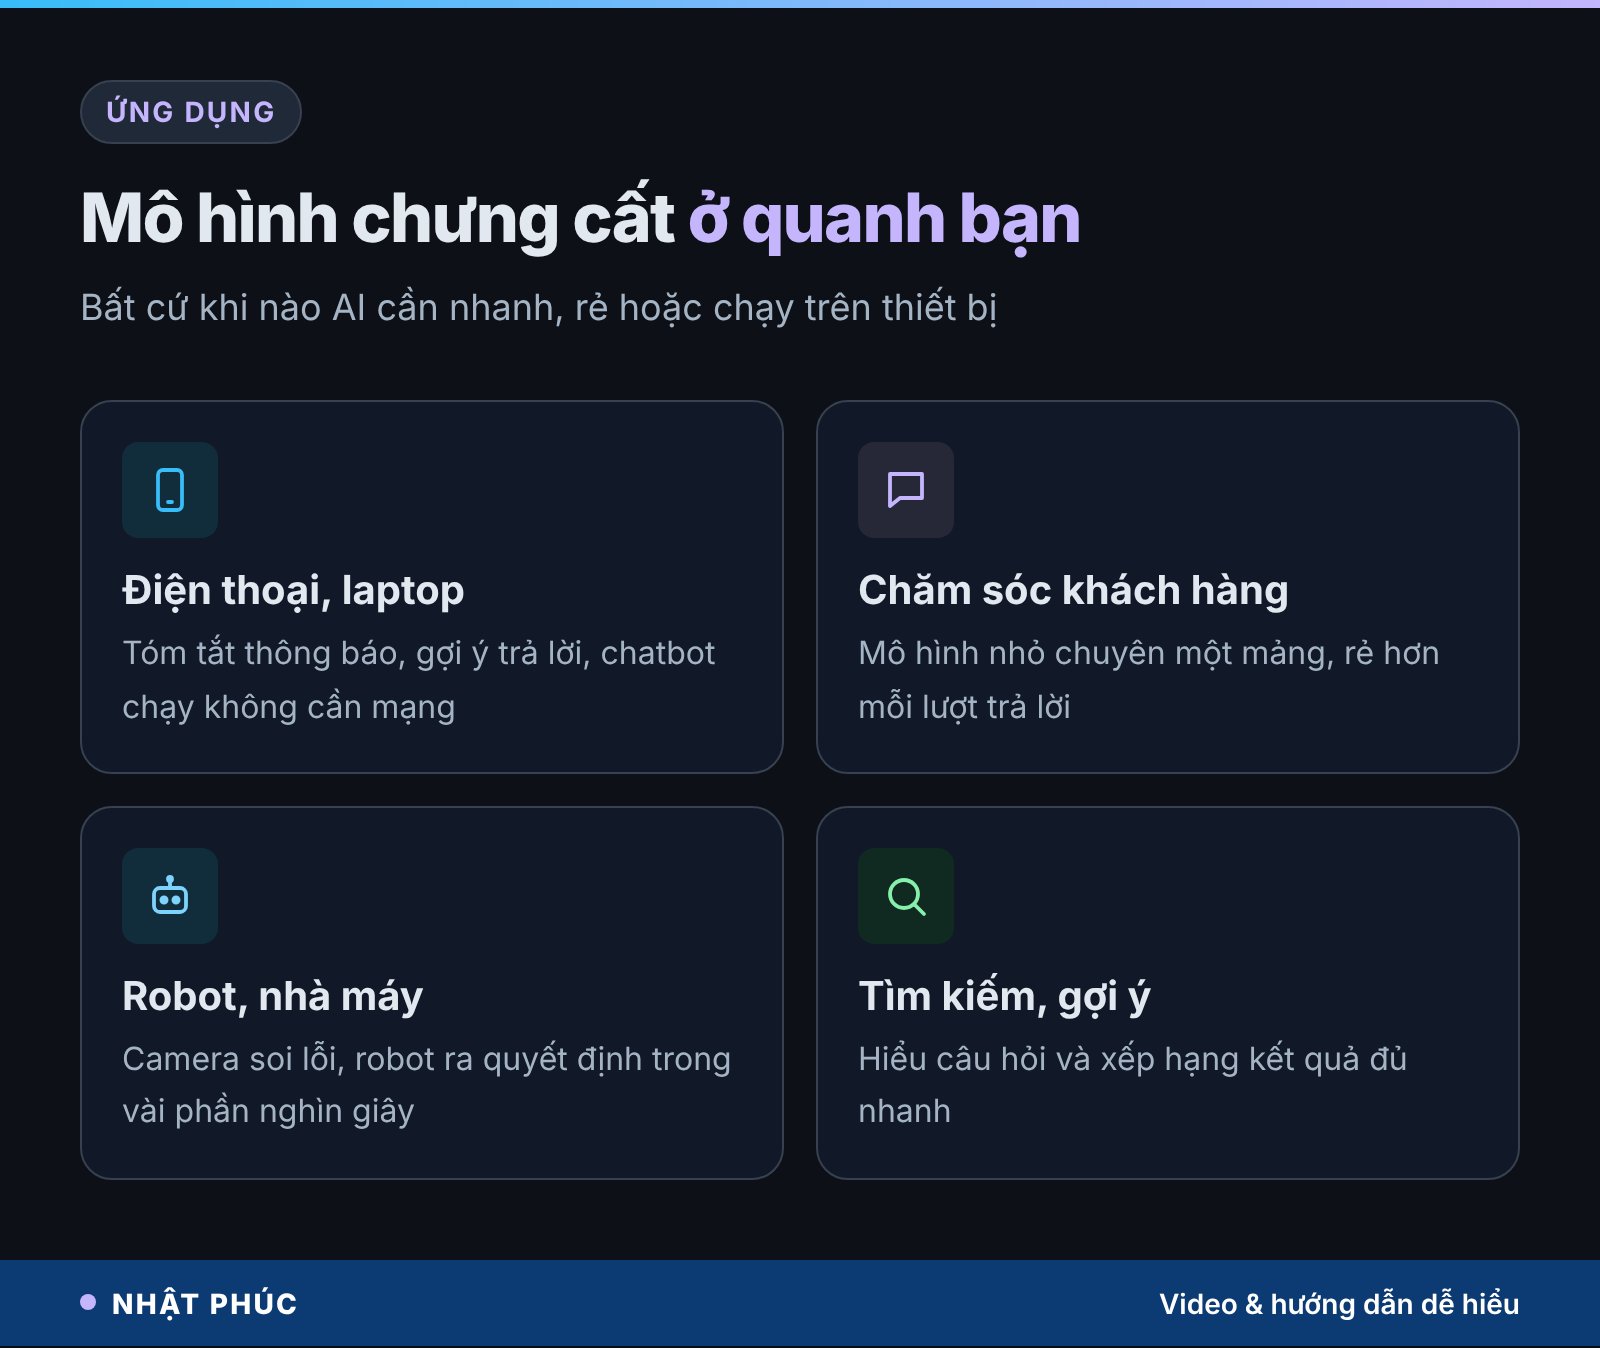
Bạn có thể đang dùng mô hình chưng cất hằng ngày mà không biết. Bất cứ khi nào AI cần chạy nhanh, rẻ hoặc chạy trên thiết bị, chưng cất thường có mặt.
Trên điện thoại và máy tính cá nhân
Trợ lý viết lại câu, tóm tắt thông báo, gợi ý trả lời tin nhắn trên điện thoại đều cần mô hình đủ nhỏ để nằm trong vài GB bộ nhớ. Chưng cất giúp các mô hình này “thông minh hơn kích cỡ của mình”. Trên máy tính, các bản DeepSeek-R1 Distill hay Llama 3.2 cỡ nhỏ là lựa chọn quen thuộc của người muốn chạy AI không cần mạng. Nhật Phúc có bài hướng dẫn AI trên thiết bị là gì để bạn tìm hiểu thêm phần cứng phía sau.
Trong doanh nghiệp và chăm sóc khách hàng
Một công ty có thể dùng mô hình lớn để sinh hàng chục nghìn câu trả lời mẫu cho câu hỏi của khách, rồi chưng cất thành một mô hình nhỏ chuyên trả lời đúng mảng đó. Chi phí mỗi lượt trả lời giảm mạnh, tốc độ phản hồi nhanh hơn, và mô hình có thể đặt trên máy chủ nội bộ để giữ dữ liệu khách hàng.
Trong robot, nhà máy và thiết bị biên
Robot hút bụi, camera kiểm tra lỗi sản phẩm trên dây chuyền, máy bay không người lái đều phải ra quyết định trong vài phần nghìn giây với chip tiết kiệm điện. Người ta thường huấn luyện một mô hình thị giác lớn thật kỹ rồi chưng cất sang mô hình nhỏ chạy ngay trên thiết bị.
Trong tìm kiếm và gợi ý
Các hệ thống tìm kiếm phải xử lý lượng truy vấn khổng lồ mỗi giây. Mô hình chưng cất giúp xếp hạng kết quả và hiểu câu hỏi đủ nhanh để người dùng không phải chờ.
Mặt trái: tranh cãi về “tấn công chưng cất”
Chưng cất kiểu thứ ba (dùng câu trả lời của thầy làm dữ liệu) chỉ cần gửi câu hỏi và đọc câu trả lời. Nghĩa là về kỹ thuật, ai cũng có thể dùng API của một mô hình mạnh làm “thầy” cho mô hình của mình, kể cả khi thầy thuộc về công ty khác.
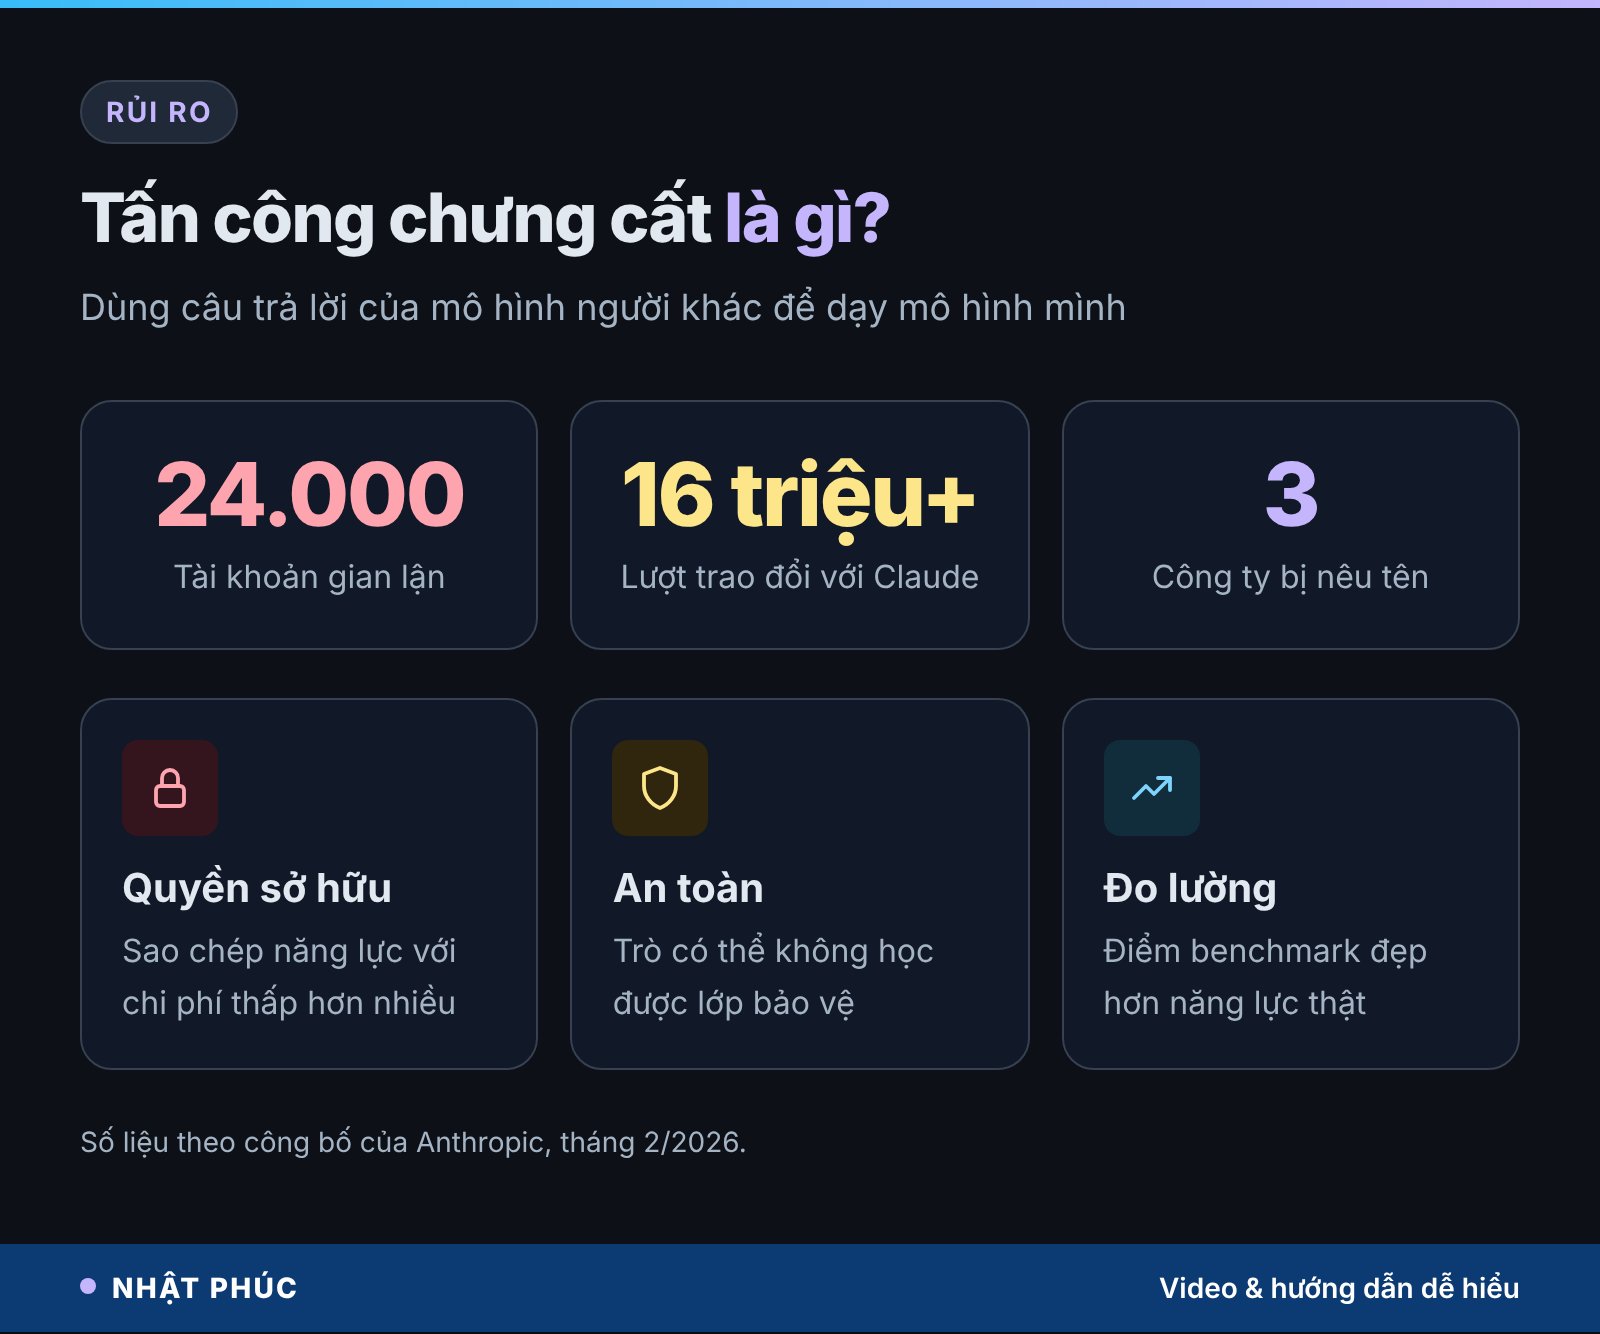
Hầu hết điều khoản dịch vụ của các nhà cung cấp AI lớn cấm dùng đầu ra để phát triển mô hình cạnh tranh. Đầu năm 2025, sau khi DeepSeek R1 gây chấn động, OpenAI cho biết đã thấy dấu hiệu mô hình của mình bị chưng cất trái phép. Tháng 2/2026, Anthropic công bố phát hiện ba công ty AI Trung Quốc là DeepSeek, Moonshot và MiniMax dùng khoảng 24.000 tài khoản gian lận để tạo hơn 16 triệu lượt trao đổi với Claude nhằm chưng cất năng lực của mô hình, và gọi đây là “tấn công chưng cất” (distillation attack).
Vì sao chuyện này đáng lo?
- Quyền sở hữu: công ty bỏ ra hàng trăm triệu USD huấn luyện thầy, đối thủ có thể sao chép phần lớn năng lực với chi phí thấp hơn nhiều.
- An toàn: mô hình trò học năng lực nhưng không chắc học được các lớp bảo vệ, có thể trả lời cả những yêu cầu nguy hiểm mà thầy từ chối.
- Đo lường sai lệch: khi nhiều mô hình học từ cùng vài người thầy, điểm benchmark có thể trông ấn tượng mà năng lực thật trên dữ liệu mới không tương xứng.
Để phòng, các nhà cung cấp theo dõi mẫu truy vấn bất thường, giới hạn tốc độ, khoá tài khoản vi phạm và nghiên cứu cách làm đầu ra khó bị dùng làm dữ liệu huấn luyện. Với người dùng thông thường, điều này ít ảnh hưởng, nhưng nó giải thích vì sao các nền tảng ngày càng siết xác minh tài khoản API.
Hiểu lầm phổ biến và giới hạn
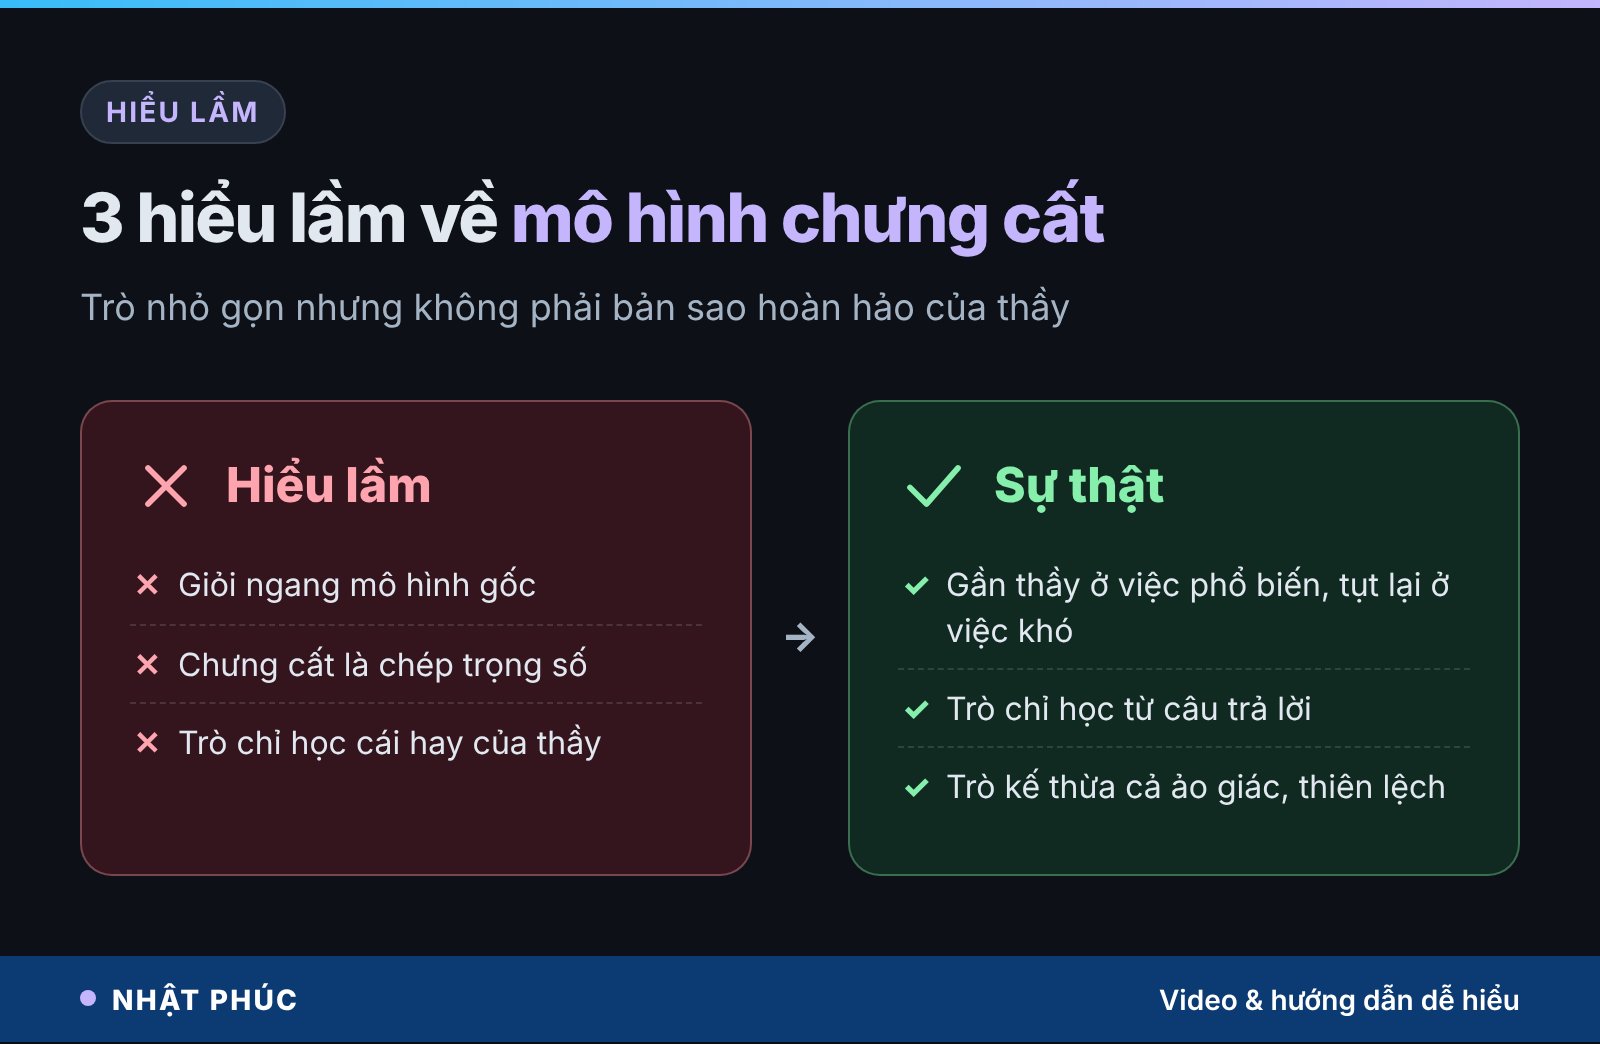
Hiểu lầm 1: “Mô hình chưng cất giỏi ngang mô hình gốc”
Không hẳn. Trò thường đạt gần thầy ở những việc phổ biến, nhưng tụt lại rõ ở việc khó: suy luận nhiều bước phức tạp, kiến thức hiếm, ngôn ngữ ít dữ liệu như tiếng Việt chuyên ngành. Video nói đúng: mô hình nhỏ “thường không bằng người anh khổng lồ trên máy chủ”.
Hiểu lầm 2: “Chưng cất là sao chép trọng số”
Trò không lấy bất kỳ con số nào trong trọng số của thầy. Nó chỉ học từ hành vi, tức câu trả lời. Đó cũng là lý do chưng cất làm được qua API, và vì sao tranh cãi pháp lý quanh nó phức tạp.
Hiểu lầm 3: “Trò học được mọi thứ tốt của thầy”
Trò học cả cái hay lẫn cái dở. Nếu thầy hay bịa thông tin (ảo giác), có thiên lệch hoặc trả lời sai một mảng nào đó, trò kế thừa luôn, đôi khi còn tệ hơn vì ít “dung lượng” để tự sửa.
Giới hạn kỹ thuật cần biết
- Khoảng cách quá lớn khó dạy: trò quá nhỏ so với thầy có thể học kém hơn cả khi học từ một “thầy trung gian” vừa tầm.
- Vẫn tốn tài nguyên: phải chạy thầy trên lượng dữ liệu lớn để lấy câu trả lời, rồi huấn luyện trò. Rẻ hơn huấn luyện mô hình lớn, nhưng không miễn phí.
- Phụ thuộc dữ liệu đưa vào: nếu tập câu hỏi dùng để chưng cất không phủ đủ các tình huống, trò sẽ yếu ở đúng những chỗ bị bỏ sót.
Cách chọn và dùng mô hình chưng cất
Nếu bạn muốn thử AI chạy trên máy tính của mình, phần lớn mô hình phù hợp đều là mô hình chưng cất. Dưới đây là các bước để chọn đúng.
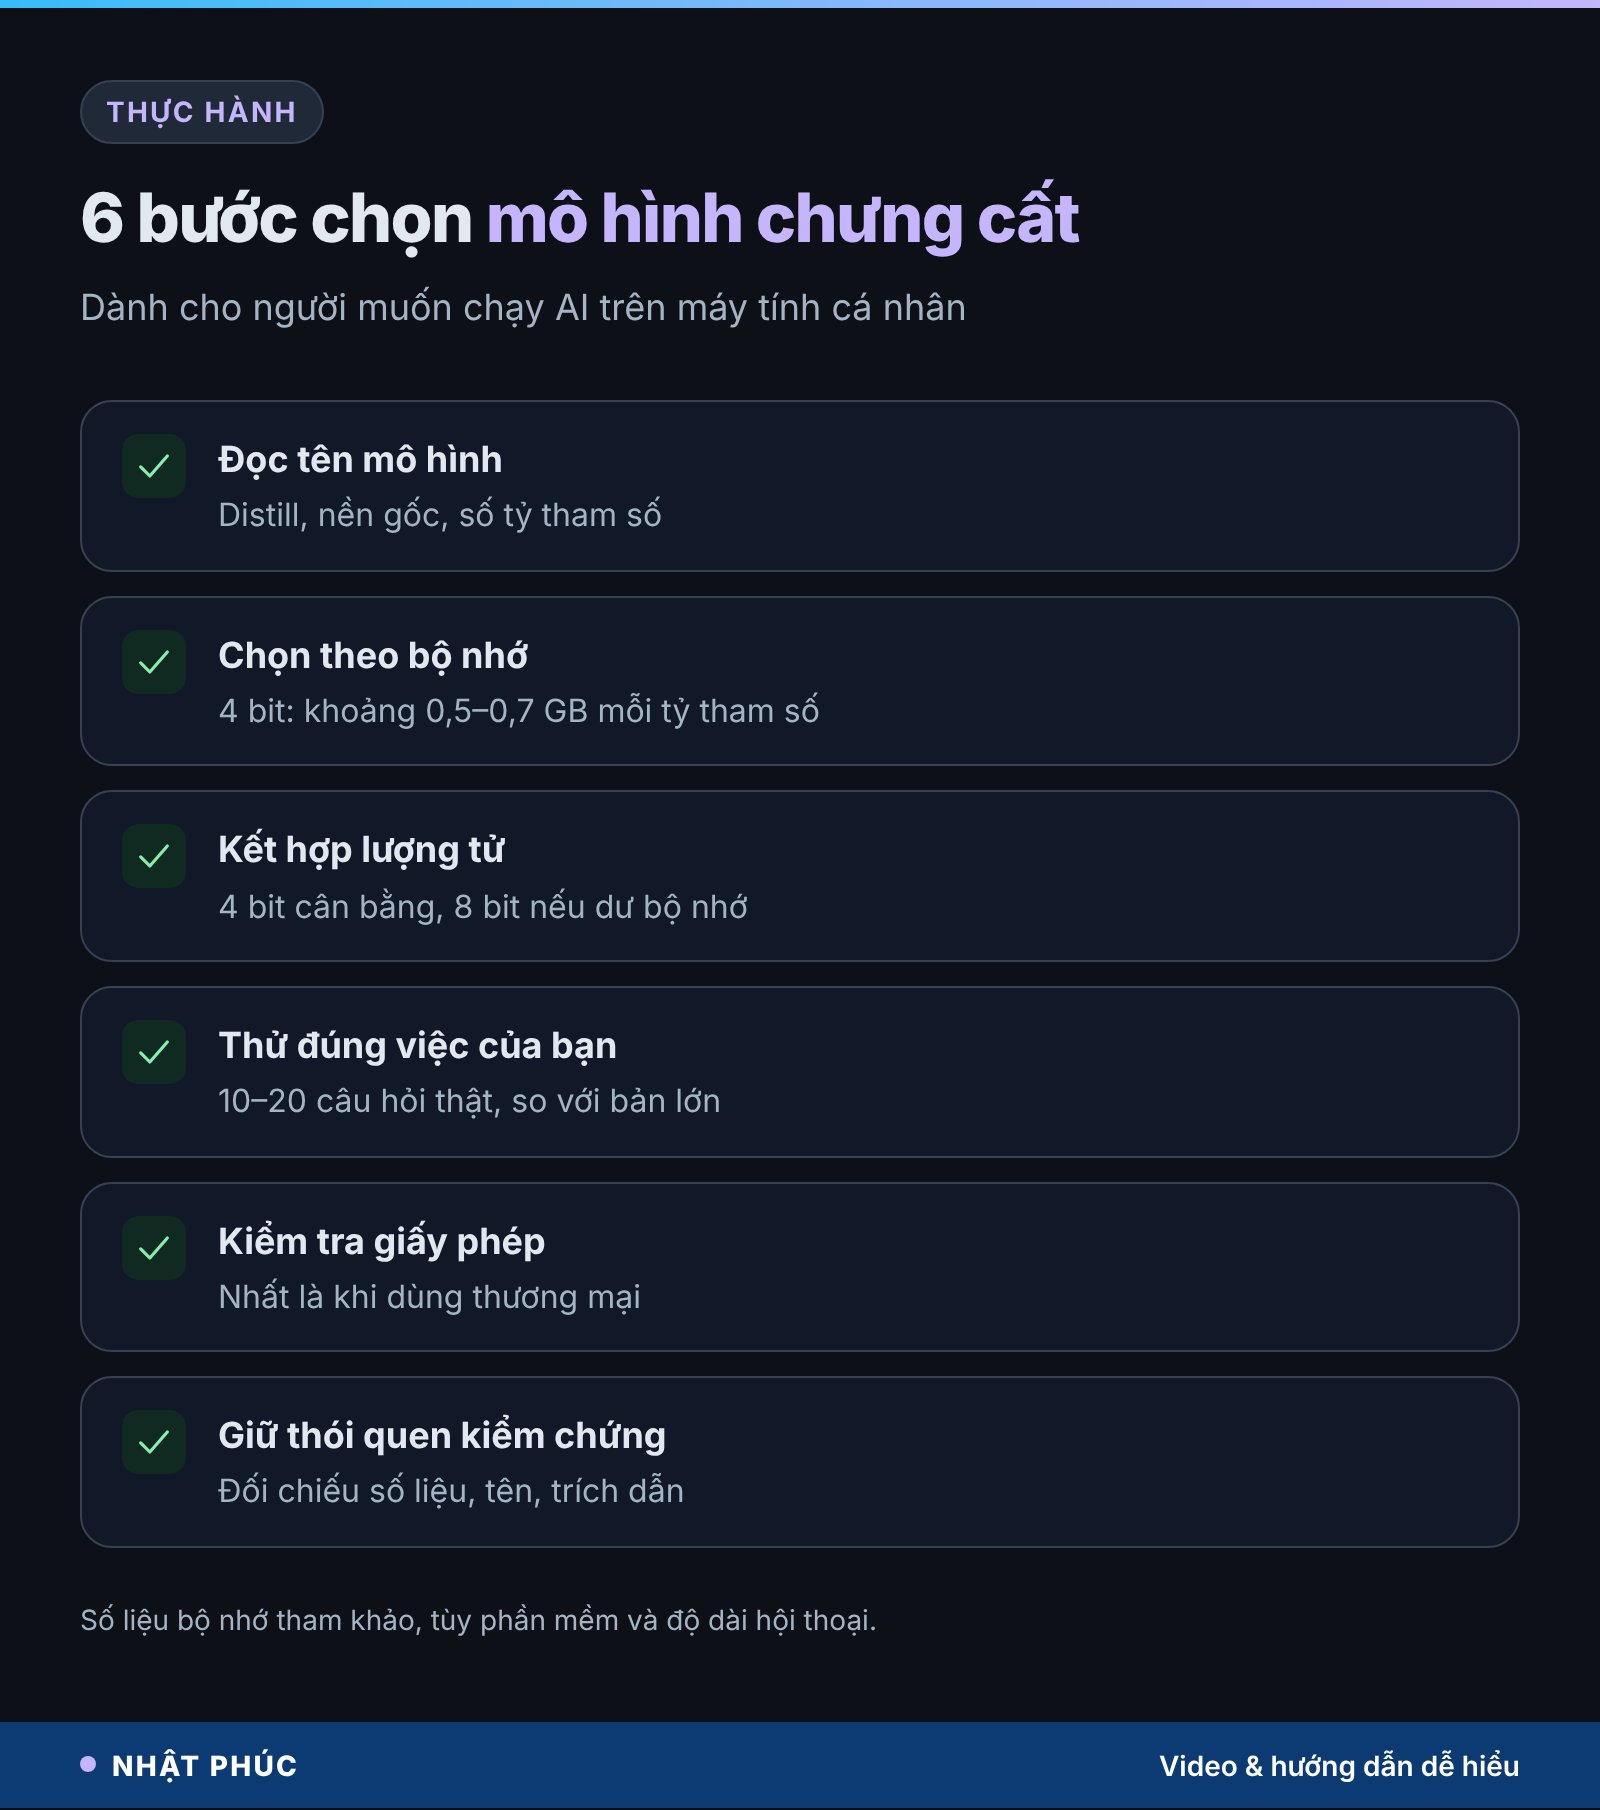
1. Đọc tên mô hình
Chữ “Distill” trong tên (ví dụ DeepSeek-R1-Distill-Qwen-7B) cho biết mô hình học từ một thầy (R1) trên nền một mô hình khác (Qwen 7B). Tên cũng cho biết số tham số: 1,5B, 7B, 14B… với B là tỷ.
2. Chọn kích cỡ theo bộ nhớ máy
Quy tắc tham khảo: bản lượng tử hóa 4 bit cần khoảng 0,5 đến 0,7 GB bộ nhớ cho mỗi tỷ tham số, cộng thêm phần cho ngữ cảnh. Máy 16 GB RAM chạy thoải mái mô hình 7 đến 8 tỷ tham số (số liệu tham khảo, tùy phần mềm và độ dài hội thoại).
3. Kết hợp với lượng tử hóa
Hầu hết mô hình chưng cất trên các kho tải có sẵn nhiều mức lượng tử. Mức 4 bit thường là điểm cân bằng tốt; nếu máy dư bộ nhớ, chọn 8 bit để giữ chất lượng cao hơn.
4. Thử trên đúng việc của bạn
Điểm benchmark chỉ là tham khảo. Hãy đưa 10 đến 20 câu hỏi thật trong công việc của bạn, so câu trả lời giữa bản nhỏ và một mô hình lớn trên mạng. Nếu chênh lệch chấp nhận được, bản nhỏ là đủ.
5. Kiểm tra giấy phép
Mô hình chưng cất mang giấy phép của cả nền gốc lẫn nhà phát hành. Dùng cho mục đích thương mại thì đọc kỹ điều khoản trên trang mô hình trước.
6. Giữ thói quen kiểm chứng
Mô hình nhỏ dễ bịa hơn ở kiến thức hiếm. Với số liệu, tên người, trích dẫn quan trọng, luôn đối chiếu với nguồn tin cậy.
Muốn bắt tay cài đặt cụ thể, bạn có thể đọc hướng dẫn cài DeepSeek R1 trên máy tính bằng LM Studio, nơi chính các bản R1-Distill được dùng làm ví dụ.
Câu hỏi thường gặp
Chưng cất tri thức và chưng cất mô hình có phải một không?
Có. “Chưng cất tri thức” là cách dịch sát thuật ngữ knowledge distillation, còn “chưng cất mô hình” là cách gọi đời thường. Cả hai đều chỉ việc huấn luyện mô hình nhỏ bắt chước mô hình lớn. Một số tài liệu còn gọi là “mô hình thầy trò” (teacher–student).
Mô hình trò có thể giỏi hơn thầy không?
Thông thường thì không, trò bị giới hạn bởi những gì thầy biết. Tuy vậy, có trường hợp trò làm tốt hơn thầy ở một việc hẹp, khi nó được chưng cất rồi tinh chỉnh thêm bằng dữ liệu chuyên biệt mà thầy chưa từng thấy. Ở mức tổng quát, thầy vẫn mạnh hơn.
Chưng cất có phải là ăn cắp mô hình?
Bản thân kỹ thuật là hợp pháp và phổ biến; các công ty chưng cất mô hình của chính mình hằng ngày. Vấn đề nằm ở việc dùng đầu ra của mô hình người khác trái với điều khoản dịch vụ. Ranh giới pháp lý vẫn đang được tranh luận ở nhiều nước.
Người dùng phổ thông có tự chưng cất mô hình được không?
Về nguyên tắc là được với các công cụ mã nguồn mở, nhưng cần GPU, dữ liệu và kiến thức huấn luyện. Với đa số người dùng, cách thực tế hơn là tải mô hình đã được chưng cất sẵn và chạy bằng phần mềm như LM Studio hoặc Ollama.
Mô hình chưng cất có an toàn bằng mô hình gốc không?
Không chắc. Các lớp từ chối yêu cầu nguy hiểm được xây bằng huấn luyện riêng, và không phải lúc nào cũng truyền sang trò đầy đủ. Mô hình chưng cất chính thức từ nhà phát hành thường được kiểm thử thêm; bản do bên thứ ba tự chưng cất thì cần thận trọng hơn.
Kết luận
Chưng cất mô hình AI là lý do một bộ óc khổng lồ có thể “truyền nghề” cho một mô hình nhỏ vừa chiếc điện thoại. Bí quyết không nằm ở việc ép nhỏ mà ở việc học đúng chỗ: trò học cả những điều thầy phân vân, những phương án thầy thấy “gần đúng”, thứ tri thức ngầm mà nhãn đúng/sai không bao giờ chứa được. Kết hợp với lượng tử hóa và cắt tỉa, nó tạo nên phần lớn AI chạy nhanh, rẻ và riêng tư mà bạn dùng hôm nay.
Đồng thời, hãy nhớ giới hạn: trò hiếm khi vượt thầy, kế thừa cả lỗi của thầy, và chưng cất trái phép đang là vấn đề nóng của ngành AI. Như video kết lại, điều đáng ngạc nhiên không phải là AI có thể nhỏ đến vậy, mà là phần lớn những gì nó cần để thông minh lại chưa bao giờ cần to đến thế.
Bạn đã từng thử một mô hình “Distill” trên máy mình chưa, và nó làm tốt hay kém ở việc gì? Hãy để lại bình luận và theo dõi Nhật Phúc để không bỏ lỡ các bài giải thích AI dễ hiểu tiếp theo.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.