Bạn muốn chạy một mô hình ngôn ngữ cỡ lớn ngay trên bàn làm việc, không gửi tài liệu lên máy chủ nước ngoài? Câu hỏi đầu tiên thường không phải “chip mạnh cỡ nào” mà là “máy có bao nhiêu bộ nhớ hợp nhất“. Đó là lý do vài dòng máy tính mini mới cho AI đều khoe con số 128 GB thay vì xung nhịp CPU.
Câu trả lời ngắn: bộ nhớ hợp nhất (unified memory) là một vùng RAM duy nhất mà CPU và GPU cùng đọc, cùng ghi, không phải chép dữ liệu qua lại. Với AI chạy cục bộ, dung lượng vùng nhớ này quyết định mô hình to cỡ nào nạp vừa, còn băng thông của nó quyết định máy trả lời nhanh hay chậm.
Bài này lấy chiếc máy tính mini MSI EdgeMesa N AI+ dùng nền tảng NVIDIA RTX Spark làm ví dụ để giải thích cơ chế, cách ước tính bộ nhớ cho từng cỡ mô hình, so sánh với card đồ hoạ rời, máy Mac và thuê đám mây, rồi gợi ý ai thật sự nên đầu tư một máy chạy AI cục bộ.
Tóm tắt nhanh
- Bộ nhớ hợp nhất cho CPU và GPU dùng chung một kho RAM, nên mô hình AI có thể dùng gần trọn dung lượng máy thay vì bị giới hạn bởi bộ nhớ của card đồ hoạ.
- Ước tính nhanh: mô hình nén 4-bit cần khoảng 0,5–0,6 GB cho mỗi tỷ tham số, chưa tính phần ngữ cảnh.
- Dung lượng quyết định “chạy được hay không”, băng thông bộ nhớ quyết định “trả lời nhanh hay chậm”.
- MSI EdgeMesa N AI+ có tối đa 128 GB LPDDR5X, công bố tới 1 petaflop FP4, hiện chỉ bán ở Mỹ với giá từ 4.699 USD.
- Máy AI cục bộ hợp với nhóm cần giữ dữ liệu trong nhà và chạy tác vụ liên tục; người dùng thỉnh thoảng hỏi chatbot thì chưa cần.
Nội dung chính:
- Bộ nhớ hợp nhất là gì?
- Vì sao mô hình AI cần nhiều bộ nhớ
- Dung lượng và băng thông: hai con số khác nhau
- Ví dụ: NVIDIA RTX Spark và MSI EdgeMesa N AI+
- So sánh máy mini, card rời, Mac và đám mây
- Ai nên mua máy chạy AI cục bộ?
- Ứng dụng trong văn phòng ở Việt Nam
- Hiểu lầm phổ biến
- 6 bước tính toán trước khi mua
- Câu hỏi thường gặp
Bộ nhớ hợp nhất là gì?
Trong một chiếc máy tính để bàn quen thuộc, CPU dùng RAM trên bo mạch chủ, còn card đồ hoạ (GPU) có bộ nhớ riêng gọi là VRAM. Hai kho này tách biệt. Muốn GPU xử lý dữ liệu nào, máy phải chép dữ liệu đó từ RAM sang VRAM qua khe PCIe, xong việc lại chép ngược về.
Hãy hình dung một nhà hàng có hai gian bếp. Gian bếp nóng (GPU) nấu rất nhanh nhưng tủ lạnh nhỏ. Gian bếp lạnh (CPU) có kho to nhưng nấu chậm. Mỗi lần nấu món lớn, nhân viên phải bê nguyên liệu qua lại hành lang. Bộ nhớ hợp nhất giống việc gộp hai gian thành một bếp chung với một kho lớn ở giữa: ai cần gì thì lấy ngay, không ai phải bê qua bê lại.
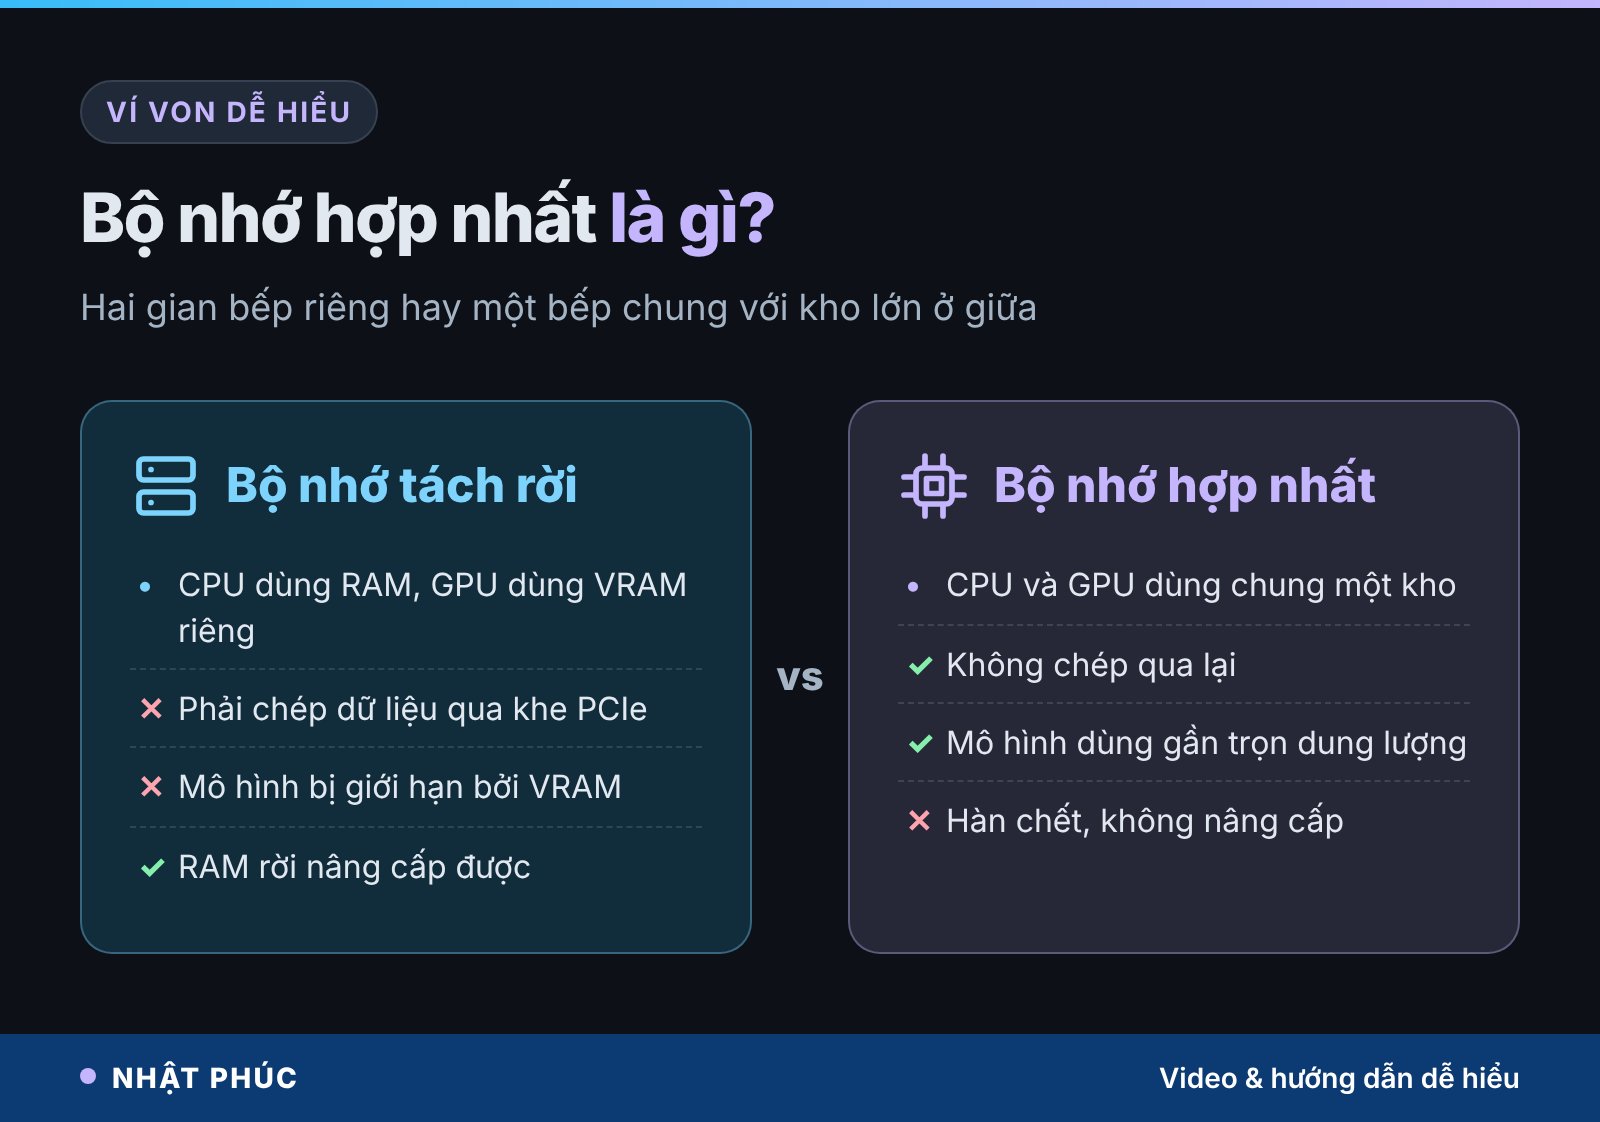
Kiến trúc này không mới. Máy chơi game console và các chip Apple M-series đã dùng từ lâu. Điểm mới năm 2026 là nhiều hãng đưa nó vào máy tính Windows dành cho AI, với dung lượng lên tới 128 GB, gấp khoảng bốn lần VRAM của card đồ hoạ tiêu dùng mạnh nhất.
Đổi lại, bộ nhớ hợp nhất thường là loại LPDDR hàn chết trên bo mạch. Bạn mua bản bao nhiêu GB thì dùng bấy nhiêu suốt đời máy, không nâng cấp được như thanh RAM rời.
Vì sao mô hình AI cần nhiều bộ nhớ
Một mô hình ngôn ngữ lớn (LLM) về bản chất là một khối khổng lồ các con số gọi là tham số. Mỗi lần tạo ra một chữ, máy phải đọc gần như toàn bộ khối số đó. Vì vậy cả mô hình nên nằm sẵn trong bộ nhớ nhanh, nếu không máy sẽ phải đọc từ ổ SSD và chậm đi hàng chục lần.
Công thức ước tính nhanh
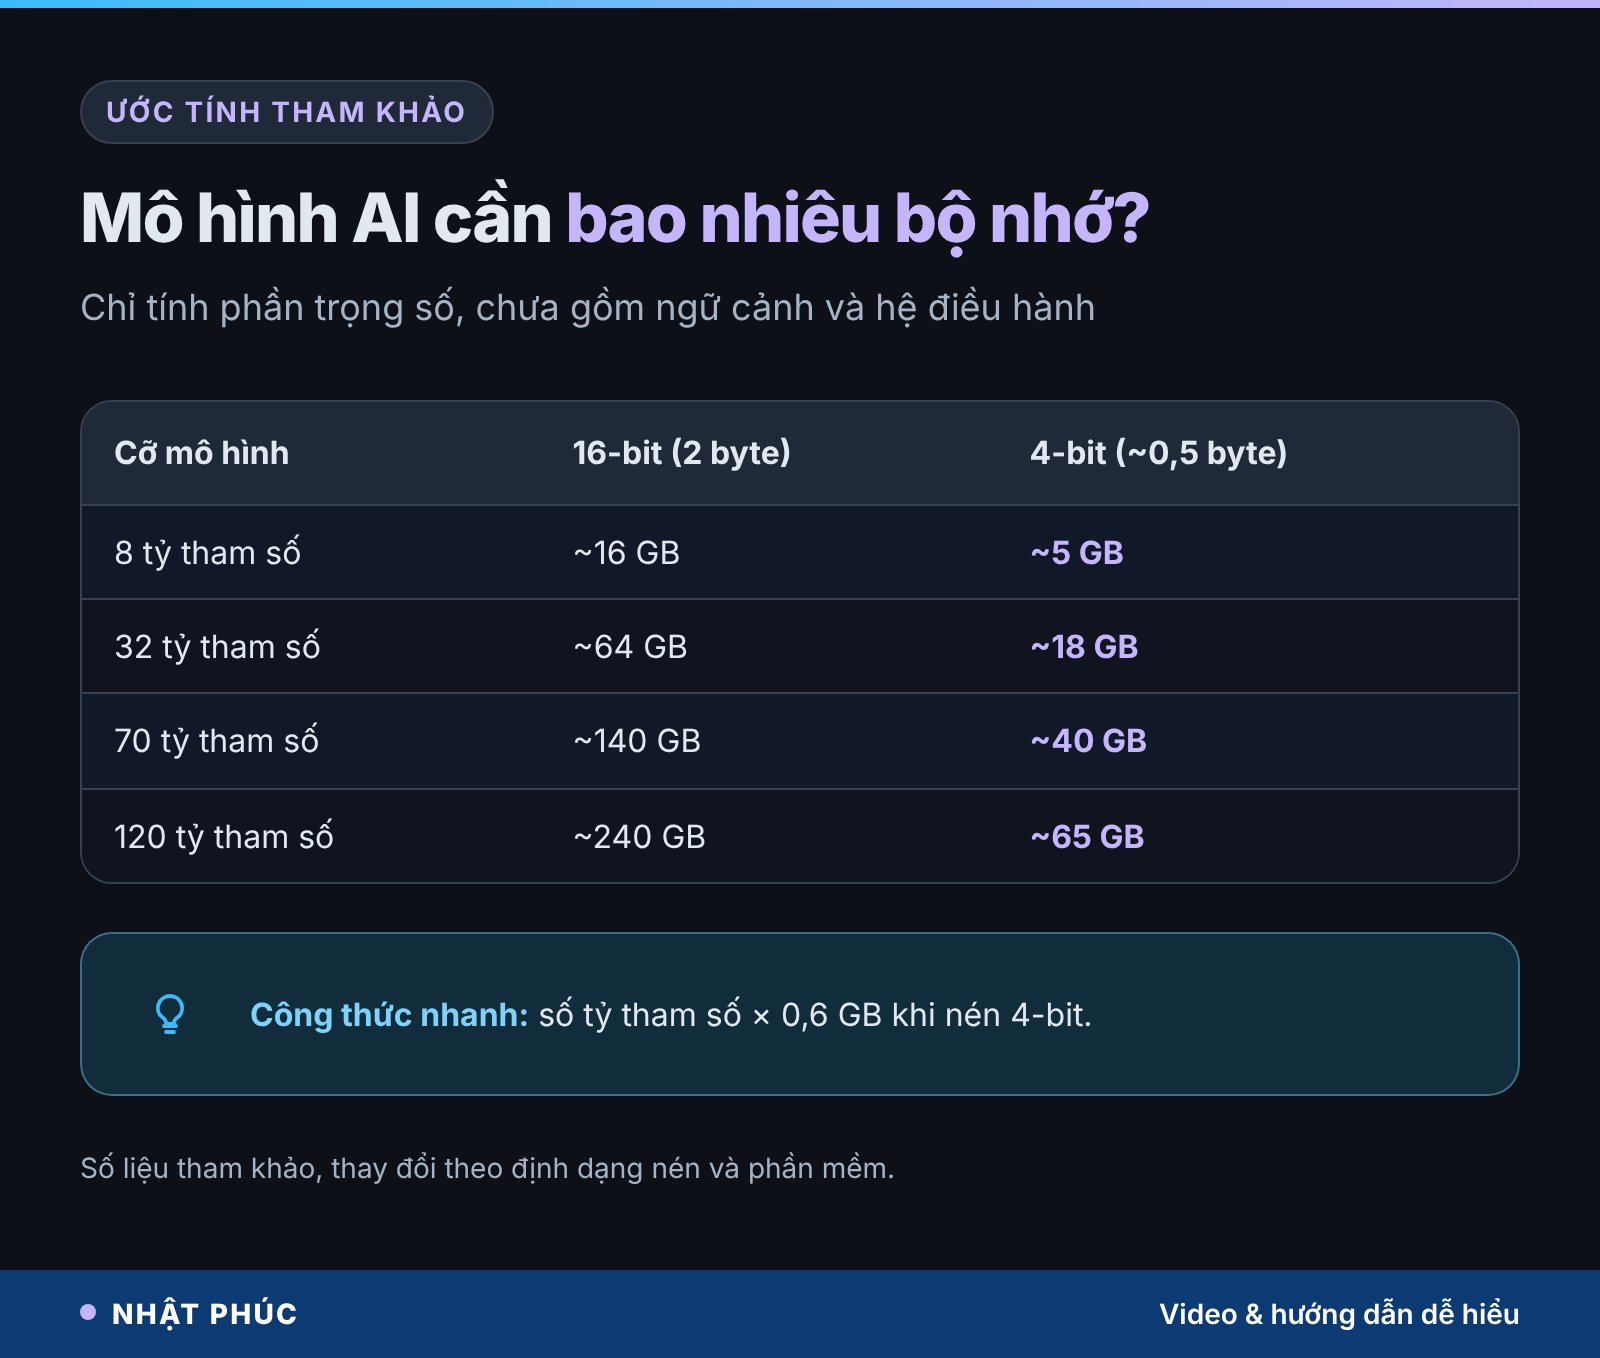
Dung lượng cần cho phần trọng số xấp xỉ bằng số tham số × số byte mỗi tham số. Ở độ chính xác gốc 16-bit, mỗi tham số chiếm 2 byte. Khi nén xuống 8-bit còn 1 byte, nén 4-bit còn khoảng 0,5 byte. Kỹ thuật nén này gọi là lượng tử hoá (quantization), đổi một chút độ chính xác lấy dung lượng nhỏ hơn nhiều.
Ví dụ, mô hình 70 tỷ tham số ở 16-bit cần khoảng 140 GB, vượt mọi máy mini hiện nay. Nén 4-bit thì còn khoảng 40 GB, nạp vừa thoải mái vào máy 64 GB hoặc 128 GB.
Phần “trí nhớ ngắn hạn” cũng tốn chỗ
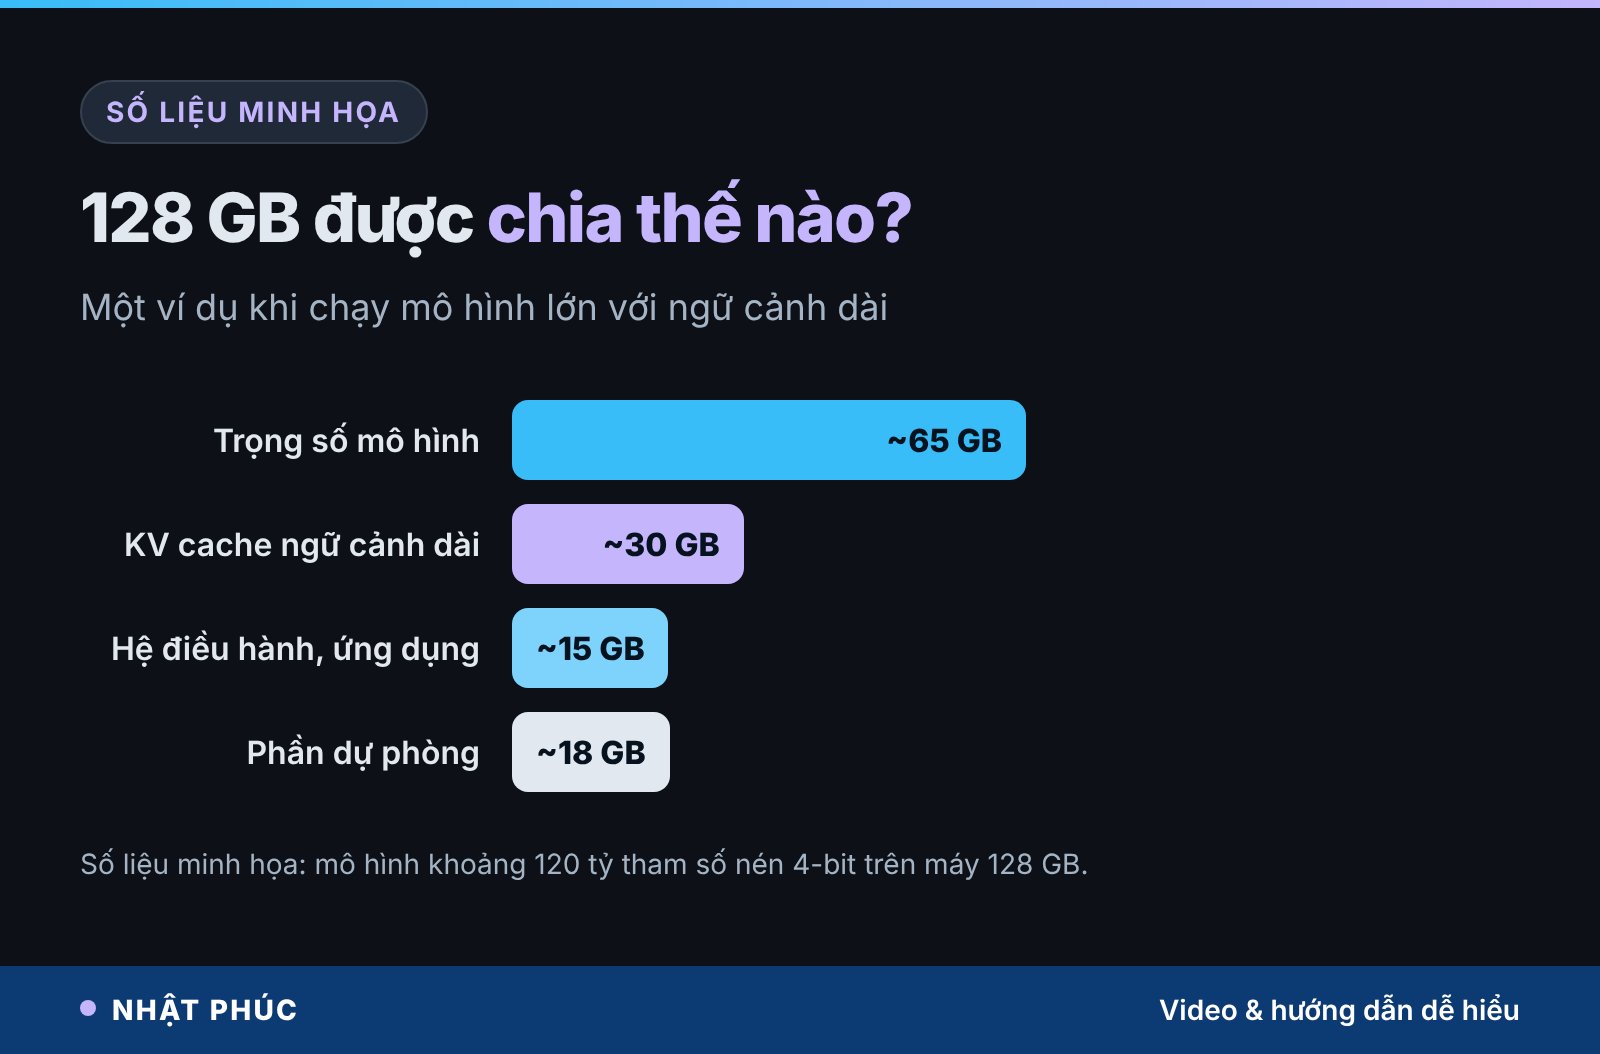
Ngoài trọng số, mô hình còn cần chỗ cho bộ nhớ đệm khoá–giá trị (KV cache), nơi lưu lại những gì đã đọc trong cuộc trò chuyện. Ngữ cảnh càng dài, bộ đệm này càng lớn. Đưa cho AI một hợp đồng 200 trang hoặc cả kho mã nguồn có thể tốn thêm hàng chục GB.
Đó là lý do NVIDIA quảng bá nền tảng RTX Spark có thể chạy mô hình tới 120 tỷ tham số với ngữ cảnh tới 1 triệu token: con số 128 GB phải gánh cả mô hình lẫn ngữ cảnh, cộng thêm hệ điều hành và ứng dụng khác.
Dung lượng và băng thông: hai con số khác nhau
Nhiều người nhìn thấy 128 GB là nghĩ máy sẽ chạy nhanh. Thực tế, dung lượng chỉ trả lời câu hỏi “có nạp vừa không”. Tốc độ trả lời phụ thuộc nhiều hơn vào băng thông bộ nhớ, tức mỗi giây máy đọc được bao nhiêu GB dữ liệu.
Vì sao băng thông quan trọng
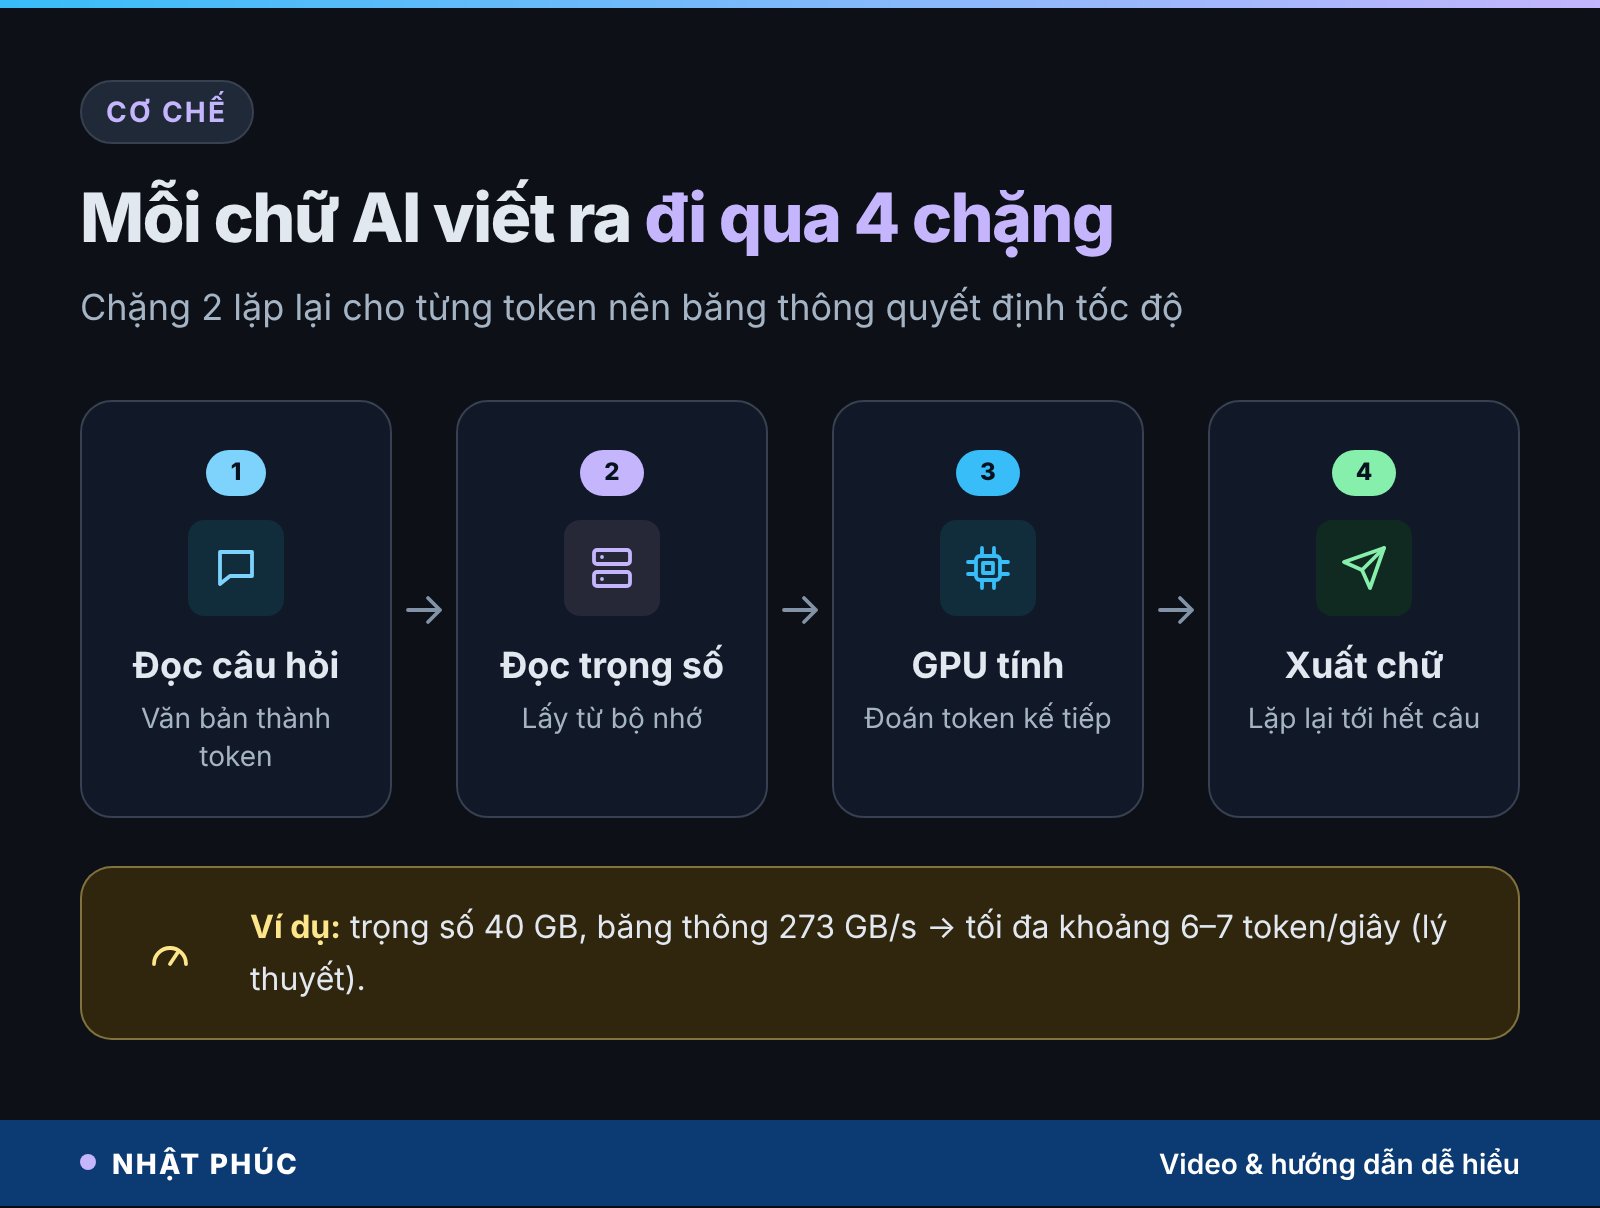
Khi sinh từng token (một mẩu chữ), mô hình dày đặc phải đọc gần hết trọng số một lần. Nếu trọng số nặng 40 GB và băng thông là 273 GB/s, trên lý thuyết máy chỉ sinh được khoảng 6–7 token mỗi giây, chưa kể các chi phí khác. Đó là giới hạn trên, tốc độ thật thường thấp hơn.
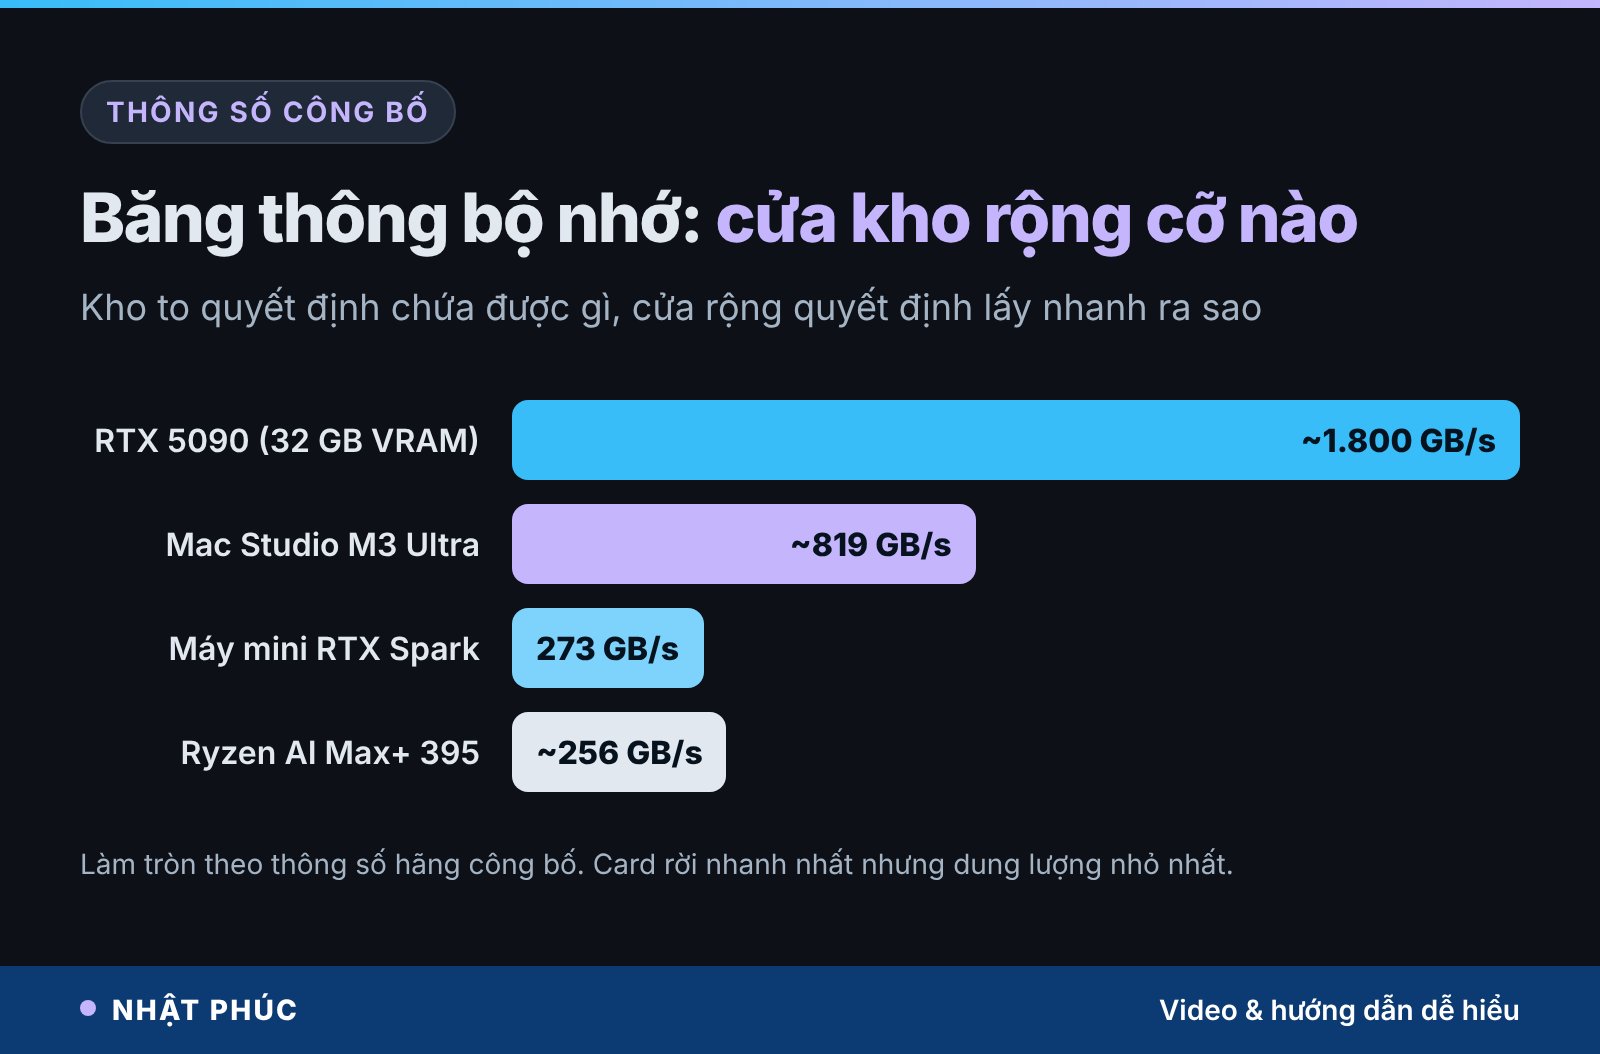
Ví von đơn giản: dung lượng là kích thước kho, băng thông là độ rộng cửa kho. Kho to mà cửa hẹp thì vẫn chất được nhiều hàng, nhưng mỗi lần lấy ra rất lâu.
Mô hình MoE giải bài toán ra sao
Các mô hình chuyên gia hỗn hợp (MoE) chỉ kích hoạt một phần nhỏ tham số cho mỗi token. Ví dụ, mô hình mở gpt-oss-120b của OpenAI có khoảng 117 tỷ tham số tổng nhưng chỉ khoảng 5,1 tỷ tham số hoạt động mỗi token. Toàn bộ mô hình vẫn phải nằm trong bộ nhớ, nhưng mỗi bước chỉ đọc một phần nhỏ, nên tốc độ trên máy băng thông vừa phải vẫn chấp nhận được. Cơ chế này được giải thích kỹ trong bài MoE là gì và vì sao AI nghìn tỷ tham số vẫn chạy rẻ.
Nói cách khác, máy có bộ nhớ hợp nhất lớn nhưng băng thông vừa phải đặc biệt hợp với mô hình MoE: dung lượng lớn để chứa đủ, phần kích hoạt nhỏ để chạy nhanh.
Ví dụ: NVIDIA RTX Spark và MSI EdgeMesa N AI+
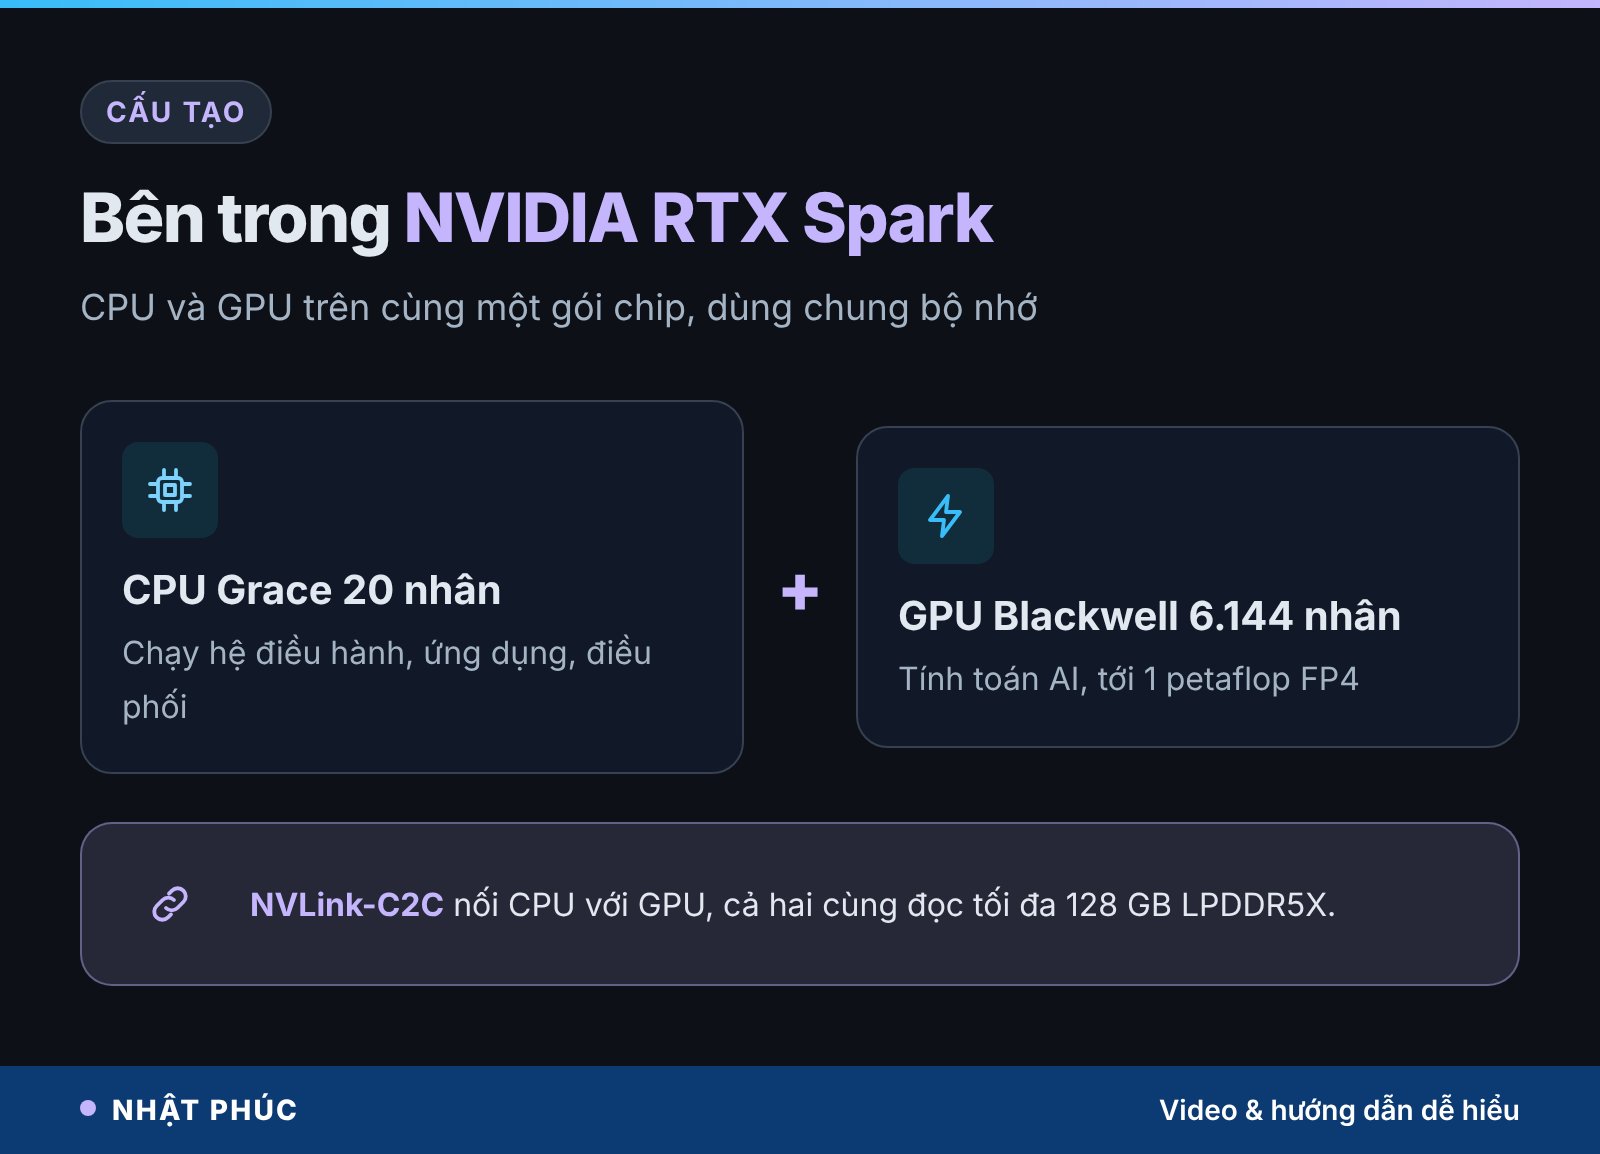
Cuối tháng 5/2026, NVIDIA cùng Microsoft công bố RTX Spark, một “siêu chip” cho máy tính Windows. Chip ghép GPU kiến trúc Blackwell 6.144 nhân CUDA với CPU Grace 20 nhân, nối với nhau bằng đường liên kết NVLink-C2C và dùng chung tối đa 128 GB bộ nhớ hợp nhất. NVIDIA công bố hiệu năng AI tới 1 petaflop ở độ chính xác FP4. Đây là “người anh em” chạy Windows của chip GB10 trong máy DGX Spark vốn dùng Linux.
MSI giới thiệu EdgeMesa N AI+ tại Computex 2026 (tháng 6/2026) và gần đây đã niêm yết giá bán tại Mỹ. Đây là máy để bàn thể tích 1,3 lít, dùng bản RTX Spark mạnh nhất (20 nhân CPU, 6.144 nhân GPU), chạy Windows 11 Pro. Theo trang của MSI và các trang công nghệ quốc tế, máy có:
- Bộ nhớ hợp nhất LPDDR5X 64 GB hoặc 128 GB, băng thông 273 GB/s theo cửa hàng MSI tại Mỹ.
- Một khe M.2 NVMe: bản 64 GB đi kèm SSD 1 TB, bản 128 GB đi kèm SSD 4 TB.
- Mạng có dây 10 Gb, Wi-Fi 7, Bluetooth 5.4.
- Bốn cổng USB-C 20 Gbps (ba cổng xuất hình DisplayPort, một cổng nhận nguồn), một cổng HDMI 2.1.
- Tản nhiệt buồng hơi kèm quạt, công suất tới khoảng 140 W, sạc rời 240 W, có chip bảo mật TPM 2.0.
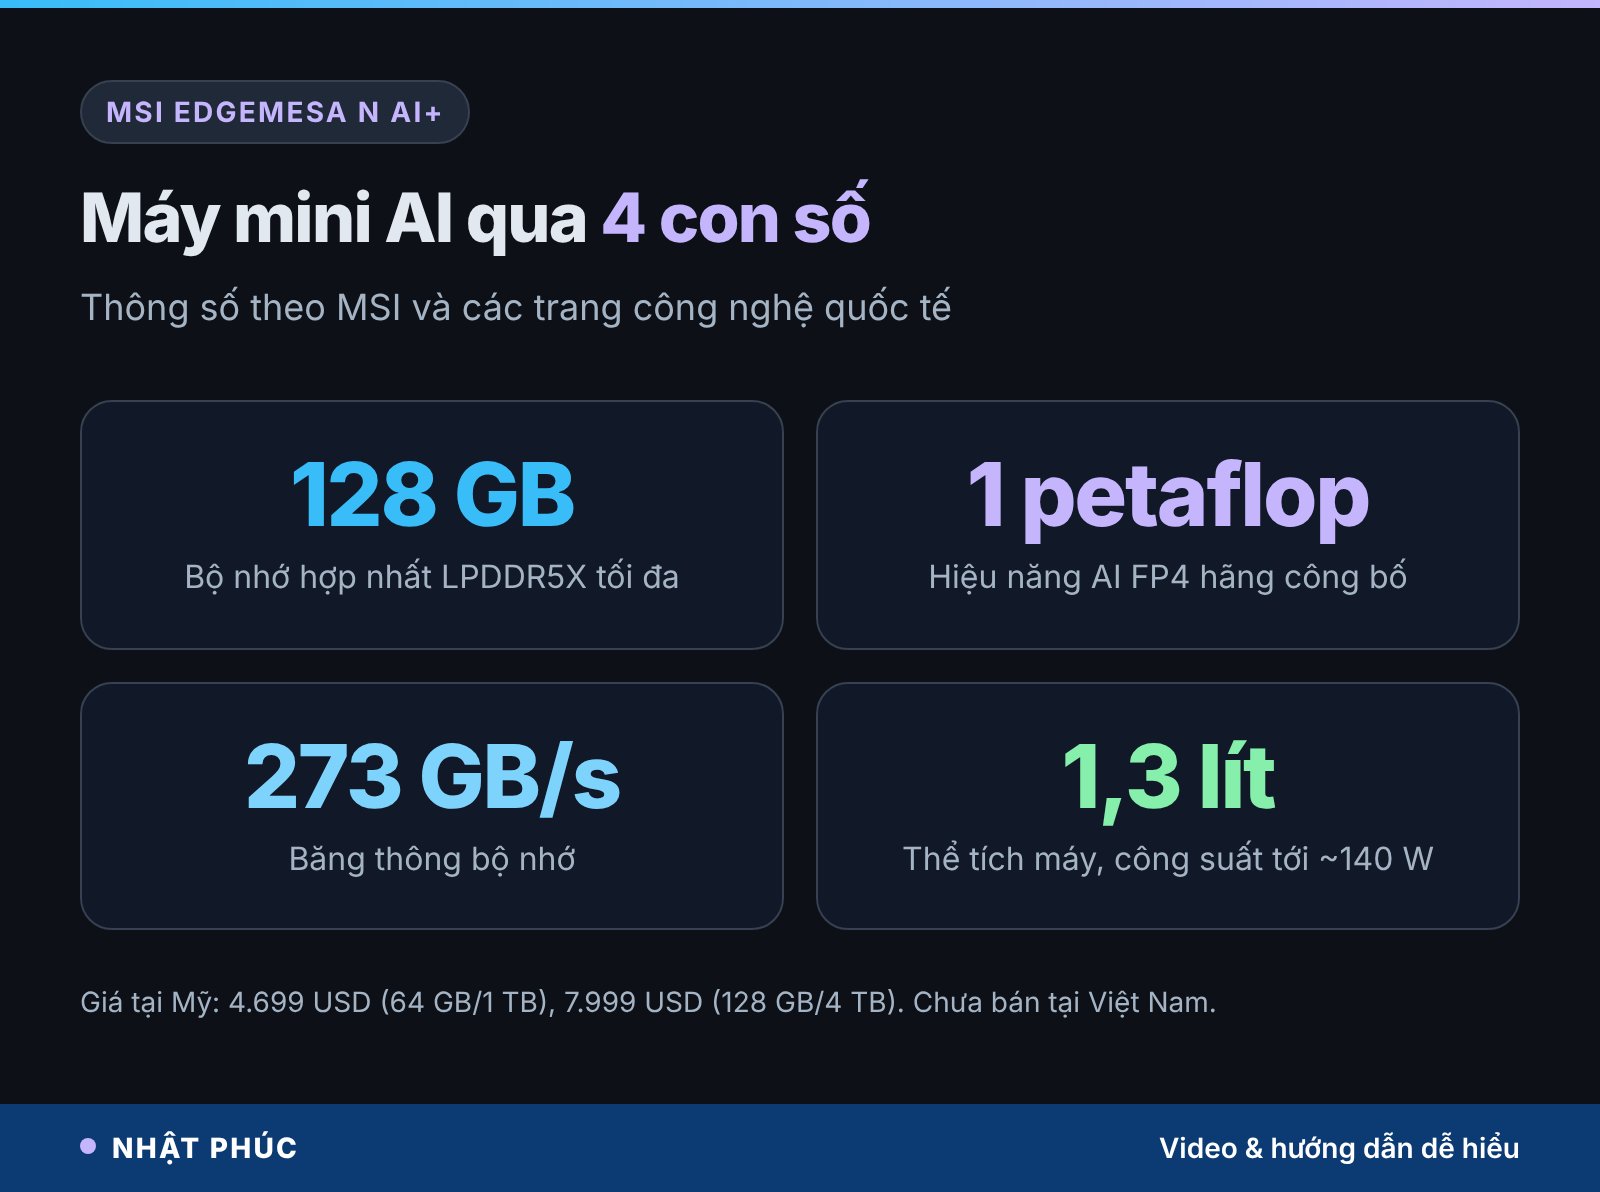
Giá niêm yết tại cửa hàng trực tuyến MSI Mỹ là 4.699 USD cho bản 64 GB/1 TB và 7.999 USD cho bản 128 GB/4 TB. Chênh lệch 3.300 USD hoàn toàn đến từ bộ nhớ và SSD vì hai bản dùng chung một chip. Tại thời điểm viết bài, máy chỉ bán ở Mỹ; MSI chưa công bố giá hay thời điểm cho thị trường khác, kể cả Việt Nam.
Ngoài phần cứng, NVIDIA và Microsoft cũng giới thiệu lớp bảo mật mới cho tác tử AI chạy trên Windows, cùng bộ công cụ NVIDIA OpenShell cho phép người dùng đặt quy tắc tác tử được làm gì, định tuyến câu hỏi sang mô hình cục bộ theo chính sách riêng tư và che thông tin cá nhân khi buộc phải gửi lên mô hình đám mây.
So sánh máy mini, card rời, Mac và đám mây
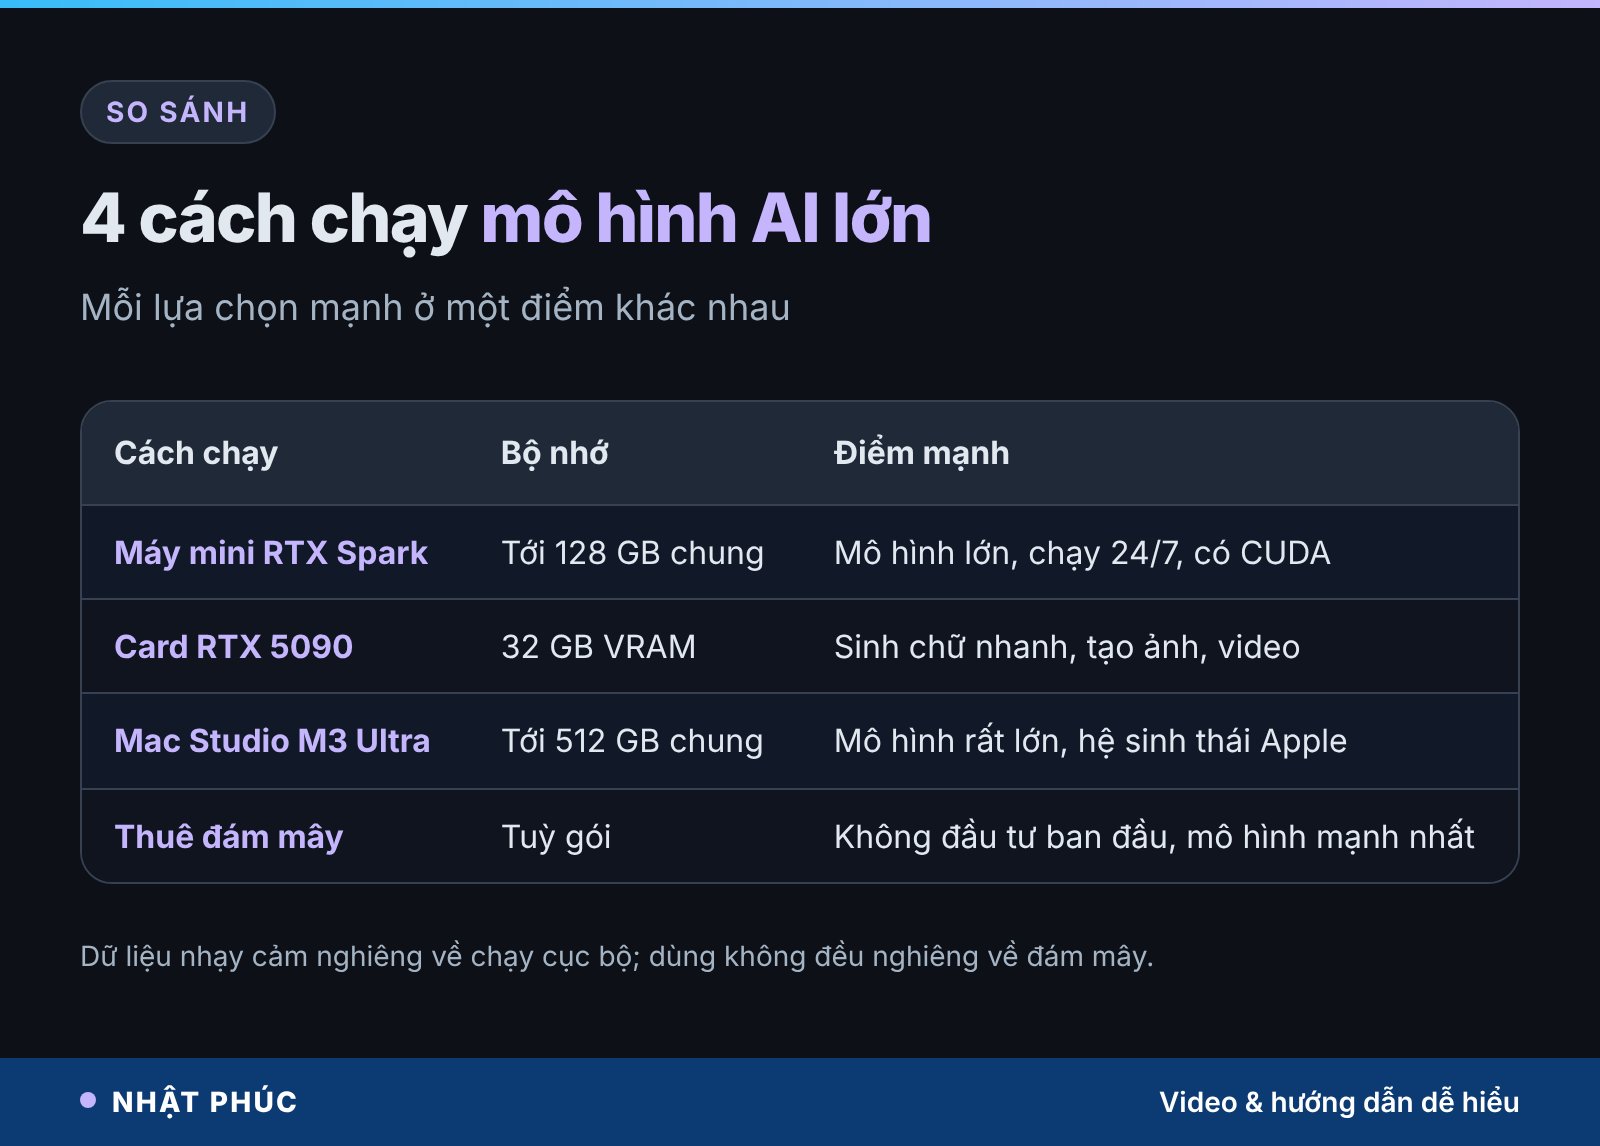
Máy mini bộ nhớ hợp nhất không phải cách duy nhất để chạy AI lớn. Mỗi lựa chọn mạnh ở một điểm khác nhau.
Card đồ hoạ rời như RTX 5090 có băng thông rất cao (khoảng 1,8 TB/s) nên sinh token nhanh, nhưng chỉ có 32 GB VRAM. Mô hình lớn hơn phải cắt bớt sang RAM hệ thống và chậm hẳn. Máy Mac dùng chip Apple cũng có bộ nhớ hợp nhất, bản Mac Studio M3 Ultra lên tới 512 GB với băng thông khoảng 819 GB/s, nhưng hệ sinh thái phần mềm AI xoay quanh CUDA của NVIDIA thì không chạy trực tiếp. Muốn ghép nhiều máy Mac thành cụm, bạn có thể xem bài ghép nhiều máy Mac chạy mô hình AI lớn.
Thuê đám mây không tốn tiền đầu tư ban đầu và luôn có mô hình mạnh nhất, nhưng dữ liệu rời khỏi văn phòng và chi phí tăng theo số lượng sử dụng.
| Cách chạy | Bộ nhớ cho mô hình | Băng thông | Hợp với |
|---|---|---|---|
| Máy mini RTX Spark | Tới 128 GB dùng chung | 273 GB/s | Mô hình lớn, MoE, chạy 24/7, cần CUDA và Windows |
| Card rời RTX 5090 | 32 GB VRAM | Khoảng 1,8 TB/s | Mô hình vừa, cần tốc độ, tạo ảnh/video |
| Mac Studio M3 Ultra | Tới 512 GB dùng chung | Khoảng 819 GB/s | Mô hình rất lớn, người dùng hệ sinh thái Apple |
| Thuê đám mây | Tuỳ gói | Rất cao | Dùng không đều, cần mô hình mạnh nhất |
Bạn đọc mới tìm hiểu về vai trò của GPU có thể xem thêm bài GPU là gì và vì sao GPU chạy AI; còn laptop phổ thông có chip AI nhỏ thì phù hợp với tác vụ khác, như phân tích trong bài NPU là gì.
Ai nên mua máy chạy AI cục bộ?
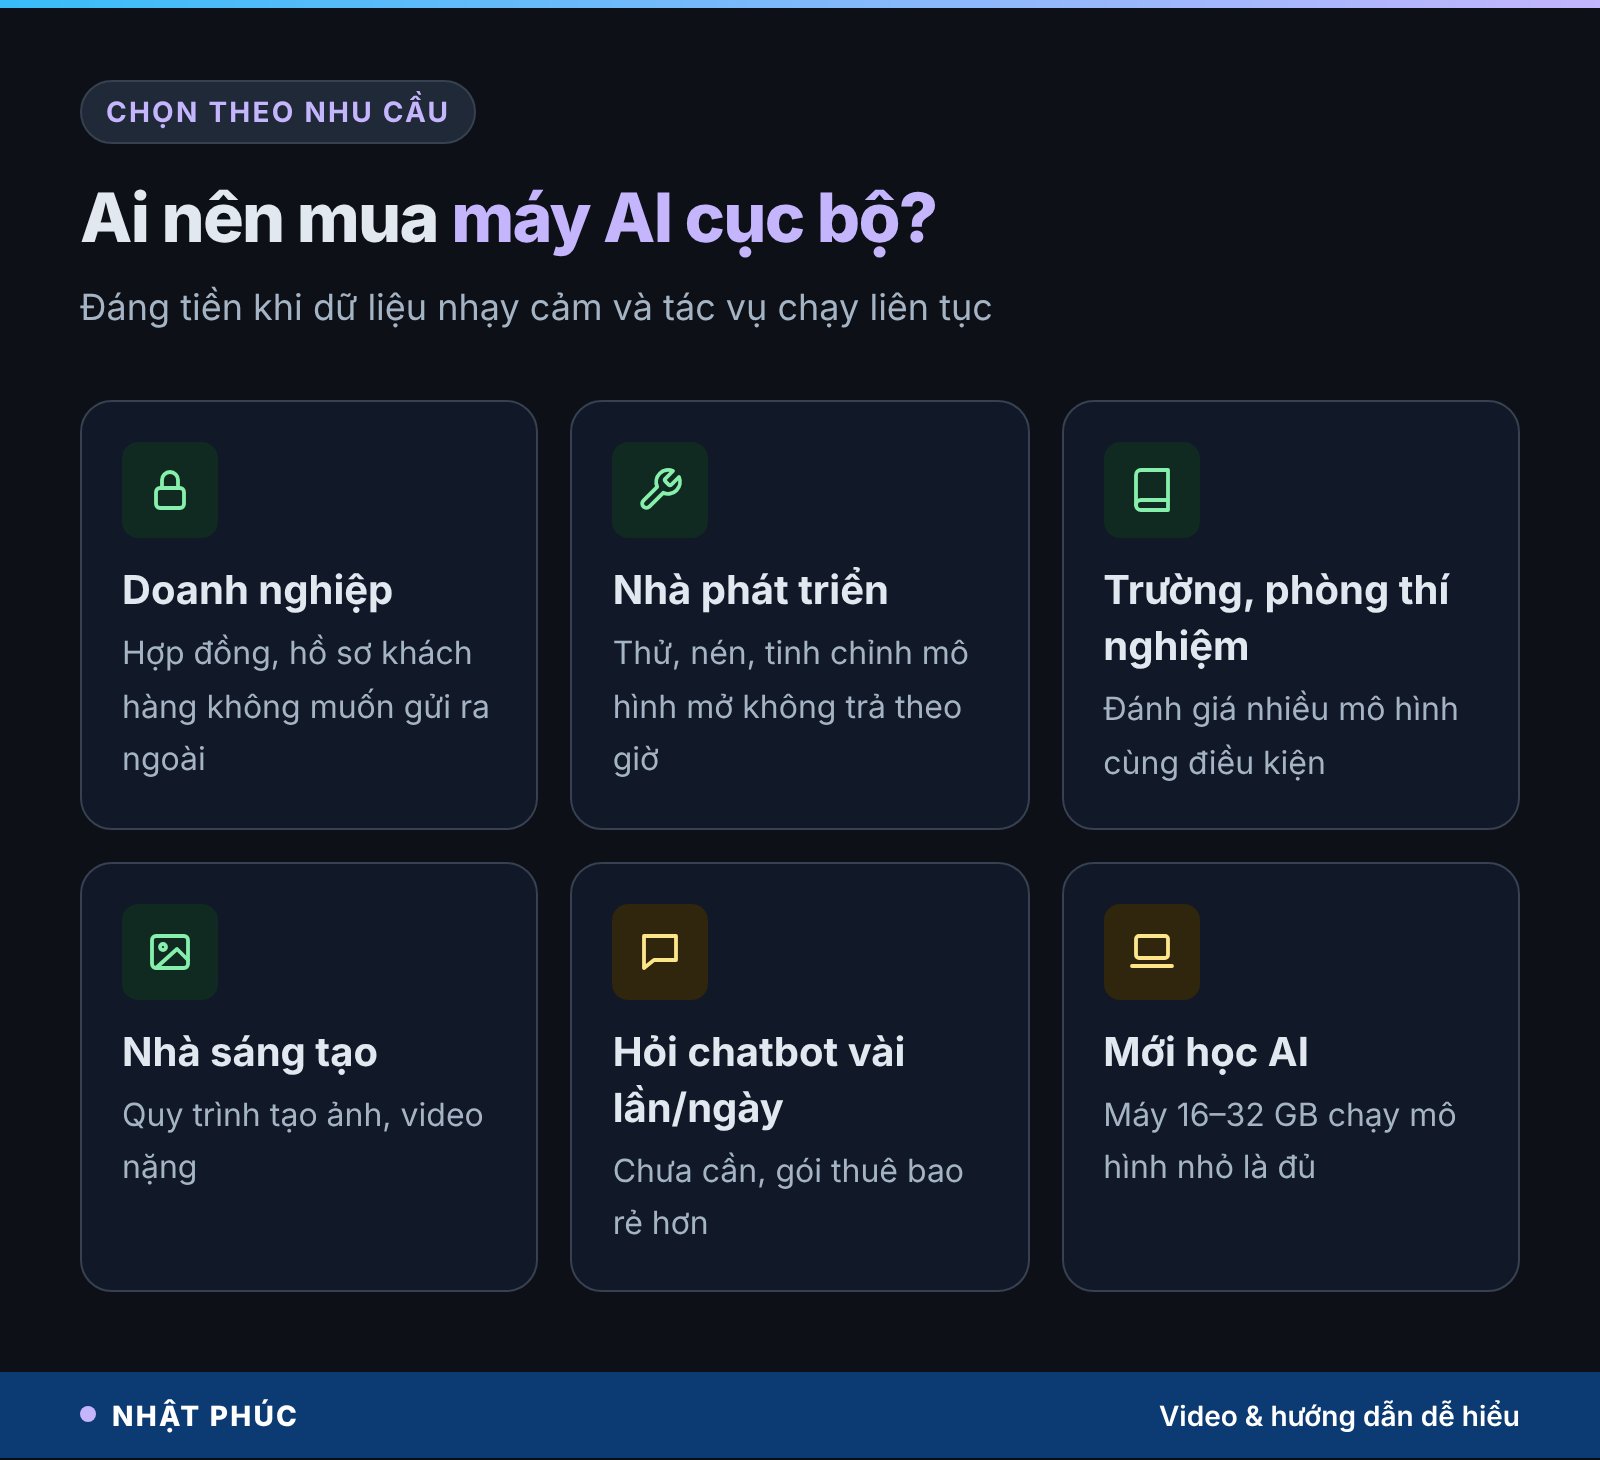
Một máy giá vài nghìn USD chỉ đáng tiền khi nó thay thế được một khoản chi khác hoặc giải được bài toán mà đám mây không giải được. Dựa trên nhóm khách hàng MSI hướng tới, có thể chia như sau.
Nhóm nên cân nhắc
- Doanh nghiệp có dữ liệu nhạy cảm: hồ sơ khách hàng, hợp đồng, dữ liệu y tế, tài chính không muốn gửi ra ngoài.
- Nhóm phát triển phần mềm AI: cần thử nghiệm, lượng tử hoá, tinh chỉnh mô hình mở mà không trả tiền theo giờ.
- Trường học, phòng thí nghiệm: đánh giá nhiều mô hình mở trong cùng điều kiện.
- Nhà sáng tạo nội dung: chạy quy trình tạo ảnh, video bằng ComfyUI với mô hình nặng.
Nhóm chưa cần
Nếu bạn chủ yếu hỏi chatbot vài lần mỗi ngày, soạn email, tóm tắt tài liệu thông thường, gói thuê bao chatbot có sẵn vẫn rẻ và mạnh hơn nhiều. Máy cũ có 16–32 GB RAM cũng đủ chạy mô hình nhỏ để học, như hướng dẫn trong bài chạy AI offline trên máy tính.
Ứng dụng máy AI cục bộ trong văn phòng ở Việt Nam
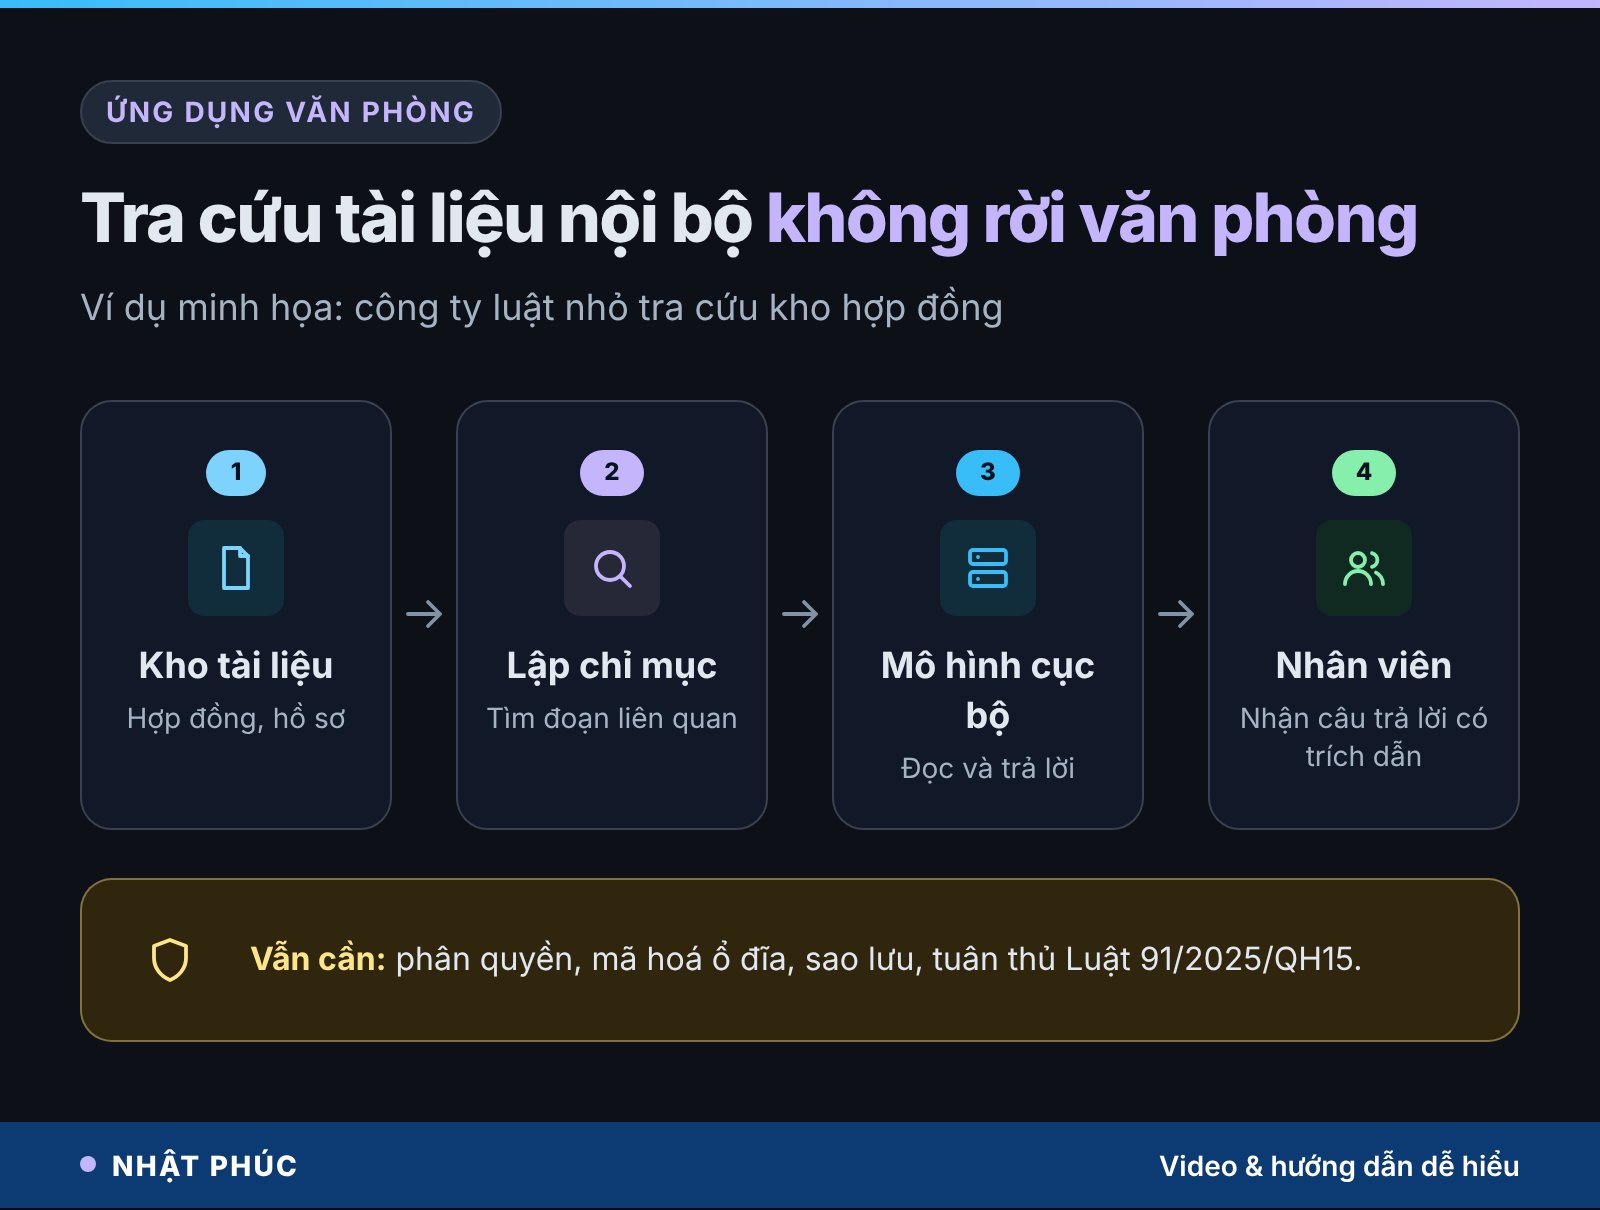
Hãy hình dung một công ty luật nhỏ ở TP.HCM với kho hàng nghìn hợp đồng mẫu và hồ sơ vụ việc. Họ muốn một trợ lý AI trả lời câu hỏi kiểu “điều khoản phạt chậm thanh toán trong các hợp đồng thuê kho năm ngoái thường là bao nhiêu” nhưng không được phép đưa hồ sơ khách hàng lên dịch vụ nước ngoài. Đây là ví dụ minh họa điển hình cho máy AI cục bộ.
Ba kiểu việc phổ biến
- Tra cứu tài liệu nội bộ (RAG): AI tìm đoạn liên quan trong kho tài liệu rồi trả lời kèm trích dẫn. Cơ chế này được giải thích trong bài RAG là gì.
- Trợ lý lập trình nội bộ: đọc mã nguồn công ty, gợi ý sửa lỗi mà mã không rời mạng nội bộ.
- Tự động hoá việc lặp lại: phân loại email, trích thông tin từ hoá đơn, chép lời cuộc họp, chạy liên tục suốt ngày đêm.
Lưu ý pháp lý và an toàn
Chạy cục bộ giúp dữ liệu không rời khỏi văn phòng, nhưng không tự động đúng luật. Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 (hiệu lực từ 1/1/2026) vẫn yêu cầu bạn có căn cứ xử lý dữ liệu, phân quyền truy cập và bảo vệ thiết bị. Máy đặt ở văn phòng cần mật khẩu mạnh, mã hoá ổ đĩa, sao lưu và nhật ký truy cập. Nếu cho tác tử AI quyền đọc email hay thao tác tệp, hãy đề phòng kiểu tấn công chèn lệnh qua nội dung, như phân tích trong bài prompt injection là gì.
Về việc làm, máy AI cục bộ không thay hẳn nhân viên mà chuyển trọng tâm công việc: bớt gõ lại, tra cứu, sắp xếp; thêm kiểm tra kết quả và đặt câu hỏi đúng. Người hiểu dữ liệu của công ty vẫn là người quyết định AI trả lời có đúng hay không.
Hiểu lầm phổ biến về máy chạy AI cục bộ
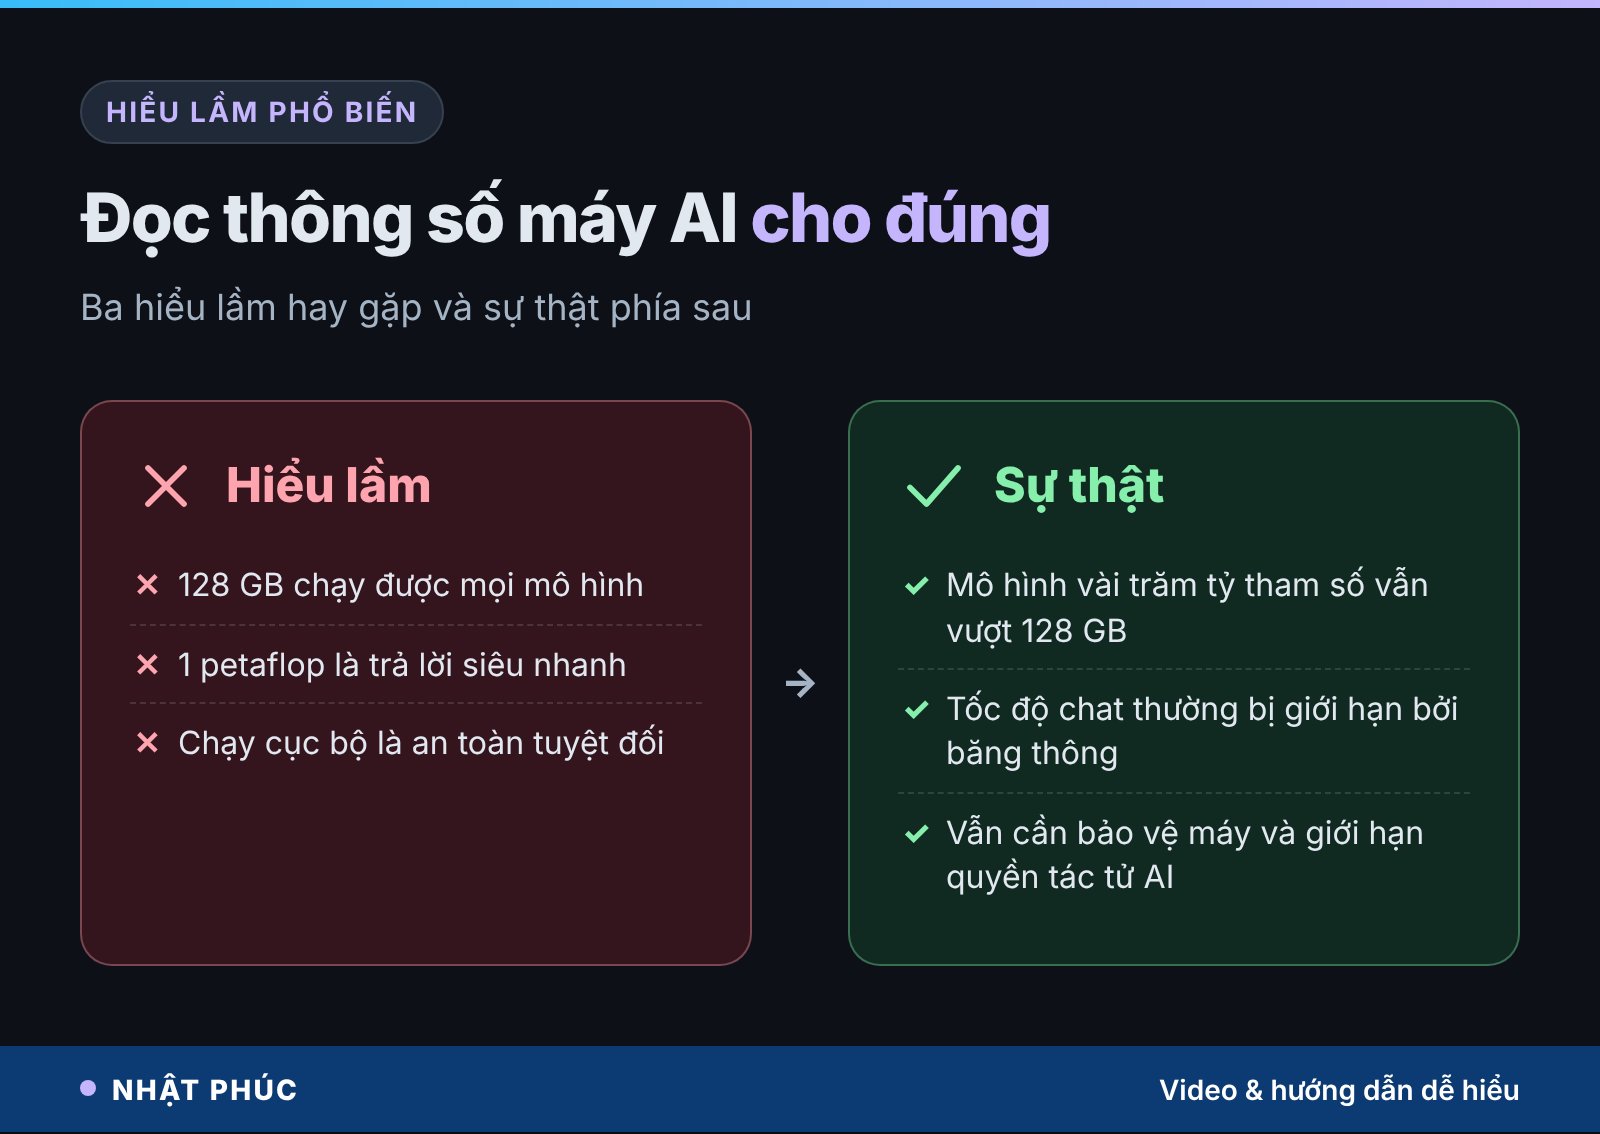
“Có 128 GB là chạy được mọi mô hình”
Không. Mô hình vài trăm tỷ tham số dù nén 4-bit vẫn có thể vượt 128 GB. Mô hình nặng nhất của các hãng lớn như GPT, Gemini, Claude cũng không phát hành trọng số để tải về.
“1 petaflop nghĩa là trả lời nhanh gấp nhiều lần”
Con số petaflop FP4 là đỉnh tính toán lý thuyết ở độ chính xác thấp. Khi trò chuyện, tốc độ sinh chữ thường bị giới hạn bởi băng thông bộ nhớ trước khi chạm đỉnh tính toán.
“Chạy cục bộ là an toàn tuyệt đối”
Dữ liệu không đi ra ngoài, nhưng vẫn có thể lộ nếu máy bị truy cập trái phép, mô hình tải từ nguồn không rõ ràng, hoặc tác tử AI được cấp quyền quá rộng.
6 bước tính toán trước khi mua máy chạy AI cục bộ
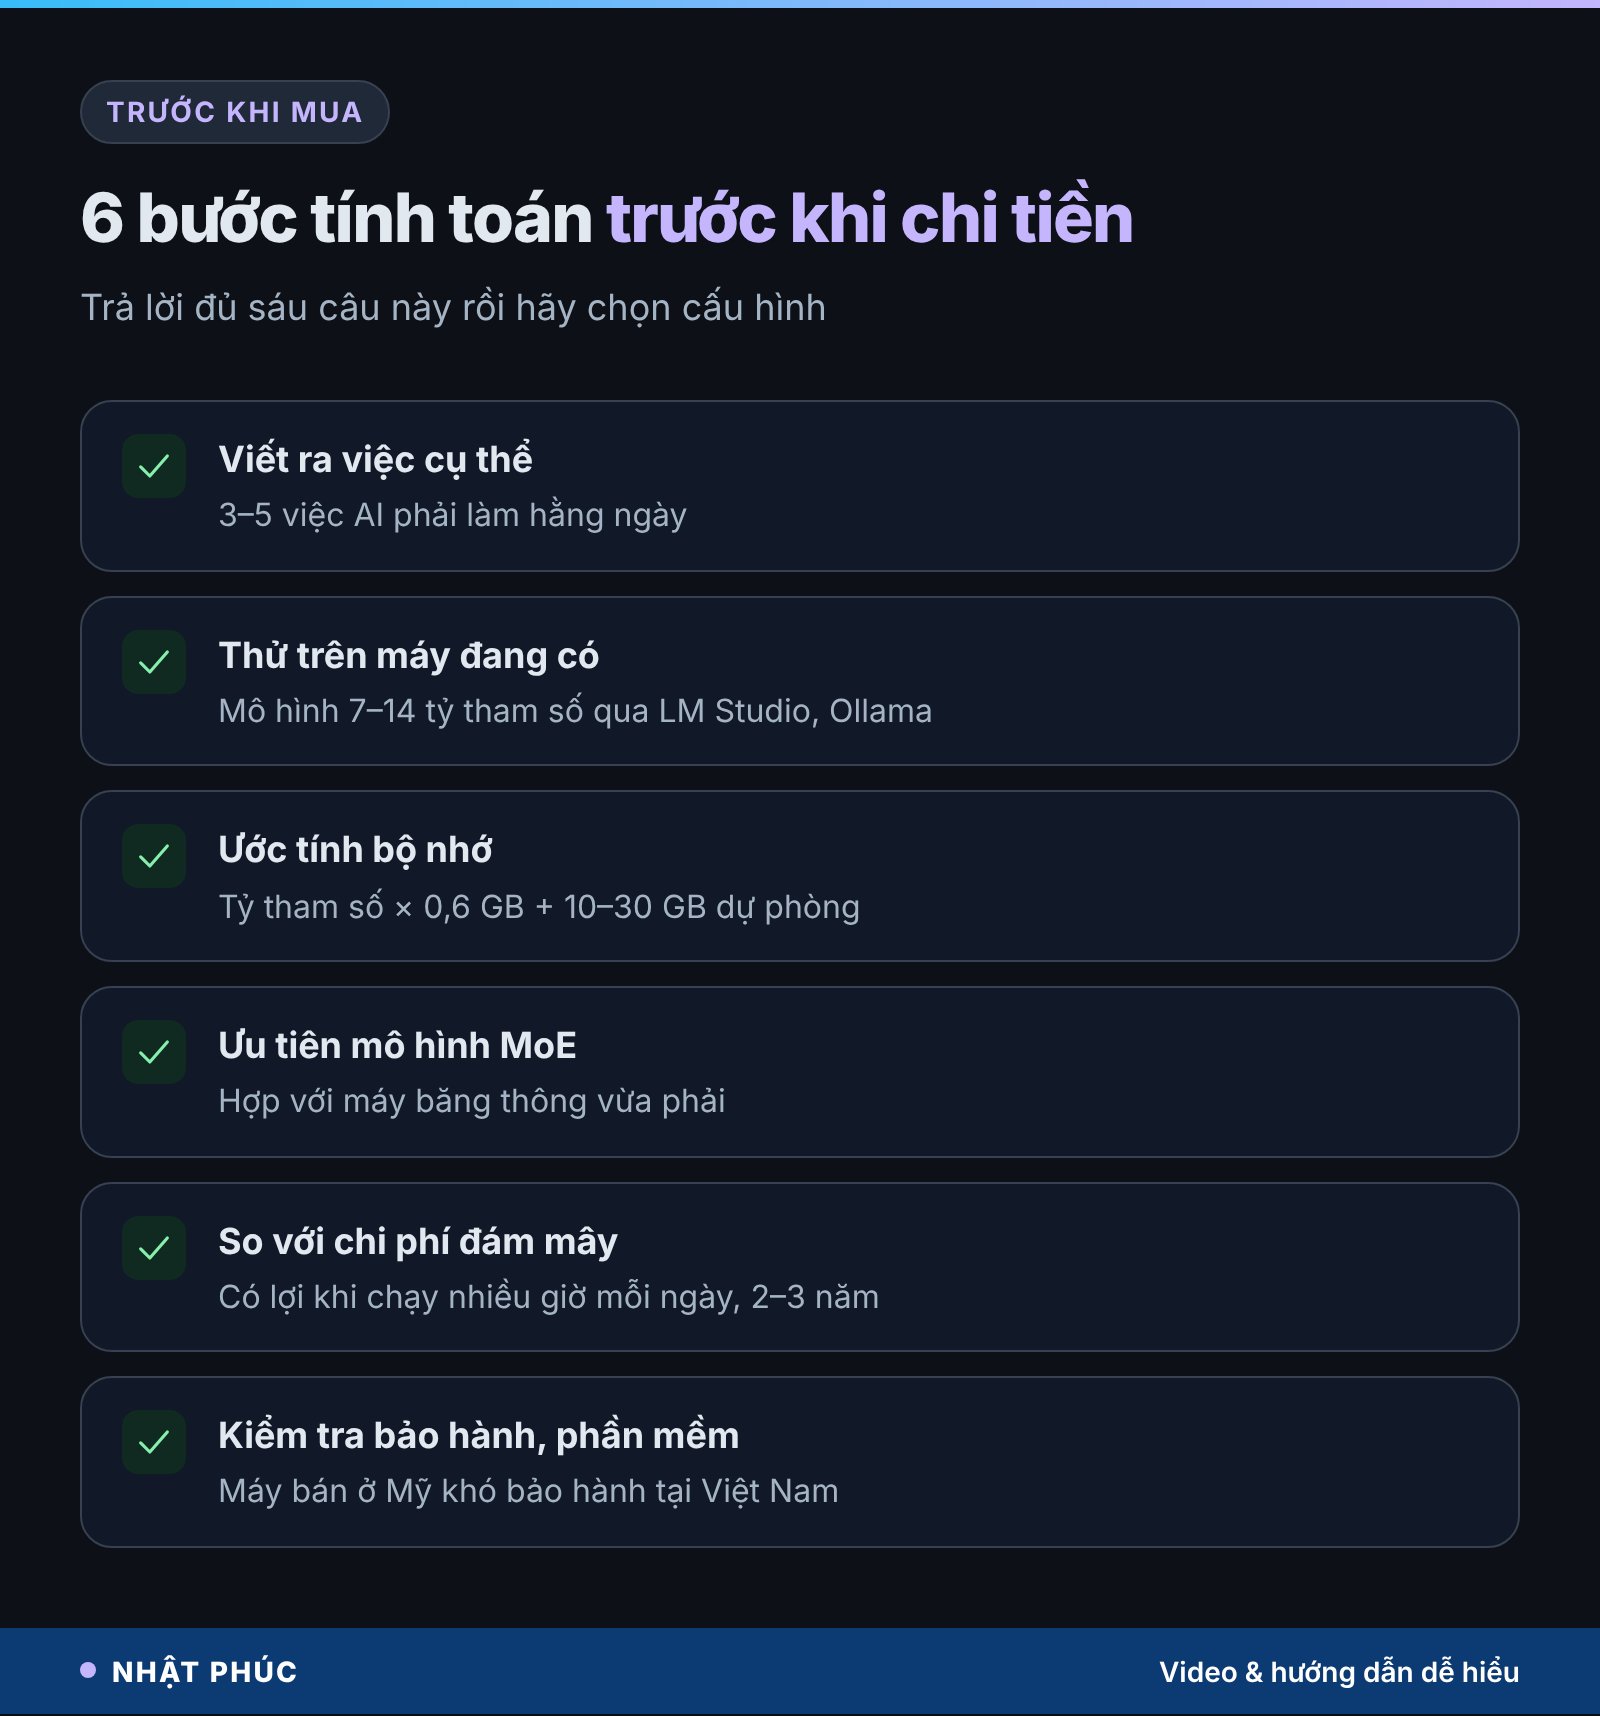
1. Viết ra việc cụ thể
Liệt kê 3–5 việc bạn muốn AI làm hằng ngày, ví dụ tóm tắt biên bản, tra cứu hợp đồng, viết mã. Việc mơ hồ dẫn đến mua thừa cấu hình.
2. Thử mô hình mở trên máy đang có
Cài công cụ như LM Studio hoặc Ollama, thử mô hình nhỏ 7–14 tỷ tham số. Nếu kết quả đã đủ tốt, bạn có thể không cần máy mới. Bài cài mô hình AI bằng LM Studio có hướng dẫn chi tiết.
3. Ước tính bộ nhớ
Nhân số tỷ tham số với khoảng 0,6 GB (4-bit), cộng 10–30 GB cho ngữ cảnh dài và hệ điều hành. Bộ nhớ hàn chết nên hãy chừa dư cho mô hình của năm sau.
4. Ưu tiên mô hình MoE nếu băng thông vừa phải
Với máy 273 GB/s, mô hình MoE có phần kích hoạt nhỏ thường cho trải nghiệm mượt hơn mô hình dày đặc cùng dung lượng.
5. So với chi phí thuê đám mây
Ước tính số giờ sử dụng mỗi tháng và chi phí API tương đương. Nếu máy chạy liên tục nhiều giờ mỗi ngày trong 2–3 năm, đầu tư một lần mới bắt đầu có lợi.
6. Kiểm tra bảo hành, phân phối và phần mềm
Máy mới chỉ bán ở Mỹ thì mua về Việt Nam sẽ khó bảo hành. Hãy kiểm tra phần mềm bạn cần đã hỗ trợ Windows trên chip Arm và CUDA trên nền tảng mới hay chưa.
Câu hỏi thường gặp về bộ nhớ hợp nhất và máy AI cục bộ
Bộ nhớ hợp nhất có giống RAM thường không?
Về vật lý, nó vẫn là chip RAM (thường là LPDDR5X). Khác biệt nằm ở cách dùng: CPU và GPU cùng truy cập một vùng nhớ, không chia thành RAM và VRAM riêng. Nhờ vậy GPU có thể dùng phần lớn dung lượng máy cho mô hình AI, đổi lại không nâng cấp được sau khi mua.
Máy 64 GB chạy được mô hình bao nhiêu tham số?
Ước tính tham khảo, máy 64 GB chạy thoải mái mô hình 30–40 tỷ tham số nén 4-bit kèm ngữ cảnh khá dài, và có thể chạy mô hình khoảng 70 tỷ tham số nén 4-bit với ngữ cảnh ngắn. Con số thực tế phụ thuộc định dạng nén, phần mềm và các ứng dụng khác đang mở.
MSI EdgeMesa N AI+ có bán ở Việt Nam không?
Tại thời điểm viết bài, máy chỉ được bán qua cửa hàng MSI tại Mỹ. MSI chưa công bố giá hay lịch bán cho thị trường khác. Nếu mua xách tay, bạn nên tính tới thuế, bảo hành và nguồn điện.
Máy chạy Windows trên chip Arm có dùng được phần mềm quen thuộc?
Phần lớn ứng dụng phổ biến đã có bản cho Windows trên Arm hoặc chạy qua lớp giả lập. Các công cụ AI dựa trên CUDA được NVIDIA hỗ trợ trên nền tảng này, nhưng phần mềm chuyên ngành cũ và driver thiết bị ngoại vi nên kiểm tra kỹ trước khi mua.
Mô hình chạy cục bộ có hiểu tiếng Việt không?
Tuỳ mô hình. Nhiều mô hình mở đa ngôn ngữ đọc và viết tiếng Việt ở mức dùng được, nhưng chất lượng thường kém mô hình đám mây hàng đầu. Hãy thử mô hình trên chính tài liệu tiếng Việt của bạn trước khi triển khai cho cả nhóm.
Có nên mua máy AI cục bộ thay vì trả phí chatbot?
Với cá nhân dùng không thường xuyên thì chưa nên. Máy cục bộ hợp lý khi dữ liệu không được rời khỏi công ty, tác vụ chạy liên tục hoặc bạn cần tự tinh chỉnh mô hình. Nhiều nơi kết hợp cả hai: việc nhạy cảm chạy cục bộ, việc phổ thông dùng đám mây.
Kết luận
Bộ nhớ hợp nhất là chìa khoá khiến những chiếc máy tính mini cỡ hộp cơm có thể chạy mô hình AI hàng trăm tỷ tham số ngay trên bàn làm việc. Khi đọc thông số, hãy nhìn đồng thời hai con số: dung lượng cho biết mô hình nào nạp vừa, băng thông cho biết máy trả lời nhanh đến đâu. Với mức giá hiện tại, máy như MSI EdgeMesa N AI+ hướng tới doanh nghiệp và nhà phát triển cần giữ dữ liệu trong nhà hơn là người dùng phổ thông.
Bạn đang chạy AI trên máy tính của mình hay vẫn dùng chatbot trên mây? Hãy chia sẻ cấu hình và nhu cầu của bạn ở phần bình luận, và theo dõi Nhật Phúc để đọc thêm những bài giải thích công nghệ dễ hiểu.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.