Mỗi lần bạn hỏi một chatbot, tìm kiếm có tóm tắt AI hay nhờ AI viết đoạn mã, ở đâu đó trong trung tâm dữ liệu có hàng nghìn con chip đang làm phép nhân ma trận. Phần lớn người dùng chỉ nghe nói tới GPU. Nhưng Google có một loại chip riêng, đã chạy âm thầm hơn mười năm, và giờ đang được chính các đối thủ AI đặt mua với số lượng rất lớn. Đó là TPU.
Câu trả lời ngắn: TPU (Tensor Processing Unit) là chip chuyên dụng do Google tự thiết kế chỉ để chạy các phép tính của mạng nơ-ron. Nó bỏ bớt sự đa năng của CPU và GPU để đổi lấy tốc độ và hiệu quả điện năng cao hơn khi huấn luyện và vận hành mô hình AI. Bạn có thể dùng thử TPU miễn phí trên Google Colab và Kaggle.
Bài viết này giải thích TPU là gì theo cách dễ hiểu nhất, vì sao thế hệ TPU 8 được tách thành nhiều hệ thống khác nhau, vì sao Anthropic và OpenAI quan tâm tới chip của Google, và người Việt có thể tự tay chạy thử TPU ra sao.
Tóm tắt nhanh
- TPU là chip ASIC của Google, chuyên làm phép nhân ma trận cho AI; Google dùng nội bộ từ 2015, công bố năm 2016.
- Trái tim của TPU là mảng tâm thu (systolic array): dữ liệu chảy qua hàng chục nghìn ô nhân cộng như dây chuyền.
- Thế hệ 8 có 4 hệ thống: 8t (huấn luyện), 8i (suy luận), 8tx (suy luận bảo mật) và 8i Max (ngữ cảnh rất dài).
- Anthropic đã công bố dùng tới 1 triệu TPU; nhà phân tích Ming-Chi Kuo dự báo OpenAI và Anthropic chiếm khoảng 80% lượng TPU xuất xưởng 2028–2029.
- Người Việt dùng được TPU qua Google Colab, Kaggle (miễn phí, có giới hạn) và Google Cloud (trả phí).
Nội dung chính:
- TPU là gì? Hiểu bằng một ví von
- TPU hoạt động thế nào: mảng tâm thu
- Lịch sử TPU qua các thế hệ
- TPU thế hệ 8: vì sao tách thành bốn hệ thống
- Suy luận bảo mật trên TPU 8tx là gì
- Vì sao Anthropic và OpenAI mua TPU
- TPU và GPU: khác nhau ở đâu
- Người Việt dùng TPU được không
- 5 bước chạy thử TPU trên Google Colab
- Hiểu lầm phổ biến về TPU
- Câu hỏi thường gặp
TPU là gì? Hiểu bằng một ví von
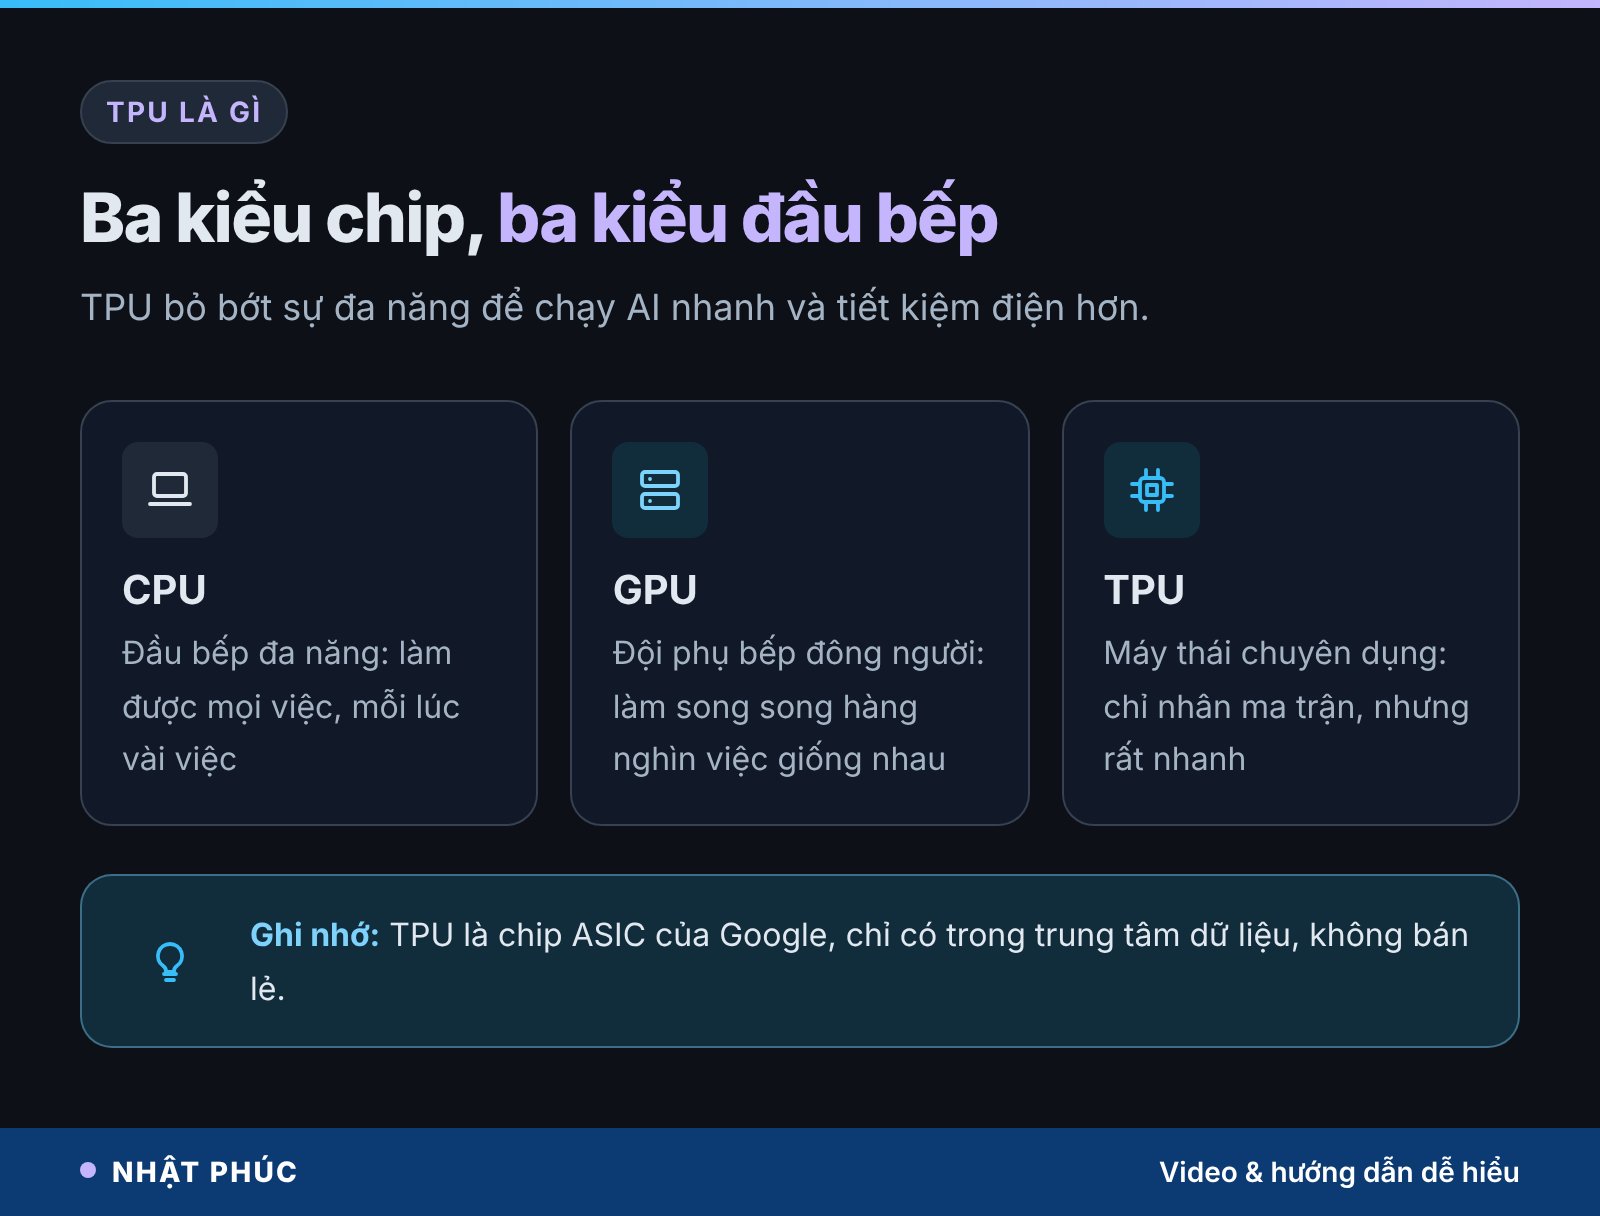
Hãy hình dung một căn bếp. CPU giống người đầu bếp đa năng: nấu được mọi món, nhưng mỗi lúc chỉ làm vài việc. GPU giống cả một đội phụ bếp đông người, rất giỏi thái hàng nghìn củ hành cùng lúc. Còn TPU giống một cỗ máy thái chuyên dụng trong nhà máy thực phẩm: nó chỉ làm một kiểu việc, nhưng làm việc đó nhanh và tốn ít điện hơn hẳn.
Về mặt kỹ thuật, TPU thuộc nhóm ASIC (Application-Specific Integrated Circuit), tức mạch tích hợp chế tạo riêng cho một ứng dụng. Ứng dụng ở đây là tính toán tensor, những khối số nhiều chiều mà mạng nơ-ron dùng để biểu diễn chữ, ảnh, âm thanh. Gần như toàn bộ công việc của một mô hình ngôn ngữ lớn quy về phép nhân ma trận và cộng dồn, nên một con chip chỉ giỏi đúng việc này có thể bỏ đi rất nhiều mạch điều khiển phức tạp mà CPU hay GPU phải mang theo.
Nếu bạn muốn hiểu kỹ vì sao card đồ hoạ lại chạy được AI, bài GPU là gì và vì sao GPU chạy được AI đã giải thích chi tiết. Còn con chip AI nhỏ trong laptop là chuyện khác, xem bài NPU là gì. Điểm khác biệt quan trọng: NPU nằm trong máy cá nhân, còn TPU chỉ có trong trung tâm dữ liệu của Google, bạn không mua lẻ được.
TPU hoạt động thế nào: mảng tâm thu nhân ma trận
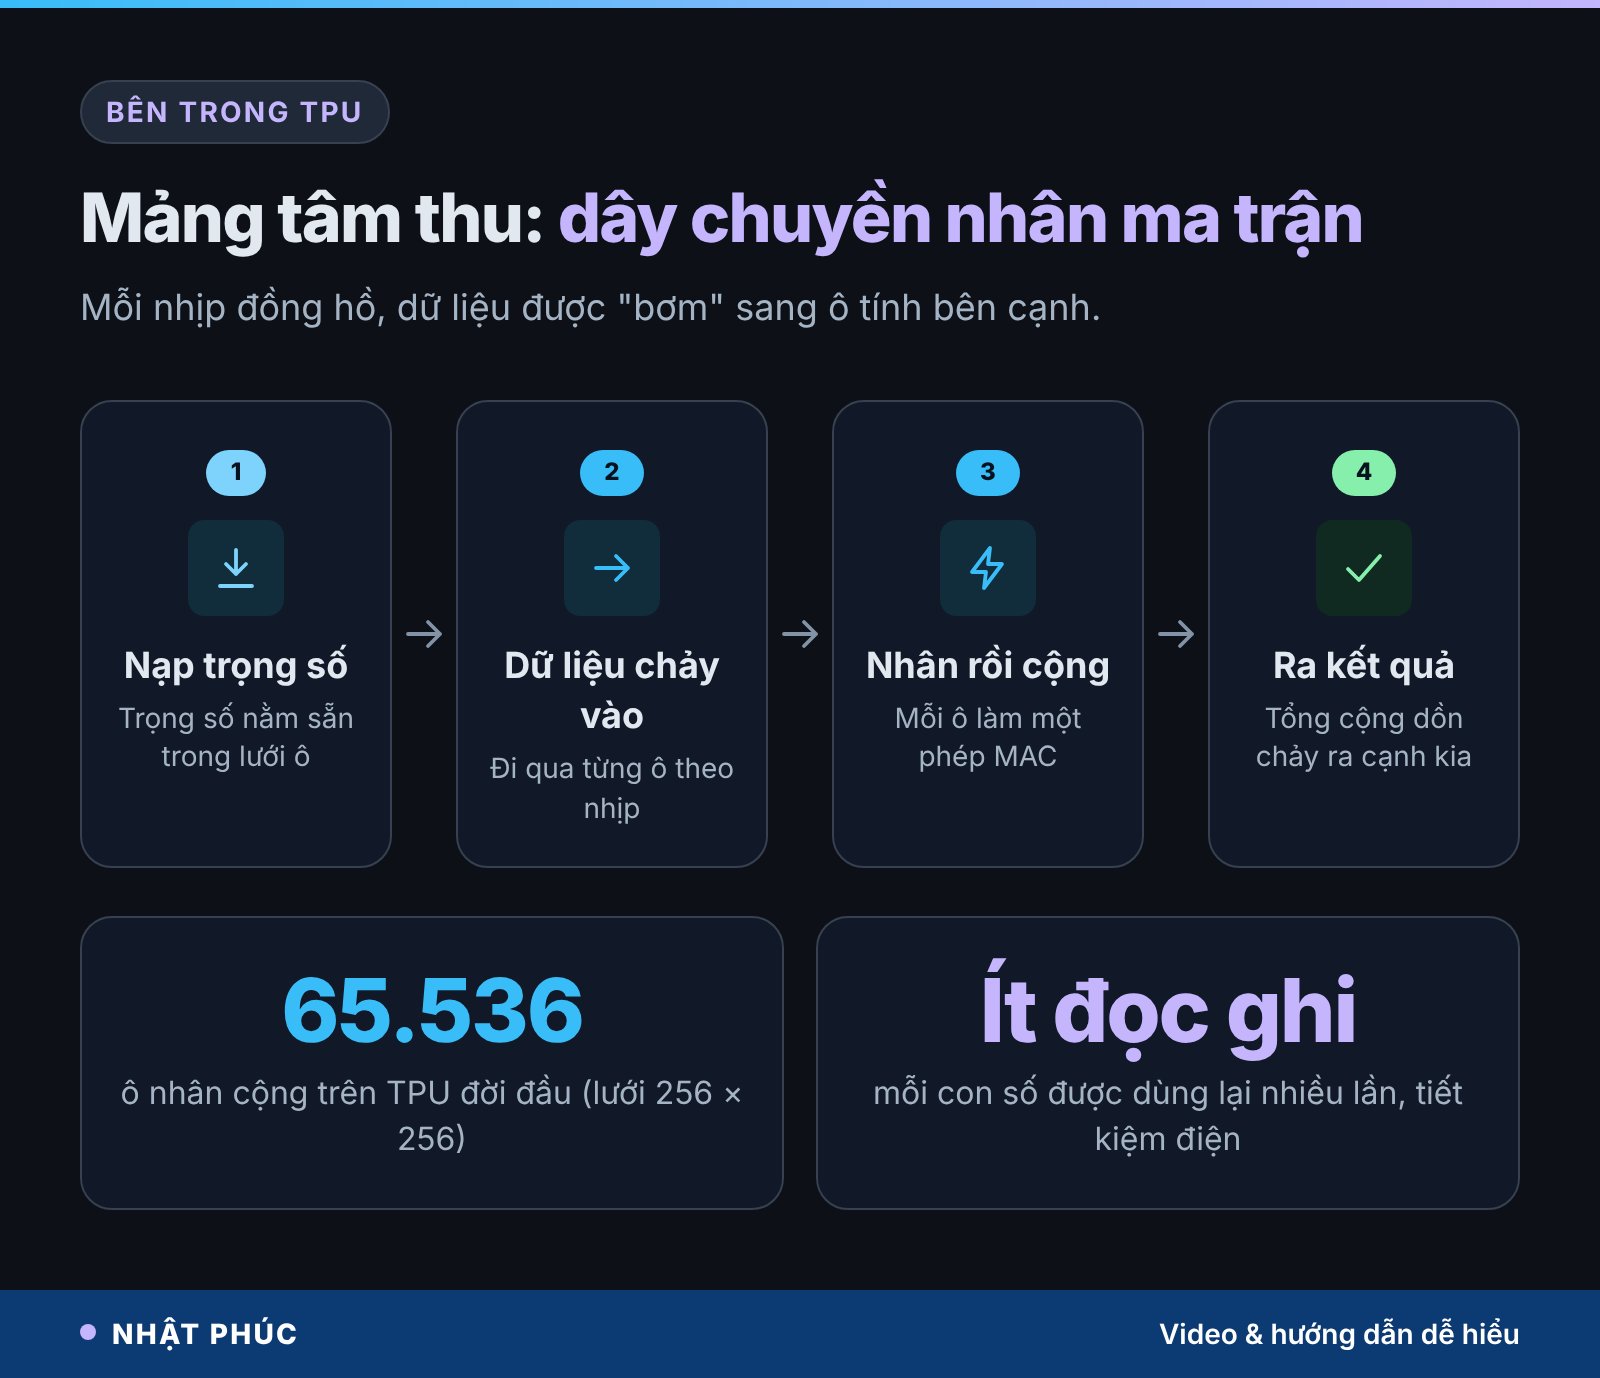
Bí quyết của TPU nằm ở một cấu trúc có cái tên hơi lạ: mảng tâm thu (systolic array). Chữ “tâm thu” lấy từ nhịp tim: mỗi nhịp, máu được bơm đi một đoạn. Trong TPU, mỗi nhịp đồng hồ, dữ liệu được “bơm” sang ô tính bên cạnh.
Dây chuyền hàng chục nghìn ô nhân cộng
Mảng tâm thu là một lưới gồm rất nhiều ô nhỏ, mỗi ô chỉ biết làm một việc: nhân hai số rồi cộng vào tổng đang có (gọi là MAC, multiply-accumulate). Trọng số của mô hình được nạp sẵn vào các ô. Dữ liệu đầu vào chảy vào từ một cạnh, đi qua từng ô theo nhịp, còn kết quả cộng dồn chảy theo hướng còn lại. Theo bài báo khoa học Google công bố năm 2017 về TPU đầu tiên, con chip này có lưới 256 × 256, tức 65.536 ô nhân cộng chạy song song.
Vì sao cách này tiết kiệm điện
Trong máy tính, việc tốn năng lượng nhất thường không phải là phép tính mà là việc đọc ghi bộ nhớ. CPU và GPU phải liên tục lấy số từ bộ nhớ ra, tính, rồi cất lại. Mảng tâm thu thì dùng lại mỗi con số nhiều lần khi nó trôi qua lưới, nên số lần truy cập bộ nhớ giảm mạnh. Hãy nghĩ tới một dây chuyền đóng gói: thay vì mỗi công nhân tự chạy vào kho lấy hàng, hàng được băng chuyền đưa tới tận tay.
TPU còn dùng số có độ chính xác thấp (8 bit ở thế hệ đầu, rồi bfloat16, FP8, FP4 ở các thế hệ sau). Mạng nơ-ron chịu được sai số nhỏ, nên chip tính nhanh hơn mà kết quả gần như không đổi.
Lịch sử TPU qua các thế hệ
Câu chuyện bắt đầu từ một bài toán rất thực tế. Khoảng đầu những năm 2010, Google tính rằng nếu người dùng chỉ dùng tìm kiếm bằng giọng nói vài phút mỗi ngày, lượng máy chủ cần thêm sẽ khổng lồ. Thay vì mua thêm máy, họ tự làm chip.
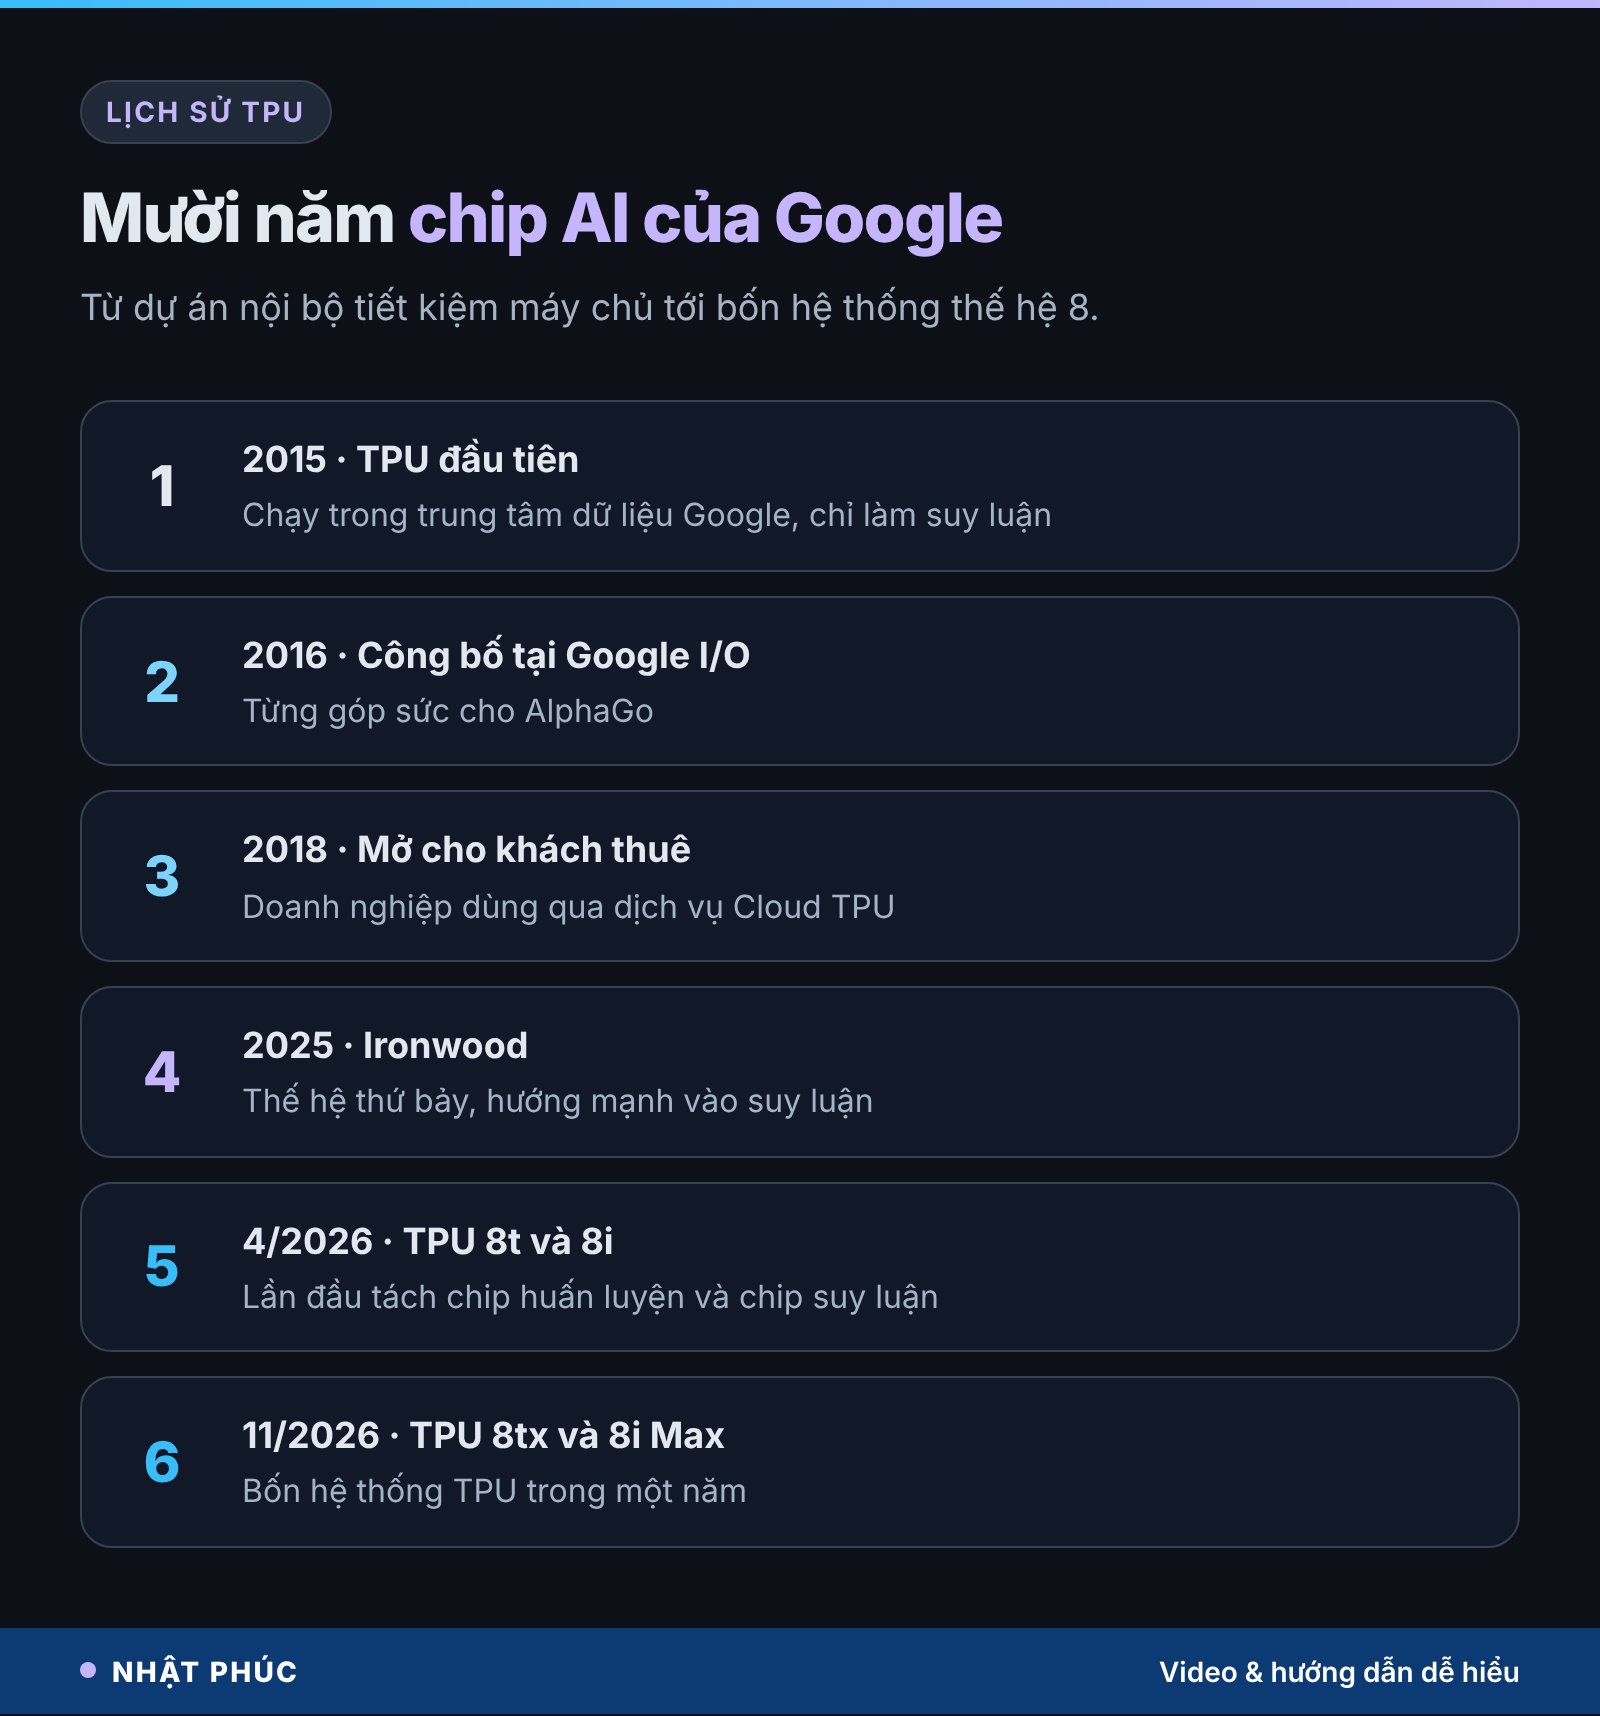
- 2015: TPU đầu tiên chạy trong trung tâm dữ liệu của Google, chỉ làm suy luận (chạy mô hình đã huấn luyện xong).
- 2016: Google công bố TPU tại hội nghị Google I/O. Chip này từng góp sức cho AlphaGo.
- 2017–2018: TPU thế hệ hai hỗ trợ cả huấn luyện; từ 2018 các doanh nghiệp bên ngoài thuê được qua dịch vụ Cloud TPU.
- 2025: Ironwood, thế hệ thứ bảy, hướng mạnh vào suy luận.
- Tháng 4/2026: tại Google Cloud Next 26, Google lần đầu tách thế hệ 8 thành hai chip riêng: TPU 8t cho huấn luyện và TPU 8i cho suy luận.
- Tháng 11/2026: thêm TPU 8tx và TPU 8i Max, nâng tổng số hệ thống TPU ra mắt trong một năm lên bốn, lần đầu tiên trong lịch sử dòng chip này.
Mười năm qua, TPU đã đi từ một dự án nội bộ để tiết kiệm máy chủ thành sản phẩm mà Google cho biết có gần 100 khách hàng, gồm các phòng thí nghiệm AI hàng đầu, công ty giao dịch tài chính, nhà bán lẻ và trường đại học.
TPU thế hệ 8: vì sao tách thành bốn hệ thống
Huấn luyện và suy luận là hai bài toán khác nhau
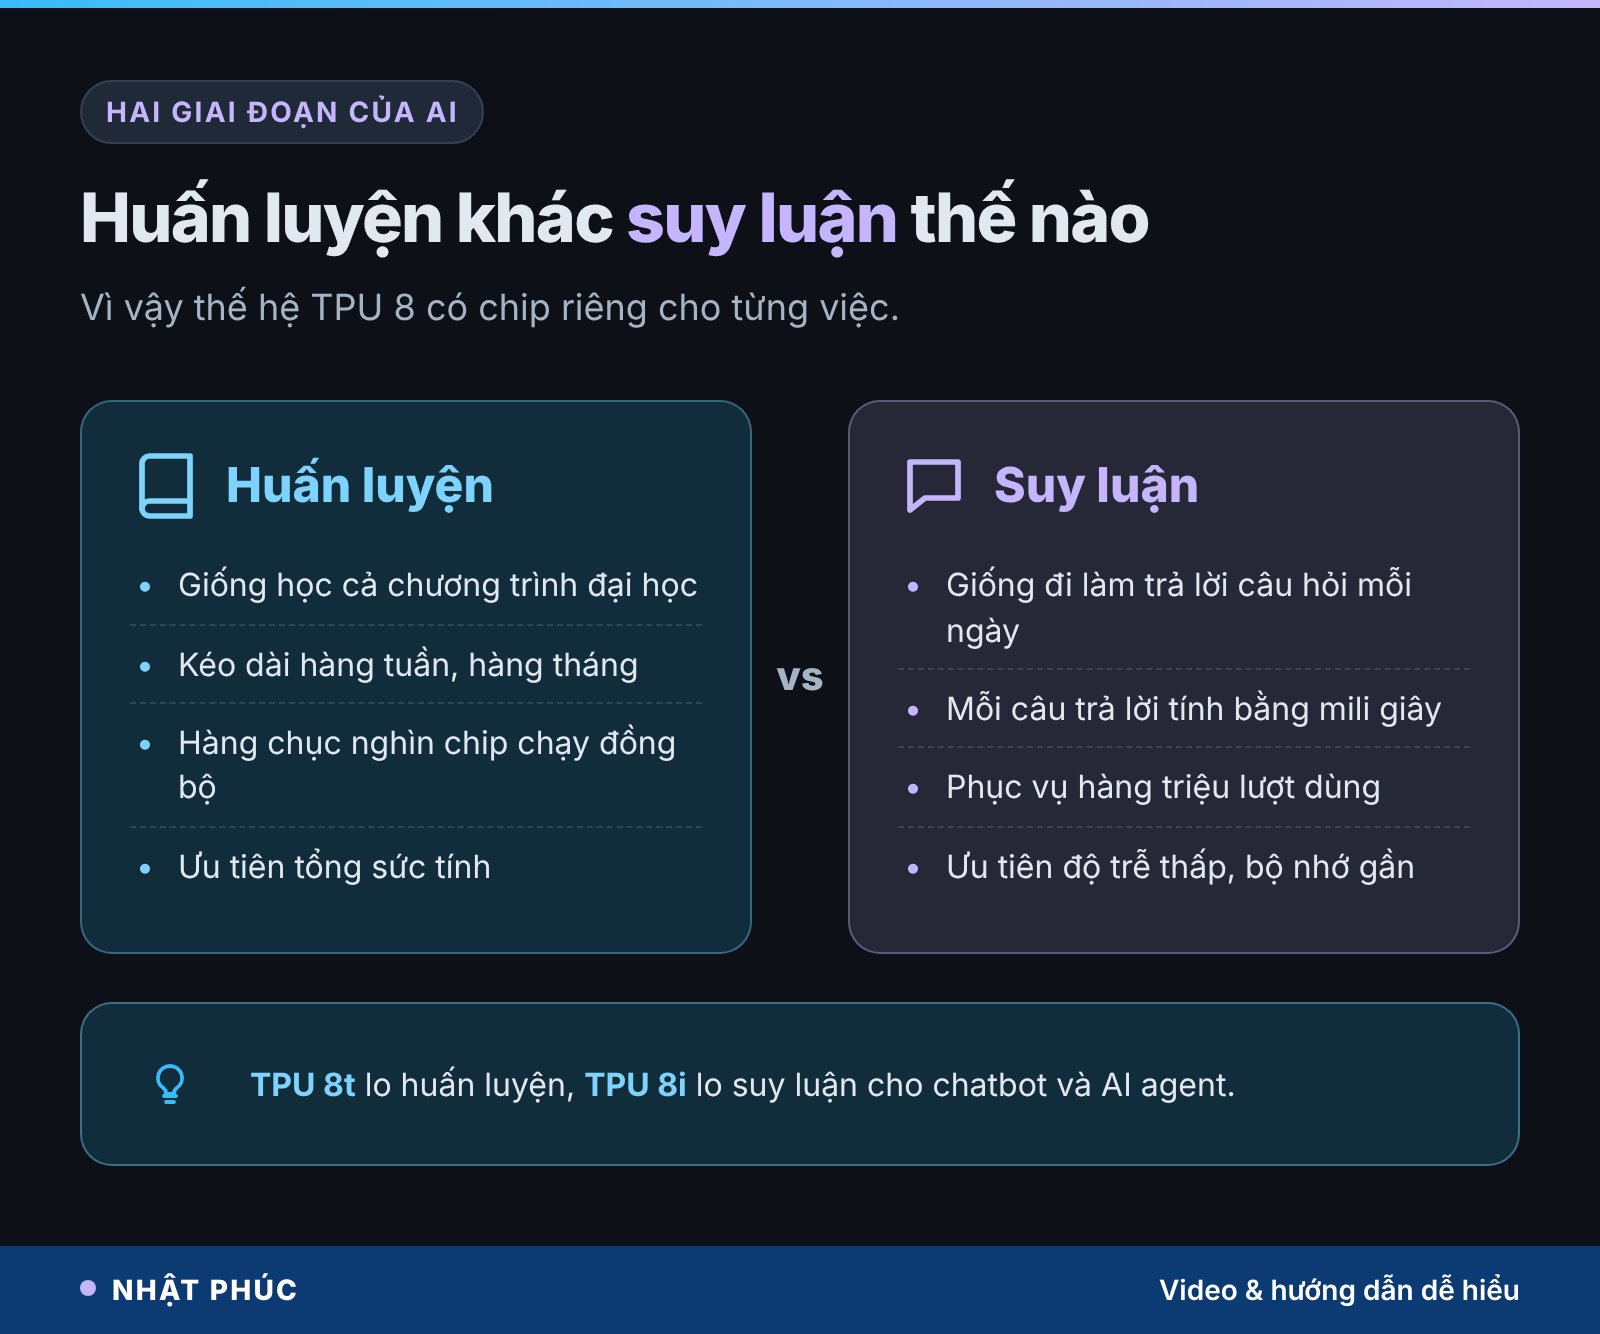
Muốn hiểu vì sao Google tách dòng chip, cần phân biệt hai giai đoạn của một mô hình AI. Huấn luyện giống việc học cả chương trình đại học: tốn hàng tháng, cần hàng chục nghìn chip làm việc đồng bộ, ưu tiên sức tính tổng. Suy luận giống việc đi làm hằng ngày: mỗi câu hỏi phải trả lời trong tích tắc, ưu tiên độ trễ thấp và bộ nhớ đủ chứa “trí nhớ ngắn hạn” của cuộc trò chuyện.
Khi AI agent phổ biến, suy luận ngày càng nặng: một tác tử có thể đọc cả kho mã nguồn hay hàng giờ video, chạy nhiều bước liên tiếp. Một con chip “làm mọi việc ở mức khá” không còn tối ưu nữa.
Bốn hệ thống, hai loại chip
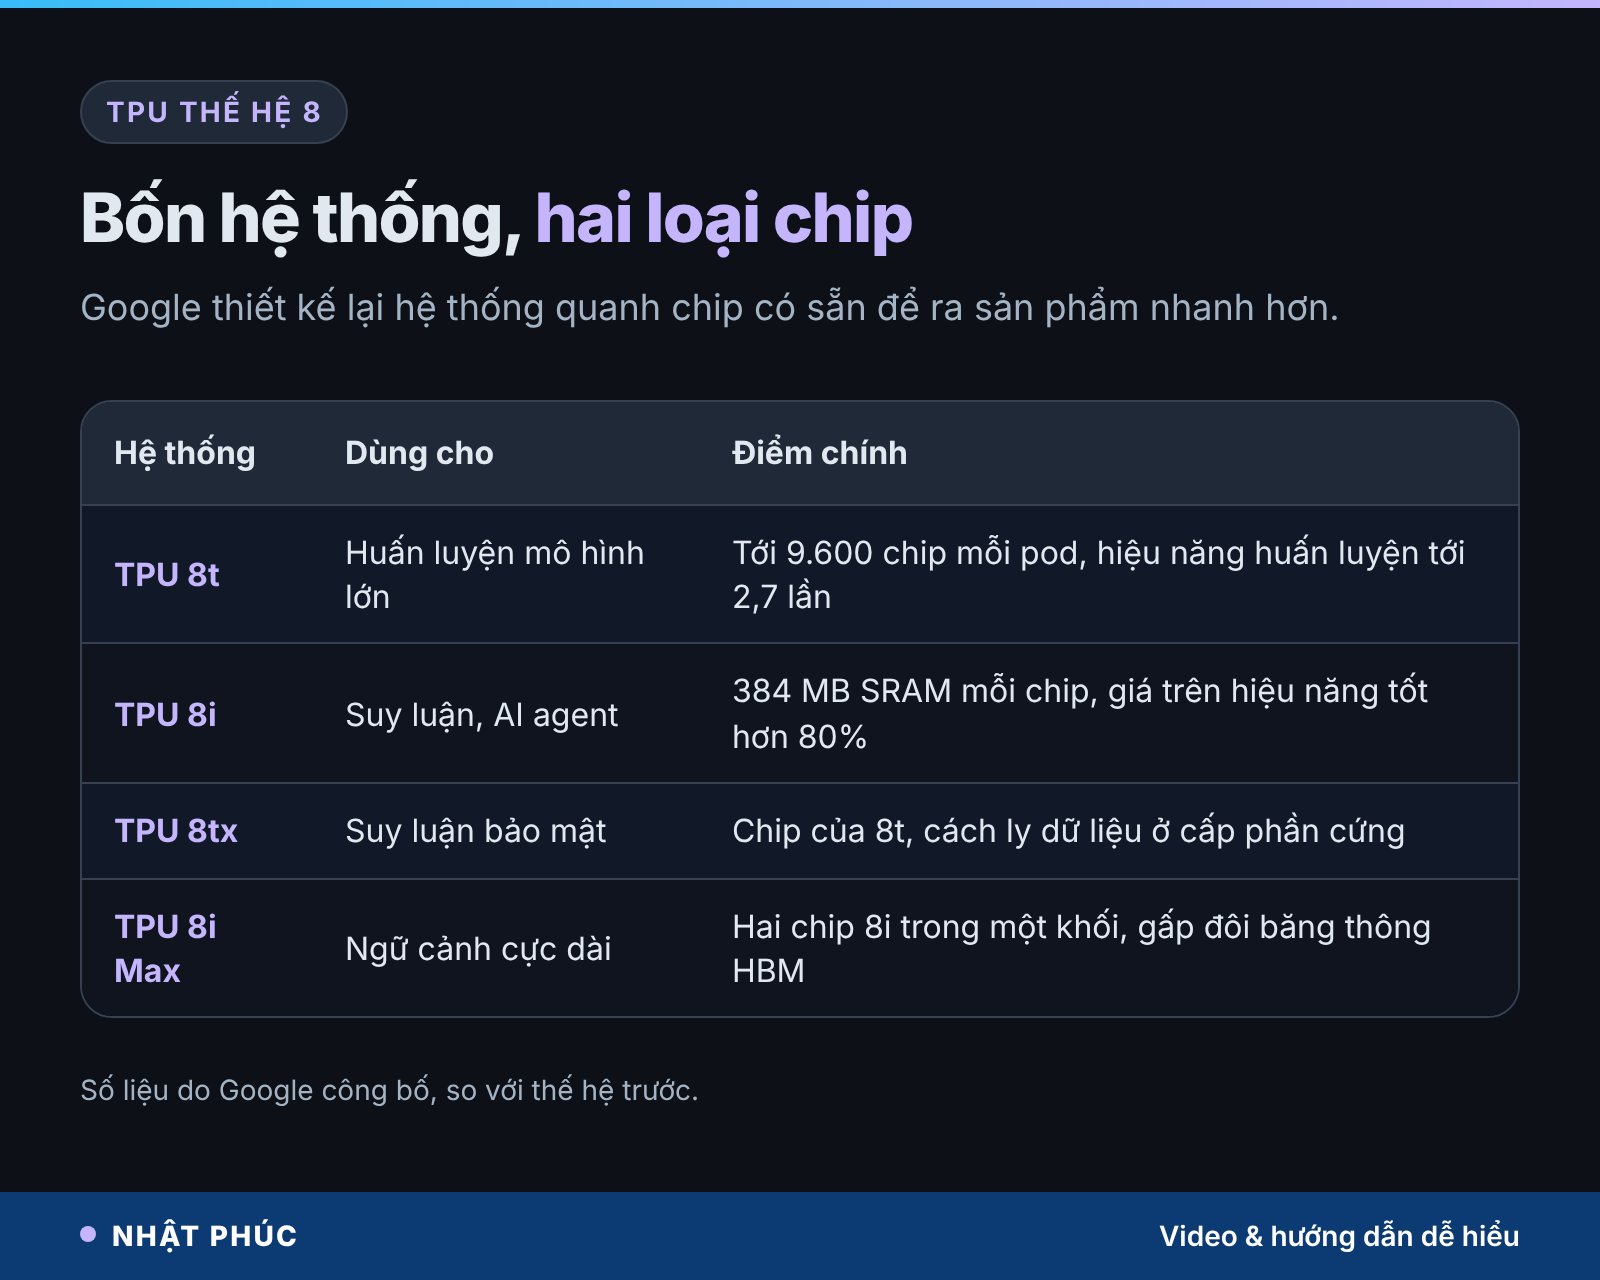
Theo các thông tin Google công bố, TPU 8t dành cho huấn luyện: mỗi pod có thể ghép tới 9.600 chip, hiệu năng huấn luyện tới 2,7 lần thế hệ trước. TPU 8i dành cho suy luận: mỗi chip có 384 MB SRAM ngay trên chip để giữ dữ liệu của tác tử, dùng kiểu mạng Boardfly giảm độ trễ, và Google cho biết hiệu quả giá trên hiệu năng suy luận tốt hơn 80% so với thế hệ trước.
Ngày 9/11/2026 (giờ Mỹ), Google bổ sung hai hệ thống dựng trên chính hai con chip đó. TPU 8i Max gói hai chip 8i vào một khối, gấp đôi sức tính, SRAM và băng thông bộ nhớ HBM so với 8i, nhắm tới các mô hình cần cửa sổ ngữ cảnh cực lớn. TPU 8tx dùng chip của 8t nhưng thêm khả năng tính toán bảo mật ở cấp phần cứng.
Lý do Google đưa ra khá thực tế: thiết kế một con chip mới mất nhiều năm, còn thiết kế lại cả hệ thống quanh con chip có sẵn (mạng, bộ nhớ, đóng gói, máy chủ đi kèm) thì nhanh hơn nhiều, nên có thể đáp ứng nhu cầu khách hàng trong vài tháng.
Suy luận bảo mật trên TPU 8tx là gì
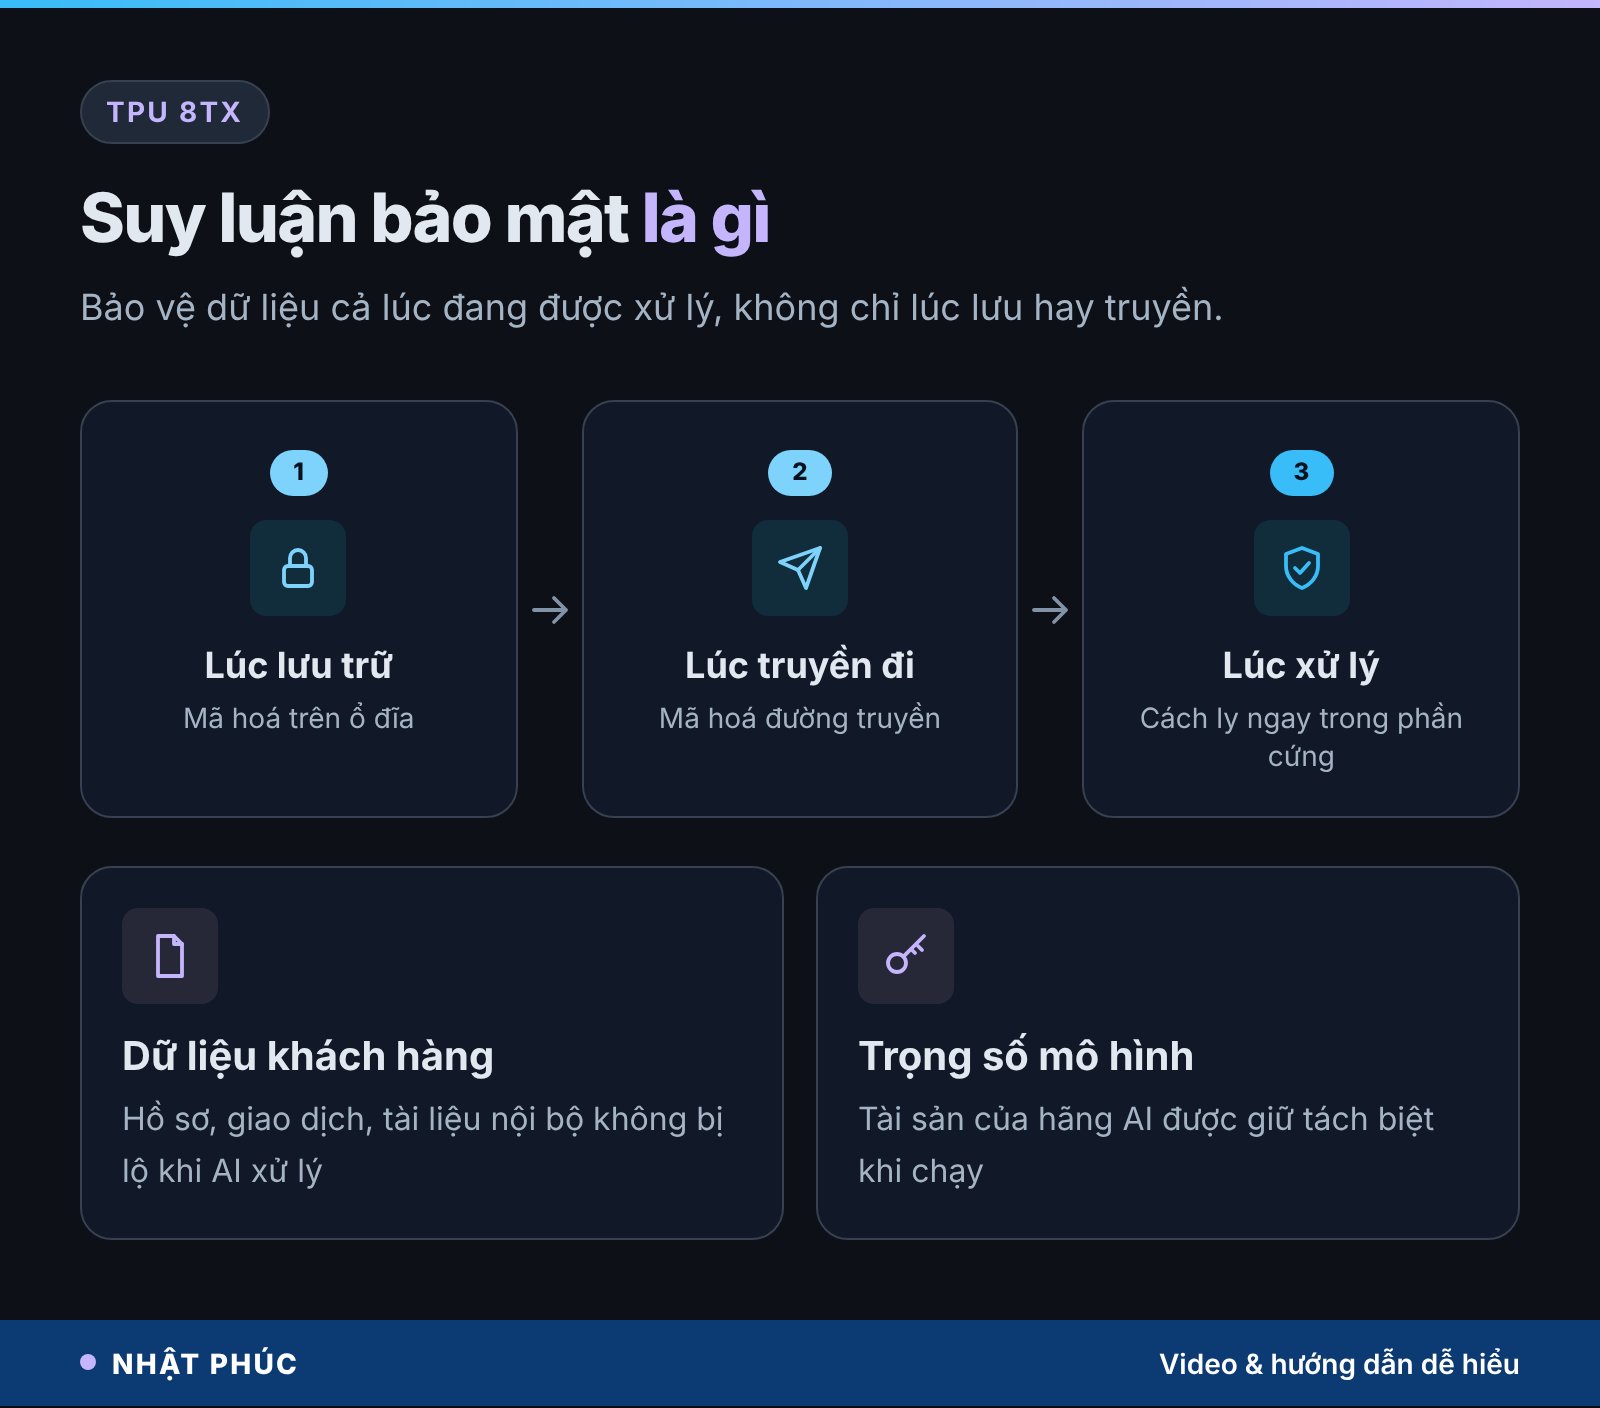
Dữ liệu thường được bảo vệ ở hai trạng thái: khi nằm yên trong ổ đĩa (mã hoá lưu trữ) và khi di chuyển trên mạng (mã hoá đường truyền). Nhưng lúc đang được xử lý, dữ liệu phải giải mã trong bộ nhớ, và đó là khe hở. Tính toán bảo mật (confidential computing) bịt khe hở này bằng cách cách ly vùng xử lý ngay trong phần cứng, để cả quản trị viên máy chủ cũng không đọc được dữ liệu đang chạy.
Với AI, thứ cần bảo vệ có hai: dữ liệu của khách hàng (hồ sơ bệnh án, giao dịch ngân hàng, tài liệu nội bộ) và trọng số mô hình, tài sản trị giá hàng tỷ USD của hãng AI. Google cho biết TPU 8tx giữ cả hai tách biệt trong lúc sử dụng, đi kèm CPU AMD EPYC thế hệ 5, độ trễ thấp hơn tới 2 lần so với 8t và gần như không mất hiệu năng. Các việc phù hợp gồm tinh chỉnh mô hình trên dữ liệu riêng, chưng cất mô hình lớn thành mô hình nhỏ và huấn luyện tác tử bằng học tăng cường mà không phải chuyển dữ liệu nhạy cảm giữa các cụm máy.
Với doanh nghiệp Việt Nam, đây là hướng đáng theo dõi: Luật Bảo vệ dữ liệu cá nhân (Luật số 91/2025/QH15) đặt ra yêu cầu chặt hơn khi đưa dữ liệu khách hàng lên dịch vụ đám mây, và hạ tầng tính toán bảo mật là một trong những công cụ giúp giảm rủi ro đó.
Vì sao Anthropic và OpenAI mua TPU của Google
Nghe có vẻ lạ: Google có Gemini, cạnh tranh trực tiếp với Claude của Anthropic và ChatGPT của OpenAI, vậy mà lại bán sức tính cho chính đối thủ. Thực ra mảng điện toán đám mây của Google là một mảng kinh doanh riêng, và chip AI đang là món hàng khan hiếm nhất ngành.
Những gì đã được công bố
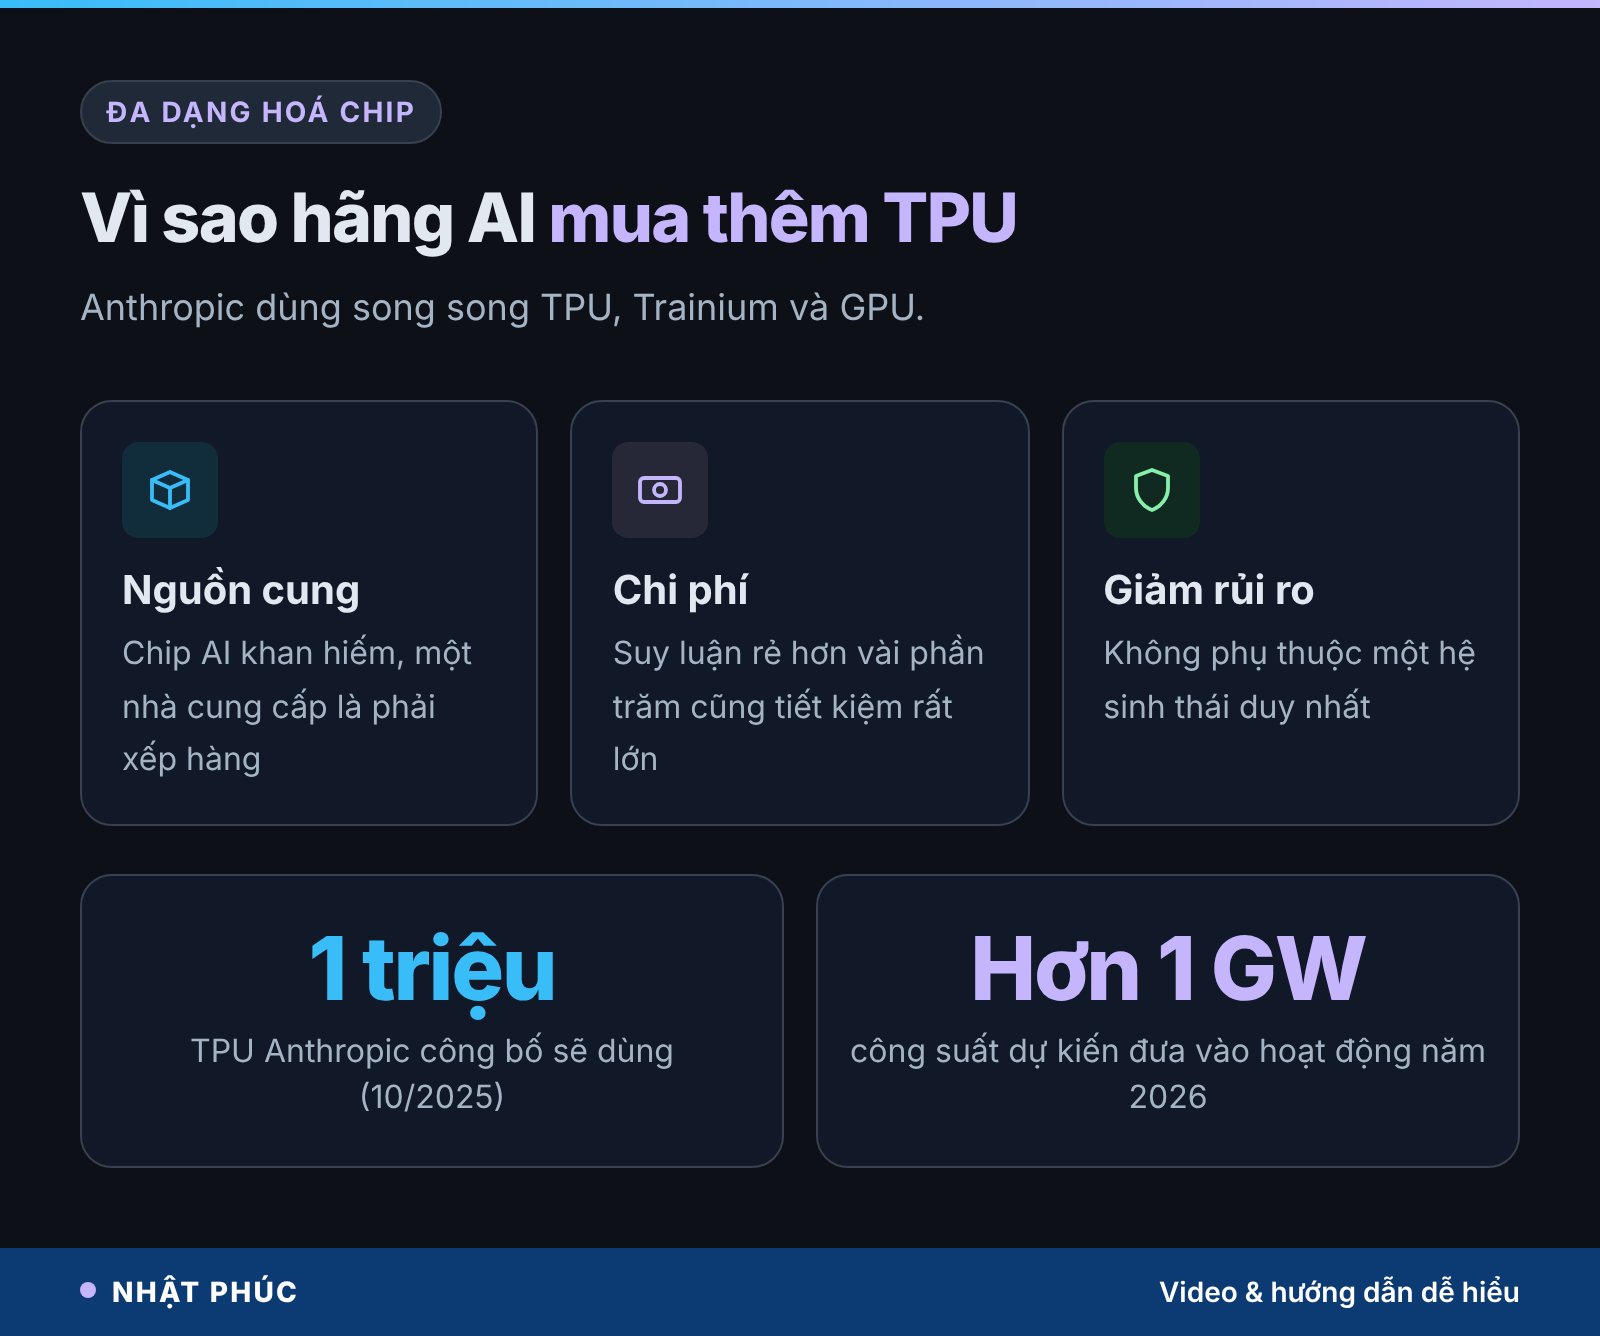
Ngày 23/10/2025, Anthropic thông báo mở rộng sử dụng Google Cloud với quy mô tới một triệu TPU, dự kiến đưa hơn 1 GW công suất vào hoạt động trong năm 2026, giá trị hàng chục tỷ USD. Anthropic cũng nói rõ họ dùng song song ba nền tảng chip: TPU của Google, Trainium của Amazon và GPU của NVIDIA. Về phía OpenAI, đến nay chưa có thông báo chính thức; trang The Information đưa tin công ty này đã thuê TPU từ năm 2025 và đang tính mua thêm.
Ba lý do các hãng AI đa dạng hoá chip
Có thể tóm lại bằng ba chữ: nguồn cung, chi phí và rủi ro. Khi nhu cầu vượt xa khả năng sản xuất, phụ thuộc vào một nhà cung cấp nghĩa là phải xếp hàng. Với suy luận chạy hằng ngày cho hàng trăm triệu người, chỉ cần chi phí mỗi câu trả lời giảm vài phần trăm cũng tiết kiệm được rất nhiều tiền. Và khi phần mềm như PyTorch, vLLM chạy được trên nhiều loại chip, việc chuyển đổi bớt đau đầu hơn trước.
Dự báo của nhà phân tích Ming-Chi Kuo
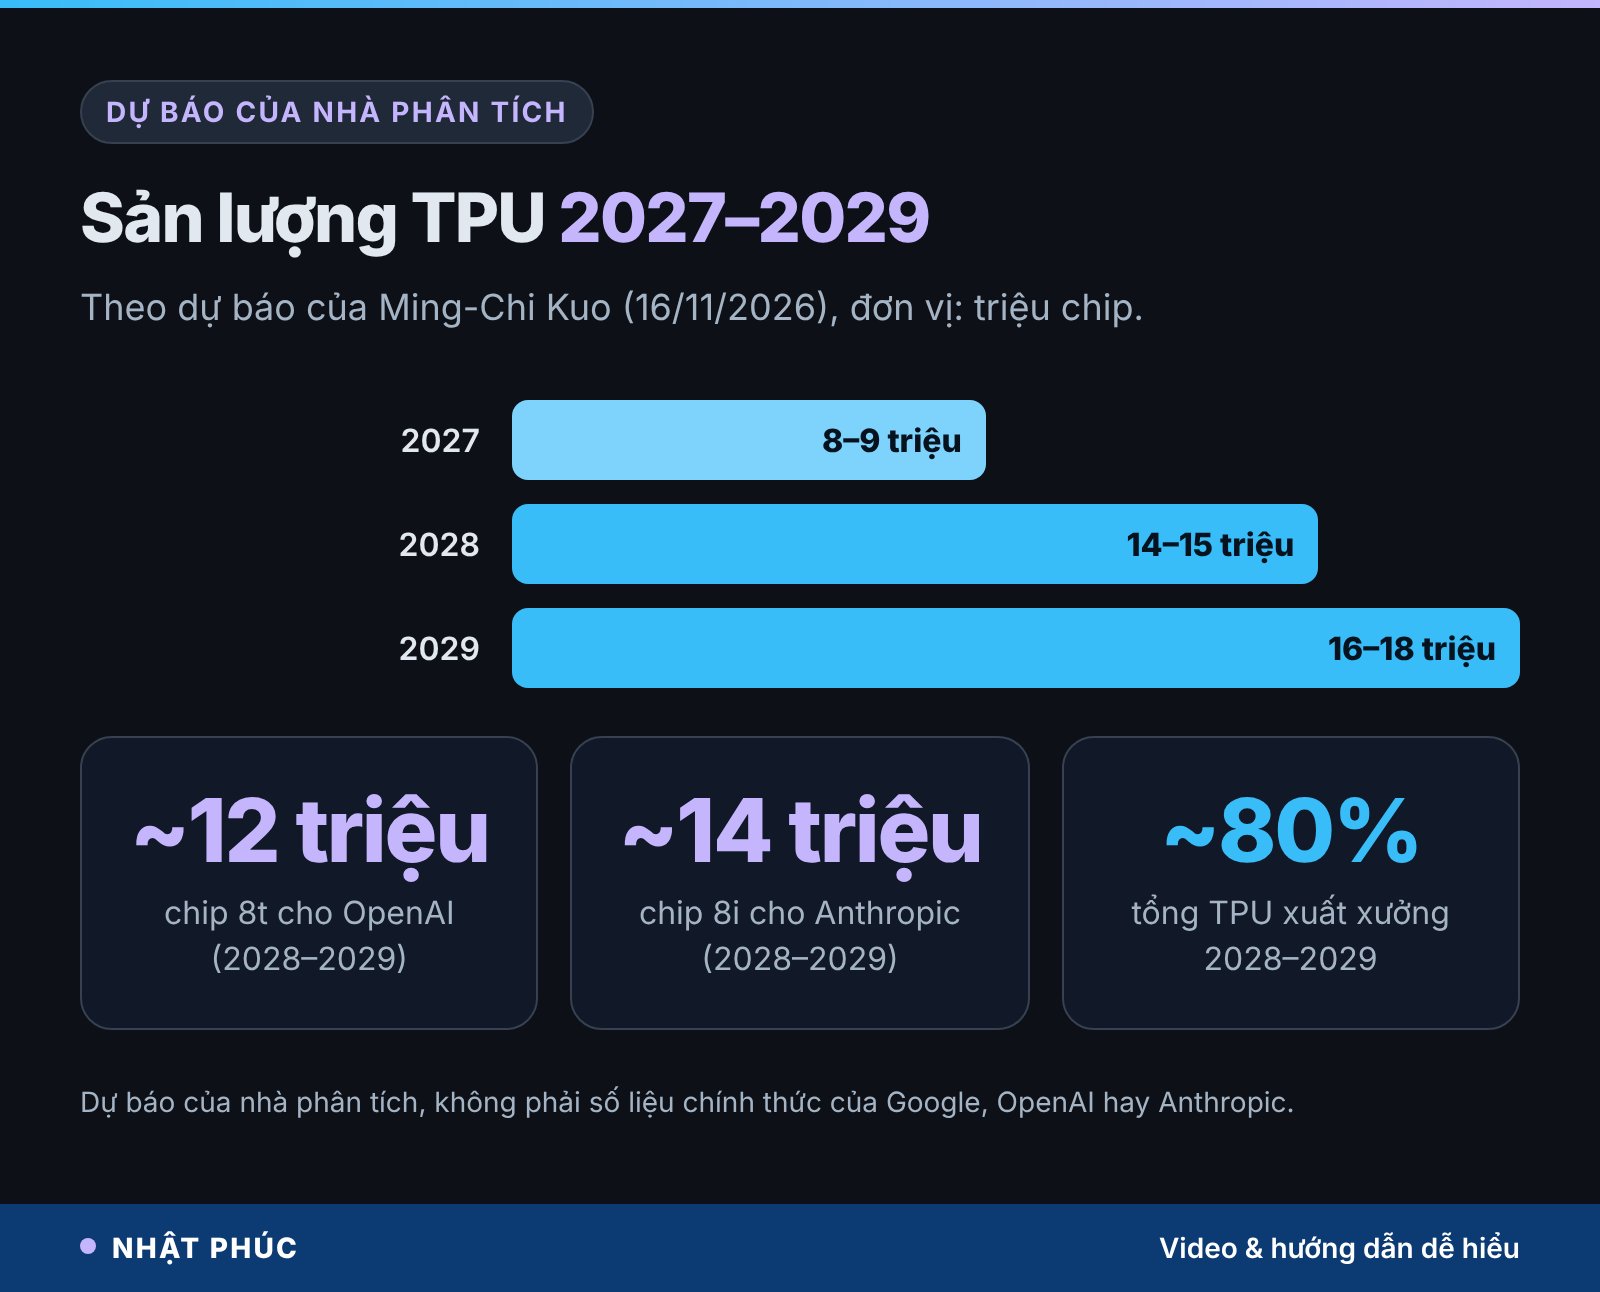
Ngày 16/11/2026, nhà phân tích chuỗi cung ứng Ming-Chi Kuo đưa ra một dự báo gây chú ý. Theo ông, đơn hàng mới từ OpenAI và Anthropic giúp tầm nhìn xuất xưởng TPU kéo dài tới năm 2029, xa hơn GPU và các chip AI tuỳ biến khác. Ước tính của Kuo cho giai đoạn 2028–2029: OpenAI cần khoảng 12 triệu chip 8t, Anthropic khoảng 14 triệu chip 8i, cộng lại khoảng 26 triệu chiếc, tương đương khoảng 80% lượng TPU xuất xưởng hai năm đó. Ông dự báo sản lượng TPU khoảng 8–9 triệu chiếc năm 2027, 14–15 triệu năm 2028 và 16–18 triệu năm 2029.
Kuo cũng cho rằng Broadcom và MediaTek, hai đối tác giúp Google thiết kế và hoàn thiện chip, sẽ hưởng lợi lớn, trong đó MediaTek được dự báo giữ vai trò ngày càng lớn ở các thế hệ sau. Cần nhớ đây là dự báo của nhà phân tích, không phải số liệu Google, OpenAI hay Anthropic công bố; con số thật sẽ chỉ rõ khi có dữ liệu xuất xưởng.
TPU và GPU: khác nhau ở đâu
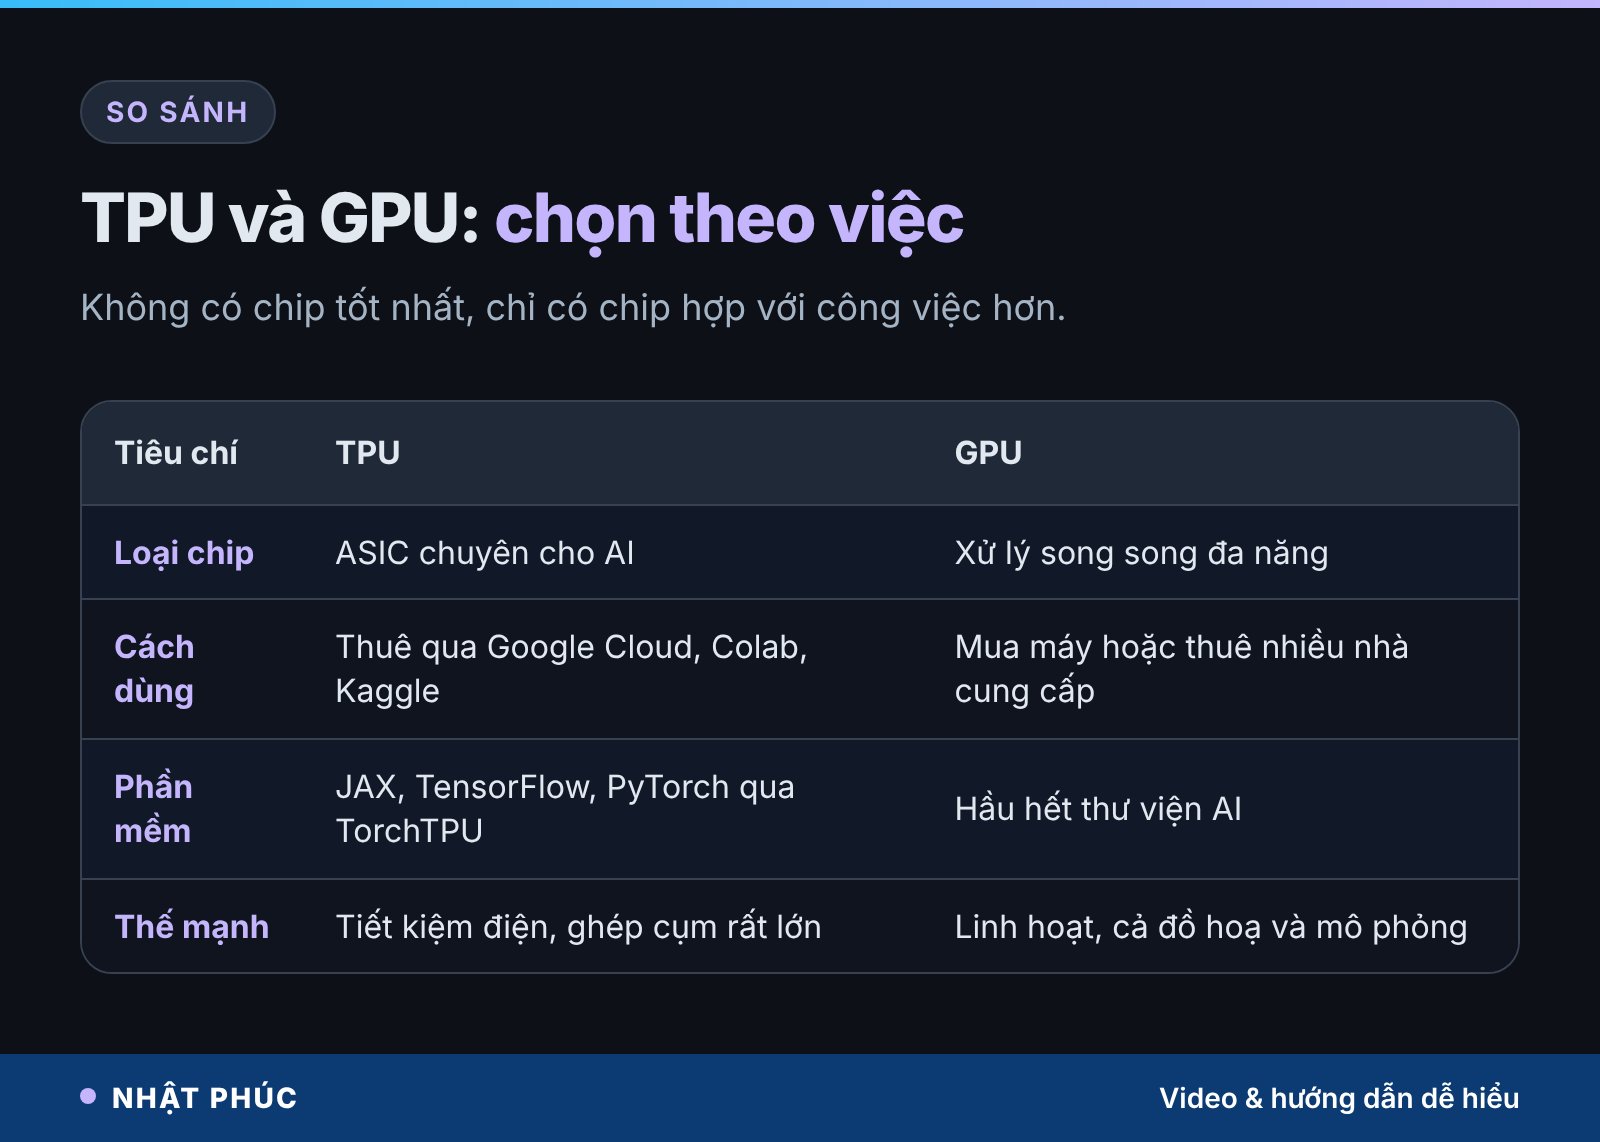
Không có chip nào “tốt hơn” tuyệt đối, chỉ có chip hợp với việc hơn. GPU linh hoạt, chạy được đồ hoạ, mô phỏng khoa học lẫn AI, lại có hệ sinh thái phần mềm lâu đời và mua được để đặt trong phòng máy riêng. TPU hẹp hơn nhưng tối ưu sâu cho AI, ghép được hàng nghìn chip thành một khối nhờ mạng riêng của Google, đổi lại chỉ thuê được qua Google Cloud.
| Tiêu chí | TPU | GPU |
|---|---|---|
| Loại chip | ASIC chuyên cho AI | Bộ xử lý song song đa năng |
| Cách tiếp cận | Thuê qua Google Cloud, Colab, Kaggle | Mua máy, thuê nhiều nhà cung cấp đám mây |
| Phần mềm | JAX, TensorFlow, PyTorch qua TorchTPU, vLLM | Hầu hết thư viện AI, hệ sinh thái lâu đời |
| Thế mạnh | Hiệu quả điện năng, ghép cụm rất lớn | Linh hoạt, làm được cả đồ hoạ, mô phỏng |
Một thay đổi đáng chú ý năm 2026: Google cho biết đã mở mã nguồn TorchTPU để mã PyTorch và mô hình trên Hugging Face chạy thẳng trên TPU mà không phải viết lại, đồng thời vLLM và SGLang có sẵn phần chạy cho TPU. Rào cản lớn nhất của TPU xưa nay chính là phần mềm, nên đây là bước đi quan trọng.
Người Việt dùng TPU được không
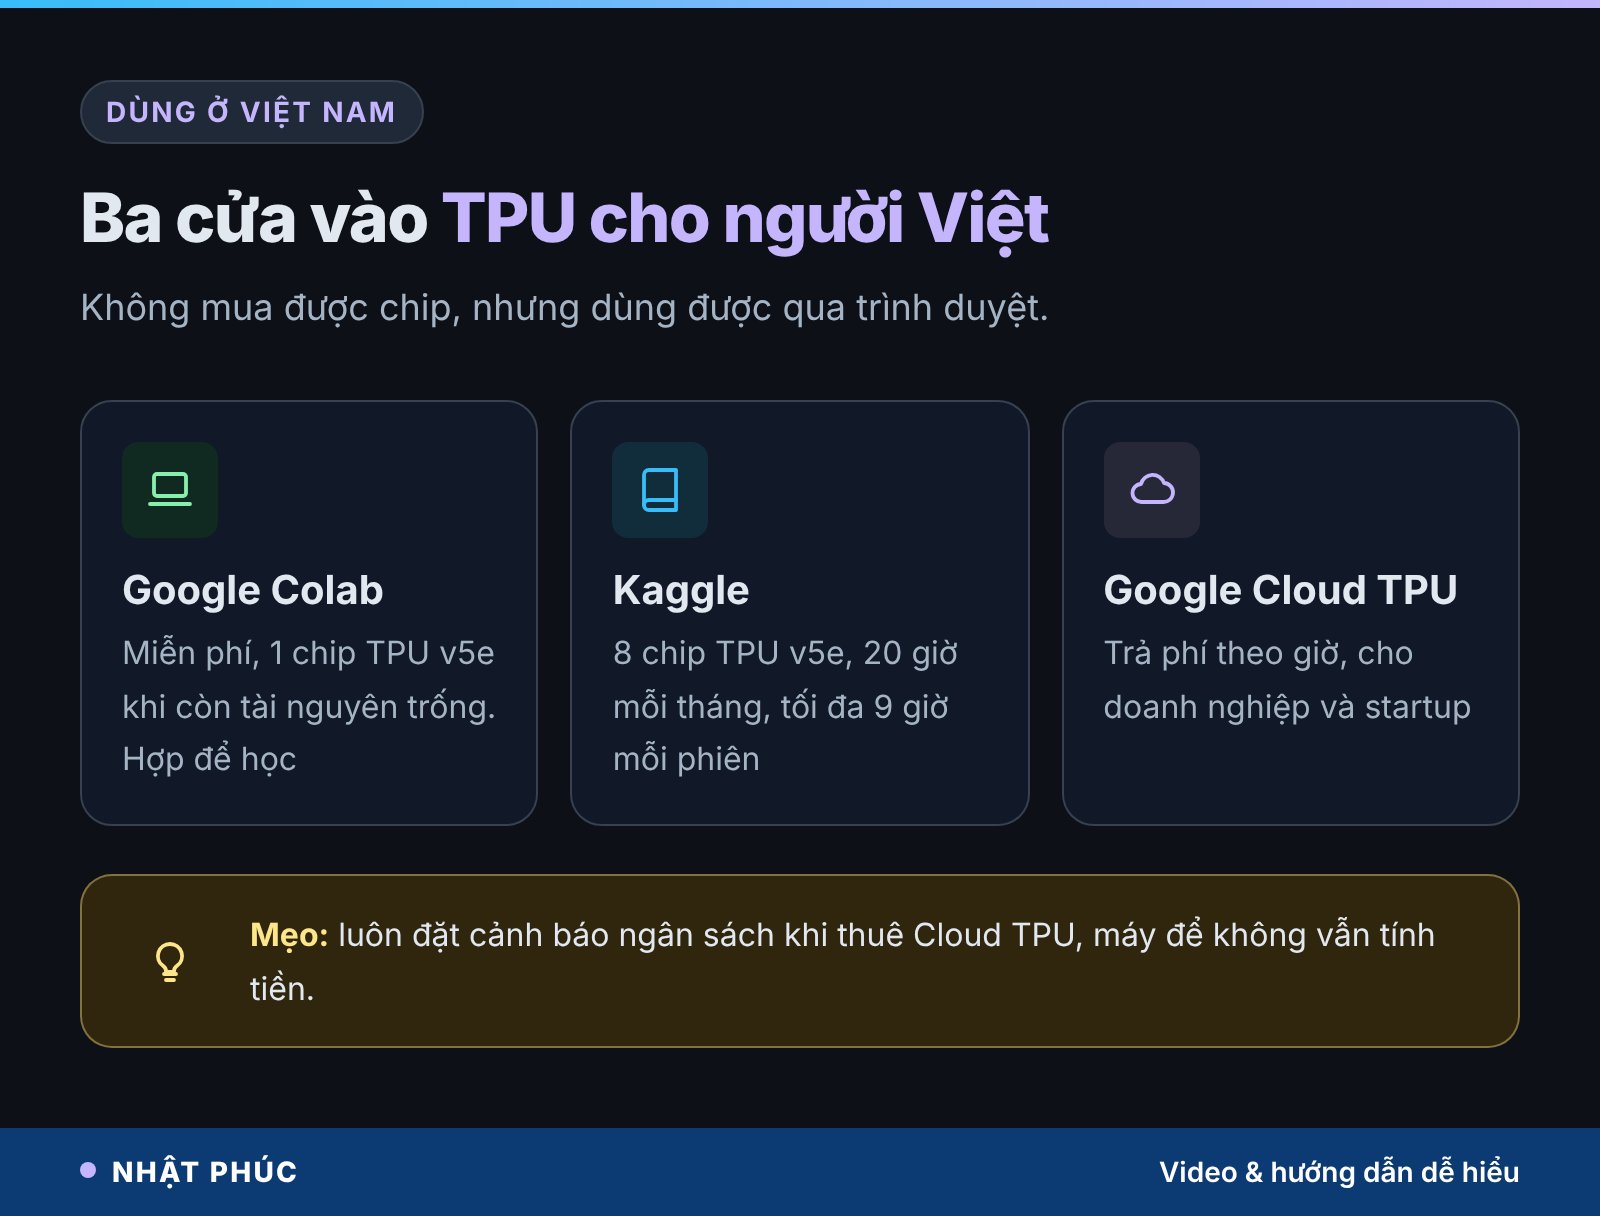
Bạn không mua được TPU để cắm vào máy tính, nhưng hoàn toàn dùng được qua mạng. Có ba cửa vào, từ miễn phí tới trả phí.
Google Colab
Colab là sổ tay lập trình Python chạy trên trình duyệt, đăng nhập bằng tài khoản Google là dùng được ở Việt Nam. Bản miễn phí cho chọn thời gian chạy TPU (theo Google, là một chip TPU v5e) khi tài nguyên còn trống. Phù hợp để học thư viện JAX, PyTorch trên TPU và chạy thử mô hình nhỏ, không bảo đảm luôn có máy.
Kaggle Notebooks
Kaggle, nền tảng thi đấu dữ liệu của Google, cấp sổ tay có 8 chip TPU v5e. Theo hướng dẫn của Google, hạn mức là 20 giờ mỗi tháng và tối đa 9 giờ mỗi phiên trong ngày. Đủ để tinh chỉnh nhiều mô hình ngôn ngữ cỡ vừa, cần xác minh tài khoản bằng số điện thoại.
Google Cloud TPU
Doanh nghiệp, startup cần chạy lâu dài thì thuê Cloud TPU, trả theo giờ sử dụng. Sinh viên, nhà nghiên cứu có thể tìm hiểu các chương trình tín dụng giáo dục của Google Cloud. Hãy luôn đặt cảnh báo ngân sách, vì máy để chạy không cũng vẫn tính tiền.
5 bước chạy thử TPU trên Google Colab
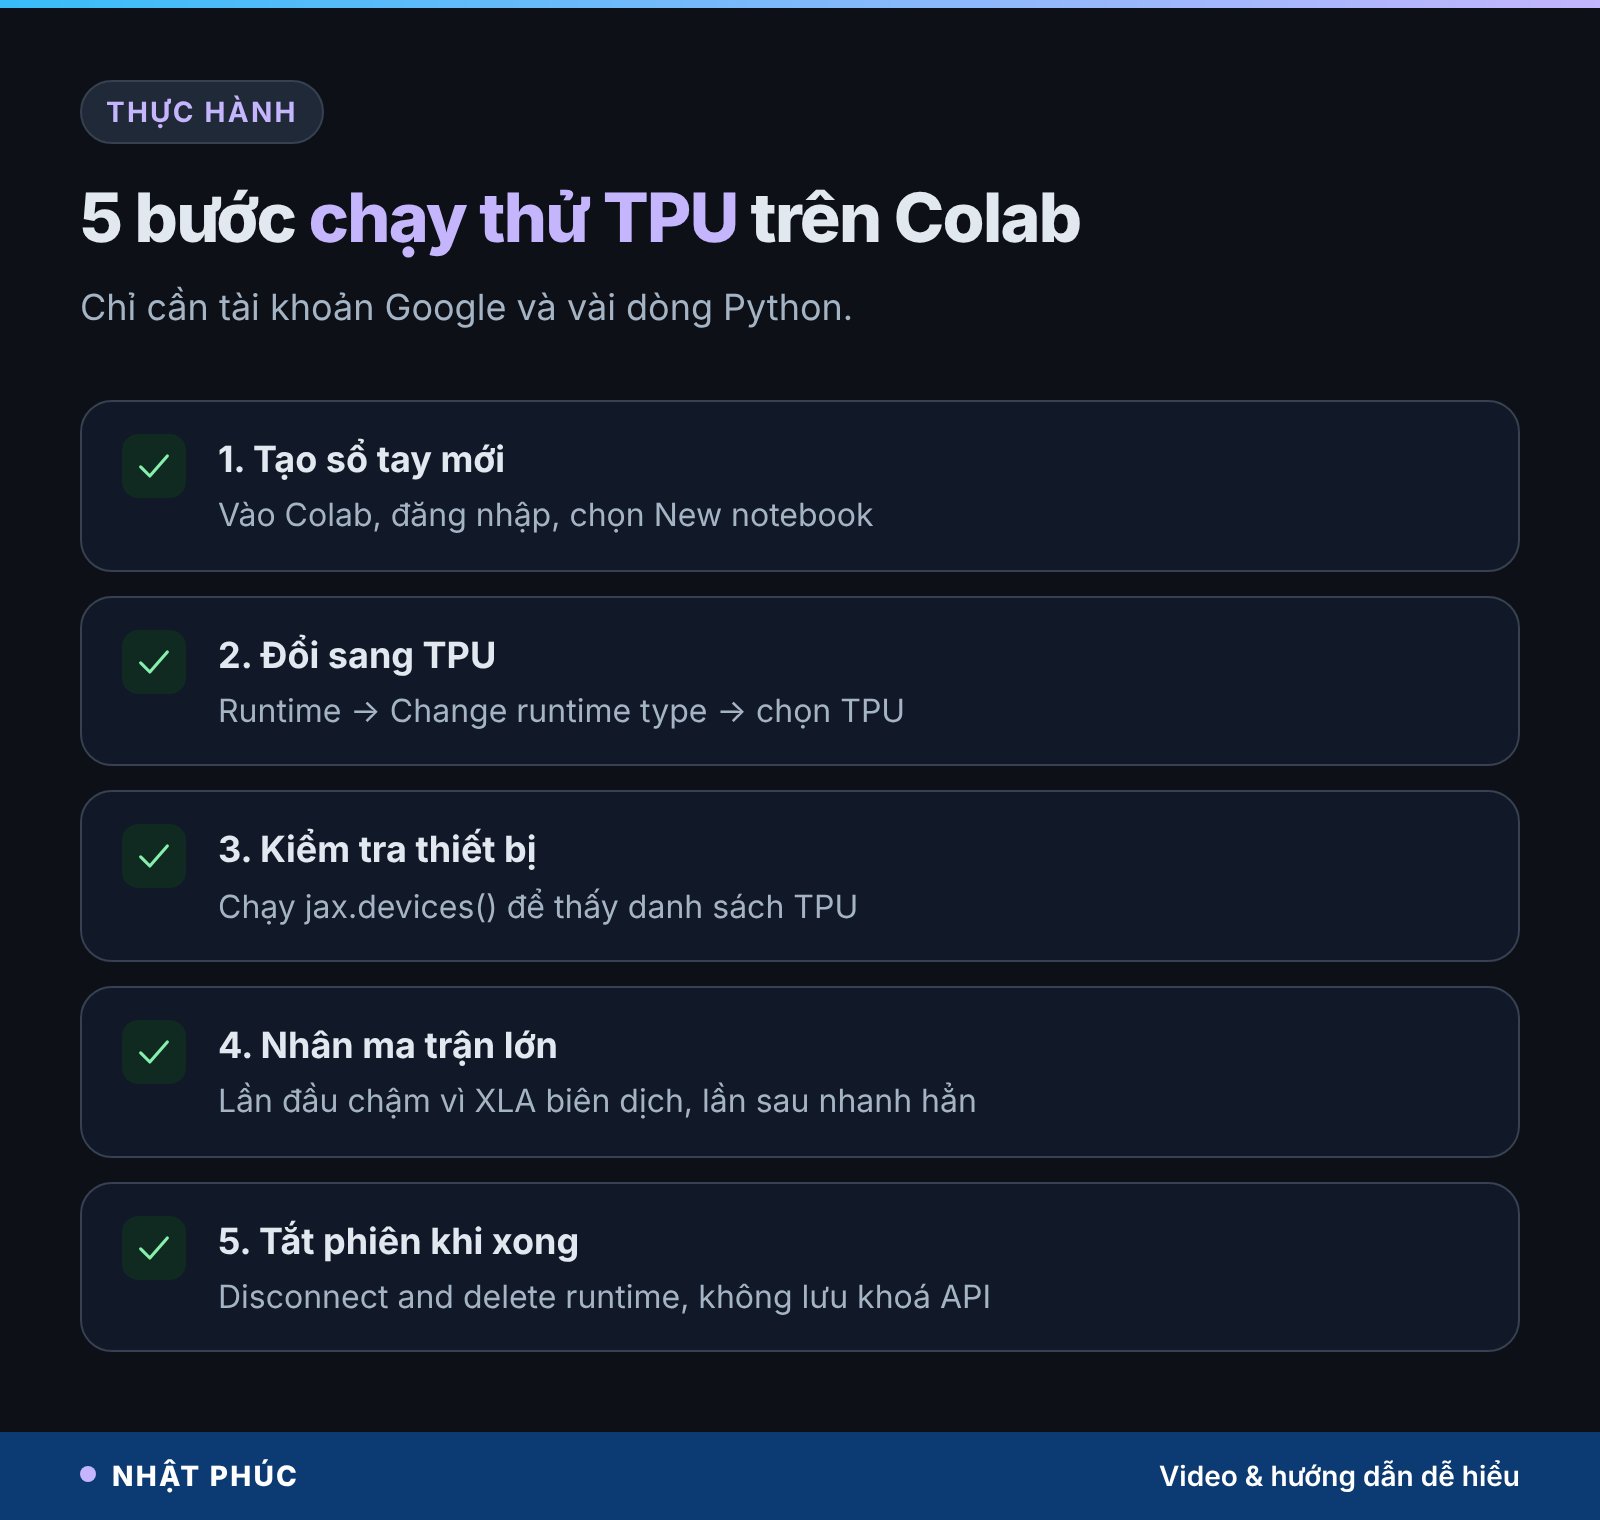
Bạn không cần biết nhiều về phần cứng. Chỉ cần tài khoản Google và vài dòng Python.
1. Tạo sổ tay mới
Vào colab.research.google.com, đăng nhập, chọn tạo sổ tay mới (New notebook).
2. Đổi loại thời gian chạy sang TPU
Mở menu Runtime (Thời gian chạy), chọn Change runtime type (Thay đổi loại thời gian chạy), chọn mục TPU rồi lưu. Nếu báo hết tài nguyên, hãy thử lại sau ít phút.
3. Kiểm tra TPU đã nhận
Gõ vào ô mã: import jax; print(jax.devices()) rồi chạy. Kết quả liệt kê thiết bị TPU là bạn đã có chip trong tay.
4. Thử một phép nhân ma trận lớn
Tạo hai ma trận ngẫu nhiên cỡ vài nghìn hàng bằng jax.numpy và nhân chúng. Lần chạy đầu chậm vì trình biên dịch XLA đang dịch mã cho TPU; các lần sau nhanh hơn hẳn. Đây là cách trực quan nhất để thấy mảng tâm thu làm việc.
5. Tắt phiên khi xong
Chọn Disconnect and delete runtime để trả tài nguyên. Không lưu khoá API hay dữ liệu cá nhân của khách hàng trong sổ tay chia sẻ công khai.
Hiểu lầm phổ biến về TPU
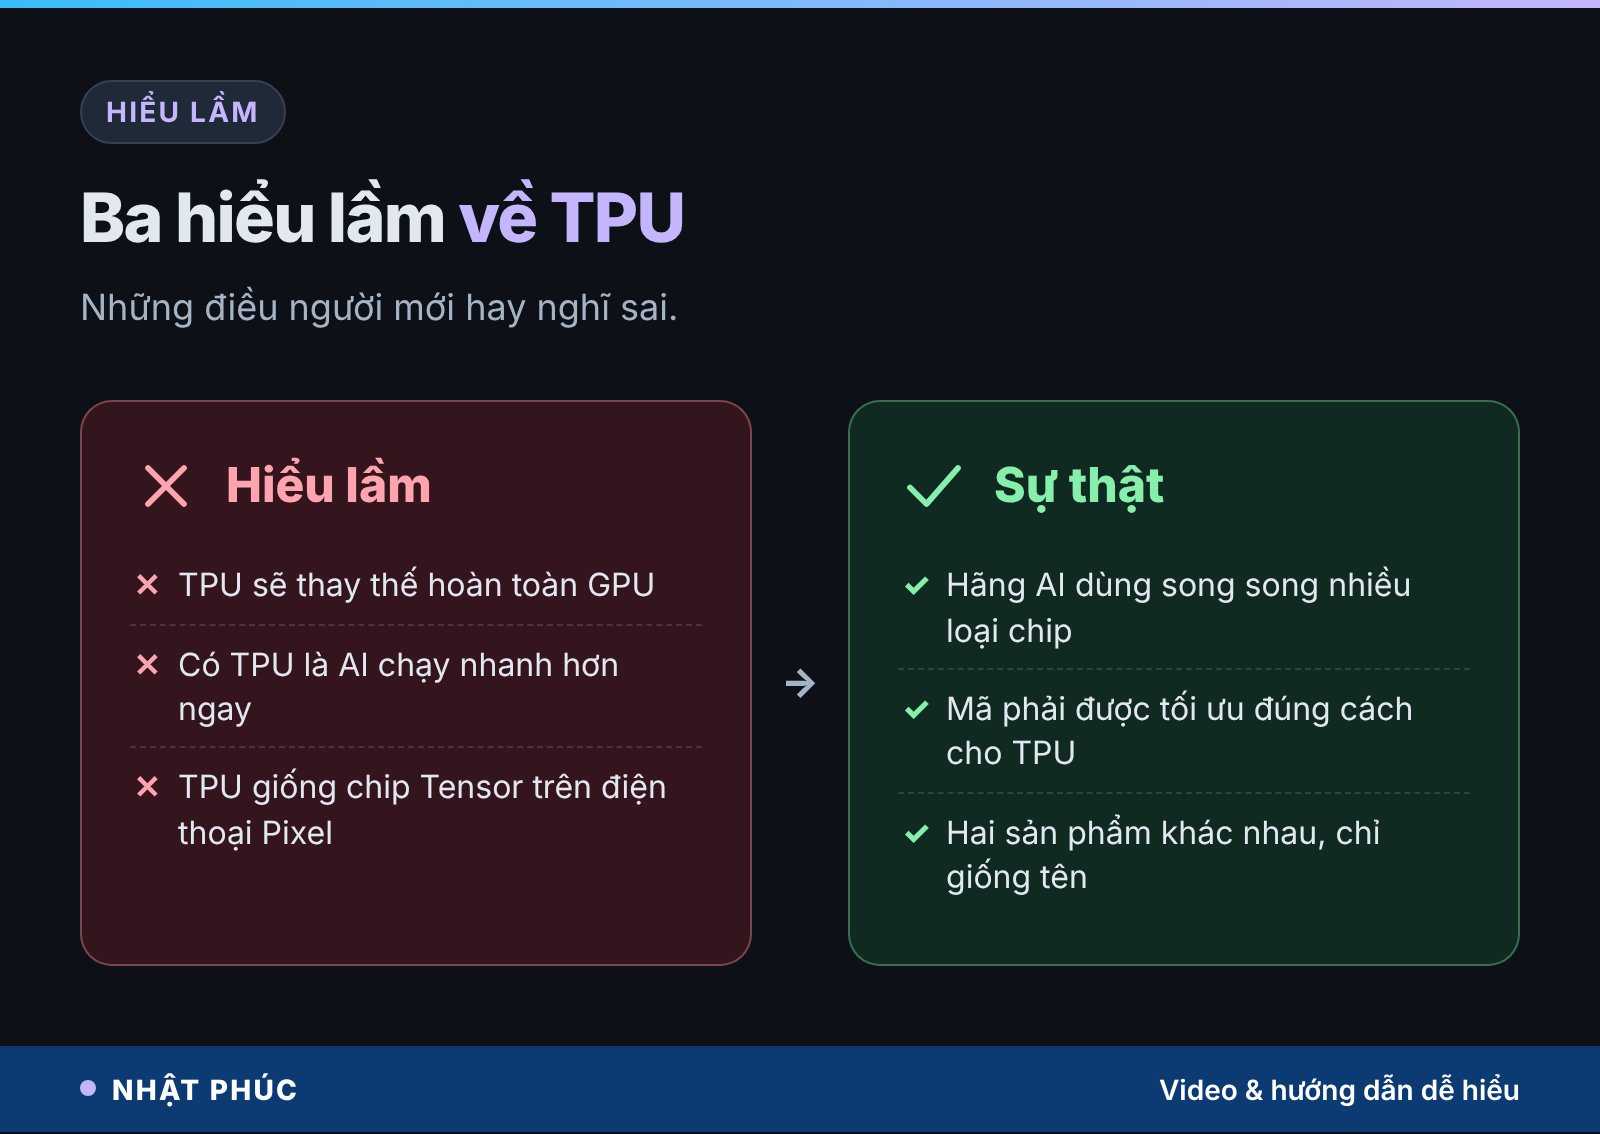
“TPU sẽ thay thế hoàn toàn GPU”
Chưa có dấu hiệu đó. Chính Anthropic, khách hàng TPU lớn, vẫn dùng song song GPU và Trainium. Các hãng chọn chip theo từng việc.
“Có TPU là chạy AI nhanh hơn ngay”
Mã viết cho GPU không tự động nhanh trên TPU. Kích thước dữ liệu, kiểu số và cách chia việc cho nhiều chip quyết định rất nhiều; chạy sai cách có khi còn chậm hơn.
“TPU giống chip AI trong điện thoại Pixel”
Chip Tensor trong điện thoại Pixel và TPU trong trung tâm dữ liệu là hai sản phẩm khác nhau, chỉ giống nhau ở tên gọi và mục tiêu chạy AI.
TPU tác động gì đến người dùng AI bình thường
Bạn sẽ không bao giờ nhìn thấy một con TPU, nhưng nó ảnh hưởng trực tiếp tới trải nghiệm hằng ngày. Khi chip suy luận rẻ và nhanh hơn, các dịch vụ AI có thể trả lời nhanh hơn, cho dùng miễn phí nhiều hơn hoặc giữ giá ổn định dù mô hình ngày càng lớn. Các tính năng như AI đọc cả tài liệu dài, tác tử tự làm nhiều bước liên tiếp cũng phụ thuộc vào bộ nhớ và độ trễ của phần cứng phía sau.
Mặt trái là điện năng. Dù TPU tiết kiệm điện hơn trên mỗi phép tính, tổng nhu cầu vẫn tăng nhanh vì số lượng chip tăng; bài trung tâm dữ liệu AI tốn bao nhiêu điện đã phân tích chuyện này. Với người làm nghề, hiểu sự khác nhau giữa các loại chip cũng giúp bạn chọn dịch vụ đám mây và ước tính chi phí khi tự chạy mô hình.
Câu hỏi thường gặp
TPU là viết tắt của gì?
TPU là viết tắt của Tensor Processing Unit, nghĩa là bộ xử lý tensor. Tensor là khối số nhiều chiều mà mạng nơ-ron dùng để biểu diễn dữ liệu. Tên gọi này cũng gắn với TensorFlow, thư viện AI do Google phát triển, vốn là phần mềm đầu tiên chạy trên TPU.
Tôi có mua được TPU để lắp vào máy tính không?
Không. TPU chỉ có trong trung tâm dữ liệu của Google và được cho thuê qua Google Cloud. Nếu muốn có chip AI trong máy cá nhân, bạn sẽ tìm tới GPU rời hoặc laptop có NPU, mỗi loại phù hợp một nhu cầu khác nhau.
TPU miễn phí trên Colab có giới hạn gì?
Bản miễn phí chỉ cấp TPU khi còn tài nguyên trống, phiên có thể bị ngắt nếu để lâu không thao tác, và dung lượng bộ nhớ đủ cho mô hình nhỏ. Muốn chạy lâu hơn, bạn có thể dùng Kaggle với hạn mức 20 giờ mỗi tháng hoặc thuê Cloud TPU.
Gemini có chạy trên TPU không?
Google nhiều lần cho biết các mô hình của mình được huấn luyện và vận hành trên hạ tầng TPU. Đây cũng là lý do Google đầu tư mạnh cho dòng chip này: mỗi phần trăm hiệu quả tăng thêm đều nhân lên trên hàng tỷ lượt dùng.
Học lập trình AI có cần biết về TPU không?
Không bắt buộc khi mới bắt đầu. Nhưng nếu bạn làm việc với mô hình lớn hoặc tối ưu chi phí trên đám mây, hiểu sự khác nhau giữa CPU, GPU và TPU sẽ giúp bạn chọn đúng công cụ và tránh trả tiền cho phần cứng không phù hợp.
Kết luận
TPU là ví dụ rõ nhất cho xu hướng chip chuyên dụng trong kỷ nguyên AI: thay vì một con chip làm mọi việc, mỗi giai đoạn của mô hình có phần cứng riêng. Từ một dự án tiết kiệm máy chủ năm 2015, TPU nay có bốn hệ thống thế hệ 8 và được chính các đối thủ của Gemini đặt mua. Dự báo của các nhà phân tích còn cần kiểm chứng, nhưng cuộc đua chip AI rõ ràng không chỉ còn một cái tên.
Bạn đã thử chạy mô hình trên TPU của Colab hay Kaggle chưa? Hãy chia sẻ trải nghiệm ở phần bình luận và theo dõi Nhật Phúc để đọc thêm các bài giải thích công nghệ AI dễ hiểu.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.