Năm 2012, một mạng máy tính nhìn ảnh và gọi tên vật thể chính xác hơn hẳn mọi đối thủ, khiến cả giới nghiên cứu sửng sốt. Điều lạ là ý tưởng đằng sau nó đã cũ hàng chục năm. Vậy rốt cuộc cái gì đã thay đổi? Câu trả lời không nằm ở một thuật toán mới. Nó nằm ở ImageNet, một bộ sưu tập ảnh.
Câu trả lời ngắn: ImageNet là bộ dữ liệu khoảng 14 triệu ảnh được con người gắn nhãn theo hàng chục nghìn loại vật thể, ra mắt năm 2009 do nhóm của giáo sư Fei-Fei Li xây dựng. Cuộc thi dựa trên ImageNet là nơi mạng nơ-ron AlexNet thắng áp đảo năm 2012, mở màn kỷ nguyên học sâu cho thị giác máy tính.
Bài viết này giải thích ImageNet là gì, vì sao một “kho ảnh” lại quan trọng ngang một phát minh, AlexNet đã thắng ra sao, và những bài học về dữ liệu mà đến nay các hệ thống AI vẫn phải đối mặt.
Nếu bạn thích nghe kể bằng hình ảnh, hãy xem video ImageNet là gì trên kênh Vọc Sĩ trước, rồi đọc tiếp phần phân tích chi tiết bên dưới.
Tóm tắt nhanh
- ImageNet là bộ dữ liệu khoảng 14 triệu ảnh có nhãn, công bố năm 2009.
- Ý tưởng cốt lõi: vấn đề của máy không chỉ là “bộ não” mà là “bài học” quá ít.
- Hàng chục nghìn người làm trực tuyến khắp thế giới đã cùng xác nhận nhãn ảnh.
- Năm 2012, AlexNet giảm tỷ lệ sai xuống khoảng 15%, thấp hơn đội hạng nhì gần 11 điểm phần trăm.
- Dữ liệu lớn cũng mang theo lỗi và thiên lệch: nhiều nhãn sai, nhiều nhãn ảnh người phải gỡ bỏ.
Nội dung chính:
- ImageNet là gì?
- Dạy máy nhận ra con mèo giống dạy trẻ con
- Ý tưởng ngược dòng của Fei-Fei Li
- ImageNet được gắn nhãn thế nào?
- Cuộc thi ImageNet: luật chơi và cách chấm
- AlexNet năm 2012: cú sốc của giới nghiên cứu
- Vì sao ý tưởng cũ bỗng thành công?
- Cái giá của dữ liệu lớn
- Hiểu lầm phổ biến về ImageNet
- Bài học từ ImageNet cho người dùng AI hôm nay
- Câu hỏi thường gặp
ImageNet là gì?
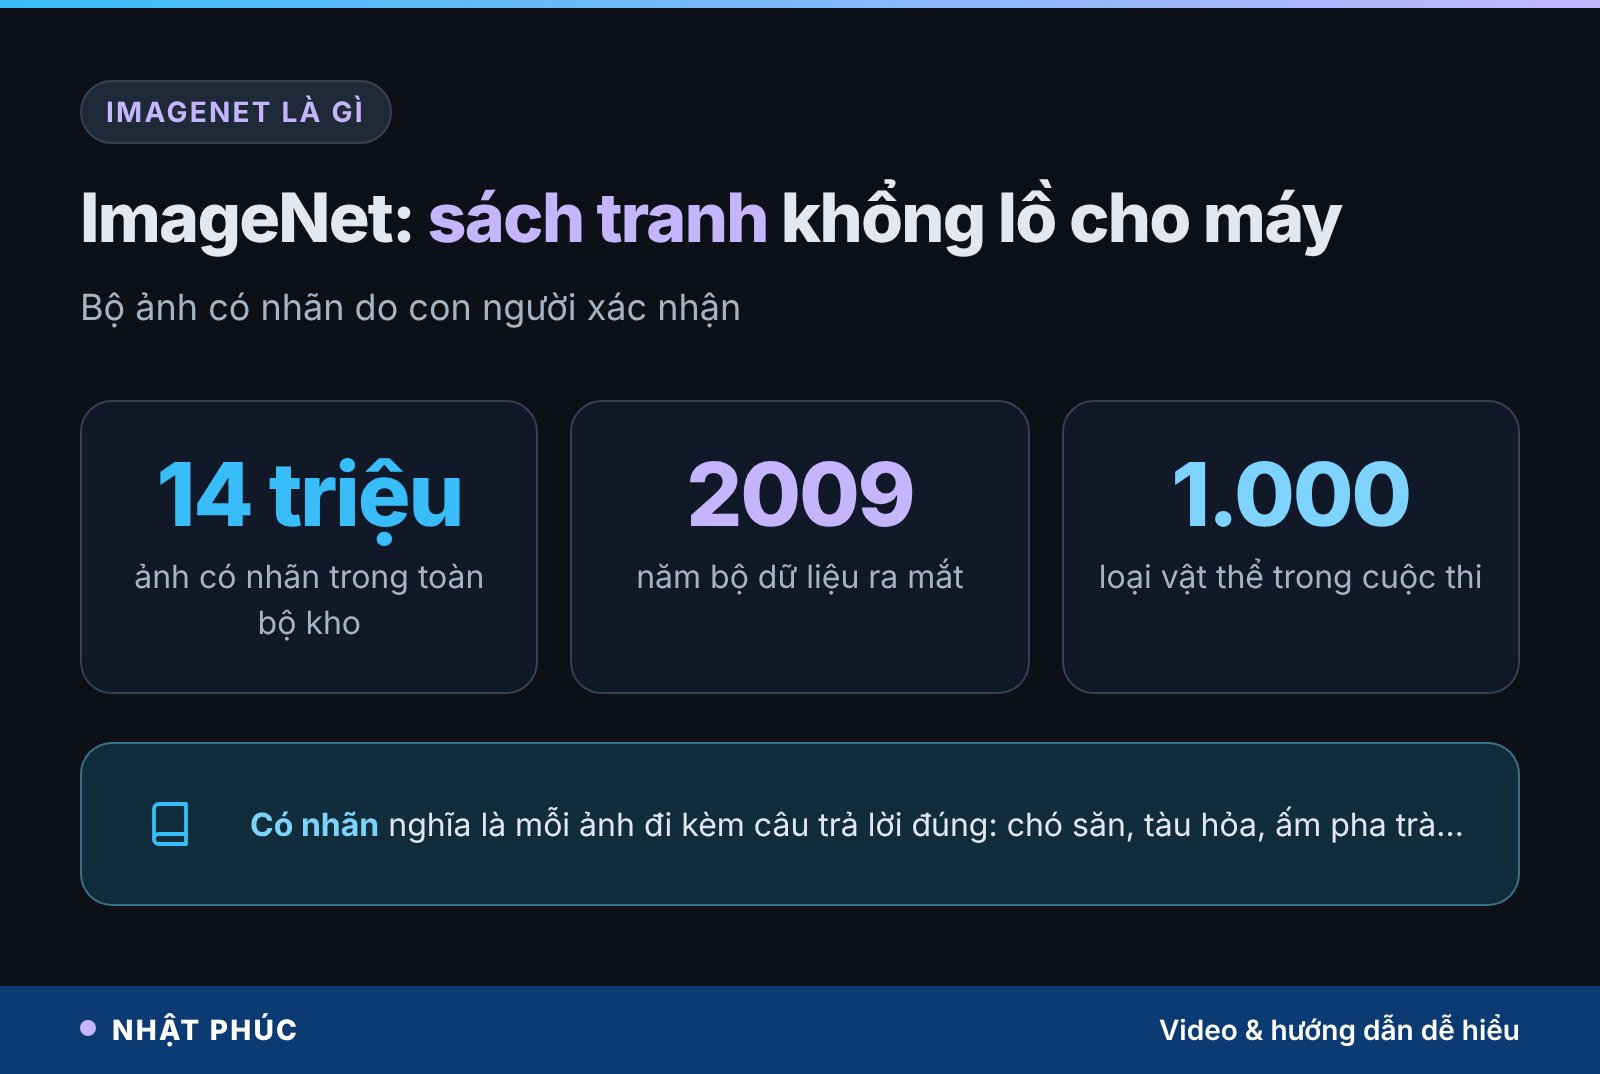
ImageNet là một bộ dữ liệu ảnh có nhãn (labeled image dataset) dùng để huấn luyện và đánh giá máy tính trong việc nhận dạng vật thể. “Có nhãn” nghĩa là mỗi tấm ảnh đi kèm một câu trả lời đúng do con người xác nhận: tấm này là chó săn, tấm kia là tàu hoả, tấm nọ là cái ấm pha trà.
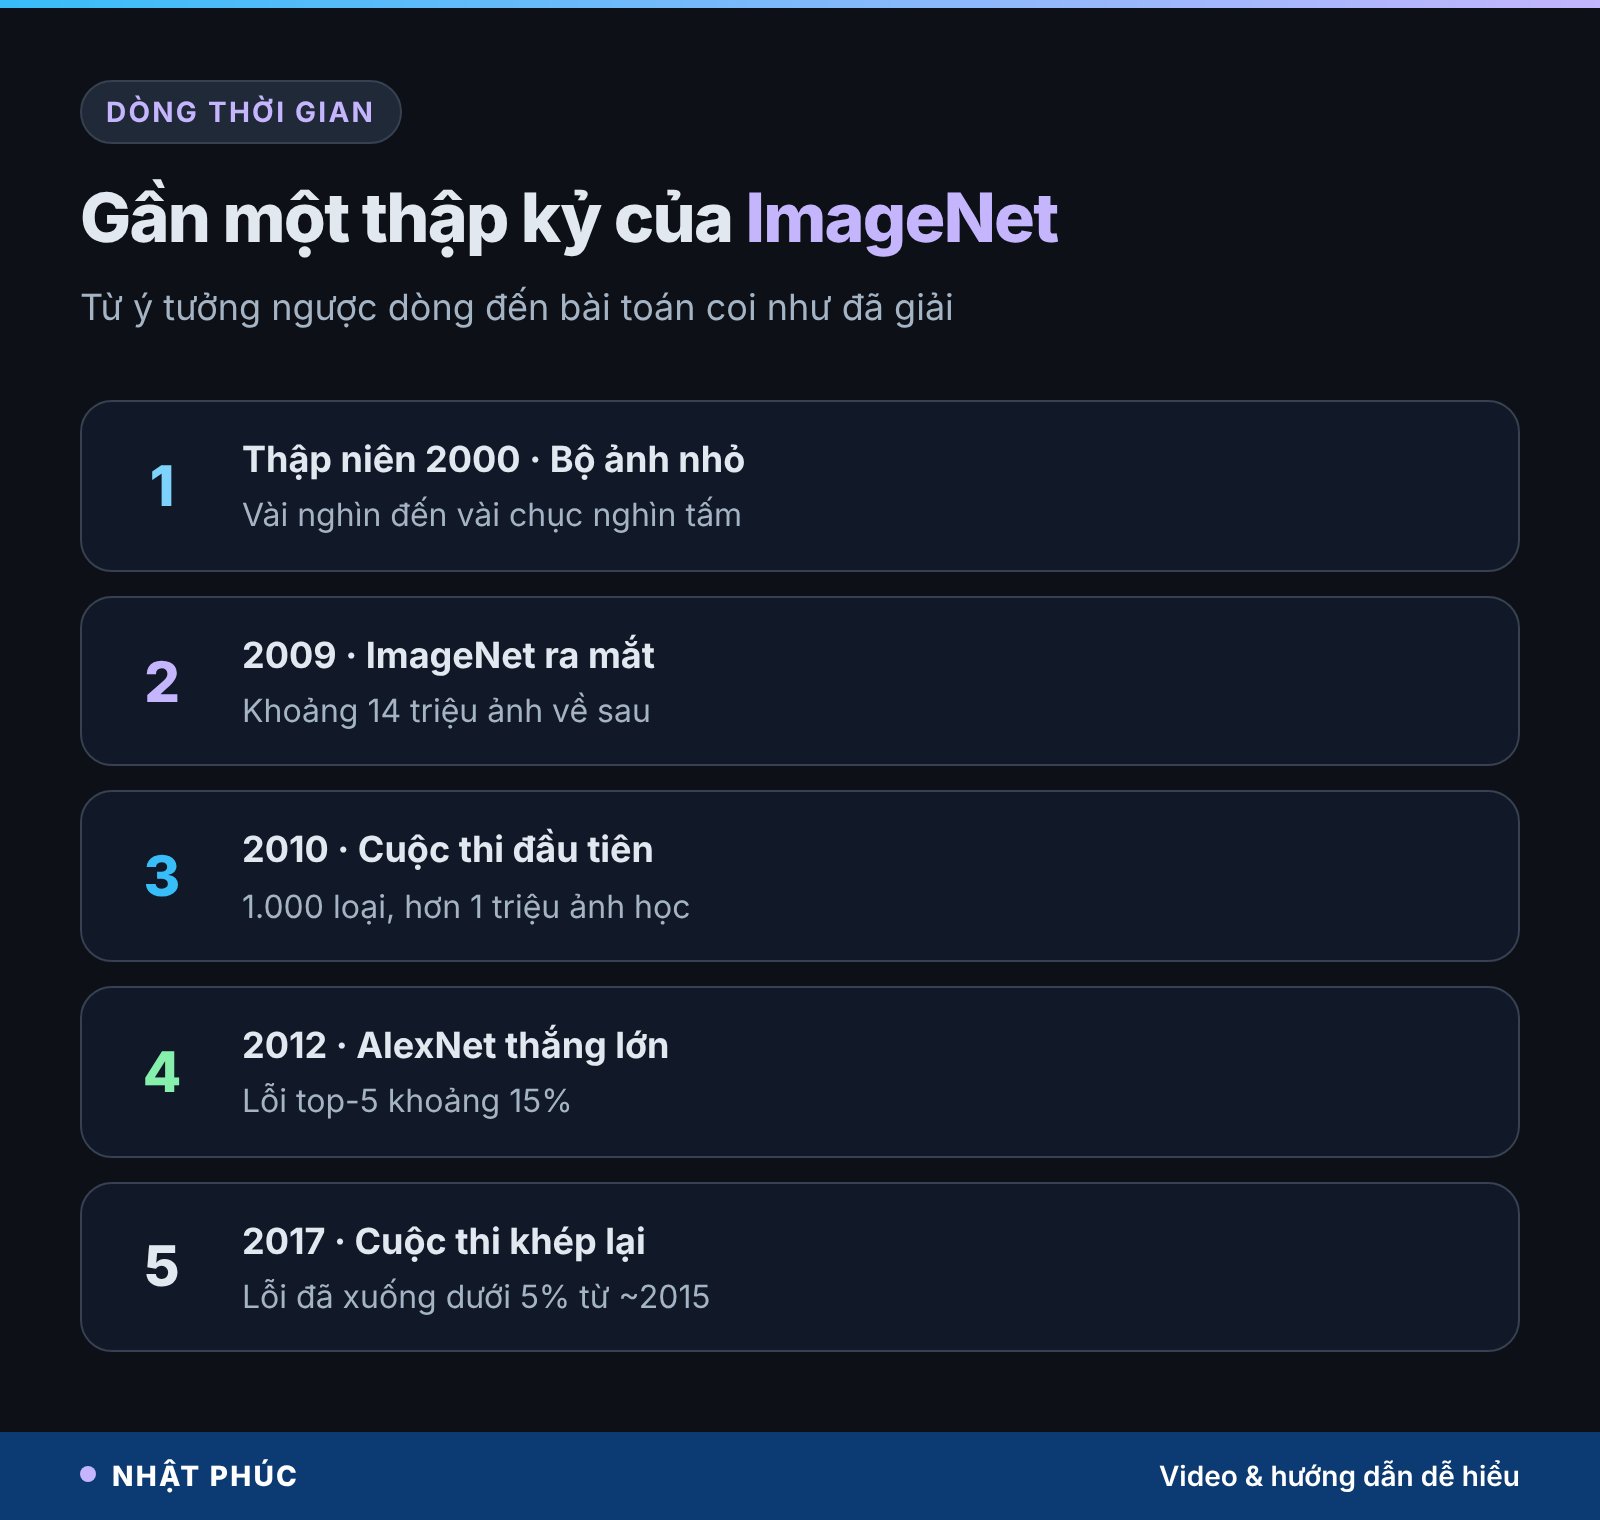
Về quy mô, ImageNet về sau chứa khoảng 14 triệu ảnh, xếp vào hàng chục nghìn loại. Các loại được tổ chức theo cây từ vựng của WordNet, một cơ sở dữ liệu tiếng Anh nhóm các từ cùng nghĩa thành từng “nút”. Nhờ vậy, “chó săn” nằm dưới “chó”, “chó” nằm dưới “động vật có vú”, giống cách một thư viện xếp sách theo kệ lớn, kệ nhỏ.
Hãy hình dung ImageNet như một cuốn sách tranh khổng lồ cho máy: mỗi trang là một tấm ảnh, dưới ảnh có chú thích. Máy không được ai giảng định nghĩa “con mèo là gì”; nó chỉ được lật thật nhiều trang và tự tìm ra quy luật.
ImageNet khác gì một kho ảnh trên mạng?
Internet có hàng tỷ ảnh, nhưng phần lớn không có câu trả lời đúng đi kèm. Chú thích trên mạng xã hội thường là cảm xúc (“chiều nay đẹp quá”) chứ không phải tên vật thể. Giá trị của ImageNet nằm ở chỗ nhãn đã được con người kiểm tra, đủ đồng đều để dùng làm sách giáo khoa và đề thi cho máy.
Dạy máy nhận ra con mèo giống dạy trẻ con
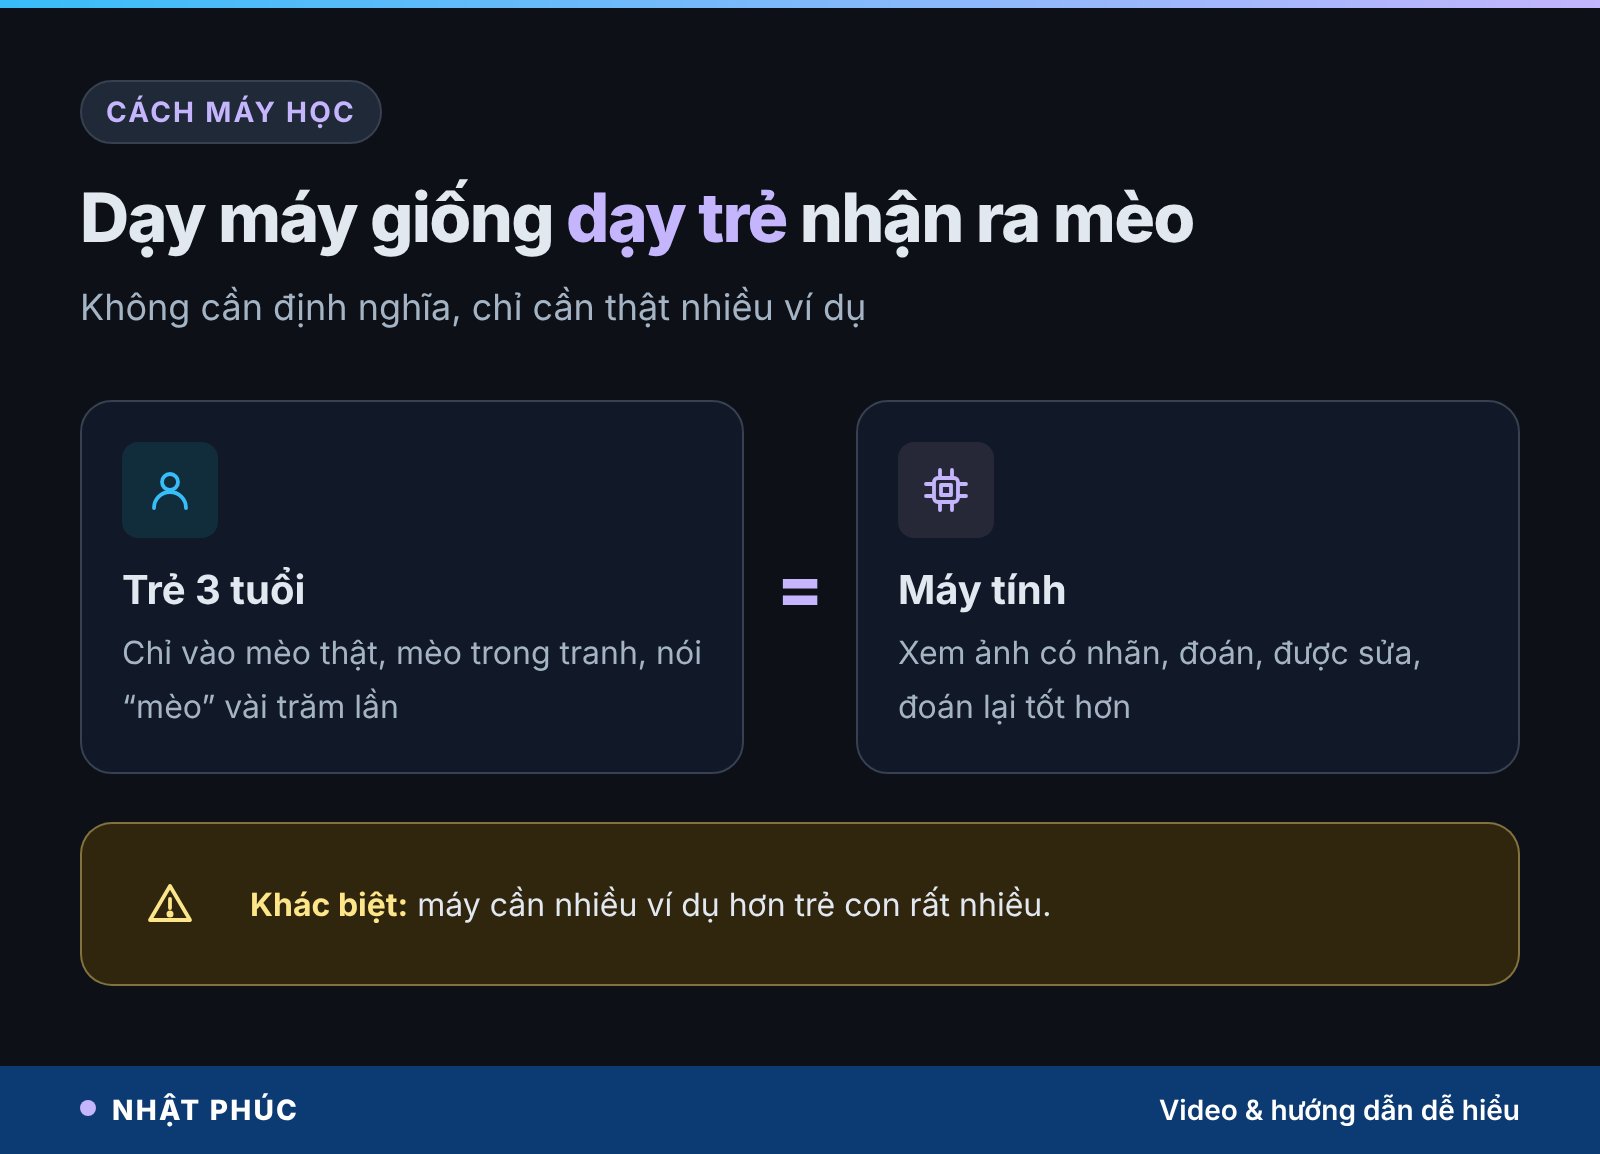
Hãy bắt đầu từ một câu hỏi đời thường: làm sao dạy một đứa trẻ 3 tuổi nhận ra con mèo? Bạn không đọc định nghĩa sinh học. Bạn chỉ vào mèo thật, mèo trong tranh, mèo đang ngủ, mèo đang nhảy và nói “mèo”. Vài trăm lần như thế, bé tự rút ra quy luật: tai nhọn, ria dài, dáng mềm.
Máy tính trong lĩnh vực học máy (machine learning) học theo cách tương tự: xem ví dụ, đoán, được sửa, rồi đoán lại tốt hơn. Khác biệt là máy cần nhiều ví dụ hơn trẻ con rất nhiều. Một đứa trẻ có đôi mắt mở suốt ngày, nhìn thế giới liên tục từ mọi góc; còn máy chỉ thấy những gì ta đưa cho nó.
Đây chính là chỗ các nhà nghiên cứu những năm 2000 bị kẹt. Họ có ý tưởng hay, nhưng “cuốn sách tranh” trong tay quá mỏng. Bạn có thể là giáo viên giỏi nhất thế giới, nhưng nếu chỉ có mười tấm ảnh để dạy, học trò vẫn sẽ nhầm mèo với chó con.
Ý tưởng ngược dòng của Fei-Fei Li
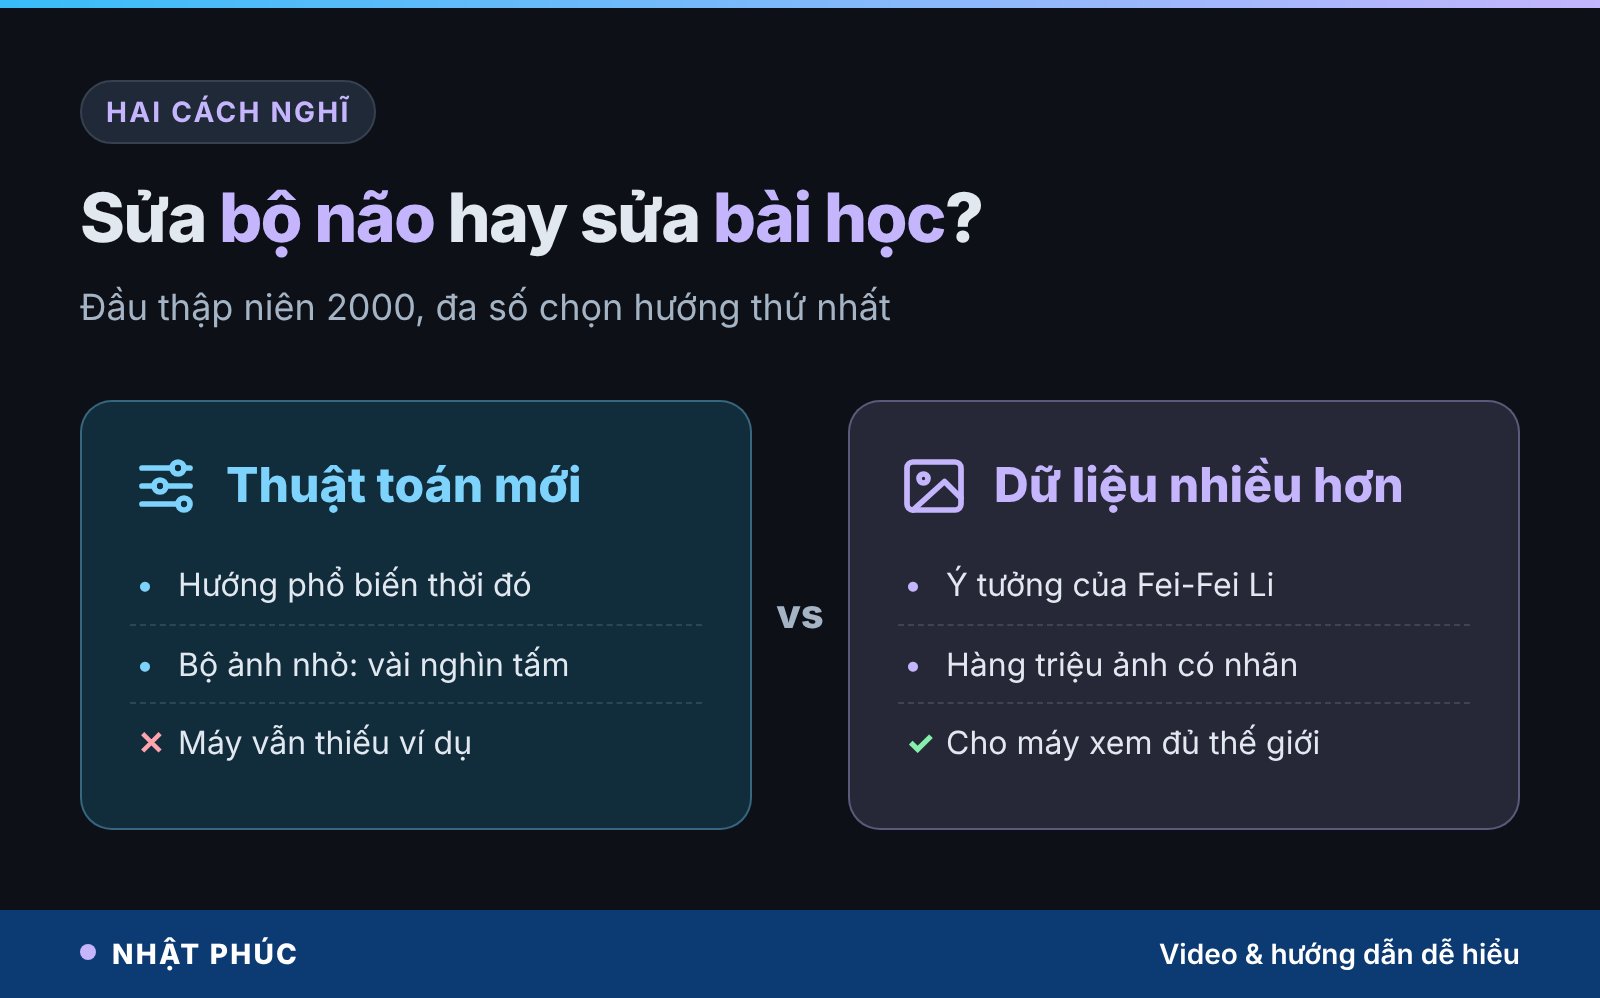
Vào đầu thập niên 2000, các nhà nghiên cứu thị giác máy tính thường làm việc với những bộ ảnh nhỏ, chỉ vài nghìn đến vài chục nghìn tấm. Gần như mọi nỗ lực đổ vào việc chế ra thuật toán khéo léo hơn: cách trích đặc trưng mới, công thức so khớp mới.
Giáo sư Fei-Fei Li, khi ấy ở Đại học Princeton (sau chuyển sang Stanford), nghĩ theo hướng ngược lại. Theo bà, vấn đề không chỉ nằm ở “bộ não” của máy mà nằm ở “bài học” của nó. Một đứa trẻ nhìn thế giới hàng triệu lần mỗi năm, còn máy chỉ được xem vài tấm ảnh. Muốn máy nhìn giỏi, trước hết phải cho nó xem đủ nhiều.
Ý tưởng này nghe hiển nhiên hôm nay, nhưng hồi đó là một canh bạc. Xây một bộ dữ liệu khổng lồ tốn nhiều năm, nhiều tiền, và không ai chắc thuật toán thời ấy có tận dụng được hay không. Nhiều đồng nghiệp coi đây là việc “lao động chân tay” hơn là khoa học.
ImageNet được gắn nhãn thế nào?
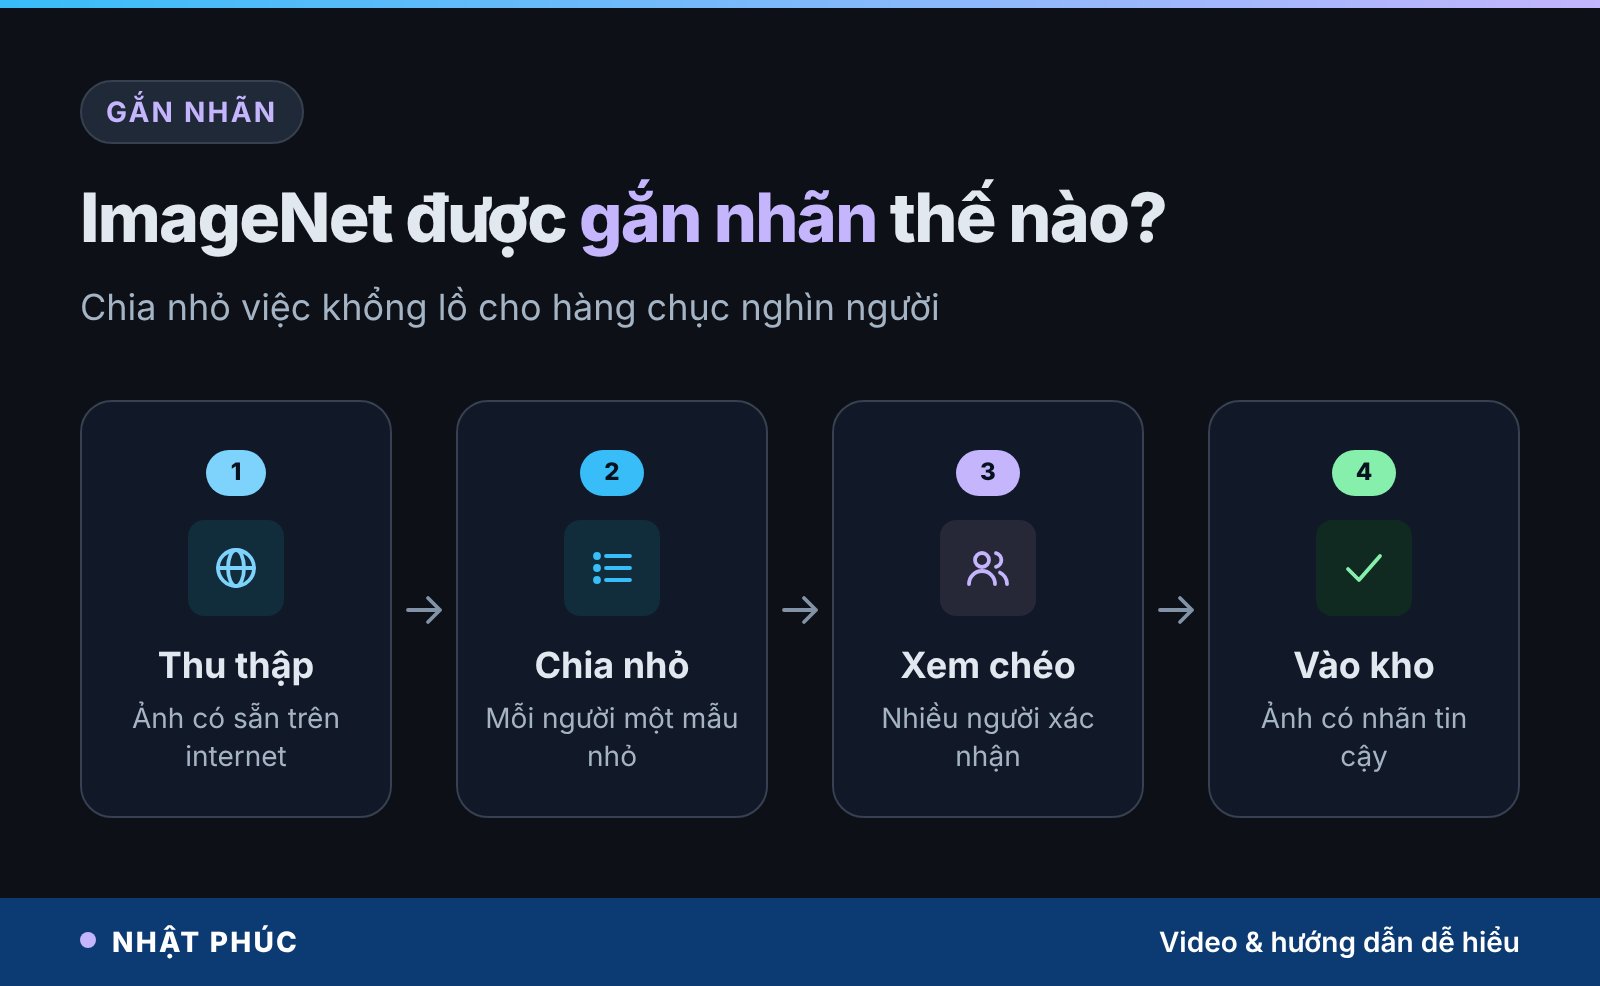
Ảnh thì internet có sẵn. Cái khó là nhãn, tức là ai đó phải nói cho máy biết tấm này là gì. Gắn tay hàng triệu ảnh là việc không một nhóm sinh viên nào làm nổi: nếu mỗi ảnh mất vài giây, một người làm liên tục cũng cần nhiều năm.
Nhóm của Fei-Fei Li tìm ra lối thoát bằng cách chia nhỏ công việc và thuê hàng chục nghìn người làm trực tuyến trên khắp thế giới qua nền tảng việc vặt Amazon Mechanical Turk. Mỗi người chỉ xác nhận từng mẫu nhỏ: “ảnh này có chứa chó săn không?”. Một ảnh được nhiều người xem chéo để giảm nhầm lẫn.
Vì sao phải nhiều người xem cùng một ảnh?
Mỗi người có lúc mệt, lúc vội, lúc không phân biệt nổi hai giống chó trông giống nhau. Khi nhiều người cùng đồng ý, khả năng nhãn đúng cao hơn. Đây là ý tưởng “trí tuệ đám đông”, giống như hỏi đường năm người qua đường thay vì chỉ một.
Năm 2009, bộ dữ liệu ImageNet ra mắt tại một hội nghị thị giác máy tính lớn. Ban đầu nó chưa được chú ý nhiều. Phải đến khi có một cuộc thi, giá trị của nó mới lộ rõ.
Cuộc thi ImageNet: luật chơi và cách chấm
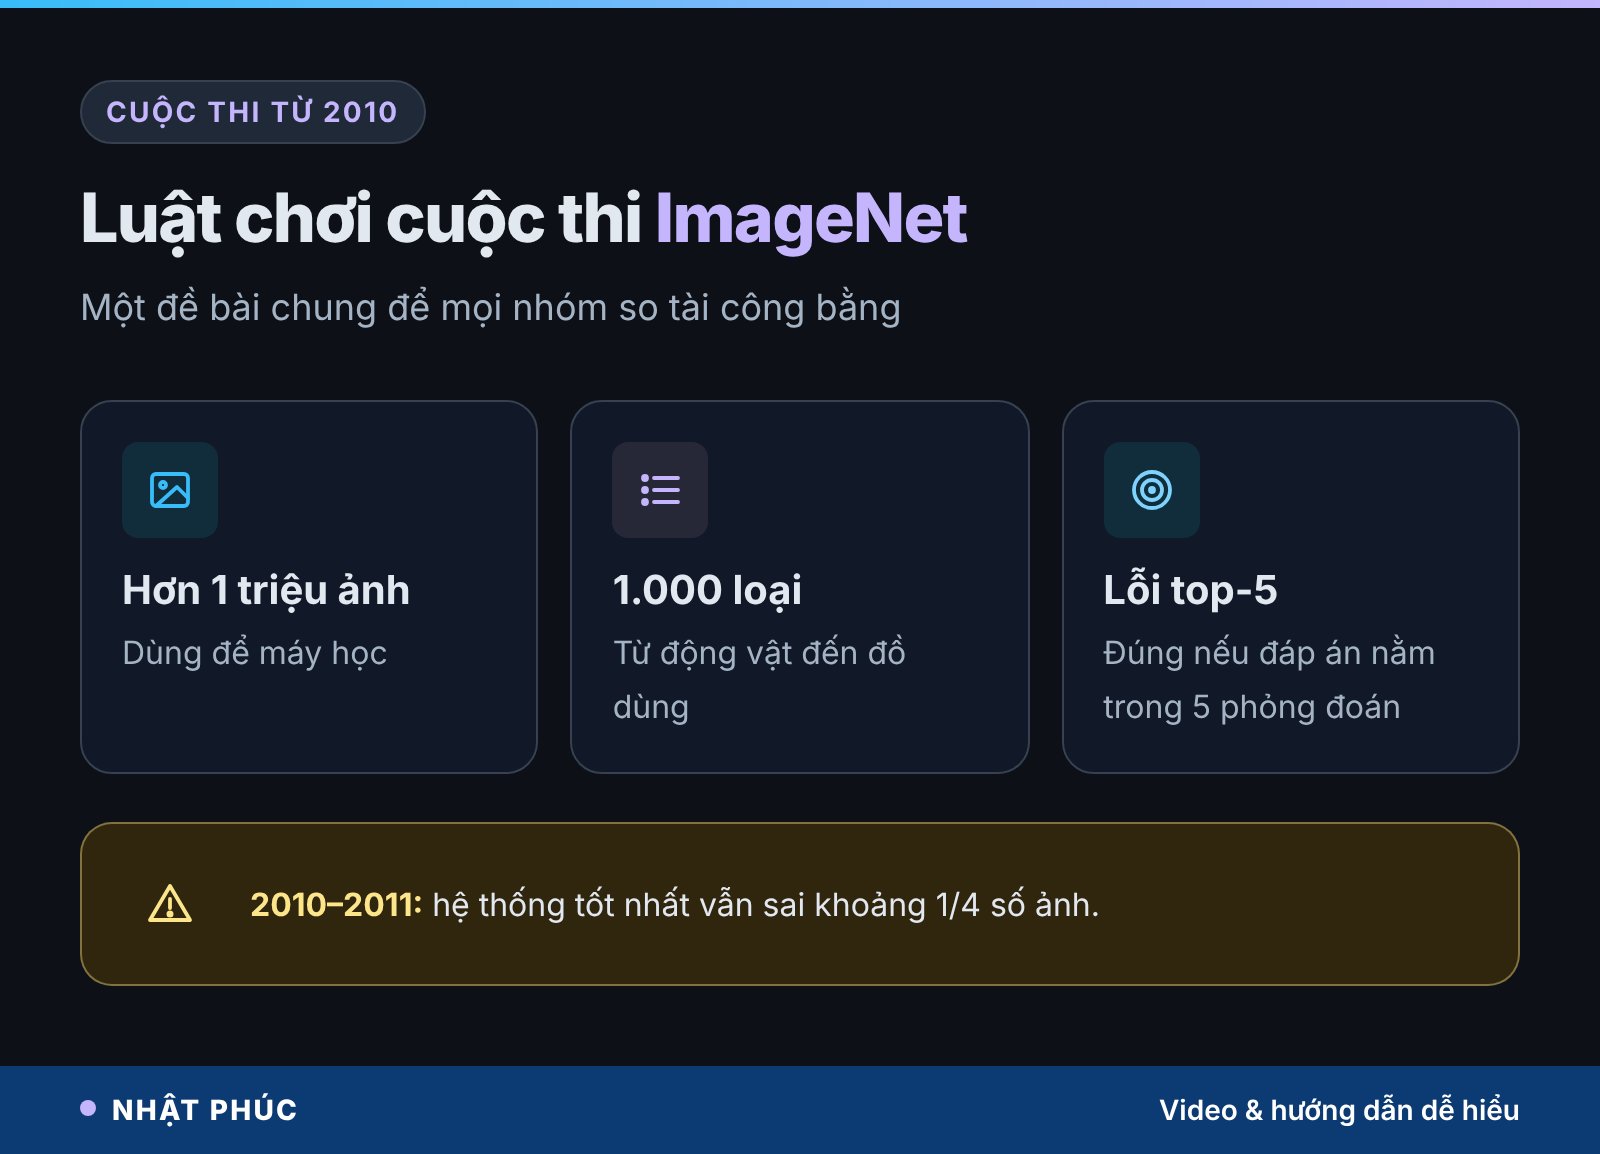
Từ năm 2010, ban tổ chức mở cuộc thi thường niên ImageNet Large Scale Visual Recognition Challenge (thường gọi tắt ILSVRC). Đề bài gọn gàng: hơn 1 triệu ảnh để học, 1.000 loại vật thể, ai gọi tên đúng nhiều nhất trên bộ ảnh thi thì thắng.
Cách chấm phổ biến nhất là tỷ lệ lỗi top-5: mỗi ảnh, hệ thống được đưa ra 5 phỏng đoán; nếu đáp án đúng nằm trong 5 phỏng đoán đó thì tính là đúng. Cách chấm này rộng lượng vì nhiều ảnh chứa nhiều vật thể, và có những loại rất giống nhau.
| Hạng mục | Nội dung |
|---|---|
| Thời gian | Tổ chức hằng năm từ 2010 |
| Ảnh để học | Hơn 1 triệu ảnh |
| Số loại vật thể | 1.000 loại, từ động vật đến đồ dùng |
| Cách chấm chính | Tỷ lệ lỗi top-5 (5 phỏng đoán mỗi ảnh) |
| Ý nghĩa | Thước đo chung để so sánh các phương pháp |
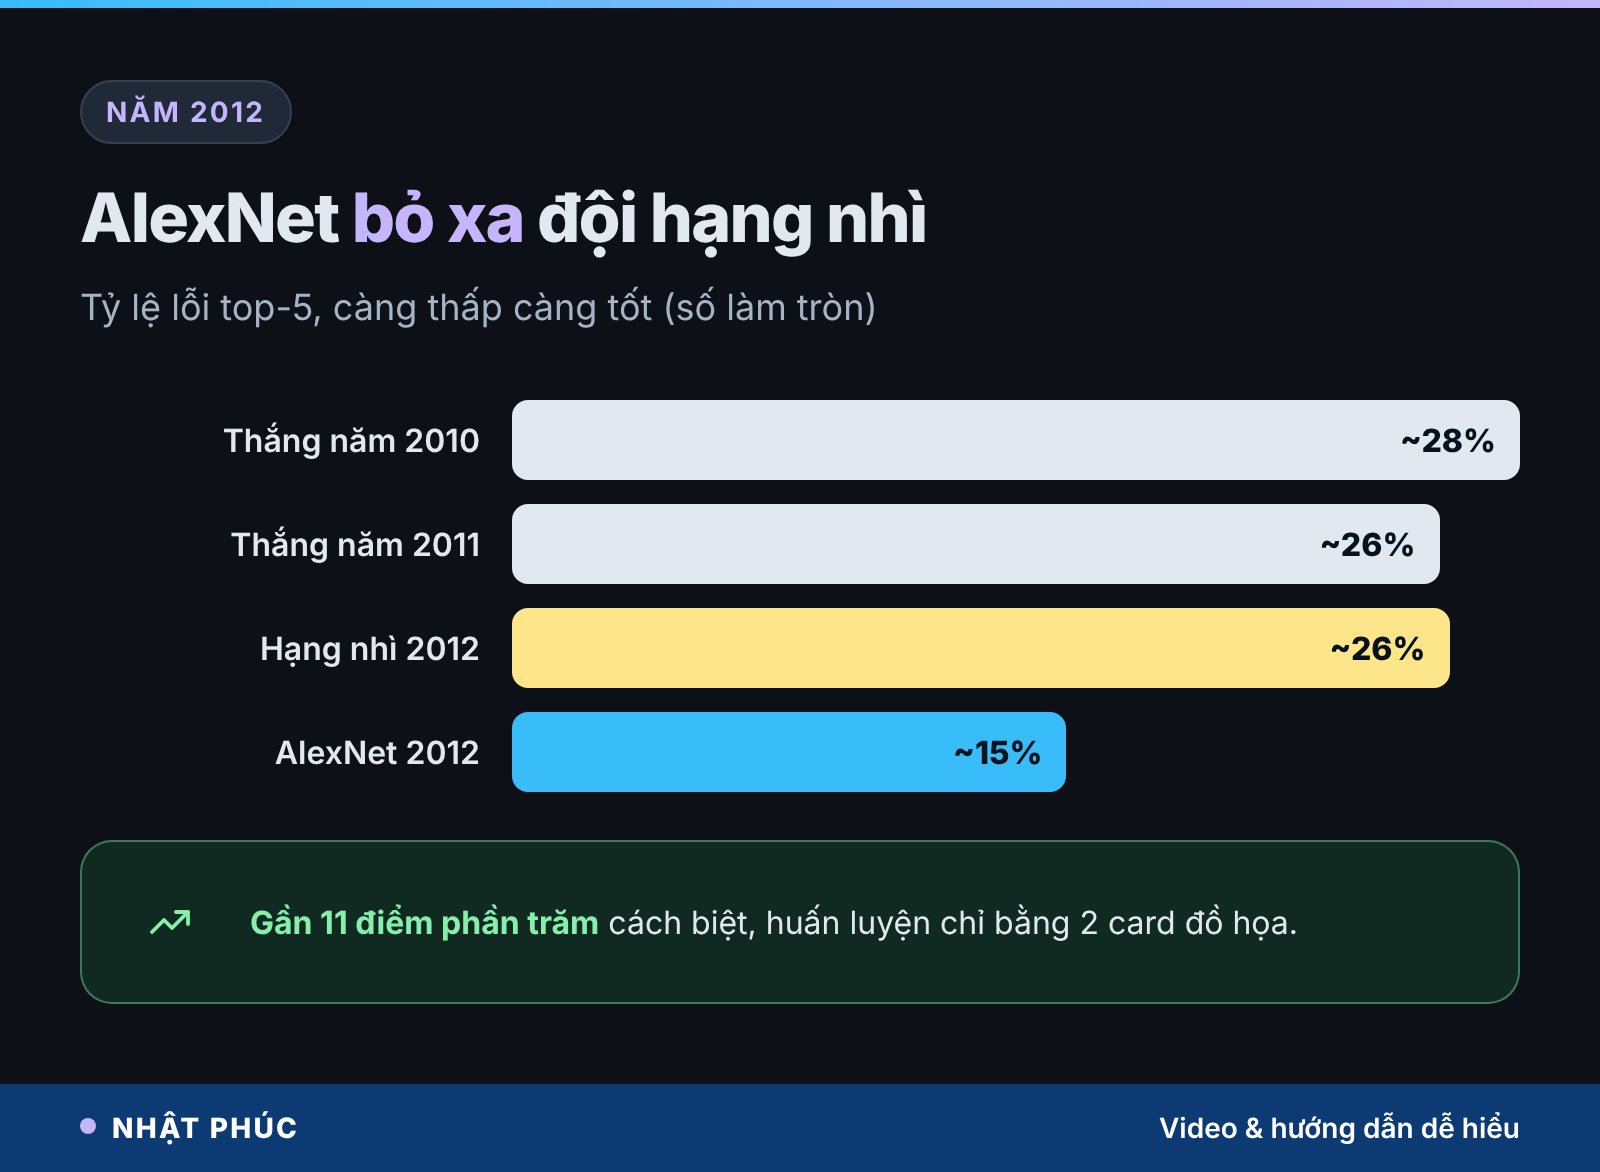
Hai năm đầu, các hệ thống tốt nhất vẫn sai khoảng một phần tư số ảnh. Chúng dùng những phương pháp “thủ công”: con người tự thiết kế cách trích đặc trưng như cạnh, góc, kết cấu, rồi đưa cho một bộ phân loại.
AlexNet năm 2012: cú sốc của giới nghiên cứu
Năm 2012, nhóm của Alex Krizhevsky, Ilya Sutskever và Geoffrey Hinton ở Đại học Toronto nộp một mạng nơ-ron tên là AlexNet. Tỷ lệ lỗi top-5 của nó chỉ khoảng 15%, thấp hơn đội hạng nhì gần 11 điểm phần trăm. Trong một cuộc thi mà các đội thường hơn kém nhau vài điểm, khoảng cách này giống như một vận động viên về đích khi người thứ hai còn ở khúc cua cuối.
AlexNet có gì đặc biệt?
AlexNet là một mạng nơ-ron tích chập (convolutional neural network, CNN) nhiều lớp. Thay vì để con người thiết kế đặc trưng, mạng tự học: lớp đầu nhận ra cạnh và màu, lớp giữa ghép thành hoa văn, lớp sau nhận ra mắt, tai, bánh xe. Nó có khoảng 60 triệu tham số, tức 60 triệu “núm vặn” được chỉnh dần trong lúc học.
Điều khiến nhiều người bất ngờ: họ huấn luyện nó chỉ bằng hai chiếc card đồ hoạ (GPU) dành cho chơi game, chạy trong khoảng gần một tuần. Card đồ hoạ vốn giỏi làm hàng nghìn phép tính nhỏ cùng lúc, đúng kiểu phép tính mà mạng nơ-ron cần.
Sau AlexNet, chuyện gì xảy ra?
Chỉ vài năm sau, gần như mọi đội dự thi đều chuyển sang mạng nơ-ron sâu. Tỷ lệ lỗi tiếp tục giảm mạnh qua từng năm; đến khoảng năm 2015, các mạng tốt nhất đã xuống dưới 5%, ngang hoặc tốt hơn mức một người thử làm cùng bài thi. Cuộc thi chính khép lại sau năm 2017, vì bài toán “gọi tên 1.000 loại” coi như đã được giải.
Vì sao ý tưởng cũ bỗng thành công?
Nghe đến đây bạn có thể hỏi: mạng nơ-ron đâu phải phát minh năm 2012? Đúng vậy. Ý tưởng mạng nơ-ron đã có từ nhiều thập niên trước, và mạng tích chập cũng từng được dùng để đọc chữ số viết tay từ cuối thập niên 1980. Nhưng nó giống như một chiếc động cơ tốt mà thiếu nhiên liệu.
Hãy hình dung một vận động viên marathon cả đời chỉ được tập quanh sân nhà. Cho anh ta cả con đường dài, tiềm năng mới bung ra. Năm 2012, ba thứ cùng hội tụ:
- Dữ liệu đủ lớn: hơn 1 triệu ảnh có nhãn của ImageNet, đủ để một mạng hàng chục triệu tham số học mà không “học vẹt”.
- Phần cứng đủ khoẻ: card đồ hoạ tính song song rẻ và phổ biến nhờ thị trường game.
- Vài cải tiến kỹ thuật: những mẹo huấn luyện giúp mạng sâu học nhanh và ít bị khớp quá mức.
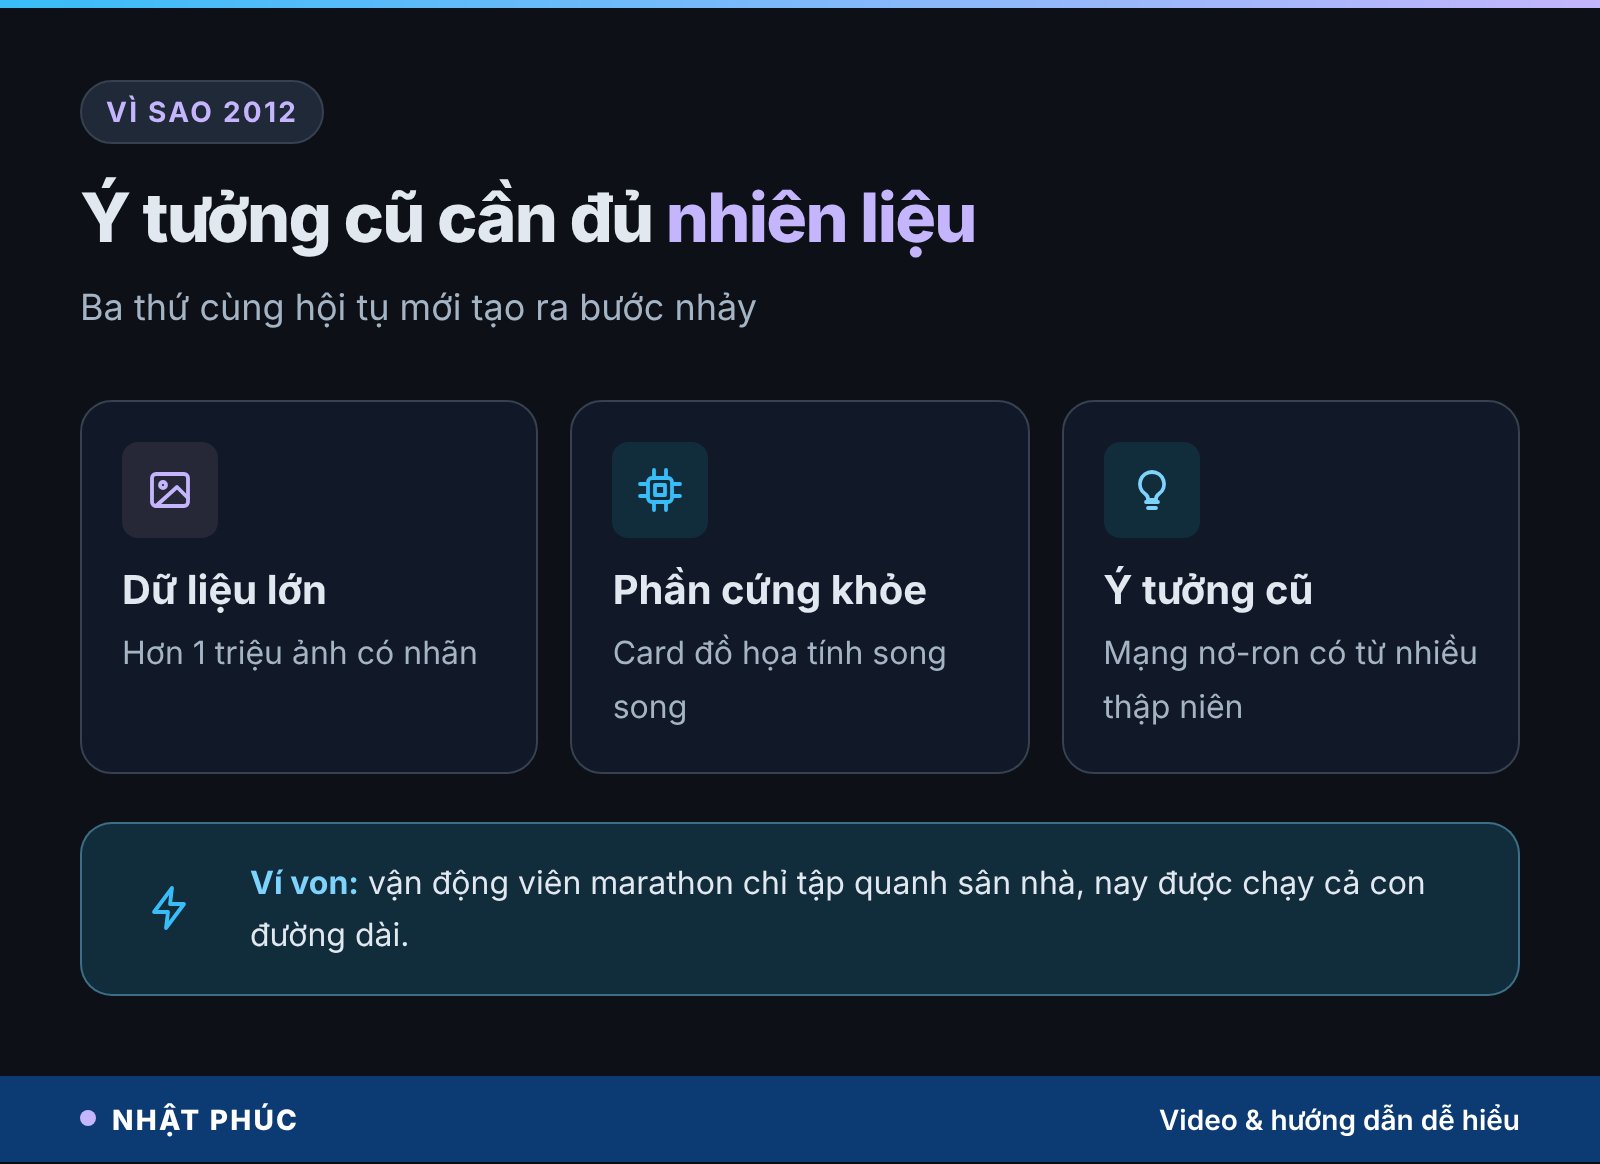
Khi cả ba cùng có mặt, ý tưởng cũ bỗng thành thứ hoàn toàn mới. Đây cũng là lý do bạn hay nghe nói “dữ liệu là nhiên liệu của AI”: thuật toán là động cơ, nhưng không có nhiên liệu thì động cơ tốt mấy cũng đứng yên.
Cái giá của dữ liệu lớn
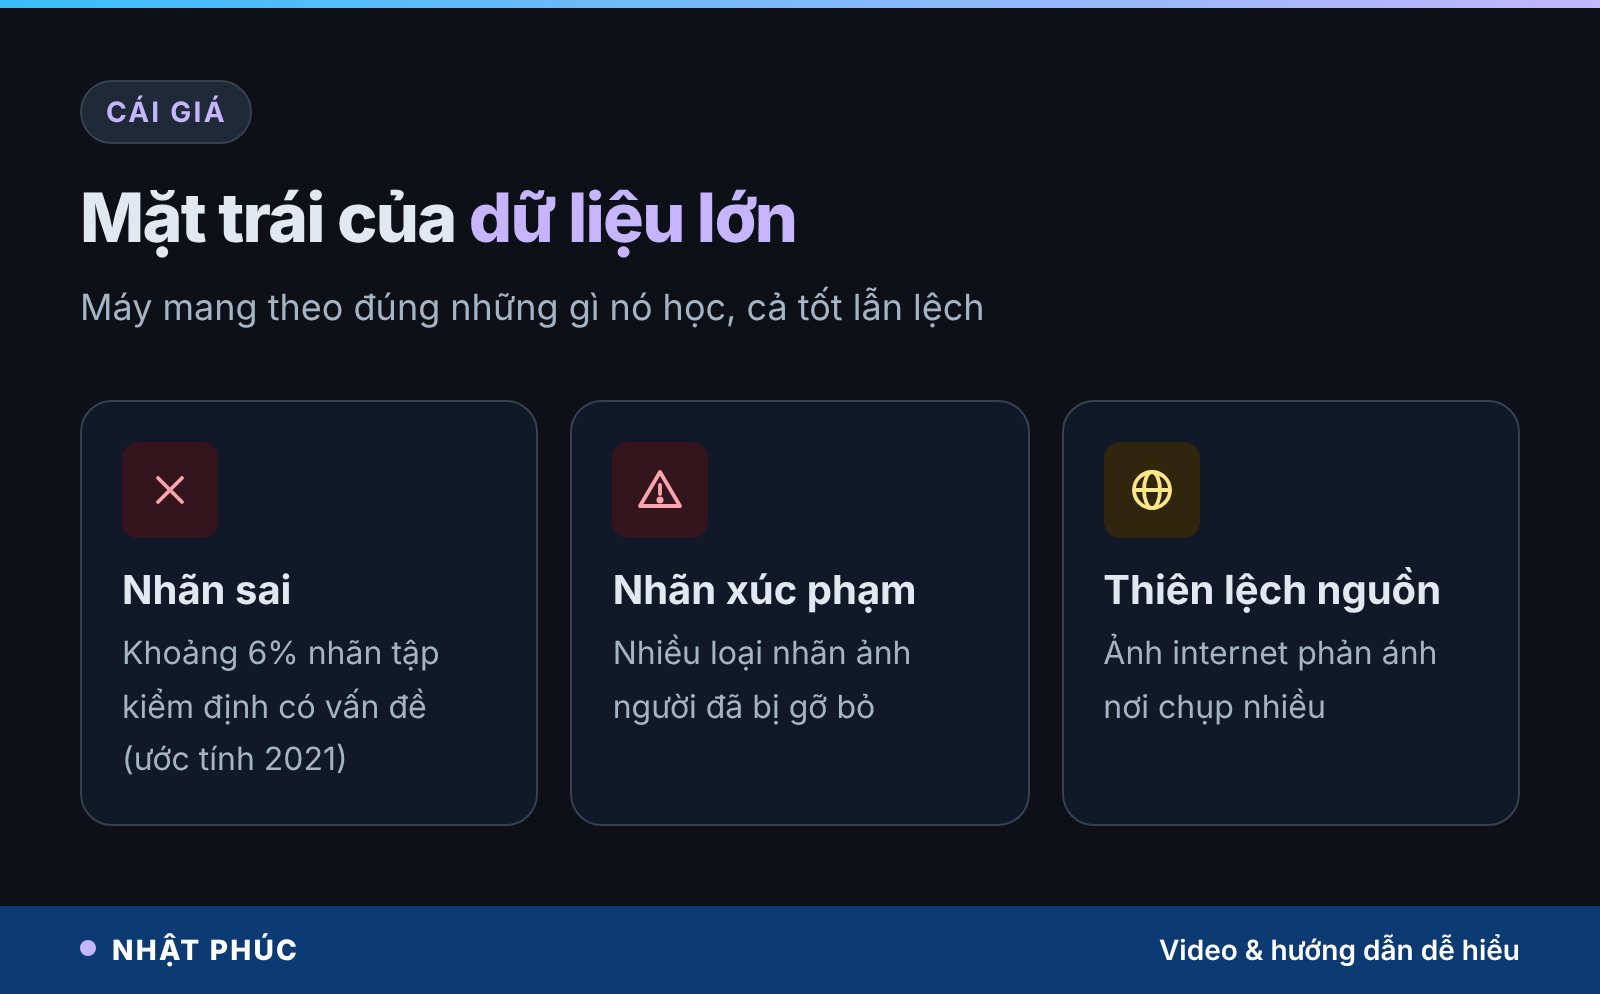
Bộ dữ liệu khổng lồ nào cũng có cái giá của nó. Nhãn do con người gắn thì có sai sót. Về sau, các nhà nghiên cứu rà lại và phát hiện nhiều ảnh bị gắn nhầm; một nghiên cứu năm 2021 ước tính khoảng 6% nhãn trong tập ảnh kiểm định của ImageNet có vấn đề. Nghĩa là ngay cả “đáp án” của đề thi cũng không hoàn hảo.
Vấn đề nghiêm trọng hơn nằm ở phần ảnh chụp người. Vì các loại được lấy từ cây từ vựng có sẵn, một số nhãn gắn cho ảnh người mang tính xúc phạm hoặc định kiến. Khoảng năm 2019, sau khi các nhà nghiên cứu và nghệ sĩ chỉ ra vấn đề, nhóm ImageNet đã rà soát và gỡ bỏ nhiều loại nhãn trong nhánh “người” cùng các ảnh đi kèm.
Thiên lệch đến từ đâu?
Ảnh trong ImageNet chủ yếu lấy từ internet, nên nó phản ánh những gì người dùng mạng hay chụp và đăng. Đồ vật, khung cảnh quen thuộc ở một số nước xuất hiện nhiều hơn hẳn nơi khác. Một hệ thống học từ đó có thể nhận ra “đám cưới” kiểu phương Tây tốt hơn đám cưới truyền thống ở nơi khác.
Bài học đơn giản: máy học gì từ dữ liệu, nó mang theo đúng cái ấy, cả cái tốt lẫn cái lệch. Muốn AI công bằng, phải bắt đầu từ việc soi kỹ dữ liệu.
Hiểu lầm phổ biến về ImageNet
Dù giỏi gọi tên 1.000 loại vật thể, hệ thống kiểu này không hiểu mèo là gì. Nó không biết mèo kêu meo, thích nằm nắng hay sợ nước. Nó chỉ nhận ra những quy luật của điểm ảnh thường đi cùng chữ “mèo”. Nếu đổi phông nền hay thêm một lớp nhiễu khéo léo, mạng có thể đoán sai một cách khó hiểu.
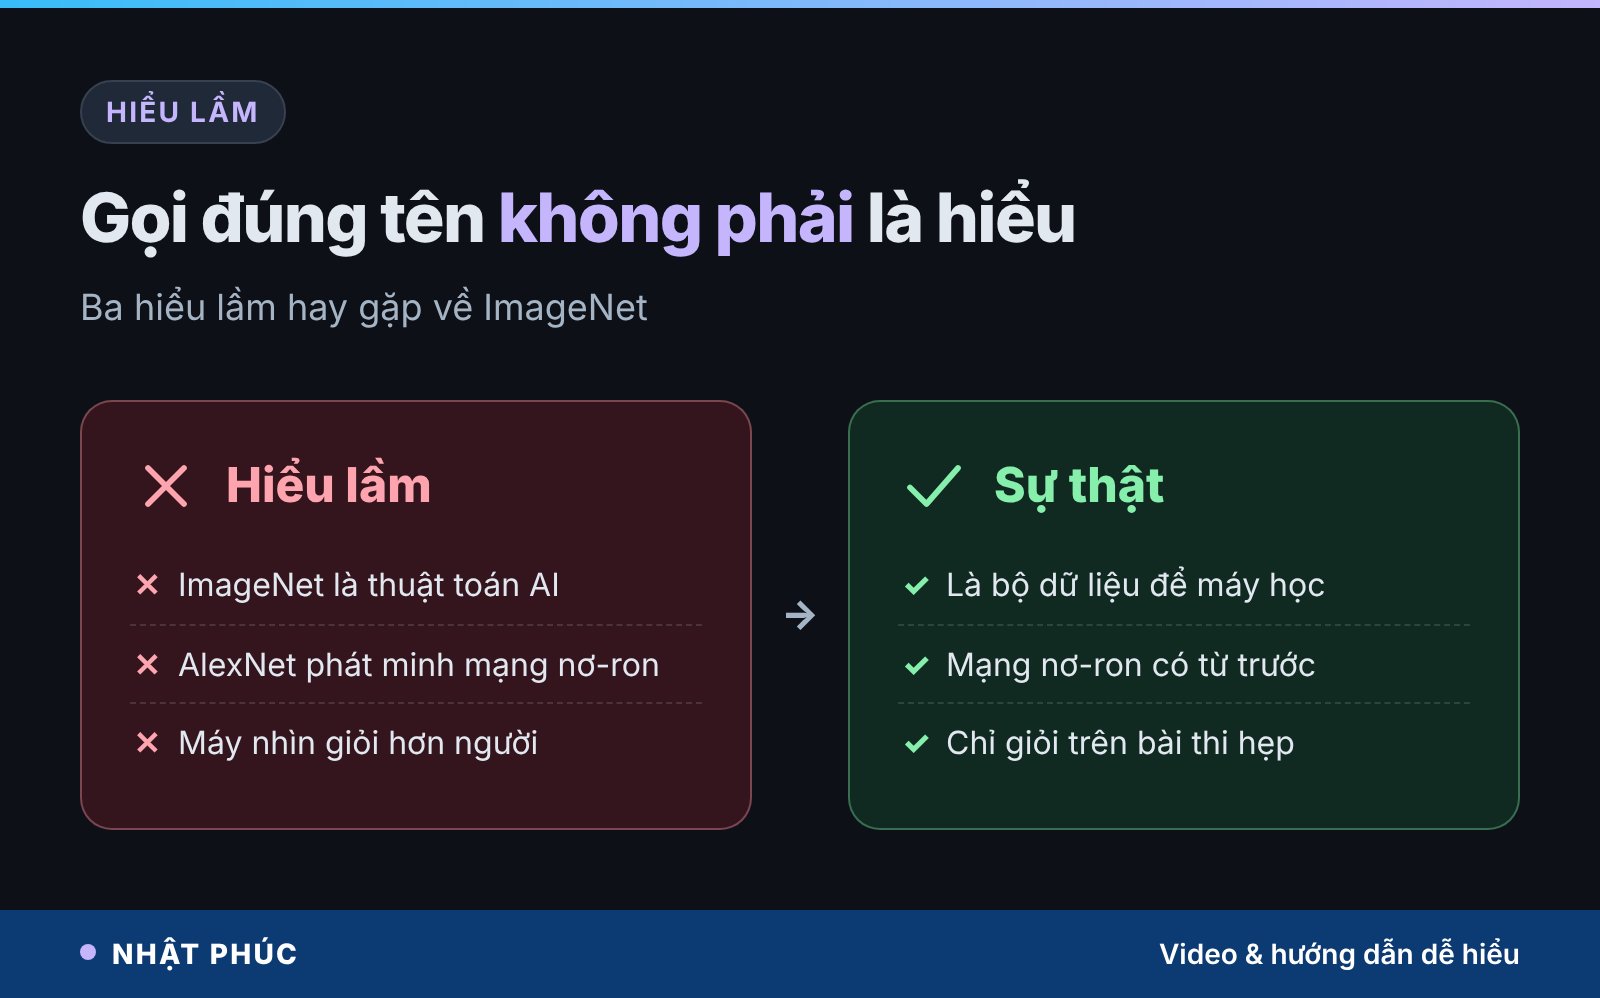
- Hiểu lầm: ImageNet là một thuật toán AI. Sự thật: nó là bộ dữ liệu; thuật toán là thứ học từ nó.
- Hiểu lầm: AlexNet phát minh ra mạng nơ-ron. Sự thật: mạng nơ-ron đã có từ trước; AlexNet chứng minh nó thắng lớn khi có đủ dữ liệu và GPU.
- Hiểu lầm: máy “vượt người” trên ImageNet nghĩa là máy nhìn giỏi hơn người. Sự thật: máy chỉ giỏi hơn trên một bài thi hẹp, với 1.000 loại cố định.
Bài học từ ImageNet cho người dùng AI hôm nay
Vậy bài học của ImageNet là gì? Rằng trong học máy, câu hỏi hay không chỉ là “chế ra bộ não thông minh hơn”. Nhiều khi nó là: ta đã cho máy xem đủ cuộc sống chưa? Các mô hình ngôn ngữ lớn ngày nay đi đúng con đường ấy, chỉ là thay ảnh bằng văn bản với quy mô lớn hơn rất nhiều.
Với người dùng bình thường, câu chuyện ImageNet gợi ra vài thói quen hữu ích khi làm việc với AI:
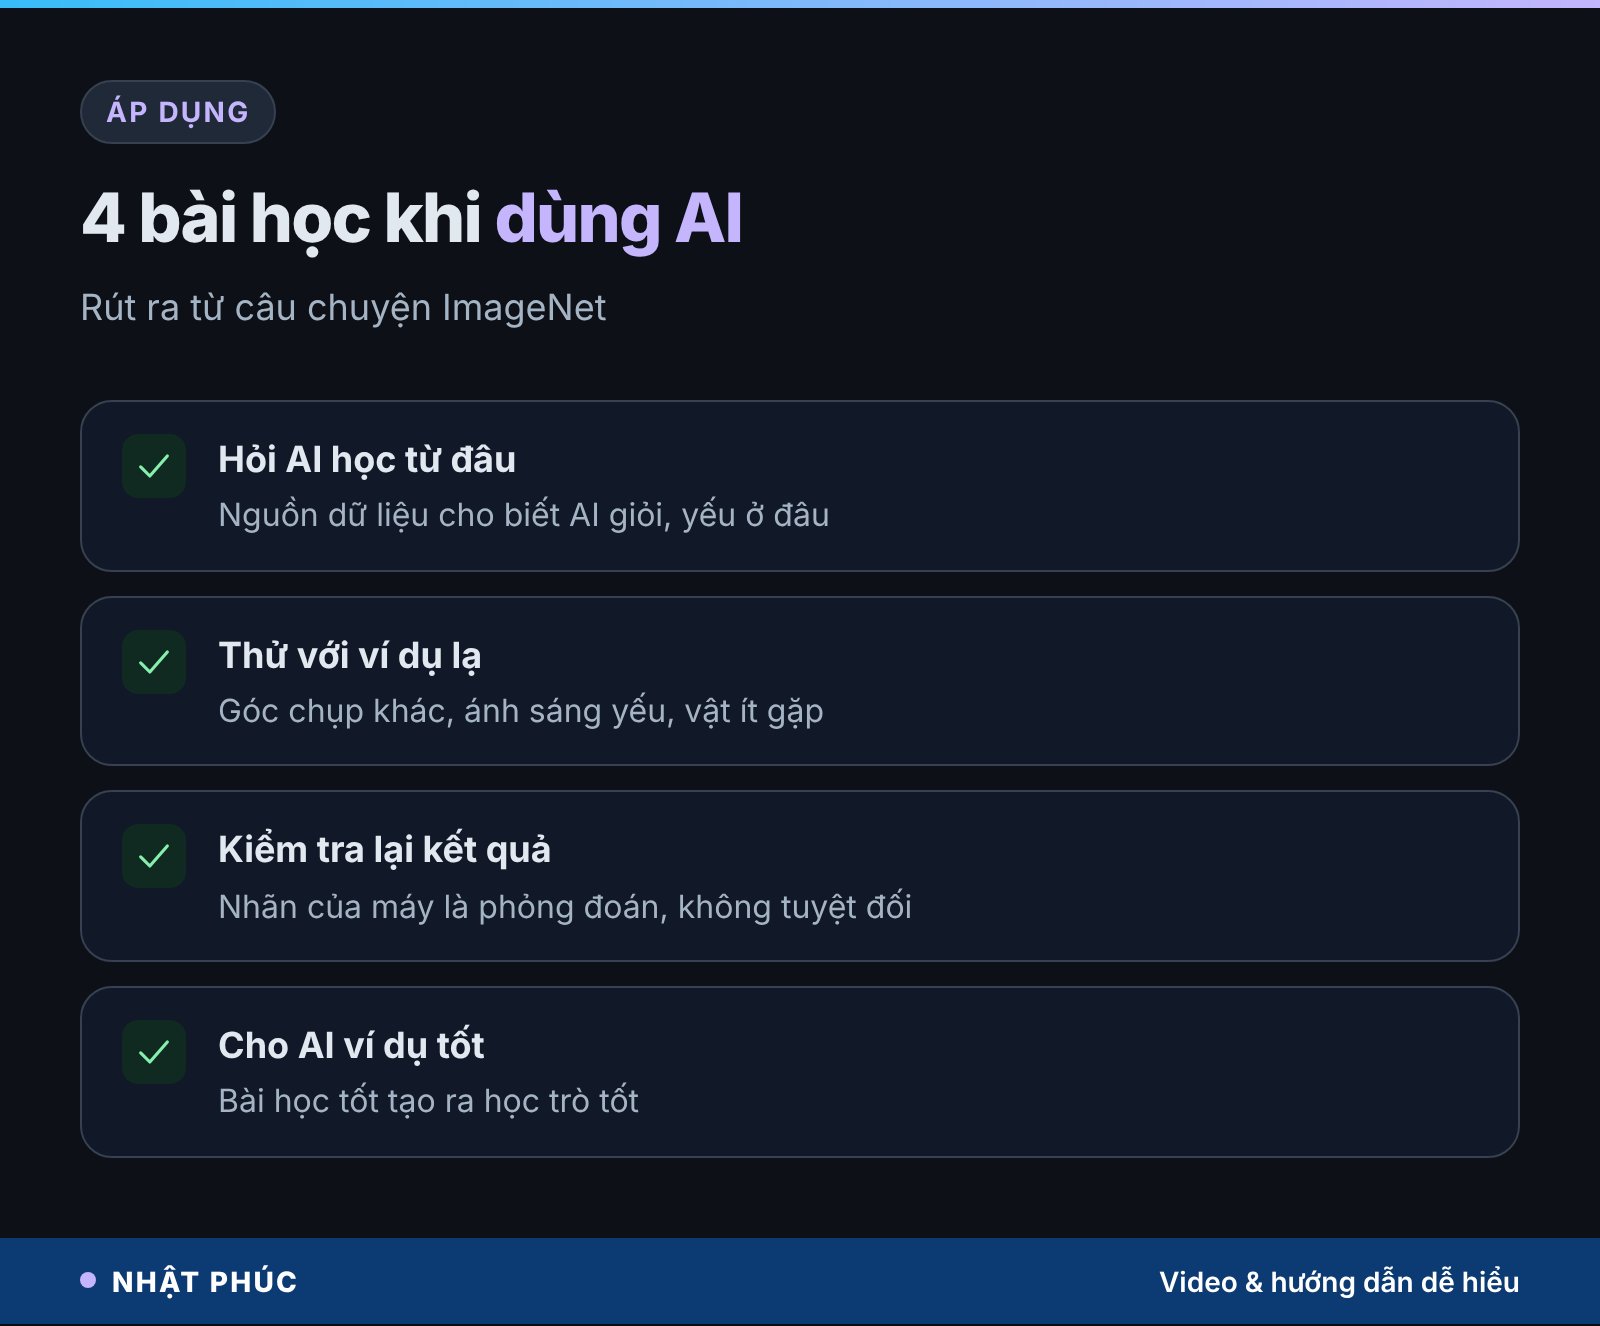
1. Hỏi “AI này học từ đâu?”
Một ứng dụng nhận diện cây cối học chủ yếu từ cây ôn đới có thể nhận nhầm cây nhiệt đới. Biết nguồn dữ liệu giúp bạn đoán được AI sẽ giỏi và yếu ở đâu.
2. Thử với ví dụ “lạ”
Đưa cho công cụ AI một tấm ảnh góc chụp khác, ánh sáng yếu, hoặc vật thể ít phổ biến. Nếu kết quả đổi hẳn, đó là dấu hiệu nó dựa vào quy luật bề mặt.
3. Đừng coi nhãn của máy là sự thật tuyệt đối
Ngay cả “đáp án” của ImageNet cũng có sai. Kết quả của AI là một phỏng đoán có xác suất, cần người kiểm tra trong việc quan trọng.
4. Muốn AI hiểu việc của bạn, cho nó ví dụ tốt
Khi nhờ AI viết hay phân loại, đưa kèm vài ví dụ đúng ý bạn. Đó là phiên bản nhỏ của bài học ImageNet: bài học tốt tạo ra học trò tốt.
| Tiêu chí | Trước 2012 | Sau AlexNet |
|---|---|---|
| Đặc trưng ảnh | Con người tự thiết kế | Mạng tự học từ dữ liệu |
| Dữ liệu | Vài nghìn đến vài chục nghìn ảnh | Hàng triệu ảnh có nhãn |
| Phần cứng | Chủ yếu CPU | Card đồ hoạ (GPU) |
| Tỷ lệ lỗi top-5 | Khoảng 25% trở lên | Khoảng 15%, rồi giảm dưới 5% |
Câu hỏi thường gặp
ImageNet có bao nhiêu ảnh?
Toàn bộ ImageNet chứa khoảng 14 triệu ảnh, chia thành hàng chục nghìn loại theo cây từ vựng WordNet. Phiên bản dùng cho cuộc thi nổi tiếng nhỏ hơn: hơn 1 triệu ảnh để học với 1.000 loại vật thể. Khi các bài báo nói “huấn luyện trên ImageNet”, họ thường muốn nói phiên bản 1.000 loại này.
Ai tạo ra ImageNet?
ImageNet do nhóm của giáo sư Fei-Fei Li khởi xướng khi bà ở Đại học Princeton, sau tiếp tục ở Stanford, cùng nhiều cộng sự. Bộ dữ liệu ra mắt năm 2009. Việc xác nhận nhãn được chia nhỏ cho hàng chục nghìn người làm trực tuyến trên khắp thế giới.
AlexNet là gì và vì sao nổi tiếng?
AlexNet là mạng nơ-ron tích chập do Alex Krizhevsky, Ilya Sutskever và Geoffrey Hinton phát triển. Năm 2012, nó thắng cuộc thi ImageNet với tỷ lệ lỗi top-5 khoảng 15%, bỏ xa đội hạng nhì gần 11 điểm phần trăm. Chiến thắng này khiến cả ngành chuyển sang học sâu.
Vì sao huấn luyện AI cần card đồ hoạ?
Mạng nơ-ron cần thực hiện rất nhiều phép nhân cộng nhỏ giống nhau. Card đồ hoạ được thiết kế để làm hàng nghìn phép tính như vậy cùng lúc khi vẽ hình game, nên nhanh hơn CPU nhiều lần cho việc này. AlexNet chỉ dùng hai card đồ hoạ để huấn luyện.
ImageNet còn được dùng hôm nay không?
Có. Cuộc thi chính đã khép lại sau năm 2017, nhưng ImageNet vẫn là bộ dữ liệu chuẩn để thử nghiệm mô hình thị giác mới và để huấn luyện trước các mô hình trước khi tinh chỉnh cho việc cụ thể. Dù vậy, các nhà nghiên cứu ngày càng chú ý đến lỗi nhãn và thiên lệch của nó.
AI nhận ra mèo có nghĩa là hiểu con mèo không?
Không. Hệ thống phân loại ảnh chỉ học mối liên hệ giữa các mẫu điểm ảnh và chữ “mèo”. Nó không biết mèo là sinh vật sống, có thói quen hay cảm xúc gì. Vì vậy nó có thể nhầm lẫn theo những cách mà con người thấy rất vô lý.
Kết luận: để máy biết nhìn, hãy chịu khó cho nó xem
Quay lại câu hỏi ban đầu: năm 2012 không có phép màu nào xảy ra. Ý tưởng mạng nơ-ron đã chờ sẵn hàng chục năm. Thứ nó thiếu chỉ là một bài học đủ dài, và ImageNet chính là bài học ấy. Đôi khi, để một cỗ máy biết nhìn, việc đầu tiên không phải là dạy nó nghĩ, mà là chịu khó cho nó xem.
Bạn nghĩ dữ liệu hay thuật toán quan trọng hơn trong AI hôm nay? Hãy để lại ý kiến ở phần bình luận, và theo dõi Nhật Phúc để đọc thêm những bài giải thích công nghệ dễ hiểu như thế này.