Bạn gõ một câu tiếng Việt, nhấn một nút, và chỉ một giây sau nó đã thành tiếng Nhật hay tiếng Bồ Đào Nha. Nghe như phép màu. Nhưng nếu máy chỉ mở từ điển ra tra từng chữ, kết quả gần như chắc chắn là một mớ chữ vô nghĩa. Vậy dịch máy hoạt động thế nào để biến một câu của ngôn ngữ này thành một câu tự nhiên ở ngôn ngữ khác?
Câu trả lời ngắn: Dịch máy hiện đại không tra từng chữ. Nó học từ hàng triệu cặp câu đã được con người dịch sẵn, dùng mạng nơ-ron để nén ý nghĩa cả câu thành một dãy con số, rồi viết lại ý đó bằng ngôn ngữ đích từng chữ một. Kiến trúc Transformer với cơ chế chú ý giúp máy nhìn cả ngữ cảnh khi chọn từng chữ, nên bản dịch trôi chảy hơn hẳn trước đây.
Trong bài này, Nhật Phúc đi lại đúng con đường mà dịch máy đã đi suốt hơn 70 năm: từ những ngày viết tay quy tắc ngữ pháp, sang dịch máy thống kê, rồi mạng nơ-ron và Transformer. Cuối bài là những giới hạn mà bạn cần biết trước khi tin tuyệt đối vào một bản dịch tự động.
Nếu bạn thích xem hơn đọc, hãy xem video giải thích dịch máy trong hơn 3 phút ngay dưới đây, rồi quay lại bài viết để đi sâu từng giai đoạn.
Tóm tắt nhanh
- Dịch từng chữ thất bại vì ngôn ngữ là cách diễn đạt ý, không phải bảng tra từ.
- Dịch máy dựa trên quy tắc (từ thập niên 1950) vấp phải vô số ngoại lệ ngữ pháp.
- Dịch máy thống kê học từ văn bản song ngữ, chọn cụm từ có xác suất cao nhất.
- Dịch máy bằng mạng nơ-ron đọc cả câu, nén ý nghĩa rồi viết lại bằng ngôn ngữ đích.
- Transformer và cơ chế chú ý giúp máy dùng ngữ cảnh để hiểu đúng nghĩa từng chữ.
- Bản dịch trôi chảy chưa chắc đã đúng: tài liệu quan trọng vẫn cần người kiểm tra.
Nội dung chính:
- Dịch máy là gì và vì sao nó khó
- Vì sao dịch từng chữ thất bại?
- Dịch máy dựa trên quy tắc: lạc quan năm 1954
- Dịch máy thống kê là gì?
- Dịch máy bằng mạng nơ-ron hoạt động thế nào?
- Transformer và cơ chế chú ý trong dịch máy
- So sánh ba thế hệ dịch máy
- Giới hạn của dịch máy
- Những hiểu lầm phổ biến về dịch máy
- Cách dùng dịch máy hiệu quả và an toàn
- Câu hỏi thường gặp về dịch máy
- Kết luận
Dịch máy là gì và vì sao nó khó
Dịch máy (tiếng Anh: machine translation) là việc dùng chương trình máy tính để chuyển một đoạn văn bản hoặc lời nói từ ngôn ngữ này sang ngôn ngữ khác mà không cần người dịch trực tiếp. Google Dịch, công cụ dịch trong trình duyệt, tính năng dịch biển hiệu bằng camera điện thoại hay phụ đề tự động trên video đều là những dạng dịch máy bạn gặp mỗi ngày.
Nghe thì đơn giản: có từ điển, có ngữ pháp, cứ thế mà đổi. Nhưng thực tế, đây là một trong những bài toán khó nhất của khoa học máy tính. Lý do là ngôn ngữ không vận hành như một bảng quy đổi đơn vị. Một chữ có thể có nhiều nghĩa, một ý có thể nói bằng nhiều cách, và rất nhiều thứ nằm ngoài chữ: văn hoá, ngữ cảnh, quan hệ giữa người nói và người nghe.
Hãy so với việc đổi tiền. Đổi 100 đô la sang tiền Việt chỉ cần nhân với tỷ giá, kết quả luôn giống nhau. Còn “dịch” một câu giống việc kể lại một câu chuyện cho người ở nền văn hoá khác: bạn phải hiểu ý trước, rồi chọn cách nói mà người nghe thấy tự nhiên. Toàn bộ lịch sử dịch máy là câu chuyện về việc máy tính tiến dần từ “đổi tiền” sang “kể lại”.
Vì sao dịch từng chữ thất bại?
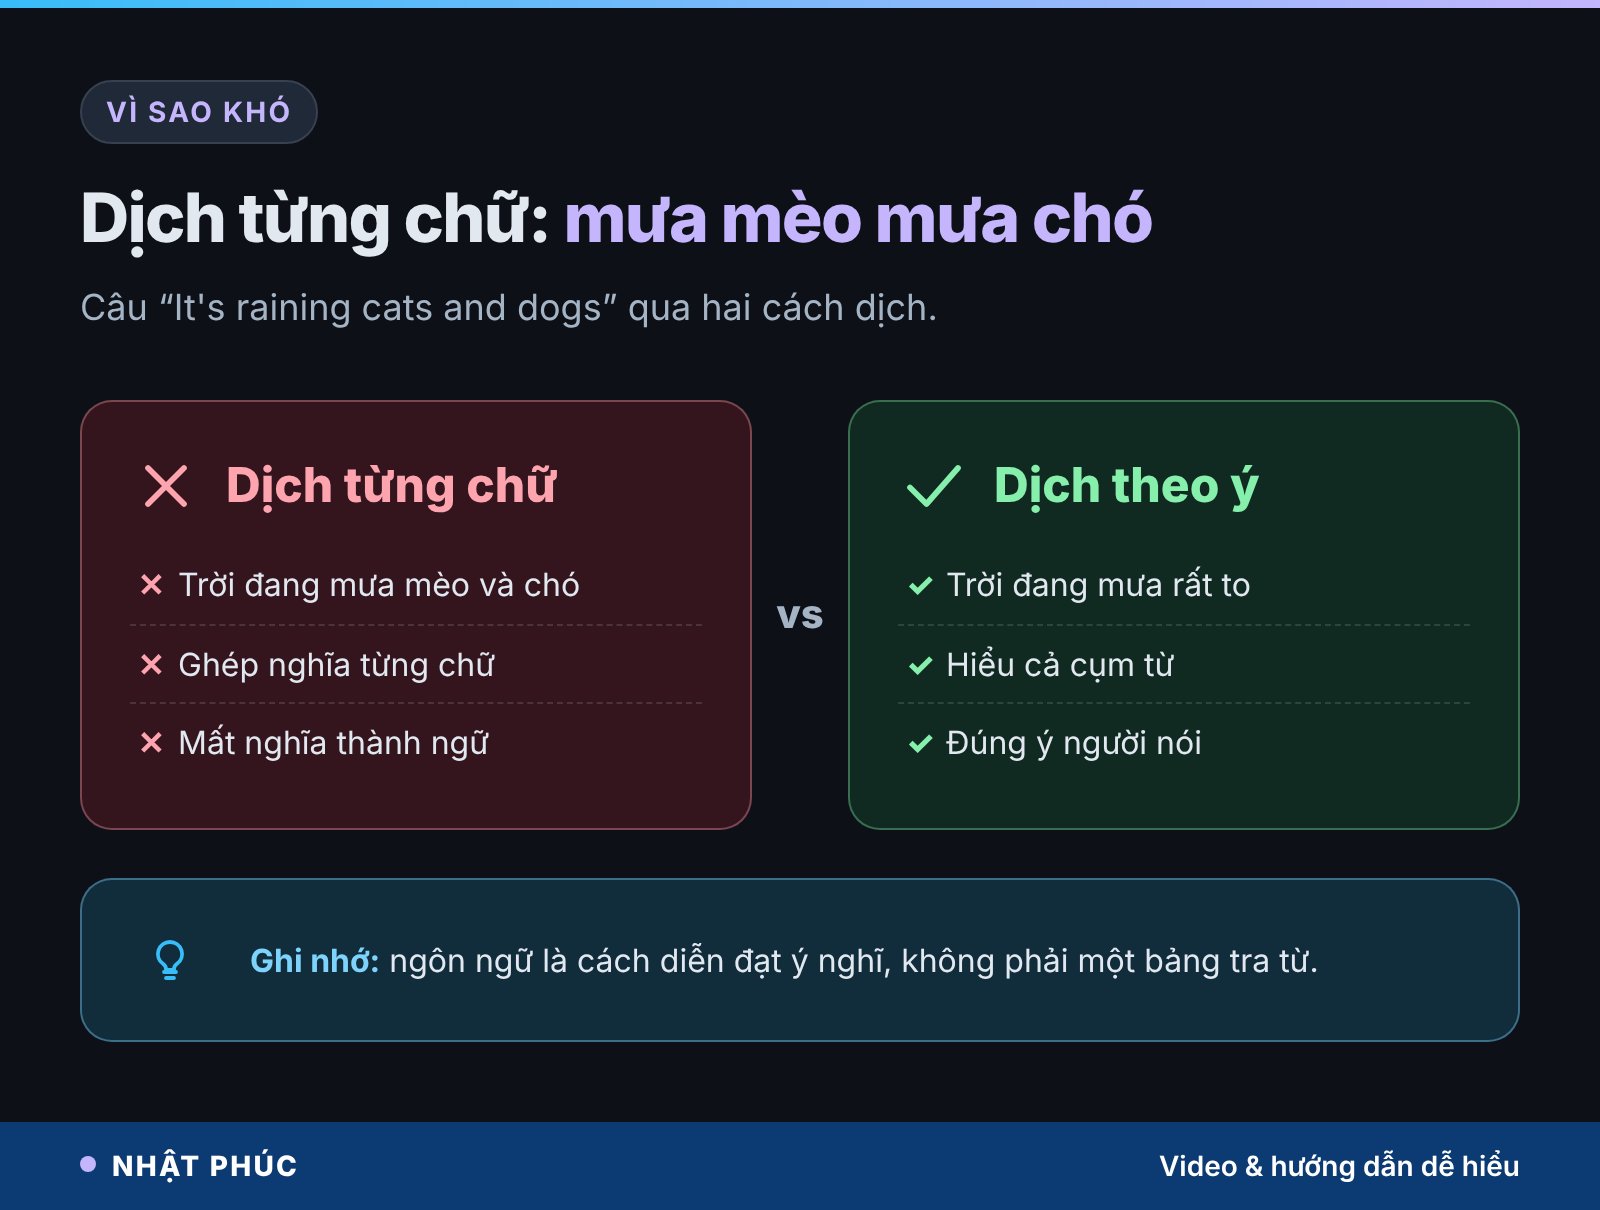
Thử dịch từng chữ câu tiếng Anh “It’s raining cats and dogs”. Bạn sẽ có một câu về mèo và chó rơi từ trên trời xuống. Trong khi người nói tiếng Anh chỉ muốn bảo rằng trời đang mưa rất to. Đây là một thành ngữ: nghĩa của cả cụm khác hẳn nghĩa cộng lại của từng chữ.
Thành ngữ chỉ là một phần của vấn đề. Dịch từng chữ còn vấp ít nhất ba cái bẫy khác:
- Trật tự từ khác nhau: tiếng Việt nói “ngôi nhà đỏ”, tiếng Anh nói “red house”, còn tiếng Nhật thường đặt động từ ở cuối câu.
- Một chữ nhiều nghĩa: chữ “bank” có thể là ngân hàng hoặc bờ sông; chữ “bàn” trong tiếng Việt có thể là cái bàn hoặc việc bàn bạc.
- Thứ không có trong ngôn ngữ kia: tiếng Việt không chia thì động từ, tiếng Anh không có hệ thống xưng hô anh, chị, em, cô, chú như tiếng Việt.
Đó chính là bài toán của dịch máy. Ngôn ngữ không phải một bảng tra từ, mà là cách con người diễn đạt ý nghĩ. Muốn dịch tốt, máy phải xử lý được ý nghĩa ở mức cả câu, thậm chí cả đoạn, chứ không chỉ ở mức từng chữ.
Dịch máy dựa trên quy tắc: lạc quan năm 1954
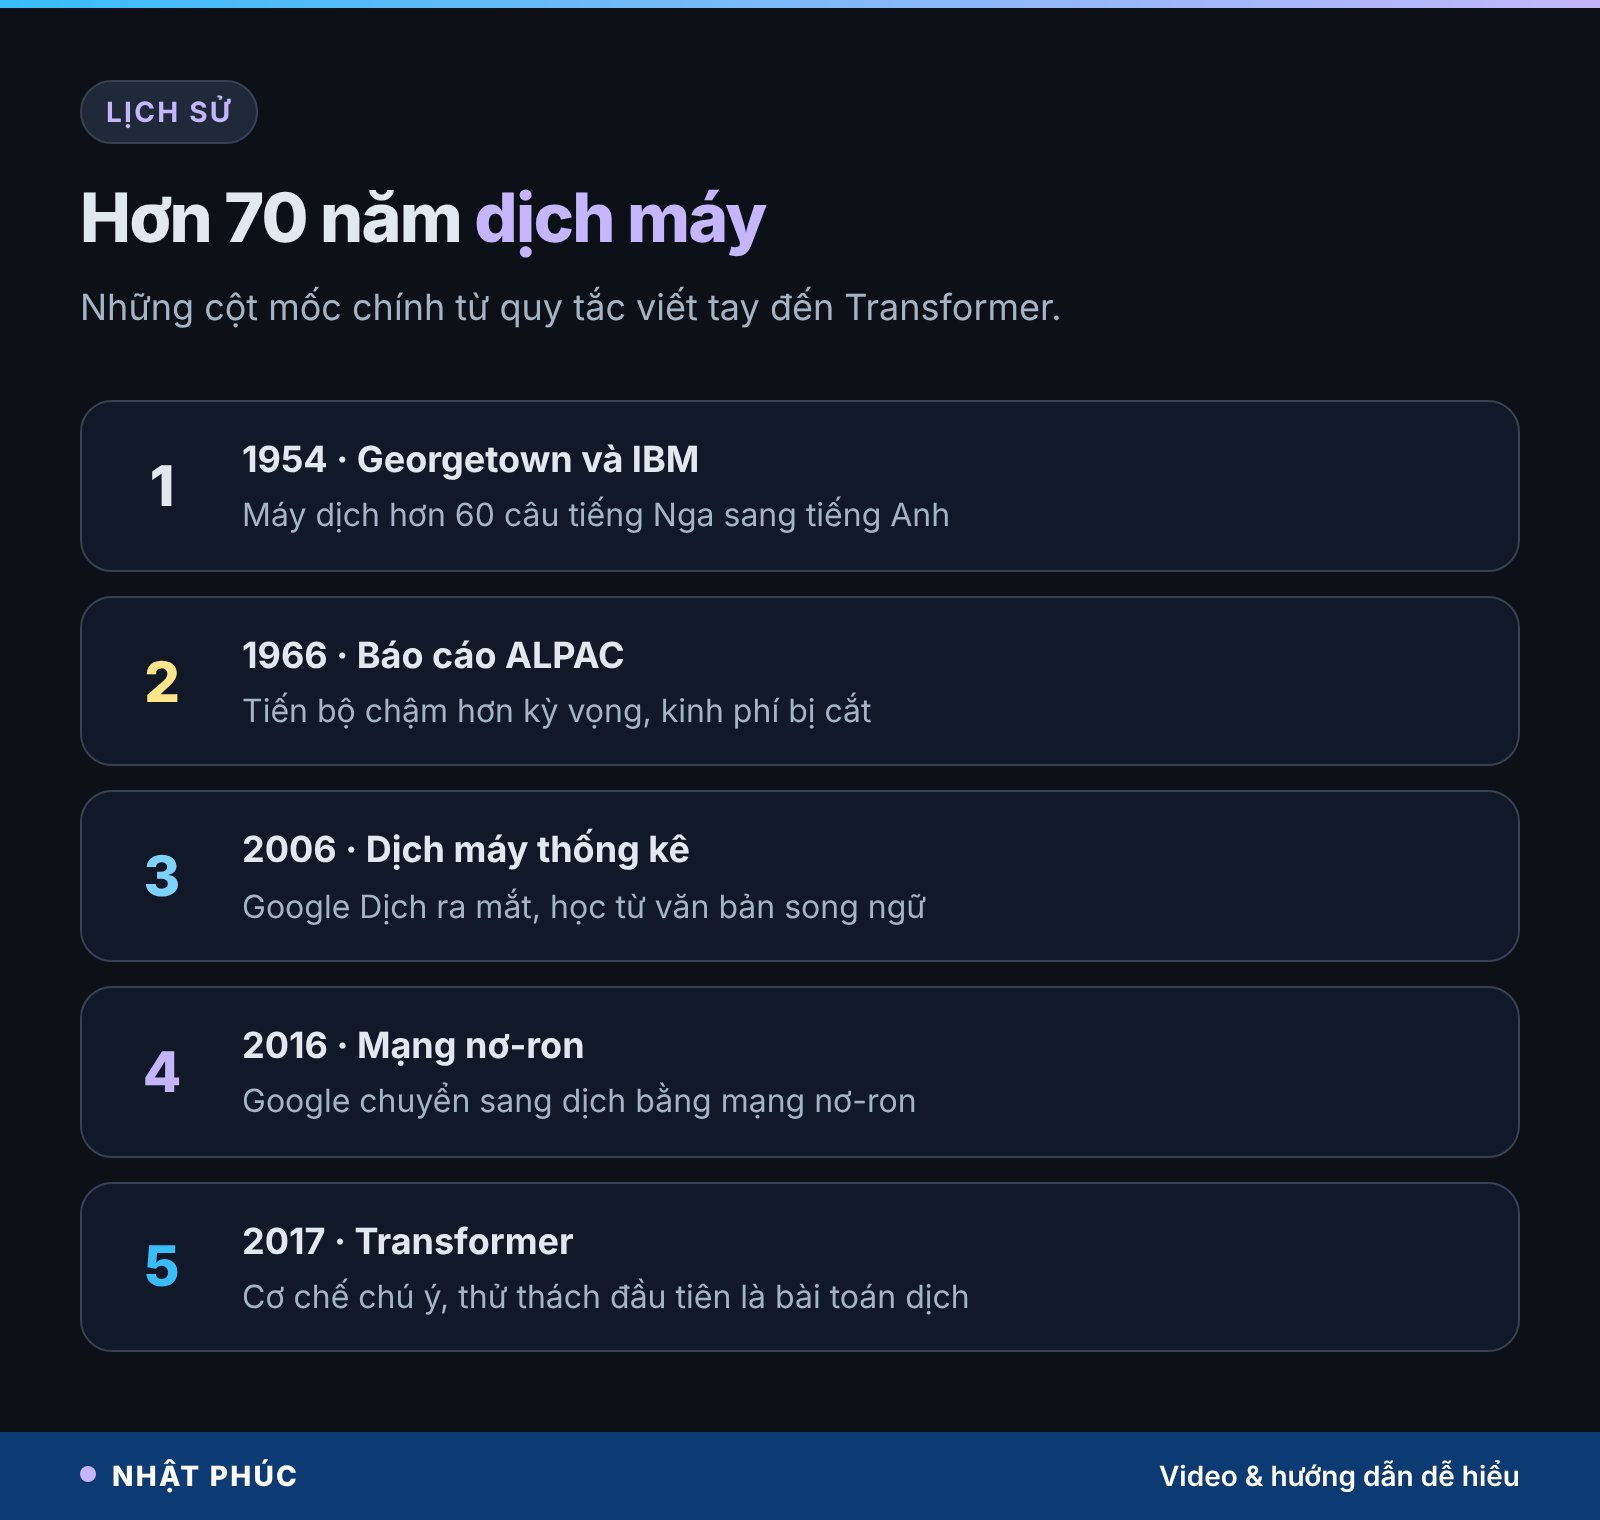
Tháng 1 năm 1954, Đại học Georgetown và IBM tổ chức một buổi trình diễn gây chấn động: máy tính tự động dịch hơn 60 câu tiếng Nga sang tiếng Anh. Hệ thống khi đó chỉ có vài trăm từ vựng và vài chục quy tắc ngữ pháp, các câu thử cũng được chọn khá kỹ. Nhưng báo chí và nhiều nhà nghiên cứu tin rằng chỉ vài năm nữa bài toán dịch sẽ được giải xong.
Họ đã quá lạc quan. Cách làm thời đó gọi là dịch máy dựa trên quy tắc (rule-based machine translation): các nhà ngôn ngữ học và lập trình viên ngồi viết tay từ điển song ngữ cùng hàng loạt quy tắc kiểu “nếu danh từ đi sau tính từ thì đảo lại”, “nếu động từ ở thì quá khứ thì thêm đuôi này”.
Vì sao quy tắc viết tay không đủ?
Vấn đề là quy tắc nào cũng có ngoại lệ, và ngoại lệ thì nhiều vô kể. Mỗi lần thêm một quy tắc để sửa một lỗi, người ta lại tạo ra lỗi mới ở chỗ khác. Hệ thống phình to, khó bảo trì, và vẫn dịch cứng nhắc. Đến giữa thập niên 1960, một báo cáo đánh giá tại Mỹ (thường gọi là báo cáo ALPAC, năm 1966) kết luận dịch máy tiến bộ chậm hơn kỳ vọng nhiều, khiến kinh phí cho lĩnh vực này bị cắt giảm mạnh trong một thời gian dài.
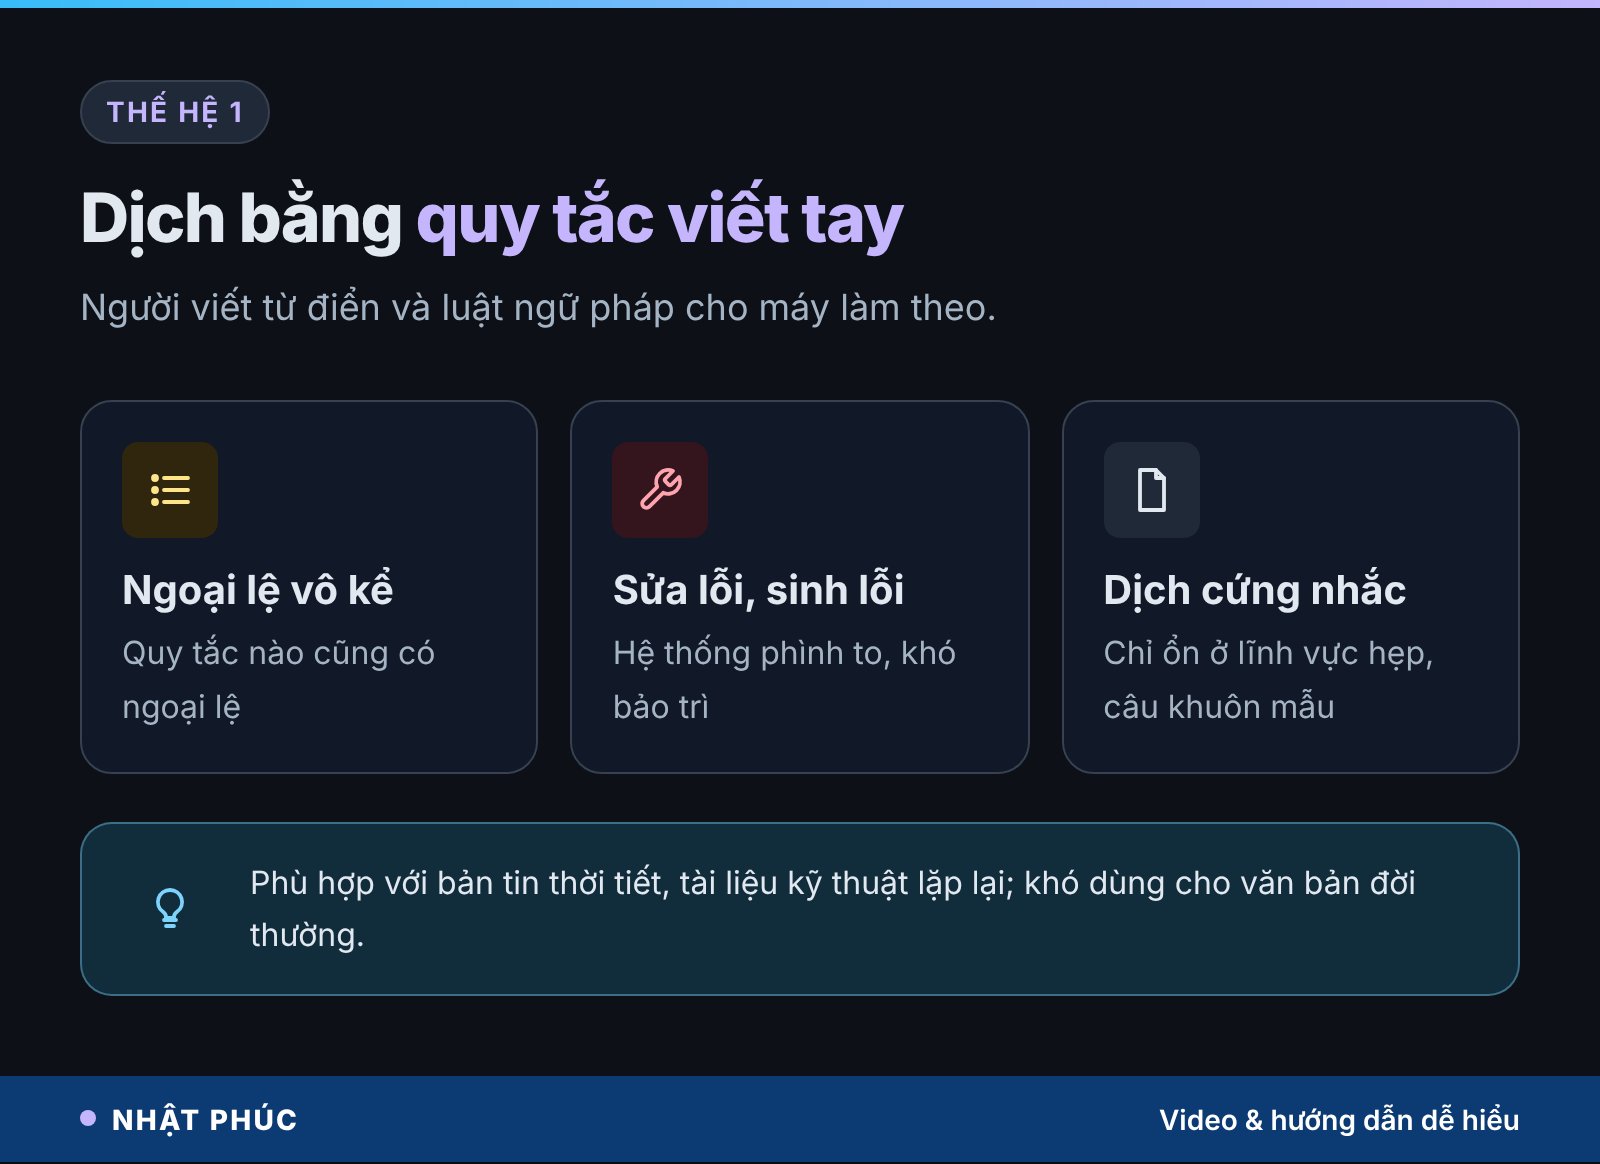
Dù vậy, dịch máy dựa trên quy tắc vẫn được dùng nhiều thập kỷ ở những lĩnh vực hẹp, nơi câu chữ lặp lại và có khuôn mẫu, chẳng hạn bản tin thời tiết hay tài liệu kỹ thuật. Ở đó, số ngoại lệ ít hơn nên quy tắc viết tay vẫn đủ dùng.
Dịch máy thống kê là gì?
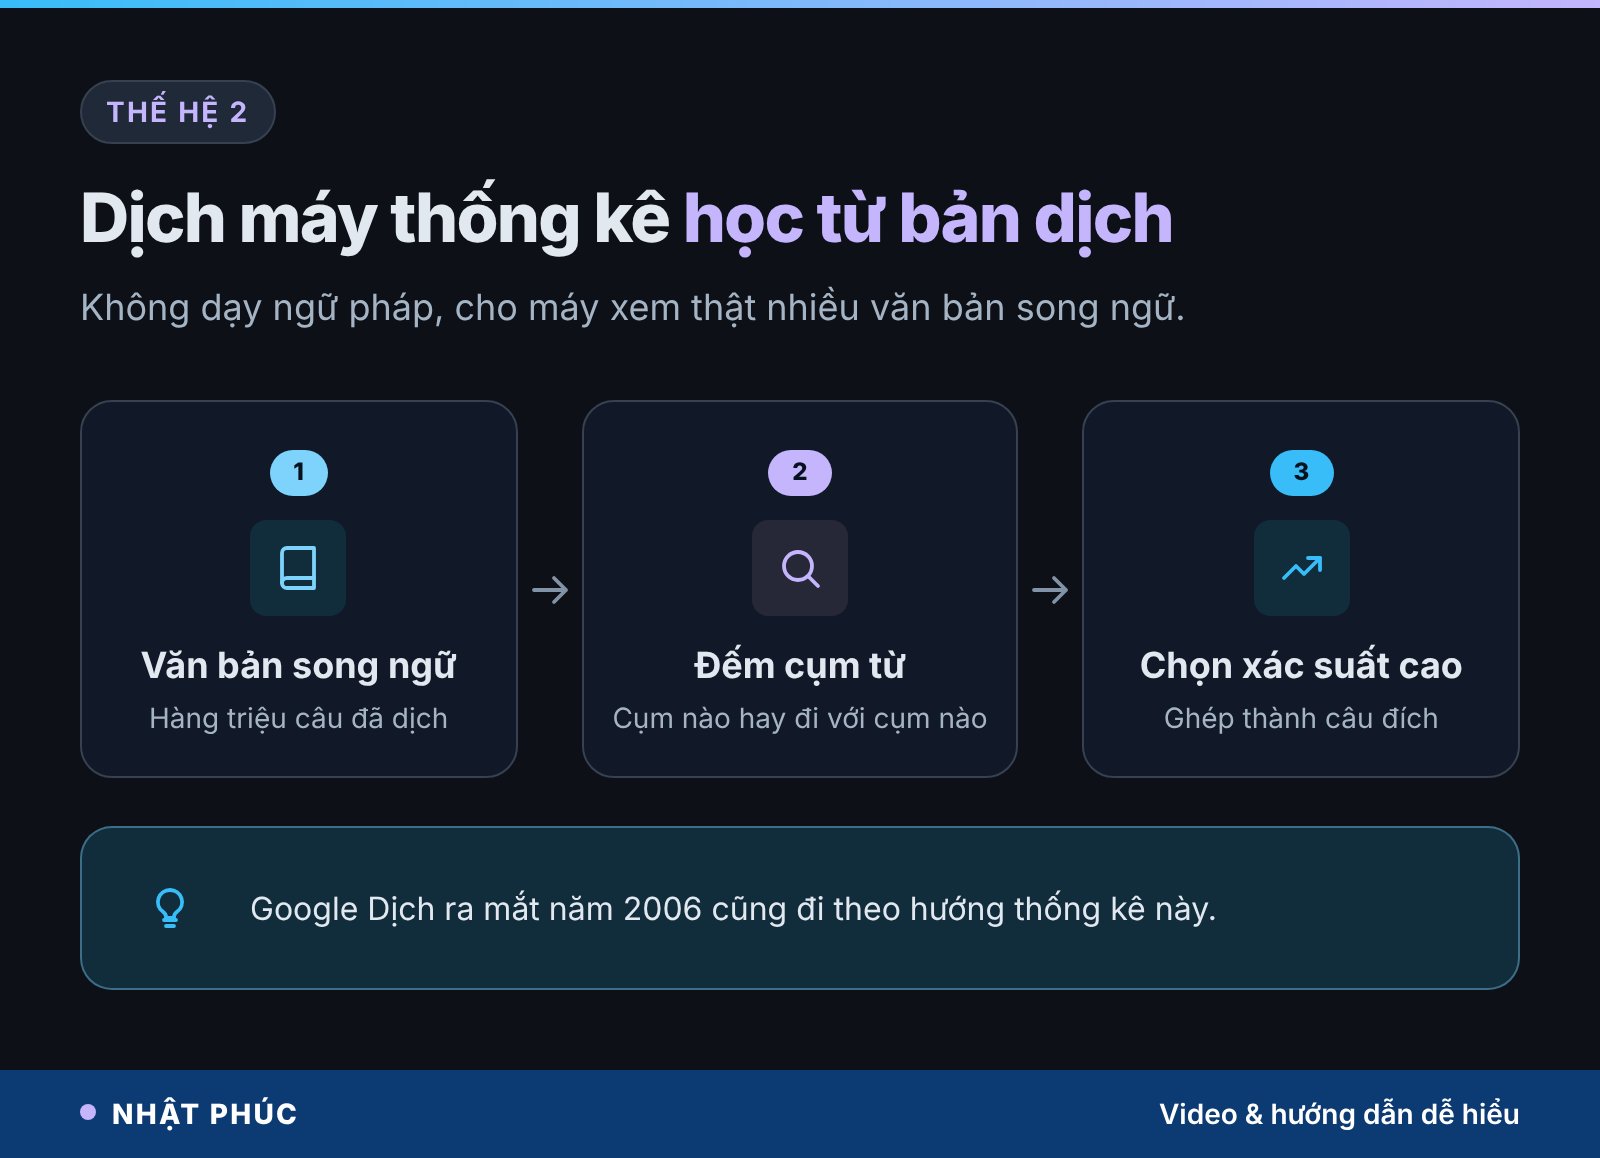
Vậy làm sao thoát khỏi mớ quy tắc ấy? Câu trả lời đến từ một hướng khác hẳn: đừng dạy máy ngữ pháp, hãy cho nó xem thật nhiều bản dịch có sẵn. Cách này gọi là dịch máy thống kê (statistical machine translation), phát triển mạnh từ khoảng cuối thập niên 1980 và thống trị suốt hai thập kỷ sau đó.
Hãy hình dung một người chưa biết tiếng Pháp, nhưng được đọc hàng triệu văn bản song ngữ, chẳng hạn tài liệu của các tổ chức quốc tế vốn được dịch song song ra nhiều thứ tiếng. Đọc mãi, người đó dần nhận ra: cụm tiếng Pháp này hay đi kèm cụm tiếng Anh kia. Không ai dạy ngữ pháp, nhưng họ vẫn đoán được cách dịch khá chuẩn.
Máy “đếm” như thế nào?
Máy cũng làm y như vậy, chỉ là ở quy mô khổng lồ. Nó đếm xem cụm từ nào thường ứng với cụm từ nào trong kho văn bản song ngữ, rồi khi gặp câu mới, nó ghép các mảnh dịch lại và chọn phương án có xác suất cao nhất. Đi kèm là một “mô hình ngôn ngữ” chấm điểm xem câu đích nghe có tự nhiên không.
Google Dịch ra mắt năm 2006 cũng đi theo hướng này. Ưu điểm lớn: muốn thêm một cặp ngôn ngữ mới, bạn không cần thuê chuyên gia viết quy tắc, chỉ cần đủ văn bản song ngữ.
Điểm yếu: chỉ nhìn từng mảnh
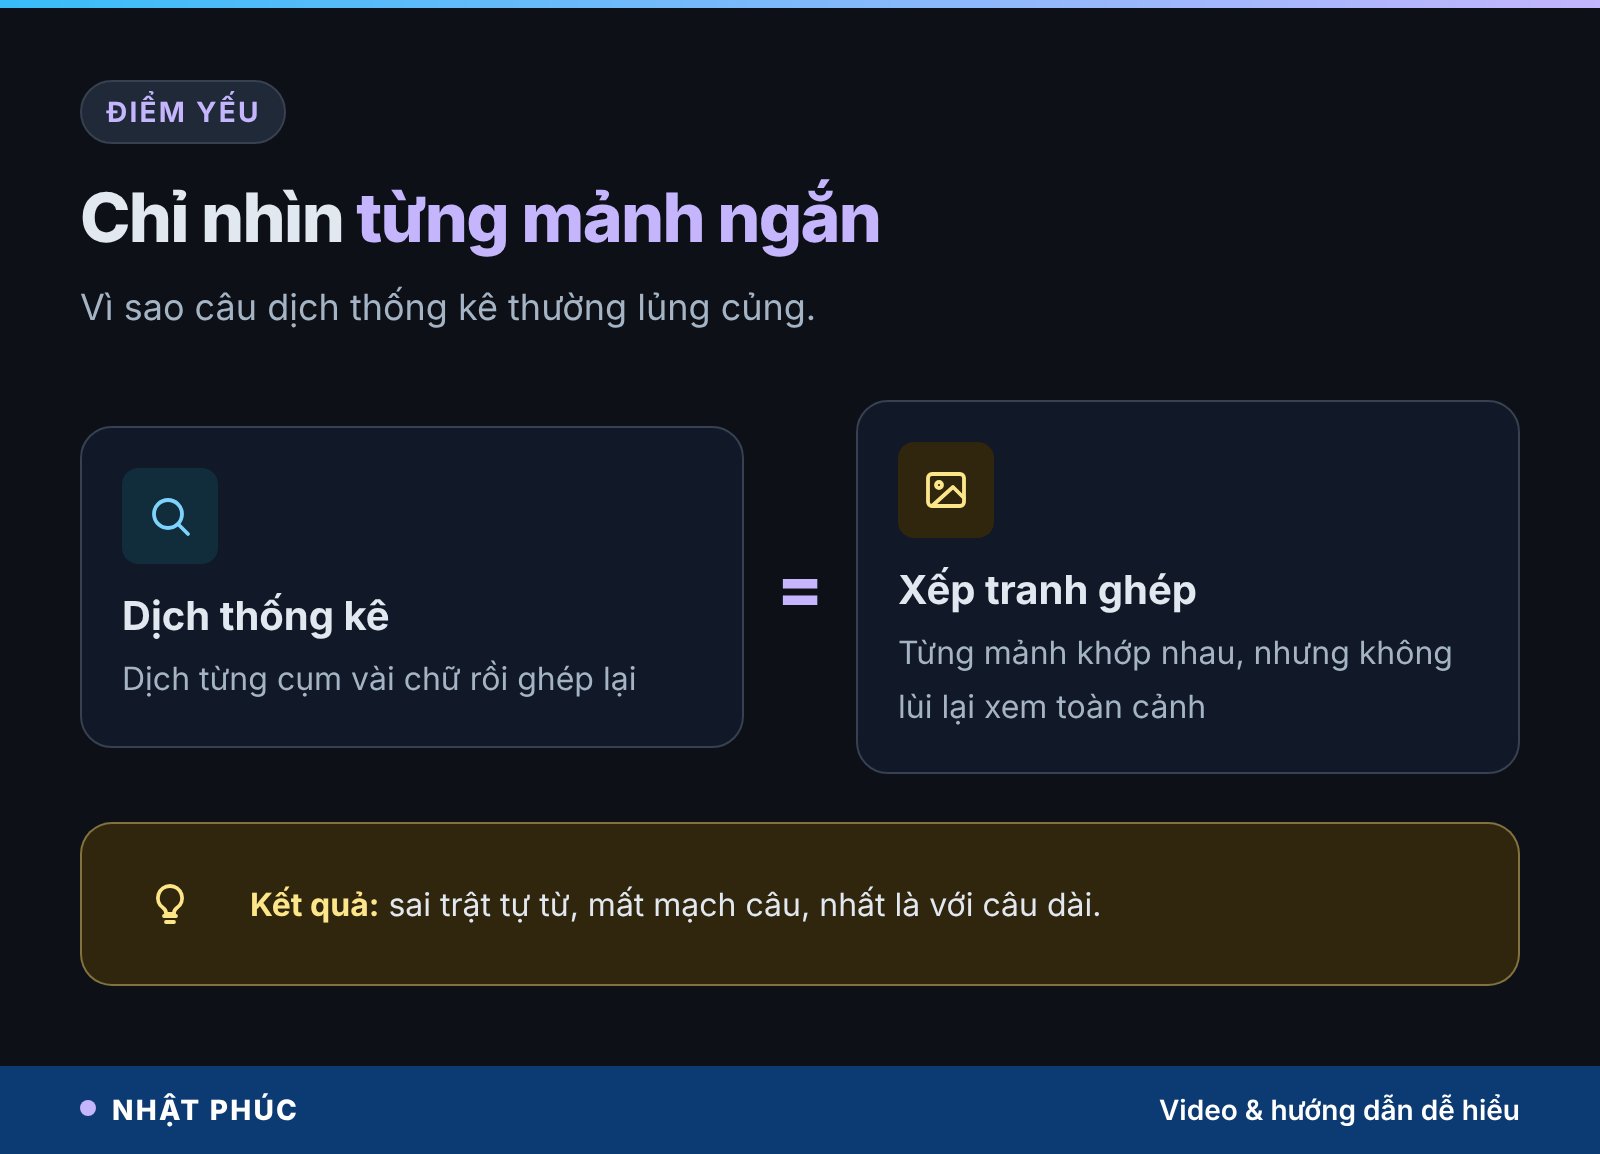
Nhưng cách đó có một điểm yếu cố hữu. Máy chỉ nhìn từng mảnh ngắn vài chữ, nên cả câu ghép lại thường lủng củng, sai trật tự, mất mạch. Giống như xếp một bức tranh ghép mà không bao giờ lùi ra xem toàn cảnh: từng mảnh khớp với mảnh bên cạnh, nhưng tổng thể thì méo.
Dịch máy bằng mạng nơ-ron hoạt động thế nào?
Bước ngoặt đến khi mạng nơ-ron bước vào cuộc chơi, khoảng giữa thập niên 2010. Cách làm này gọi là dịch máy bằng mạng nơ-ron (neural machine translation, viết tắt NMT). Thay vì đếm từng mảnh, nó làm hai việc nối tiếp nhau.
Bước 1: đọc cả câu và nén ý nghĩa
Phần thứ nhất, thường gọi là bộ mã hoá (encoder), đọc toàn bộ câu nguồn và nén ý nghĩa của nó thành một dãy con số. Bạn có thể hình dung dãy số này như một kiểu “bản đồ của ý”: những câu có ý gần nhau sẽ nằm gần nhau trên bản đồ, dù chữ khác nhau.
Bước 2: viết lại bằng ngôn ngữ đích
Phần thứ hai, bộ giải mã (decoder), dựa vào bản đồ ấy để viết ra câu mới bằng ngôn ngữ đích, từng chữ một. Mỗi chữ được chọn dựa trên ý nghĩa của câu nguồn và những chữ đã viết trước đó.
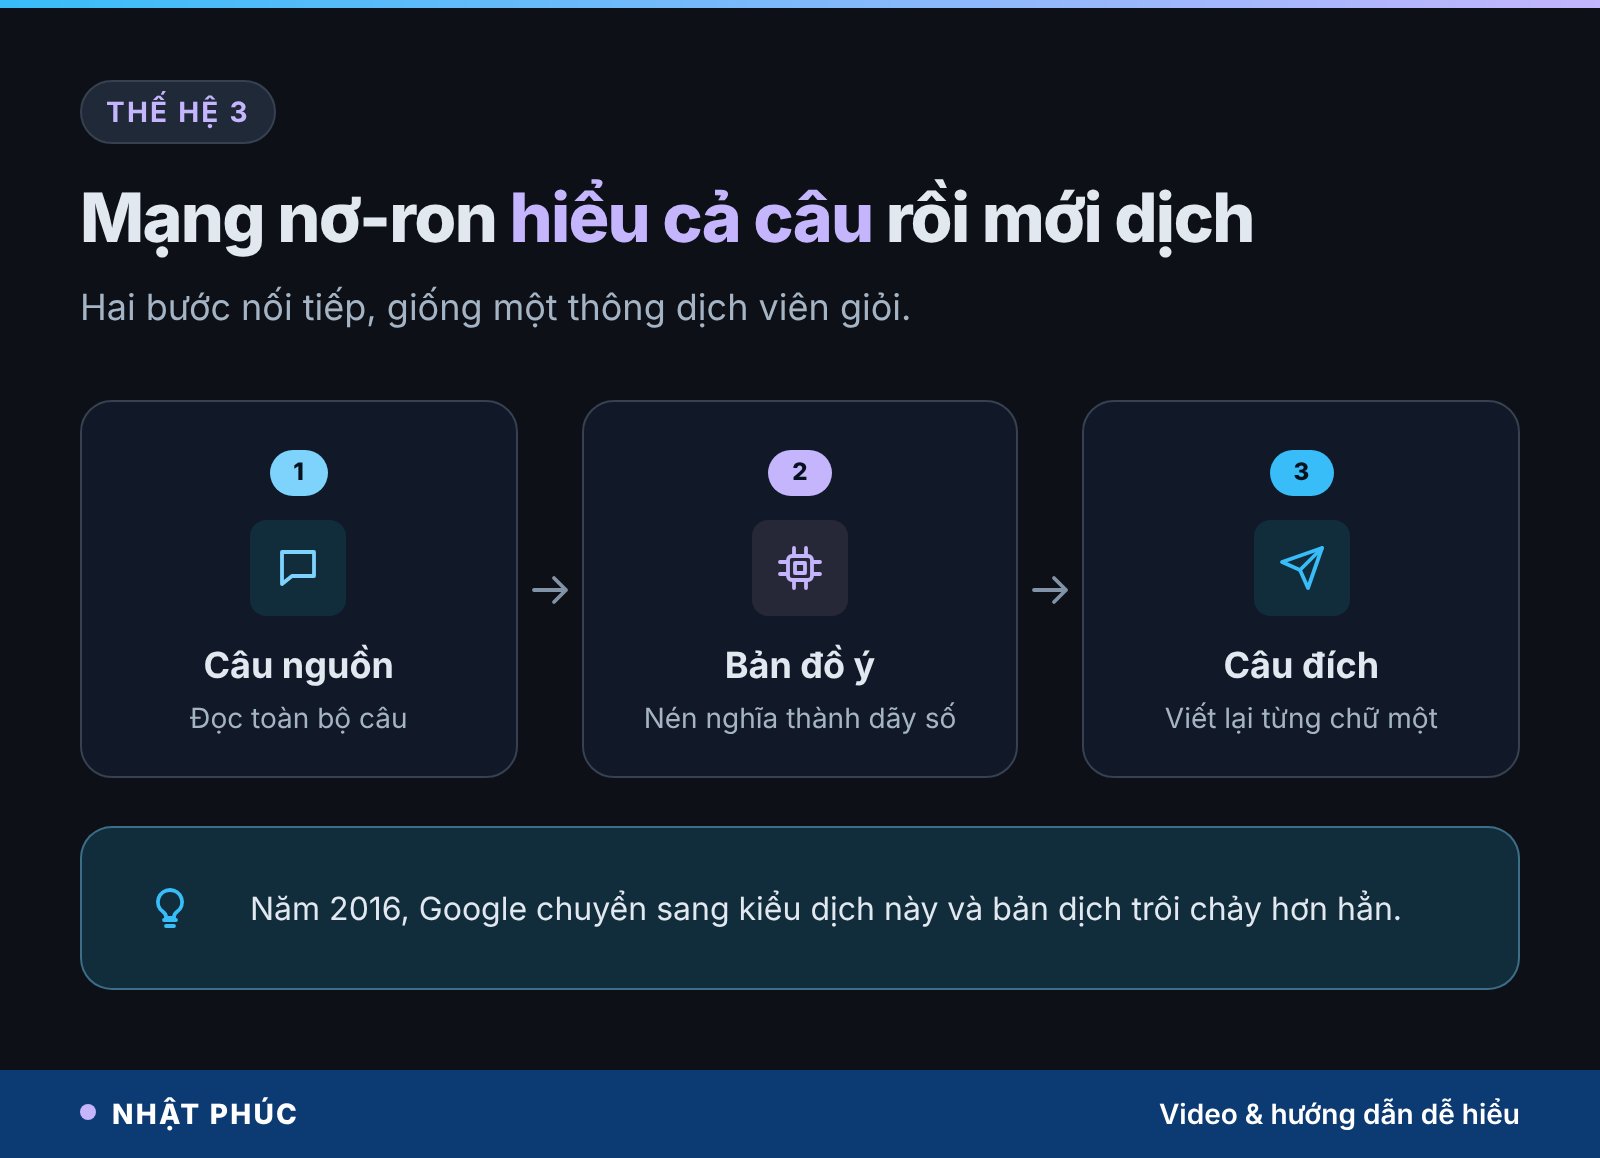
Hãy tưởng tượng một thông dịch viên giỏi: họ không dịch đuổi từng chữ khi bạn đang nói. Họ nghe hết đoạn, hiểu ý, rồi mới nói lại bằng lời của mình. Dịch máy bằng mạng nơ-ron cố gắng bắt chước đúng thói quen đó.
Năm 2016, Google chuyển dịch vụ dịch sang kiểu này và bản dịch trôi chảy hơn hẳn, đặc biệt ở trật tự từ và độ liền mạch của câu. Mạng nơ-ron cũng học từ văn bản song ngữ như dịch thống kê, nhưng thay vì ghi nhớ bảng xác suất cụm từ, nó tự điều chỉnh hàng triệu tham số bên trong để dịch ngày càng sát nghĩa hơn.
Transformer và cơ chế chú ý trong dịch máy
Thế hệ mạng nơ-ron dịch đầu tiên vẫn có một nút thắt: khi câu dài, việc nén cả câu vào một “bản đồ” duy nhất dễ làm rơi mất chi tiết. Cơ chế chú ý (attention) ra đời để giải quyết chuyện đó, và đến năm 2017, kiến trúc Transformer đưa cơ chế này thành trung tâm của toàn bộ mô hình.
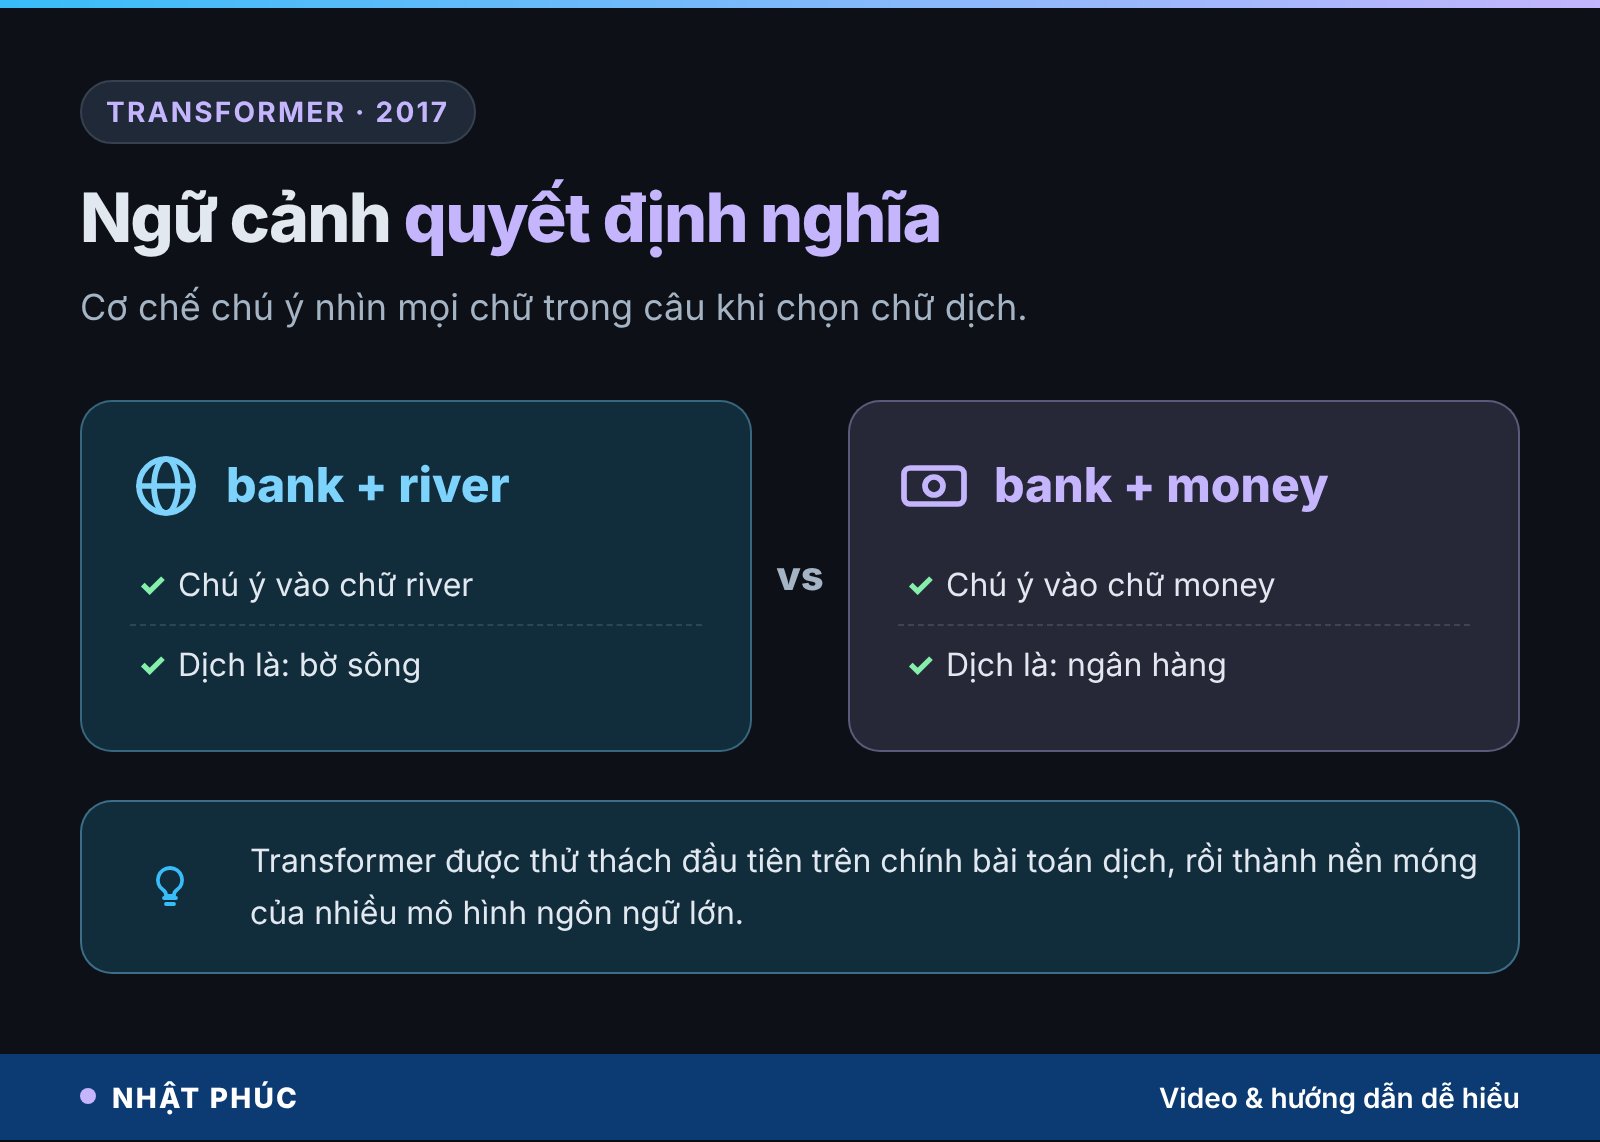
Điều thú vị là chính bài toán dịch là nơi Transformer được thử thách đầu tiên: bài báo giới thiệu nó đánh giá trên các tác vụ dịch Anh sang Đức và Anh sang Pháp. Sau đó, cùng kiến trúc này trở thành nền móng cho hầu hết các mô hình ngôn ngữ lớn ngày nay.
Cơ chế chú ý giúp hiểu ngữ cảnh ra sao?
Nhờ cơ chế chú ý, khi chọn từng chữ đầu ra, máy có thể “nhìn lại” mọi chữ trong câu nguồn và tự quyết định chữ nào quan trọng nhất lúc đó. Ví dụ quen thuộc là chữ bank: trong câu có chữ river, máy hiểu là bờ sông; trong câu có chữ money, máy hiểu là ngân hàng. Ngữ cảnh đã bắt đầu định nghĩa nghĩa của từ.
Kết quả là dịch máy hôm nay làm được những việc mà vài năm trước còn khó tin. Bạn hướng camera điện thoại vào tấm biển ở nước ngoài và chữ tự đổi thành tiếng Việt ngay trên màn hình. Bạn nói vào điện thoại và nghe lại câu dịch bằng giọng đọc. Rào cản ngôn ngữ đang mỏng đi rất nhanh.
So sánh ba thế hệ dịch máy
Nếu gom lại, lịch sử dịch máy có thể chia thành ba thế hệ chính. Mỗi thế hệ không xoá sổ hoàn toàn thế hệ trước, nhưng cách tiếp cận và chất lượng khác nhau rõ rệt.
| Thế hệ | Học từ đâu | Điểm mạnh | Điểm yếu |
|---|---|---|---|
| Dựa trên quy tắc (từ thập niên 1950) | Từ điển và quy tắc do người viết tay | Dễ kiểm soát trong lĩnh vực hẹp | Vô số ngoại lệ, dịch cứng nhắc |
| Thống kê (khoảng 1990–2016) | Văn bản song ngữ, đếm cụm từ | Mở rộng nhanh sang nhiều cặp ngôn ngữ | Nhìn từng mảnh, câu lủng củng |
| Mạng nơ-ron và Transformer (từ 2016) | Văn bản song ngữ, học ý nghĩa cả câu | Trôi chảy, hiểu ngữ cảnh tốt hơn | Có thể sai mà vẫn rất tự tin |
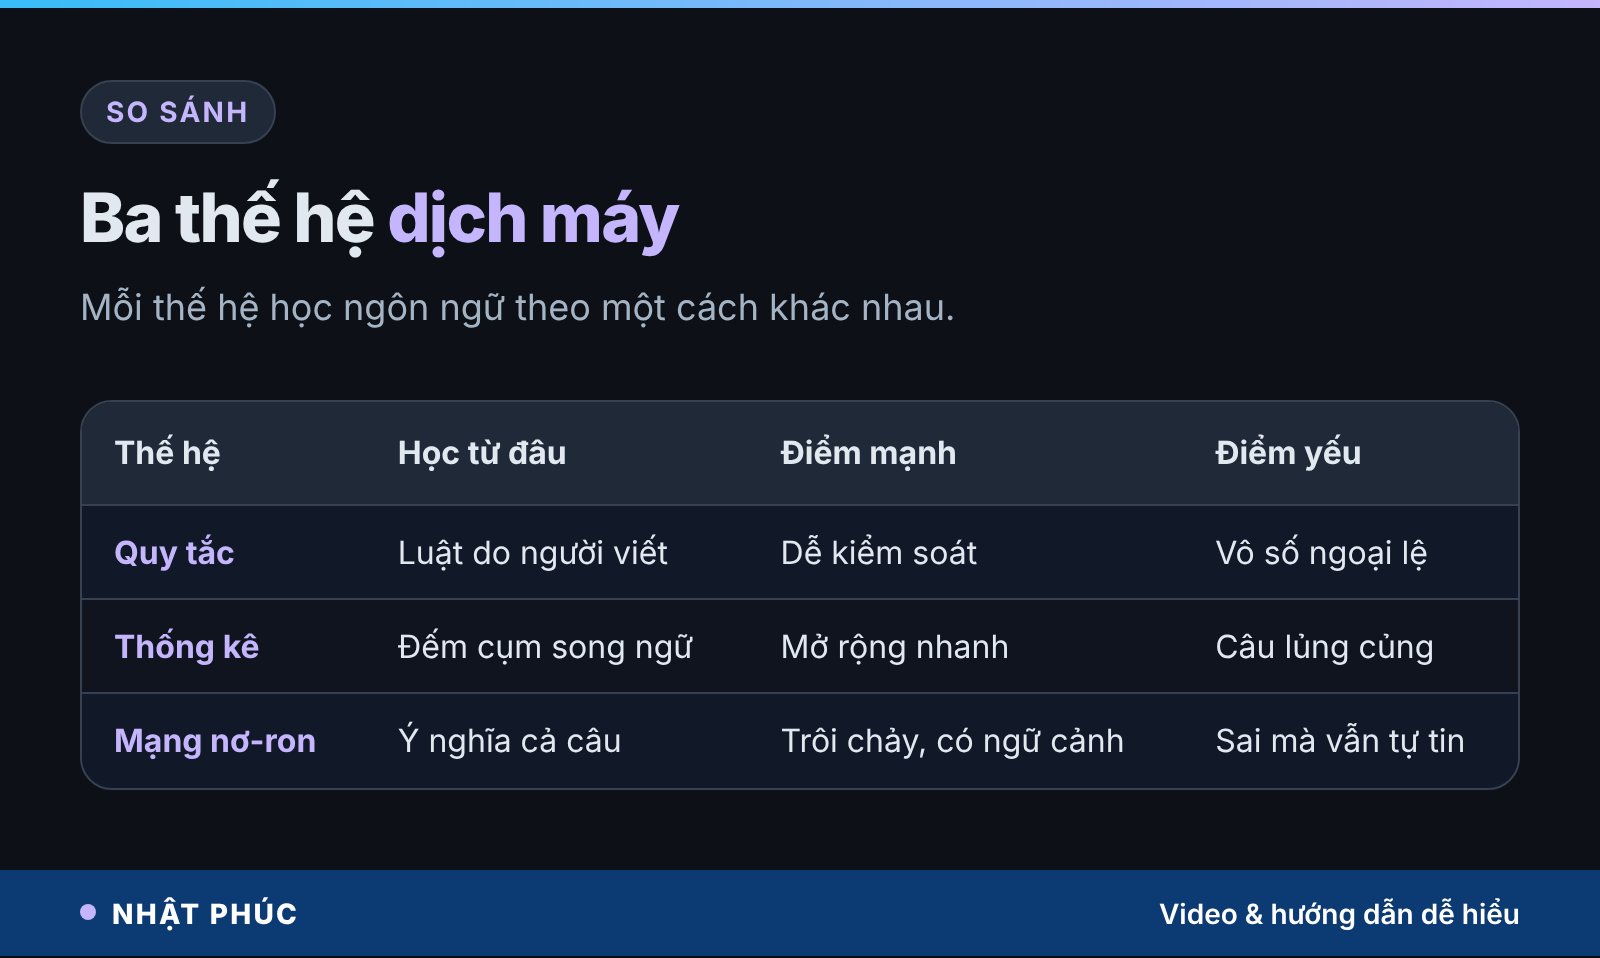
Điểm đáng chú ý nằm ở cột cuối. Thế hệ mới nhất dịch hay hơn hẳn, nhưng lỗi của nó cũng khó phát hiện hơn. Một câu lủng củng của dịch thống kê thì ai đọc cũng thấy sai. Còn một câu trôi chảy nhưng sai nghĩa của mạng nơ-ron thì có thể lọt qua mắt người đọc không biết ngôn ngữ gốc.
Giới hạn của dịch máy
Tuy tiến bộ rất nhanh, bạn đừng tin dịch máy tuyệt đối. Máy dịch vẫn học từ dữ liệu, nên chất lượng phụ thuộc trực tiếp vào lượng và chất của dữ liệu đó.
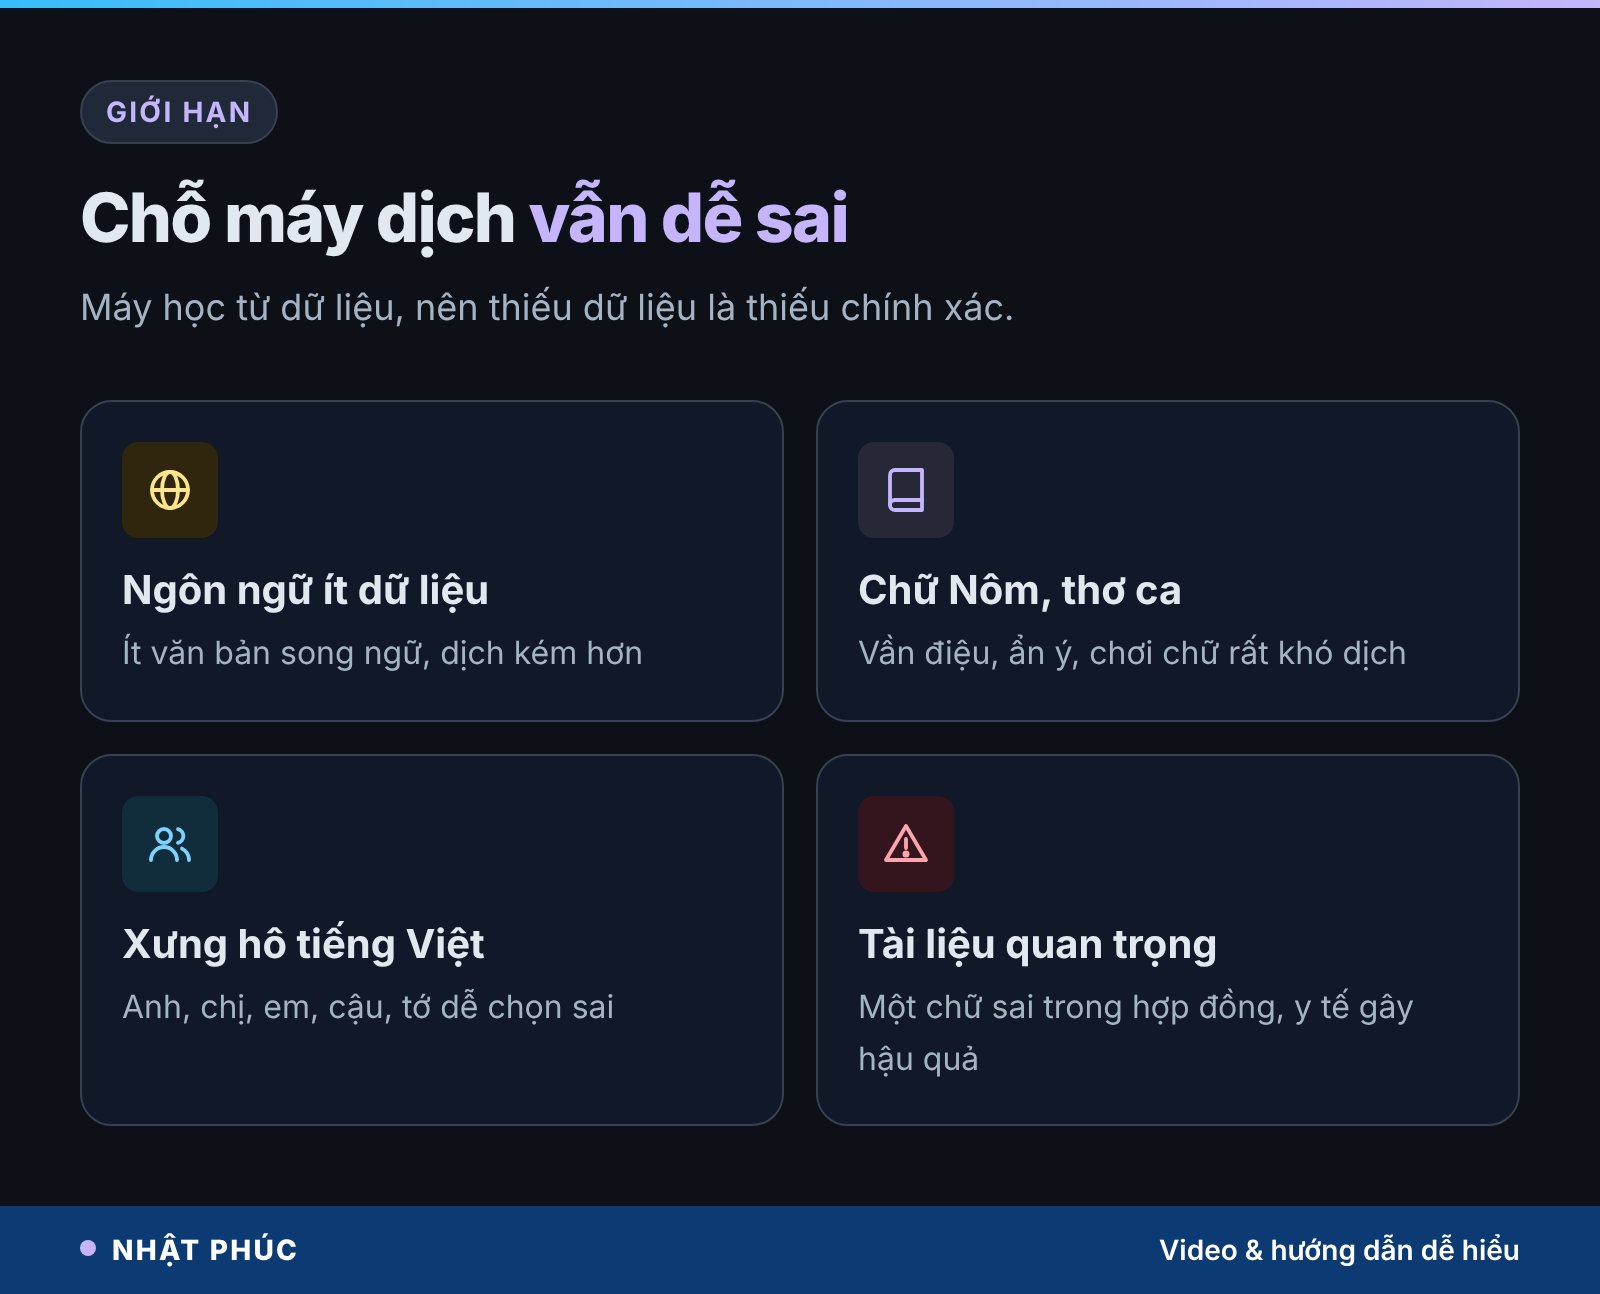
Ngôn ngữ ít dữ liệu dịch kém hơn
Những cặp ngôn ngữ có nhiều văn bản song ngữ, như Anh và Pháp, thường dịch rất tốt. Ngôn ngữ nào ít văn bản song ngữ thì máy có ít “bài mẫu” để học, nên dịch kém hơn nhiều. Nhiều hệ thống còn đi đường vòng qua tiếng Anh làm trung gian, khiến lỗi cộng dồn qua hai lần dịch.
Chữ Nôm, thơ ca và cách xưng hô tiếng Việt
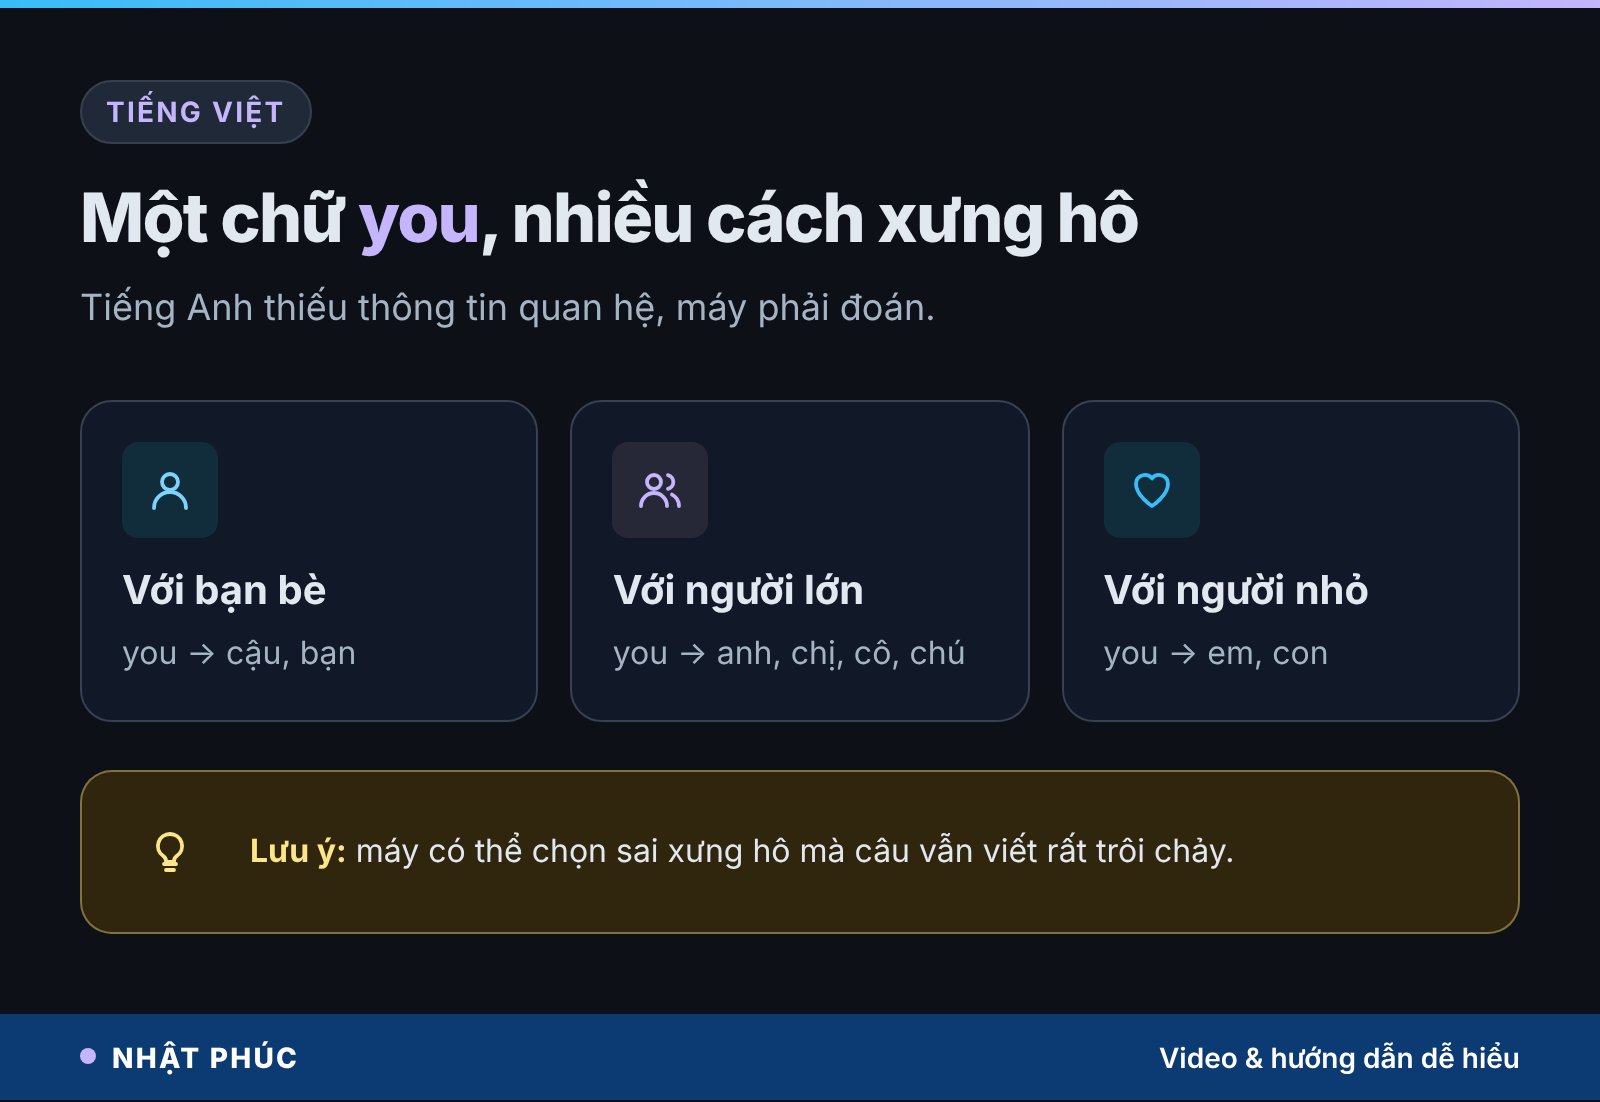
Văn bản cổ như chữ Nôm, thơ ca với vần điệu, ẩn ý, chơi chữ vẫn là thử thách rất lớn. Với tiếng Việt, cách xưng hô tinh tế như anh, chị, em, cậu, tớ, cô, chú là “cơn ác mộng” riêng. Tiếng Anh chỉ có “I” và “you”, nên khi dịch sang tiếng Việt, máy phải đoán quan hệ giữa hai người. Nó có thể chọn sai xưng hô mà câu vẫn viết rất trôi chảy.
Một chữ sai, hậu quả thật
Với hợp đồng, giấy tờ pháp lý hay tài liệu y tế, một chữ sai có thể gây hậu quả thật: hiểu sai điều khoản, sai liều dùng, sai hướng dẫn an toàn. Vì vậy, hãy luôn nhớ một nguyên tắc: bản dịch tự nhiên không đồng nghĩa với bản dịch đúng.
Những hiểu lầm phổ biến về dịch máy
Vì dịch máy ngày càng mượt, nhiều người bắt đầu gán cho nó những khả năng mà nó không có. Dưới đây là vài hiểu lầm hay gặp nhất.
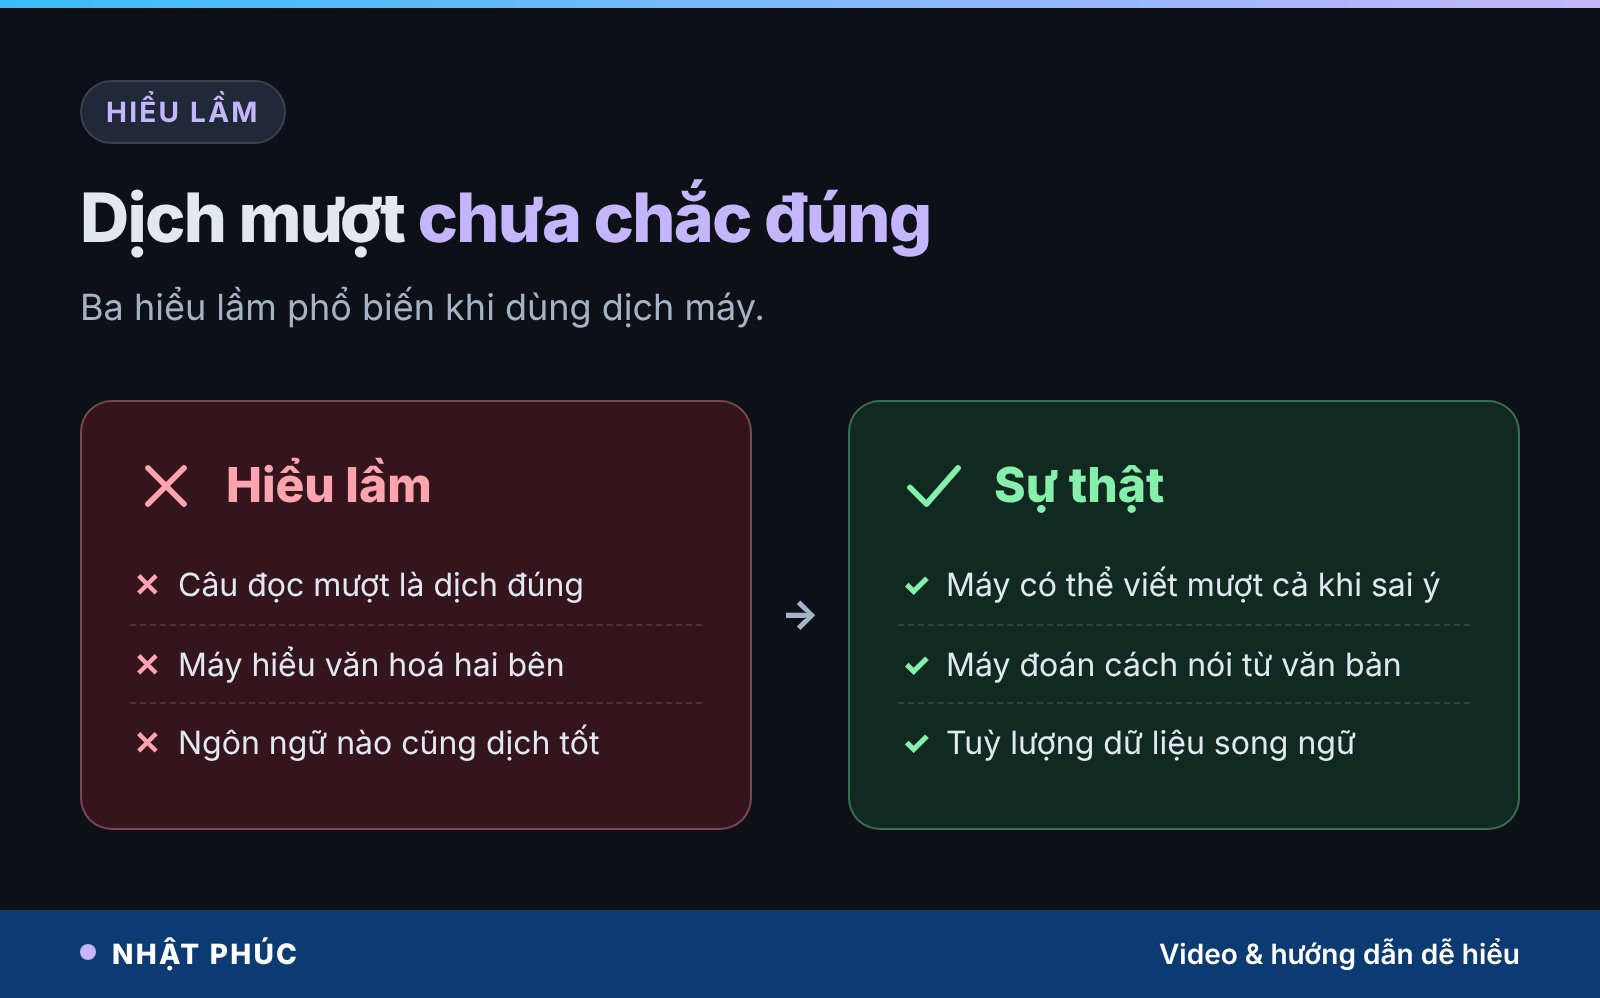
- “Câu dịch đọc mượt là dịch đúng.” Sai. Mạng nơ-ron được tối ưu để viết câu tự nhiên, nên nó có thể viết mượt cả khi hiểu sai ý gốc.
- “Máy dịch hiểu văn hoá hai bên.” Không hẳn. Nó là công cụ học từ khối văn bản khổng lồ để đoán cách con người nói cùng một ý bằng hai thứ tiếng, không phải người sống trong hai nền văn hoá.
- “Dịch máy rồi sẽ thay hoàn toàn người dịch.” Với việc cần hiểu nhanh, máy đã làm rất tốt. Nhưng với văn bản quan trọng, văn học, pháp lý, y tế, vai trò kiểm tra và chịu trách nhiệm của con người vẫn không thể thiếu.
- “Ngôn ngữ nào máy cũng dịch tốt như nhau.” Sai. Chất lượng chênh lệch rất lớn giữa các cặp ngôn ngữ, tuỳ lượng dữ liệu song ngữ có sẵn.
Cách dùng dịch máy hiệu quả và an toàn
Hiểu cách dịch máy hoạt động giúp bạn dùng nó thông minh hơn. Vài mẹo đơn giản dưới đây sẽ giúp bản dịch sát nghĩa hơn và tránh những lỗi đáng tiếc.
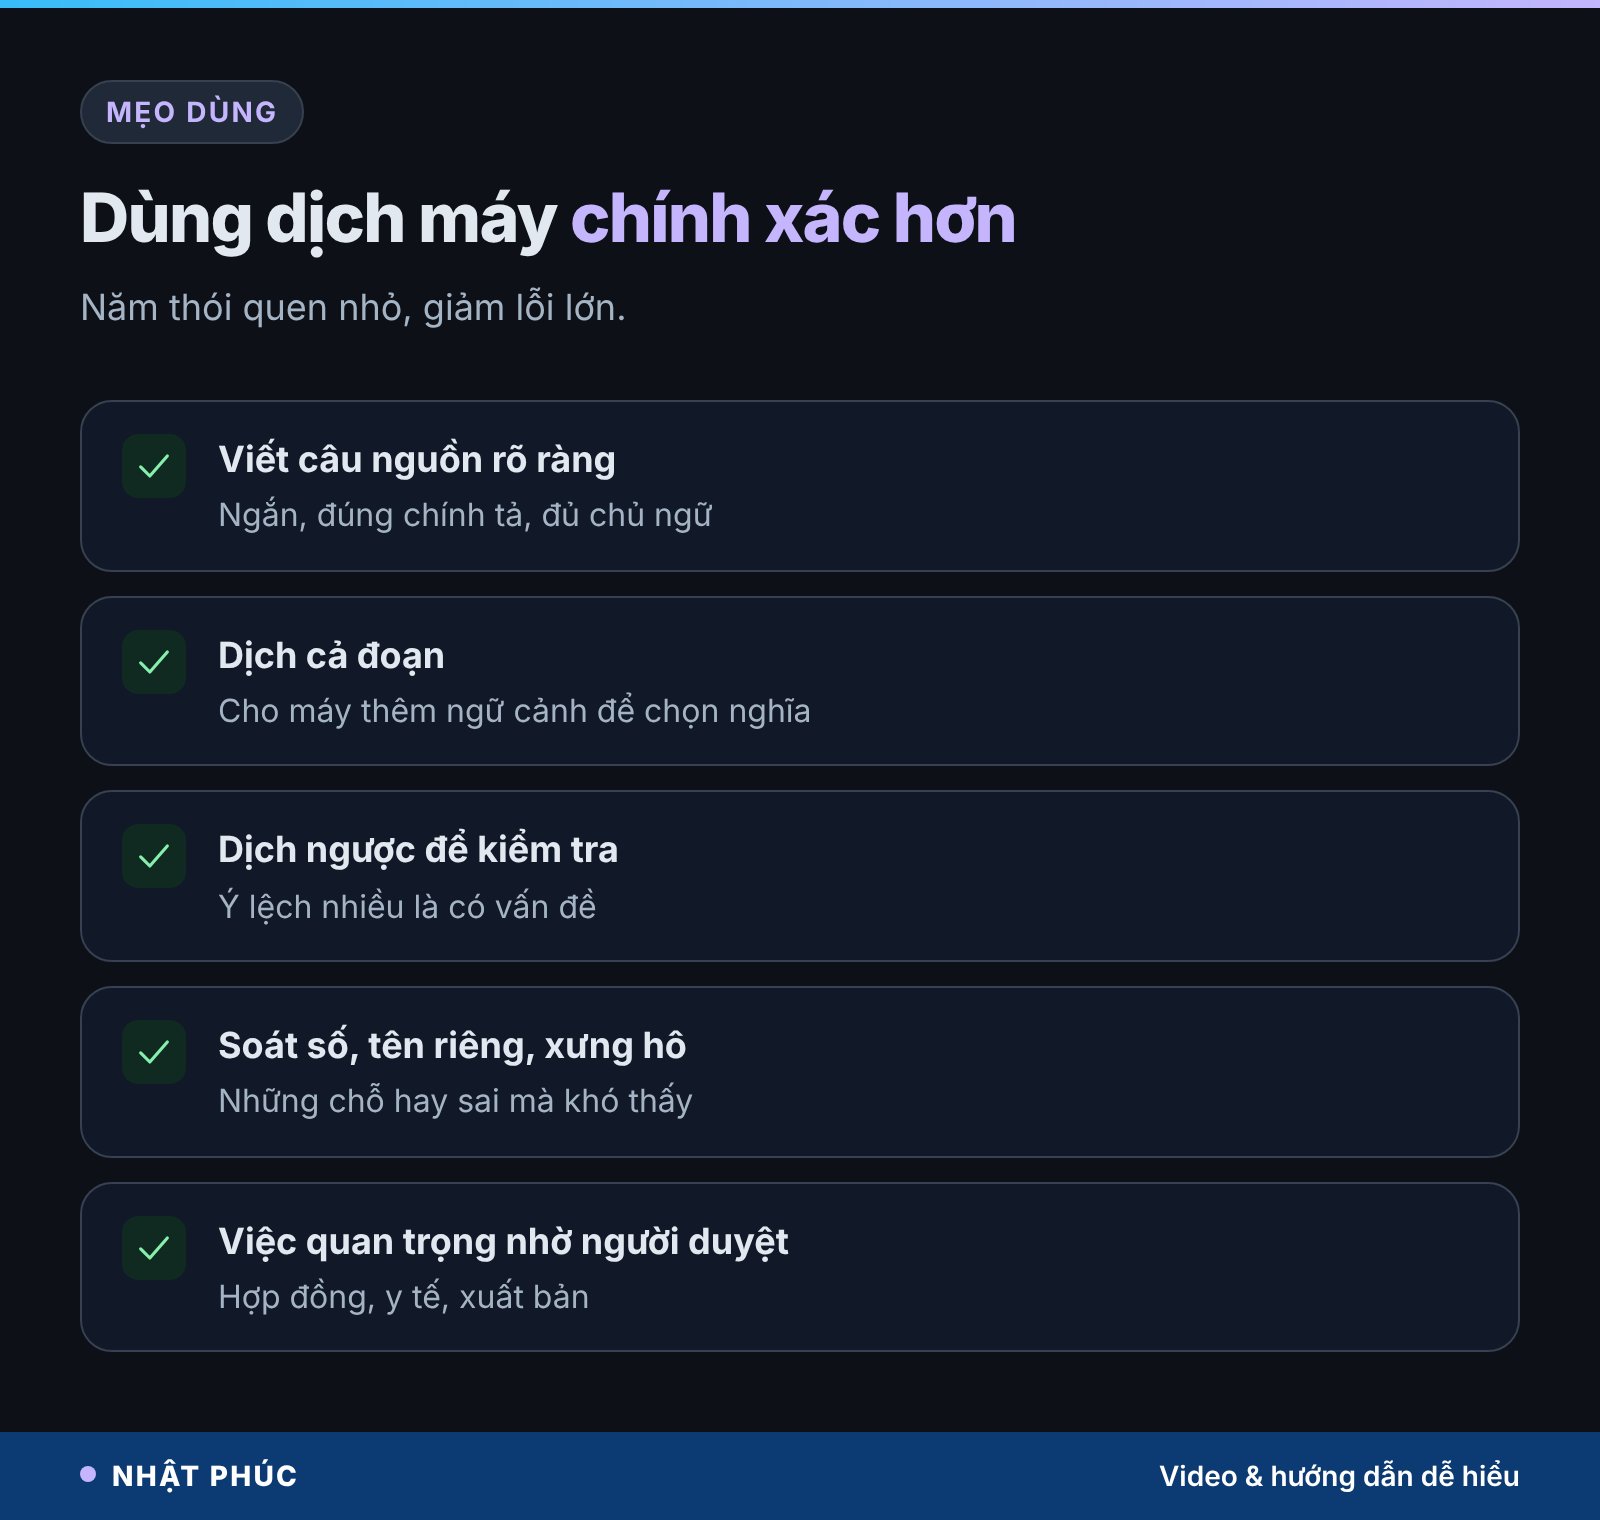
1. Viết câu nguồn rõ ràng, đủ chủ ngữ
Máy dịch tốt nhất khi câu nguồn ngắn gọn, đúng chính tả, có đủ chủ ngữ và vị ngữ. Tránh viết tắt, tiếng lóng hay câu dài nhiều mệnh đề. Câu tiếng Việt càng rõ ai làm gì, bản dịch càng ít phải đoán.
2. Đưa đủ ngữ cảnh
Vì cơ chế chú ý dựa vào ngữ cảnh, hãy dịch cả đoạn thay vì từng câu rời. Một chữ đứng một mình rất dễ bị hiểu sai nghĩa; đặt trong đoạn văn, máy có thêm manh mối để chọn nghĩa đúng.
3. Dịch ngược để kiểm tra
Dịch xong, hãy dịch ngược bản dịch về tiếng Việt. Nếu ý bị lệch nhiều, đó là dấu hiệu bản dịch có vấn đề. Cách này không đảm bảo đúng tuyệt đối, nhưng giúp phát hiện lỗi lớn rất nhanh.
4. Soát kỹ con số, tên riêng và xưng hô
Con số, ngày tháng, đơn vị, tên người, tên địa danh và cách xưng hô là những chỗ hay sai nhất mà khó nhận ra. Hãy đọc lại riêng những phần này, nhất là khi gửi cho người khác.
5. Việc quan trọng thì nhờ người kiểm tra
Hợp đồng, hồ sơ, tài liệu y tế hay nội dung xuất bản nên được người thạo cả hai ngôn ngữ đọc duyệt. Dịch máy giúp bạn có bản nháp nhanh, còn người kiểm tra giúp bạn yên tâm.
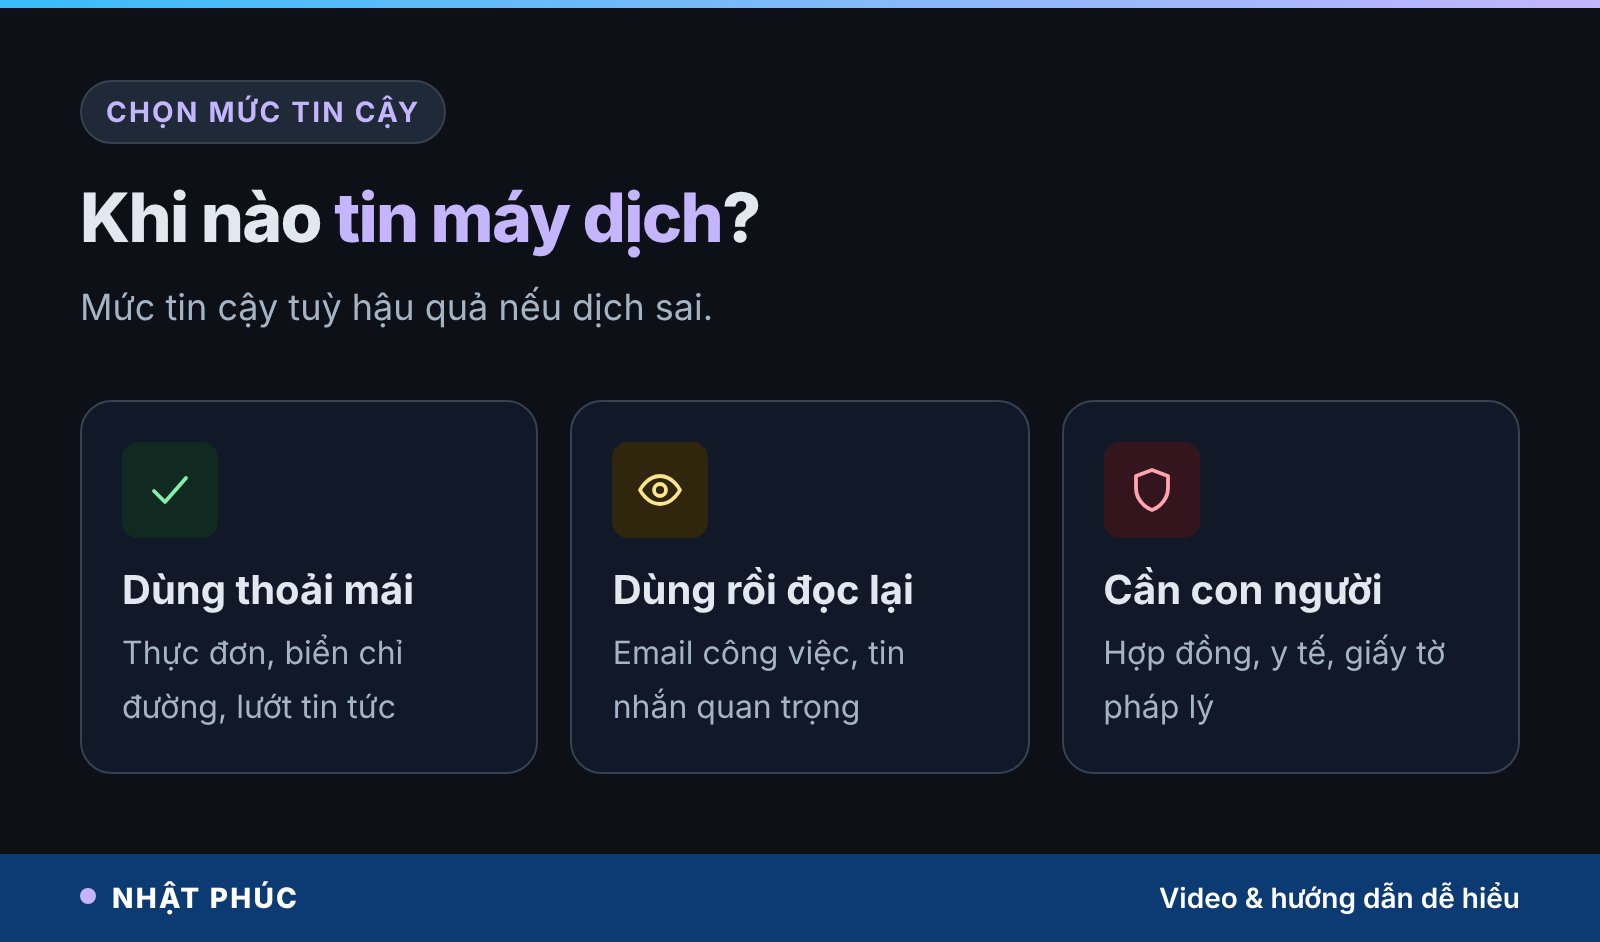
Một cách nghĩ dễ nhớ: hiểu nhanh thì cứ dùng máy thoải mái, như đọc thực đơn, biển chỉ đường hay lướt một bài báo nước ngoài. Gửi email công việc thì dùng máy rồi đọc lại. Còn việc có hậu quả pháp lý, sức khoẻ hay tiền bạc thì luôn cần con người.
Câu hỏi thường gặp về dịch máy
Google Dịch hoạt động theo nguyên lý nào?
Khi ra mắt năm 2006, Google Dịch dùng dịch máy thống kê, học từ văn bản song ngữ và chọn cụm từ có xác suất cao nhất. Từ năm 2016, Google chuyển sang dịch máy bằng mạng nơ-ron, đọc cả câu để nắm ý rồi viết lại bằng ngôn ngữ đích, nhờ đó bản dịch trôi chảy hơn nhiều.
Transformer liên quan gì đến dịch máy?
Transformer là kiến trúc mạng nơ-ron ra đời năm 2017, được thử nghiệm đầu tiên trên chính bài toán dịch. Nhờ cơ chế chú ý, nó nhìn được mọi chữ trong câu khi chọn từng chữ đầu ra, nên hiểu ngữ cảnh tốt hơn. Kiến trúc này sau đó trở thành nền tảng của nhiều mô hình ngôn ngữ lớn.
Vì sao máy dịch hay sai xưng hô tiếng Việt?
Nhiều ngôn ngữ như tiếng Anh chỉ có vài đại từ như “I” và “you”, trong khi tiếng Việt chọn xưng hô theo tuổi tác, quan hệ, mức độ thân mật. Câu gốc thường không chứa đủ thông tin đó, nên máy phải đoán. Nó có thể đoán sai mà câu vẫn rất trôi chảy.
Dịch máy có thay được người dịch không?
Với nhu cầu hiểu nhanh, dịch máy đã thay được phần lớn việc tra cứu thông thường. Nhưng với văn học, pháp lý, y tế hay nội dung cần sắc thái văn hoá, người dịch vẫn cần để kiểm tra, chỉnh giọng văn và chịu trách nhiệm về độ chính xác.
Làm sao biết bản dịch máy có đáng tin không?
Hãy dịch ngược về ngôn ngữ gốc để xem ý có giữ nguyên không, soát riêng con số, tên riêng và xưng hô, và thử với nhiều công cụ khác nhau. Nếu văn bản quan trọng, cách chắc chắn nhất vẫn là nhờ người thạo cả hai ngôn ngữ đọc lại.
Kết luận
Từ những ngày máy chỉ biết tra từng chữ rồi dịch cả “mưa mèo mưa chó”, dịch máy đã đi qua ba thế hệ: quy tắc viết tay, thống kê, rồi mạng nơ-ron với Transformer. Giờ đây nó đã biết rằng mưa to chỉ là mưa to. Nó không phải một người hiểu hai nền văn hoá, mà là công cụ học từ khối văn bản khổng lồ để đoán cách con người nói cùng một ý bằng hai thứ tiếng.
Hiểu nhanh thì tuyệt, việc quan trọng thì vẫn cần con người kiểm tra. Vì hiểu một câu và hiểu một con người vẫn là hai chuyện khác nhau.
Bạn từng gặp bản dịch máy nào dở khóc dở cười? Hãy kể ở phần bình luận, và theo dõi kênh Nhật Phúc để không bỏ lỡ những video giải thích công nghệ dễ hiểu tiếp theo.