Muốn dạy một chiếc xe tự lái nhận ra tài xế sắp lấn làn, bạn cần hàng chục nghìn khoảnh khắc ngay trước va chạm. Ngoài đời, không ai dám dàn dựng chừng ấy vụ tai nạn để quay phim. Vì vậy, nhiều nhóm nghiên cứu đã làm một việc nghe có vẻ lạ: mở một trò chơi điện tử thế giới mở, cho xe trong game đâm nhau, rồi dùng chính những khung hình đó để dạy AI. Cách làm này thuộc một lĩnh vực đang được nhắc đến rất nhiều: dữ liệu tổng hợp.
Câu trả lời ngắn: Dữ liệu tổng hợp (synthetic data) là dữ liệu do máy tính tạo ra, ví dụ ảnh dựng từ trò chơi hay phần mềm mô phỏng, thay vì thu thập từ đời thật. Nó giúp AI được luyện với tình huống hiếm và nguy hiểm, có sẵn nhãn chính xác và không chứa thông tin cá nhân, nhưng luôn phải kiểm tra lại bằng dữ liệu thật.
Bài viết này giải thích dữ liệu tổng hợp hoạt động thế nào, vì sao trò chơi điện tử lại trở thành phòng thí nghiệm an toàn giao thông, các nghiên cứu cụ thể đã làm được gì, giới hạn của cách làm này và những công cụ miễn phí bạn có thể thử.
Tóm tắt nhanh
- Dữ liệu tổng hợp là dữ liệu được máy tạo ra có chủ đích để huấn luyện hoặc kiểm tra AI.
- Ba lợi ích lớn: tạo được tình huống hiếm và nguy hiểm, nhãn có sẵn và chính xác tới từng điểm ảnh, không lộ thông tin cá nhân.
- Từ năm 2016, các nhà khoa học đã lấy ảnh từ một trò chơi thế giới mở để gán nhãn 25.000 ảnh đường phố cho AI thị giác máy tính.
- Gần đây, một số nhóm ở Đức, Hà Lan và Hàn Quốc dùng game để thử thiết bị cảnh báo cho người đi xe đạp và dạy AI nhận ra xe nguy hiểm.
- Phần lớn vẫn là nghiên cứu thử nghiệm: AI học từ thế giới ảo luôn cần được kiểm chứng trên đường thật.
Nội dung chính:
- Dữ liệu tổng hợp là gì?
- Vì sao AI cần dữ liệu tổng hợp?
- Vì sao trò chơi điện tử thành phòng thí nghiệm?
- Mốc 2016: lấy nhãn ảnh từ trò chơi
- Các nghiên cứu an toàn giao thông dùng game
- Khoảng cách giữa thế giới ảo và đường thật
- Hiểu lầm và rủi ro của dữ liệu tổng hợp
- Dữ liệu tổng hợp có ích gì ở Việt Nam?
- Tự thử tạo dữ liệu tổng hợp với công cụ miễn phí
- Câu hỏi thường gặp
Dữ liệu tổng hợp là gì?
AI hiện đại học bằng ví dụ. Muốn một mô hình nhận ra người đi bộ, bạn phải cho nó xem rất nhiều ảnh, và trong mỗi ảnh phải có người đánh dấu sẵn đâu là người, đâu là xe, đâu là vỉa hè. Phần đánh dấu đó gọi là nhãn (label). Ảnh kèm nhãn chính là “sách giáo khoa” của AI.
Dữ liệu tổng hợp là sách giáo khoa do máy tự soạn. Thay vì chụp ảnh ngoài đường rồi thuê người tô từng chiếc xe, ta dựng một cảnh 3D trong máy tính. Vì chính máy tính đặt từng vật thể vào cảnh, nó biết chính xác điểm ảnh nào thuộc chiếc xe nào, nên nhãn có sẵn ngay khi ảnh được vẽ ra.
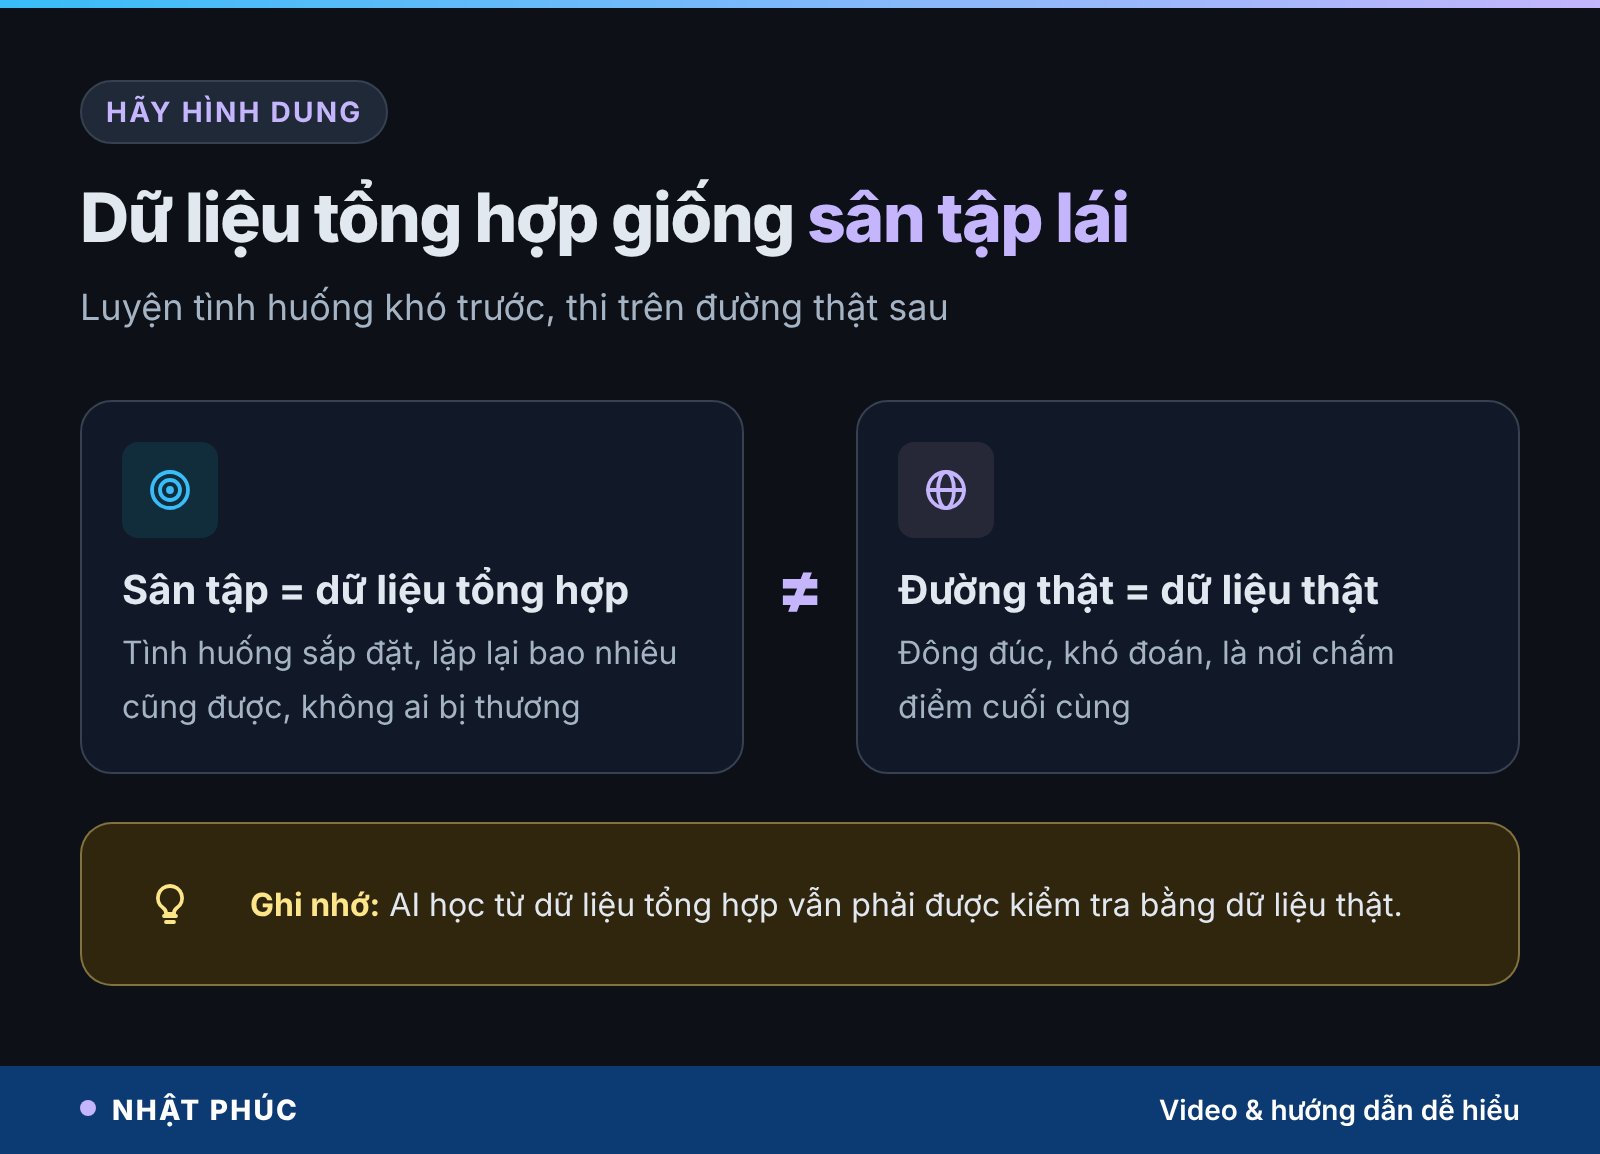
Hãy hình dung việc học lái xe máy. Đề thi thật là con đường giờ cao điểm. Nhưng trước đó, bạn luyện trong sân tập với vạch kẻ, cọc tiêu, tình huống được sắp đặt. Sân tập không thay được đường thật, nhưng giúp bạn luyện đi luyện lại những thao tác khó mà không gây nguy hiểm cho ai.
Dữ liệu tổng hợp có những dạng nào?
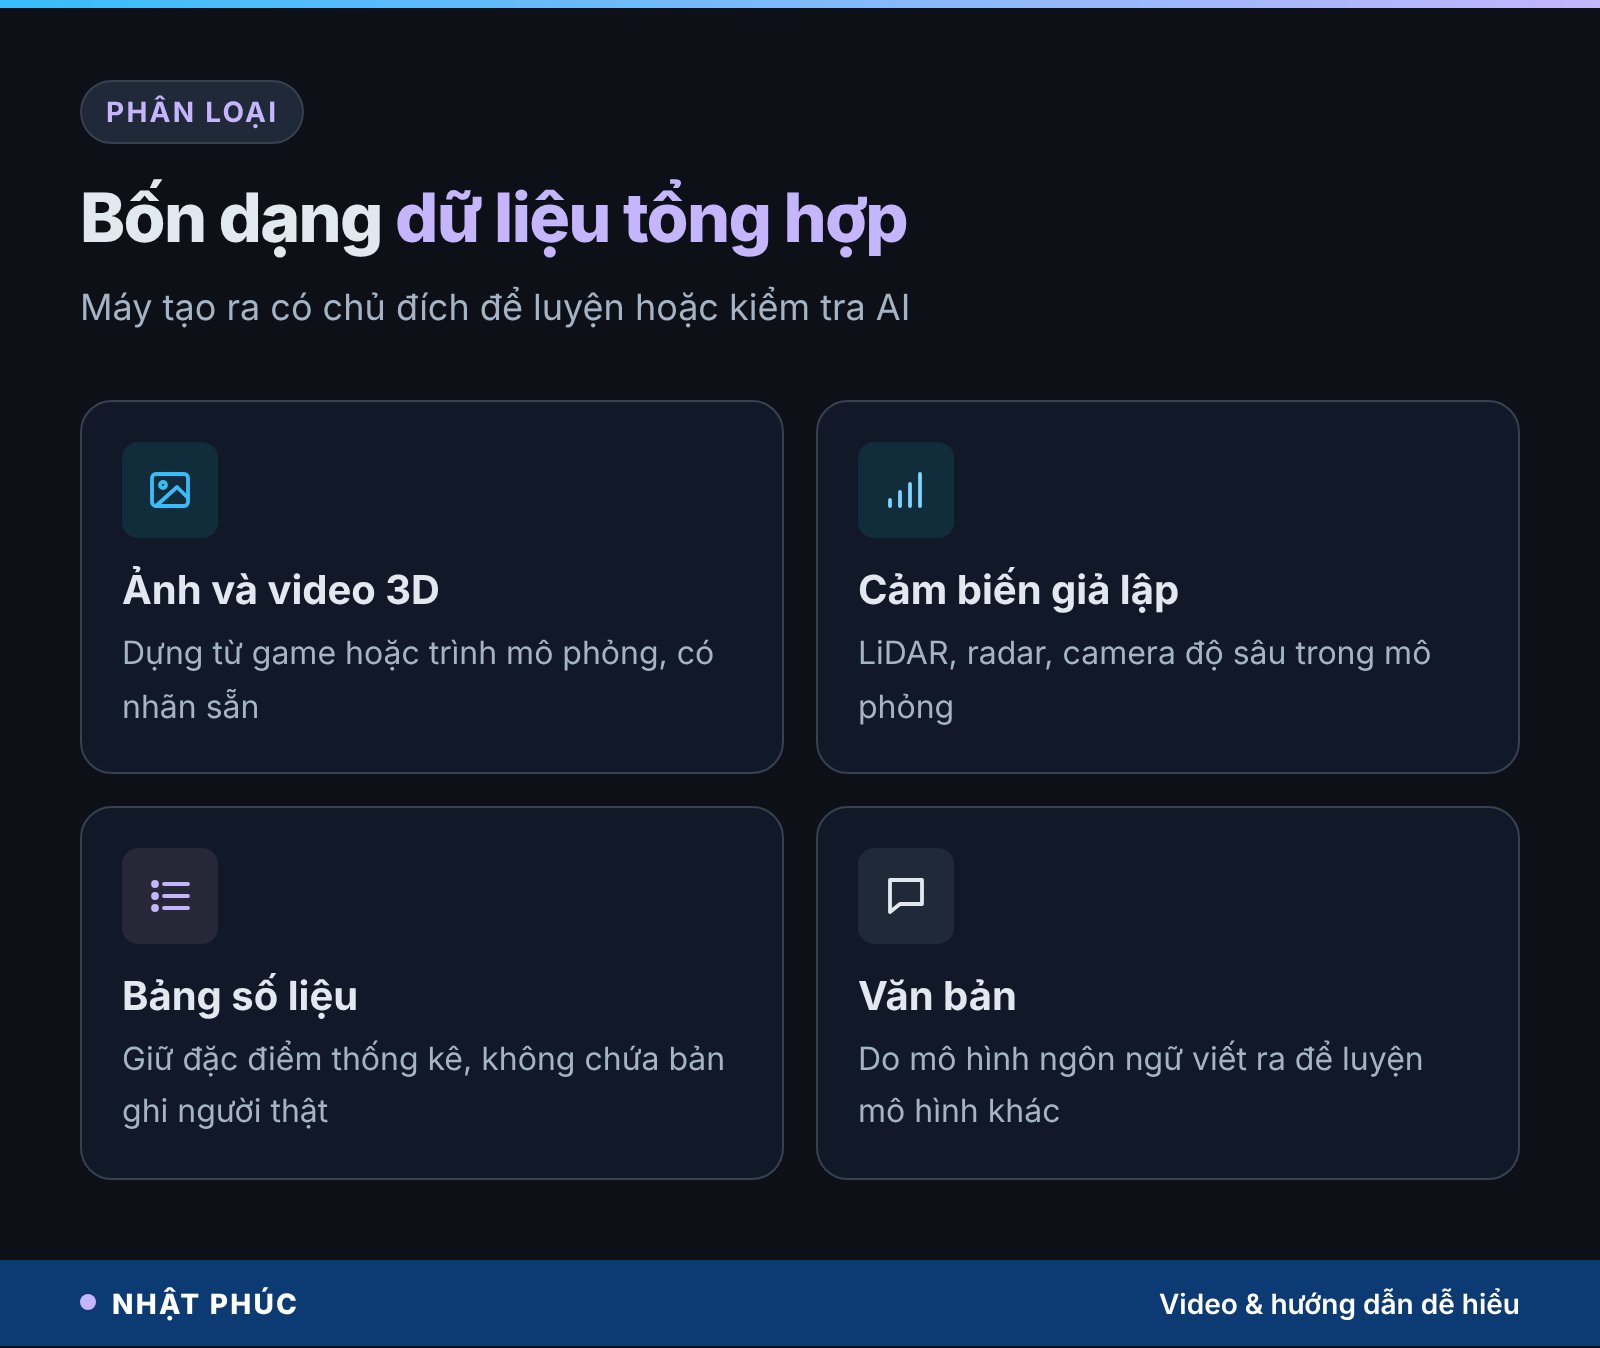
Không chỉ có ảnh. Dữ liệu tổng hợp có thể là ảnh và video dựng từ cảnh 3D, dữ liệu cảm biến giả lập như LiDAR hay radar, bảng số liệu được sinh ra để giữ đặc điểm thống kê mà không chứa bản ghi của người thật, hoặc văn bản do một mô hình ngôn ngữ viết ra để luyện mô hình khác. Bài này tập trung vào loại đầu tiên: hình ảnh từ thế giới ảo cho AI giao thông.
Vì sao AI cần dữ liệu tổng hợp?
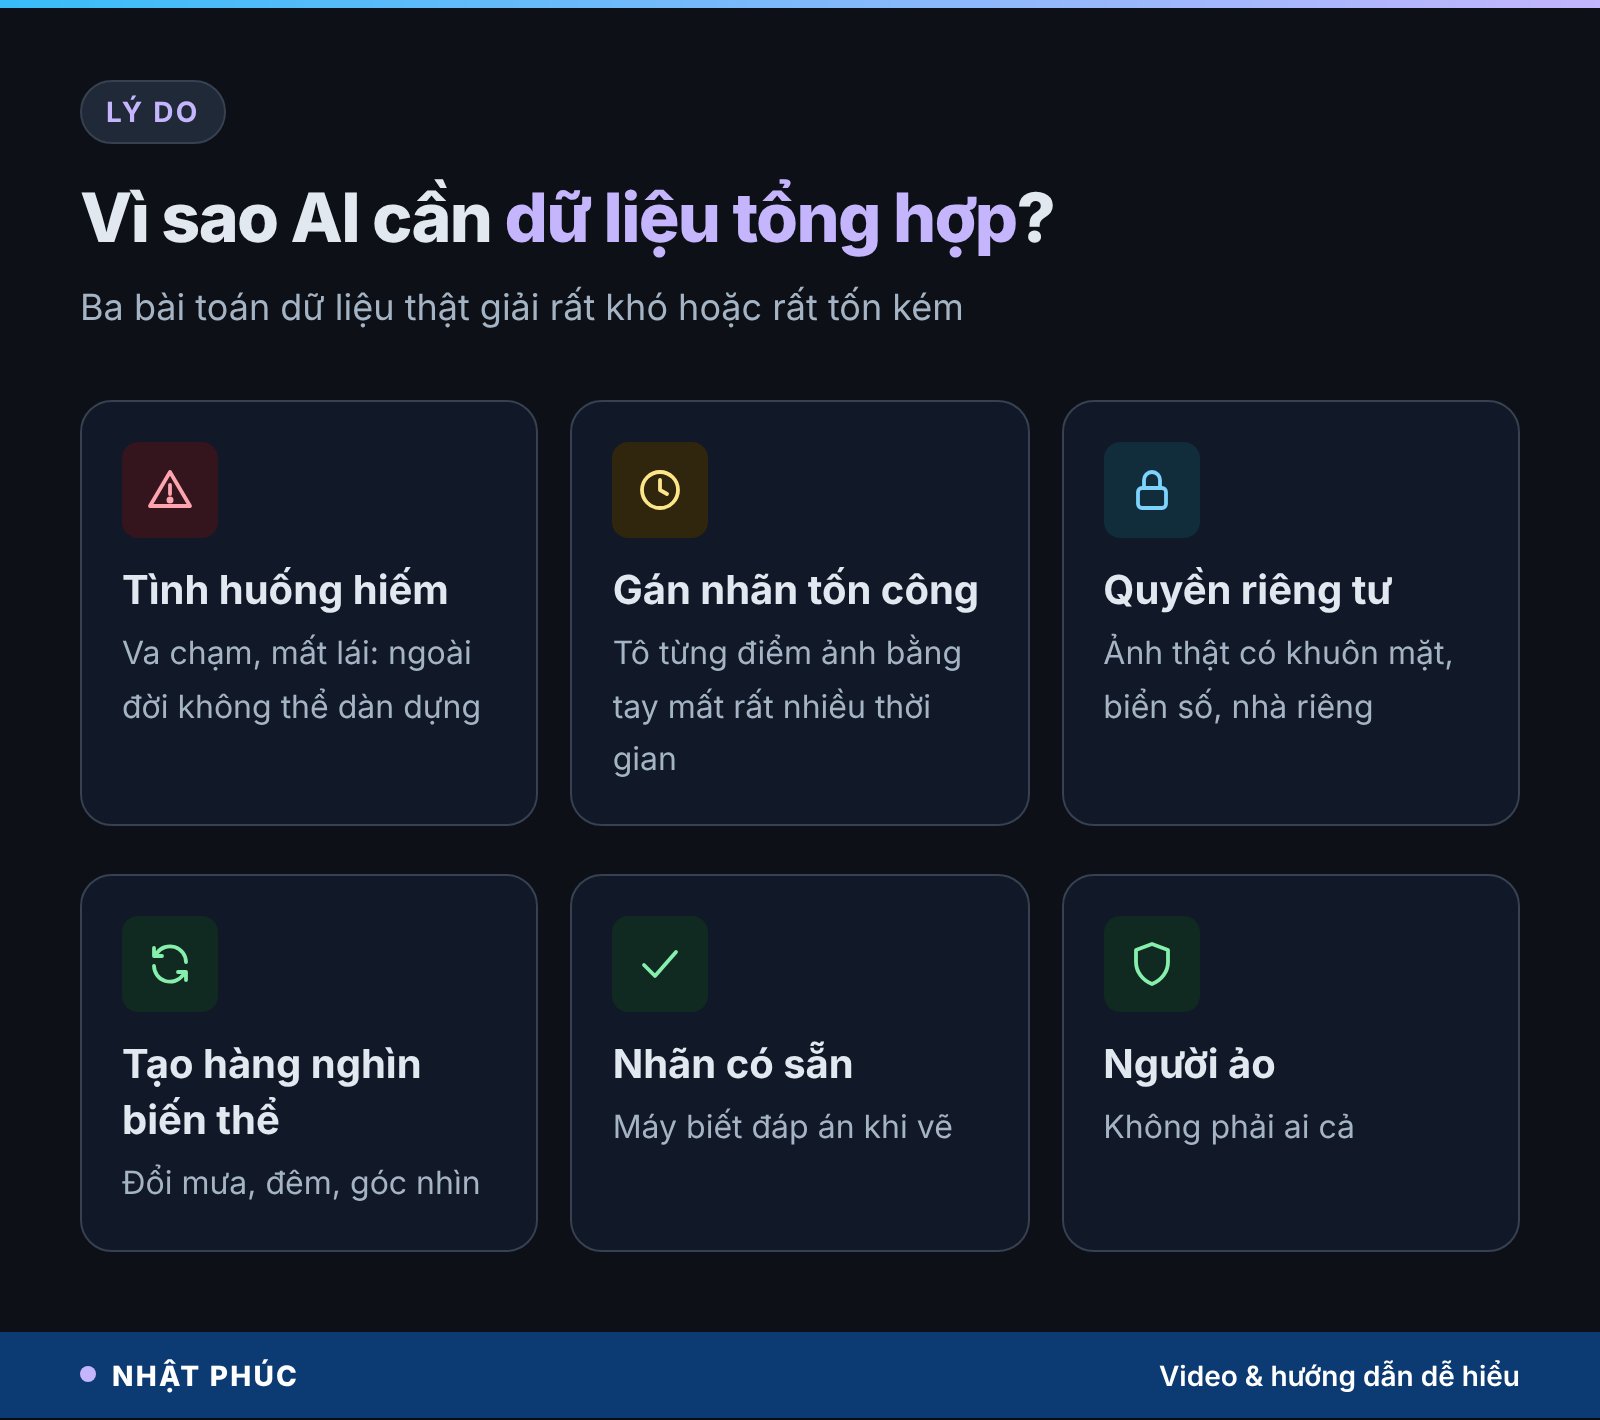
Nếu dữ liệu thật tốt hơn, tại sao không chỉ dùng dữ liệu thật? Vì có ba bài toán mà dữ liệu thật giải rất khó hoặc rất tốn kém.
1. Tình huống hiếm và nguy hiểm
Một chiếc xe có thể chạy hàng nghìn ki-lô-mét mà không gặp cảnh trẻ em chạy băng qua đường hay xe tải mất lái. Nhưng đó lại chính là những lúc AI phải phản ứng đúng nhất. Trong thế giới ảo, bạn có thể tạo hàng nghìn phiên bản của cùng một cảnh nguy hiểm, đổi trời mưa, đổi giờ tối, đổi góc nhìn, mà không ai bị thương.
2. Gán nhãn tốn công
Gán nhãn từng điểm ảnh (semantic segmentation) cho một bức ảnh đường phố có thể mất rất nhiều thời gian của người làm, vì phải tô tỉ mỉ quanh từng chiếc xe, cột điện, người đi bộ. Với ảnh tổng hợp, máy biết sẵn đáp án, nên nhãn vừa nhanh vừa chính xác.
3. Quyền riêng tư
Ảnh đường phố thật có khuôn mặt, biển số, nhà riêng. Muốn dùng phải làm mờ, xin phép, tuân thủ quy định bảo vệ dữ liệu cá nhân. Người và xe trong thế giới ảo không phải ai cả, nên rủi ro này giảm đi đáng kể.
Vì sao trò chơi điện tử thành phòng thí nghiệm?
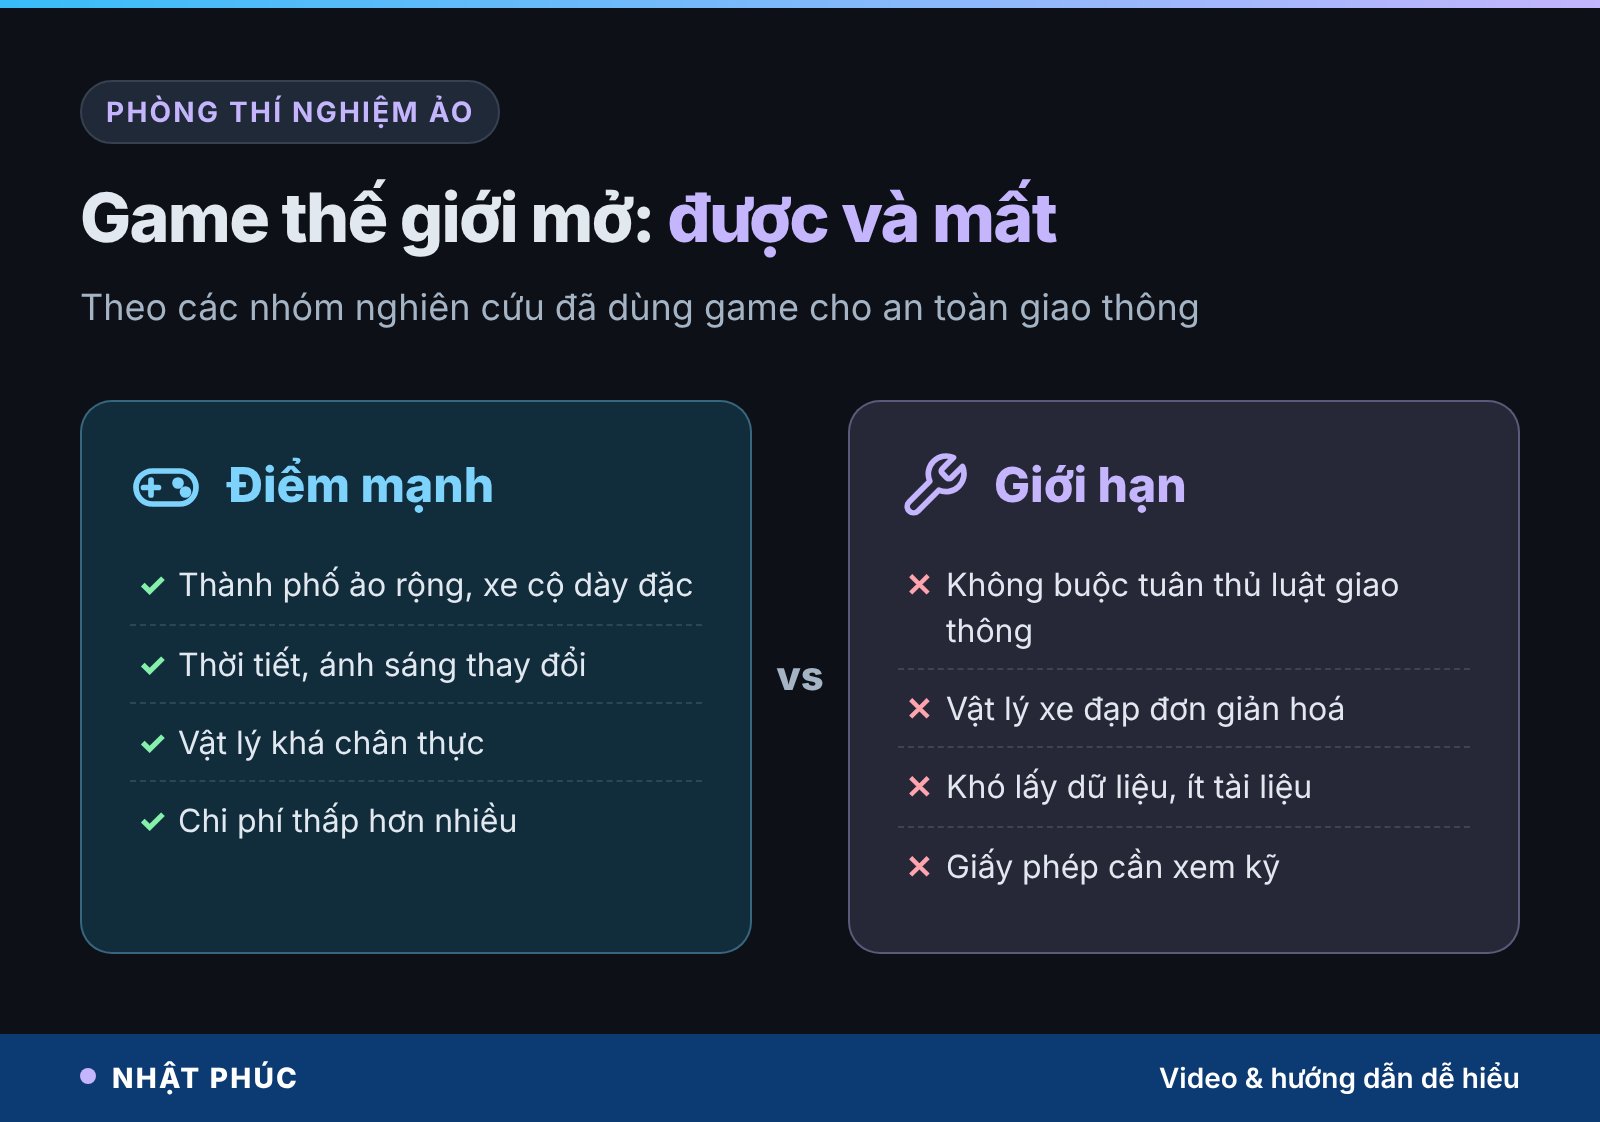
Phòng thí nghiệm lái xe chuyên nghiệp thường gồm cabin thật, màn hình bao quanh và phần mềm mô phỏng đắt tiền. Theo tường thuật của BBC Future, điểm hấp dẫn của trò chơi thế giới mở hiện đại là chúng đã có sẵn vật lý chân thực, thời tiết thay đổi và mạng lưới giao thông dày đặc, nên trở thành một môi trường thử nghiệm dựng sẵn với chi phí chỉ bằng một phần nhỏ so với hệ thống mô phỏng chuyên dụng.
Trò chơi được nhắc đến nhiều nhất là Grand Theft Auto V, một game hành động thế giới mở ra mắt năm 2013 với thành phố giả tưởng rộng lớn, xe cộ và người đi đường tự di chuyển. Bạn có thể nghĩ về nó như một “mô hình thành phố thu nhỏ” có sẵn hàng trăm loại xe, đèn đường, ngã tư và người đi bộ.
Tuy vậy, game giải trí không được làm ra cho khoa học. Theo chính nhóm nghiên cứu ở Đức dùng game này, trong trò chơi người chơi không bị buộc tuân thủ luật giao thông, tương tác giữa các bên tham gia giao thông còn hạn chế, vật lý xe đạp được đơn giản hoá và môi trường viết kịch bản (script) ít tài liệu. Đó là lý do giới nghiên cứu còn phát triển các trình mô phỏng mã nguồn mở chuyên cho xe tự lái.
| Tiêu chí | Trò chơi thương mại | Trình mô phỏng mã nguồn mở | Hệ thống mô phỏng chuyên dụng |
|---|---|---|---|
| Chi phí | Thấp, giá một bản game | Miễn phí phần mềm, cần máy mạnh | Cao |
| Độ chân thực đồ hoạ | Cao | Khá đến cao | Tuỳ hệ thống |
| Can thiệp, lấy dữ liệu | Khó, phải cài bản sửa đổi | Dễ, có API lập trình | Có, theo nhà cung cấp |
| Giấy phép dùng nghiên cứu | Cần xem kỹ điều khoản | Rõ ràng (ví dụ giấy phép MIT) | Theo hợp đồng |
Mốc 2016: lấy nhãn ảnh từ trò chơi
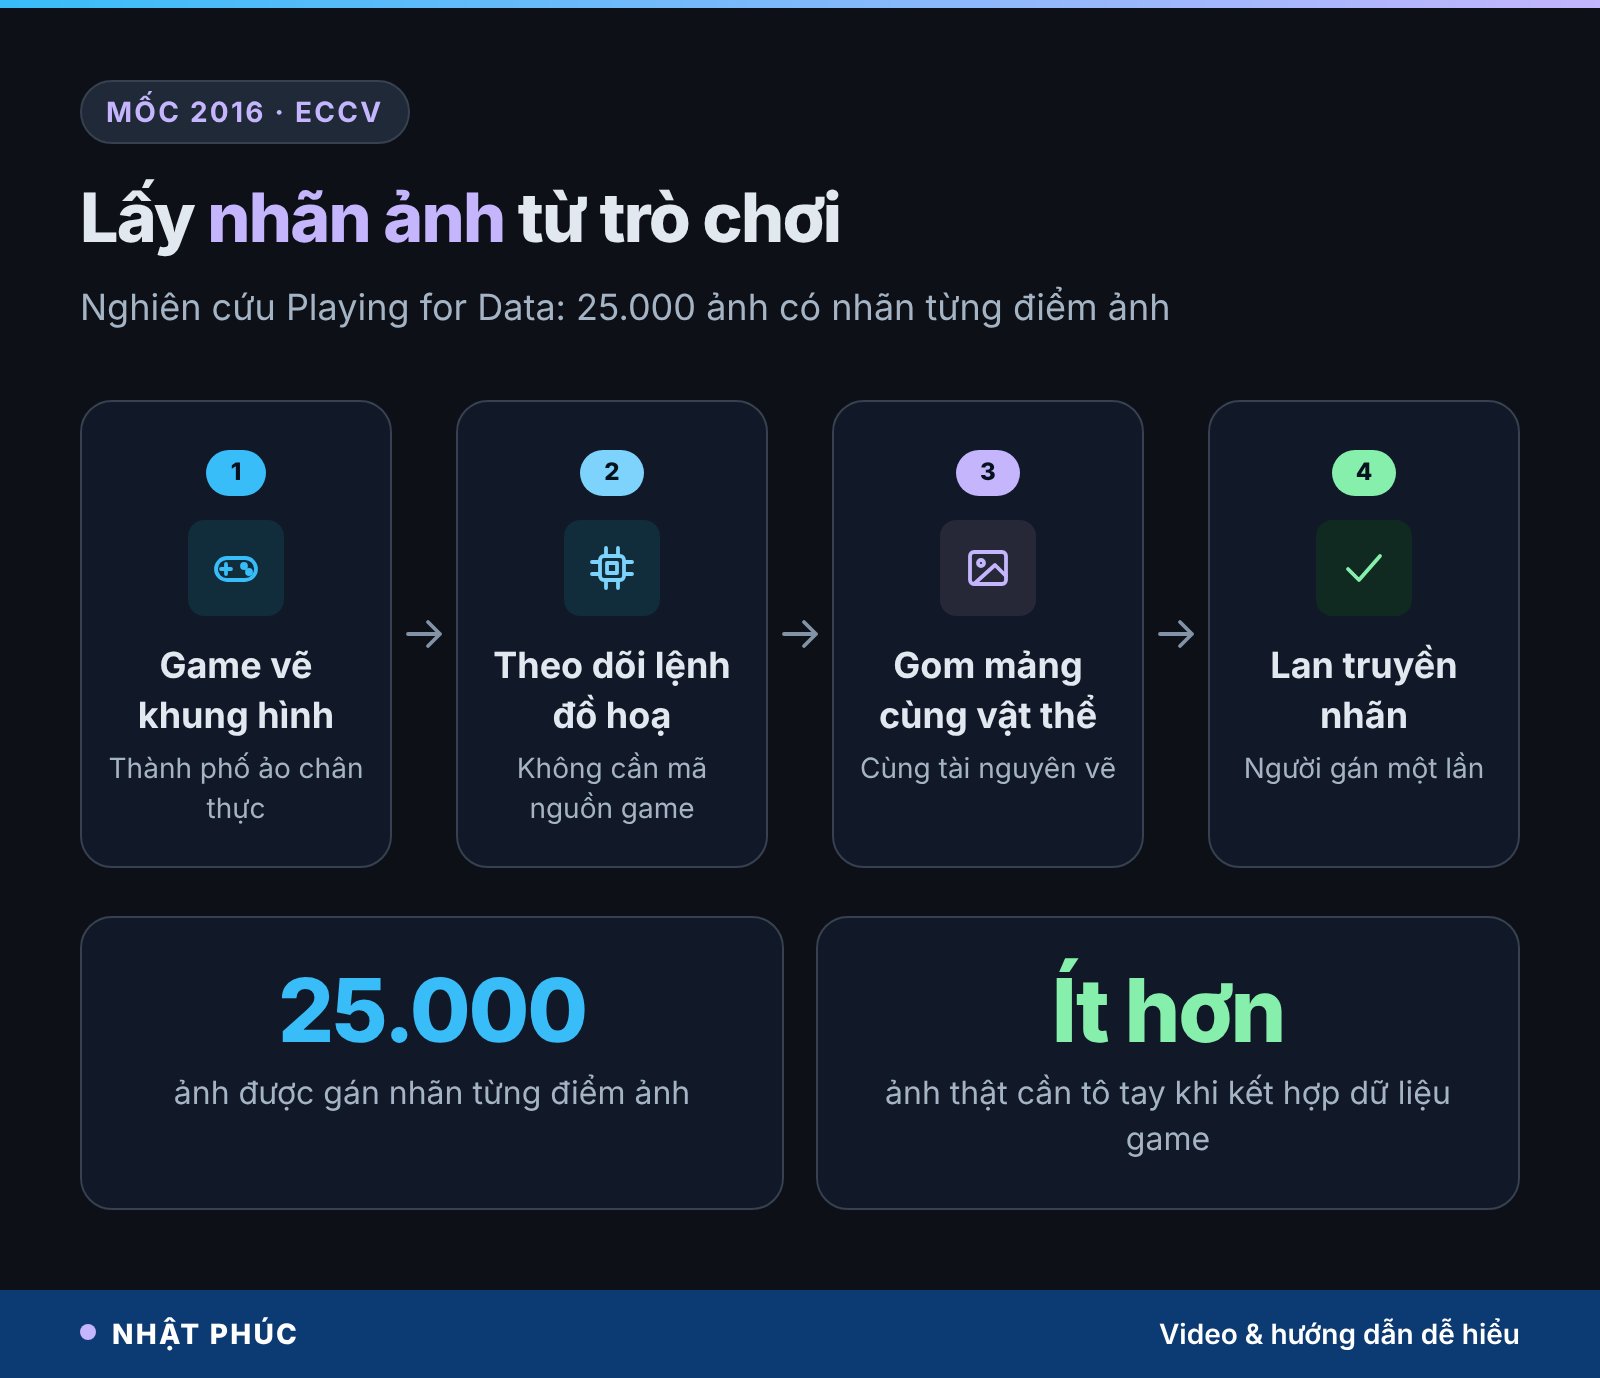
Cột mốc hay được nhắc là nghiên cứu “Playing for Data: Ground Truth from Computer Games” của Stephan R. Richter, Vibhav Vineet, Stefan Roth và Vladlen Koltun, công bố tại hội nghị thị giác máy tính ECCV năm 2016. Nhóm này muốn giải bài toán gán nhãn từng điểm ảnh cho ảnh đường phố mà không phải tô tay toàn bộ.
Điểm khéo léo là họ không có mã nguồn của trò chơi. Thay vào đó, họ theo dõi các lệnh mà game gửi tới card đồ hoạ khi vẽ mỗi khung hình. Vì cùng một chiếc xe, cùng một bức tường luôn được vẽ bằng cùng tài nguyên, nhóm có thể nhận ra mảng ảnh nào thuộc về cùng vật thể, rồi lan truyền nhãn trong một ảnh và sang các ảnh khác. Người chỉ cần gán nhãn một lần cho mỗi nhóm, máy lo phần còn lại.
Kết quả là 25.000 ảnh được gán nhãn từng điểm ảnh từ một trò chơi thế giới mở chân thực. Theo bài báo, mô hình được huấn luyện bằng dữ liệu game kết hợp với ảnh thật cho độ chính xác phân vùng cao hơn, và dữ liệu game giúp giảm lượng ảnh thật cần gán nhãn bằng tay.
Một năm sau, năm 2017, nhóm có Alexey Dosovitskiy, German Ros, Felipe Codevilla, Antonio Lopez và Vladlen Koltun giới thiệu CARLA, một trình mô phỏng lái xe đô thị mã nguồn mở xây trên Unreal Engine. CARLA ra đời đúng để giải những bất tiện khi phải “mượn” game thương mại: có API Python, cho điều khiển thời tiết, đèn giao thông, người đi bộ, và xuất ảnh kèm nhãn trực tiếp.
Các nghiên cứu an toàn giao thông dùng game
Tháng 11/2026, BBC Future tổng hợp một loạt dự án dùng trò chơi thế giới mở để nghiên cứu an toàn giao thông. Dưới đây là những dự án có thể đối chiếu với bài báo khoa học gốc hoặc nhiều nguồn tin. Cần nói rõ: đây đều là nghiên cứu trong mô phỏng, chưa có dự án nào được chứng minh giúp giảm tai nạn trên đường thật.
Đức: thử thiết bị cảnh báo cho người đi xe đạp
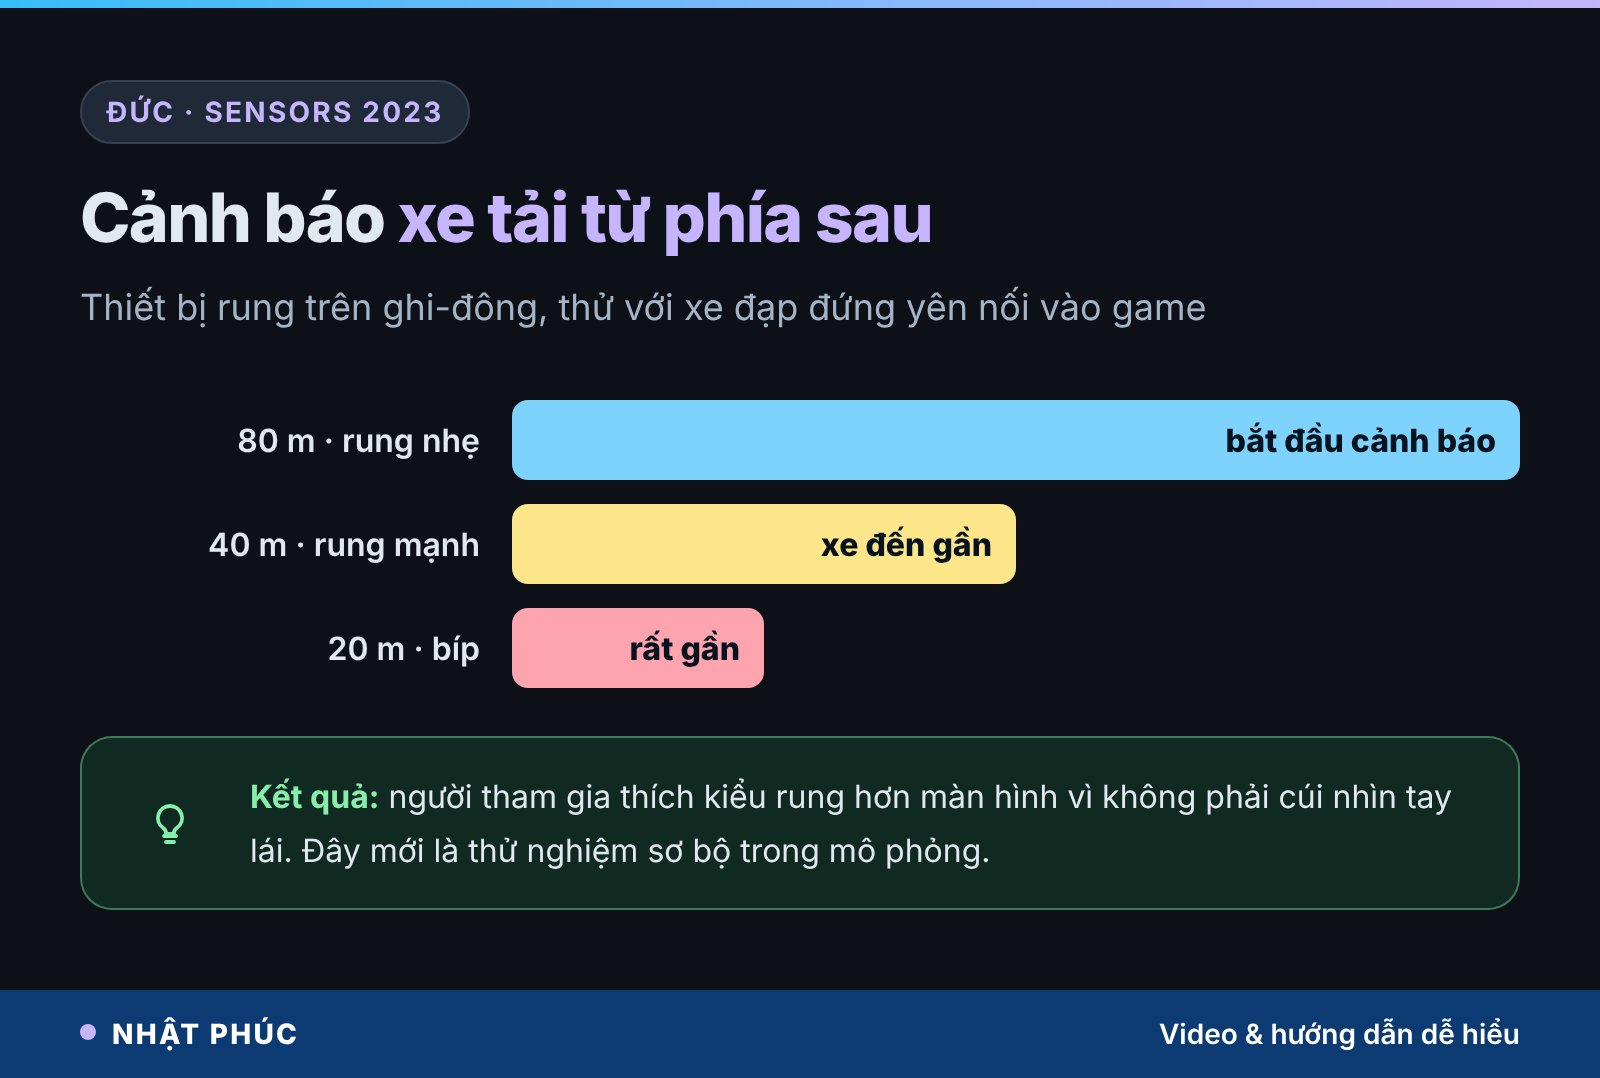
Nhóm của Julius Schöning tại Đại học Khoa học Ứng dụng Osnabrück công bố trên tạp chí Sensors năm 2023. Họ gắn cảm biến vào một chiếc xe đạp đứng yên để người tham gia đạp, lái và phanh, còn hình ảnh hiện trong game. Kịch bản là một đoạn đường thẳng có xe tải liên tục vượt qua.
Hai thiết bị được thử. Thiết bị thứ nhất gắn trên ghi-đông, rung nhẹ khi xe tải còn cách 80 m, rung mạnh hơn ở 40 m và phát tiếng bíp ở 20 m. Thiết bị thứ hai là màn hình điện thoại gắn trên xe, hiện cột màu cho biết xe đang tới từ bên nào và còn bao xa. Người tham gia thích kiểu rung hơn vì không phải cúi nhìn xuống tay lái.
Nhóm tác giả cũng tự nêu giới hạn: chỉ là thử nghiệm sơ bộ với vài người tham gia trên một đoạn đường thẳng; xe đứng yên nên không nghiêng được khi vào cua; có độ trễ giữa tay lái và hình ảnh; và độ rung có thể khó cảm nhận trên mặt đường lát đá.
Hà Lan: theo dõi ánh mắt người đi xe đạp
Một nhóm kỹ sư cơ sinh học tại Đại học Công nghệ Delft kết hợp game với thiết bị theo dõi ánh mắt (eye-tracking). Họ ghi lại người đi xe đạp nhìn vào đâu khi gặp nguy hiểm như cửa ô tô bất ngờ mở ra hay xe lùi ra khỏi chỗ đỗ. Kiểu dữ liệu này giúp hiểu người tham gia giao thông chú ý vào đâu, từ đó gợi ý cách thiết kế giao lộ an toàn hơn.
Hàn Quốc: dạy AI nhận ra xe nguy hiểm
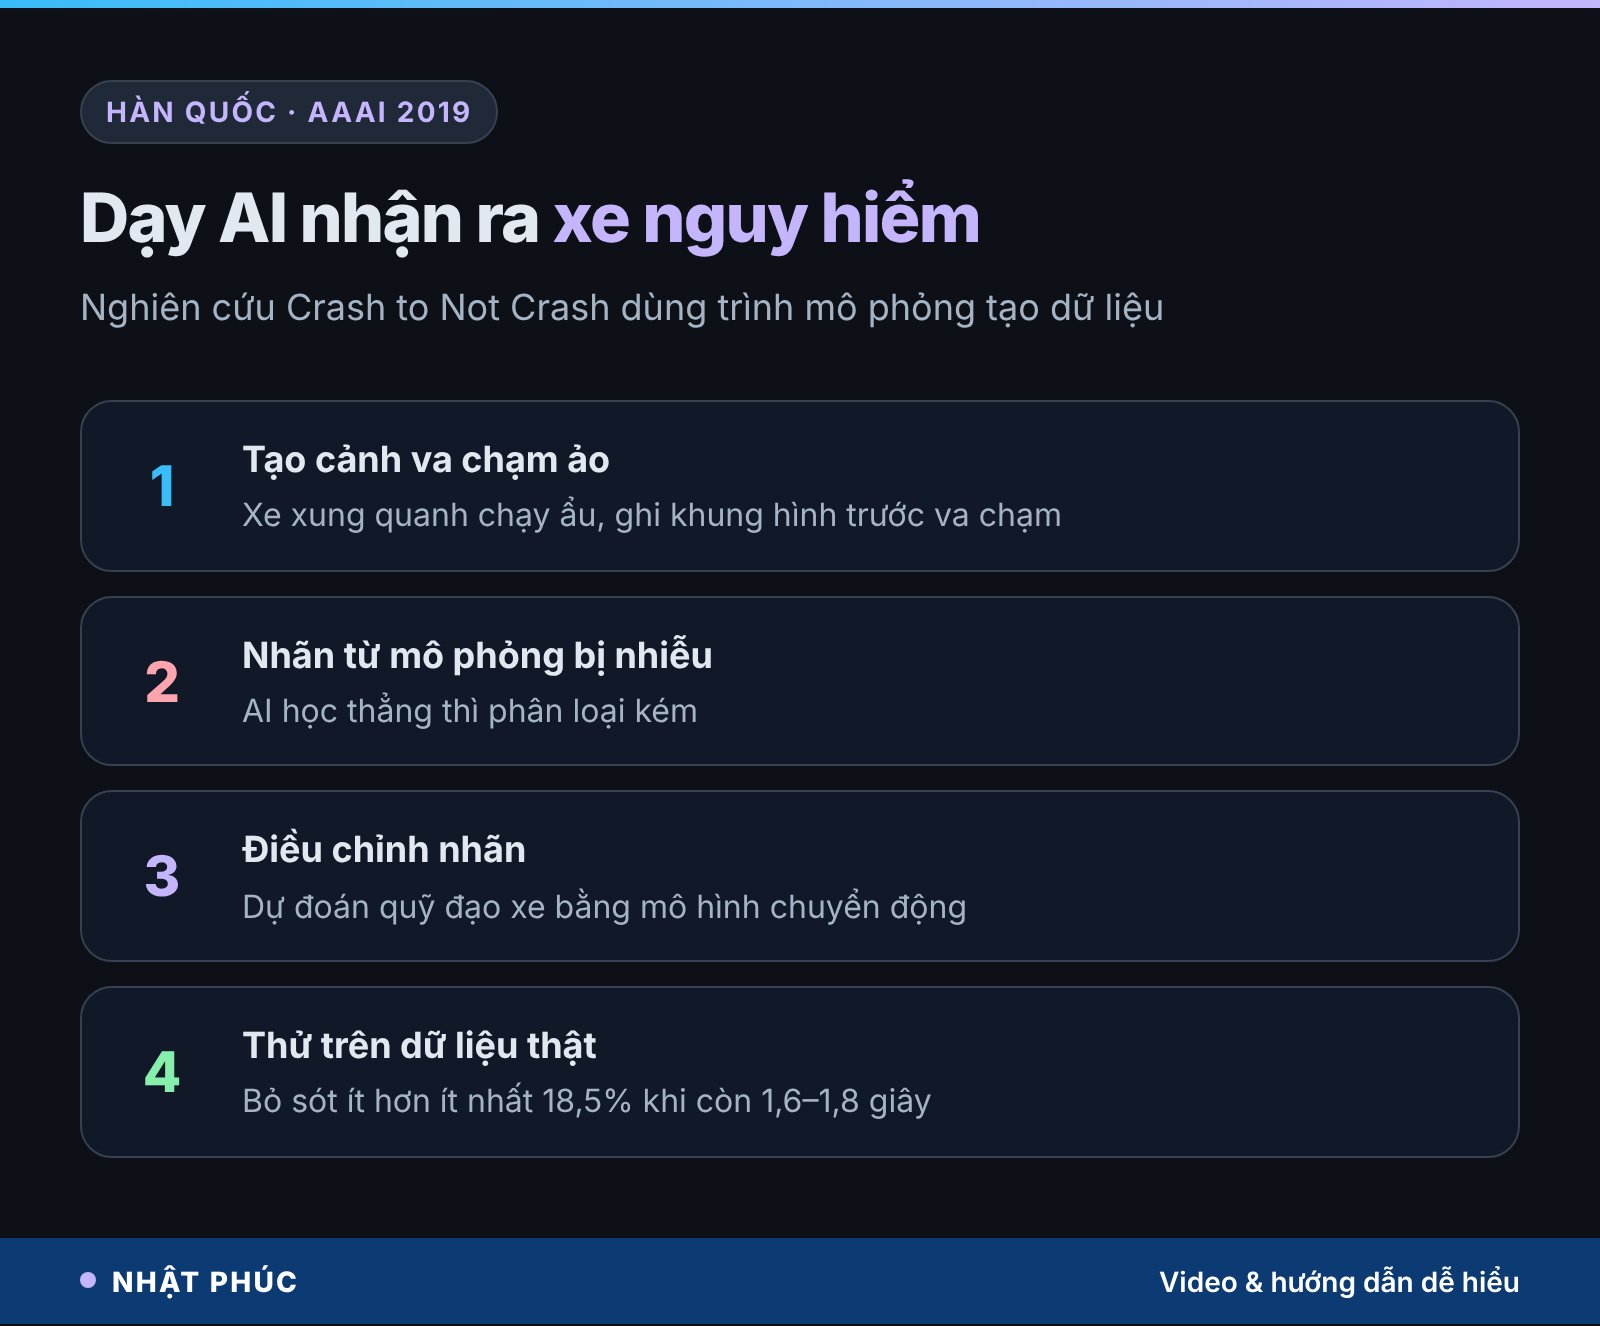
Đây là phần gần nhất với dữ liệu tổng hợp cho AI. Nhóm của Hoon Kim, Kangwook Lee, Gyeongjo Hwang và Changho Suh tại KAIST công bố bài “Crash to Not Crash” ở hội nghị AAAI 2019. Họ xây bộ sinh dữ liệu trên nền một trình mô phỏng lái xe, cho xe xung quanh chạy ẩu để tạo ra cảnh sắp va chạm và cảnh an toàn.
Bài học thú vị nhất: nhãn lấy thẳng từ kết quả mô phỏng rất “nhiễu”, khiến AI phân loại kém. Nhóm phải thêm bước điều chỉnh nhãn, lấy trạng thái bên trong của xe từ trình mô phỏng rồi dự đoán quỹ đạo bằng mô hình chuyển động. Khi thử trên dữ liệu thật, bộ phân loại giảm tỷ lệ bỏ sót xe nguy hiểm ít nhất 18,5% so với mô hình chỉ học từ dữ liệu thật, trong khoảng thời gian trước va chạm 1,6–1,8 giây.
Khoảng cách giữa thế giới ảo và đường thật
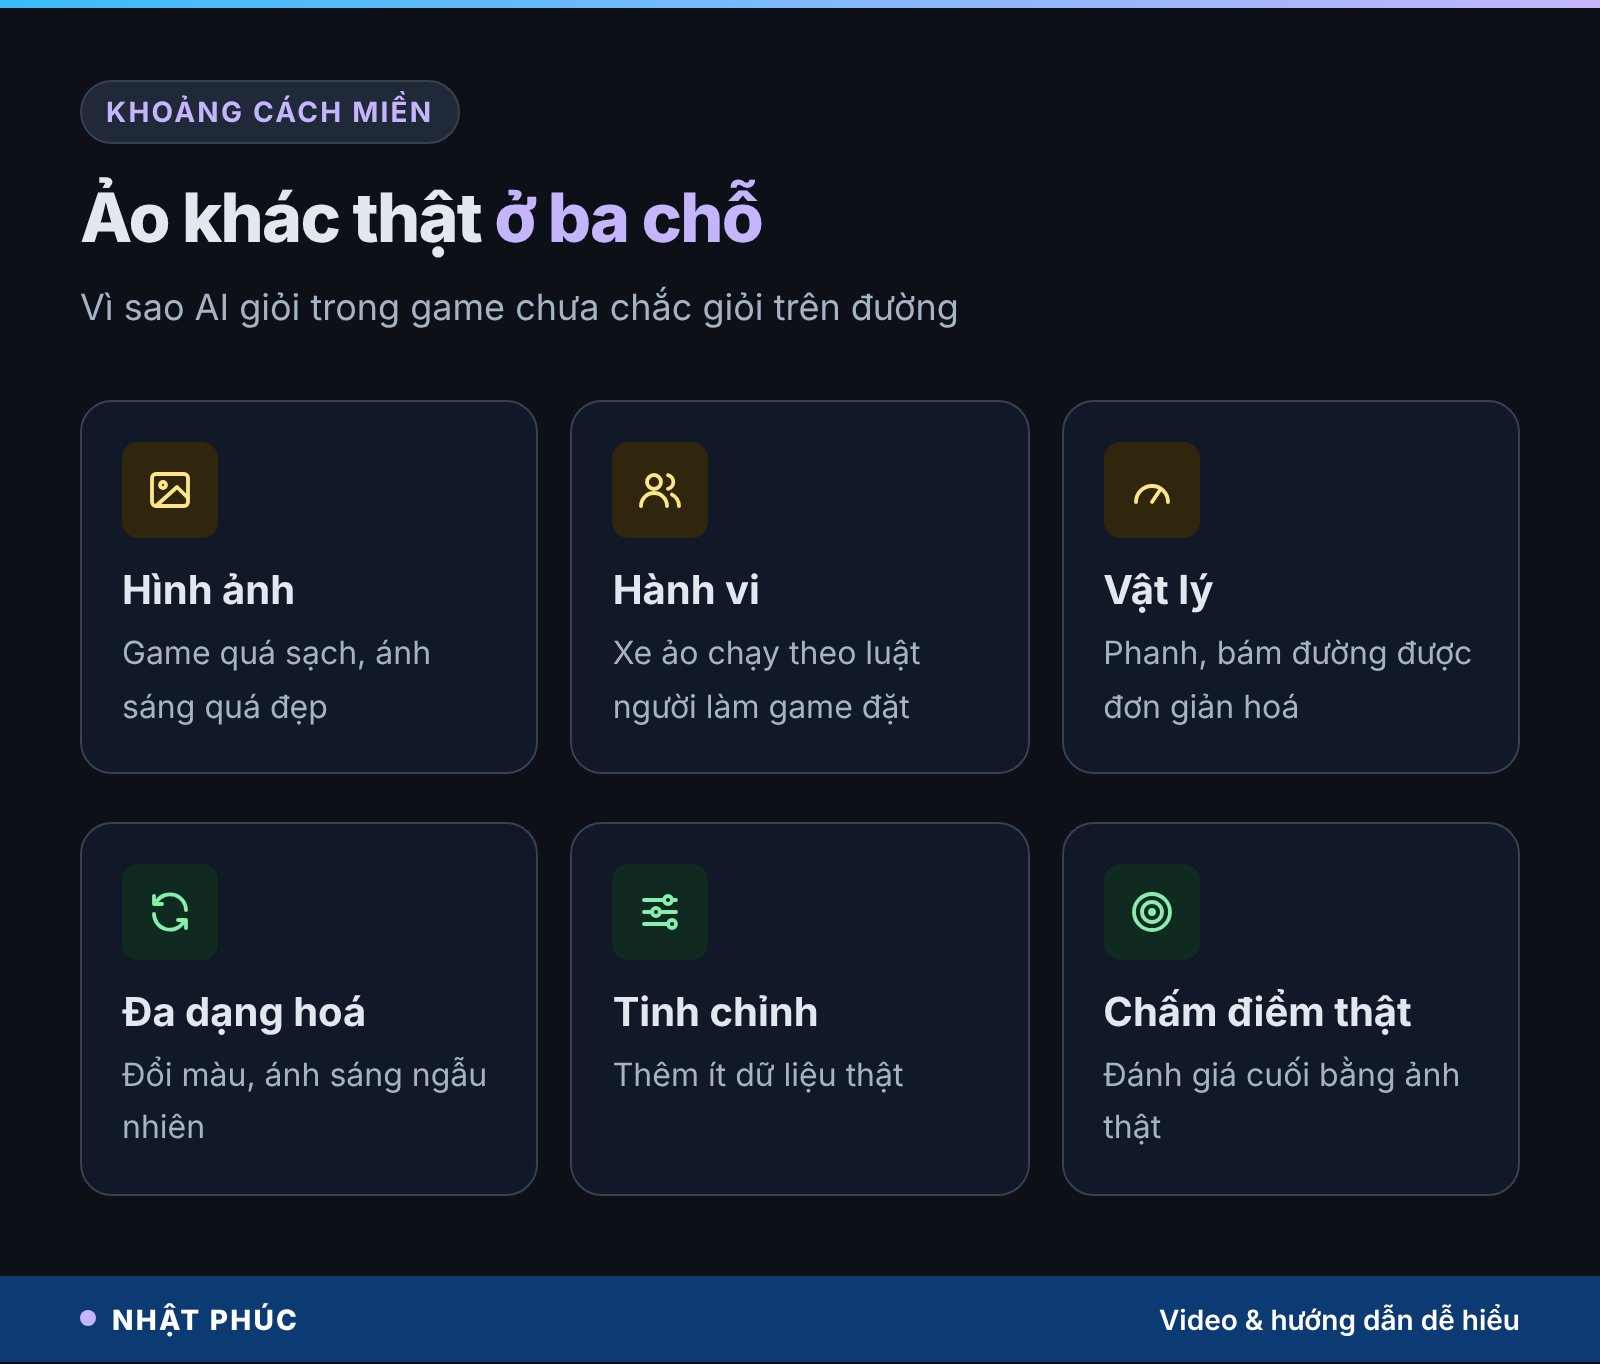
Mô hình học trong game giỏi nhận ra chiếc xe trong game. Ra đường thật, ánh sáng, chất liệu, bụi bẩn, cách người ta lái xe đều khác. Giới nghiên cứu gọi đó là khoảng cách miền (domain gap). Đây cũng là lý do mọi nghiên cứu nêu trên đều nhấn mạnh phải thử lại trên dữ liệu thật.
Với dữ liệu ảnh, khoảng cách thường nằm ở ba chỗ: hình ảnh (game quá sạch, quá đẹp), hành vi (xe trong game chạy theo luật do người làm game đặt ra) và vật lý (bánh xe, phanh, độ bám đường được đơn giản hoá). Nếu bạn quan tâm tới cách robot vượt qua khoảng cách này khi học vận động, hãy đọc thêm bài robot tự học thế nào qua mô phỏng.
Cách làm phổ biến là trộn: dùng nhiều dữ liệu tổng hợp để mô hình học cái chung, rồi tinh chỉnh bằng một lượng nhỏ dữ liệu thật, và đánh giá cuối cùng luôn bằng dữ liệu thật. Một kỹ thuật khác là cố tình làm thế giới ảo “đa dạng quá mức”, đổi màu, ánh sáng, kết cấu ngẫu nhiên, để mô hình không bám vào chi tiết riêng của game.
Hiểu lầm và rủi ro của dữ liệu tổng hợp
Dữ liệu tổng hợp hấp dẫn đến mức dễ bị thổi phồng. Dưới đây là vài hiểu lầm hay gặp.
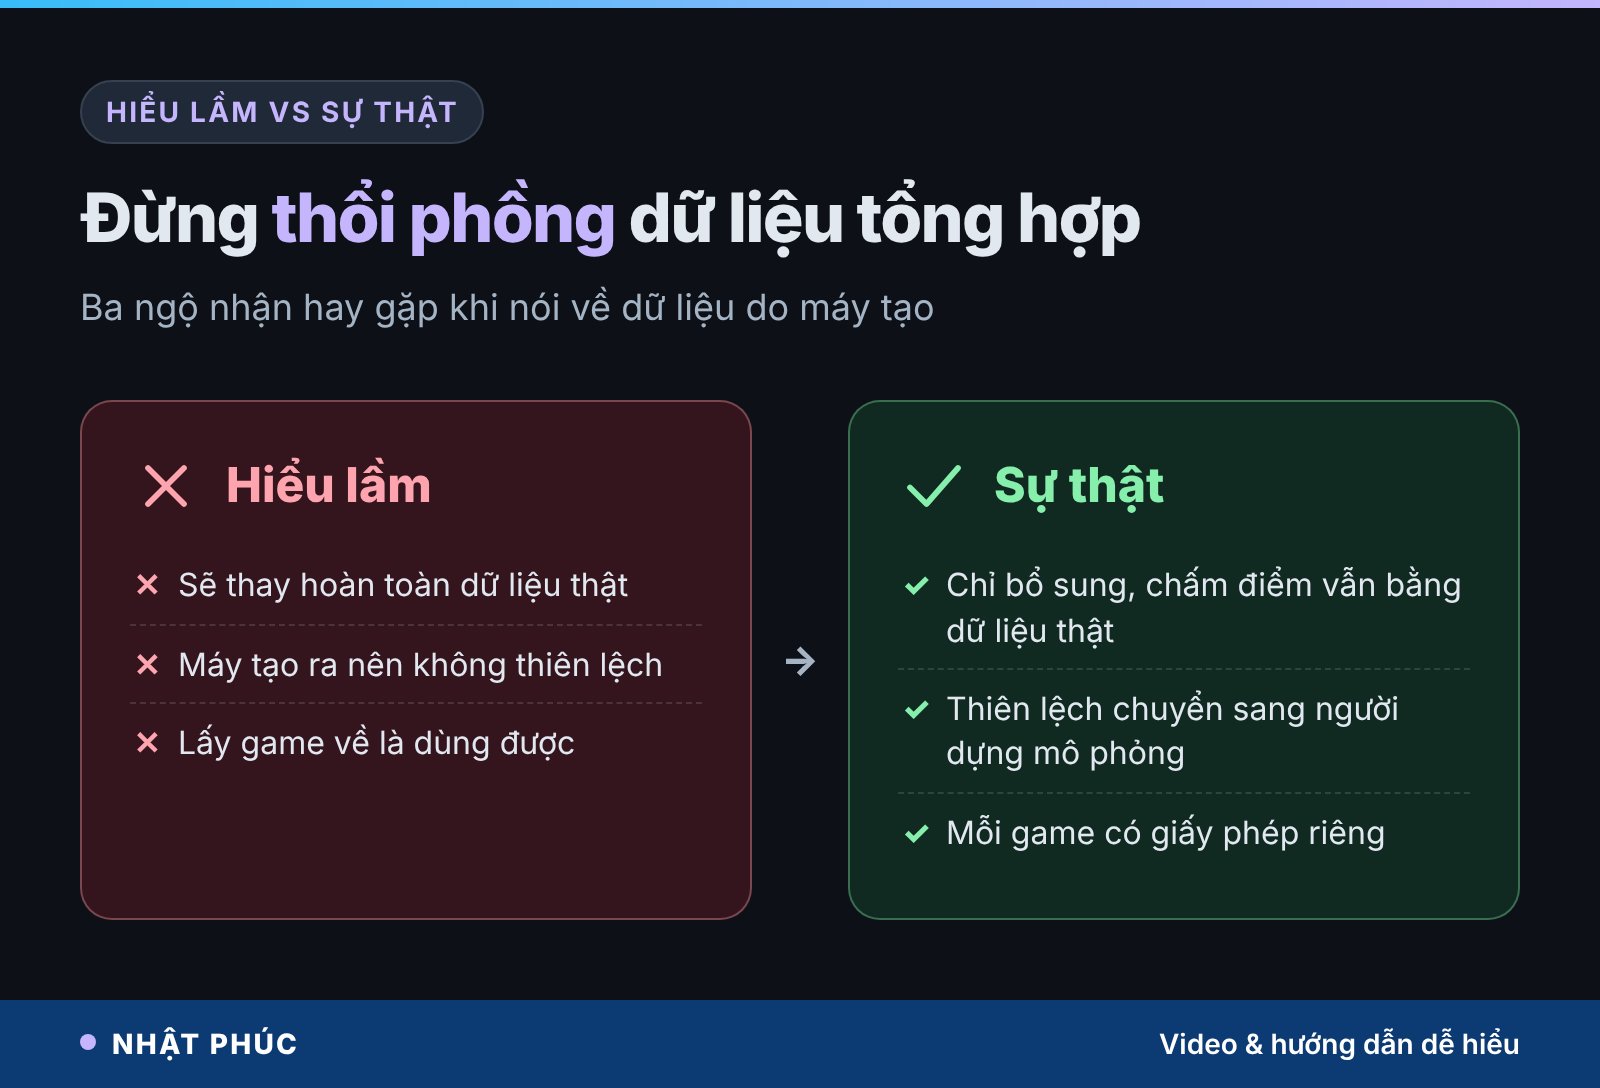
“Dữ liệu tổng hợp sẽ thay hoàn toàn dữ liệu thật”
Chưa. Các nghiên cứu nghiêm túc đều dùng dữ liệu tổng hợp để bổ sung, còn kiểm tra cuối cùng vẫn là dữ liệu thật. Một AI chỉ đạt điểm cao trong mô phỏng chưa nói lên điều gì về đường phố thật.
“Máy tạo ra thì không có thiên lệch”
Sai. Thế giới ảo phản ánh lựa chọn của người dựng nó. Nếu thành phố trong game toàn ô tô và đường rộng, AI sẽ lúng túng trước dòng xe máy dày đặc. Thiên lệch không biến mất, nó chỉ chuyển từ người chụp ảnh sang người thiết kế mô phỏng.
“Cứ lấy game về là dùng được”
Mỗi trò chơi thương mại có thoả thuận giấy phép riêng. Dùng cho nghiên cứu học thuật, chia sẻ bộ dữ liệu trích từ game hay dùng cho sản phẩm thương mại là những chuyện khác nhau, cần đọc kỹ điều khoản hoặc dùng trình mô phỏng có giấy phép rõ ràng.
Rủi ro khi AI học từ dữ liệu do AI tạo
Với văn bản, một nghiên cứu đăng trên tạp chí Nature năm 2024 cho thấy khi mô hình liên tục được huấn luyện bằng dữ liệu do thế hệ mô hình trước sinh ra, chất lượng có thể suy giảm dần, gọi là “sụp đổ mô hình” (model collapse). Bài học chung: dữ liệu tổng hợp cần được trộn và kiểm soát, không thể “tự nuôi” vô hạn.
Dữ liệu tổng hợp có ích gì ở Việt Nam?
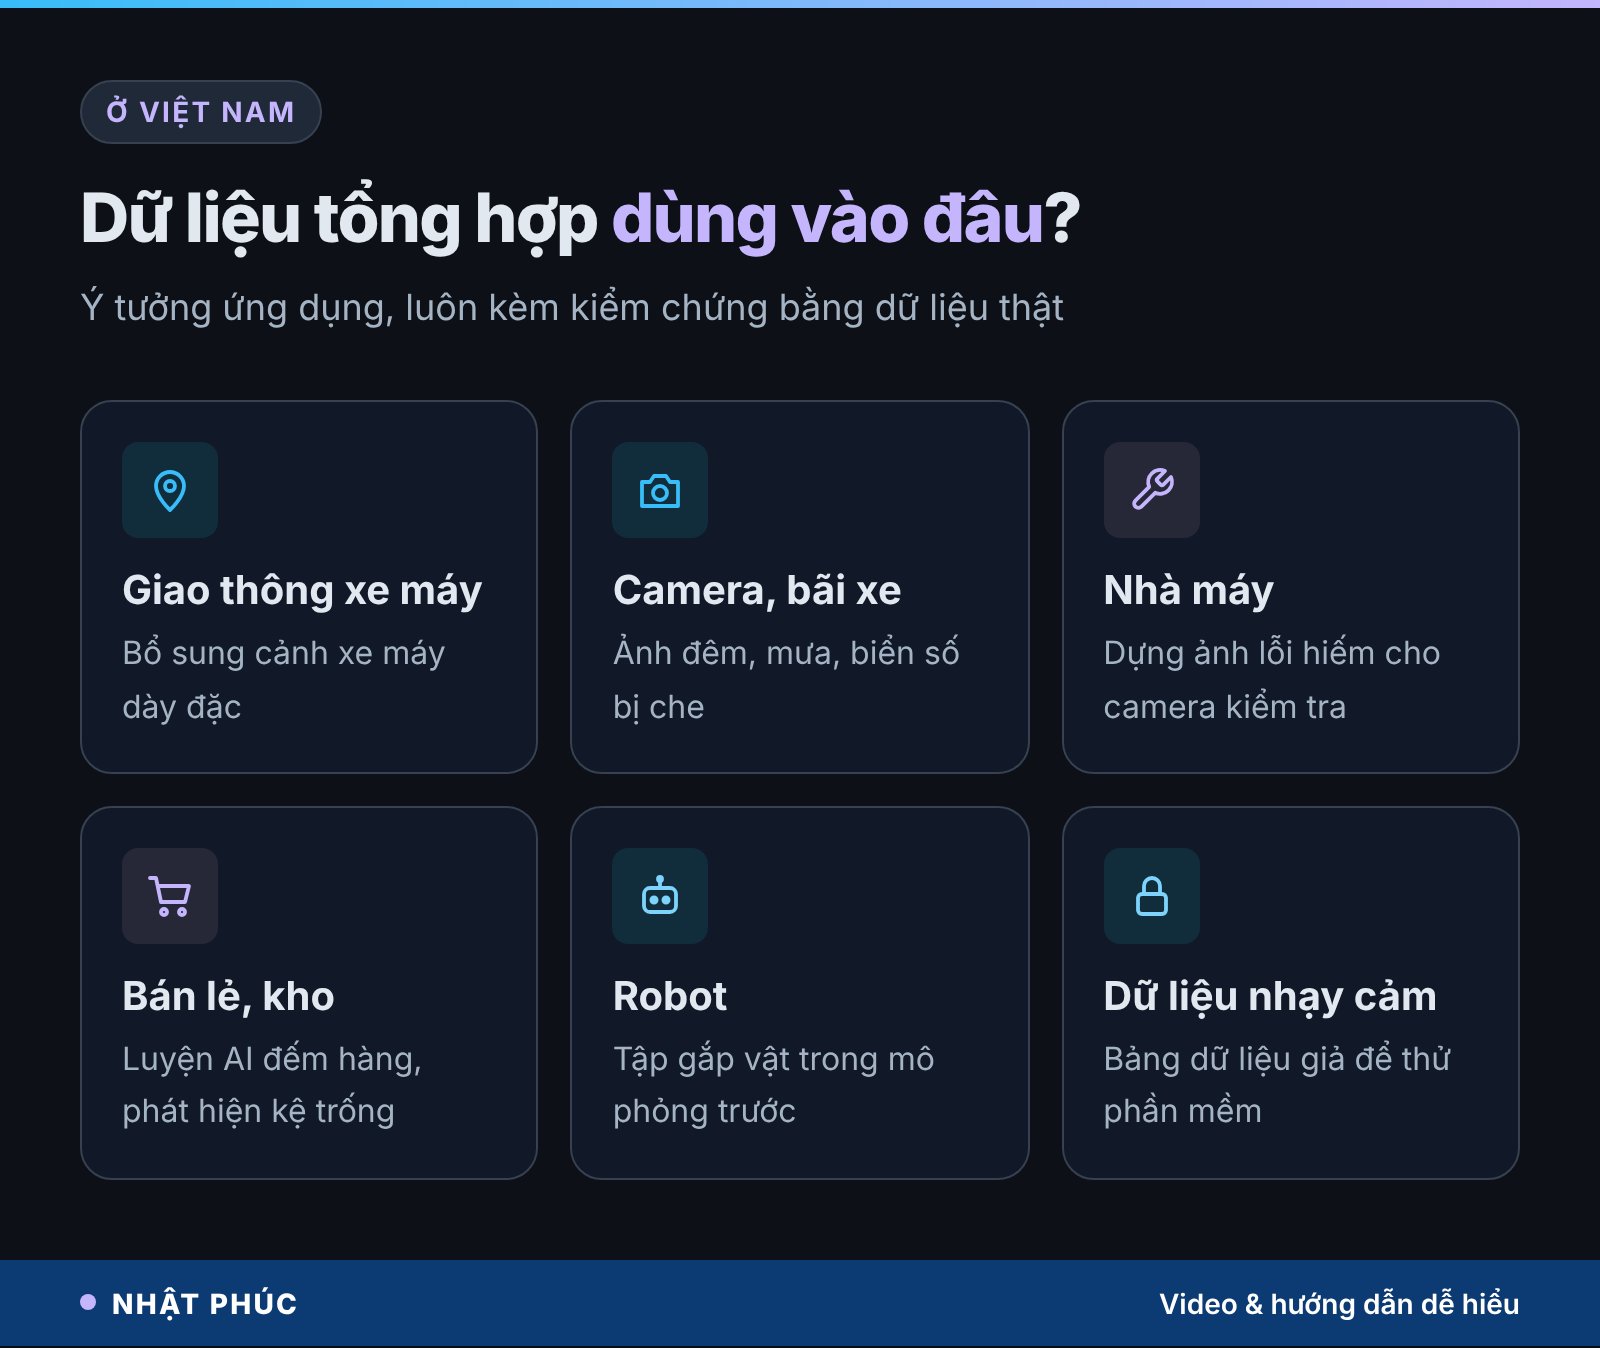
Giao thông Việt Nam có đặc điểm mà các bộ dữ liệu nước ngoài ít phản ánh: xe máy chiếm số đông, len lỏi, chở hàng cồng kềnh, đi cùng ô tô, xe buýt, xe đạp trên cùng làn. Một AI học từ đường phố châu Âu hay Mỹ khó hiểu ngay cảnh này. Dữ liệu tổng hợp là một cách bổ sung tình huống đặc thù mà không phải quay hàng nghìn giờ video.
Ngoài giao thông, nguyên lý tương tự áp dụng được ở nhiều nơi:
- Camera giao thông, bãi xe: bổ sung ảnh ban đêm, trời mưa, biển số bị che một phần để luyện mô hình nhận diện, sau đó kiểm tra bằng ảnh thật đã được phép sử dụng.
- Nhà máy: lỗi sản phẩm thường hiếm, nên có thể dựng ảnh 3D các vết xước, móp, thiếu linh kiện để dạy camera kiểm tra chất lượng.
- Bán lẻ, kho hàng: dựng ảnh kệ hàng với nhiều cách sắp xếp, ánh sáng để luyện AI đếm hàng, phát hiện kệ trống.
- Robot và tự động hoá: luyện robot gắp vật trong mô phỏng trước khi cho chạy trên dây chuyền.
- Dữ liệu nhạy cảm: sinh bảng dữ liệu giả có đặc điểm thống kê giống thật để thử phần mềm, hạn chế dùng thông tin cá nhân.
Với dữ liệu cá nhân, Việt Nam đã có Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15. Dữ liệu tổng hợp không tự động miễn trách nhiệm: nếu được sinh ra từ dữ liệu thật, vẫn cần đánh giá xem có thể suy ngược ra người cụ thể hay không.
Tự thử tạo dữ liệu tổng hợp với công cụ miễn phí
Bạn không cần phòng thí nghiệm để hiểu dữ liệu tổng hợp. Hai công cụ miễn phí phù hợp để bắt đầu:
- CARLA: trình mô phỏng lái xe đô thị mã nguồn mở, giấy phép MIT, xây trên Unreal Engine. Có API Python và C++, mô phỏng camera thường, camera độ sâu, camera phân vùng ngữ nghĩa, LiDAR, cảm biến va chạm và lấn làn; cho điều khiển thời tiết, đèn giao thông, người đi bộ. Cần máy tính có card đồ hoạ khá.
- Blender: phần mềm dựng 3D miễn phí, mã nguồn mở. Bạn có thể dựng vật thể, đổi ánh sáng, góc máy bằng script Python và xuất ảnh cùng mặt nạ vật thể làm nhãn. Hợp với bài toán nhỏ như nhận diện sản phẩm trên bàn.
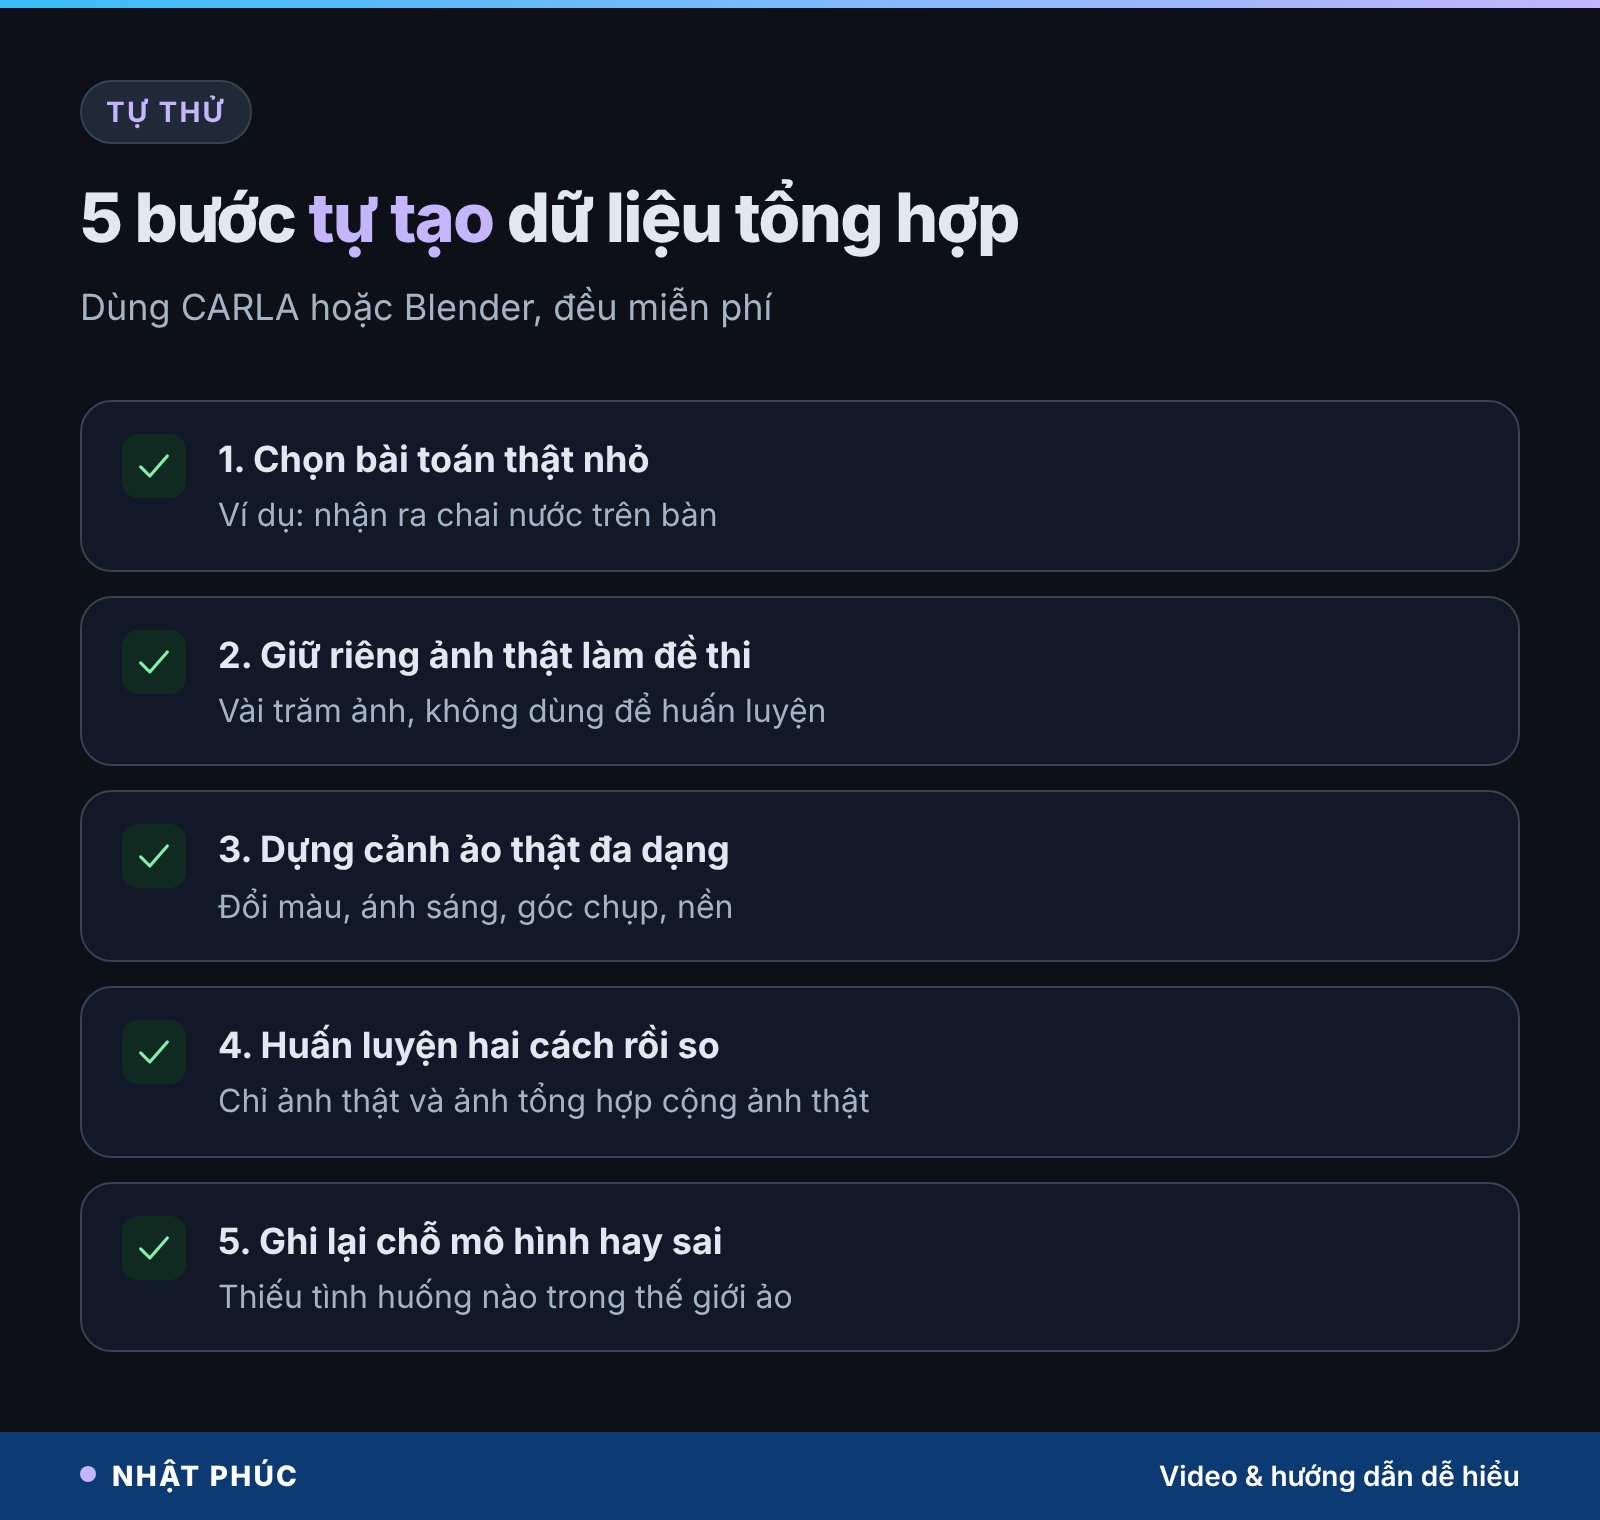
1. Chọn một bài toán thật nhỏ
Ví dụ: nhận ra chai nước trên bàn, hoặc phân biệt xe máy và ô tô trong ảnh. Bài toán càng hẹp, càng dễ thấy hiệu quả.
2. Thu một ít dữ liệu thật để làm “đề thi”
Chụp vài trăm ảnh thật và giữ riêng, không dùng để huấn luyện. Đây là thước đo trung thực duy nhất.
3. Dựng cảnh ảo và đa dạng hoá
Đổi màu, ánh sáng, góc chụp, nền phía sau một cách ngẫu nhiên. Mục tiêu là đa dạng, không phải đẹp.
4. Huấn luyện theo hai cách và so sánh
Một mô hình chỉ học ảnh thật, một mô hình học ảnh tổng hợp rồi tinh chỉnh bằng ảnh thật. So kết quả trên bộ “đề thi” ở bước 2.
5. Ghi lại giới hạn
Ảnh nào mô hình hay sai? Thiếu tình huống nào trong thế giới ảo? Ghi chép này quan trọng không kém con số độ chính xác.
| Tình huống | Dữ liệu thật | Dữ liệu tổng hợp | Gợi ý |
|---|---|---|---|
| Cảnh thường gặp, dễ chụp | Phù hợp | Không cần nhiều | Ưu tiên dữ liệu thật |
| Cảnh hiếm, nguy hiểm | Rất khó thu | Phù hợp | Tổng hợp rồi kiểm tra bằng ảnh thật |
| Cần nhãn từng điểm ảnh | Tốn công gán nhãn | Có nhãn sẵn | Kết hợp hai loại |
| Dữ liệu có thông tin cá nhân | Phải xin phép, làm mờ | Giảm rủi ro | Vẫn đánh giá khả năng suy ngược |
Câu hỏi thường gặp
Dữ liệu tổng hợp có phải là dữ liệu giả không?
Nó được máy tạo ra nên không phải bản ghi của sự kiện có thật, nhưng không phải “giả” theo nghĩa lừa dối. Dữ liệu tổng hợp được tạo có chủ đích, có nhãn chính xác, để luyện hoặc kiểm tra AI. Vấn đề chỉ nảy sinh khi người ta đánh đồng kết quả trong mô phỏng với hiệu quả ngoài đời.
Vì sao các nhà nghiên cứu lại chọn trò chơi điện tử?
Vì trò chơi thế giới mở có sẵn thành phố ảo rộng, xe cộ, thời tiết và vật lý khá chân thực với chi phí thấp. Đổi lại, game không được làm cho khoa học: khó lấy dữ liệu, có giới hạn về vật lý và giấy phép, nên nhiều nhóm chuyển sang trình mô phỏng mã nguồn mở như CARLA.
AI xe tự lái hiện nay có học từ game không?
Các hãng xe tự lái thường dùng trình mô phỏng riêng và dữ liệu thu từ đội xe thật, ít khi công bố chi tiết. Việc dùng game thương mại chủ yếu xuất hiện trong nghiên cứu học thuật. Điểm chung là mô phỏng chỉ là một bước, kiểm tra trên đường thật mới quyết định.
Các nghiên cứu dùng game đã giúp đường phố an toàn hơn chưa?
Chưa có bằng chứng như vậy. Thiết bị cảnh báo cho xe đạp mới thử trên xe đứng yên với vài người tham gia, còn bộ phân loại xe nguy hiểm mới được đánh giá trên tập dữ liệu. Đây là bước khởi đầu đầy hứa hẹn, không phải giải pháp đã triển khai.
Người mới có tự tạo dữ liệu tổng hợp được không?
Được, ở quy mô nhỏ. Với Blender bạn có thể dựng vài nghìn ảnh một vật thể kèm mặt nạ nhãn; với CARLA bạn có thể lấy ảnh đường phố ảo có nhãn. Quan trọng nhất là giữ một bộ ảnh thật riêng để đánh giá trung thực.
Kết luận: sân tập tốt, nhưng bài thi là đường thật
Dữ liệu tổng hợp đang giúp AI luyện những tình huống mà ngoài đời không ai muốn gặp: va chạm, xe mất lái, người đi xe đạp bị ép sát. Việc một trò chơi hành động trở thành phòng thí nghiệm an toàn giao thông cho thấy khoa học có thể tận dụng công cụ giải trí rất sáng tạo. Nhưng như mọi sân tập, giá trị của nó chỉ được chứng minh khi ra đường thật.
Bạn nghĩ dữ liệu tổng hợp nên được dùng vào bài toán nào ở Việt Nam trước tiên: giao thông xe máy, nhà máy hay cửa hàng? Hãy để lại bình luận và theo dõi Nhật Phúc để đọc thêm các bài giải thích AI dễ hiểu.
Bình luận
Chưa có bình luận nào. Bạn có câu hỏi hay kinh nghiệm riêng về chủ đề này? Hãy là người mở đầu.