Bạn có để ý các mô hình AI mới ra mắt ngày càng dày không? Một báo cáo độc lập công bố ngày 5/11/2026 đưa ra lời giải thích đáng chú ý: tại Anthropic, công ty làm ra Claude, AI tự cải tiến đã bắt đầu thành chuyện có số đo. Nói cách khác, chính AI đang giúp kỹ sư làm ra thế hệ AI tiếp theo nhanh hơn trước.
Báo cáo do METR thực hiện, sau khoảng 11 tuần làm việc bên trong Anthropic với dữ liệu nội bộ. Kết luận chính: tốc độ tăng điểm năng lực của mô hình đã nhanh khoảng 1,9 lần so với trước tháng 10/2025, và phần lớn mức tăng đó nhiều khả năng đến từ việc dùng AI trong nghiên cứu.
Câu trả lời ngắn: AI tự cải tiến là vòng lặp trong đó mô hình hiện tại giúp nghiên cứu và huấn luyện mô hình sau. METR ước tính Anthropic đang tiến bộ nhanh khoảng gấp đôi nhịp cũ, nhưng khoảng sai số rất rộng, nhiều bằng chứng bị che và AI vẫn chủ yếu đóng vai trợ lý cho con người.
Tóm tắt nhanh
- METR đánh giá Anthropic từ 12/8 đến 29/10/2026, công bố kết quả ngày 5/11/2026.
- Điểm năng lực nội bộ (AECI) tăng nhanh 1,9 lần nhịp trước tháng 10/2025, khoảng tin cậy 95% là 1,5–2,8 lần.
- METR đoán khoảng 80% mức tăng tốc là nhờ AI, và chắc chắn không phải do tăng điện toán huấn luyện.
- Anthropic đã che nhiều bằng chứng quan trọng nhất trong bản công bố.
- Kết quả gắn với lời kêu gọi “giảm tốc” của CEO Dario Amodei ngày 12/9/2026 và đợt IPO sắp tới của Anthropic.
Nội dung chính
- AI tự cải tiến là gì?
- METR là ai, vì sao được vào tận bên trong?
- Những con số chính của báo cáo
- Vì sao METR cho rằng AI là nguyên nhân chính?
- METR đã đo bằng cách nào?
- Giới hạn và phần bị che
- Bối cảnh: lời kêu gọi giảm tốc và đợt IPO
- Hiểu lầm phổ biến
- Các hãng AI khác thì sao?
- Người dùng ở Việt Nam nên hiểu và làm gì?
- Câu hỏi thường gặp
AI tự cải tiến là gì?
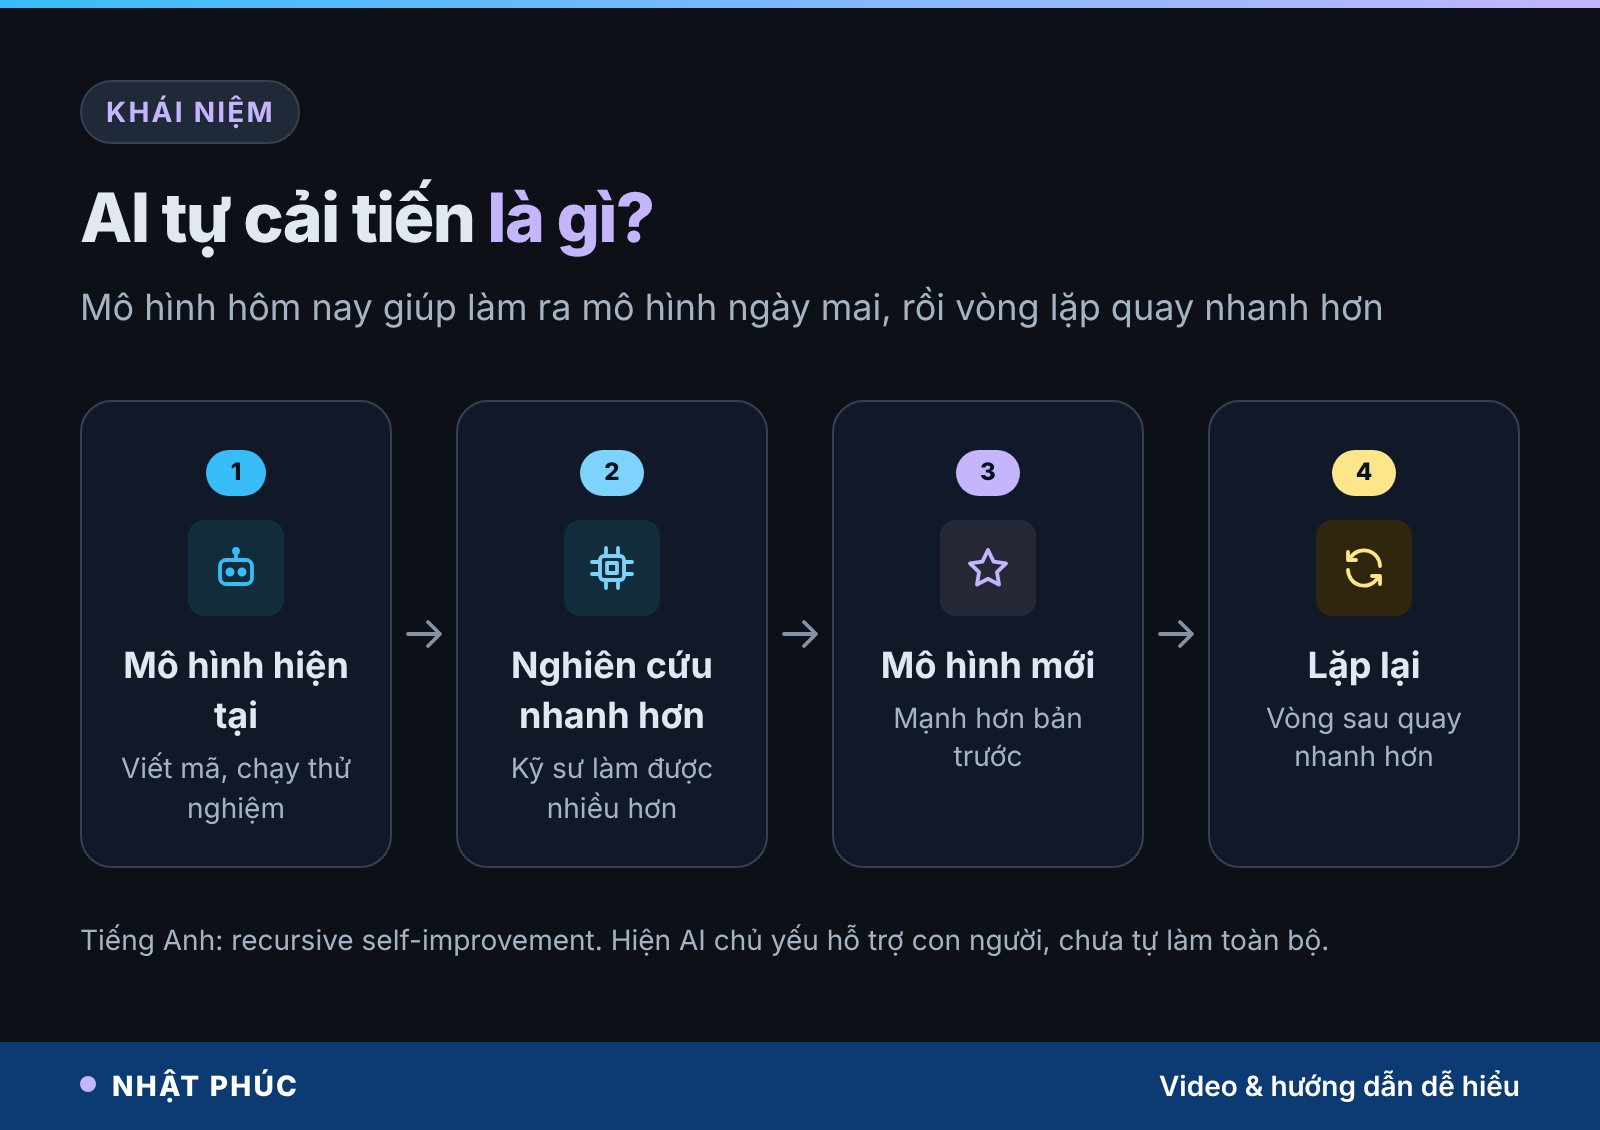
Hãy hình dung một xưởng làm máy tiện. Ban đầu thợ phải tiện từng chi tiết bằng tay. Khi có chiếc máy tiện đầu tiên, họ dùng nó để làm chiếc thứ hai chính xác hơn, rồi chiếc thứ hai làm chiếc thứ ba nhanh hơn nữa. Công cụ giúp làm ra công cụ tốt hơn, và vòng lặp cứ thế tăng tốc.
Trong AI, hiện tượng này gọi là recursive self-improvement, tạm dịch là AI tự cải tiến hay tự cải thiện theo vòng lặp. Mô hình hiện tại viết mã, chạy thí nghiệm, phân tích kết quả, đề xuất ý tưởng. Kỹ sư nhờ vậy thử được nhiều hướng hơn trong cùng một tuần, và mô hình kế tiếp ra đời sớm hơn. Đến lượt mô hình mới lại giúp vòng sau nhanh thêm.
Điều quan trọng cần nhớ: báo cáo không nói AI đã tự mình làm ra AI mới. Theo METR, AI chưa thể đóng góp tự chủ thật sự quan trọng vào những phần cốt lõi nhất của quá trình huấn luyện. Phần lớn lợi ích hiện nay đến từ AI hỗ trợ con người, kiểu như một trợ lý nghiên cứu rất nhanh. Tuy vậy, các nhà nghiên cứu của Anthropic mô tả đã thấy “dấu hiệu” cho thấy đóng góp tự chủ có thể sớm tăng lên. Nếu bạn muốn hiểu AI làm việc nhiều bước như thế nào, bài ví dụ AI agent trong thực tế là điểm khởi đầu tốt.
METR là ai, vì sao được vào tận bên trong?
METR (Model Evaluation and Threat Research) là tổ chức phi lợi nhuận đặt tại Berkeley, bang California, Mỹ. Tổ chức này ra đời năm 2022 với tên ARC Evals, đổi tên thành METR vào tháng 12/2023. Việc chính của họ là đo xem các mô hình AI tiên tiến làm được những tác vụ dài, nhiều bước đến đâu, và đánh giá rủi ro trước khi mô hình được tung ra.
Theo hãng tin AP, METR sống bằng tiền tài trợ và không nhận thù lao cho việc đánh giá. Các công ty AI hợp tác chỉ cung cấp quyền truy cập và lượng token để họ chạy thử nghiệm. METR đã nhiều năm đánh giá mô hình cho Anthropic, OpenAI và các phòng thí nghiệm khác. Một nghiên cứu nổi tiếng của họ cho thấy độ dài tác vụ phần mềm mà AI làm được tăng gấp đôi khoảng mỗi 7 tháng (bản 3/2025), sau đó bản cập nhật tháng 1/2026 rút xuống khoảng 4,3 tháng.
Lần này khác ở chỗ METR được mời vào làm việc gần như một nhóm nội bộ. Anthropic cung cấp điểm benchmark của cả mô hình chưa ra mắt, số liệu huấn luyện, khảo sát nhân viên và cho phỏng vấn. METR gọi đây là mức truy cập “chưa từng có” vào quy trình nghiên cứu AI của một công ty.
Những con số chính của báo cáo
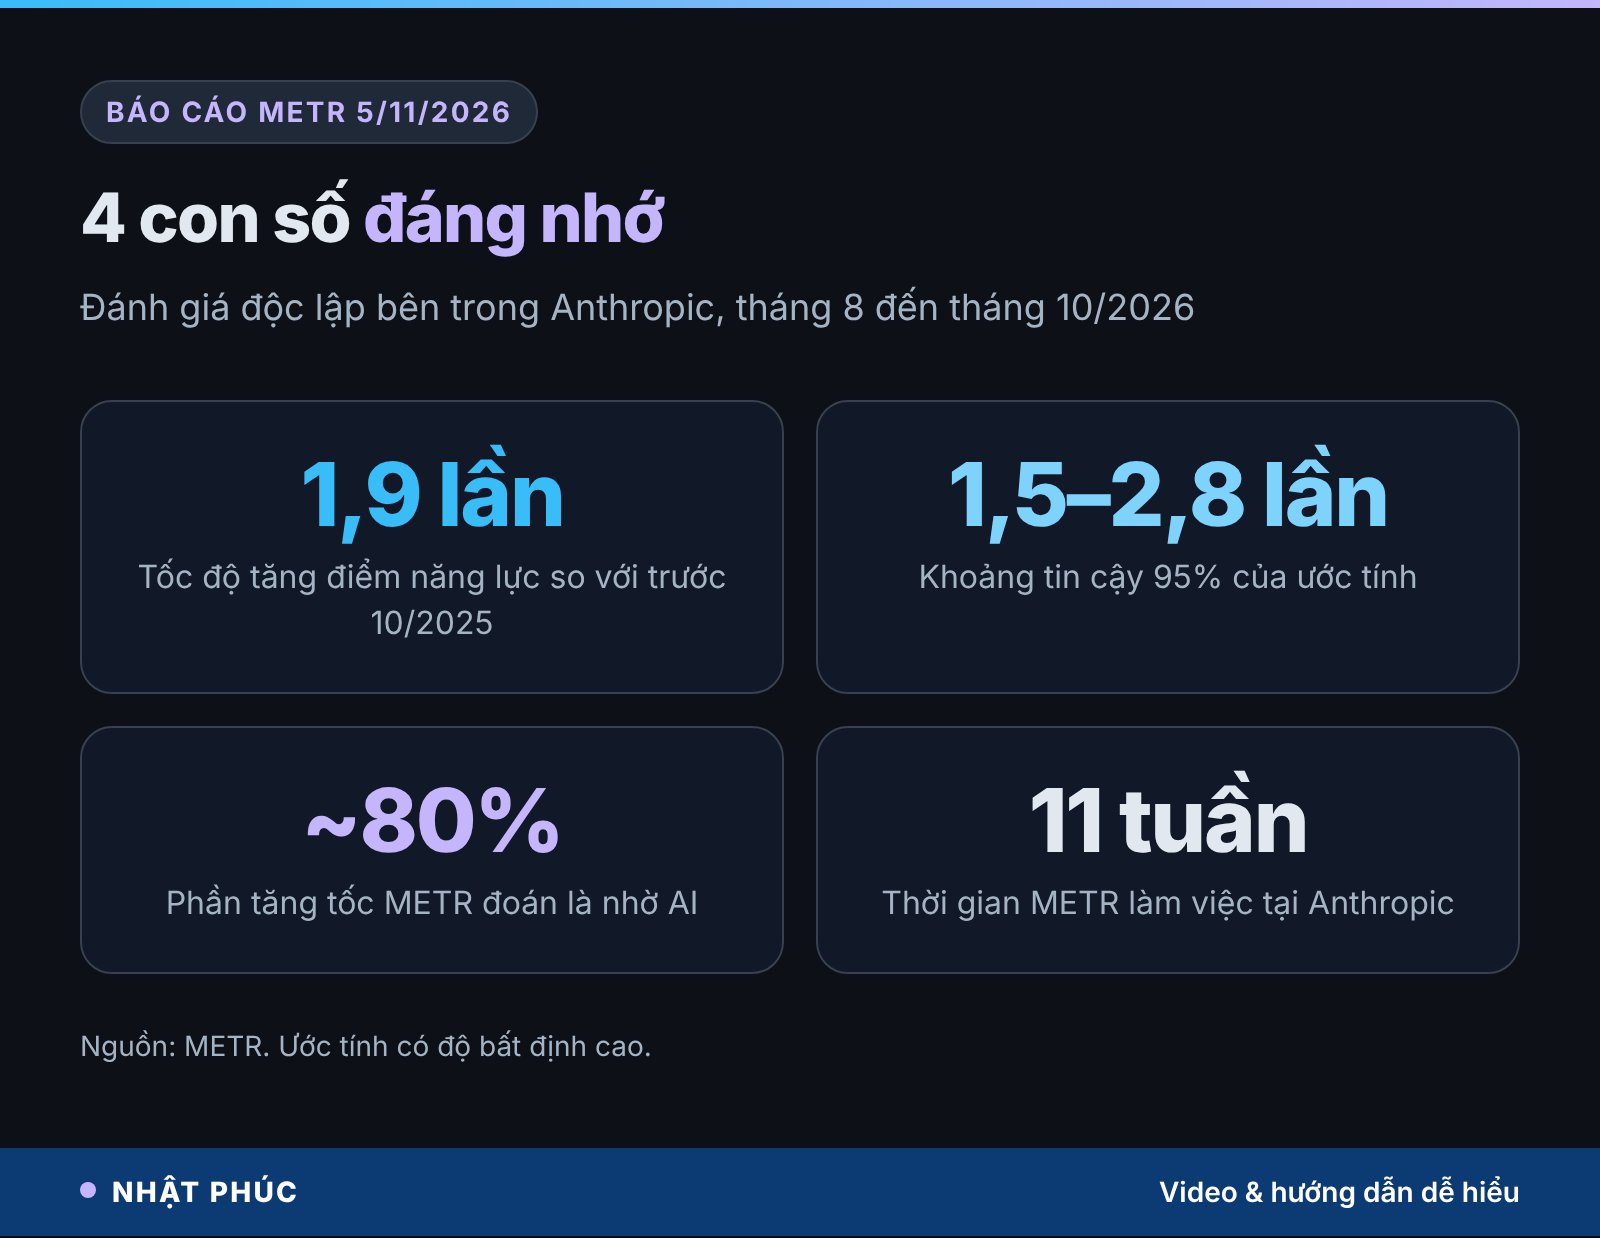
Báo cáo có tên Independent Assessment of AI R&D Acceleration at Anthropic in October 2026, đăng trên trang của METR ngày 5/11/2026. Bốn con số nên nhớ:
- 1,9 lần: tốc độ tăng điểm năng lực từ tháng 10/2025 so với giai đoạn trước đó.
- 1,5–2,8 lần: khoảng tin cậy 95% của con số trên. Tuỳ cách chọn tập benchmark và cách tính, ước tính có thể dao động từ 1,1 đến 2,9 lần.
- Khoảng 80%: phần tăng tốc hiện tại mà METR đoán là nhờ AI, kèm lưu ý độ bất định cao.
- 11 tuần: thời gian METR làm việc tại Anthropic, từ 12/8 đến 29/10/2026.
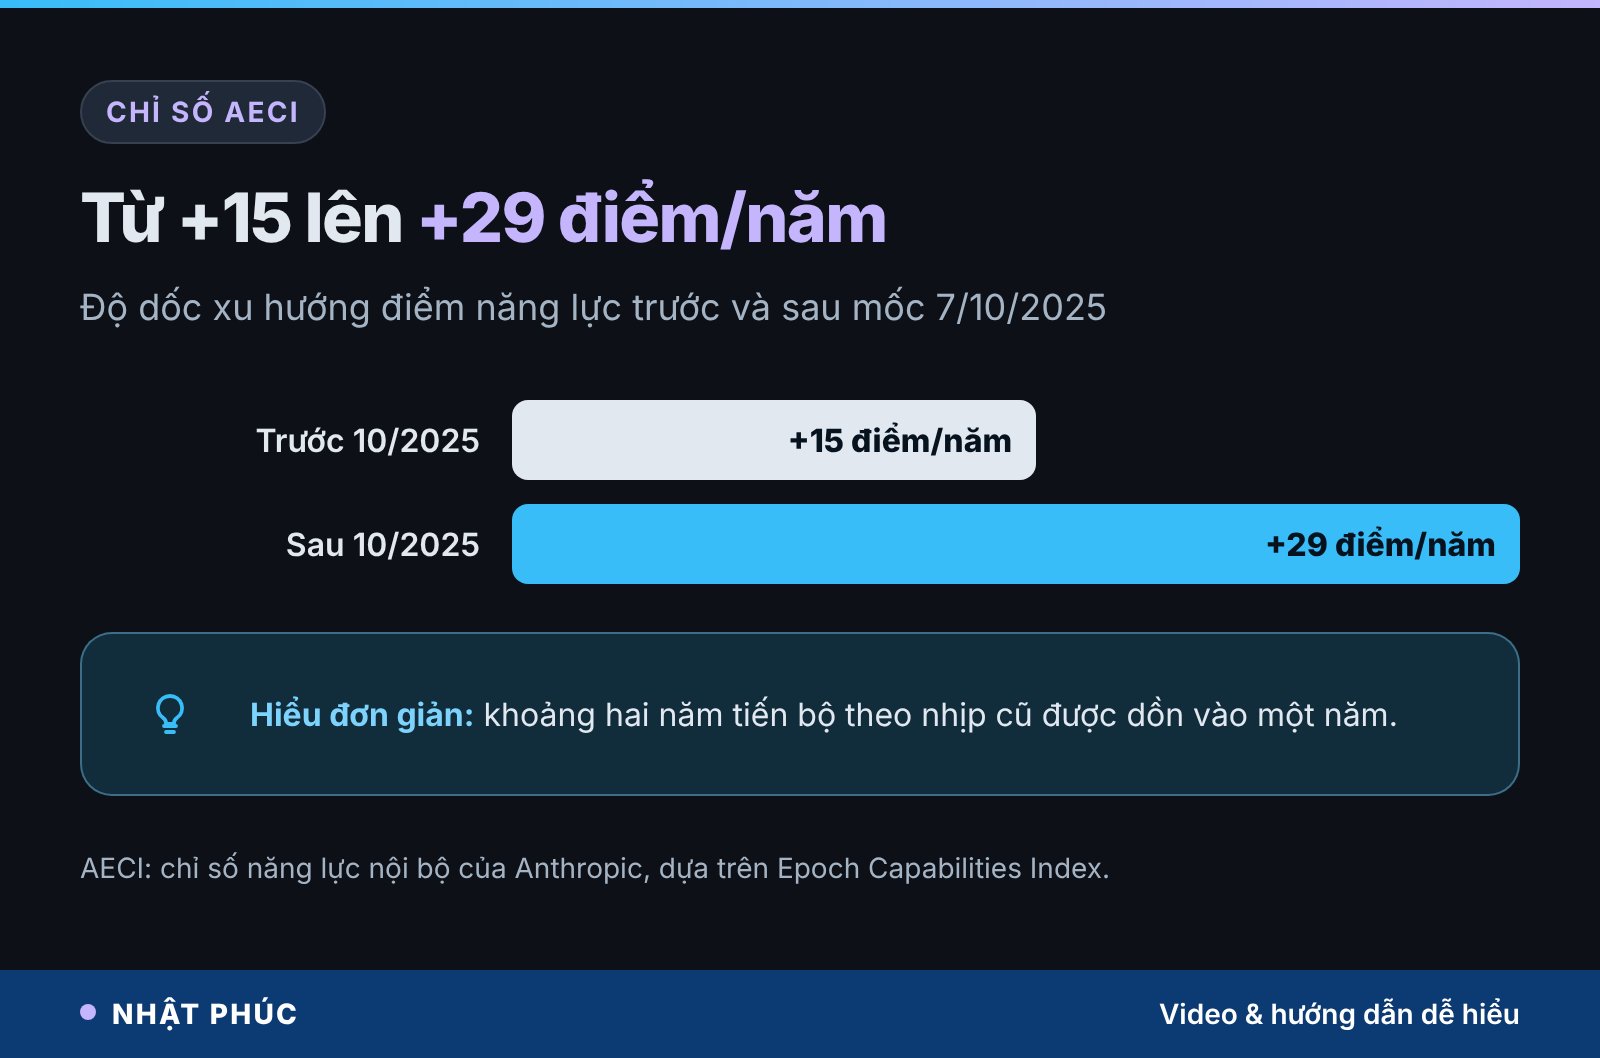
Thước đo được dùng là AECI, phiên bản nội bộ của Anthropic dựa trên Epoch Capabilities Index. Chỉ số này gom điểm của nhiều bài kiểm tra (benchmark) thành một thang năng lực chung. Theo METR, xu hướng đổi độ dốc quanh ngày 7/10/2025: trước đó điểm tăng khoảng 15 điểm mỗi năm, sau đó khoảng 29 điểm mỗi năm. Nói dễ hiểu, Anthropic đạt được khoảng hai năm tiến bộ theo nhịp cũ chỉ trong một năm.
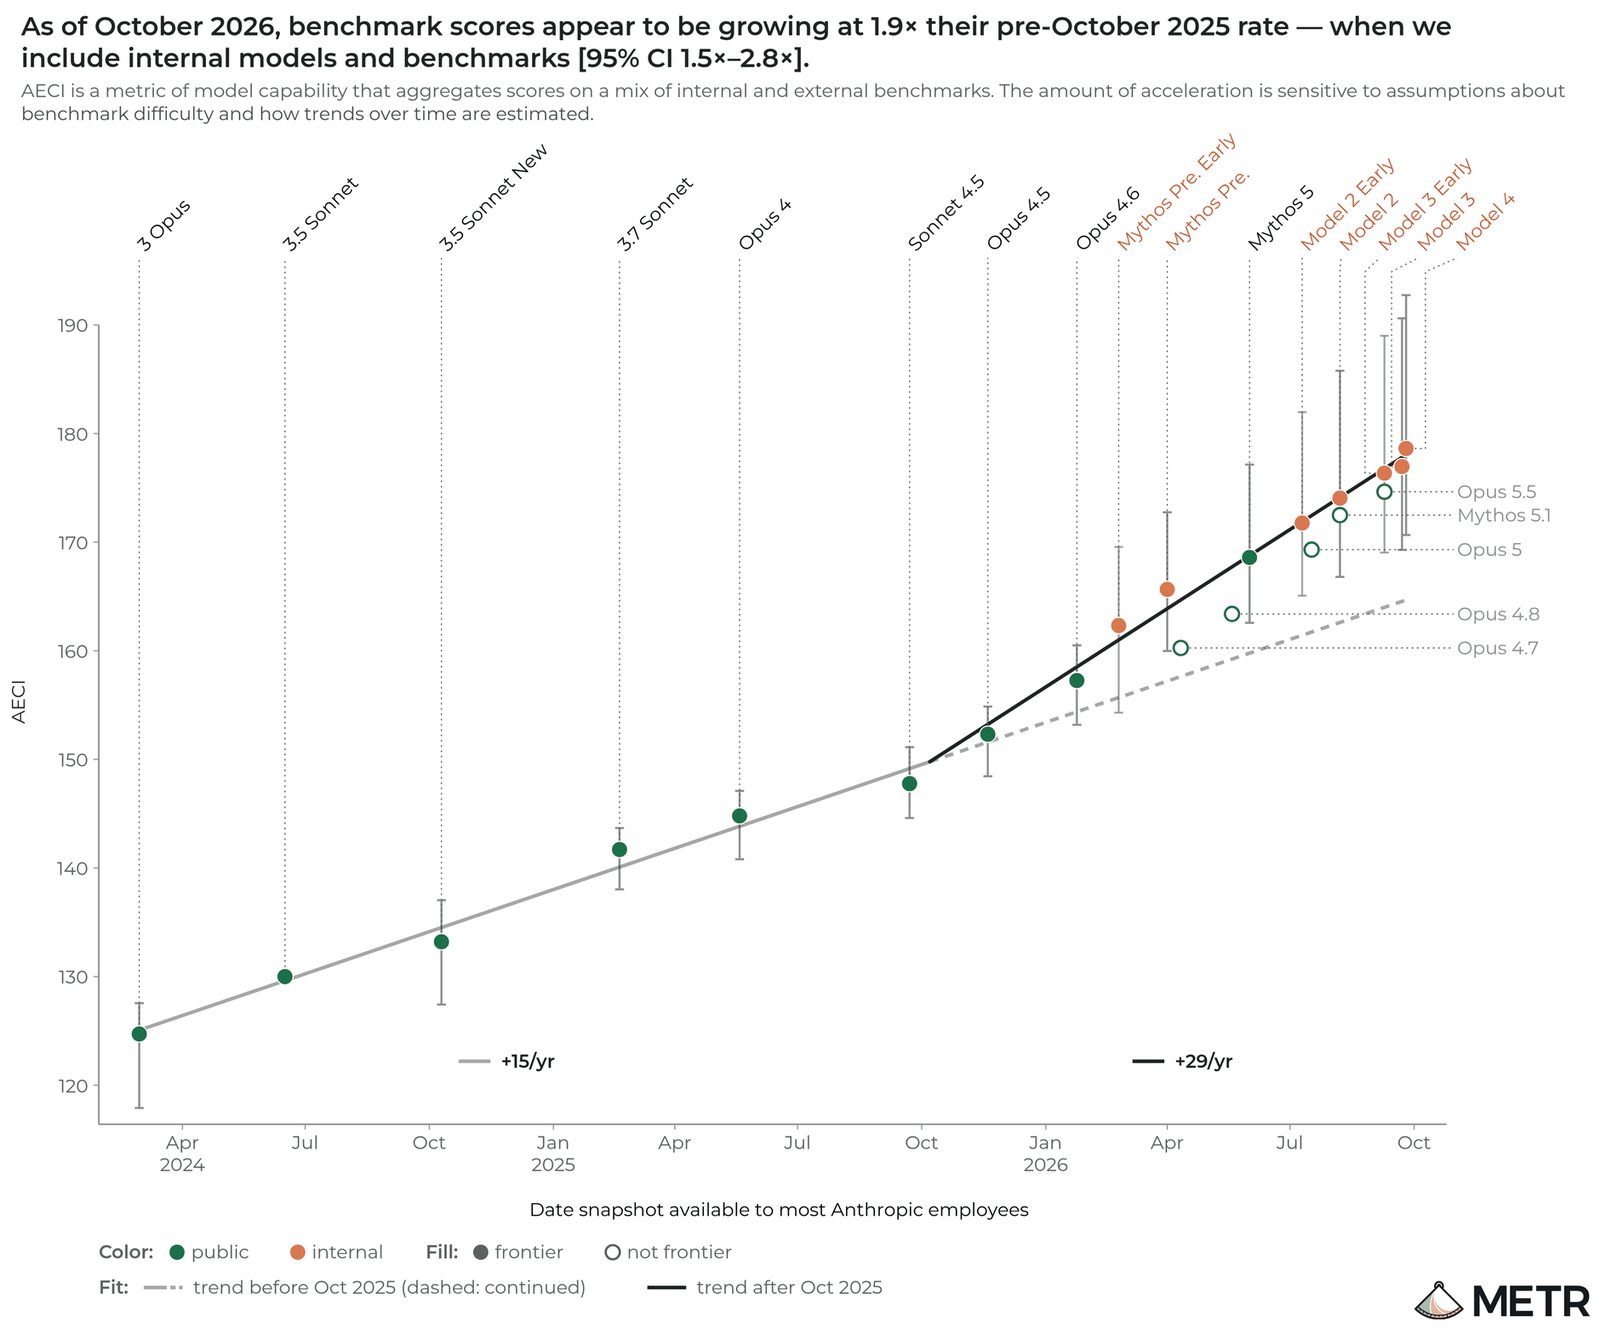
Tính trên toàn bộ bức tranh, METR cho rằng Anthropic nhiều khả năng đang cải thiện năng lực mô hình trên các tác vụ được định nghĩa rõ với tốc độ khoảng gấp đôi giai đoạn 3/2024–10/2025. Họ cũng nói thẳng: nếu con số thật là 1,3 lần hay 3 lần thì cũng không quá bất ngờ.
Vì sao METR cho rằng AI là nguyên nhân chính?
Năng lực một mô hình AI thường đến từ ba thứ: thuật toán, chất lượng dữ liệu và điện toán (sức máy dùng để huấn luyện). Muốn biết vì sao tốc độ tăng, phải loại dần từng nguyên nhân.
Điểm METR tự tin nhất là tăng tốc không đến từ việc đổ thêm điện toán huấn luyện nhanh hơn. Khi nguyên nhân dễ thấy nhất bị loại, các giả thuyết còn lại là thuật toán tốt hơn, dữ liệu tốt hơn, và quan trọng là kỹ sư làm việc nhanh hơn nhờ có Claude hỗ trợ. Dựa trên phỏng vấn và số liệu, METR đoán phần lớn, khoảng 80%, là nhờ AI.
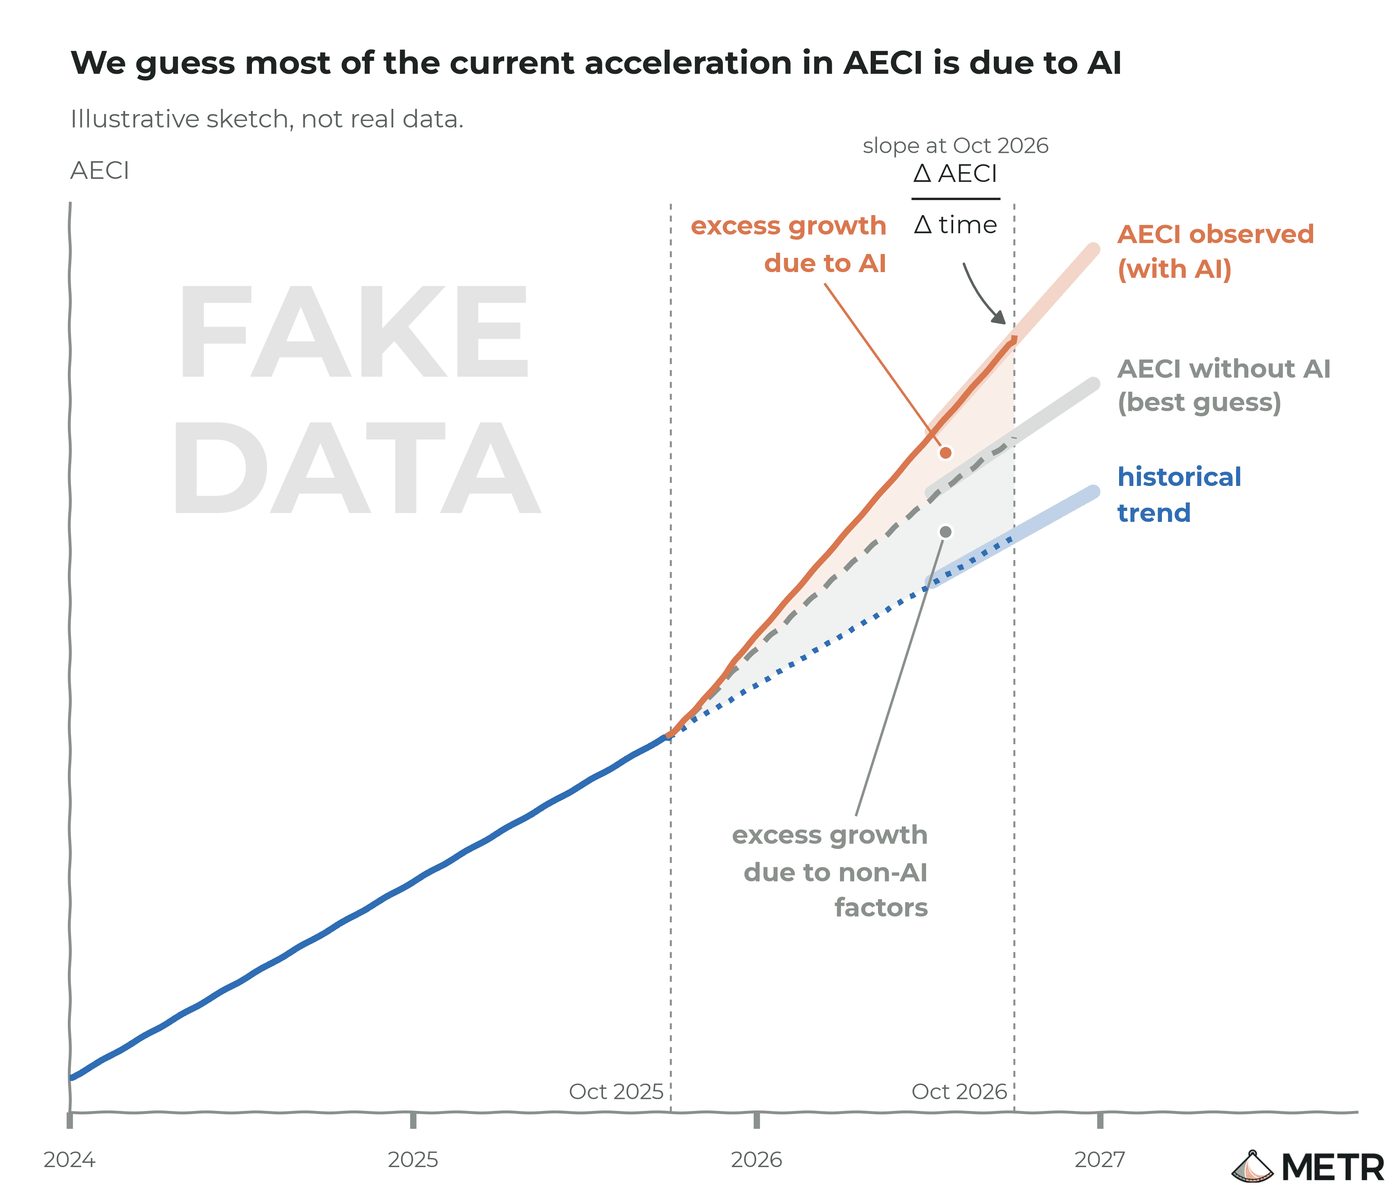
METR cũng không tìm thấy nút thắt nào đủ thuyết phục, như thiếu điện toán, thiếu dữ liệu hay thiếu máy chạy thí nghiệm, có thể kìm tốc độ này trong 12 tháng tới. Tuy nhiên, họ ghi rõ nhận định này có độ tin cậy thấp và quan điểm của nhóm đã thay đổi vài lần trong quá trình làm.
METR đã đo bằng cách nào?
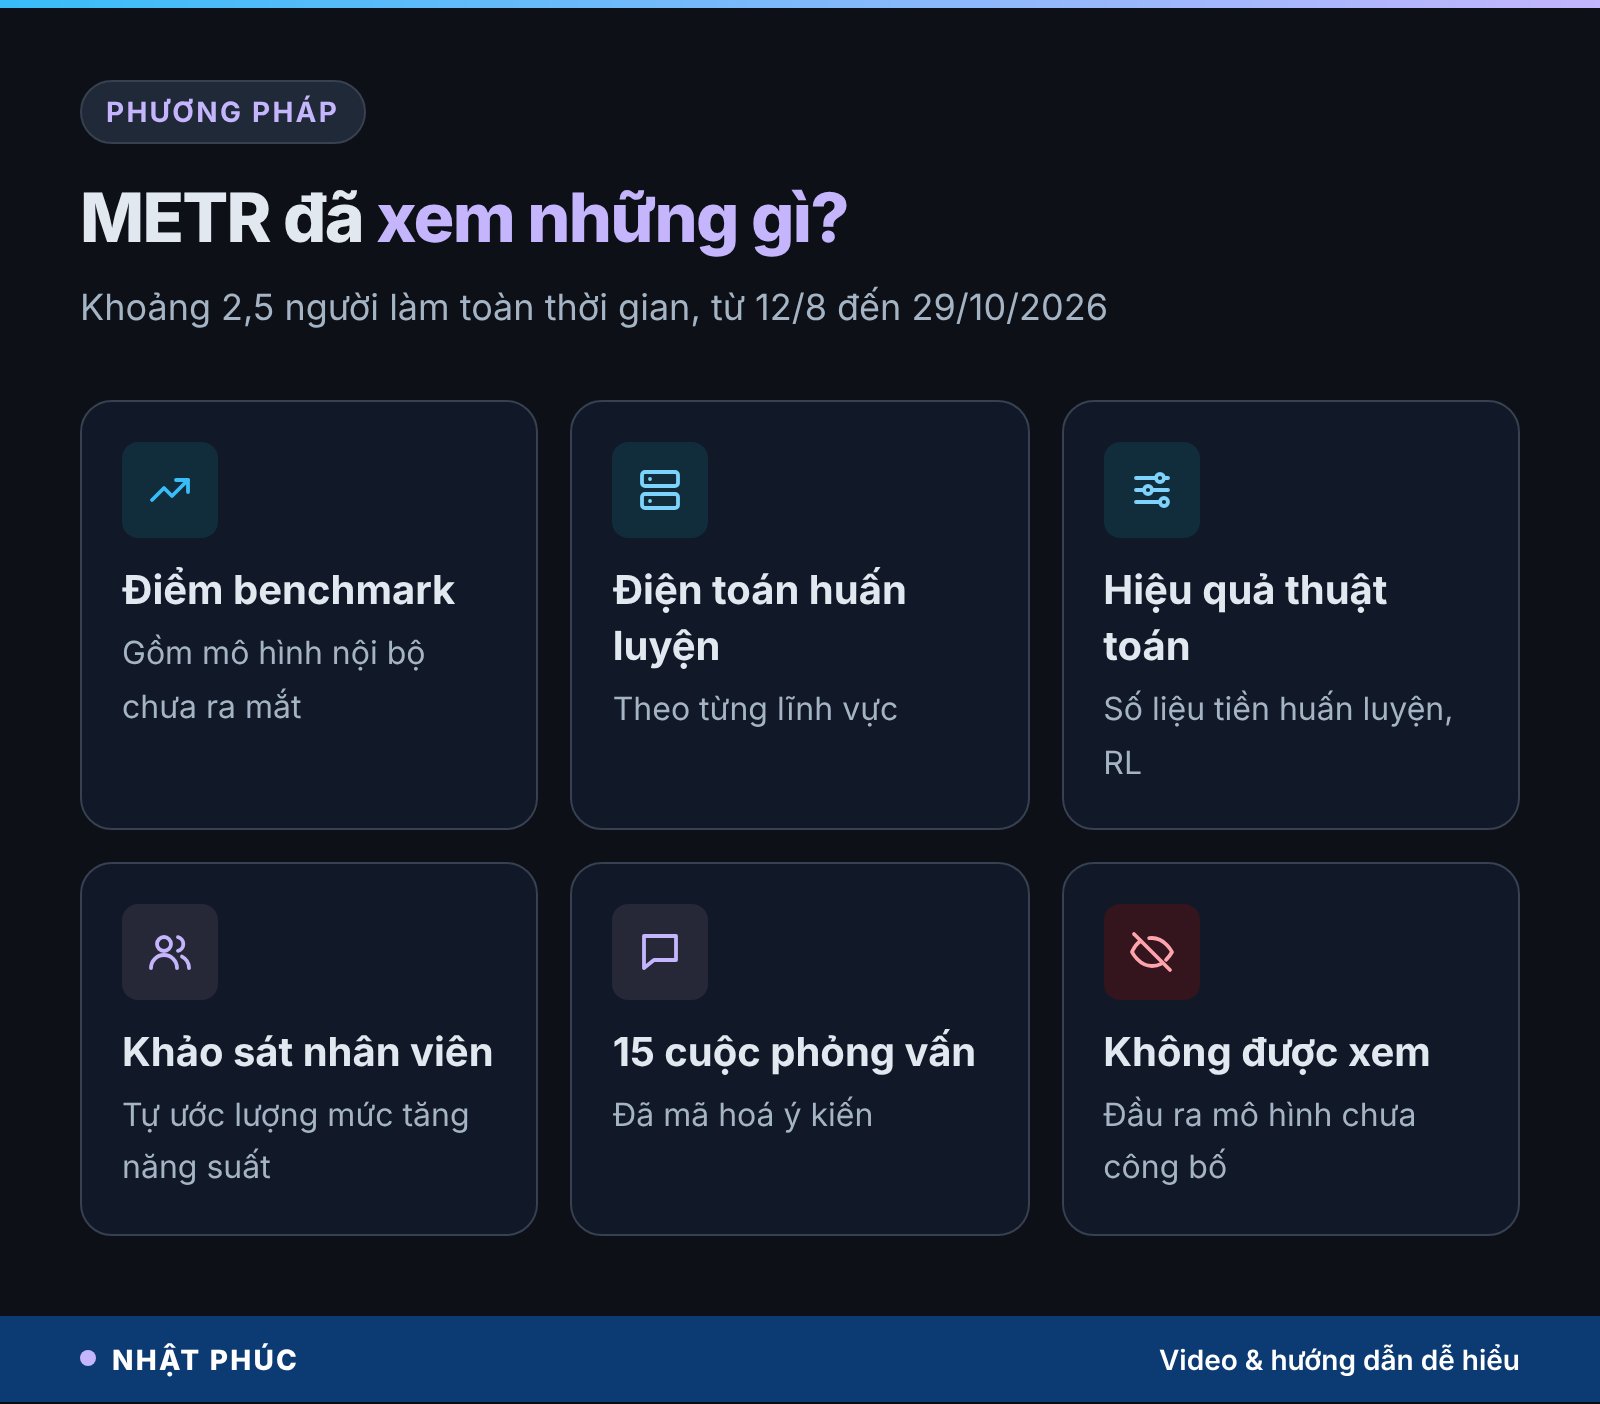
Khoảng 2,5 người làm toàn thời gian của METR làm việc với dữ liệu Anthropic cung cấp. Các nguồn chính gồm: điểm benchmark nội bộ và AECI, số liệu hiệu quả thuật toán ở giai đoạn tiền huấn luyện và học tăng cường (RL), điện toán huấn luyện, số lượng nhân sự, số dòng mã, chi phí chạy agent, khảo sát tự báo cáo và khoảng 15 cuộc phỏng vấn.
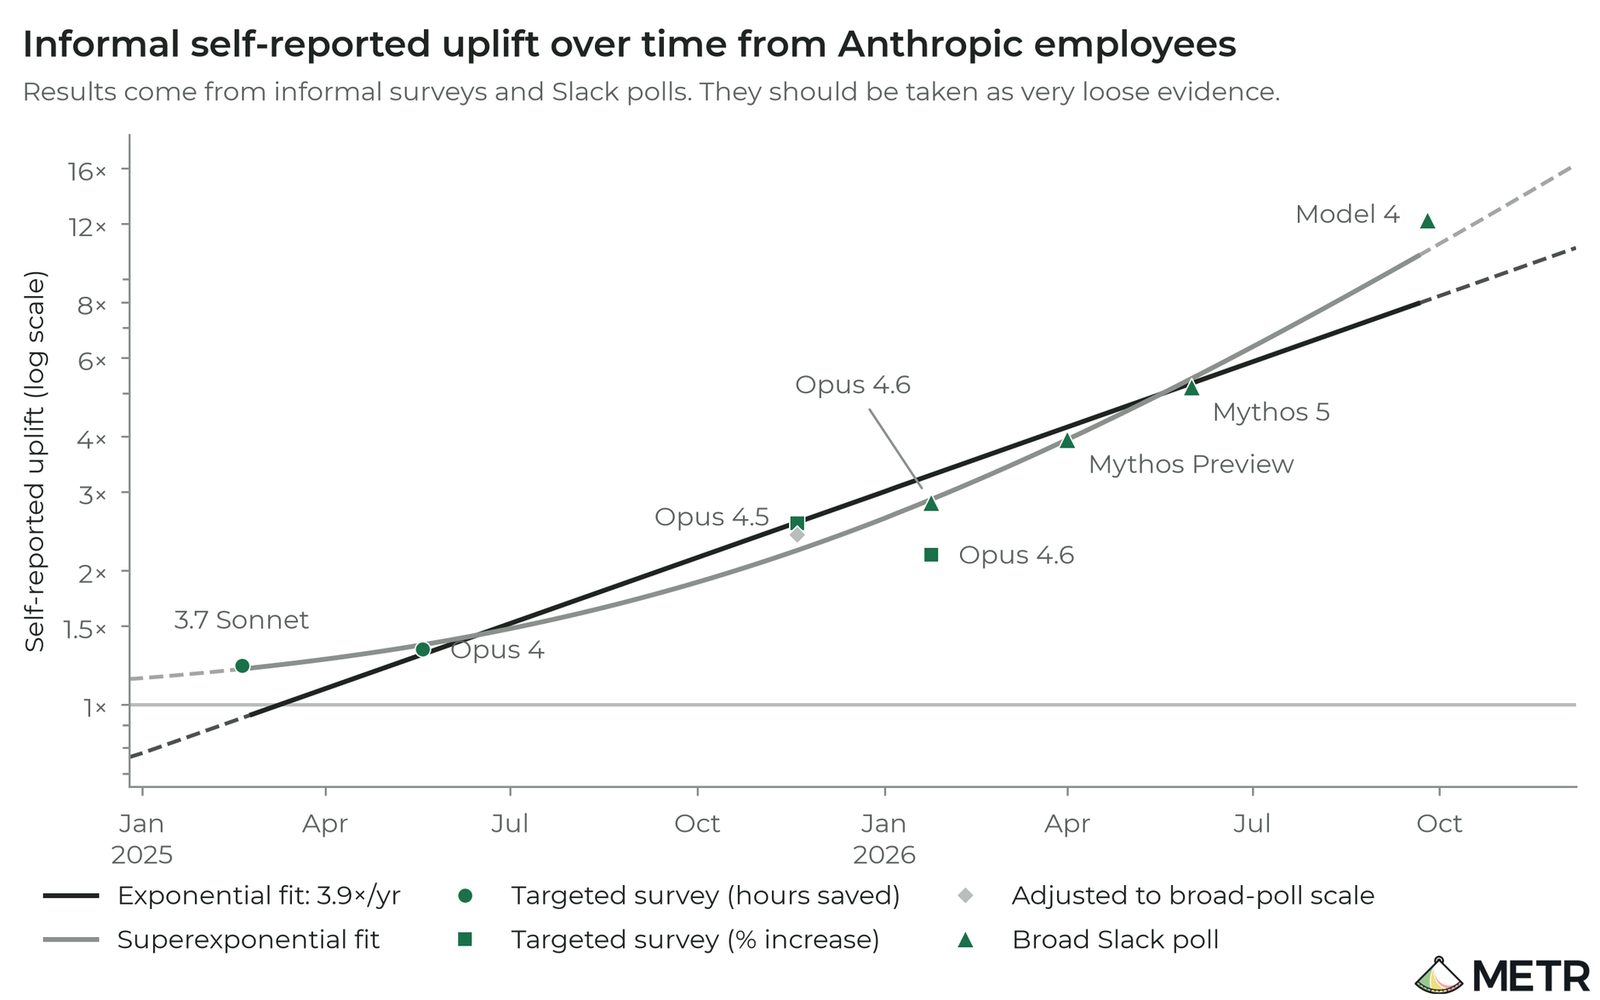
Một nguồn thú vị là khảo sát nhân viên. Người làm ở Anthropic tự ước lượng năng suất tăng thêm bao nhiêu khi dùng mô hình nội bộ. Con số tự báo cáo tăng từ khoảng 1,2 lần đầu năm 2025 lên khoảng 12 lần với mô hình nội bộ mới nhất, được gọi là Model 4. METR nhấn mạnh đây là bằng chứng “rất lỏng”, vì đến từ khảo sát không chính thức và bình chọn trên Slack.
Phỏng vấn cũng cho thấy ý kiến chưa thống nhất. Trong 15 cuộc phỏng vấn đã mã hoá, 2 người ủng hộ rõ giả thuyết tăng tốc, 3 người nghiêng về ủng hộ, 4 người không rõ, không ai nghiêng về phản đối và 2 người phản đối.
Giới hạn và phần bị che
Đây là phần nhiều người trong giới nghiên cứu chú ý nhất. Anthropic có quyền biên tập báo cáo trước khi công bố và đã che nhiều bằng chứng quan trọng: chỉ số trung gian, ước tính hiệu quả thuật toán, số đo đầu vào nghiên cứu, chi tiết nút thắt, dự báo và cả tên một số benchmark. Lý do Anthropic đưa ra là tránh lộ thông tin bí mật có thể giúp đối thủ tăng tốc. METR thừa nhận điều này khiến người đọc khó tự kiểm tra lập luận.
METR cũng không được xem mẫu đầu ra của mô hình chưa công bố. Phần xác minh xem điện toán được chia cho năng lực hay cho an toàn ra sao đã bị huỷ giữa chừng. Ngoài ra, mô hình Model 4 đã đạt trên 50% ở cả 15 benchmark được dùng, tức các bài kiểm tra bắt đầu “bão hoà” và khó phân biệt tiến bộ tiếp theo.
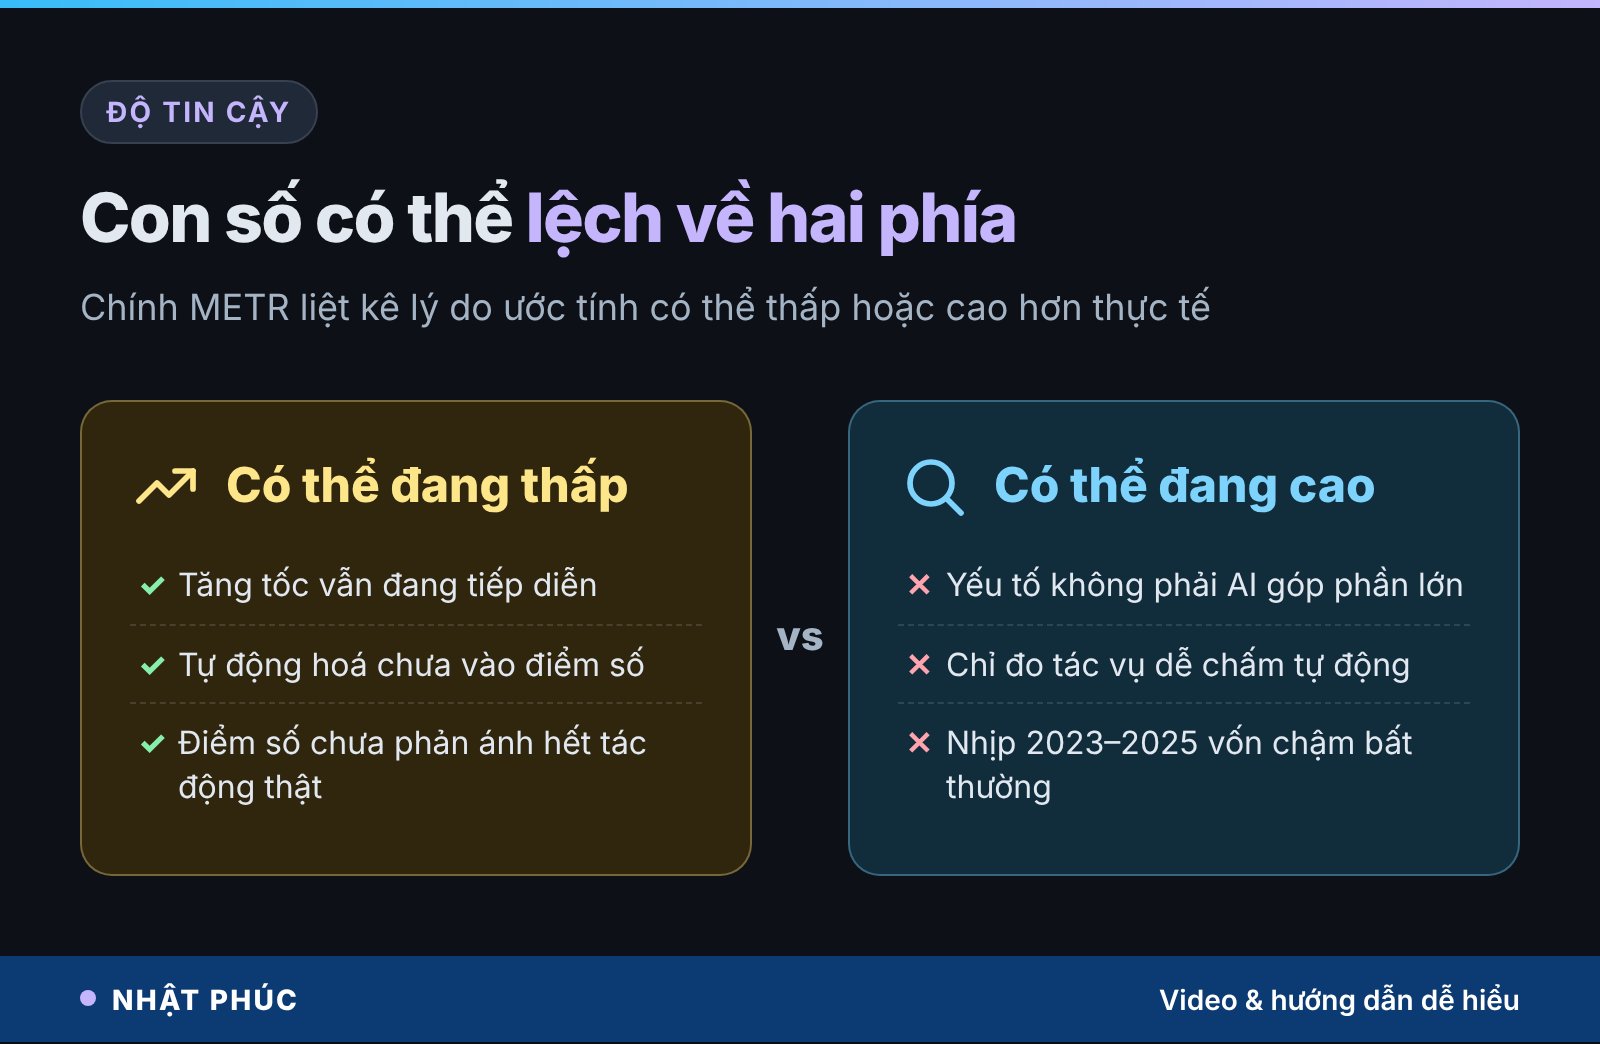
Theo METR, con số có thể đang thấp hơn thực tế vì tăng tốc có thể vẫn tiếp diễn và tác động của tự động hoá chưa kịp vào điểm số. Ngược lại, nó có thể cao hơn thực tế vì các yếu tố không phải AI có thể đóng góp nhiều, AECI chỉ đo tác vụ dễ chấm tự động, và nhịp tiến bộ 2023–2025 của Anthropic vốn chậm bất thường nên làm mức tăng trông lớn hơn.
Bối cảnh: lời kêu gọi giảm tốc và đợt IPO
Báo cáo ra đời trong một bối cảnh khá đặc biệt. Ngày 12/9/2026, CEO Anthropic Dario Amodei đăng bài “We Must Pace the Frontier” trên trang cá nhân, kêu gọi ngành AI làm chậm tốc độ cải thiện năng lực mô hình. Ông định nghĩa AI tự cải tiến là khả năng ngày càng lớn của AI trong việc xây dựng thế hệ AI tiếp theo, và cảnh báo nếu không kiểm soát, nó có thể vượt khả năng hiểu và kiểm soát của con người. Một trong các đề xuất của ông là để đánh giá viên bên ngoài có quyền truy cập như nhân viên, và METR được nêu tên.
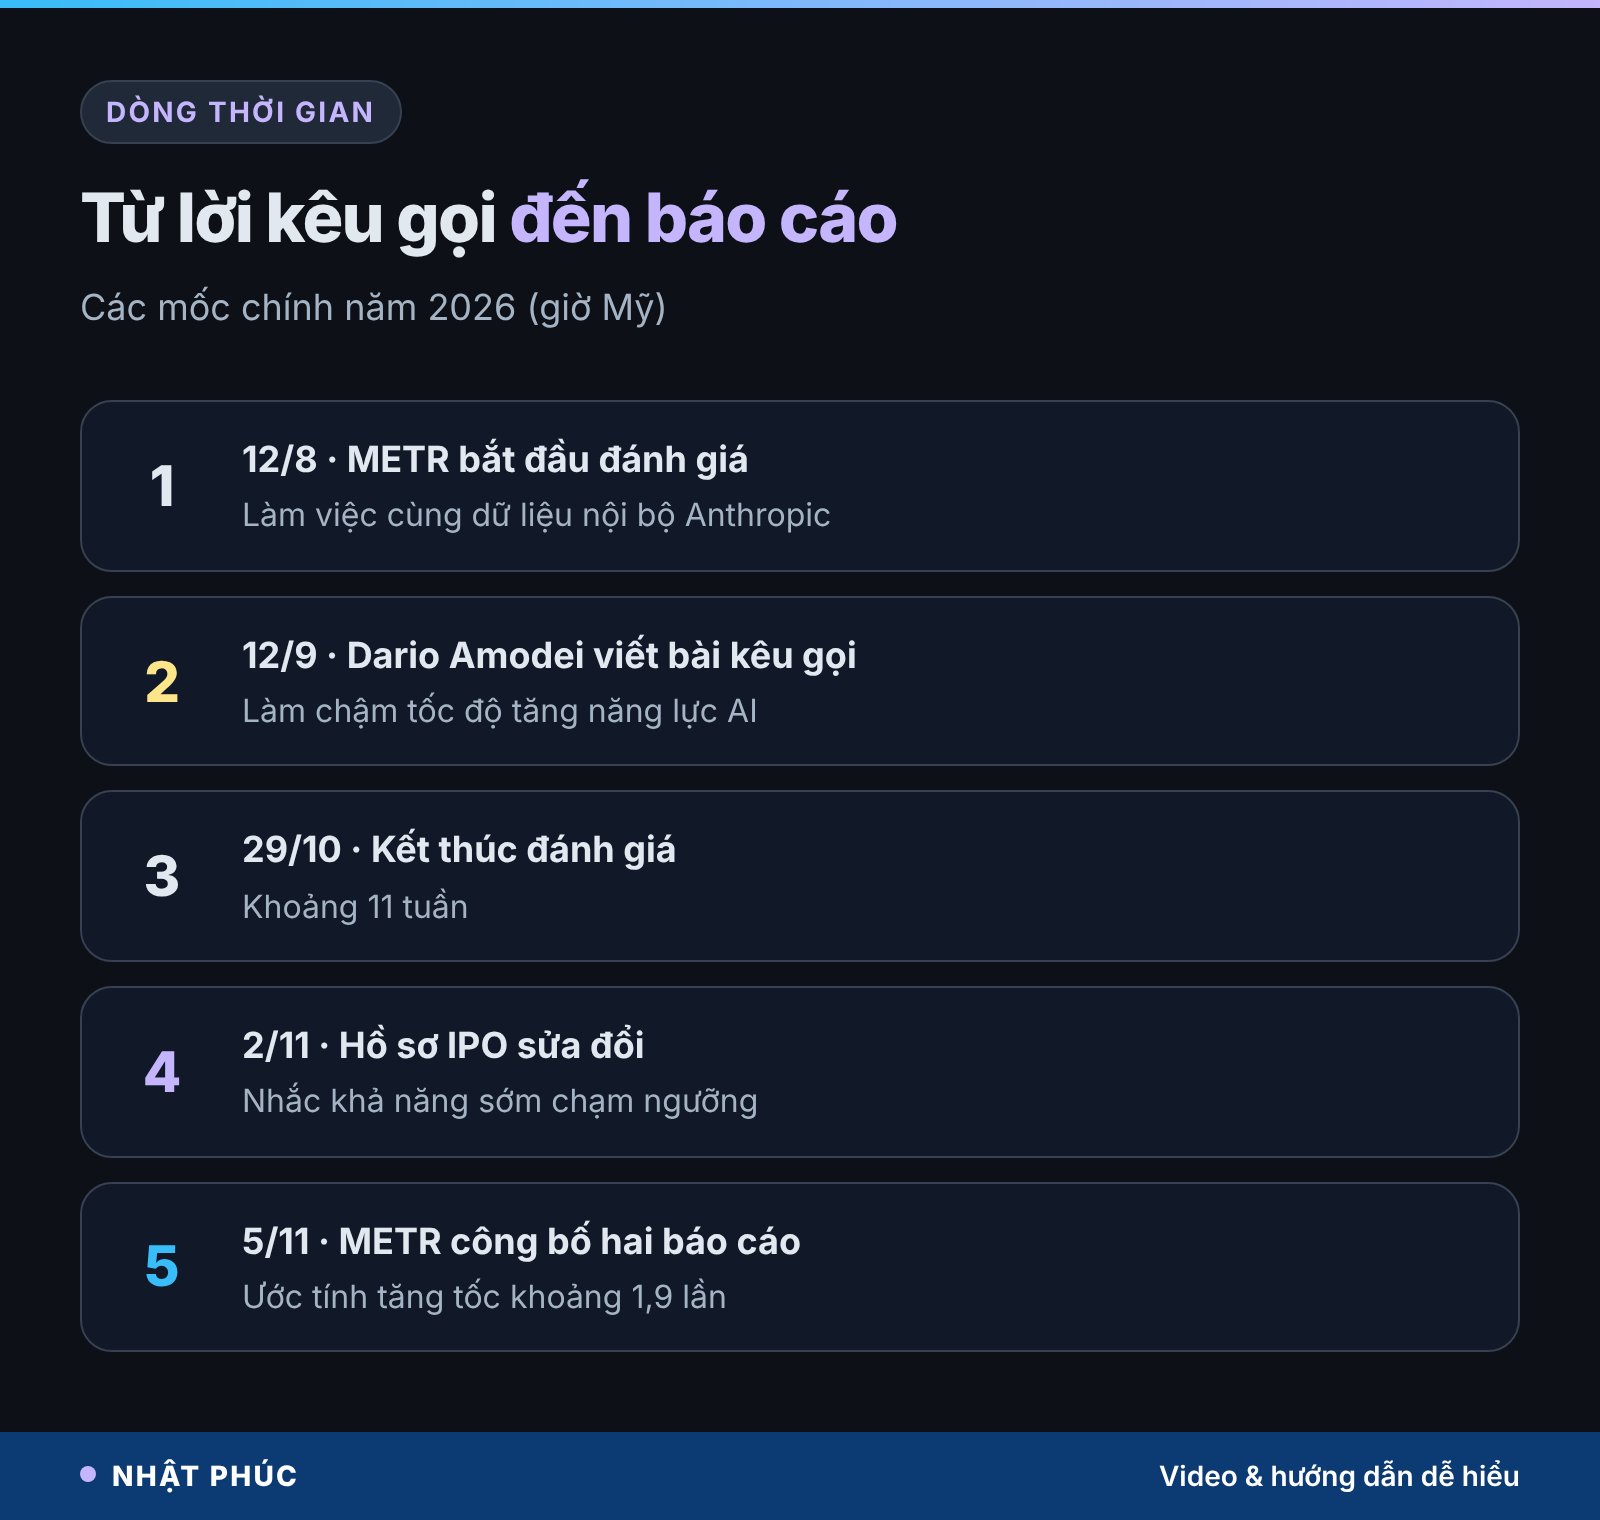
Chính sách mở rộng có trách nhiệm (Responsible Scaling Policy, RSP) của Anthropic có một ngưỡng liên quan đến mức tăng tốc nghiên cứu gấp 2 lần. Báo cáo rủi ro tháng 8/2026 của Anthropic cho rằng mức tăng tốc vẫn dưới 2 lần. Cùng ngày 5/11, METR đăng báo cáo thứ hai nhận xét lập luận “chưa vượt ngưỡng” đó bị nói quá, dù METR cũng cho biết đánh giá chính của họ không xoay quanh các ngưỡng này.
Ở góc tài chính, AP cho biết Anthropic dự kiến lên sàn chứng khoán Mỹ vào cuối tháng 11/2026. Hồ sơ IPO sửa đổi ngày 2/11/2026 có đoạn nói các mô hình tương lai có thể sớm đáp ứng định nghĩa về mức tăng tốc này. Bài viết chỉ tóm lược thông tin công khai, không phải khuyến nghị mua hay bán cổ phiếu nào.
Hiểu lầm phổ biến
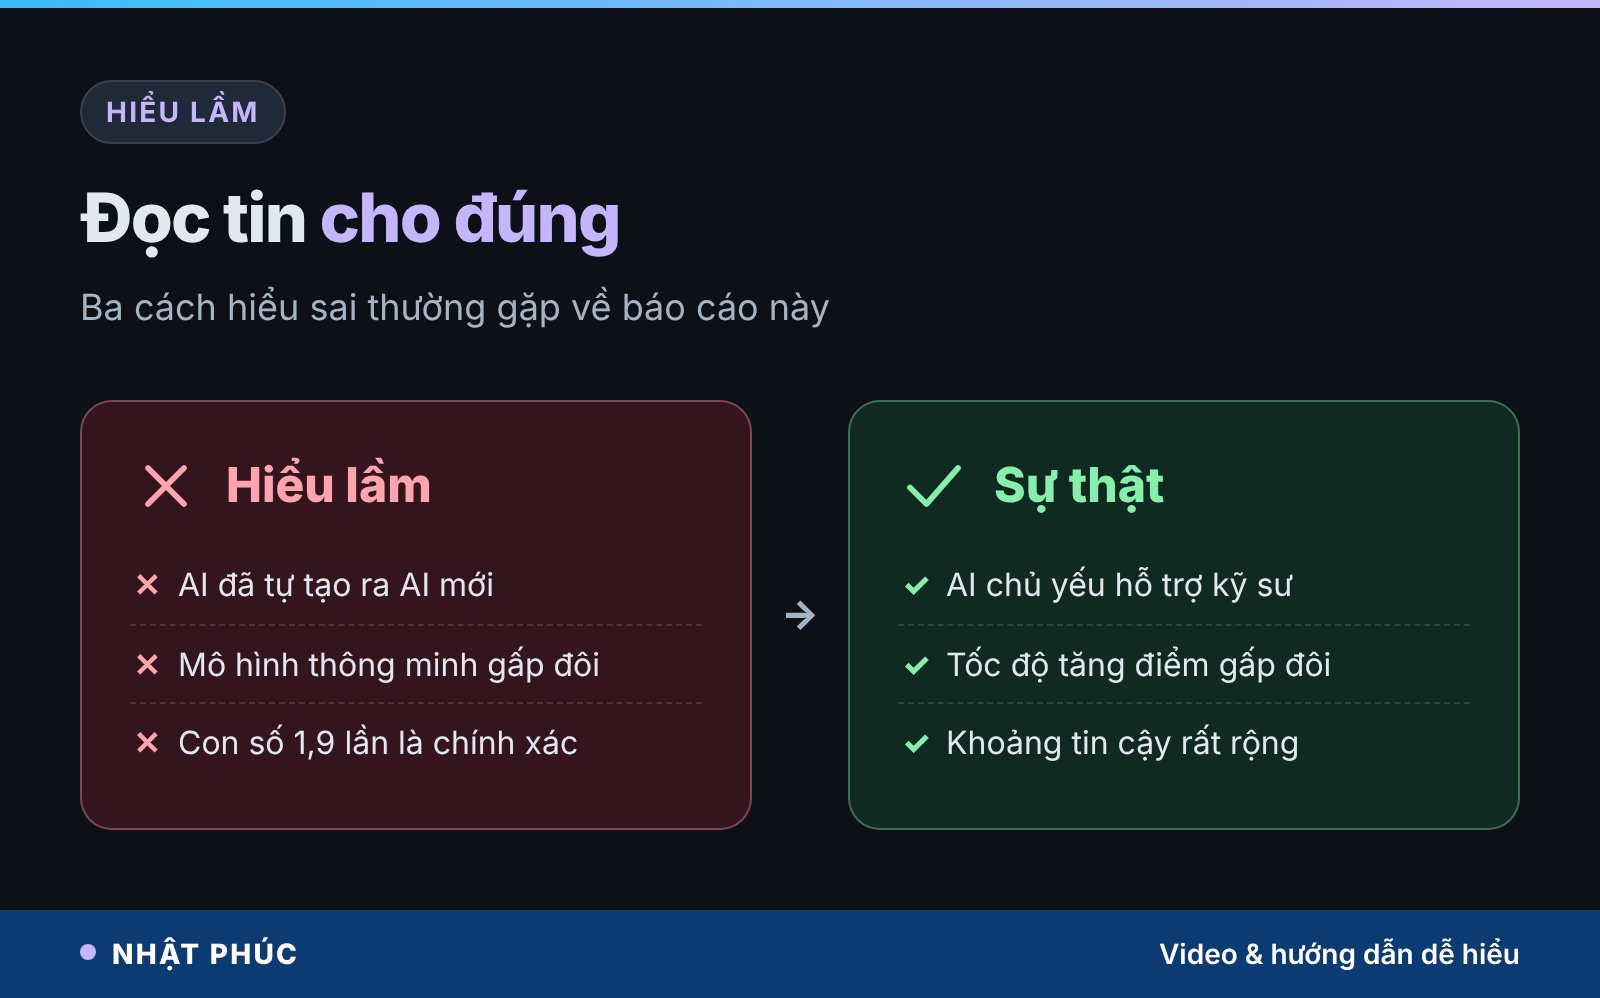
Tin “AI cải tiến nhanh gấp đôi” rất dễ bị đọc lệch. Ba hiểu lầm hay gặp:
- “AI đã tự làm ra AI mới”: chưa đúng. AI chủ yếu tăng tốc cho kỹ sư, chưa tự đảm nhận phần cốt lõi.
- “Claude thông minh gấp đôi”: sai. Con số là tốc độ tăng điểm năng lực, không phải độ thông minh.
- “1,9 lần là con số chính xác”: khoảng tin cậy từ 1,5 đến 2,8 lần, và nhiều bằng chứng đã bị che.
Các hãng AI khác thì sao?
METR cũng thử tính khi gộp các mô hình công khai của hãng khác như OpenAI, Google, xAI vào cùng thang đo. Khi đó, điểm benchmark ở “biên tiên phong” của cả ngành tăng khoảng 1,4 lần so với nhịp trước tháng 10/2025. Lưu ý là METR không thấy được mô hình nội bộ chưa ra mắt của các hãng khác, nên so sánh này thiên về Anthropic.
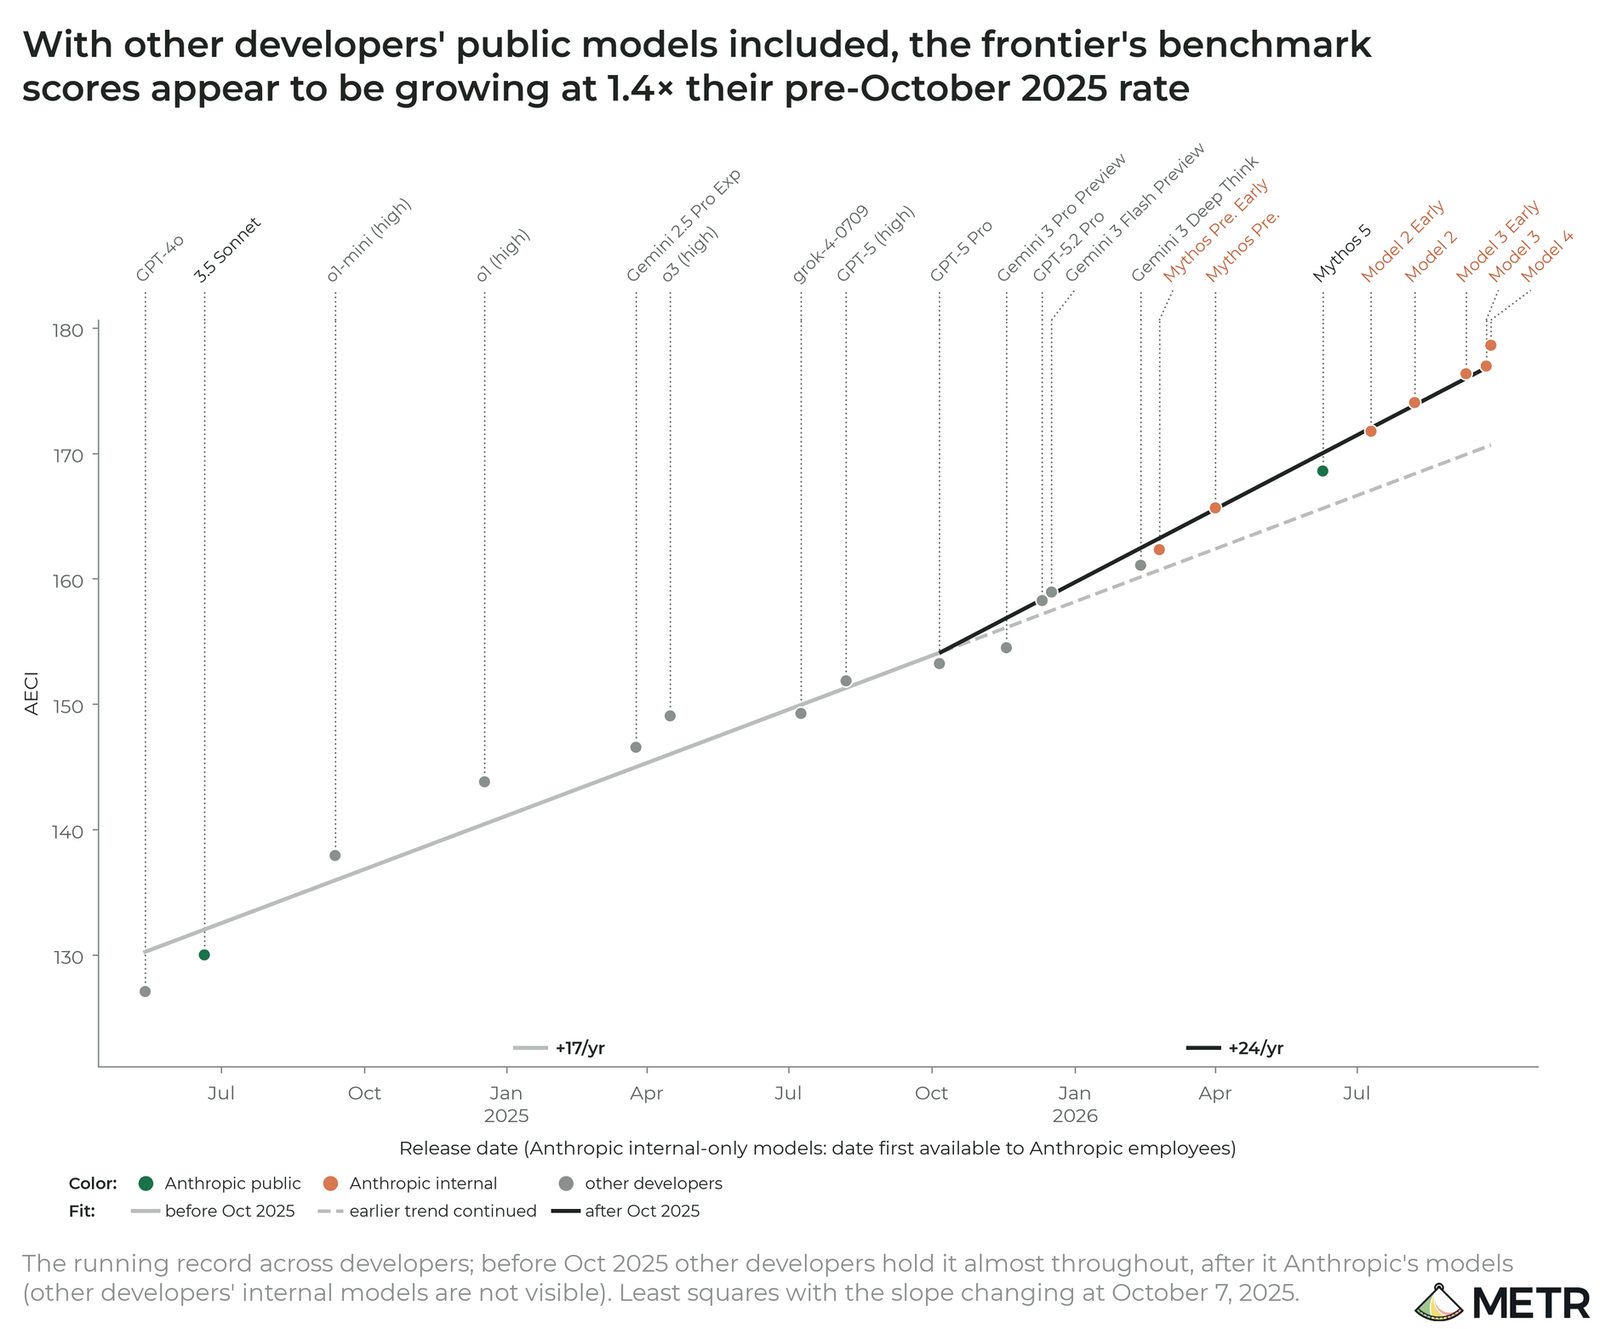
Nói cách khác, báo cáo không chứng minh cả ngành đang tăng tốc gấp đôi. Nó cho thấy một công ty cụ thể, với dữ liệu nội bộ cụ thể, đang tiến nhanh hơn nhịp lịch sử của chính mình.
Người dùng ở Việt Nam nên hiểu và làm gì?
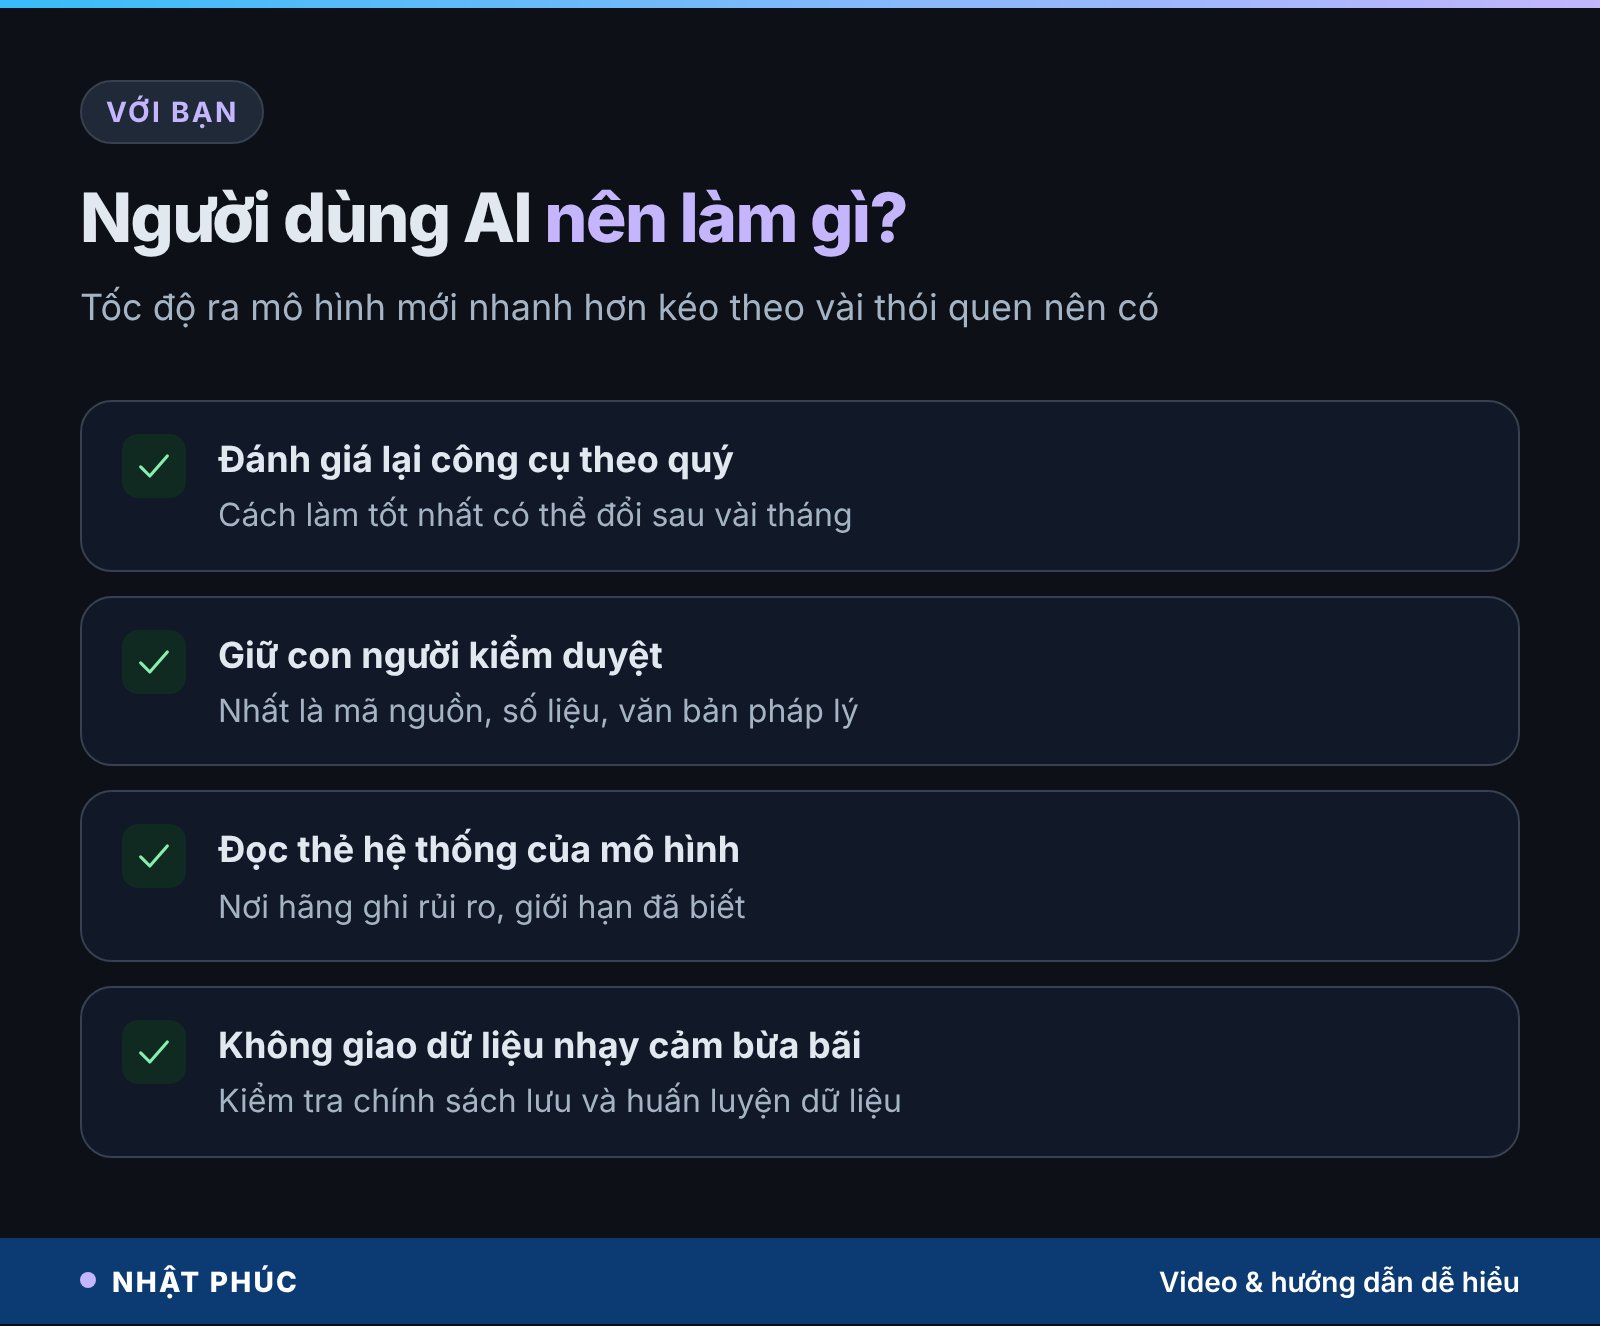
Bạn không cần lo lắng theo kiểu phim khoa học viễn tưởng, nhưng nên chuẩn bị cho một điều thực tế: công cụ AI sẽ đổi nhanh hơn. Thủ thuật dùng tốt hôm nay có thể lỗi thời sau vài tháng. Bốn thói quen nên có:
1. Đánh giá lại công cụ theo quý
Mỗi quý, thử lại vài việc quen thuộc (viết email, tóm tắt tài liệu, viết mã) trên phiên bản mới nhất để biết nên giữ hay đổi cách làm.
2. Luôn giữ con người kiểm duyệt
Mô hình mạnh hơn không có nghĩa là không sai. Với mã nguồn, số liệu tài chính hay văn bản pháp lý, hãy tự kiểm lại trước khi dùng.
3. Đọc thẻ hệ thống của mô hình
Các hãng lớn công bố thẻ hệ thống (system card) ghi rõ rủi ro và giới hạn đã biết. Đây là tài liệu đáng đọc hơn quảng cáo.
4. Cẩn trọng với dữ liệu nhạy cảm
Trước khi đưa tài liệu công việc vào chatbot, xem chính sách lưu trữ và dùng dữ liệu để huấn luyện. Bài cửa sổ ngữ cảnh là gì giúp bạn hiểu AI “nhớ” thông tin ra sao.
Ở Việt Nam, Luật Trí tuệ nhân tạo số 134/2025/QH15 đã đặt nền móng pháp lý cho việc quản lý rủi ro AI. Những báo cáo độc lập như của METR là ví dụ cho thấy vì sao việc đánh giá bởi bên thứ ba ngày càng được coi trọng trên thế giới.
Câu hỏi thường gặp
AI tự cải tiến có nghĩa là AI đã tự tạo ra AI mới?
Chưa. Theo METR, AI hiện chủ yếu hỗ trợ kỹ sư: viết mã, chạy thí nghiệm, phân tích kết quả. AI chưa thể đóng góp tự chủ thật sự quan trọng vào phần cốt lõi của huấn luyện, dù nhà nghiên cứu Anthropic nói đã thấy dấu hiệu điều đó có thể sớm thay đổi.
Con số 1,9 lần nghĩa là gì?
Đó là tỷ lệ giữa tốc độ tăng điểm năng lực AECI sau tháng 10/2025 và tốc độ trước đó. Trước tăng khoảng 15 điểm mỗi năm, sau tăng khoảng 29 điểm mỗi năm. Khoảng tin cậy 95% từ 1,5 đến 2,8 lần.
Tại sao Anthropic lại cho người ngoài vào kiểm tra?
Anthropic mời METR vào khi đang chuẩn bị IPO, và CEO Dario Amodei từng đề xuất các phòng thí nghiệm nên cho đánh giá viên bên ngoài quyền truy cập như nhân viên. Tuy vậy, Anthropic vẫn giữ quyền biên tập và đã che nhiều bằng chứng.
Báo cáo có áp dụng cho ChatGPT hay Gemini không?
Không trực tiếp. METR chỉ có dữ liệu nội bộ của Anthropic. Khi gộp mô hình công khai của các hãng khác, mức tăng ở biên tiên phong là khoảng 1,4 lần, nhưng không thấy được mô hình nội bộ của họ.
Người dùng phổ thông có bị ảnh hưởng gì?
Ảnh hưởng dễ thấy nhất là mô hình mới ra nhanh hơn, tính năng thay đổi thường xuyên hơn. Bạn nên cập nhật cách dùng định kỳ, giữ thói quen kiểm tra kết quả và đọc chính sách dữ liệu trước khi dùng cho công việc.
Kết luận
Báo cáo của METR là lần đầu một tổ chức độc lập đo được, dù còn thô, hiện tượng AI tự cải tiến bên trong một công ty AI hàng đầu. Con số khoảng gấp đôi rất đáng chú ý, nhưng đi kèm khoảng sai số rộng, nhiều bằng chứng bị che và bối cảnh IPO nhạy cảm. Cách đọc hợp lý nhất là coi đây là tín hiệu sớm, không phải kết luận cuối cùng.
Bạn nghĩ sao về việc AI giúp làm ra AI: hào hứng hay lo ngại? Hãy để lại bình luận bên dưới và theo dõi Nhật Phúc để cập nhật những thay đổi quan trọng của thế giới AI theo cách dễ hiểu nhất.