Một tài xế mới thường cần vài chục giờ tập lái và vài năm va chạm thực tế mới thật sự “lên tay”. Vậy một chiếc xe không có người cầm lái thì học bằng cách nào? Hiểu xe tự lái học lái như thế nào giúp bạn đánh giá tỉnh táo hơn những lời quảng cáo về xe thông minh, và hiểu vì sao các hãng vẫn phải chạy thử hàng trăm triệu kilômét ngoài đường thật.
Câu chuyện không chỉ là “cho máy xem thật nhiều video”. Phía sau là ba nguồn dữ liệu đan xen: dữ liệu thật ghi từ xe chạy ngoài đường, thế giới mô phỏng nơi xe có thể “đâm” bao nhiêu lần cũng được, và dữ liệu tổng hợp do chính AI tạo ra. Mỗi nguồn có cái hay, và cũng có một rủi ro rất đáng để ý.
Câu trả lời ngắn: Xe tự lái học bằng cách cho các mô hình AI xem lượng lớn dữ liệu cảm biến đã được gán nhãn từ xe chạy thật, rồi luyện thêm trong mô phỏng và dữ liệu tổng hợp để gặp những tình huống hiếm. Dữ liệu thật vẫn là “mỏ neo”: nếu học quá nhiều từ dữ liệu giả, hệ thống có thể quên dần những tình huống hiếm ngoài đời.
Điểm xuất phát của bài này là một thí nghiệm về chữ viết. Trong video của kênh, bạn sẽ thấy một mô hình ngôn ngữ được cho học đi học lại từ chữ do chính AI viết, và sau 9 vòng thì một đoạn văn về kiến trúc nhà thờ biến thành danh sách thỏ rừng. Hiện tượng đó gọi là “sụp đổ mô hình”. Ngành xe tự lái cũng đang dùng ngày càng nhiều dữ liệu do AI tạo ra để luyện xe, nên bài học ấy áp dụng rất trọn. Hãy xem video về hiện tượng sụp đổ mô hình khi AI học dữ liệu AI trước khi đọc tiếp.
Tóm tắt nhanh
- Xe tự lái không được lập trình từng tình huống bằng tay; phần lớn kỹ năng nhìn, đoán và lên kế hoạch được học từ dữ liệu.
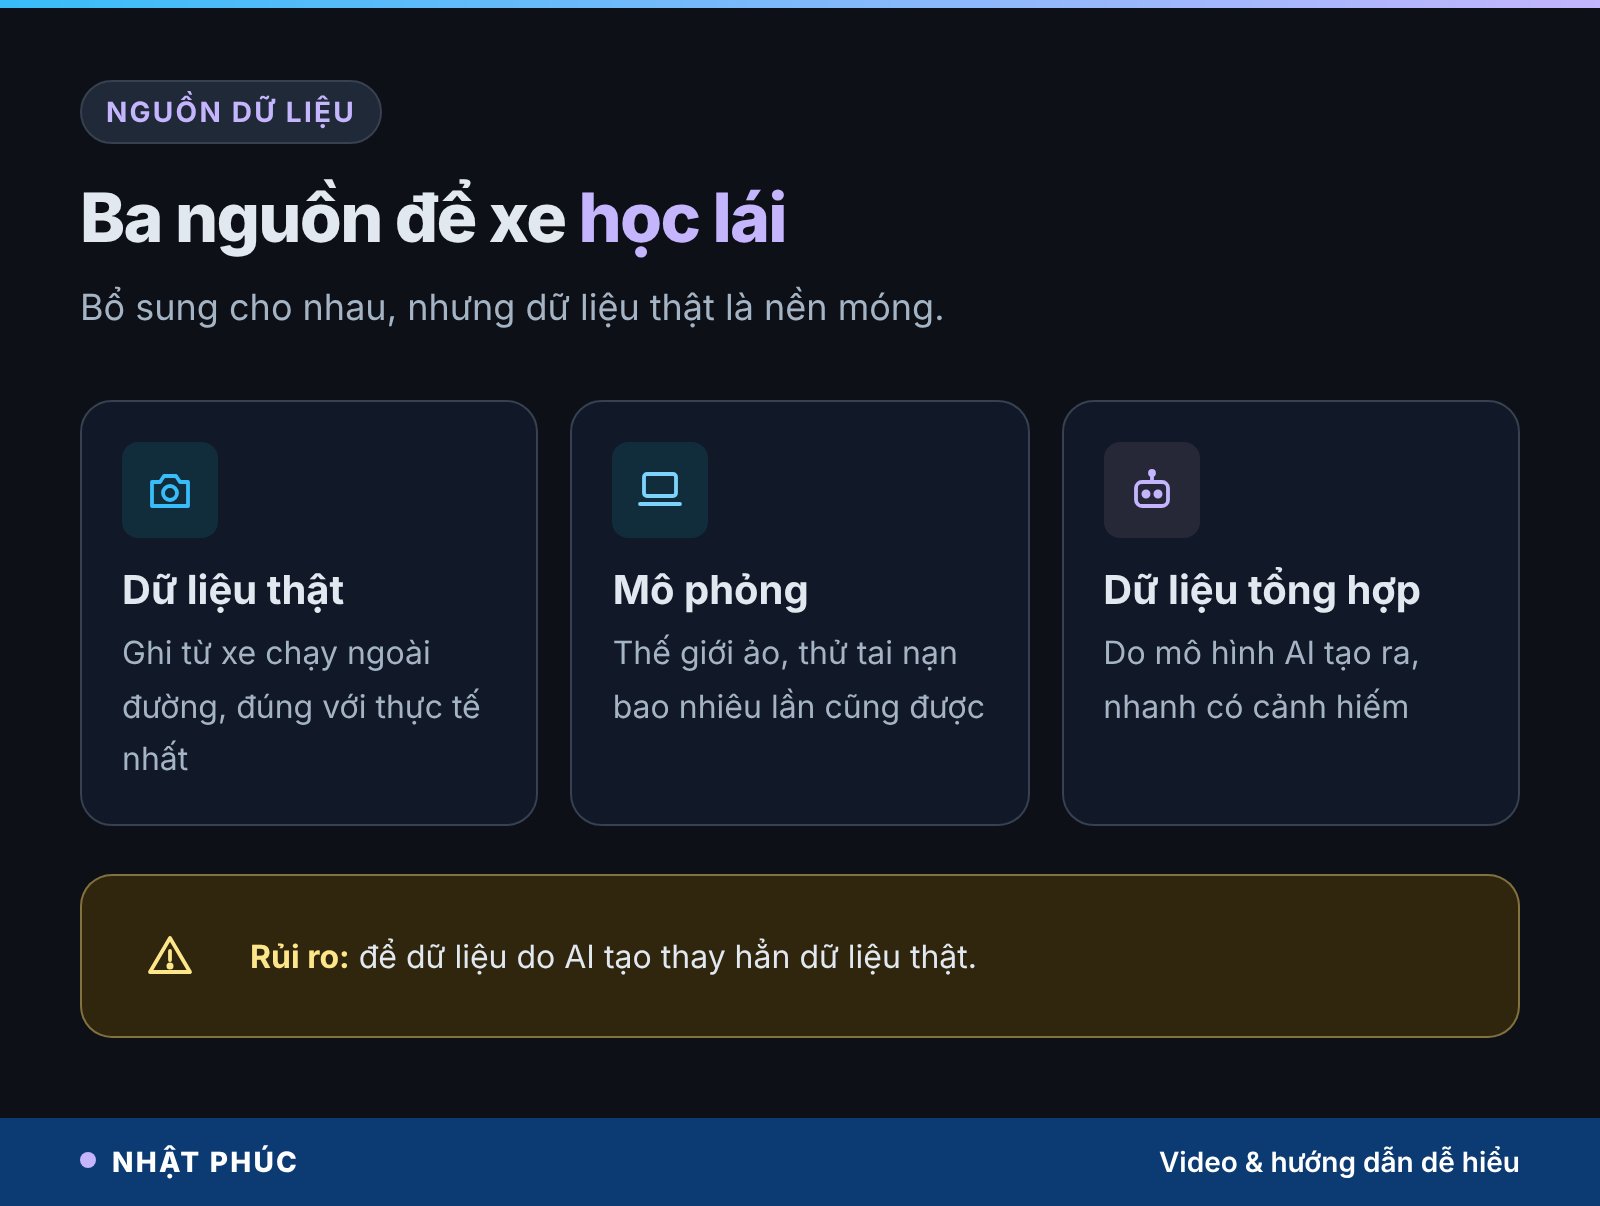
- Ba nguồn dữ liệu chính: dữ liệu thật từ đội xe, mô phỏng (thế giới ảo) và dữ liệu tổng hợp do mô hình AI tạo ra.
- Chỉ lái thật thì không đủ: theo RAND, chứng minh độ an toàn bằng chạy thử có thể cần hàng trăm triệu tới hàng trăm tỷ dặm.
- Mô phỏng và dữ liệu tổng hợp giúp luyện tình huống hiếm, nhưng nếu thay hẳn dữ liệu thật thì dễ gặp “sụp đổ mô hình”.
- Cách giảm rủi ro: giữ và tích luỹ dữ liệu thật, kiểm chứng lại ngoài đường, mở rộng vùng hoạt động từng bước.
Nội dung chính:
- Xe tự lái học lái như thế nào: từ luật viết tay đến học từ dữ liệu
- Nguồn thứ nhất: dữ liệu thật từ xe chạy ngoài đường
- Vì sao chỉ lái thật thì không bao giờ đủ
- Nguồn thứ hai: mô phỏng, phòng thi lái ảo
- Nguồn thứ ba: dữ liệu tổng hợp và mô hình thế giới
- Bài học “sụp đổ mô hình” cho xe tự lái
- Rủi ro khi xe tự lái học từ dữ liệu giả
- Các nhà phát triển giảm rủi ro thế nào
- Hiểu lầm phổ biến về cách xe tự lái học
- Người dùng xe điện cần hiểu gì từ chuyện này
- Câu hỏi thường gặp
- Kết luận
Xe tự lái học lái như thế nào: từ luật viết tay đến học từ dữ liệu
Những chiếc xe tự lái đời đầu dựa nhiều vào luật do kỹ sư viết tay: “nếu thấy đèn đỏ thì dừng”, “nếu xe trước chậm lại thì giảm ga”. Cách này dễ hiểu, nhưng đường phố có quá nhiều tình huống để viết hết thành luật. Một chiếc túi nilon bay ngang đường, một người dắt xe đạp băng qua chỗ không có vạch, một chú chó chạy ra từ hẻm: mỗi thứ cần một cách xử lý riêng.
Vì vậy các hệ thống hiện đại chuyển sang học từ dữ liệu (machine learning). Thay vì dạy luật, kỹ sư cho mô hình xem hàng triệu ví dụ đã có đáp án, để mô hình tự rút ra quy luật. Giống như bạn không học nhận ra con mèo bằng định nghĩa, mà bằng cách nhìn thấy rất nhiều con mèo.
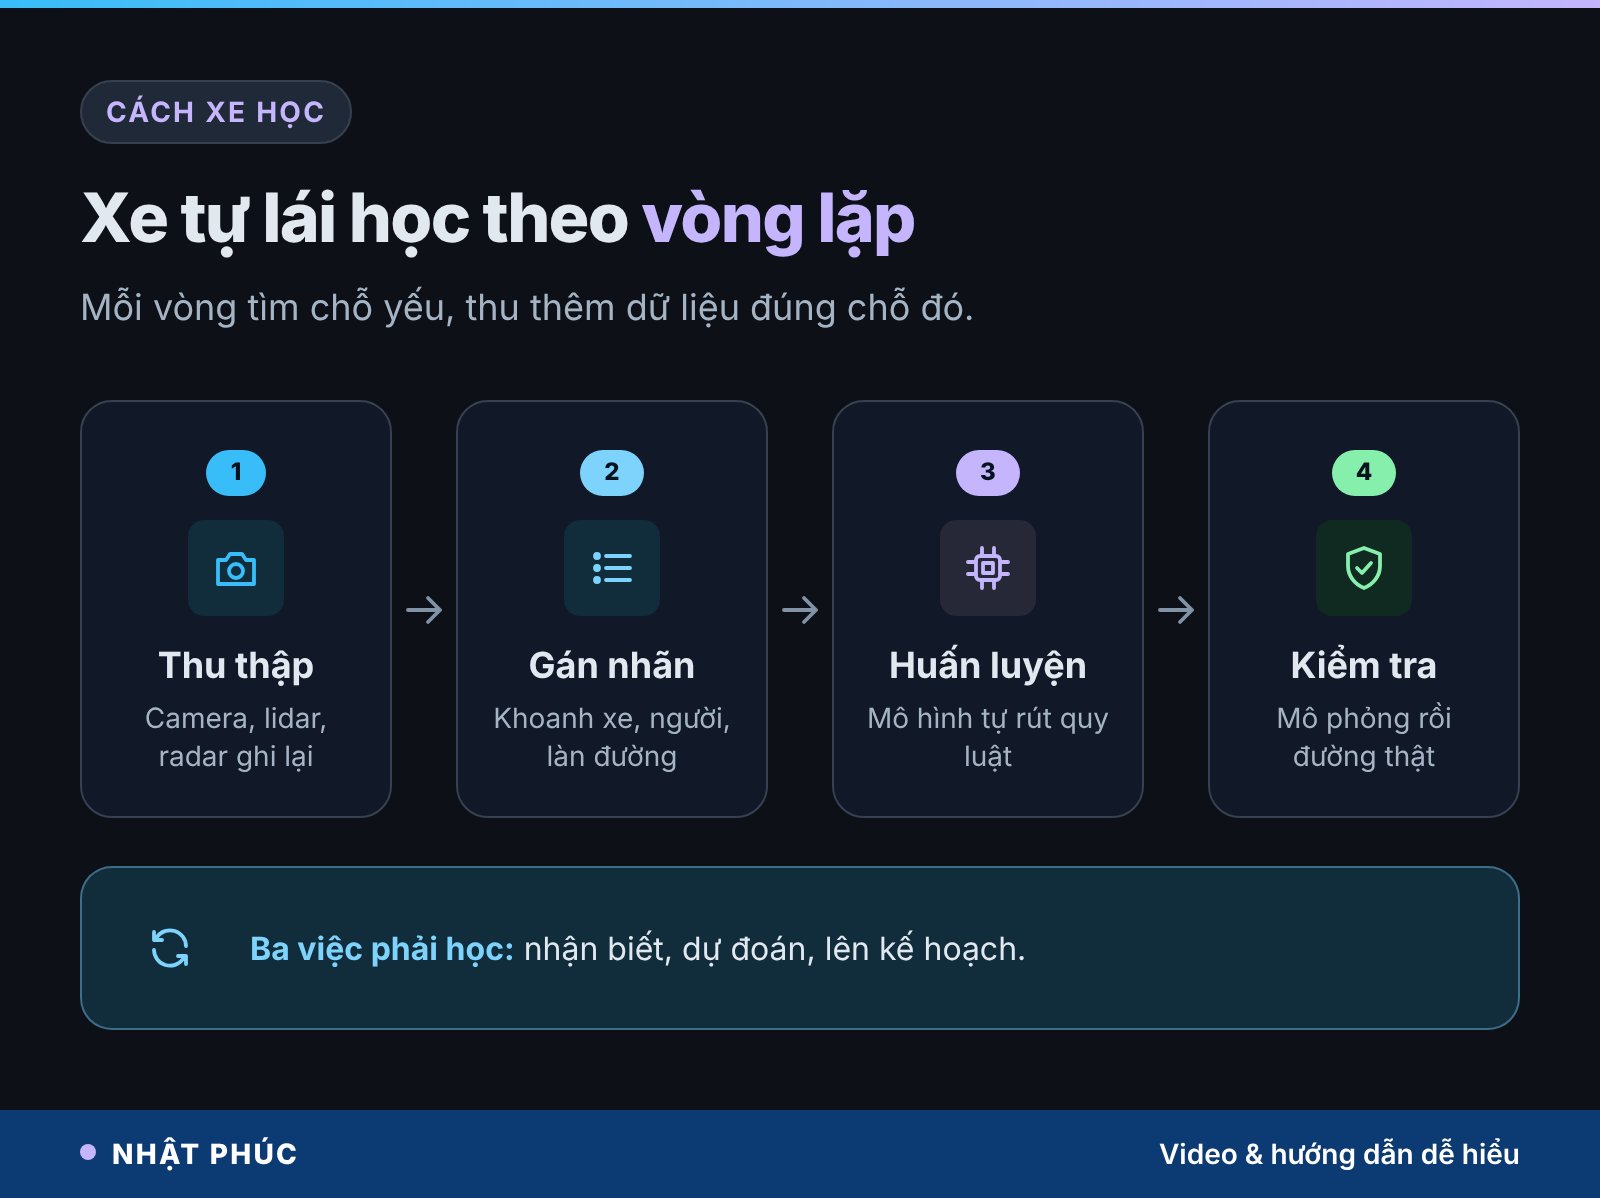
Ba việc xe phải học
- Nhận biết (perception): từ ảnh camera, điểm lidar, tín hiệu radar, xác định đâu là xe, người, làn đường, đèn tín hiệu.
- Dự đoán (prediction): người đi bộ kia có định băng qua không, xe máy bên phải có định tạt đầu không.
- Lên kế hoạch (planning): chọn tốc độ, quỹ đạo, khi nào phanh, khi nào nhường.
Một số hệ thống tách ba việc này thành các mô hình riêng; một số khác gộp nhiều bước vào một mô hình lớn học “từ đầu đến cuối” (end-to-end). Dù kiến trúc nào, chất lượng của xe vẫn phụ thuộc rất lớn vào dữ liệu mà nó được học. Quy trình chung là một vòng lặp: thu thập, gán nhãn, huấn luyện, kiểm tra, rồi quay lại thu thập những chỗ còn yếu.
Nguồn thứ nhất: dữ liệu thật từ xe chạy ngoài đường
Nguồn dữ liệu quý nhất vẫn là xe chạy thật. Một chiếc xe thử nghiệm gắn camera, lidar (cảm biến đo khoảng cách bằng tia laser), radar và các cảm biến định vị, ghi lại mọi thứ nó “thấy” cùng với hành động của người lái hoặc của hệ thống. Mỗi giờ chạy tạo ra một lượng dữ liệu rất lớn.
Để biến dữ liệu thô thành bài học, người ta phải gán nhãn: khoanh từng chiếc xe, từng người đi bộ, đánh dấu làn đường, ghi lại quỹ đạo. Việc này trước đây làm tay rất tốn công; ngày nay phần lớn được máy gán trước rồi người kiểm tra lại.
Không phải giờ chạy nào cũng đáng giá như nhau
Một giờ chạy êm trên cao tốc vắng gần như không dạy thêm gì mới. Thứ đáng giá là những khoảnh khắc lạ: người lái an toàn phải can thiệp, hệ thống dự đoán sai, một vật thể chưa từng gặp. Vì thế các đội phát triển đặt “bẫy” để tự động lọc ra những đoạn như vậy và đưa vào kho học, thay vì lưu đều mọi thứ.
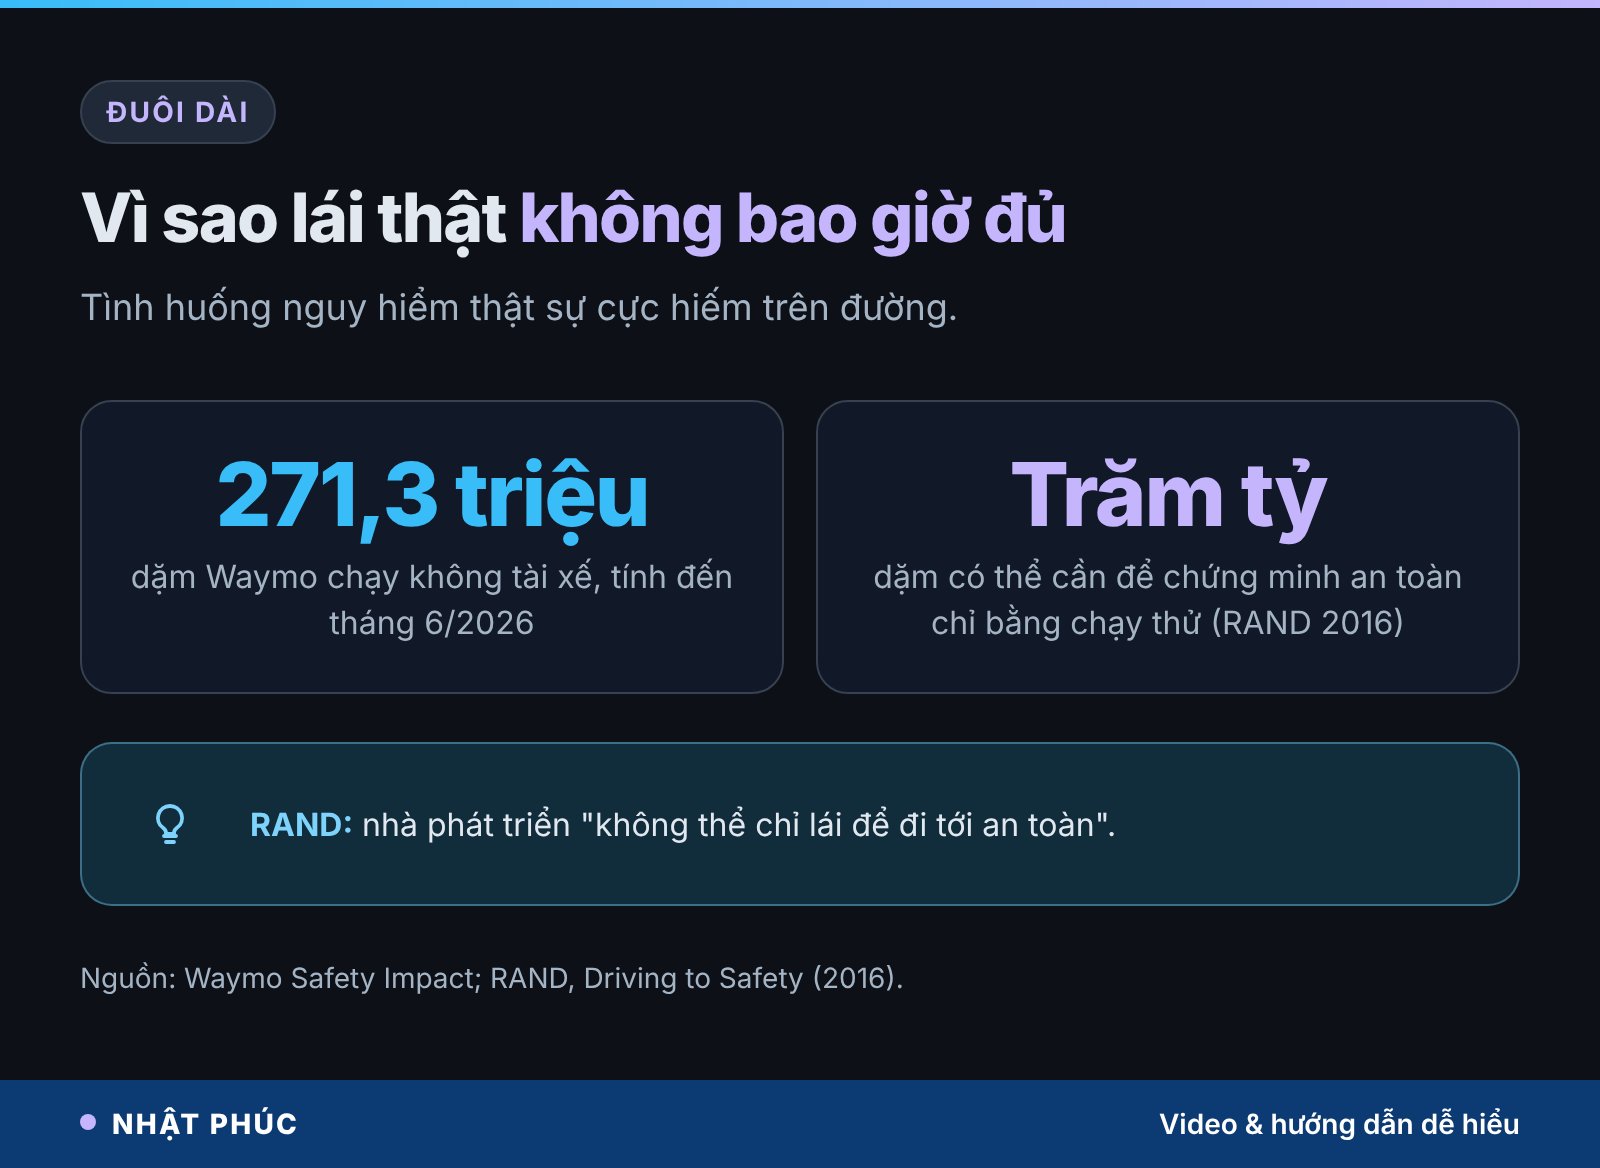
Quy mô hiện nay rất lớn. Theo trang dữ liệu an toàn của Waymo, đội xe không người lái của hãng đã chạy khoảng 271,3 triệu dặm (khoảng 436 triệu km) chở khách mà không có tài xế, tính đến tháng 6/2026. Dù vậy, như phần sau sẽ cho thấy, con số đó vẫn chưa phải là “đủ”.
Vì sao chỉ lái thật thì không bao giờ đủ
Hãy hình dung bạn học ngoại ngữ chỉ bằng cách nghe hội thoại ngoài chợ. Bạn sẽ rất giỏi câu chào hỏi, mặc cả, nhưng gần như không bao giờ nghe thấy cách báo cháy hay gọi cấp cứu. Đường sá cũng vậy: tình huống thường ngày lặp lại hàng triệu lần, còn tình huống nguy hiểm thật sự thì cực hiếm. Giới kỹ thuật gọi đó là “đuôi dài” (long tail).
Báo cáo “Driving to Safety” của RAND (2016) tính rằng muốn chứng minh xe tự lái an toàn hơn con người về số ca tử vong và chấn thương chỉ bằng chạy thử, có thể cần hàng trăm triệu, có khi hàng trăm tỷ dặm; với quy mô đội xe lúc đó, việc này mất hàng chục tới hàng trăm năm. Kết luận của báo cáo rất thẳng: nhà phát triển “không thể chỉ lái để đi tới an toàn”.
Một ví dụ đau lòng về tình huống “chưa được dạy”
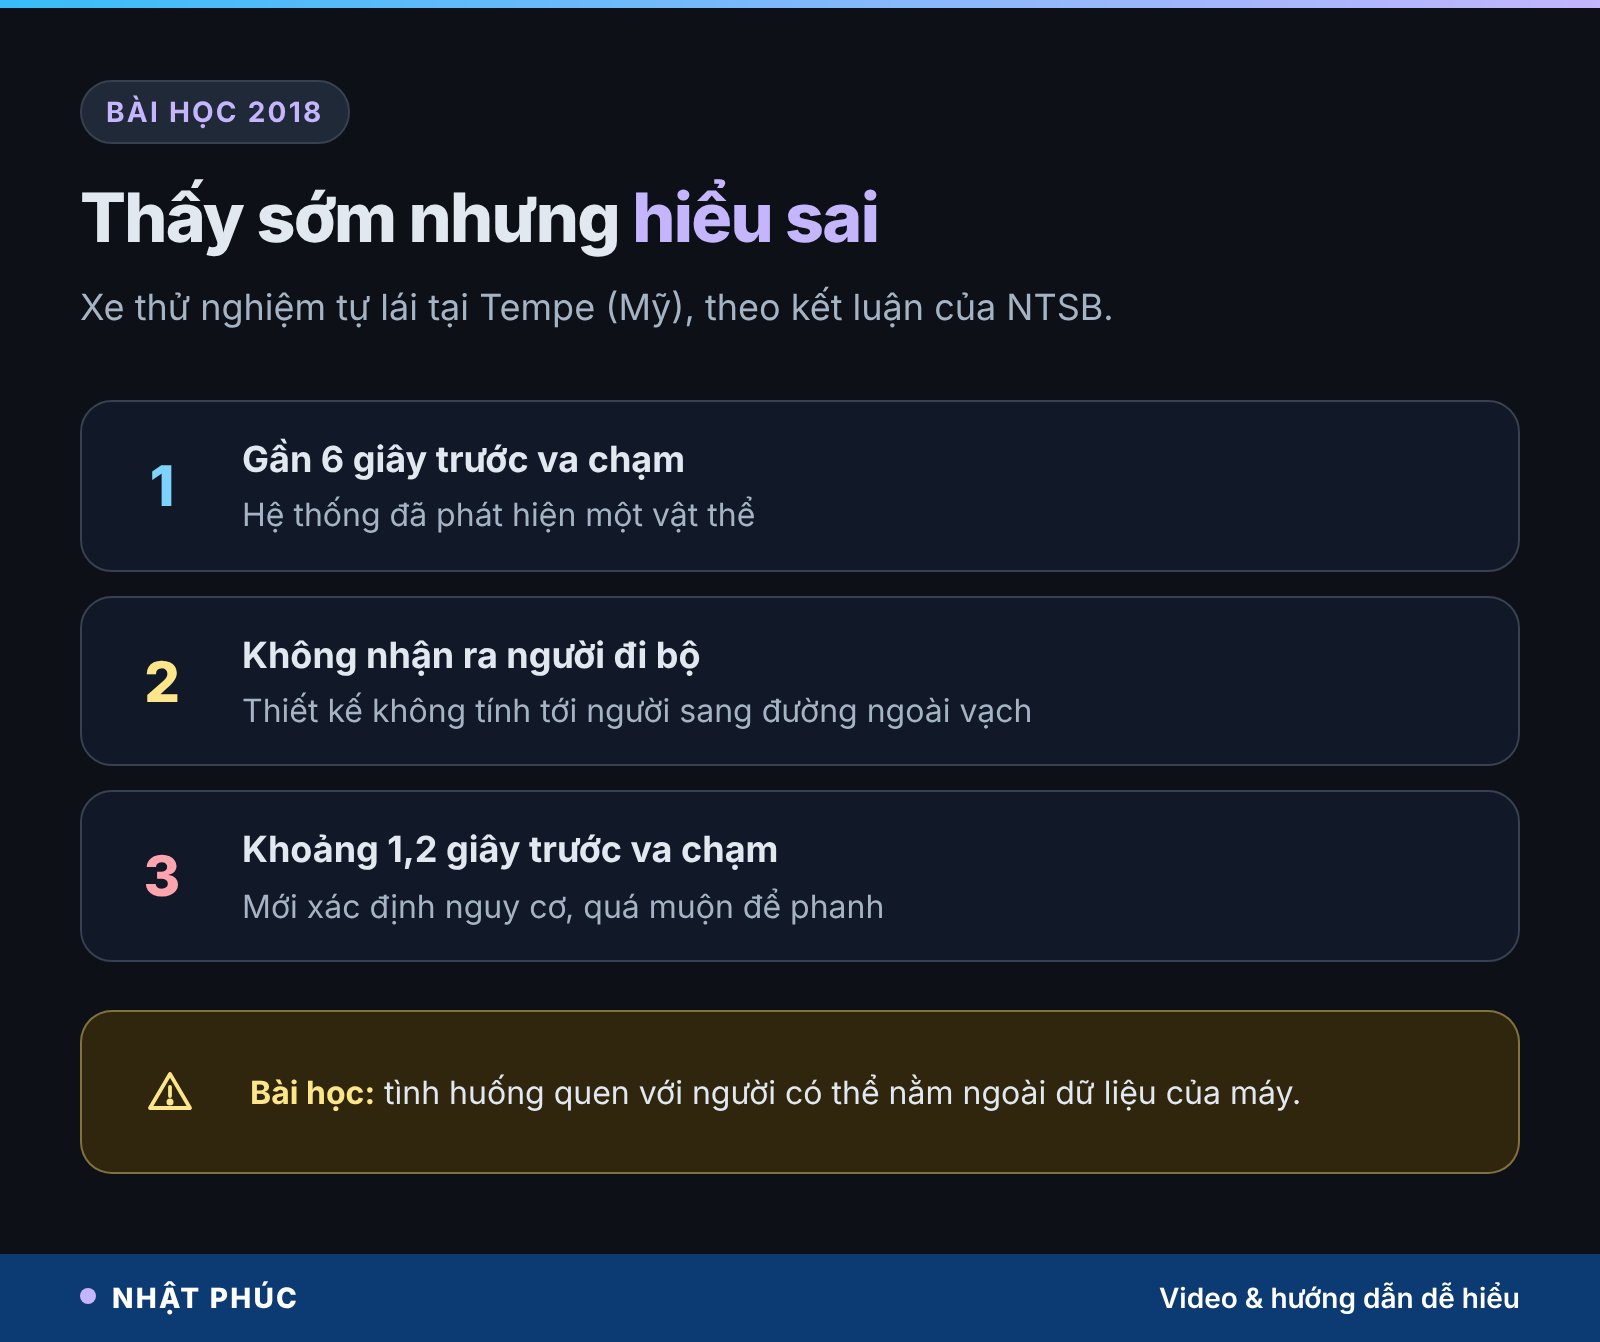
Tháng 3/2018 tại Tempe (Arizona, Mỹ), một xe thử nghiệm tự lái của Uber đâm tử vong một người phụ nữ dắt xe đạp băng qua đường ở chỗ không có vạch sang đường. Theo kết luận của NTSB (Ủy ban An toàn Giao thông Quốc gia Mỹ), hệ thống phát hiện vật thể gần 6 giây trước va chạm nhưng không nhận ra đó là người đi bộ, vì thiết kế của nó không tính tới người sang đường ngoài vạch. Hệ thống chỉ xác định có nguy cơ va chạm khoảng 1,2 giây trước khi đâm, quá muộn để phanh.
Bài học không phải “cảm biến kém”, mà là: một tình huống quen thuộc với con người lại nằm ngoài những gì hệ thống được chuẩn bị. Ở Việt Nam, người sang đường ngoài vạch, xe máy đi ngược chiều hay xe ba gác chở hàng cồng kềnh còn phổ biến hơn nhiều.
Nguồn thứ hai: mô phỏng, phòng thi lái ảo
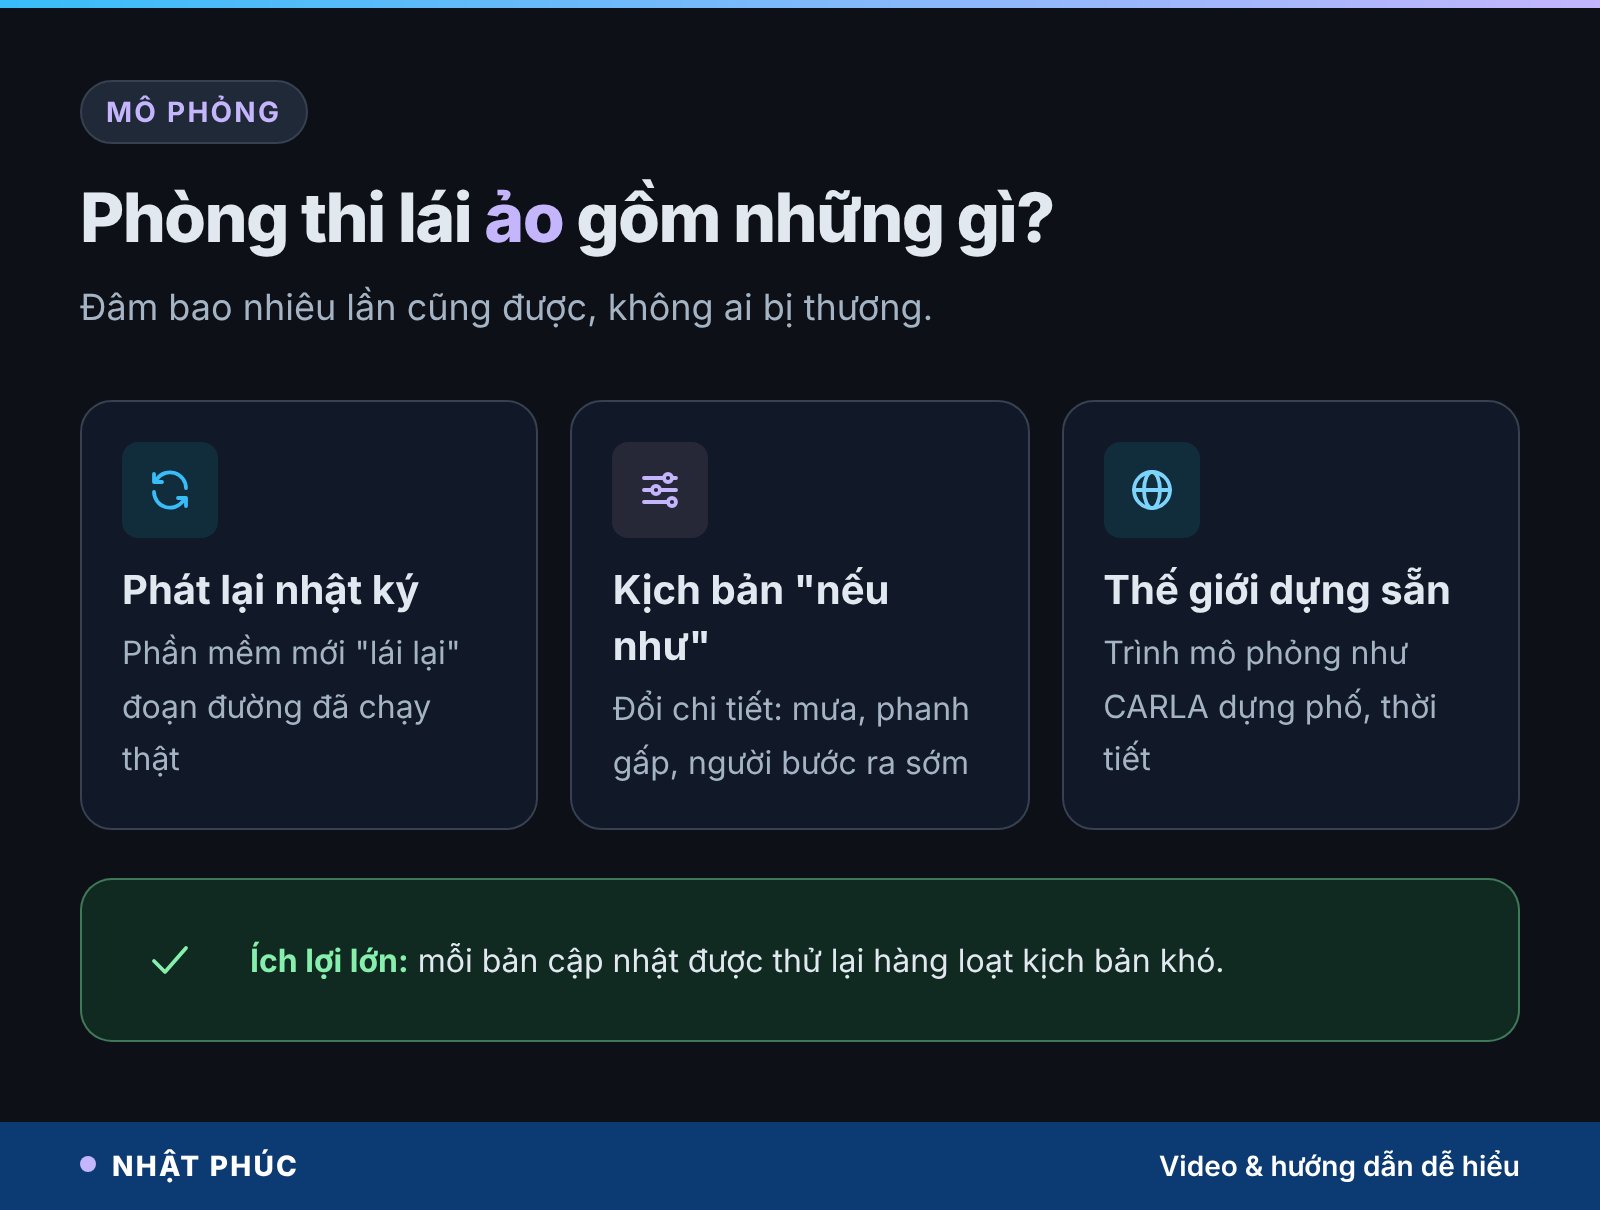
Nếu đường thật quá hiếm tình huống nguy hiểm, thì tự tạo ra chúng trong thế giới ảo. Mô phỏng (simulation) là phần mềm dựng lại đường sá, xe cộ, người đi bộ và cảm biến, để “bộ não” của xe lái trong đó như ngoài đời. Ưu điểm lớn nhất: xe có thể gặp tai nạn hàng nghìn lần mà không ai bị thương, và chạy nhanh hơn thời gian thực rất nhiều.
Ba cách dùng mô phỏng phổ biến
- Phát lại nhật ký: lấy một đoạn xe đã chạy thật, cho phiên bản phần mềm mới “lái lại” để xem nó có xử lý tốt hơn không.
- Kịch bản “nếu như”: từ một tình huống thật, thay đổi vài chi tiết (người đi bộ bước ra sớm hơn 1 giây, trời mưa, xe trước phanh gấp hơn) để thử hàng trăm biến thể.
- Thế giới ảo dựng sẵn: các trình mô phỏng như CARLA (mã nguồn mở, dùng nhiều trong nghiên cứu) cho phép dựng phố xá, thời tiết, giao thông từ đầu.
Waymo cho biết hệ thống của hãng đã lái “hàng tỷ dặm trong thế giới ảo”, nhiều hơn rất nhiều so với quãng đường chạy thật. Mô phỏng đặc biệt hữu ích để kiểm tra: mỗi lần cập nhật phần mềm, hàng loạt kịch bản khó được chạy lại để chắc rằng sửa chỗ này không làm hỏng chỗ khác.
Nguồn thứ ba: dữ liệu tổng hợp và mô hình thế giới
Bước tiếp theo của mô phỏng là để chính AI vẽ ra dữ liệu. Dữ liệu tổng hợp (synthetic data) là hình ảnh, video, điểm lidar do một mô hình tạo sinh sinh ra, trông giống dữ liệu thật nhưng không ghi từ cảm biến thật. Công cụ mạnh nhất hiện nay là “mô hình thế giới” (world model): mô hình học từ rất nhiều video để có thể tạo ra cảnh đường phố mới và phản ứng theo hành động của xe.
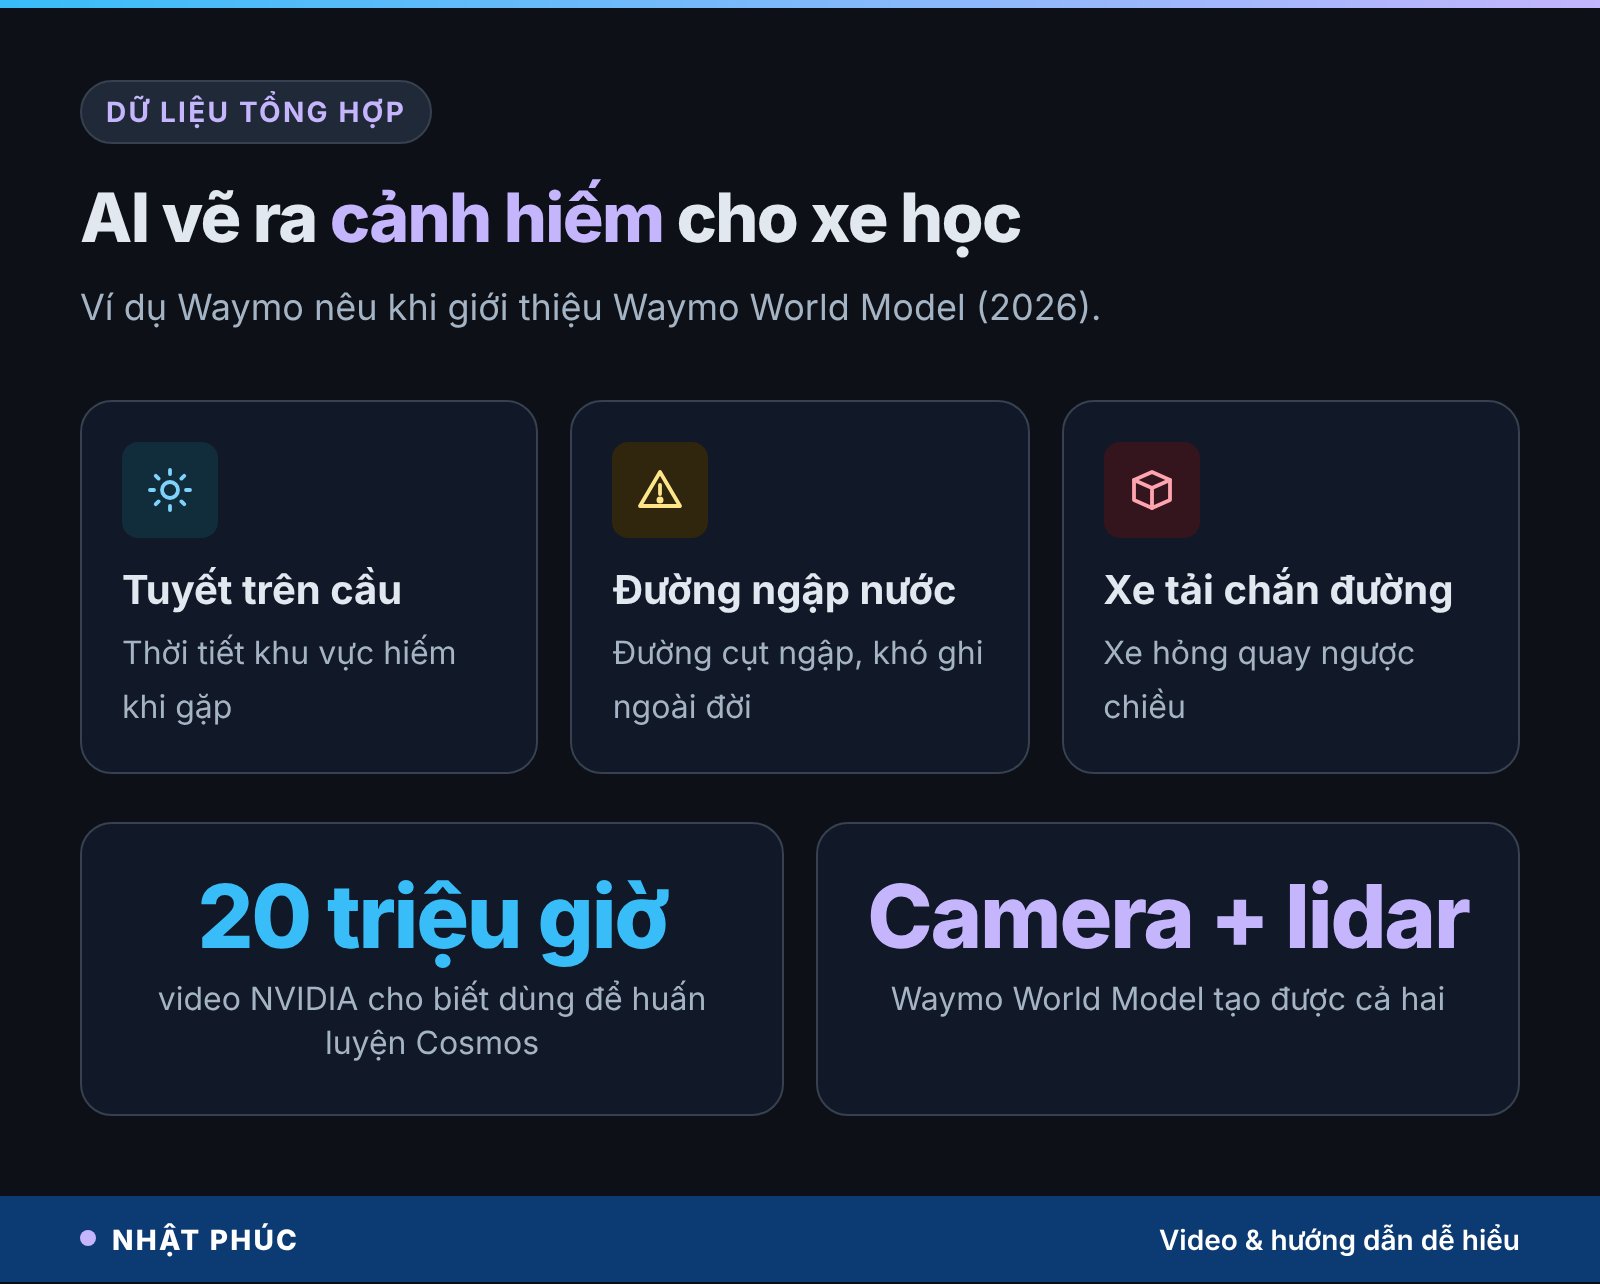
Đầu năm 2025, NVIDIA giới thiệu bộ mô hình Cosmos, được hãng cho biết huấn luyện trên khoảng 20 triệu giờ video về con người, môi trường, robot và lái xe, nhằm tạo dữ liệu tổng hợp cho robot và xe tự lái. Tháng 2/2026, Waymo công bố “Waymo World Model” xây trên Genie 3 của Google DeepMind, có thể sinh cả hình camera lẫn dữ liệu lidar.
Thứ dữ liệu tổng hợp làm tốt nhất
Theo Waymo, mô hình này dùng để tạo ra những cảnh gần như không thể ghi lại ở quy mô lớn: lái trên cầu khi có tuyết, gặp lốc xoáy, đường cụt ngập nước, một chiếc xe tải hỏng quay ngược chiều chắn đường, thậm chí một con voi giữa phố. Người kỹ sư có thể ra lệnh bằng chữ, đổi thời tiết, giờ trong ngày, bố cục đường.
Nghe rất hứa hẹn. Nhưng đây cũng là lúc câu chuyện trong video trở nên đáng suy nghĩ: dữ liệu tổng hợp do AI tạo ra, rồi lại được dùng để dạy AI.
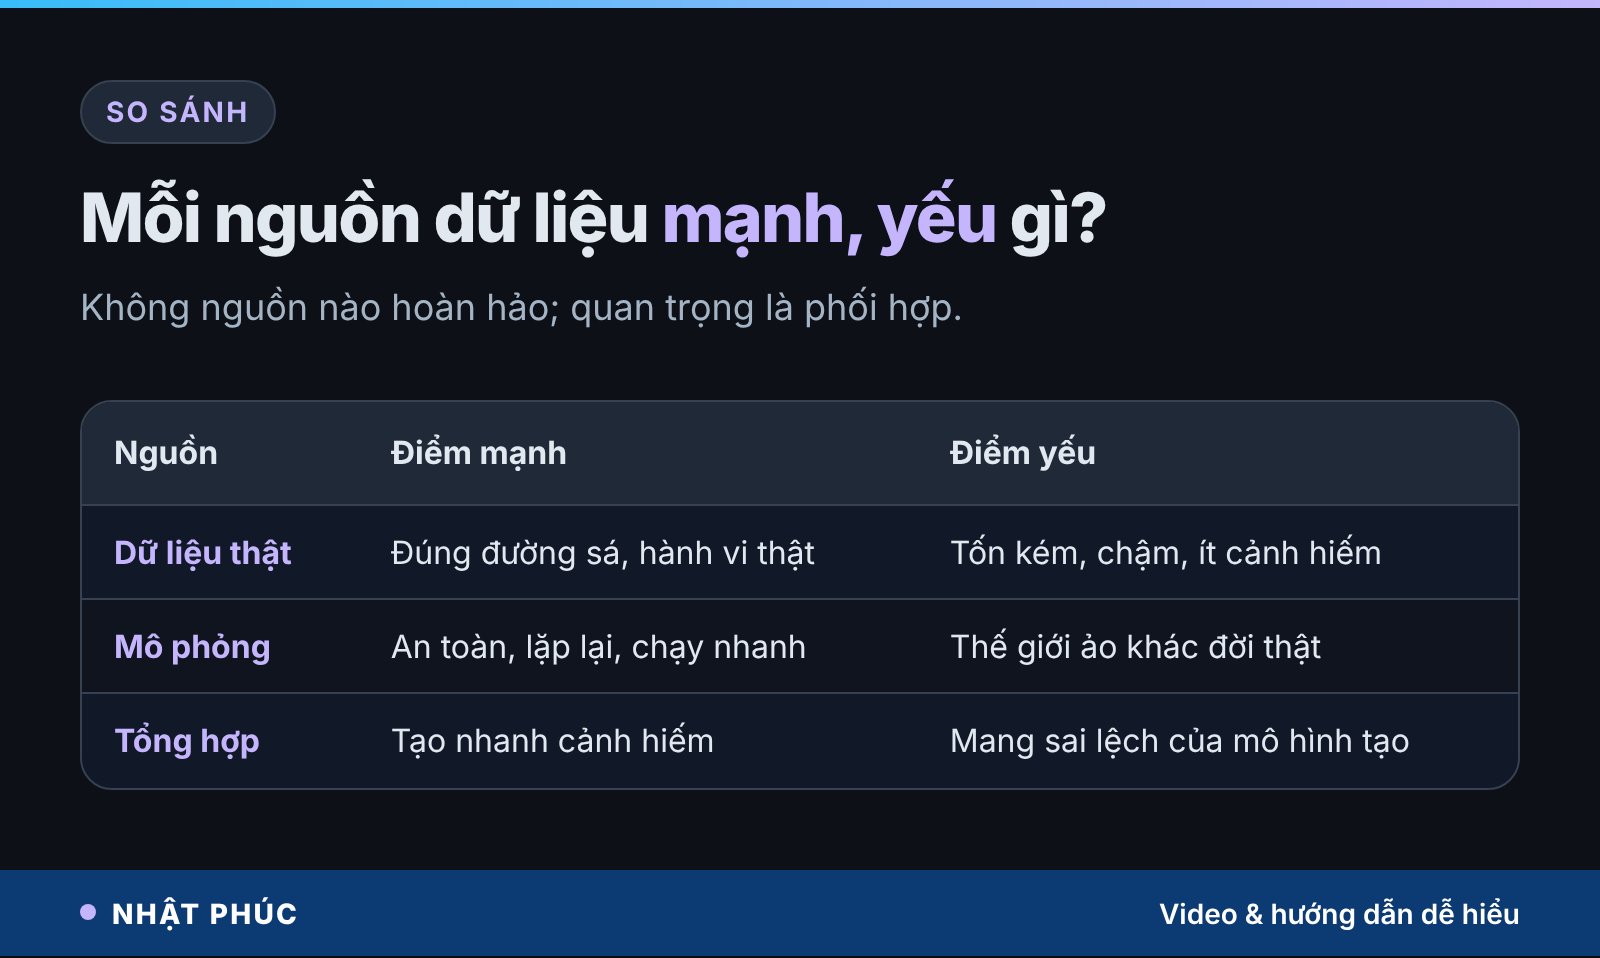
| Nguồn dữ liệu | Điểm mạnh | Điểm yếu |
|---|---|---|
| Dữ liệu thật | Đúng với đường sá, cảm biến và hành vi thật | Tốn kém, chậm, rất ít tình huống hiếm |
| Mô phỏng | An toàn, lặp lại được, chạy nhanh hàng tỷ dặm | Thế giới ảo không giống hệt đời thật |
| Dữ liệu tổng hợp | Tạo nhanh tình huống hiếm theo yêu cầu | Có thể mang sai lệch của chính mô hình tạo ra nó |
Bài học “sụp đổ mô hình” cho xe tự lái
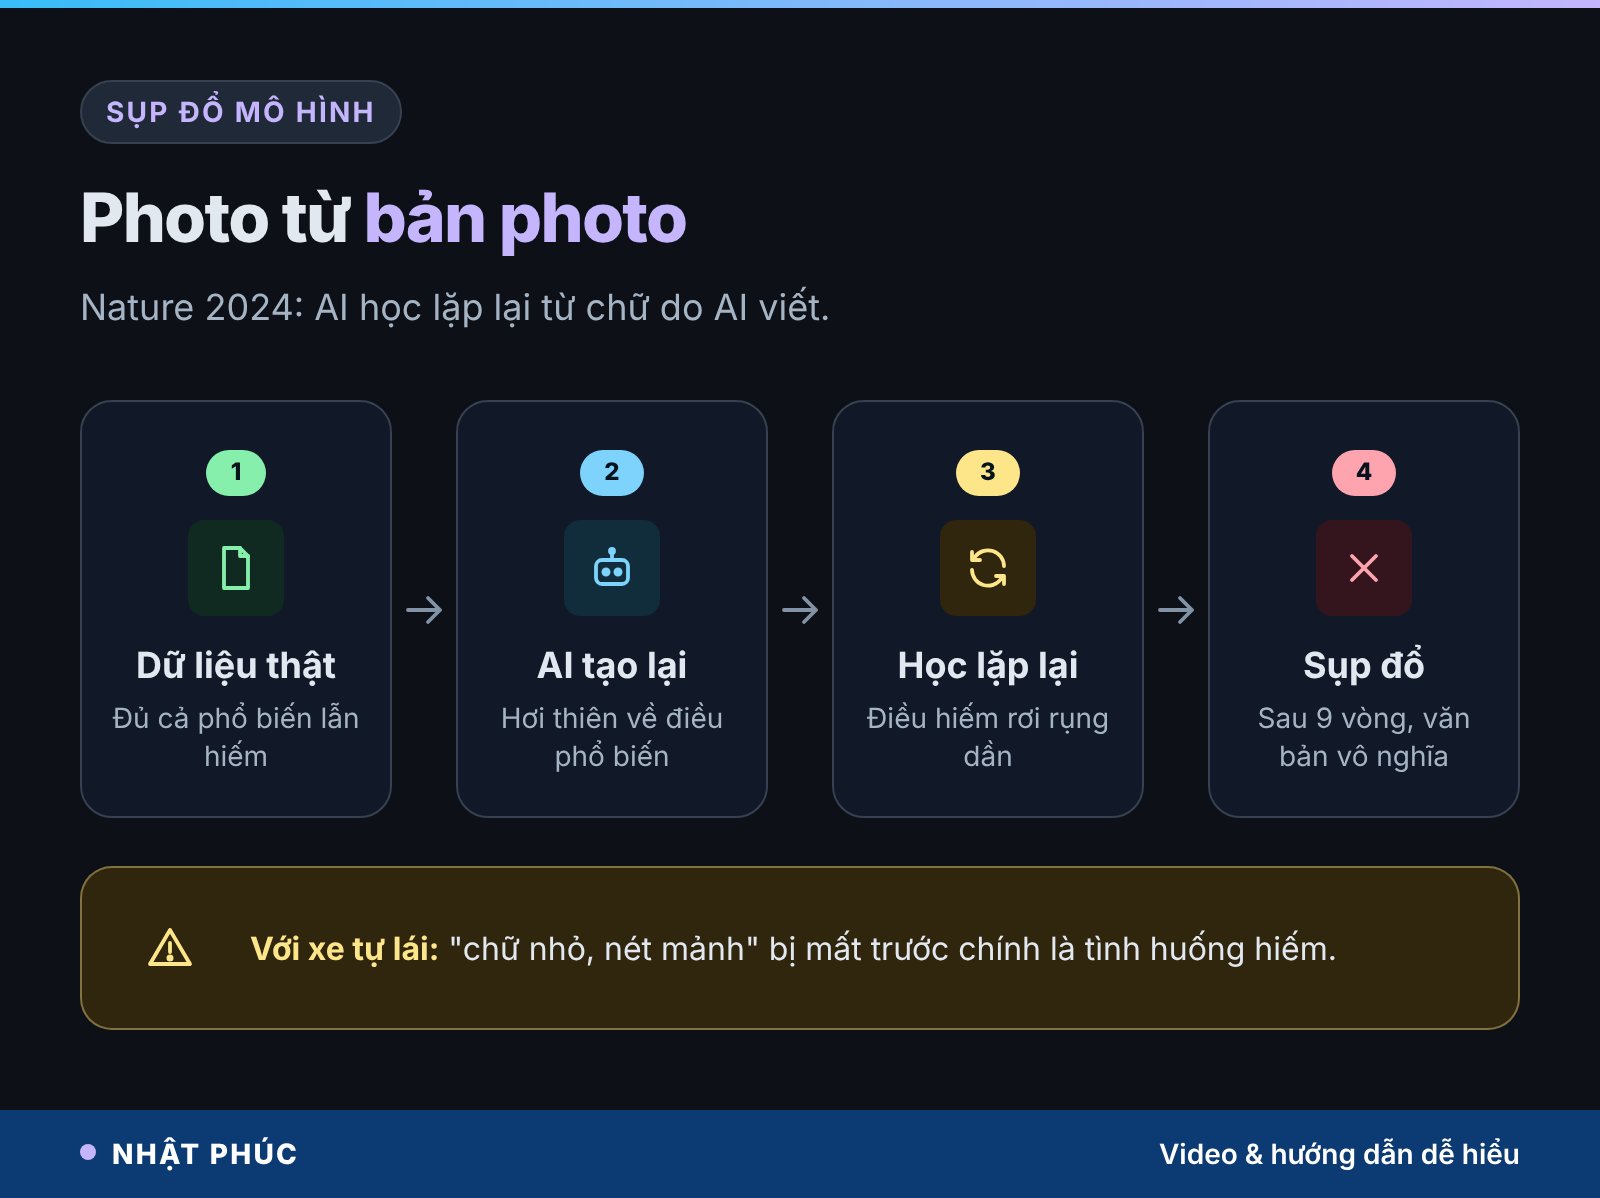
Năm 2024, nhóm của Ilia Shumailov đăng trên tạp chí Nature nghiên cứu “AI models collapse when trained on recursively generated data”. Họ cho một mô hình ngôn ngữ học từ chữ do thế hệ trước viết, rồi lặp lại nhiều thế hệ. Kết quả: sau 9 vòng, văn bản trượt dần sang vô nghĩa. Lý do cốt lõi là mỗi vòng, mô hình hơi “ưu tiên” những gì phổ biến và đánh rơi một ít những gì hiếm. Sau nhiều vòng, phần hiếm biến mất hẳn.
Ví dụ đời thường là bản photocopy: photo một trang giấy thì gần như y hệt, nhưng photo từ bản photo, rồi lại photo tiếp, chữ nhỏ và nét mảnh sẽ mất trước. Với xe tự lái, “chữ nhỏ, nét mảnh” chính là tình huống hiếm, đúng thứ mà người ta dùng dữ liệu tổng hợp để bù đắp.
Tin tốt: không phải lúc nào cũng sụp đổ
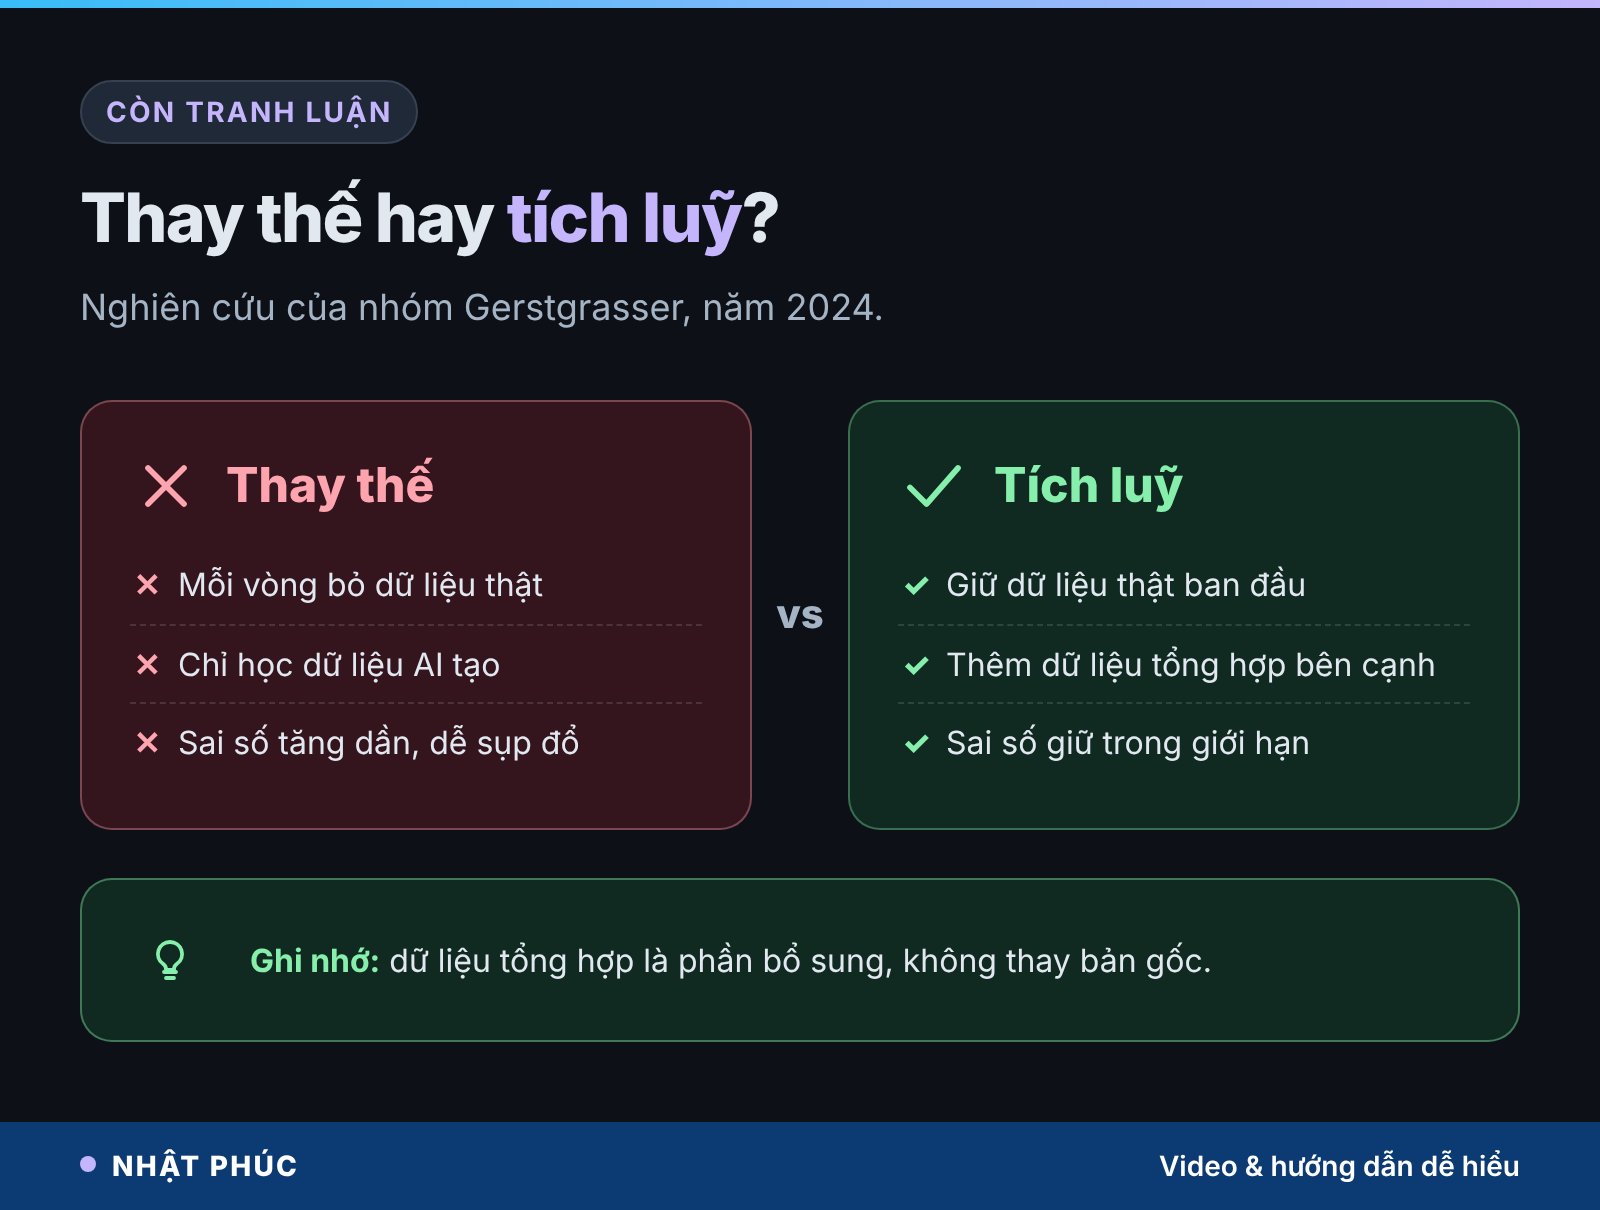
Cũng trong năm 2024, nhóm Matthias Gerstgrasser và cộng sự công bố nghiên cứu “Is Model Collapse Inevitable?”. Họ so sánh hai cách: thay thế dữ liệu thật bằng dữ liệu tổng hợp ở mỗi vòng, và tích luỹ dữ liệu tổng hợp bên cạnh dữ liệu thật ban đầu. Cách thay thế dẫn tới suy giảm; cách tích luỹ giữ được sai số trong giới hạn, trên cả mô hình ngôn ngữ, mô hình khuếch tán và mô hình tạo ảnh.
Chuyển sang xe tự lái, thông điệp rất rõ: dữ liệu tổng hợp nên là phần bổ sung, không phải phần thay thế. Dữ liệu thật đóng vai trò “bản gốc” để mỗi lần photo lại vẫn có thứ để đối chiếu.
Rủi ro khi xe tự lái học từ dữ liệu giả
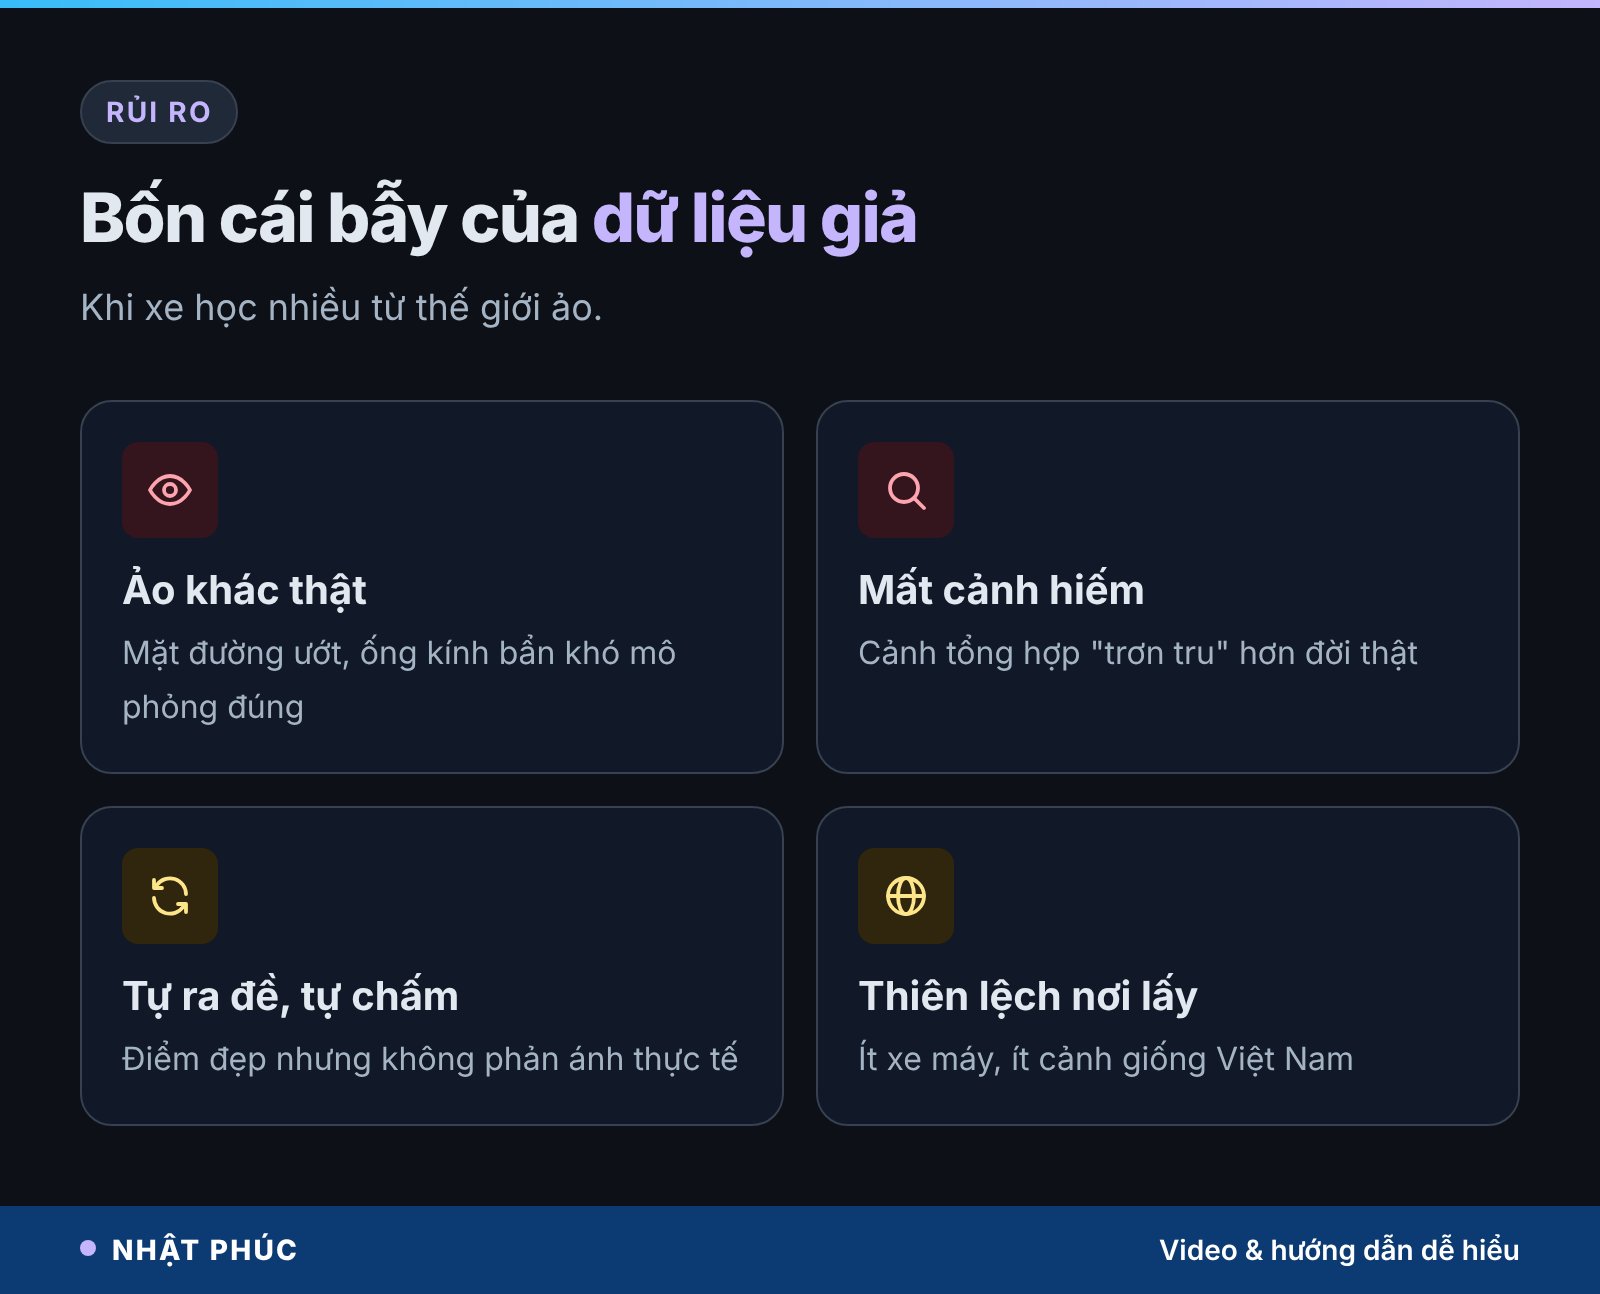
Sụp đổ mô hình là rủi ro dễ hình dung nhất, nhưng không phải duy nhất. Khi một phần đáng kể bài học của xe tự lái đến từ thế giới ảo, có ít nhất bốn điểm cần cảnh giác.
1. Khoảng cách giữa ảo và thật
Giới nghiên cứu gọi là sim-to-real gap. Ánh nắng phản chiếu trên mặt đường ướt, vết bẩn trên ống kính camera, cách một chiếc xe máy chở hàng lắc lư: những chi tiết nhỏ này rất khó mô phỏng đúng. Xe giỏi trong thế giới ảo chưa chắc giỏi ngoài đường.
2. Điều hiếm bị bào mòn
Mô hình tạo sinh học từ dữ liệu có sẵn, nên nó tạo ra tốt nhất những gì nó đã thấy nhiều. Nếu tình huống hiếm vốn ít trong dữ liệu gốc, cảnh tổng hợp có thể “trơn tru” hơn đời thật, thiếu đúng chi tiết làm nên nguy hiểm.
3. Tự ra đề, tự chấm điểm
Nếu cùng một họ mô hình vừa tạo đề thi vừa được dùng để đánh giá xe, điểm số có thể đẹp nhưng không phản ánh thực tế. Giống học sinh tự ra đề rồi tự chấm.
4. Thiên lệch theo nơi lấy dữ liệu
Mô hình học nhiều từ đường phố Mỹ hay châu Âu có thể tạo ra cảnh giao thông rất khác Việt Nam: ít xe máy, ít hàng rong, làn đường rõ ràng. Dữ liệu tổng hợp vì thế có thể khuếch đại đúng những gì vốn đã quen, thay vì bù vào chỗ thiếu.
Các nhà phát triển giảm rủi ro thế nào
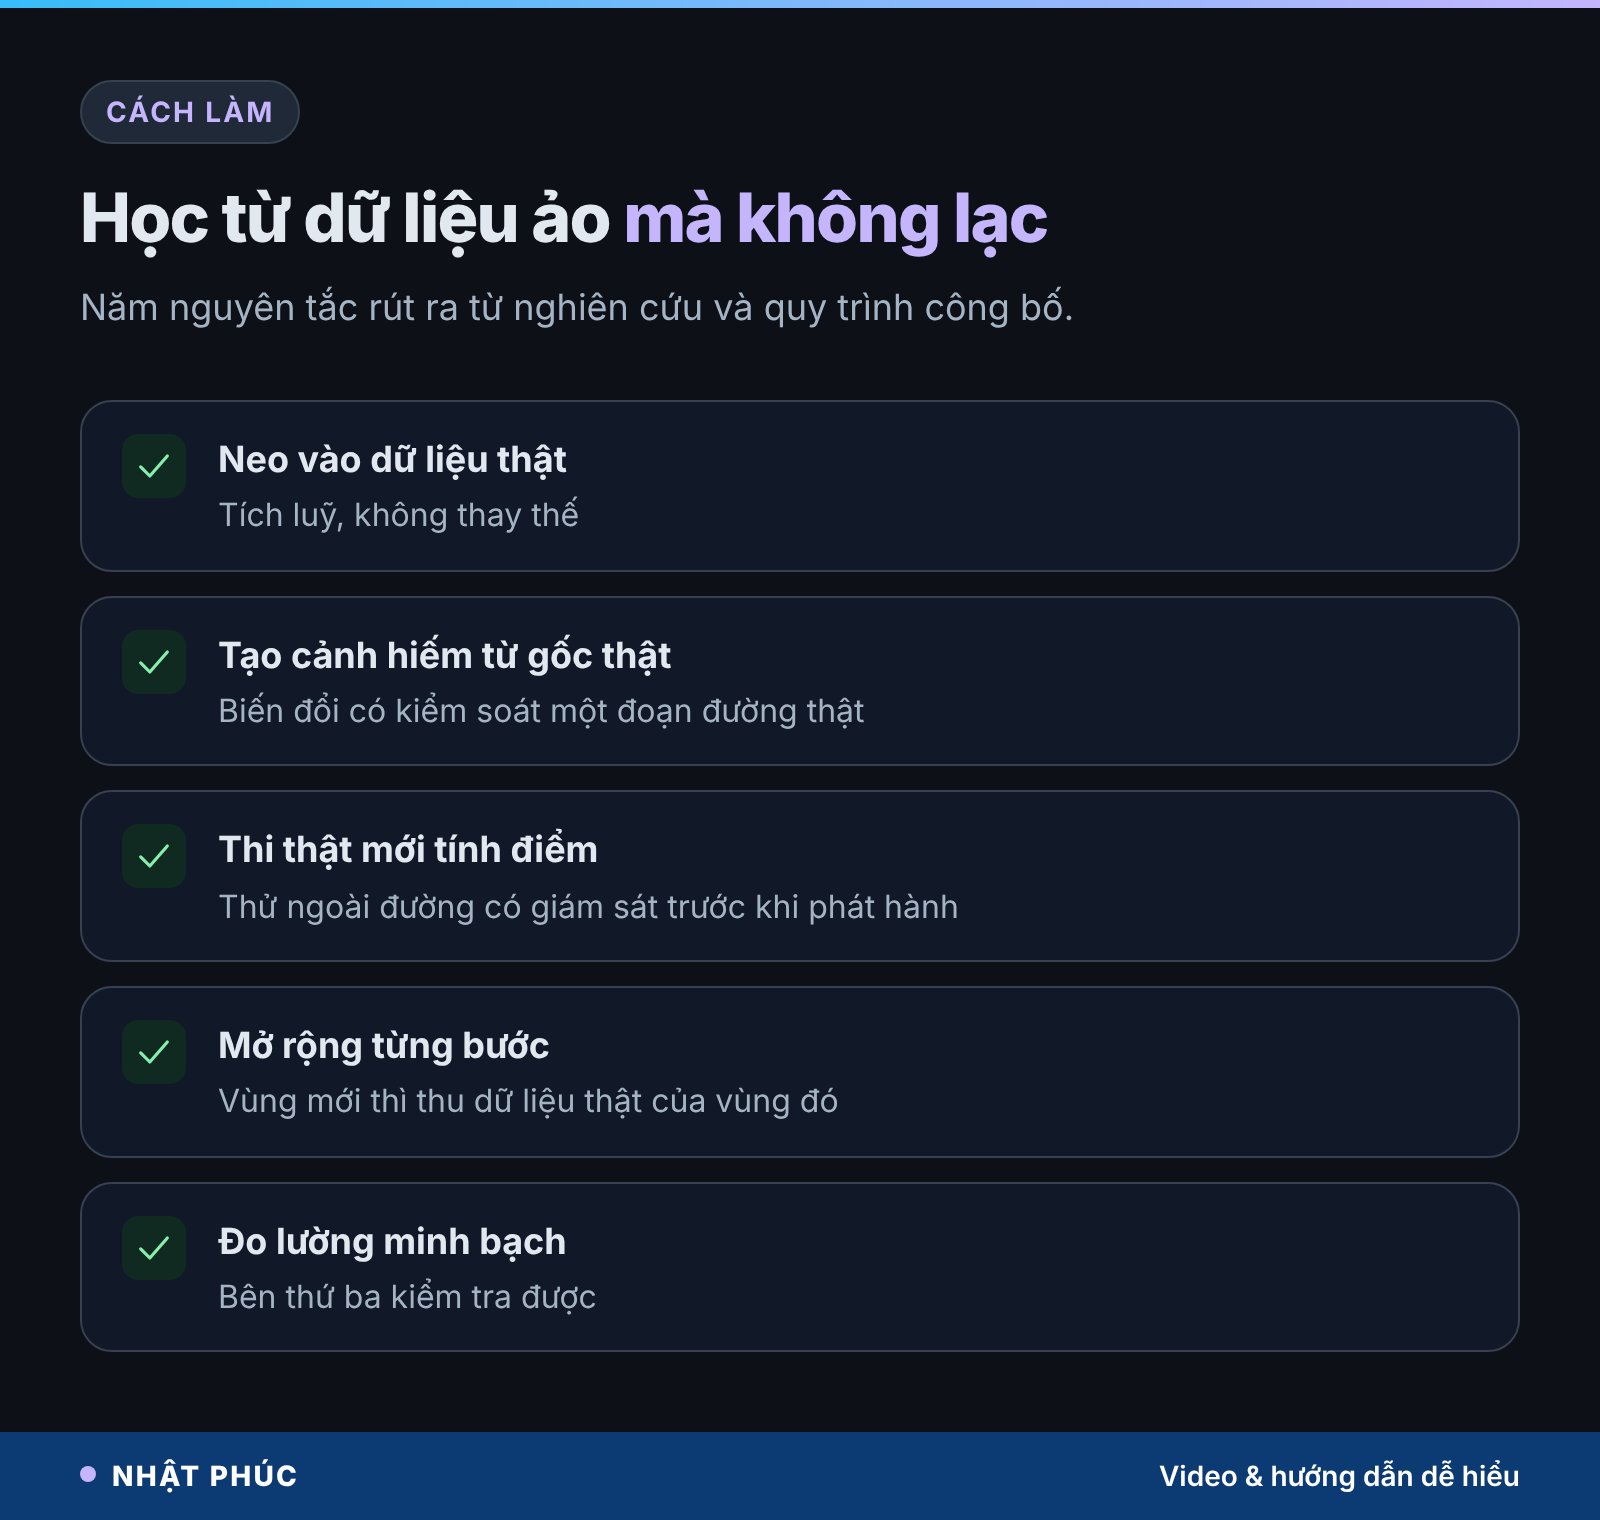
Từ các nghiên cứu và cách các hãng công bố quy trình, có thể rút ra những nguyên tắc chung để xe tự lái học từ dữ liệu tổng hợp mà không “quên” thế giới thật.
1. Neo vào dữ liệu thật
Luôn giữ và tích luỹ dữ liệu thật trong kho học, như kết quả của nhóm Gerstgrasser gợi ý. Dữ liệu tổng hợp được thêm vào, không đẩy dữ liệu thật ra.
2. Tạo cảnh hiếm từ gốc thật
Thay vì để AI tự bịa hoàn toàn, nhiều cách làm bắt đầu từ một đoạn đường thật rồi biến đổi có kiểm soát: thêm mưa, đổi giờ, cho người đi bộ bước ra sớm hơn.
3. Thi thật mới tính điểm
Kết quả trong mô phỏng chỉ là vòng loại. Phần mềm mới cần được thử ngoài đường, có người giám sát, trước khi tới tay người dùng.
4. Mở rộng từng bước
Xe tự lái thường chỉ được phép hoạt động trong một vùng hoạt động thiết kế (ODD): khu vực, tốc độ, thời tiết nhất định. Ra vùng mới thì thu thập dữ liệu thật của vùng đó trước.
5. Đo lường minh bạch
Công bố số liệu an toàn theo cách bên thứ ba kiểm tra được giúp phát hiện sớm khi hệ thống học lệch.
Hiểu lầm phổ biến về cách xe tự lái học
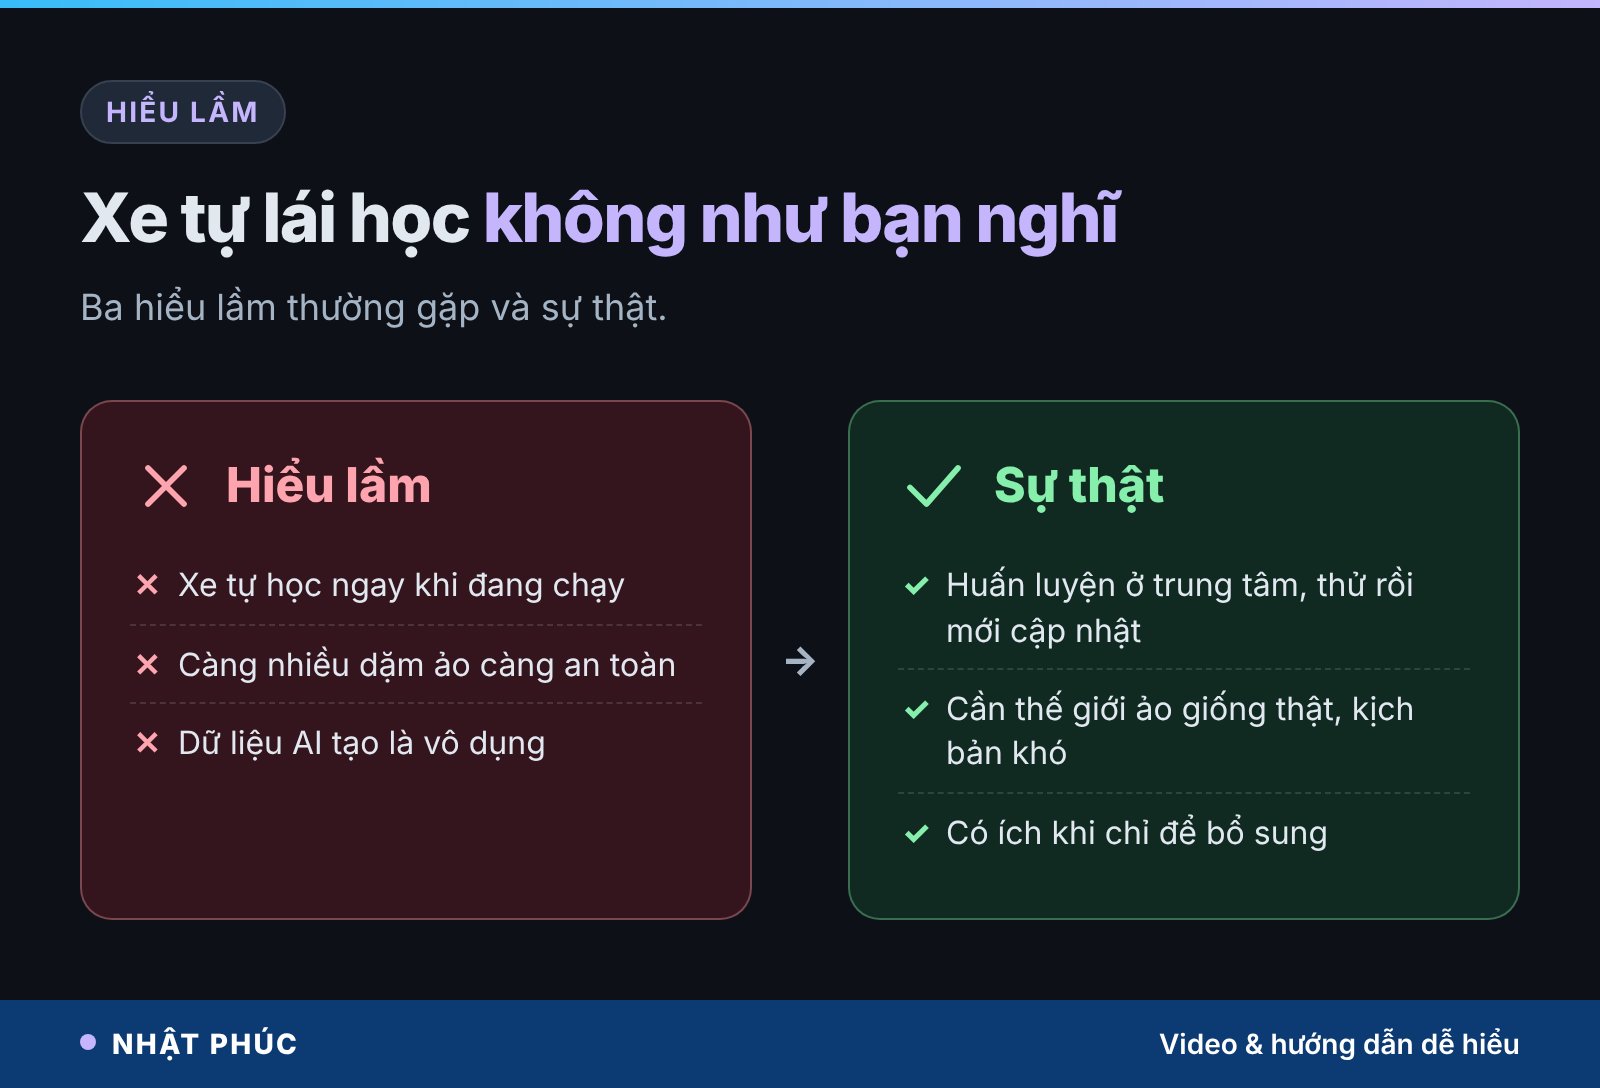
“Xe tự lái tự học ngay khi đang chạy trên đường.” Thường không phải vậy. Xe ghi dữ liệu, nhưng việc huấn luyện diễn ra ở trung tâm dữ liệu; phiên bản mới phải được kiểm tra rồi mới cập nhật xuống xe. Một chiếc xe không “tự đổi tính” giữa đường vì vừa gặp một tình huống lạ.
“Chạy càng nhiều dặm ảo thì càng an toàn.” Dặm ảo chỉ có giá trị khi thế giới ảo đủ giống thật và có kịch bản khó. Một tỷ dặm trên đường ảo vắng tanh không bằng vài nghìn tình huống hiểm hóc được dựng cẩn thận.
“Dữ liệu do AI tạo ra là đồ giả, vô dụng.” Cũng không đúng. Dùng đúng cách, nó giúp xe làm quen với cảnh hiếm mà lái thật mấy chục năm chưa chắc gặp. Vấn đề chỉ nằm ở việc để nó thay thế dữ liệu thật.
Người dùng xe điện cần hiểu gì từ chuyện này
Phần lớn xe bán cho người dùng phổ thông hiện nay, kể cả các mẫu xe điện nhiều công nghệ, mới chỉ có hệ thống hỗ trợ lái ở mức người lái vẫn phải giám sát liên tục, chưa phải xe tự lái. Nhưng các tính năng như giữ làn, ga tự động thích ứng, phanh khẩn cấp cũng được xây dựng theo cùng cách: học từ dữ liệu, kiểm tra bằng mô phỏng. Vì vậy chúng cũng có “đuôi dài” của riêng mình. Nếu bạn muốn biết cụ thể khi nào không nên tin những tính năng này, hãy đọc thêm bài giới hạn của ADAS và những điểm mù của hệ thống hỗ trợ lái.
Vài điều thực tế nên làm
- Đọc kỹ ghi chú cập nhật phần mềm (OTA) của xe: hãng thường nêu tính năng nào thay đổi và giới hạn mới.
- Xem phần quyền riêng tư trong cài đặt xe: một số hãng xin phép thu thập dữ liệu camera, hành trình để cải thiện hệ thống. Bạn có quyền biết và lựa chọn theo chính sách của hãng.
- Không thử thách hệ thống ở tình huống lạ để “xem nó học được chưa”: đó chính là vùng nó dễ sai nhất.
- Giữ cảm biến sạch và hiệu chỉnh lại sau khi thay kính, sửa đầu xe theo hướng dẫn của hãng.
Hiểu cách xe học giúp bạn có kỳ vọng đúng: một hệ thống chạy êm 99 lần không đảm bảo lần thứ 100, đặc biệt khi lần đó là một tình huống nó hiếm khi được thấy.
Câu hỏi thường gặp về việc xe tự lái học lái như thế nào
Xe tự lái có học trực tiếp từ cách tôi lái không?
Tuỳ hãng và tuỳ cài đặt. Một số hãng thu thập dữ liệu từ xe khách hàng để cải thiện hệ thống nếu người dùng đồng ý theo chính sách quyền riêng tư. Dữ liệu này được đưa về trung tâm, lọc, gán nhãn rồi mới dùng để huấn luyện; chiếc xe của bạn không tự thay đổi hành vi ngay sau một chuyến đi.
Mô phỏng có thay được chạy thử ngoài đường không?
Không thay hoàn toàn được. Mô phỏng giúp thử nhanh, an toàn và lặp lại hàng tỷ dặm, nhưng thế giới ảo luôn khác đời thật ở những chi tiết nhỏ. Vì vậy các hãng vẫn phải chạy thử ngoài đường có người giám sát và đo lường kết quả thật trước khi mở rộng dịch vụ.
Sụp đổ mô hình có xảy ra với xe tự lái không?
Nghiên cứu năm 2024 trên Nature chủ yếu thử với mô hình ngôn ngữ, nhưng nguyên lý “mất dần điều hiếm khi học lặp lại từ dữ liệu AI tạo ra” áp dụng cho nhiều loại mô hình. Nghiên cứu của nhóm Gerstgrasser cho thấy giữ và tích luỹ dữ liệu thật có thể tránh được hiện tượng này.
Vì sao xe tự lái khó chạy ở Việt Nam hơn?
Giao thông Việt Nam có mật độ xe máy cao, nhiều tình huống chen làn, sang đường ngoài vạch, hàng quán lấn lề. Những cảnh này ít xuất hiện trong dữ liệu ở nhiều nước khác, nên hệ thống cần dữ liệu thật thu tại chỗ thay vì chỉ dựa vào dữ liệu nước ngoài hay cảnh tổng hợp.
Bao nhiêu dữ liệu thì đủ để xe tự lái an toàn?
Không có con số chung. Báo cáo của RAND năm 2016 cho thấy chỉ chạy thử để chứng minh an toàn có thể cần hàng trăm triệu tới hàng trăm tỷ dặm. Vì vậy ngành kết hợp chạy thật, mô phỏng, phân tích tình huống và đo lường an toàn liên tục, thay vì chờ một mốc “đủ”.
Kết luận: dữ liệu ảo giúp xe học nhanh, dữ liệu thật giữ xe đi đúng
Trả lời câu hỏi xe tự lái học lái như thế nào, có thể tóm lại: học từ dữ liệu thật để hiểu thế giới, luyện trong mô phỏng để gặp đủ tình huống, và dùng dữ liệu tổng hợp để lấp chỗ hiếm. Nhưng như thí nghiệm “photo từ bản photo” trong video, nếu để AI học mãi từ những gì AI tạo ra, những điều hiếm, thường là nguy hiểm nhất, sẽ mờ dần. Bản gốc ngoài đường thật vẫn là thứ không thể thay.
Bạn có sẵn sàng ngồi trên một chiếc xe đã học lái phần lớn trong thế giới ảo không? Hãy chia sẻ suy nghĩ trong phần bình luận, và theo dõi Nhật Phúc để đọc thêm những bài giải thích dễ hiểu về xe điện và công nghệ trên ô tô.
Nguồn tham khảo
- Nature (2024): Shumailov và cộng sự, AI models collapse when trained on recursively generated data
- arXiv (2024): Gerstgrasser và cộng sự, Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data
- RAND Corporation (2016): Driving to Safety, How Many Miles of Driving Would It Take to Demonstrate Autonomous Vehicle Reliability?
- Waymo: Safety Impact, số dặm chạy không người lái và dữ liệu an toàn
- Waymo Blog (2026): The Waymo World Model, A New Frontier for Autonomous Driving Simulation
- NVIDIA Newsroom: Cosmos World Foundation Models and Physical AI Data Tools
- TechCrunch (2025): Nvidia releases its own brand of world models
- Engadget (2019): tổng hợp kết luận của NTSB về vụ tai nạn xe tự lái thử nghiệm tại Tempe
- CARLA: trình mô phỏng lái xe tự động mã nguồn mở