Một cỗ máy từ chối khoản vay của bạn. Bạn hỏi vì sao. Kỹ sư tạo ra nó nhún vai: “Chúng tôi cũng không biết chính xác.” Nghe như đùa, nhưng với nhiều hệ thống trí tuệ nhân tạo hiện đại, đó là sự thật. Hiện tượng này có tên gọi riêng: hộp đen AI.
Vậy hộp đen AI là gì, vì sao AI ra quyết định mà ngay cả người làm ra nó cũng không giải thích được, và các nhà khoa học đang làm gì để soi đèn vào bên trong? Bài viết này đi từng bước, bằng ví dụ đời thường, để bạn hiểu và biết cách tự bảo vệ mình khi gặp một quyết định “không lý do” từ máy.
Câu trả lời ngắn: Hộp đen AI là hệ thống mà ta thấy được đầu vào và đầu ra, nhưng không thấy lý do ở giữa. Mạng nơ-ron không có luật do người viết; nó tự chỉnh hàng tỷ con số qua hàng triệu ví dụ, nên lý do nằm rải rác trong những con số đó và rất khó đọc ra. Ngành AI giải thích được (Explainable AI) đang tìm cách soi vào.
Nếu muốn nắm ý chính trong khoảng ba phút rưỡi, bạn có thể xem video giải thích hộp đen AI của kênh Vọc Sĩ trước, sau đó đọc tiếp để hiểu sâu hơn từng phần.
Tóm tắt nhanh
- Hộp đen AI: thấy đầu vào, thấy đầu ra, không thấy lý do ở giữa.
- Phần mềm truyền thống có luật để đọc; mạng nơ-ron chỉ có hàng tỷ con số tự điều chỉnh.
- Thí nghiệm chó husky và chó sói cho thấy AI có thể đúng đáp án nhưng sai lý do.
- AI giải thích được dùng cách “hỏi ngược”: che, đổi đầu vào rồi xem kết quả thay đổi thế nào.
- Lời giải thích cũng có thể sai, và mô hình dễ giải thích thường kém mạnh hơn.
- Quyết định càng ảnh hưởng đời người, càng cần lý do rõ ràng và con người xem xét lại.
Nội dung chính:
- Hộp đen AI là gì?
- Vì sao mạng nơ-ron khác phần mềm truyền thống?
- Thí nghiệm chó husky và chó sói
- Vì sao hộp đen AI đáng lo?
- AI giải thích được (Explainable AI) là gì?
- Giới hạn thật sự của lời giải thích
- Hiểu lầm phổ biến về hộp đen AI
- Dùng AI ở đâu, với mức giải thích nào?
- Câu hỏi thường gặp
Hộp đen AI là gì?
Trong kỹ thuật, hộp đen (black box) là cách gọi một hệ thống mà ta thấy được đầu vào và đầu ra, nhưng không thấy được lý do ở giữa. Bạn đưa vào một hồ sơ vay, máy trả ra “đồng ý” hoặc “từ chối”. Còn tại sao lại ra kết quả đó thì nằm kín trong chiếc hộp.
Hãy hình dung chiếc máy bán nước tự động nhả nhầm lon. Bạn biết mình đã bấm nút nào, bạn thấy lon nào rơi ra, nhưng bạn không thể hỏi từng bánh răng bên trong xem ai làm sai. Với AI, “bánh răng” còn nhiều hơn thế rất nhiều: có thể là hàng tỷ con số.
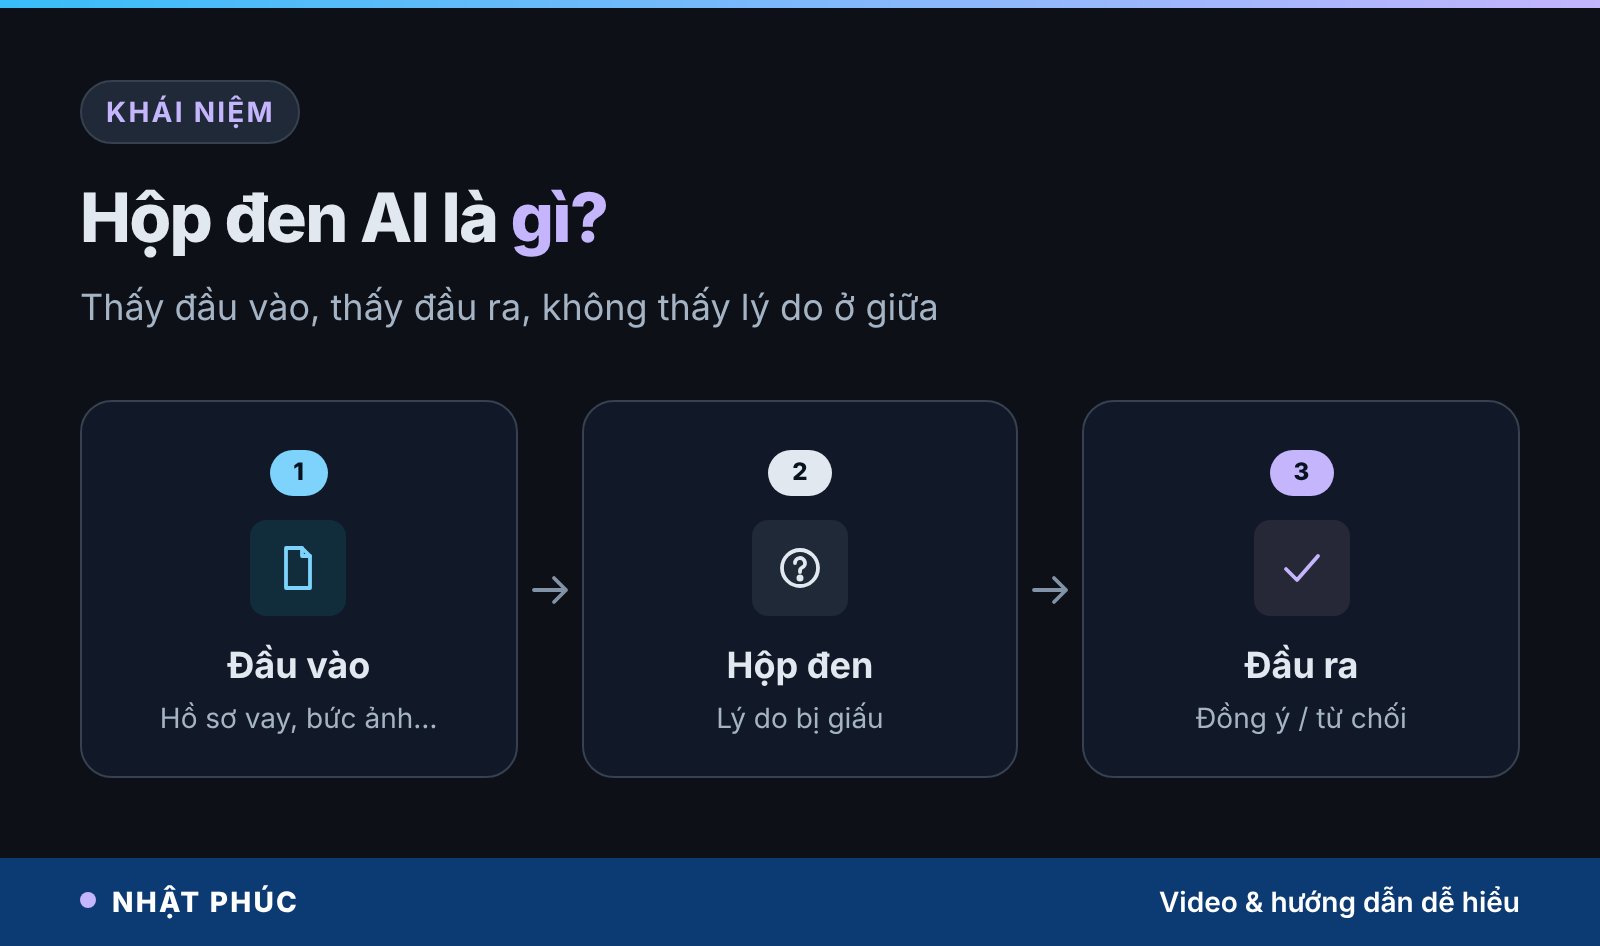
Cần nói rõ: “hộp đen” không có nghĩa là AI được thiết kế để che giấu. Ngay cả kỹ sư có toàn quyền truy cập vào mô hình, đọc được từng con số bên trong, vẫn khó trả lời câu hỏi đơn giản “vì sao”. Vấn đề không phải bị khóa, mà là quá phức tạp để đọc.
Vì sao mạng nơ-ron khác phần mềm truyền thống?
Phần mềm truyền thống: có luật để đọc
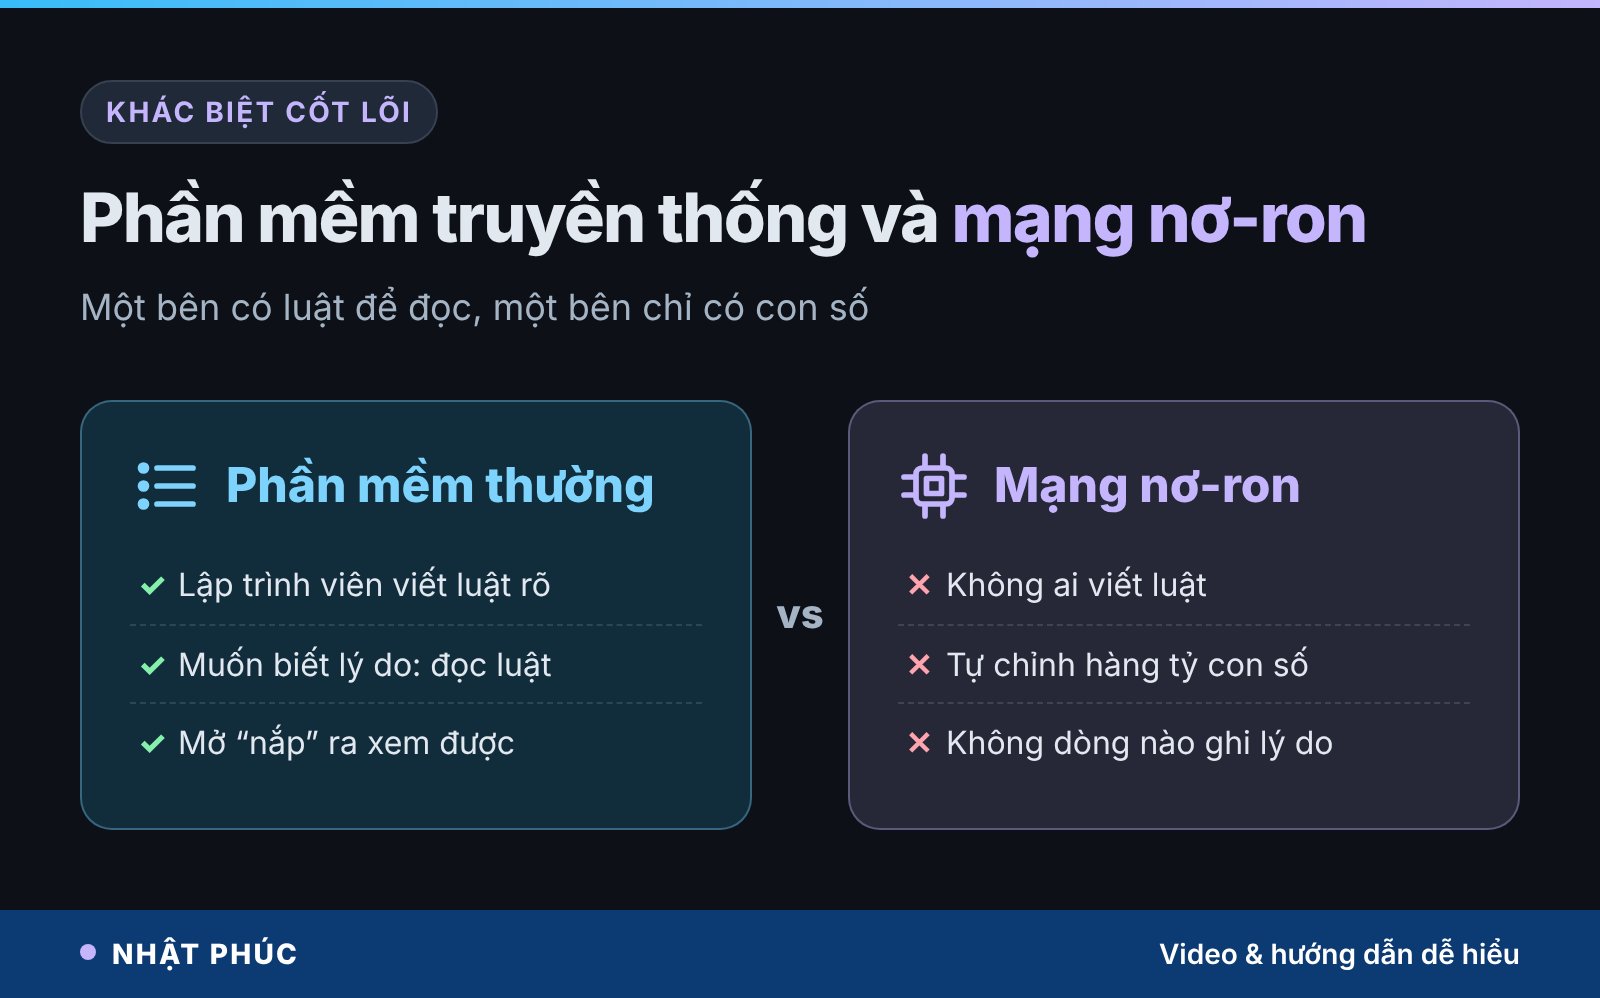
Với phần mềm truyền thống, ta vẫn mở được nắp. Lập trình viên viết luật rõ ràng, ví dụ: “Nếu thu nhập thấp hơn mức này thì từ chối.” Muốn biết lý do, chỉ cần đọc luật. Khi khách hàng thắc mắc, ngân hàng có thể chỉ ra đúng dòng điều kiện đã khiến hồ sơ bị loại.
Mạng nơ-ron: không ai viết luật
Mạng nơ-ron nhân tạo (neural network) thì khác hẳn. Không ai viết luật cho nó. Người ta đưa vào hàng triệu ví dụ, kèm đáp án đúng, và máy tự chỉnh hàng tỷ con số bên trong, gọi là trọng số, cho đến khi trả lời đúng. Quá trình này gọi là huấn luyện.
Kết quả là một mớ con số khổng lồ. Không có dòng nào ghi “từ chối vì lý do này”. Mỗi con số chỉ đóng góp một chút xíu, và chỉ khi hàng tỷ con số cùng phối hợp thì quyết định mới hình thành.
Ví von món canh
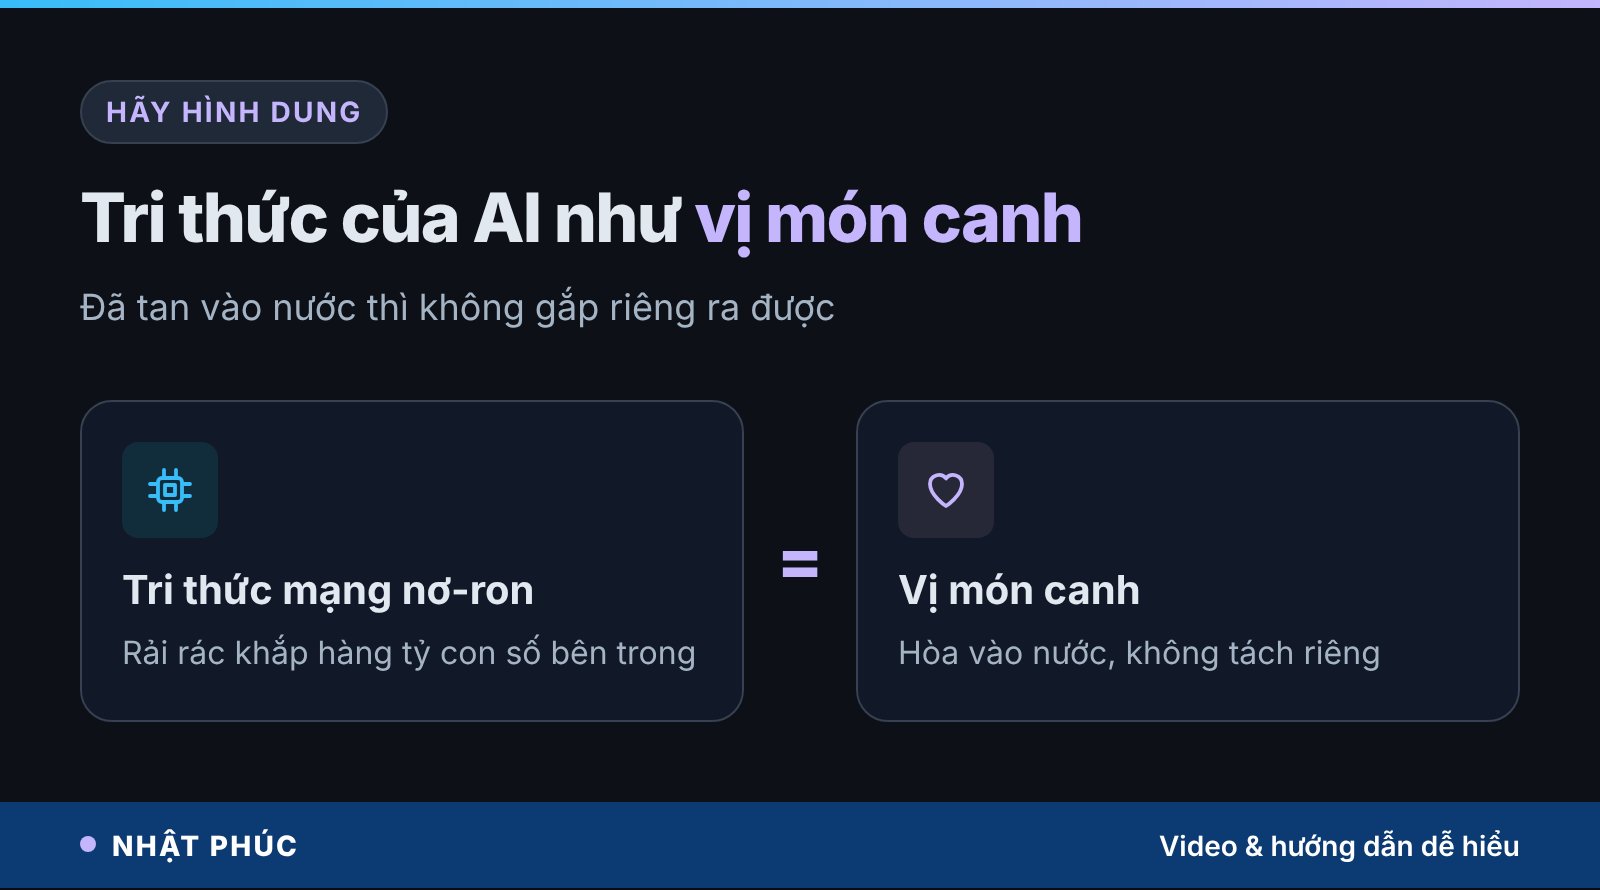
Tri thức của mạng nơ-ron nằm rải rác khắp mọi nơi, giống như vị của món canh đã tan vào nước. Bạn nếm được vị ngọt của xương, vị thơm của hành, nhưng không thể gắp riêng ra từng thứ. Muốn biết “vị mặn đến từ đâu”, bạn chỉ có thể đoán dựa trên kinh nghiệm, chứ không múc ra được một thìa “mặn nguyên chất”.
Đây cũng là lý do mạng nơ-ron mạnh: nó tự tìm ra những mẫu hình mà con người khó mô tả bằng luật, như nhận ra khuôn mặt hay hiểu một câu nói. Sức mạnh và sự khó hiểu đến từ cùng một nguồn.
Thí nghiệm chó husky và chó sói
Chuyện hộp đen gây rắc rối thật, và có một thí nghiệm nổi tiếng trong giới nghiên cứu minh họa rất rõ. Người ta dạy một mô hình phân biệt chó husky với chó sói, hai loài trông khá giống nhau. Mô hình làm rất tốt.
Nhưng khi các nhà nghiên cứu soi xem máy nhìn vào đâu trong ảnh, họ giật mình. Nó gần như không nhìn con vật. Nó nhìn nền ảnh. Ảnh chó sói trong bộ dữ liệu thường có tuyết, nên máy rút ra một “quy luật” rất tiện: có tuyết là chó sói. Đáp án đúng, lý do sai hoàn toàn.
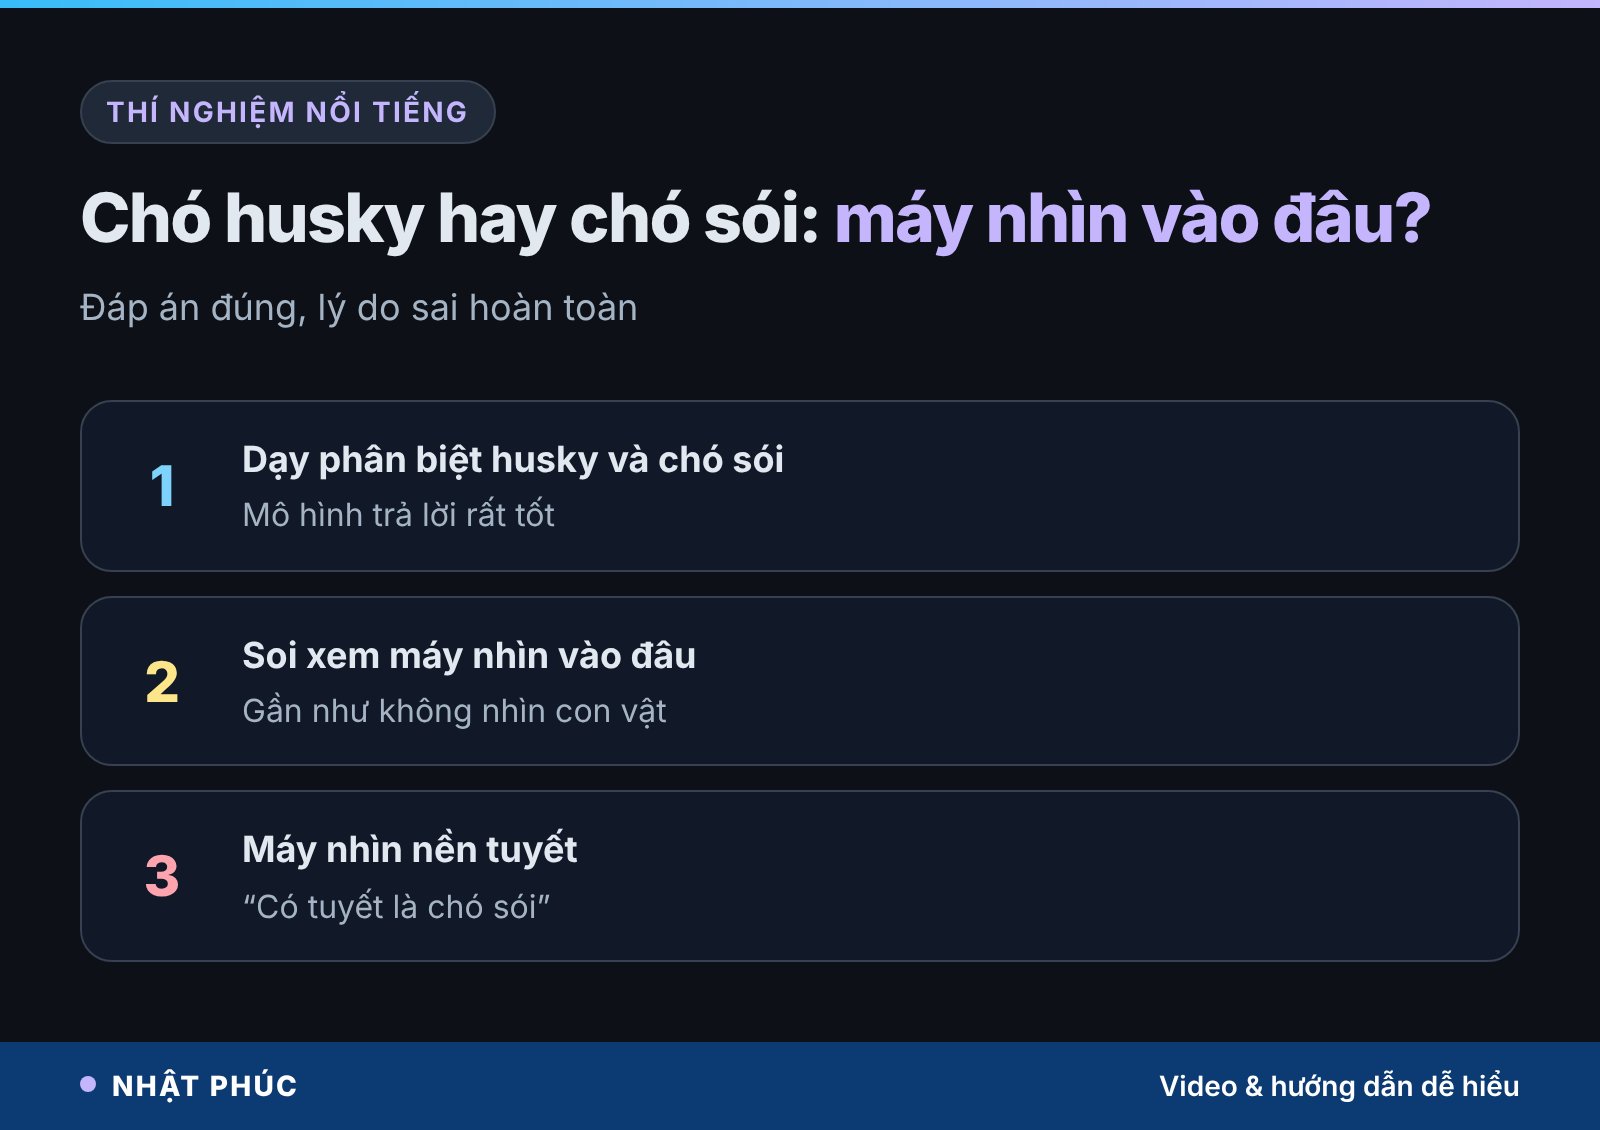
Thí nghiệm này xuất hiện trong một bài nghiên cứu năm 2016 giới thiệu phương pháp giải thích có tên LIME. Các tác giả cố ý dựng bộ dữ liệu có “bẫy” như vậy để kiểm tra xem con người có nhận ra mô hình học sai hay không khi chỉ nhìn độ chính xác, và khi được xem lời giải thích. Kết quả cho thấy: không có lời giải thích, người ta rất dễ tin nhầm một mô hình “học vẹt”.
Bài học: độ chính xác cao chưa chắc là hiểu đúng
Mô hình có thể đạt điểm cao trên bộ kiểm tra chỉ vì bộ kiểm tra có cùng “bẫy” với bộ huấn luyện. Khi gặp một bức ảnh husky trên tuyết, nó sẽ sai ngay. Vấn đề là bạn không biết điều đó cho tới khi chuyện xảy ra.
Vì sao hộp đen AI đáng lo?
Với chó và sói, sai một chút chỉ là chuyện vui. Bây giờ hãy thay con husky bằng một bệnh nhân, một ứng viên xin việc, hoặc một bị cáo. Máy có thể đúng gần như mọi lần, nhưng nếu nó đúng vì một lý do kỳ quặc, ta sẽ chỉ biết khi nó sai, và lúc đó có thể đã quá muộn.
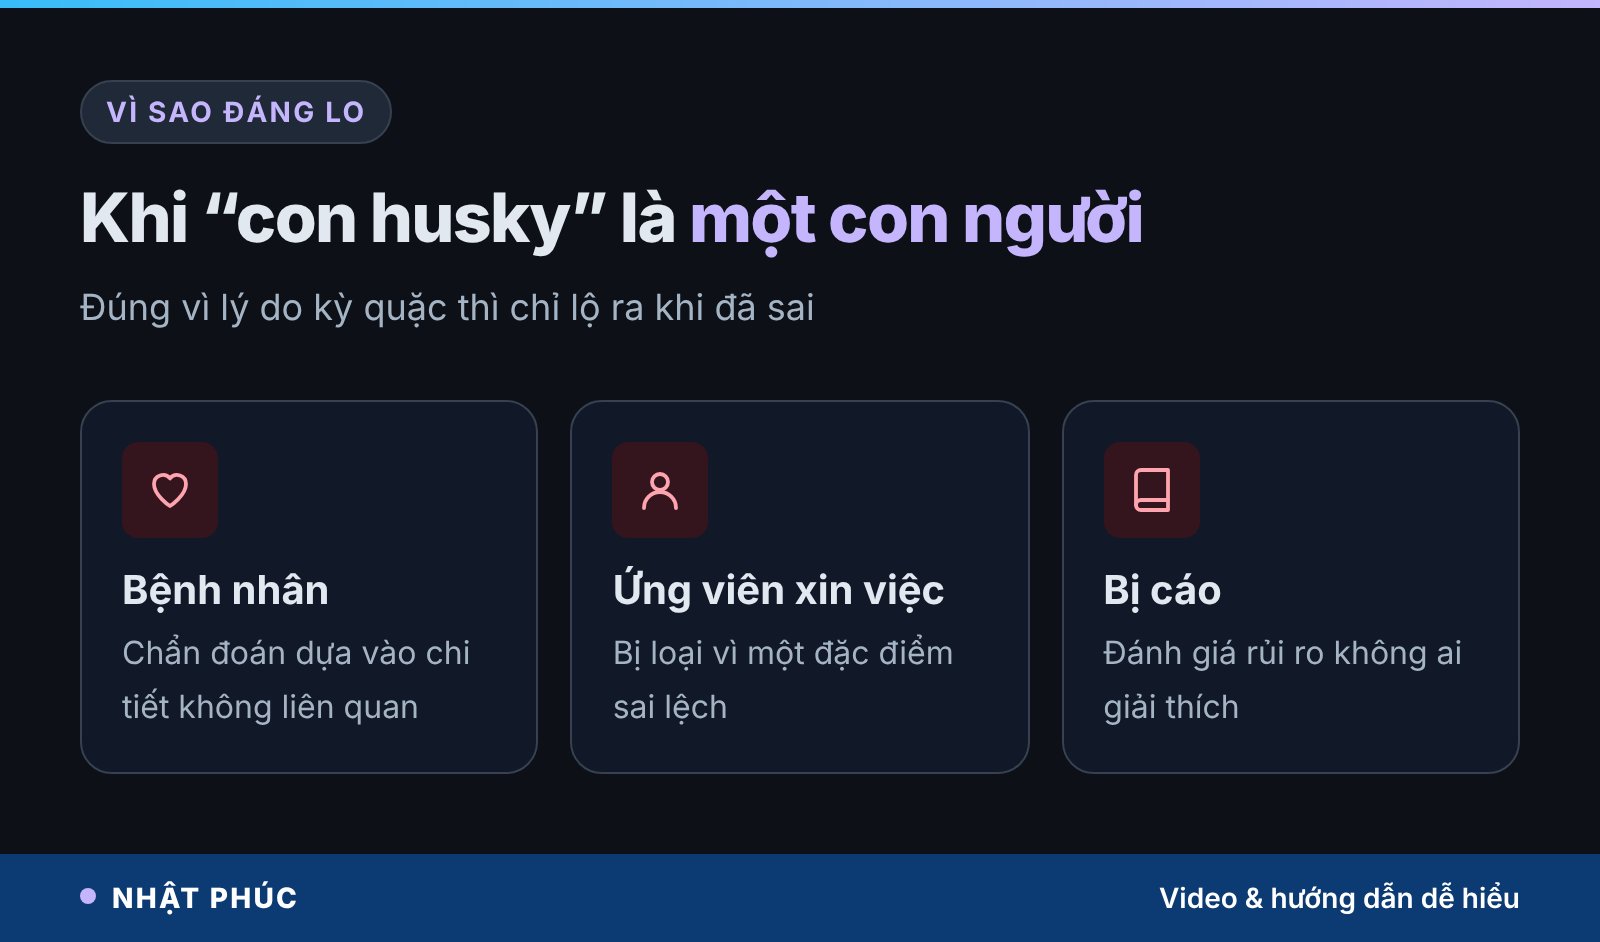
- Y tế: một mô hình đọc phim chụp có thể học theo chi tiết không liên quan đến bệnh, như ký hiệu của từng loại máy chụp, thay vì dấu hiệu bệnh thật.
- Tuyển dụng: nếu dữ liệu quá khứ có thiên kiến, mô hình có thể “học” luôn thiên kiến đó và loại ứng viên vì một đặc điểm không liên quan đến năng lực.
- Tín dụng, pháp lý: người bị ảnh hưởng có quyền chính đáng được biết vì sao, và để khiếu nại họ cần một lý do cụ thể.
Ngoài chuyện công bằng, còn có chuyện cải tiến: nếu không biết mô hình sai vì đâu, kỹ sư rất khó sửa đúng chỗ.
AI giải thích được (Explainable AI) là gì?
Vậy các nhà khoa học đang làm gì? Họ phát triển một ngành gọi là AI giải thích được, tiếng Anh là Explainable AI, thường viết tắt là XAI. Mục tiêu là giúp con người hiểu vì sao mô hình đưa ra một quyết định cụ thể.
Cách phổ biến: hỏi ngược lại
Cách phổ biến là hỏi ngược lại. Che một phần bức ảnh đi, xem câu trả lời có đổi không. Đổi một con số trong hồ sơ vay, xem kết quả có lật không. Làm đi làm lại nhiều lần, ta dần vẽ ra được những yếu tố nào đang kéo quyết định về phía nào.
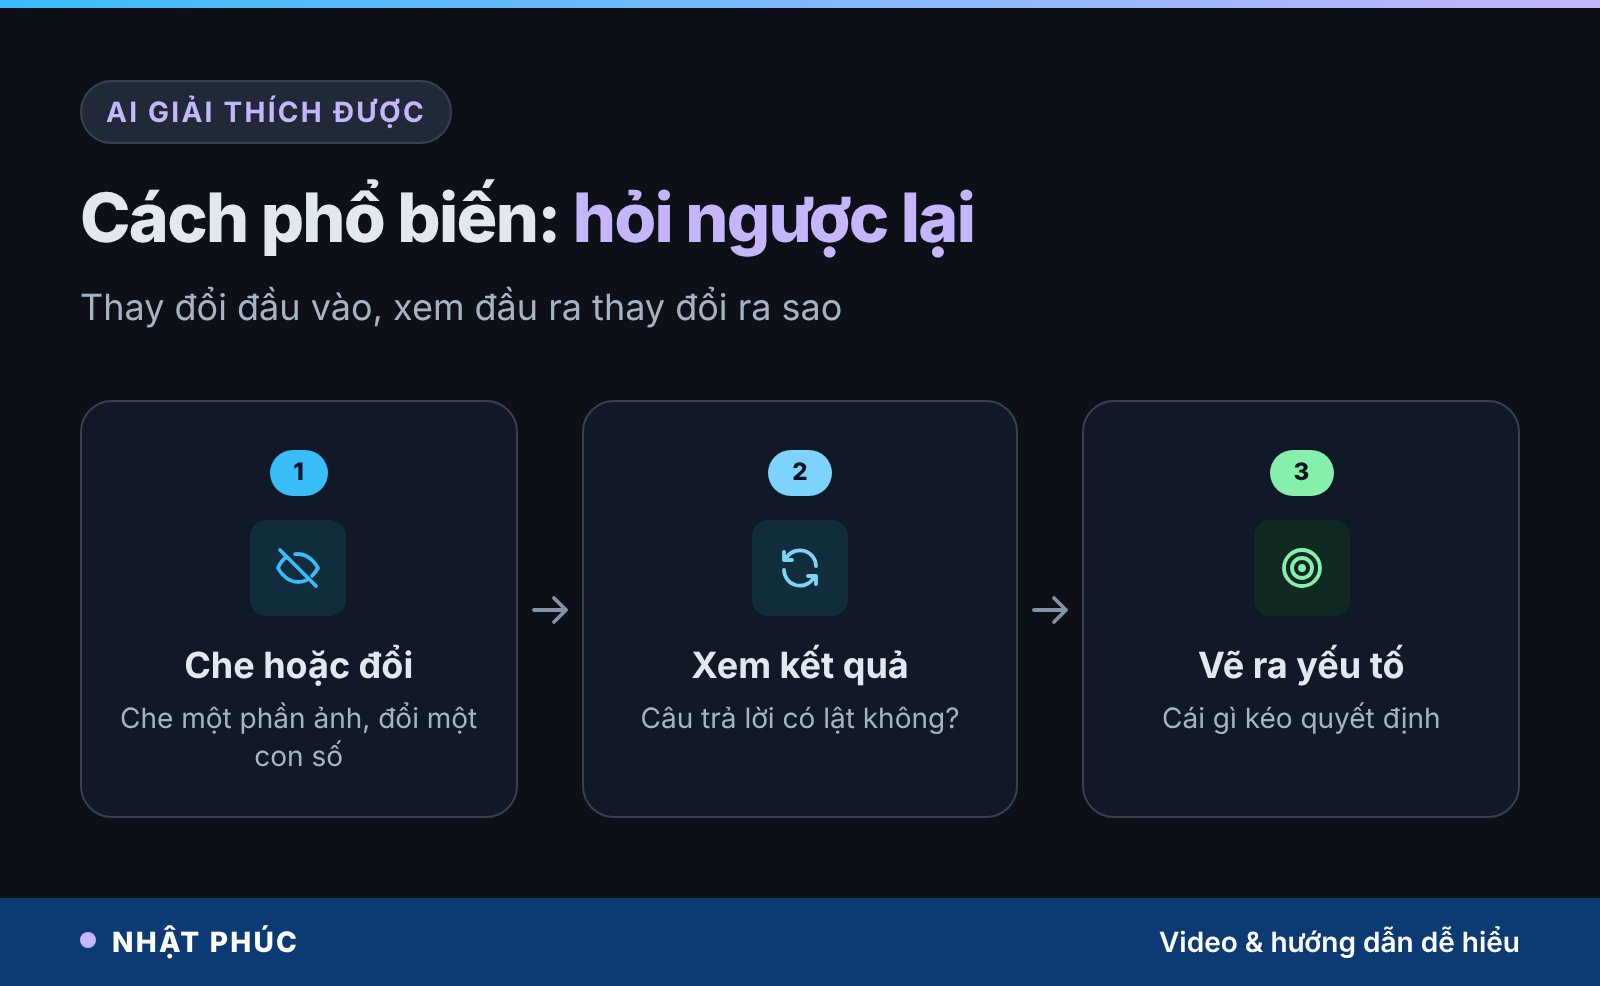
Ví dụ với hồ sơ vay: nếu tăng thu nhập thêm một chút mà kết quả chuyển từ “từ chối” sang “đồng ý”, ta biết thu nhập là yếu tố quan trọng. Nếu đổi địa chỉ mà kết quả cũng lật, đó là dấu hiệu đáng lo, vì địa chỉ không nên quyết định khả năng trả nợ.
Một số công cụ thường gặp
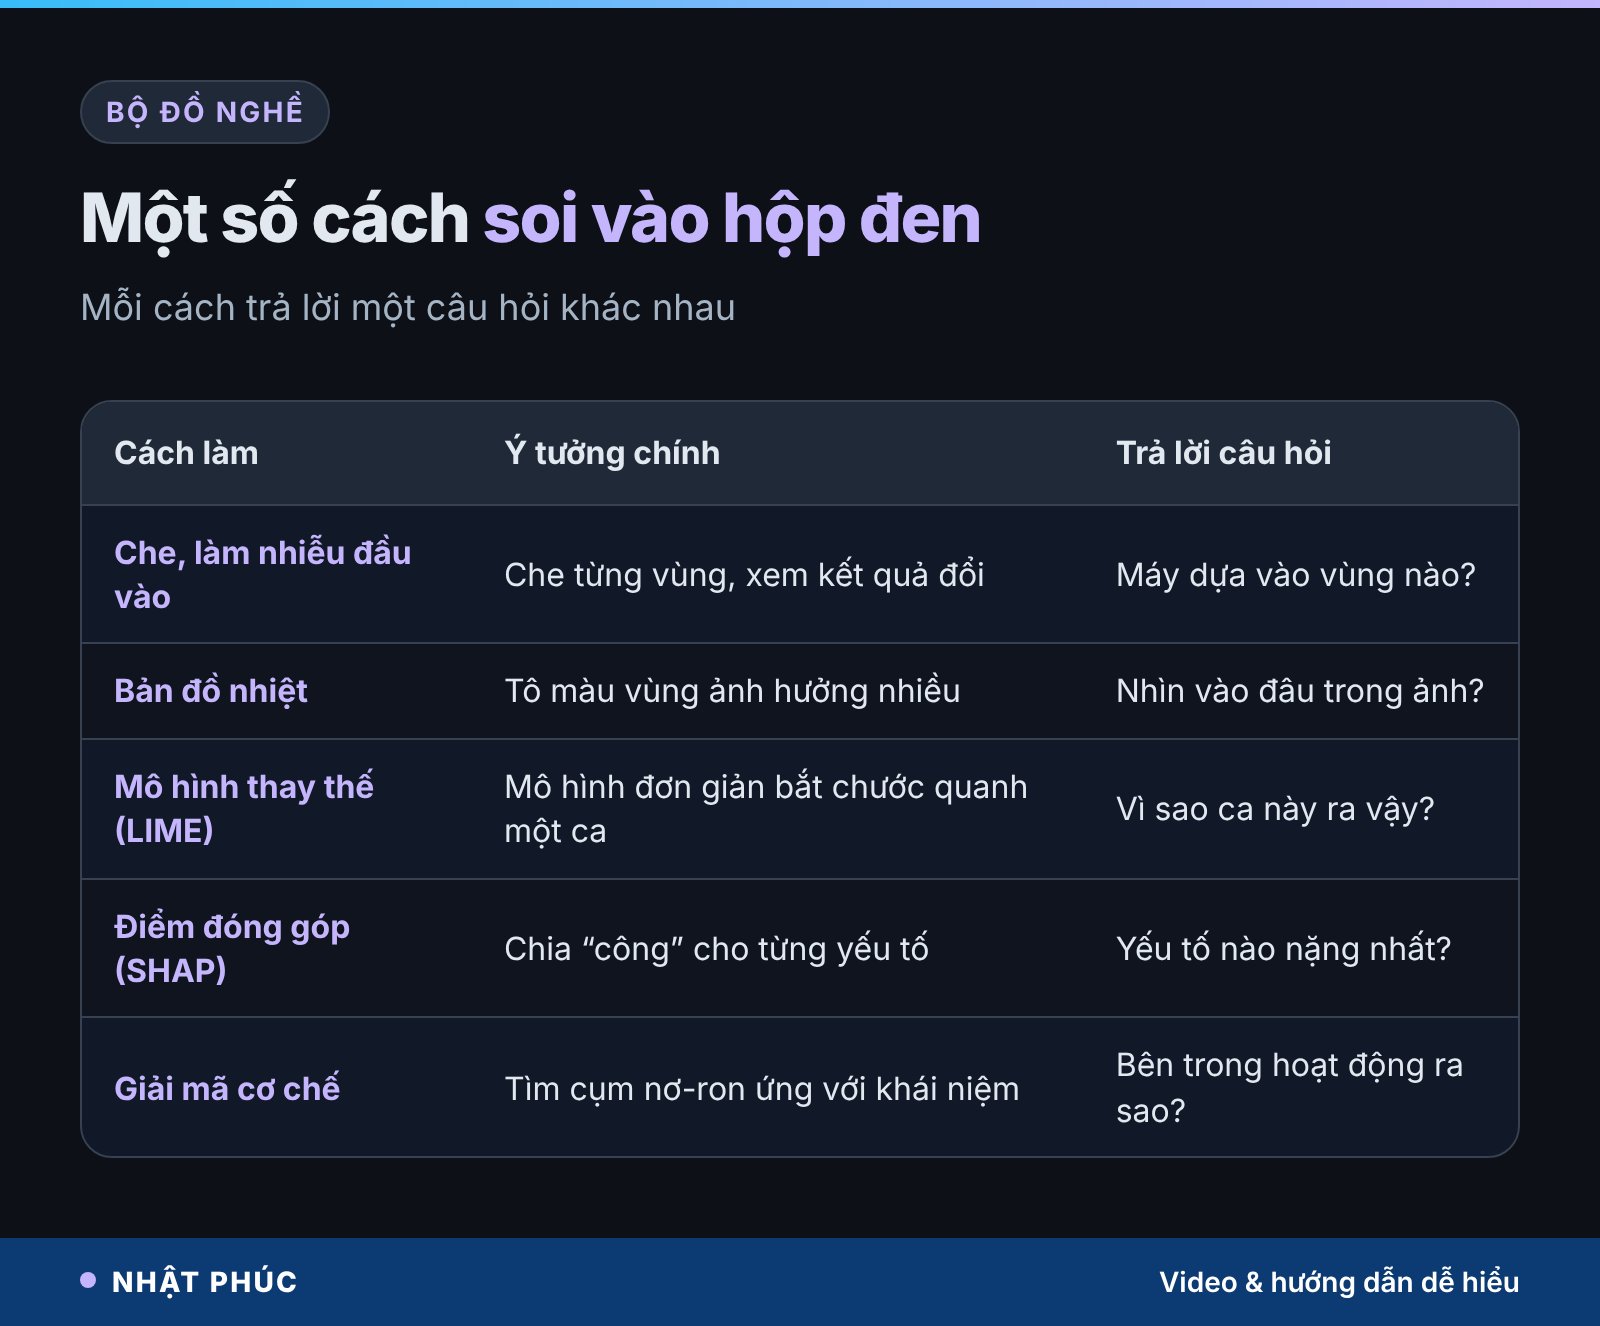
- Che, làm nhiễu đầu vào: che từng vùng ảnh hoặc thay từng trường dữ liệu để xem mô hình nhạy với phần nào.
- Bản đồ nhiệt (saliency map): tô màu những vùng ảnh ảnh hưởng nhiều nhất đến kết quả. Trong thí nghiệm husky, bản đồ nhiệt sẽ “sáng” ở vùng tuyết.
- LIME: dựng một mô hình đơn giản bắt chước mô hình phức tạp ở vùng quanh một trường hợp cụ thể, để giải thích riêng trường hợp đó.
- SHAP: dựa trên một ý tưởng từ lý thuyết trò chơi để chia “công” cho từng yếu tố, cho biết yếu tố nào đóng góp nhiều nhất.
Hướng đi sâu hơn: giải mã cơ chế bên trong
Một hướng đi sâu hơn gọi là giải mã cơ chế bên trong (mechanistic interpretability). Thay vì chỉ quan sát đầu vào và đầu ra, các nhà nghiên cứu cố tìm xem từng cụm nơ-ron đảm nhiệm khái niệm gì, giống như vẽ bản đồ não vậy: vùng này phản ứng với “mèo”, vùng kia phản ứng với “câu hỏi về toán”.
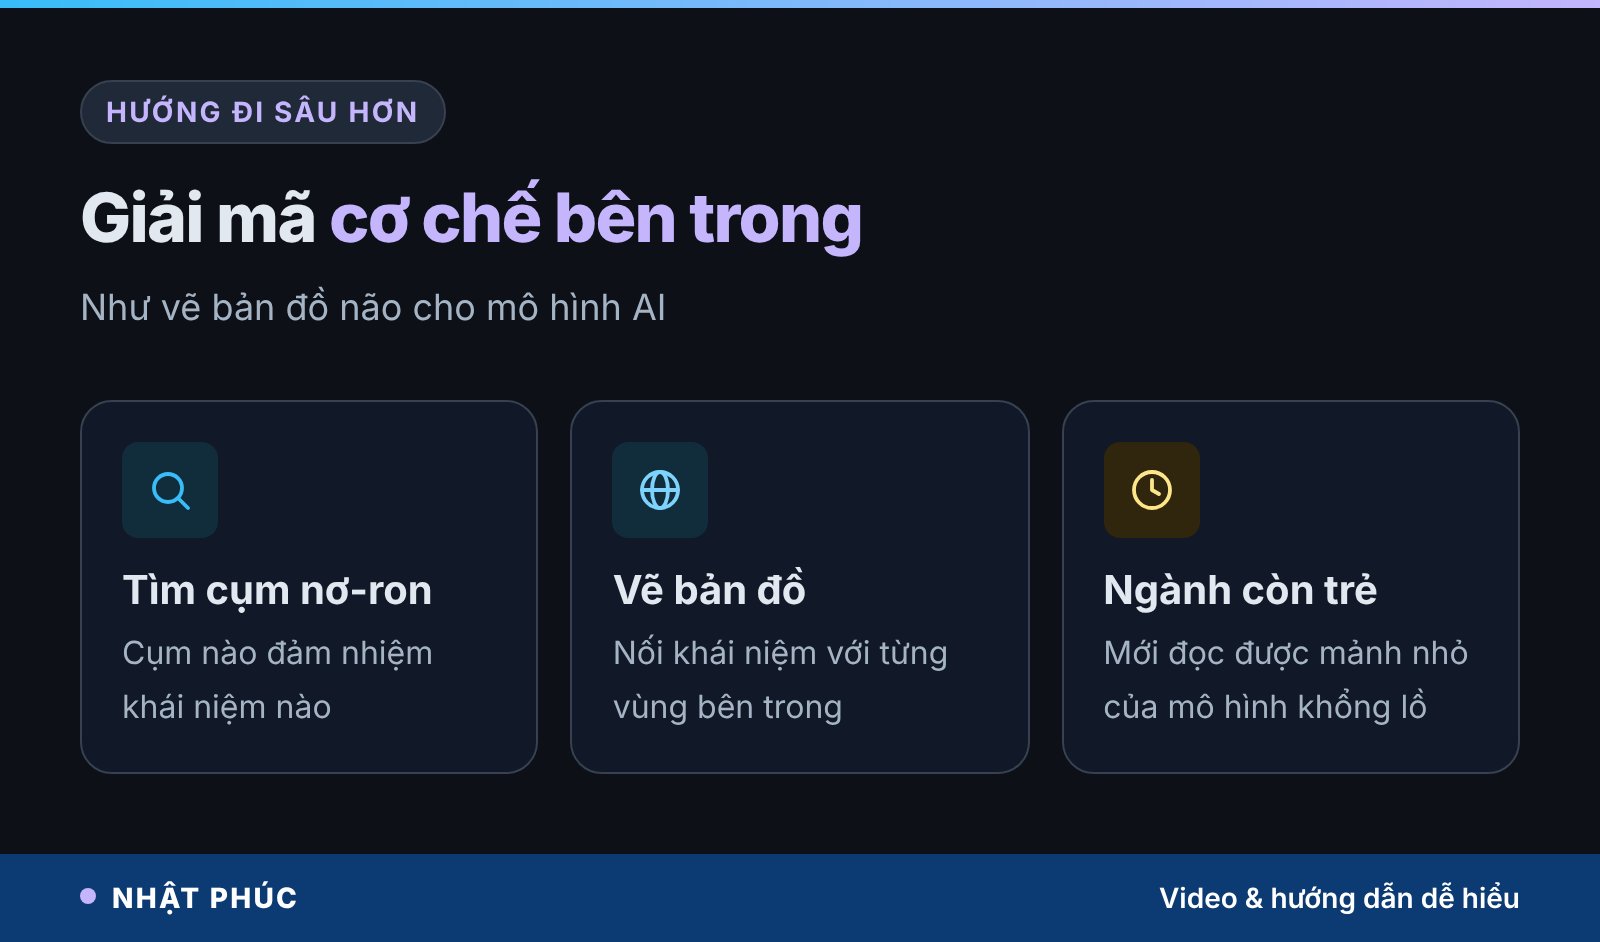
Ngành này còn rất trẻ và mới chỉ đọc được những mảnh nhỏ của những mô hình khổng lồ. Nhưng mỗi mảnh đọc được là một bước giúp ta hiểu và kiểm soát AI tốt hơn.
Giới hạn thật sự của lời giải thích
Còn đây là phần ít người nhắc tới: giới hạn thực sự.
Lời giải thích cũng có thể sai
Một bản giải thích nghe hợp lý chưa chắc phản ánh đúng điều đã xảy ra bên trong máy. Các phương pháp như LIME hay SHAP đều là cách ước lượng; chúng có thể cho kết quả khác nhau trên cùng một mô hình. Một lời giải thích “trơn tru” đôi khi còn nguy hiểm hơn không có lời giải thích, vì nó khiến ta tin quá mức.
Đánh đổi giữa dễ hiểu và mạnh
Thường có sự đánh đổi. Mô hình đơn giản, như một bộ luật “nếu… thì…” hay một cây quyết định nhỏ, dễ giải thích hơn nhưng hay kém chính xác hơn với bài toán phức tạp. Còn mô hình mạnh nhất lại khó hiểu nhất.
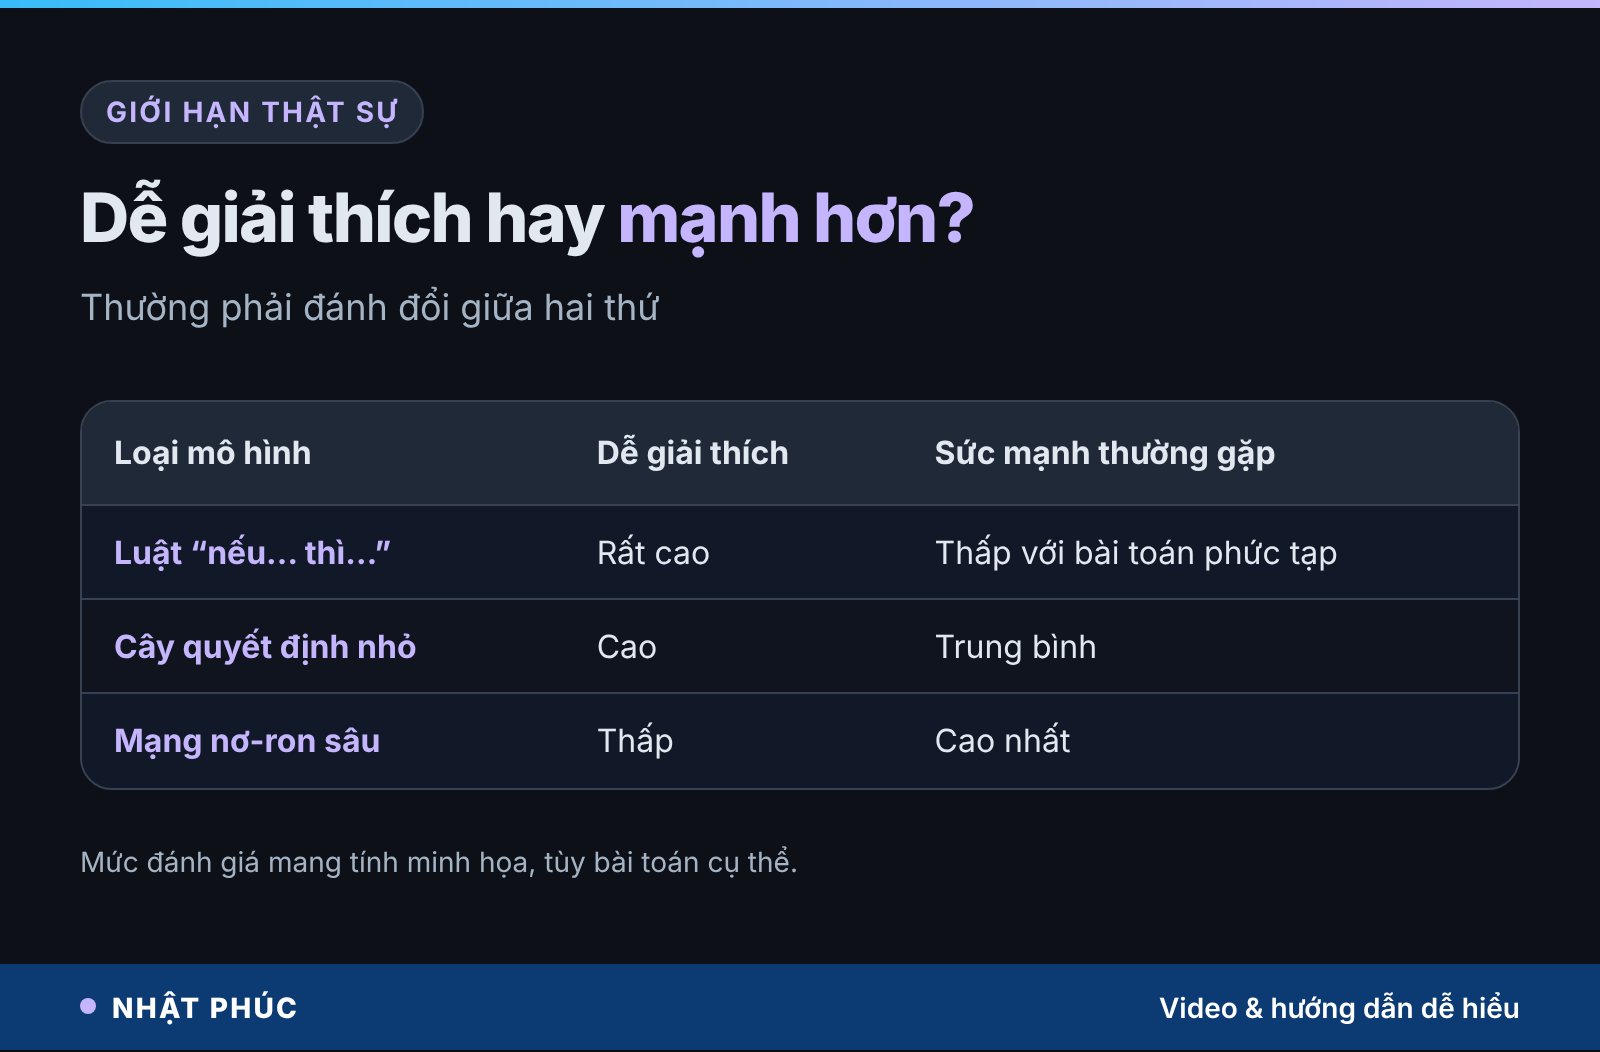
| Tiêu chí | Mô hình dễ giải thích | Mô hình hộp đen (mạng nơ-ron sâu) |
|---|---|---|
| Lý do quyết định | Đọc được trực tiếp | Phải ước lượng bằng công cụ |
| Bài toán phù hợp | Dữ liệu dạng bảng, ít yếu tố | Ảnh, giọng nói, ngôn ngữ |
| Độ chính xác thường gặp | Khá, kém hơn ở bài toán phức tạp | Cao ở bài toán phức tạp |
| Khi có sai sót | Dễ tìm và sửa đúng chỗ | Khó truy nguyên nhân |
Với y tế, tín dụng hay tòa án, ta không thể bỏ qua sự đánh đổi này. Đôi khi chấp nhận độ chính xác thấp hơn một chút để đổi lấy khả năng giải thích là lựa chọn đúng.
Hiểu lầm phổ biến về hộp đen AI
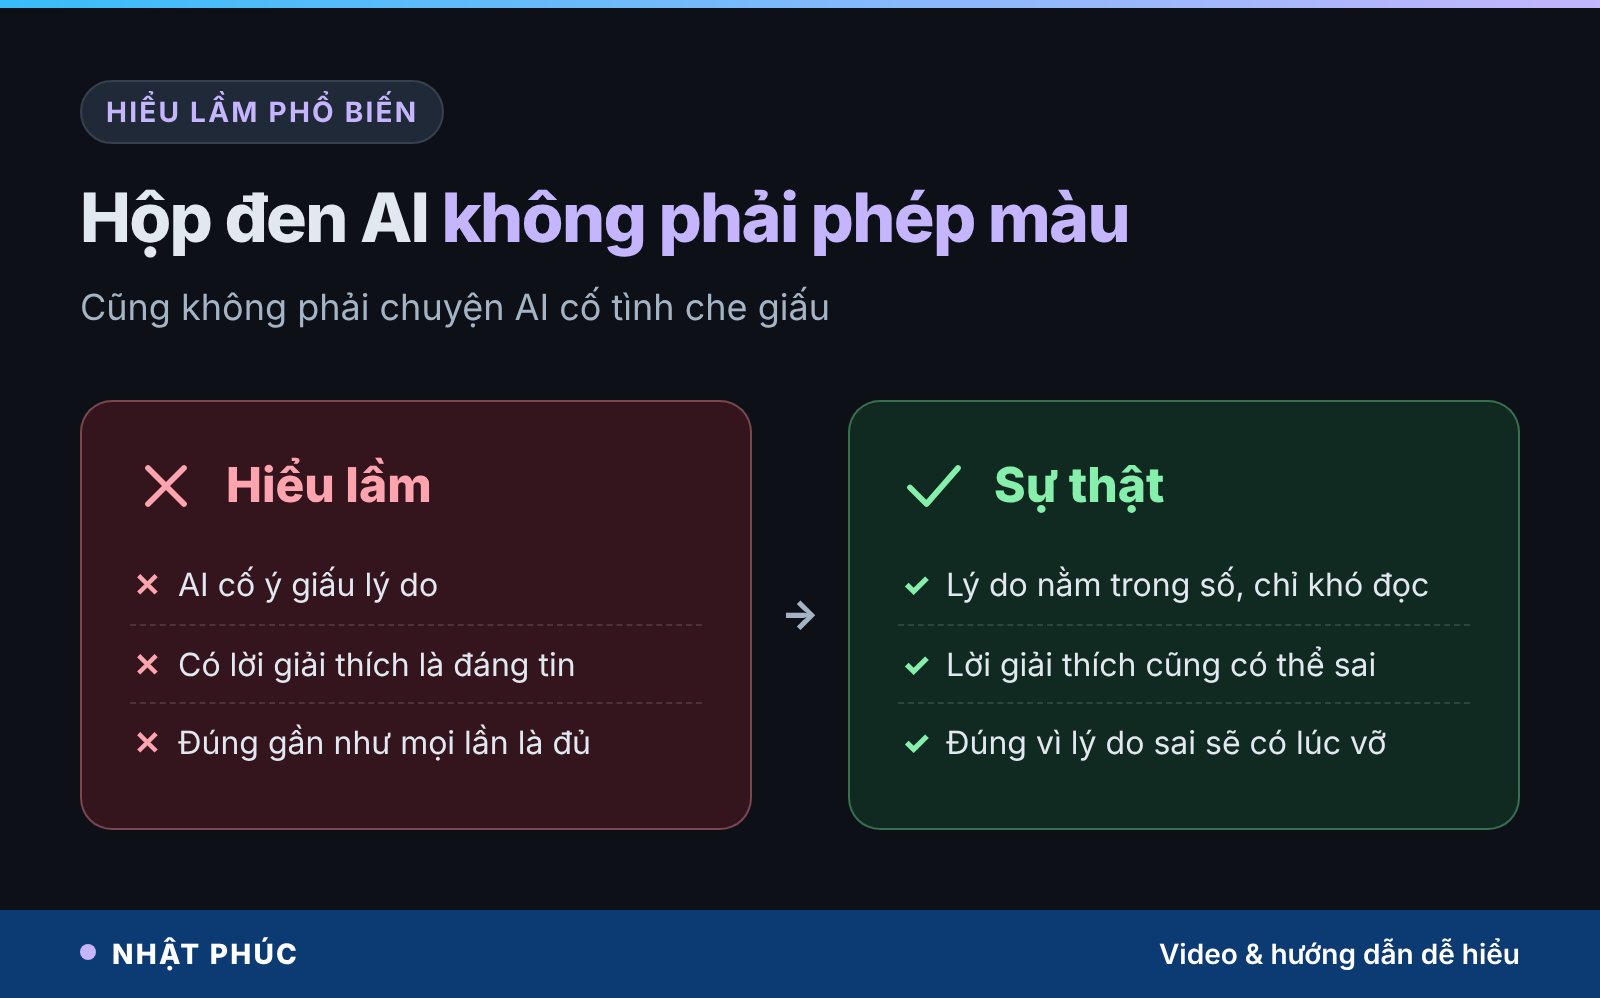
“AI cố tình giấu lý do”
AI không ác ý và không có ý định che giấu. Lý do nằm sẵn trong những con số, chỉ là con người chưa có đủ công cụ để đọc ra.
“Có lời giải thích là đáng tin”
Lời giải thích chỉ là một cách nhìn gần đúng. Cần kiểm tra chéo bằng nhiều phương pháp và bằng dữ liệu thực tế.
“Đúng gần như mọi lần là đủ”
Một mô hình đúng vì lý do sai sẽ có lúc “vỡ” khi gặp tình huống khác với dữ liệu huấn luyện, như husky đứng trên tuyết.
Dùng AI ở đâu, với mức giải thích nào?
Vì thế câu hỏi đúng không phải là “có nên dùng AI hay không”, mà là dùng ở đâu và với mức giải thích nào. Quyết định càng ảnh hưởng đến đời người, ta càng phải đòi hỏi lý do rõ ràng và luôn để con người nắm quyền xem xét lại.
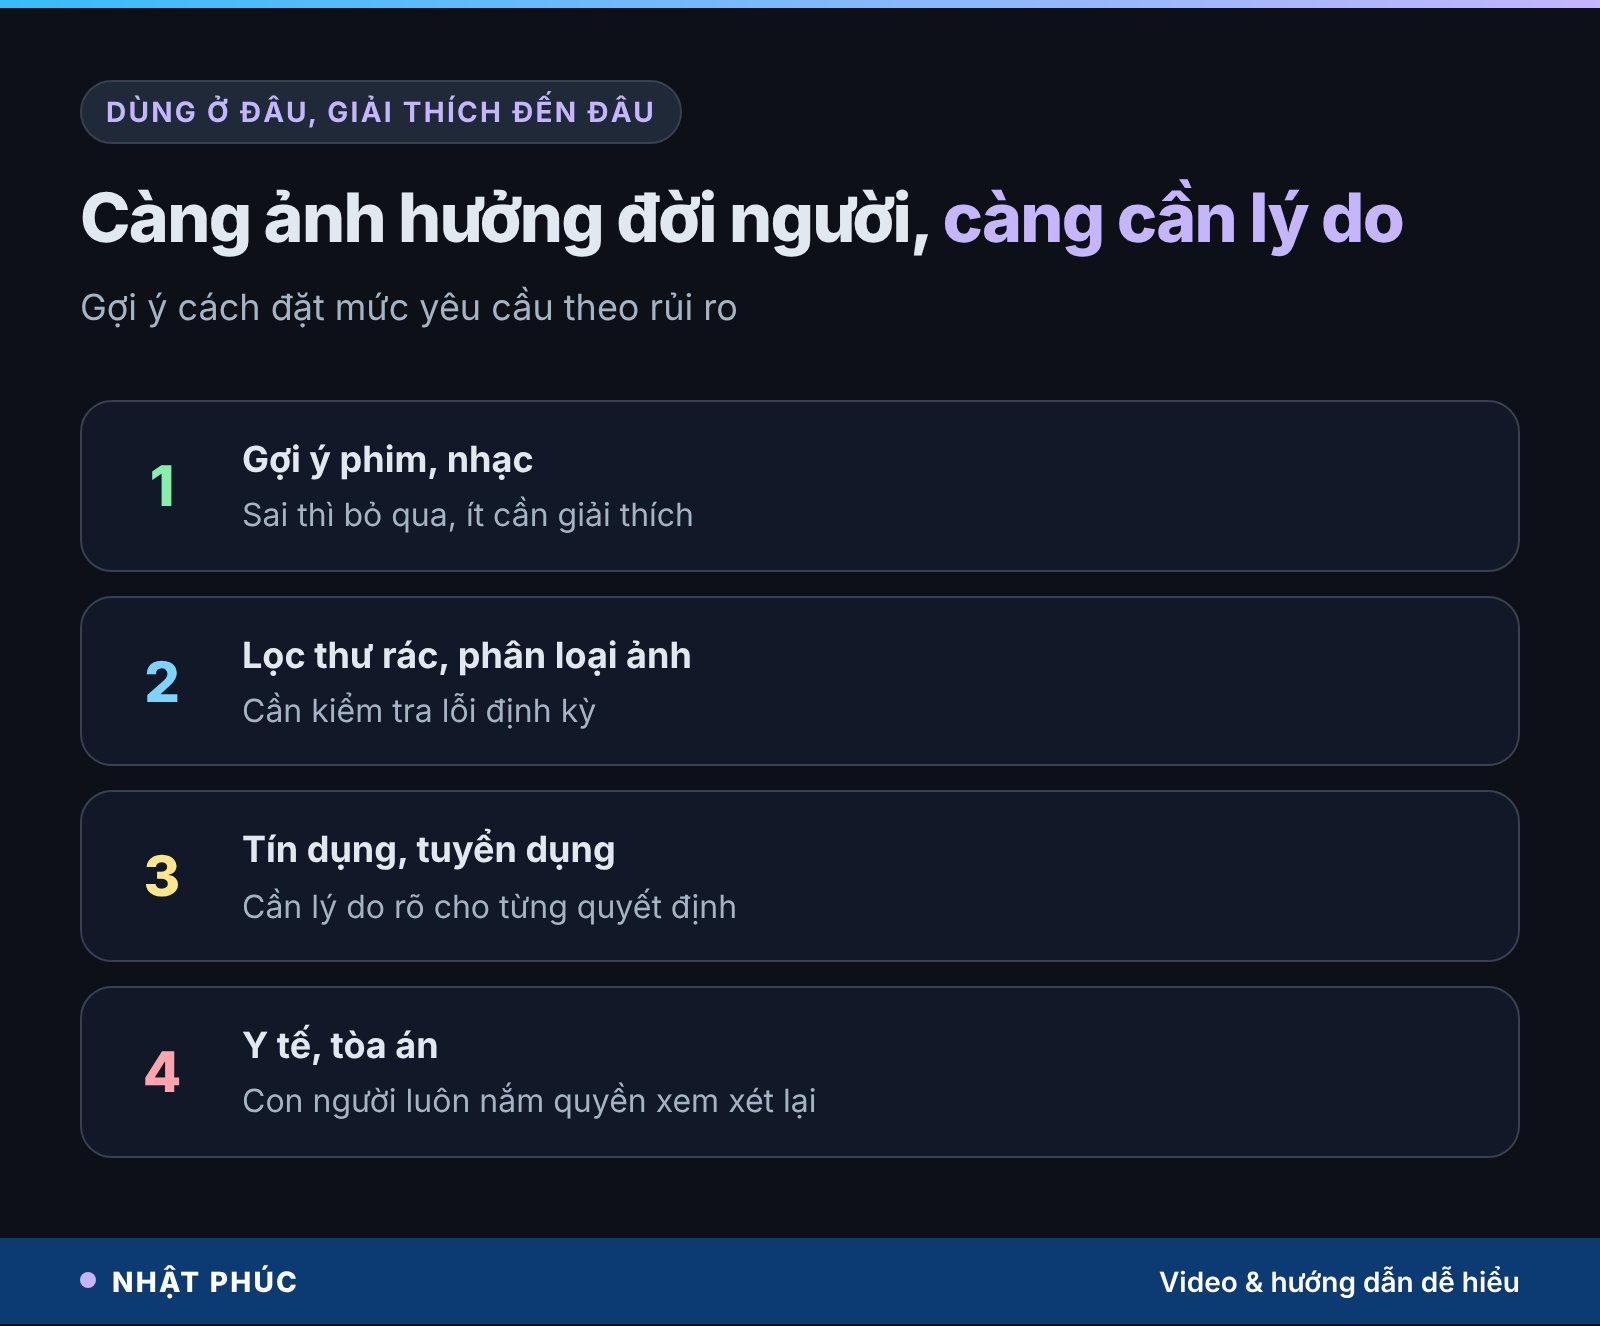
Đây cũng là hướng mà nhiều quy định đang đi theo. Ví dụ, Đạo luật AI của Liên minh châu Âu phân loại hệ thống theo mức rủi ro và đặt yêu cầu cao hơn về minh bạch, giám sát của con người với những hệ thống rủi ro cao như tuyển dụng hay chấm điểm tín dụng.
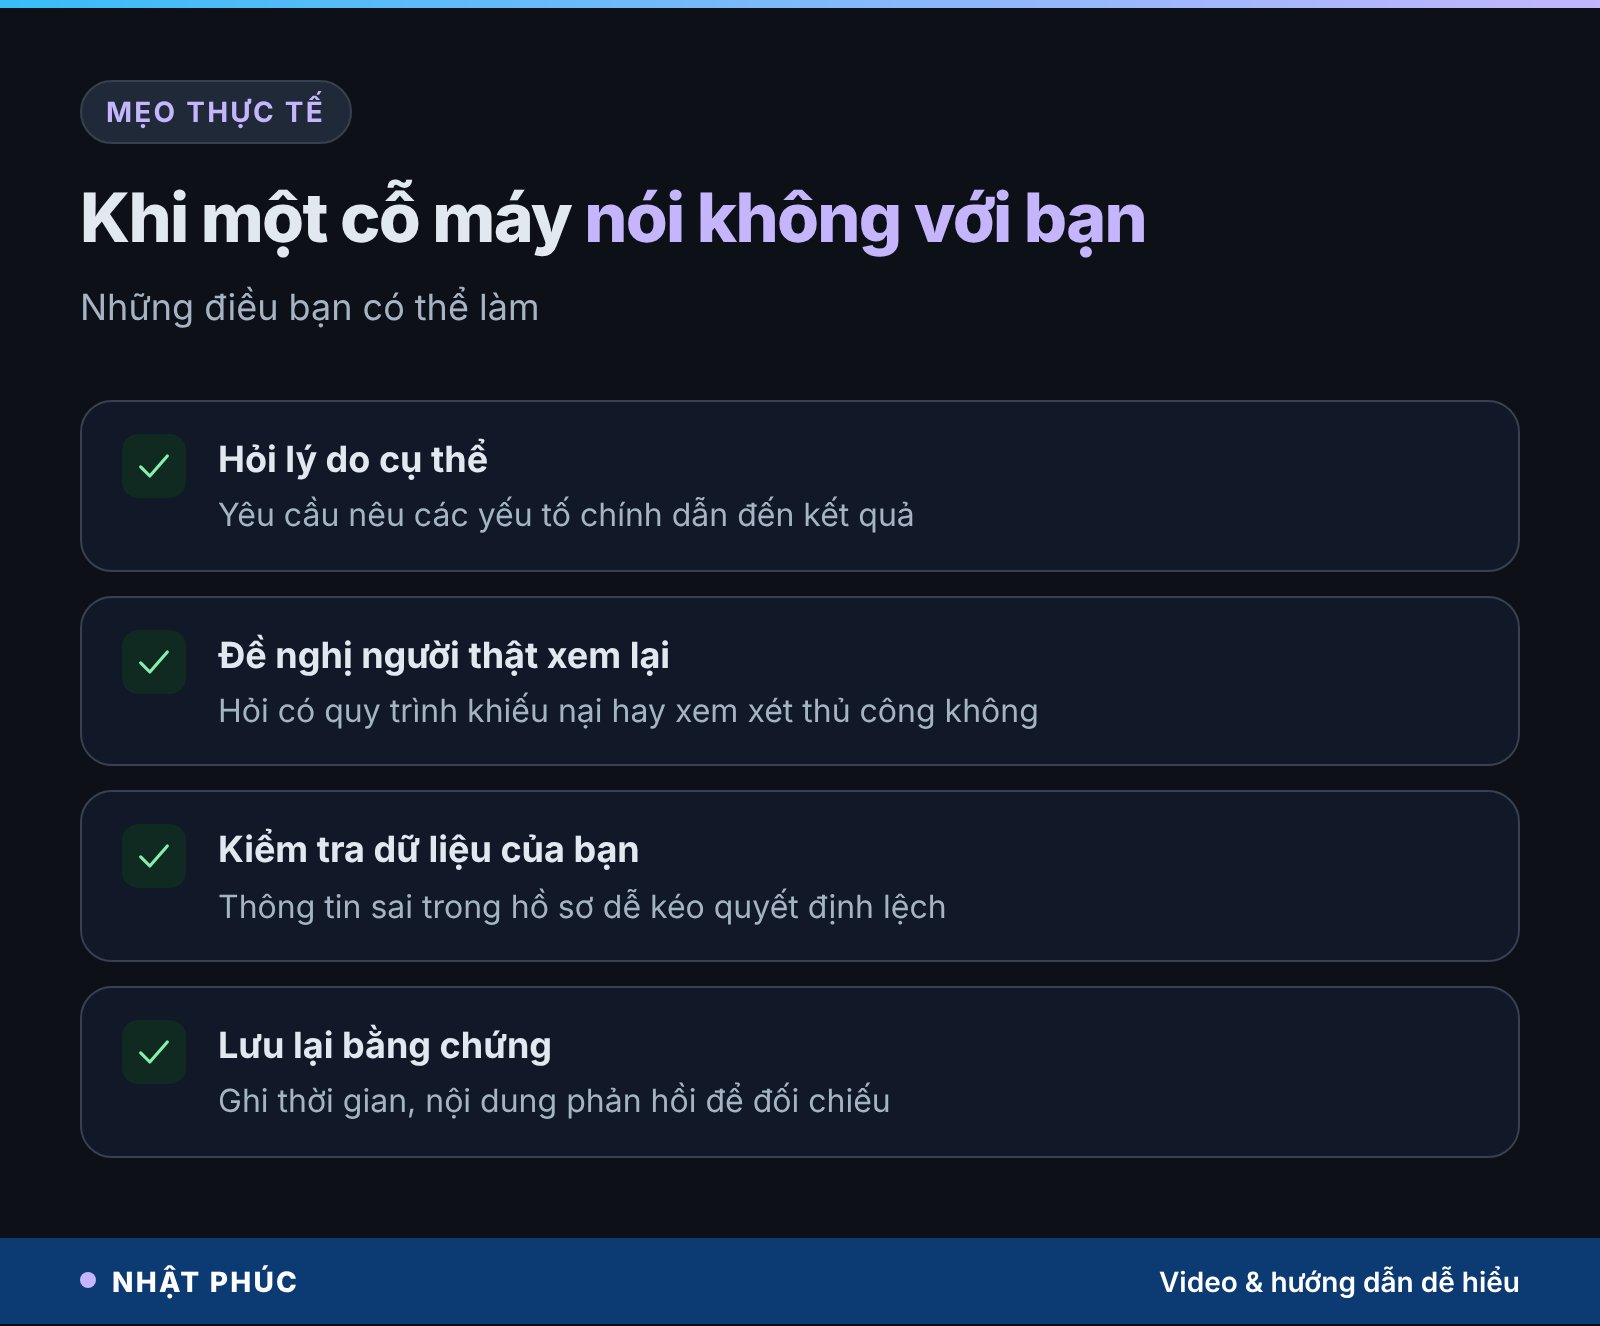
Khi bị một hệ thống tự động từ chối, bạn nên làm gì?
1. Hỏi lý do cụ thể
Yêu cầu nơi ra quyết định nêu các yếu tố chính dẫn đến kết quả, thay vì một câu trả lời chung chung.
2. Đề nghị người thật xem xét lại
Hỏi xem có quy trình khiếu nại hoặc xem xét thủ công không. Nhiều tổ chức có, nhưng chỉ làm khi bạn yêu cầu.
3. Kiểm tra dữ liệu của bạn
Thông tin sai hoặc thiếu trong hồ sơ rất dễ kéo quyết định lệch. Sửa dữ liệu đôi khi là cách nhanh nhất.
4. Lưu lại bằng chứng
Ghi lại thời gian, nội dung phản hồi để đối chiếu khi cần làm việc tiếp.
Câu hỏi thường gặp
Hộp đen AI có nghĩa là không ai biết AI hoạt động thế nào?
Không hẳn. Người ta hiểu rất rõ nguyên lý chung: mạng nơ-ron học bằng cách chỉnh trọng số theo dữ liệu. Điều khó là giải thích vì sao một quyết định cụ thể lại được đưa ra, vì lý do đó phân tán trong hàng tỷ con số chứ không nằm ở một dòng luật nào.
Explainable AI có làm AI chậm hoặc kém đi không?
Các công cụ giải thích sau khi huấn luyện như LIME hay SHAP thường không làm mô hình kém đi, nhưng tốn thêm thời gian tính toán. Nếu chọn hẳn mô hình đơn giản để dễ giải thích thì có thể đổi lại độ chính xác thấp hơn ở bài toán phức tạp.
Chatbot AI có phải là hộp đen không?
Có. Các mô hình ngôn ngữ lớn đứng sau chatbot là mạng nơ-ron rất lớn, nên cũng là hộp đen. Khi chatbot “giải thích” câu trả lời của mình, đó là văn bản nó tạo ra, không nhất thiết phản ánh đúng quá trình tính toán bên trong.
Thí nghiệm chó husky và chó sói có thật không?
Có. Nó nằm trong bài nghiên cứu năm 2016 giới thiệu phương pháp LIME. Các tác giả cố ý tạo bộ dữ liệu mà ảnh chó sói có tuyết để minh họa việc mô hình có thể học sai lý do, và cho thấy lời giải thích giúp con người phát hiện vấn đề này.
Có nên tin quyết định của AI không?
Tùy mức độ ảnh hưởng. Với gợi ý phim, nhạc, sai một chút không sao. Với quyết định về sức khỏe, tài chính, công việc, bạn nên đòi hỏi lý do rõ ràng và có người thật xem xét lại. Một câu trả lời đúng mà không ai hiểu vì sao chưa chắc đã đáng tin.
Kết luận
Hộp đen AI không phải phép màu, cũng không phải âm mưu. AI học bằng cách chỉnh hàng tỷ con số, nên lý do của nó nằm sẵn trong đó, chỉ là khó đọc ra. Ngành AI giải thích được đang dần thắp thêm đèn, nhưng chúng ta vẫn chưa đủ ánh sáng để soi hết.
Điều đó nhắc ta một nguyên tắc cũ: một câu trả lời đúng mà không ai hiểu vì sao chưa chắc đã đáng tin. Lần tới có cỗ máy nào nói “không” với bạn, hãy nhớ hỏi vì sao. Bạn có tin một quyết định của AI mà không ai giải thích được không? Hãy bình luận cho Nhật Phúc biết, và theo dõi kênh để xem thêm các bài giải thích AI dễ hiểu.